
Tek satırlık Qwen4-Max kıyaslamaları: Alibaba'nın tablosu, Qwen4-Max'i her ikisinin de yer aldığı 15 testin tamamında Qwen3.8-Max'in önüne koyuyor ve 16 testin 4'ünde genel birinciliği elde ediyor; ancak bu sayıların çoğu Alibaba'nın kendi çalıştırmalarından geliyor. Work360'ta 47,74'e karşı 52,69 puan alıyor ve görev başına ortalama maliyet 4,43 dolardan 1,67 dolara düşüyor.
Bir kıyaslama, "onu kim çalıştırdı ve nasıl?" sorusunun cevabı kadar işe yarar. Bu rehber, Alibaba'nın 16 Kasım 2026'da yayımladığı tüm puanları ele alıyor, bunları kendi bildirdiği ve üçüncü taraf kaynaklı olarak ayırıyor ve Qwen4-Max API'sine karşı kendi doğrulamanızı çalıştırmanın bir yoluyla sona eriyor. Temel bilgiler için Qwen4-Max nedir ve erişim nasıl alınır yazılarımızla başlayın.
Qwen4-Max kıyaslama puanlarına hızlı bakış
Alibaba'nın tanıtım yazısı, Qwen4-Max'i 16 kıyaslamada Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra ve Kimi K3.1 ile karşılaştırıyor.
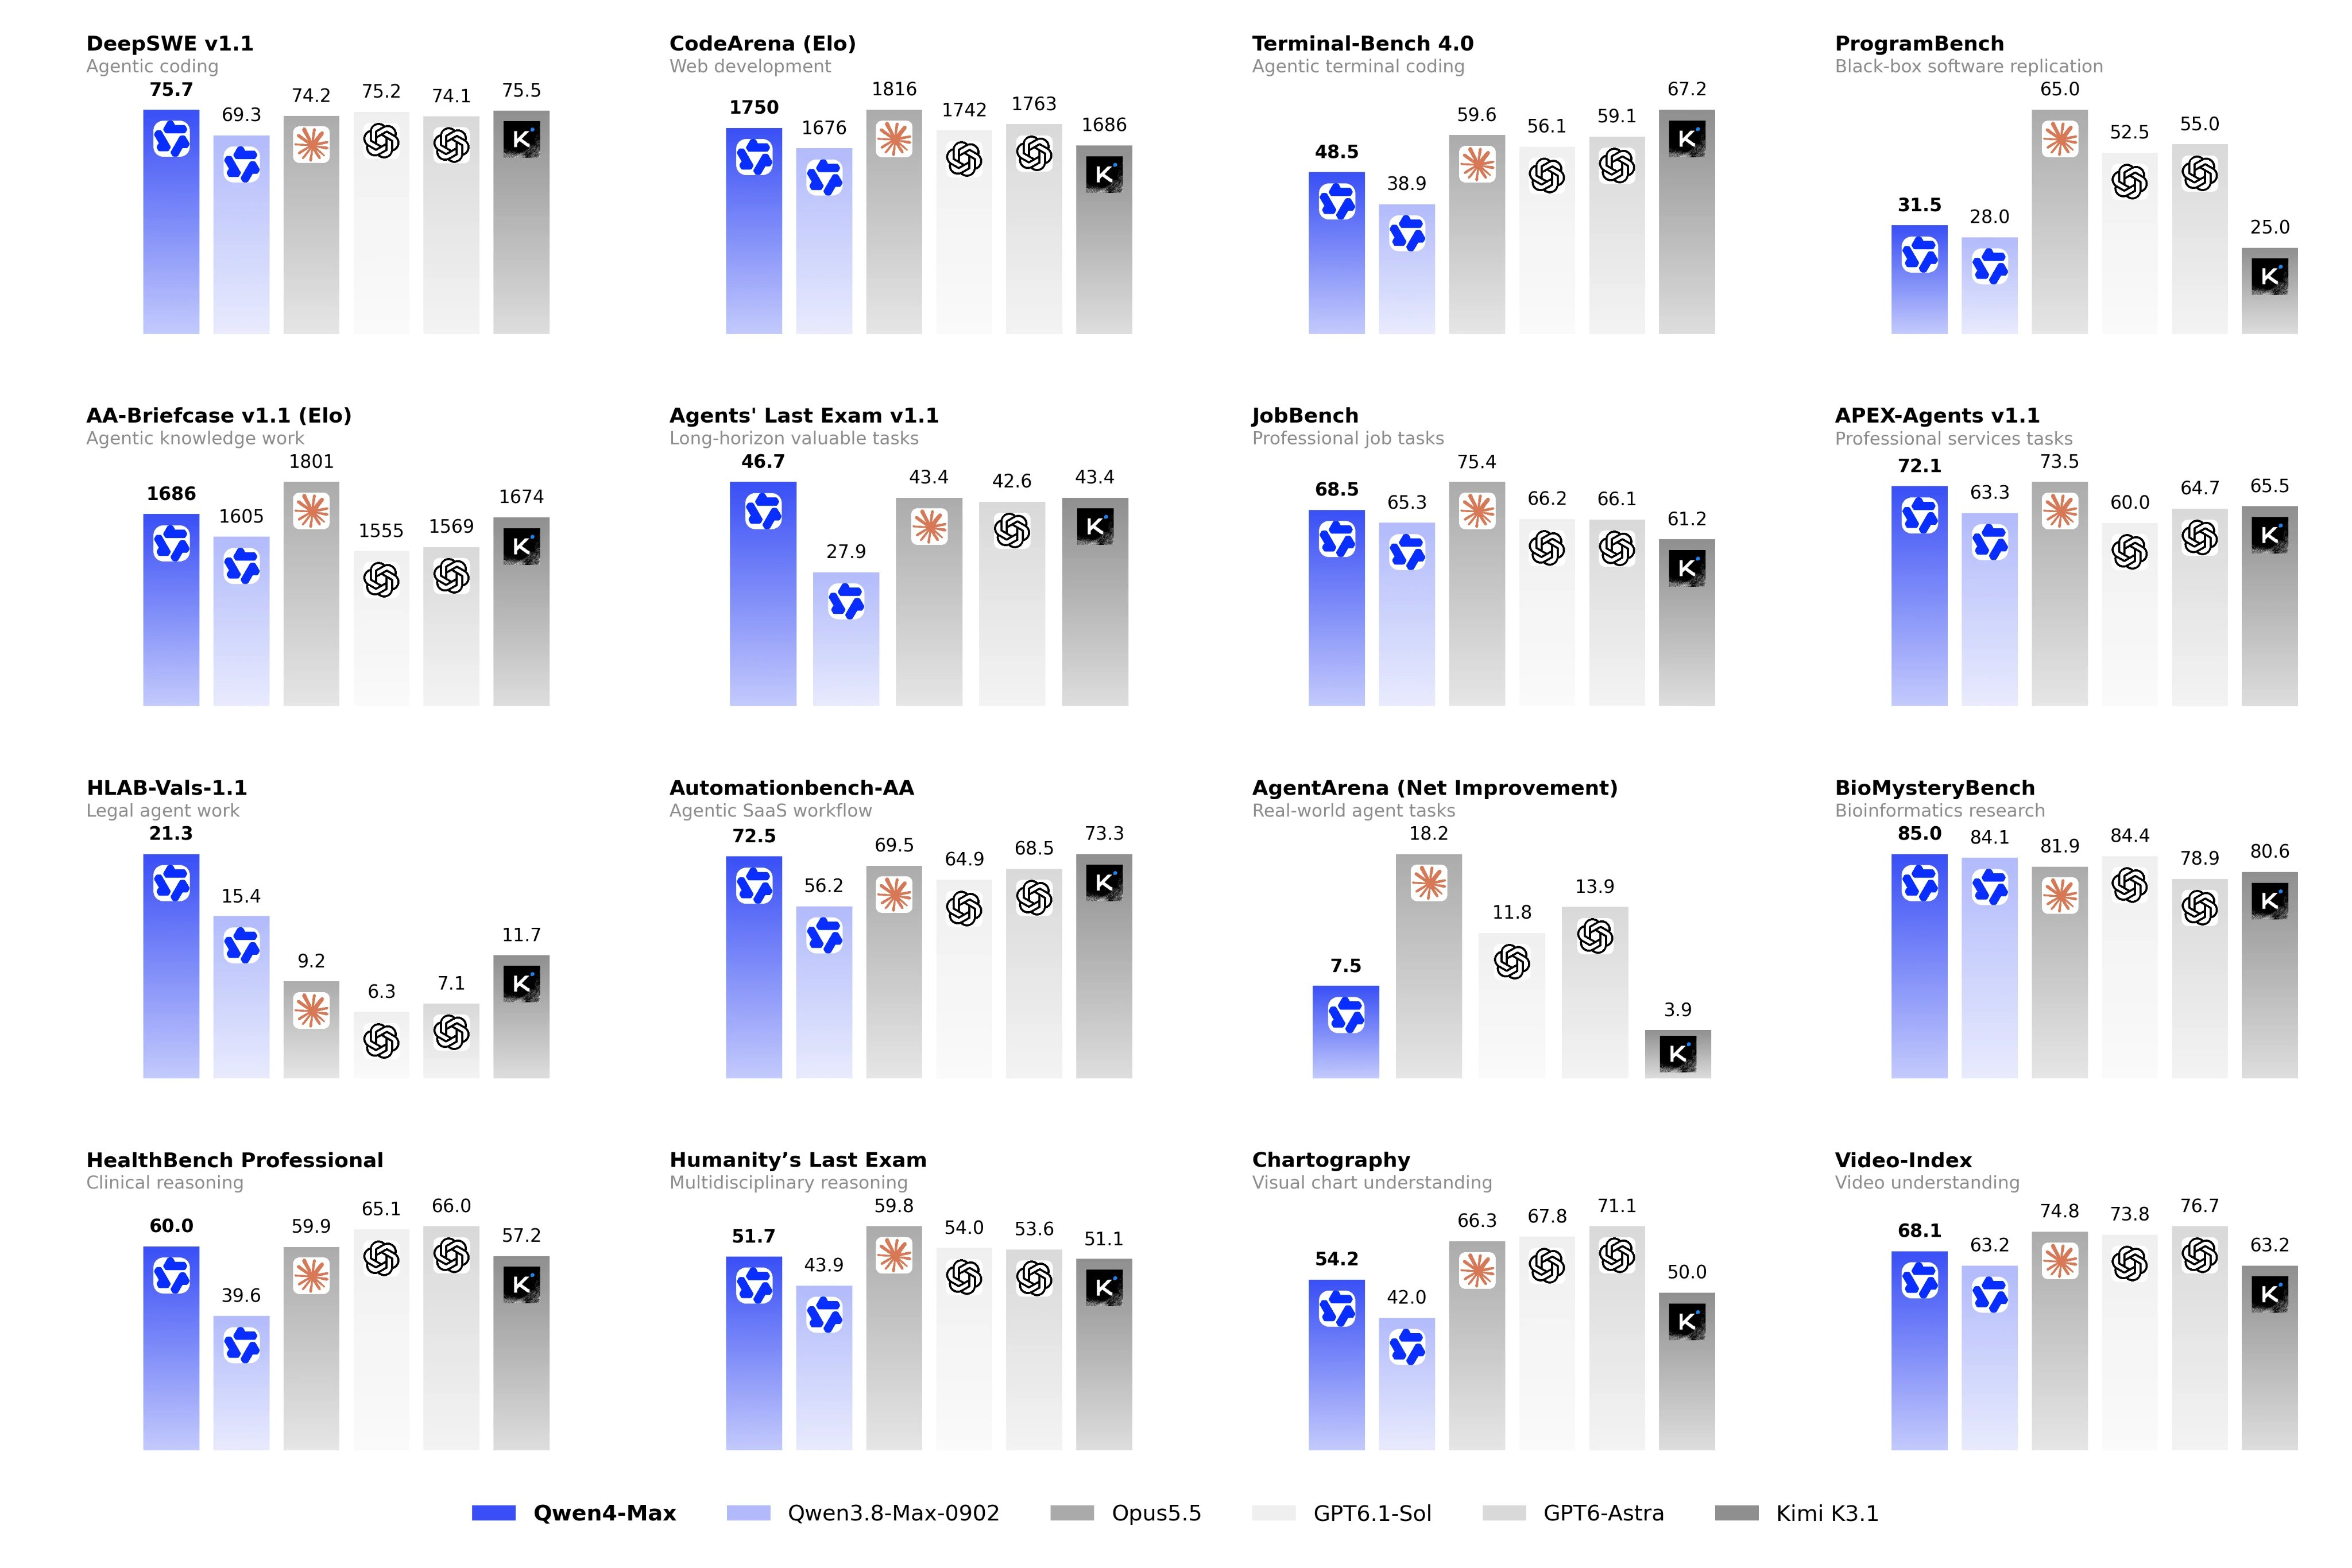
Kalın yazılanlar, tablodaki en yüksek puanı gösterir. "Alibaba" ibaresi, o test için dipnotların hiçbir dış sıralama tablosuna atıf yapmadığı anlamına gelir; yani bunu Alibaba'nın kendi çalıştırması olarak değerlendirin (JobBench ve Chartography dipnotları yalnızca Alibaba'nın kurulumunu açıklıyor).
Kendi bildirimi ile üçüncü taraf: her testi kim çalıştırdı?
16 puanın 10'u kendi bildirimlidir. Altısı, başka biri tarafından yürütülen herkese açık sıralama tablolarından alınmıştır. Bu ayrım, uygulayabileceğiniz en faydalı filtredir.
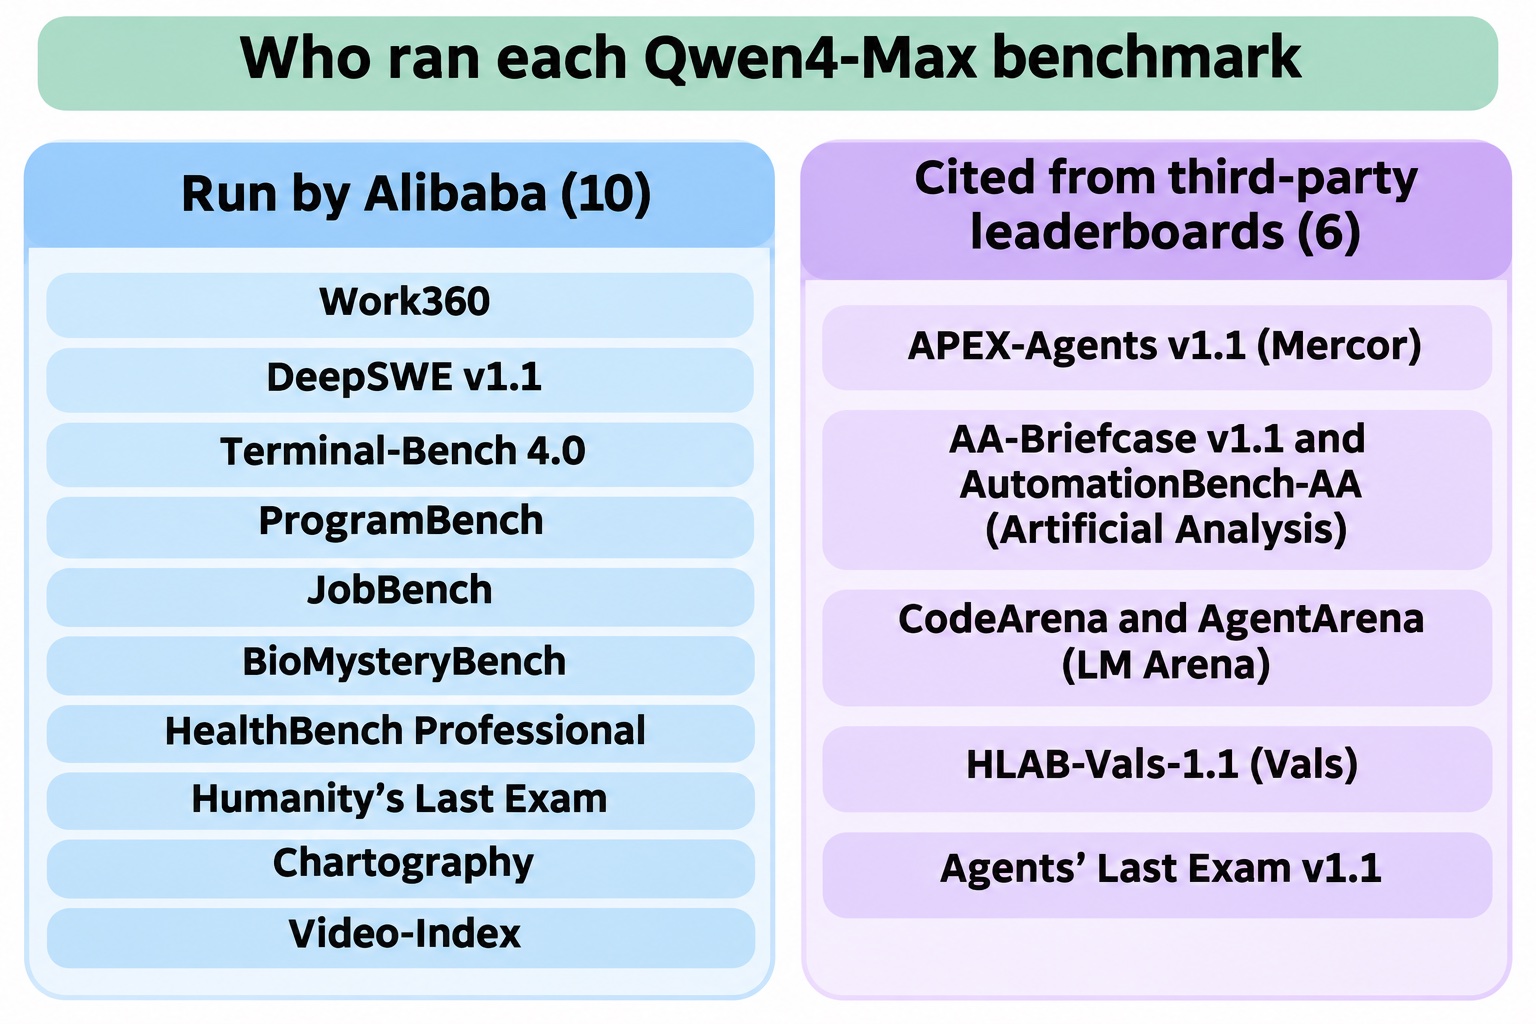
Tanıtım yazısının dipnotlarına göre üçüncü taraf grubu şöyle:
- APEX-Agents v1.1: Mercor APEX-Agents sıralama tablosundan alınmıştır
- AA-Briefcase v1.1 ve AutomationBench-AA: Artificial Analysis kaynaklıdır
- CodeArena ve AgentArena: LM Arena kaynaklıdır
- HLAB-Vals-1.1: Vals Index'ten alınmıştır
- Agents' Last Exam v1.1: kendi sıralama tablosundan alınmıştır
Bugün kontrol edebileceğiniz bağımsız bir sayı: Vals Index (sürüm 2.2, 15 Kasım 2026'da güncellendi), Qwen 4 Max'ı genel olarak %63,20 ile 11. sırada, test başına 9,33 dolarla listeliyor. Bu, onu %71,31 ile zirvede olan Claude Fable 5.2'nin önderlik ettiği on modelin gerisine bırakıyor; Kimi K3.1 Pro'nun (%62,52) ve Qwen 3.8 Max 0902'nin (%59,05) hemen önünde. Manşetteki tabloya göre daha mütevazı bir tablo çiziyor.
Work360: Alibaba'nın kendi iş kıyaslaması
Work360, 26 alanı, 182 alt alanı ve 721 uzmanlık alanını kapsayan, Alibaba'nın karmaşık sektör görevleri için geliştirdiği kıyaslamasıdır. Qwen4-Max 52,69 puan aldı; bu, Qwen3.8-Max'in 47,74 puanının üzerinde.
Bunu dikkatle okuyun: Kıyaslamayı Alibaba tasarladı ve modelleri kendisi çalıştırdı; yayımlanan karşılaştırması yalnızca Qwen4-Max ve Qwen3.8-Max'i kapsıyor ve henüz bunun için herkese açık bir sıralama tablosu yok. Bu, diğer laboratuvarlara karşı bir sıralama değil, nesilden nesile bir sayıdır.
Work360'ın sunduğu şey bir maliyet rakamı: Görev başına ortalama maliyet, görev başına daha az token ve daha düşük fiyatların birlikte etkisiyle 4,43 dolardan 1,67 dolara, yani %62 düştü. Qwen4-Max, QwenCloud model sayfasında 1M giriş tokenı için 1,50 dolar ve 1M çıkış tokenı için 4,50 dolar liste fiyatıyla sunuluyor. Tam dökümü Qwen4-Max fiyatlandırma rehberimizde bulabilirsiniz.
Terminal-Bench 4.0 ve token verimliliği
Terminal-Bench, terminalde gerçek görevleri tamamlayan ajanları ölçer. Alibaba, Qwen4-Max için 4.0 sürümünde 48,5; Qwen3.8-Max için ise 38,9 raporluyor. Alibaba'nın kendi tablosunda, Qwen dışındaki dört model 56,1 ile 67,2 arasında yer alıyor; hepsi onun üzerinde.
Daha iddialı kısım verimlilik. Alibaba, Terminal-Bench 4.0'da token kullanımının Xhigh çabasında yaklaşık %48, High çabasında yaklaşık %49 düştüğünü; Work360'ta ise yaklaşık %24 (Xhigh) ve %35 (High) düştüğünü söylüyor. Puan-token grafiği bu şekli gösteriyor:
- Work360'da Qwen4-Max, High çabasında görev başına yaklaşık 96K token ile yaklaşık 165K'ya karşılık, Xhigh çabasındaki Qwen3.8-Max'i bile geçiyor (grafikten okunmuştur, dolayısıyla yaklaşık değerlerdir).
- Terminal-Bench 4.0'da Qwen4-Max, Xhigh çabasında görev başına yaklaşık 150K token ile 48,5'e ulaşırken, Xhigh çabasındaki Qwen3.8-Max yaklaşık 290K token ile yaklaşık 38'e ulaşıyor.
Token başına ödeme yapıyorsanız, daha iyi bir puan için daha az token doğru yöndedir. Ama bu da kendi bildirimlidir.
Bilinmesi gereken bir kontrol: Herkese açık Terminal-Bench sıralama tablosu artık varsayılan olarak 4.1 sürümünü kullanıyor ve 16 Kasım itibarıyla Qwen4-Max orada listelenmiyor. Qwen3.8-Max-0902, 4.1 sürümünde %27,0 gösteriyor (Claude Code ile maksimum çabada çalıştırılmış); Alibaba'nın 4.0 tablosundaki 38,9 ile karşılaştırın. Farklı sürüm ve test altyapısı söz konusu, dolayısıyla birinden diğerini çıkarmayın; ama bir puanın kurulumla ne kadar değişebildiğini gösteriyor.
Qwen4-Max nerede önde, nerede geride?
Tablodaki diğer frontier modelleriyle karşılaştırıldığında tablo karma:
Önde olduğu alanlar (16'da 4): DeepSWE v1.1 (75,7; Kimi K3.1'in 0,2 puan önünde), Agents' Last Exam v1.1 (46,7), HLAB-Vals-1.1 (21,3) ve BioMysteryBench (85,0; GPT-6.1 Sol'un bir puanın altında farkla önünde).
Sıkı ikincilik: APEX-Agents v1.1 (72,1 - 73,5), AutomationBench-AA (72,5 - 73,3) ve AA-Briefcase (1686 - 1801 Elo).
Açık ara geride: ProgramBench (31,5 - 65,0), Terminal-Bench 4.0 (48,5 - 67,2), AgentArena (7,5 - 18,2), Chartography (54,2 - 71,1) ve Humanity's Last Exam (51,7 - 59,8).
Dört liderliğin ikisi, Agents' Last Exam ve HLAB-Vals, üçüncü taraf sıralama tablolarından geliyor; bu da onları tablodaki en güçlü iddialar yapıyor. Kodlama açısından görüntü bölünmüş: DeepSWE'de dar bir önderlik, ProgramBench ve Terminal-Bench'te geniş farklar var. Uzun süreli terminal ajanları çalıştırıyorsanız, geçiş yapmadan önce test edin. Nesiller arası değişimler için Qwen4-Max vs Qwen 3.8 yazımıza bakın.
Güvenli kodlama ve ön eğitim rakamları
Güvenli kodlama. Last Secure Code Bench'te, "güvenlik ipucu olmadan kod yeniden oluşturma" senaryosunda, hem işlevsellik hem de güvenlik açıkları kontrol edilerek, fonksiyon düzeyindeki başarı oranı Qwen3.8-Max'teki %22,0'dan %31,8'e yükseldi. Üç düzeyin (fonksiyon, dosya ve depo) tamamını geçen kod oranı %8'den %14,7'ye çıktı. Fonksiyon düzeyindeki çıktıların yaklaşık üçte ikisi hâlâ kontrolü geçemiyor; yani güvenlik incelemesi yine sizin göreviniz.
Ön eğitim. Bilgi, kod, soru-cevap ve STEM alanlarındaki dahili değerlendirmelerde Qwen4-Max-Base, %25 daha az parametre etkinleştirirken Qwen3.8-Max-Base'e göre bayt başına yaklaşık %5 ile %13 daha az bit gösteriyor. Alibaba, bu karşılaştırmadaki iki kontrol noktasının (GLM-5.3 ve Kimi-K3.1-Pro) eğitim sonrası işlenmiş olduğunu ve bunun sonucu çarpıtabileceğini belirtiyor.
Hâlâ eksik olanlar
- Çoğu test için değerlendirme ayarları. Tanıtım yazısı, her sütunu hangi çaba düzeyinin (High ya da Xhigh) ve hangi ajan altyapısının ürettiğini söylemiyor.
- Varyans. Ne hata çubukları ne de çalıştırma sayıları var. Terminal-Bench gibi sıralama tabloları yaklaşık 3-4 puanlık marjlar raporluyor; bu, yukarıdaki farkların bazılarından daha büyük.
- Bağımsız Terminal-Bench ve Work360 çalıştırmaları. İkisi de henüz herkese açık bir sıralama tablosunda yer almıyor.
Apidog CLI ile kendi Qwen4-Max kıyaslamınızı çalıştırın
Hiçbir herkese açık kıyaslama sizin istemlerinizi veya şemalarınızı kullanmıyor. Dürüst ve en hızlı kontrol, kendi isteklerinizden oluşan küçük bir test paketini her seferinde aynı şekilde çalıştırmak ve token kullanımını kaydederek kendi görev başına maliyetinizi hesaplayabilmektir.
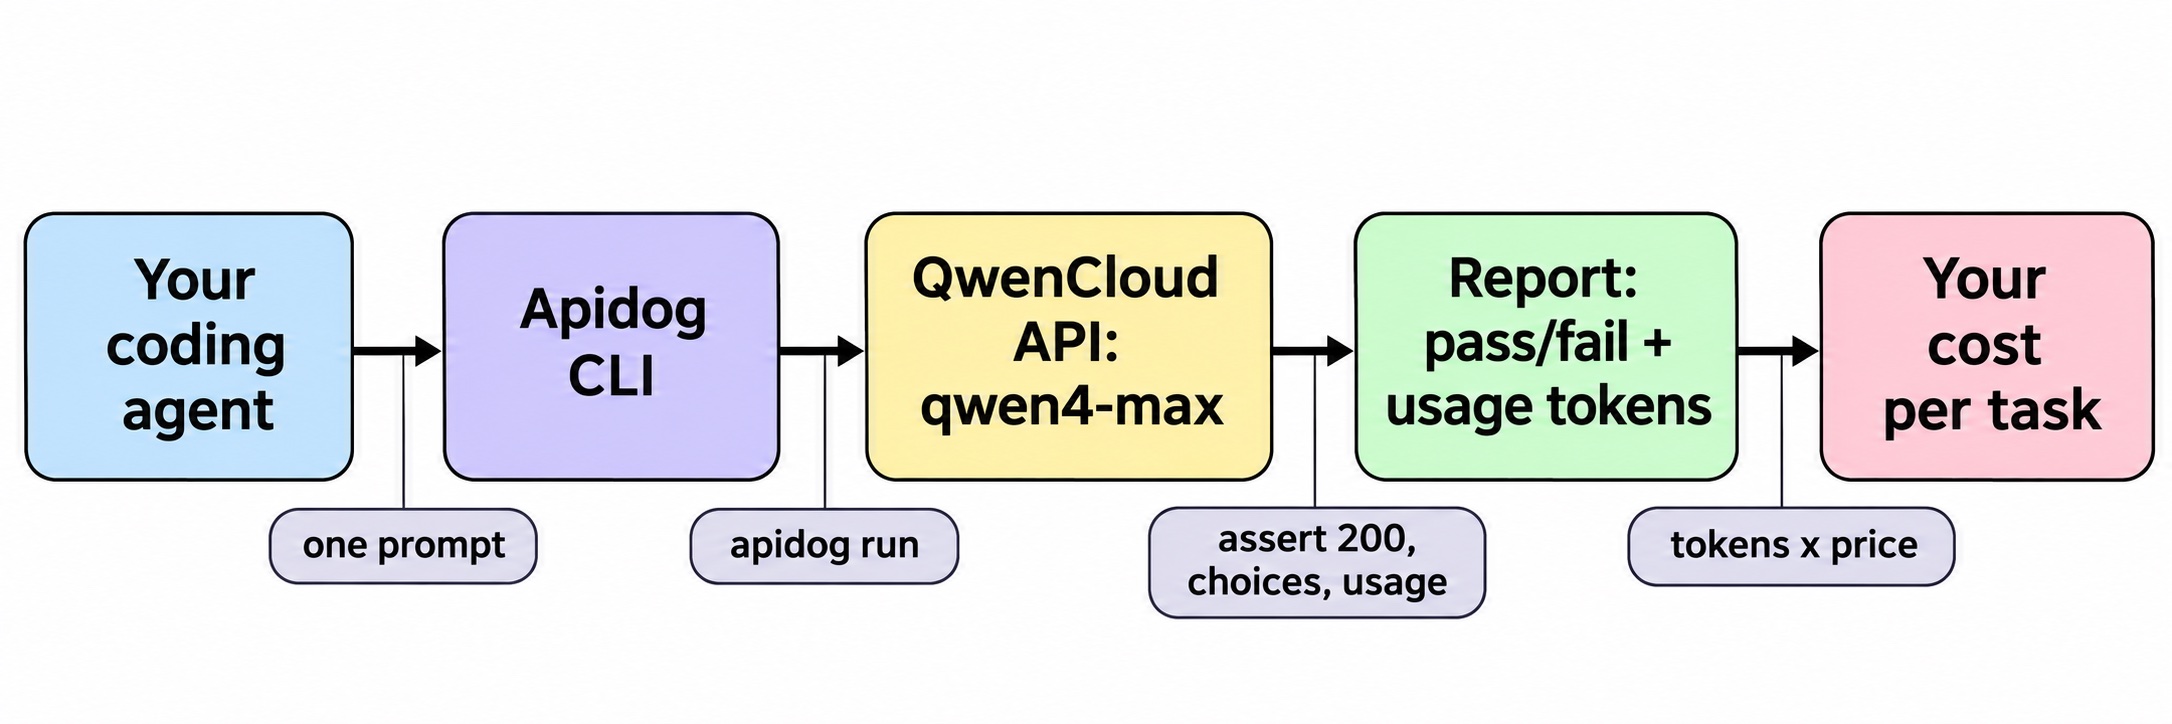
Kurulumu kodlama ajanınıza Apidog CLI ile yaptırın. Bir kez yükleyin:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install, ajanınıza CLI'yi öğretir; token'lar için kurulum rehberine bakın. Sonra ona tek bir istem verin:
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
Ajan, bir şey yazmadan önce her payload yapısını kontrol eder. Aşağıdaki her bayrak, Apidog CLI 2.2.12'deki apidog <command> --help çıktısından alınmıştır:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
-d, istem dosyanızdaki her satır için bir yineleme çalıştırır; --env-var ise anahtarı çalışma anında iletir, böylece anahtar projede asla durmaz. Ajan, apidog-reports içindeki JSON raporundan her usage bloğunu okur. İstem tokenlarını milyon başına 1,50 dolarla, tamamlama tokenlarını 4,50 dolarla çarpın; Alibaba'nın 1,67 dolarına kıyaslayabileceğiniz kendi görev başına maliyetiniz çıkar.
Aynı paketi mevcut modelinize karşı çalıştırmak için ortamı değiştirin ve varyansı görmek için iki üç kez tekrarlayın; tanıtım grafiğinde bunlar görünmüyor. Aynı apidog run satırı, -r junit ile CI'a da girer; bkz. CI/CD rehberi. Adım adım ajan kurulumu için Claude Code'da Apidog CLI yazımıza bakın. Apidog'un Ücretsiz planı 4 kullanıcıya kadar kapsar.
SSS
Qwen4-Max kıyaslamaları bağımsız mı? Büyük ölçüde hayır. Alibaba'nın tablosundaki 16 puanın 10'u kendi çalıştırmalarıdır. Altısı üçüncü taraf sıralama tablolarından alınmıştır: APEX-Agents (Mercor), AA-Briefcase ve AutomationBench-AA (Artificial Analysis), CodeArena ve AgentArena (LM Arena), HLAB-Vals (Vals) ve Agents' Last Exam.
Work360 nedir? 26 alanı kapsayan karmaşık sektör görevleri için Alibaba'nın kendi kıyaslamasıdır. Qwen4-Max, Qwen3.8-Max'in 47,74 puanına karşı 52,69 aldı; yayımlanan karşılaştırmasında yalnızca bu iki model yer alıyor.
Qwen4-Max, Terminal-Bench 4.0'da nasıl performans gösteriyor? Alibaba, tokenların yaklaşık yarısıyla 38,9'dan 48,5'e çıktığını raporluyor. Tablodaki diğer frontier modeller 56,1 ile 67,2 arasında puan alıyor.
Qwen4-Max'i çalıştırmak Qwen3.8-Max'ten daha mı ucuz? Alibaba'nın Work360 değerlendirmesinde görev başına ortalama maliyet 4,43 dolardan 1,67 dolara düştü. Liste fiyatları 1M token için 1,50 dolar giriş ve 4,50 dolar çıkış. Abonelik seçenekleri için Token Plan rehberine, maliyetsiz yollar için Ücretsiz Qwen4-Max yazımıza bakın.
Qwen4-Max tanıtımındaki Live Delivery nedir? Kullanılabilir ilk sürümü erken çıkarıp siz yönlendirirken onu geliştiren bir ajan iş akışıdır. Kıyaslama değildir. Qwen Live Delivery eklenti rehberimiz konuyu ele alıyor.