
Qwen4-Max API, QwenCloud üzerinde token başına ödeme modeliyle qwen4-max kimliğiyle kullanıma sunuldu. Bulunduğunuz bölgede kullandıkça öde tipinde bir anahtar oluşturun, OpenAI SDK'sını https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 (Singapur) adresine yönlendirin ve çağrıyı yapın. Girdi için milyon token başına 1,50 $, çıktı için 4,50 $ maliyeti var; bağlam penceresi 1M token.
Bu rehber; anahtar, temel URL'ler, düşünme modu, vision, araçlar, yapılandırılmış çıktılar, önbellekleme, Anthropic rotası, limitler ve hataları kapsıyor. Tüm kod örnekleri 16 Kasım 2026 itibarıyla okunduğu haliyle QwenCloud dokümantasyonunu takip ediyor.
Arka plan bilgisi için Qwen4-Max'in ne olduğuna göz atın. Token başına ödeme yerine abonelik erişimi için Qwen4-Max'i kullanmanın tüm yollarına ve Token Planı rehberine bakın.
Qwen4-Max API'nin sunduğu özellikler
Qwen4-Max API, Alibaba'nın amiral gemisi modelinin QwenCloud üzerinden OpenAI uyumlu, Anthropic uyumlu ve DashScope uç noktalarıyla servis edilmiş halidir. Metin, görsel ve video girdisi alır, metin döndürür, varsayılan olarak yanıt vermeden önce düşünür ve function calling, yapılandırılmış çıktılar, bağlam önbellekleme, batch işler, web arama ve ince ayar (fine-tuning) destekler.
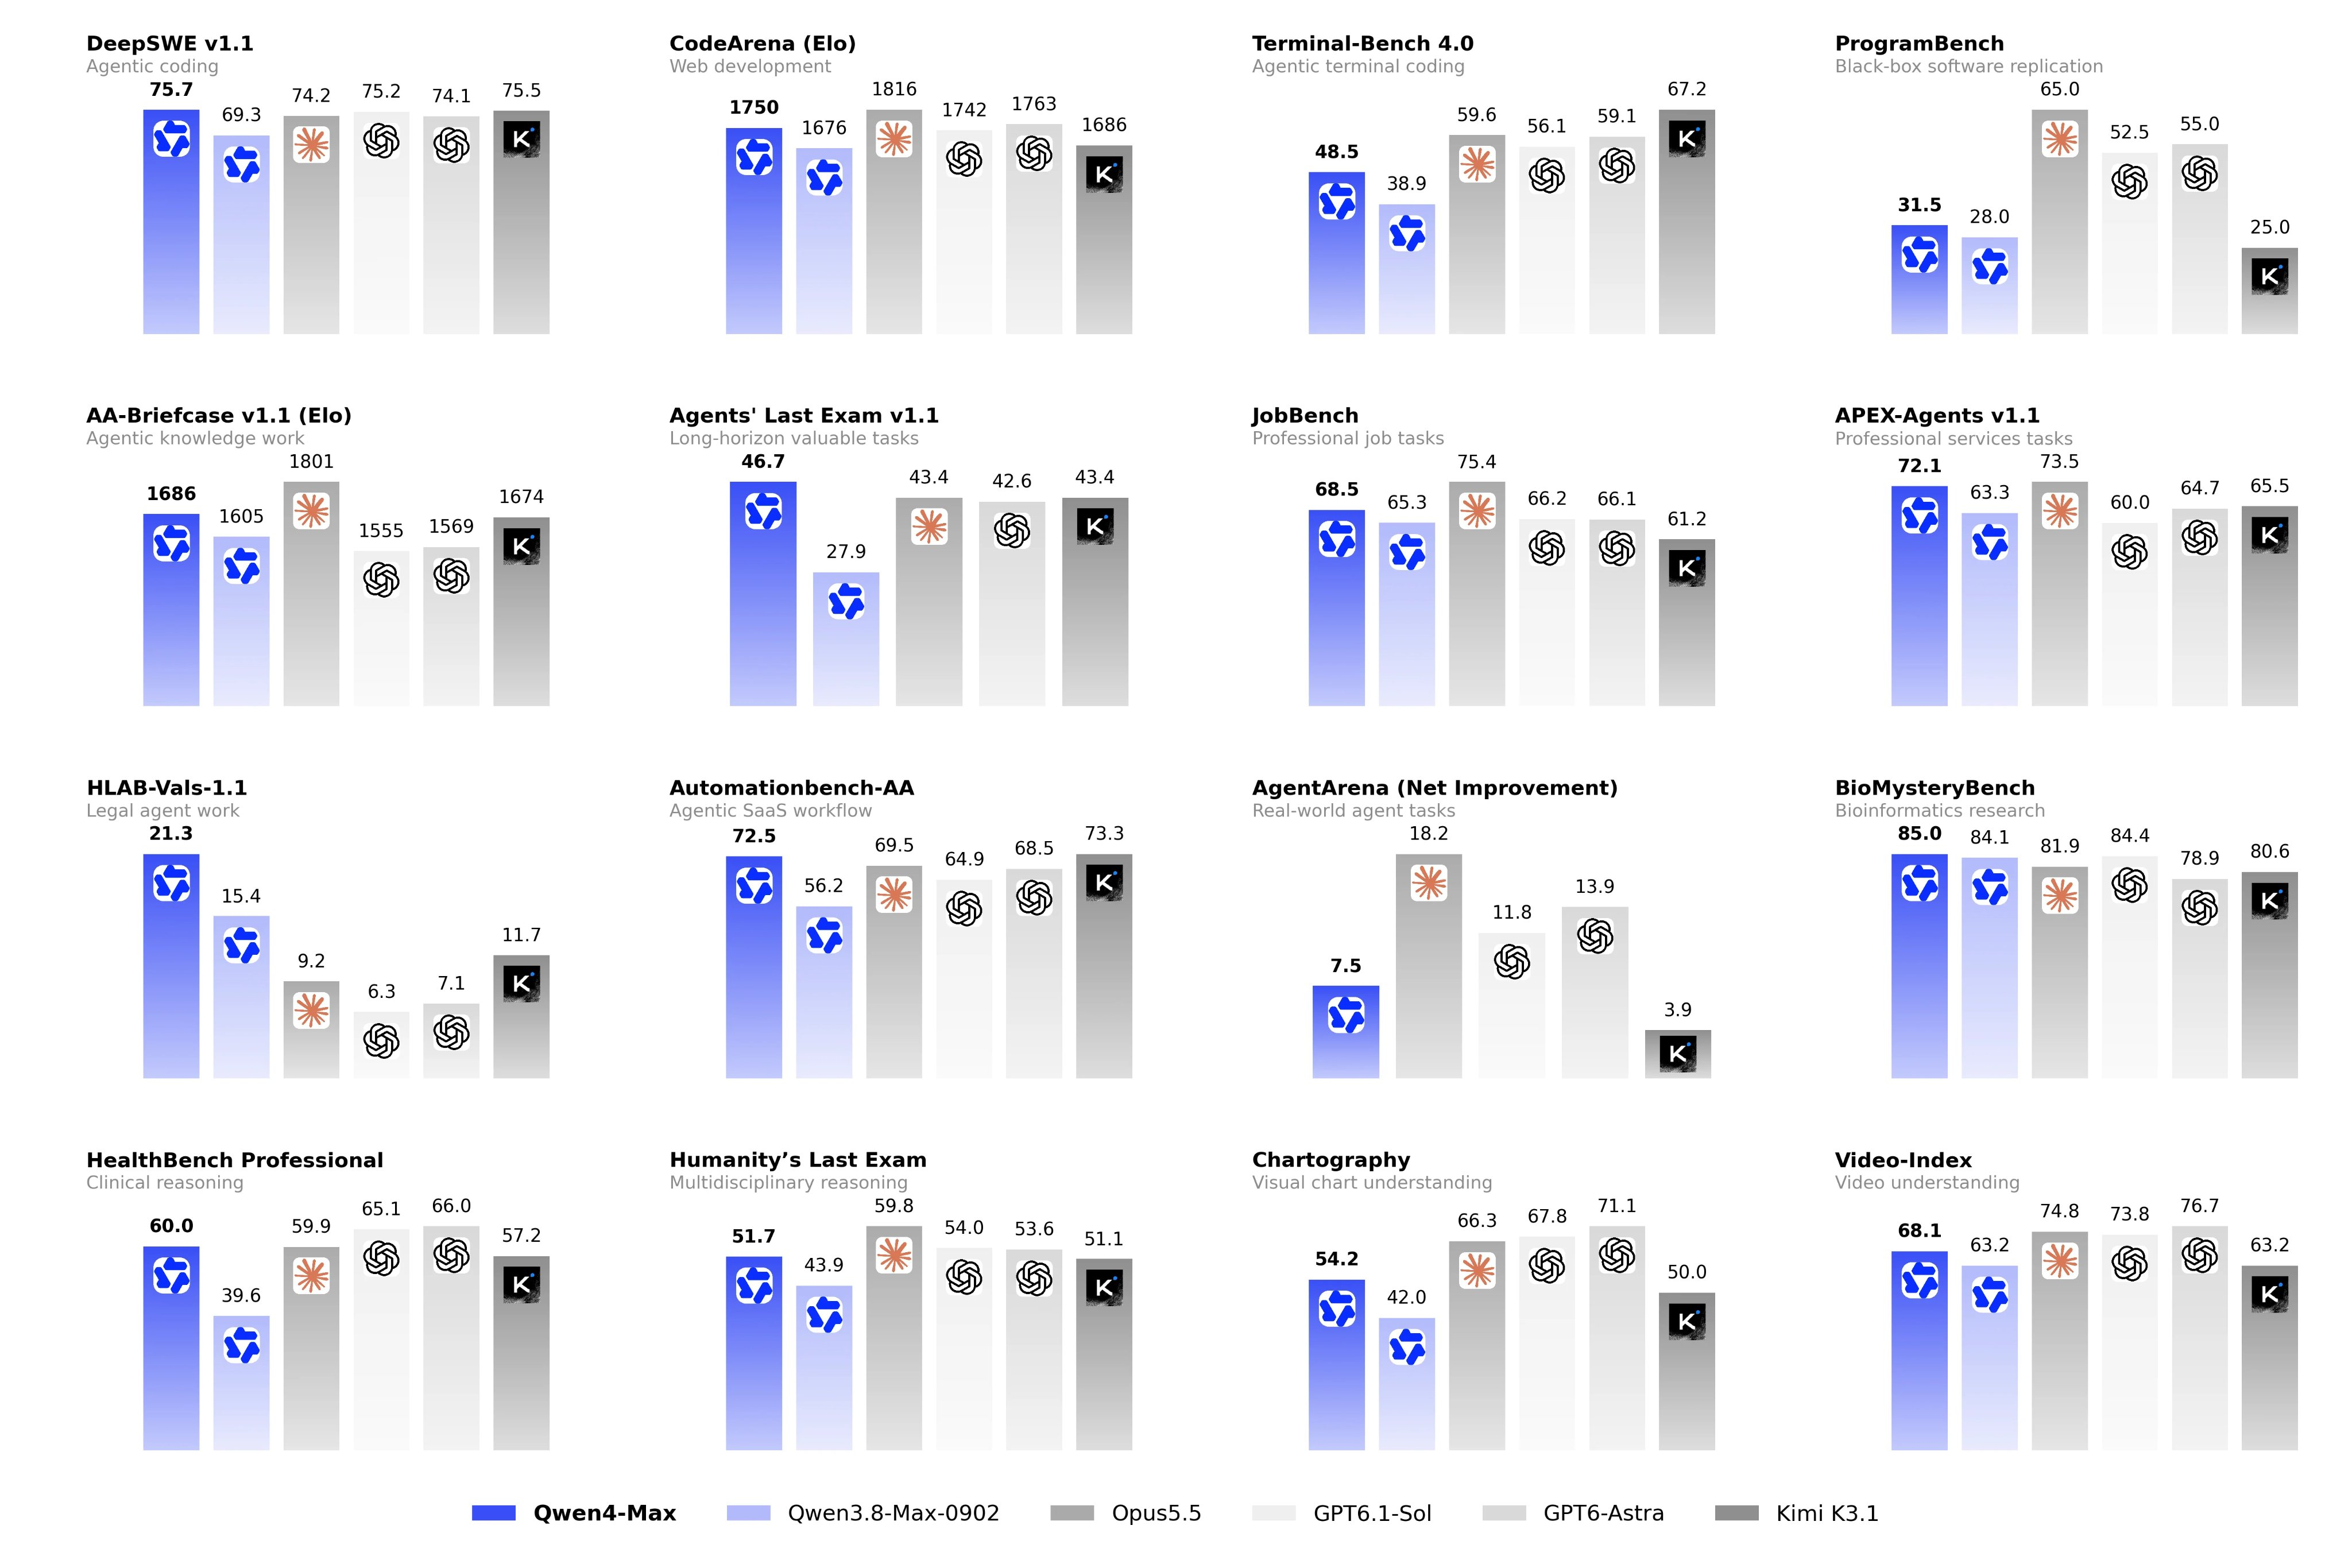
qwen4-max model sayfasından alınan sayısal veriler şöyle:
| Kalem | Değer |
|---|---|
| Model kimliği | qwen4-max |
| Girdi fiyatı | 1M token başına 1,50 $ |
| Çıktı fiyatı | 1M token başına 4,50 $ |
| Örtük önbellek girdisi / açık önbellek okuması | 1M token başına 0,075 $ |
| Açık önbellek oluşturma | 1M token başına 1,875 $ (5 dakika) veya 3 $ (1 saat) |
| Bağlam penceresi | 1M token |
| Maksimum girdi | 991K (düşünme moduyla 983K) |
| Maksimum çıktı | 393K |
| Maksimum akıl yürütme | 262K |
| Verim | 5.000.000 TPM |
Düşünme tokenları çıktı tokenı olarak faturalandırılır. Tam maliyet dökümü için Qwen4-Max fiyatlandırma rehberine bakın.
Anahtar edinin ve doğru temel URL'yi seçin
Anahtarlar bir bölgeye bağlıdır ve anahtar tipi uç noktayla eşleşmelidir.
- QwenCloud konsolunu açın ve sağ üstteki seçiciden bir bölge seçin.
- API Keys bölümüne gidin, Create API key seçeneğine tıklayın, bir açıklama ekleyin ve Generate Key butonuna basın.
- Anahtarı hemen kopyalayın; yalnızca bir kez gösterilir. Yeni kullandıkça öde anahtarları
sk-ws-ile başlar. - Dışa aktarın:
export DASHSCOPE_API_KEY="sk-ws-...".
Her bölge {region}.maas.qwencloudapi.com alan adını kullanır. Singapur ap-southeast-1; Frankfurt eu-central-1, Tokyo ap-northeast-1 ve ABD (Virginia) us-east-1 olur. Ardından protokol yolunu ekleyin:
| Protokol | Temel URL (Singapur) |
|---|---|
| OpenAI uyumlu (Chat Completions, Responses) | https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 |
| Anthropic uyumlu | https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic |
| DashScope HTTP | https://ap-southeast-1.maas.qwencloudapi.com/api/v1 |
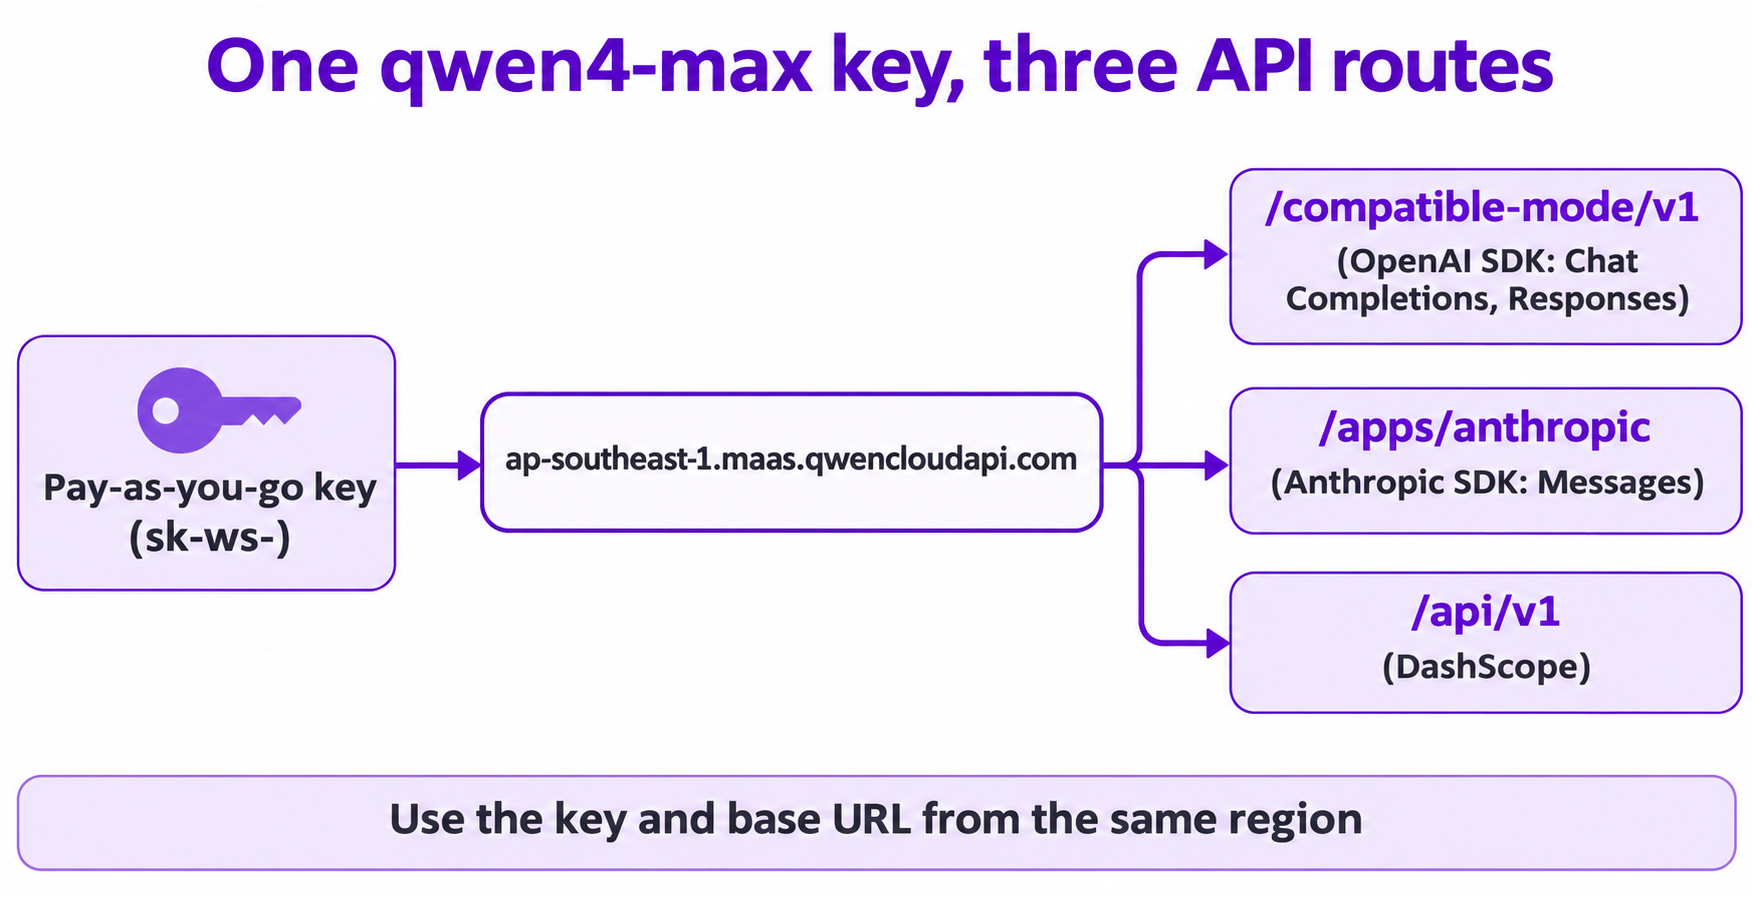
Bir Token Planı anahtarı (sk-sp-) yalnızca token-plan.maas.qwencloudapi.com üzerinde çalışır; kullandıkça öde anahtarı ise yalnızca kendi bölgesinin alan adında çalışır. İkisini karıştırmak 401 hatasına yol açar. Bölgeler ve uç noktalar sayfasına bakın.
İlk Qwen4-Max API çağrınız
OpenAI SDK'sını kurun (pip install openai) ve dokümandaki hızlı başlangıç örneğini çalıştırın:
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.getenv("DASHSCOPE_API_KEY"),
  base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1"
)
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Summarize the benefits of solar energy in three bullet points."}]
)
print(completion.choices[0].message.content)
qwen4-max için düşünme modu varsayılan olarak açıktır; dolayısıyla bu çağrı akıl yürütme tokenlarını da harcar. Uzun girdiler için akış (streaming) kullanın veya istemci zaman aşımını 180 saniye ve üzerine ayarlayın.
Düşünme modu ve reasoning_content akışı
Qwen4-Max, hibrit bir düşünme modelidir. Dokümandaki varsayılanlar şunlardır: enable_thinking=true, reasoning_effort=high ve thinking_budget=131072. Efor seviyeleri low, high ve xhigh'tur; none düşünmeyi kapatır.
Akıl yürütme ve yanıtı iki aşamalı olarak akışla alın (model sayfasındaki örnekten uyarlanmıştır):
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
messages = [{"role": "user", "content": "Who are you"}]
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True)  # phase 1: thinking
    if delta.content:
        print(delta.content, end="", flush=True)            # phase 2: answer
Üç kural:
- Çıktıyı
max_completion_tokensile sınırlayın. Düşünme açıkkenmax_tokensyalnızca 1 ile 32.768 arasındaki değerleri kabul eder (aksi halde 400 döner).max_completion_tokensbu sınırlama olmadan akıl yürütme ve yanıtı kapsar. - Derinliği
extra_bodyile ayarlayın. Zor problemler için{"enable_thinking": True, "reasoning_effort": "xhigh"}, basit işler için"low"kullanın. - Çok turlu sohbetlerde akıl yürütmeyi koruyun.
qwen4-max'tapreserve_thinkingvarsayılan olarak açıktır; bu yüzden önceki akıl yürütmeyi her asistan mesajınınreasoning_contentalanında geri gönderin, aslacontentiçine koymayın.
Düşünmeyi atlamak için {"enable_thinking": False} gönderin.
Görsel ve video girdisi
Görselleri image_url parçaları olarak, videoları video_url parçaları olarak gönderin. Aşağıdaki örnek, modeli qwen4-max olarak ayarlanmış doküman vision örneğinin aynısıdır:
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{
    "role": "user",
    "content": [
      {"type": "image_url", "image_url": {"url": "https://example.com/invoice.jpg"}},
      {"type": "text", "text": "Describe what you see in this image"},
    ],
  }],
)
Video için {"type": "video_url", "video_url": {"url": "..."}, "fps": 2} kullanın. Yerel dosyalar Base64 Data URI olarak gönderilir.
Vision rehberine göre her biri 20 MB olan en fazla 2.048 URL görseli, 250 Base64 görseli ve istek başına 64 MB sınırı vardır. Görsel detayı varsayılan olarak yüksektir; bu da daha fazla girdi tokenı maliyetine yol açar.
Function calling
Herhangi bir OpenAI uyumlu modelde olduğu gibi bir tools dizisi gönderin:
tools = [{
  "type": "function",
  "function": {
    "name": "get_current_weather",
    "description": "Useful when you want to check the weather for a specific city.",
    "parameters": {
      "type": "object",
      "properties": {"location": {"type": "string", "description": "City or county, such as Singapore or New York."}},
      "required": ["location"],
    },
  },
}]
completion = client.chat.completions.create(model="qwen4-max", messages=messages, tools=tools)
message.tool_calls alanını okuyun, fonksiyonu çalıştırın, bir tool mesajı ekleyin ve tekrar çağırın.
Düşünme modunda tool_choice yalnızca "auto" veya "none" kabul eder; bir fonksiyonu zorlamak için önce düşünmeyi devre dışı bırakın. Düşünme açıkken araç sonuçlarıyla birlikte reasoning_content alanını geri gönderin, aksi halde doğruluk düşer.
Yapılandırılmış çıktılar
qwen4-max, katı JSON Schema modunu destekler:
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Extract the name and age: Ana is 31."}],
  response_format={
    "type": "json_schema",
    "json_schema": {
      "name": "user_info",
      "strict": True,
      "schema": {
        "type": "object",
        "properties": {"name": {"type": "string"}, "age": {"type": "integer"}},
        "required": ["name", "age"],
        "additionalProperties": False,
      },
    },
  },
)
Daha esnek {"type": "json_object"} modunda, bir mesajda "JSON" kelimesi geçmelidir, aksi halde API isteği reddeder. Görsel veya video girdisinde sistem json_object moduna geri düşer; dolayısıyla şema çok kipli (multimodal) çağrılarda zorunlu tutulmaz.
Bağlam önbelleği ve batch
Önbellek. Ayar yapılmadığında, örtük önbellek önekleri eşleştirir ancak isabet garantisi vermez. Deterministik isabet için Qwen4 açık önbelleğini kullanın: bir içerik bloğunu "prompt_cache_breakpoint": {"mode": "explicit"} ile işaretleyin (mesajın content alanı bir dizi olmalıdır) ve TTL'i extra_body={"prompt_cache_options": {"mode": "explicit", "ttl": "5m"}} ile belirleyin. TTL 5m veya 1h olabilir; önbelleğe alınan önek en az 1.024 token olmalıdır. Okumalar milyon token başına 0,075 $ maliyetlidir — taze girdiden %95 daha ucuz.
Batch. Batch rehberine göre girdi ve çıktı, gerçek zamanlı fiyatın %50'si üzerinden faturalandırılır ve sonuçlar 24 saat içinde döner. qwen4-max için Batch File, Singapur dışında tek bir bölgede çalışır ve bağlam önbellekleme desteklemez; dolayısıyla bu özelliğe dayalı bir pipeline kurmadan önce batch rehberini kontrol edin.
Anthropic uyumlu rota
Zaten Anthropic SDK'sıyla mı çalışıyorsunuz? Yalnızca temel URL'yi ve anahtarı değiştirin:
import anthropic
import os

client = anthropic.Anthropic(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic",
)
message = client.messages.create(
    model="qwen4-max",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Who are you?"}],
    thinking={"type": "disabled"},
)
print(message.content)
Bu örnek, dokümanın kendi örneğinde olduğu gibi düşünmeyi kapatıyor. Temel URL'yi /apps/anthropic ile bitirin. /v1/ eklemek /v1/v1/... üretir ve 404 döndürür. Burada da düşünme varsayılan olarak açıktır ve düşünme etkinleştirildiğinde max_tokens değeri düşünme bütçesinden büyük olmalıdır. Efor ayarı output_config.effort ile yapılır (low, high, xhigh); yerleşik web_search ve web_fetch araçları bu rotada kullanılabilir.
Qwen4-Max API hız limitleri
| Bölge | RPM | TPM |
|---|---|---|
| Singapur | Dinamik | Dinamik katmanlar: 5M, 10M, 20M |
| Frankfurt, Tokyo, ABD (Virginia) ve diğer Global kapsamlı bölgeler | 30.000 | 5.000.000 |
Limitler bölge başına hesap bazında ve ayrıca saniye başına uygulanır (RPS = RPM / 60); dolayısıyla ani bir yük artışı sizi dakikalık toplamın altında kısıtlayabilir.
Ücretsiz kota sayfasına göre ücretsiz kota yalnızca Singapur'da bulunur, model başınadır (tipik olarak 1.000.000 token), 90 gün geçerlidir ve dosyada ödeme bilgisi gerektirir. Sayfa qwen4-max için bir kota belirtmiyor; dolayısıyla konsoldaki Free Tier sayfasını kontrol edin veya Qwen4-Max'i ücretsiz nasıl kullanabileceğinize göz atın.
Yaygın Qwen4-Max API hataları
| Kod | Anlamı | Çözüm |
|---|---|---|
401 InvalidApiKey |
Anahtar ve temel URL farklı bölgelerden geliyor ya da bir Token Planı anahtarı kullandıkça öde uç noktasına gönderildi | URL ile aynı bölgede oluşturulmuş bir anahtar kullanın |
400 InvalidParameter |
Genellikle düşünme açıkken max_tokens değerinin 1 ile 32.768 aralığının dışında olması |
max_completion_tokens kullanmaya geçin |
403 AllocationQuota.FreeTierOnly |
Ödeme bilgisi ayarlanmadan ücretsiz kotanın tükenmesi | Free Tier sayfasına ödeme bilgisi ekleyin |
404 ModelNotFound |
qwen4-max, çağrı yaptığınız bölgede sunulmuyor |
O bölge için Model fiyatlarını kontrol edin |
429 Throttling |
RPM veya TPM limitine ulaşıldı | Geri çekilip tekrar deneyin veya yükü saniyelere dağıtın |
Kodlama ajanınızın Qwen4-Max API'yi Apidog CLI ile test etmesine izin verin
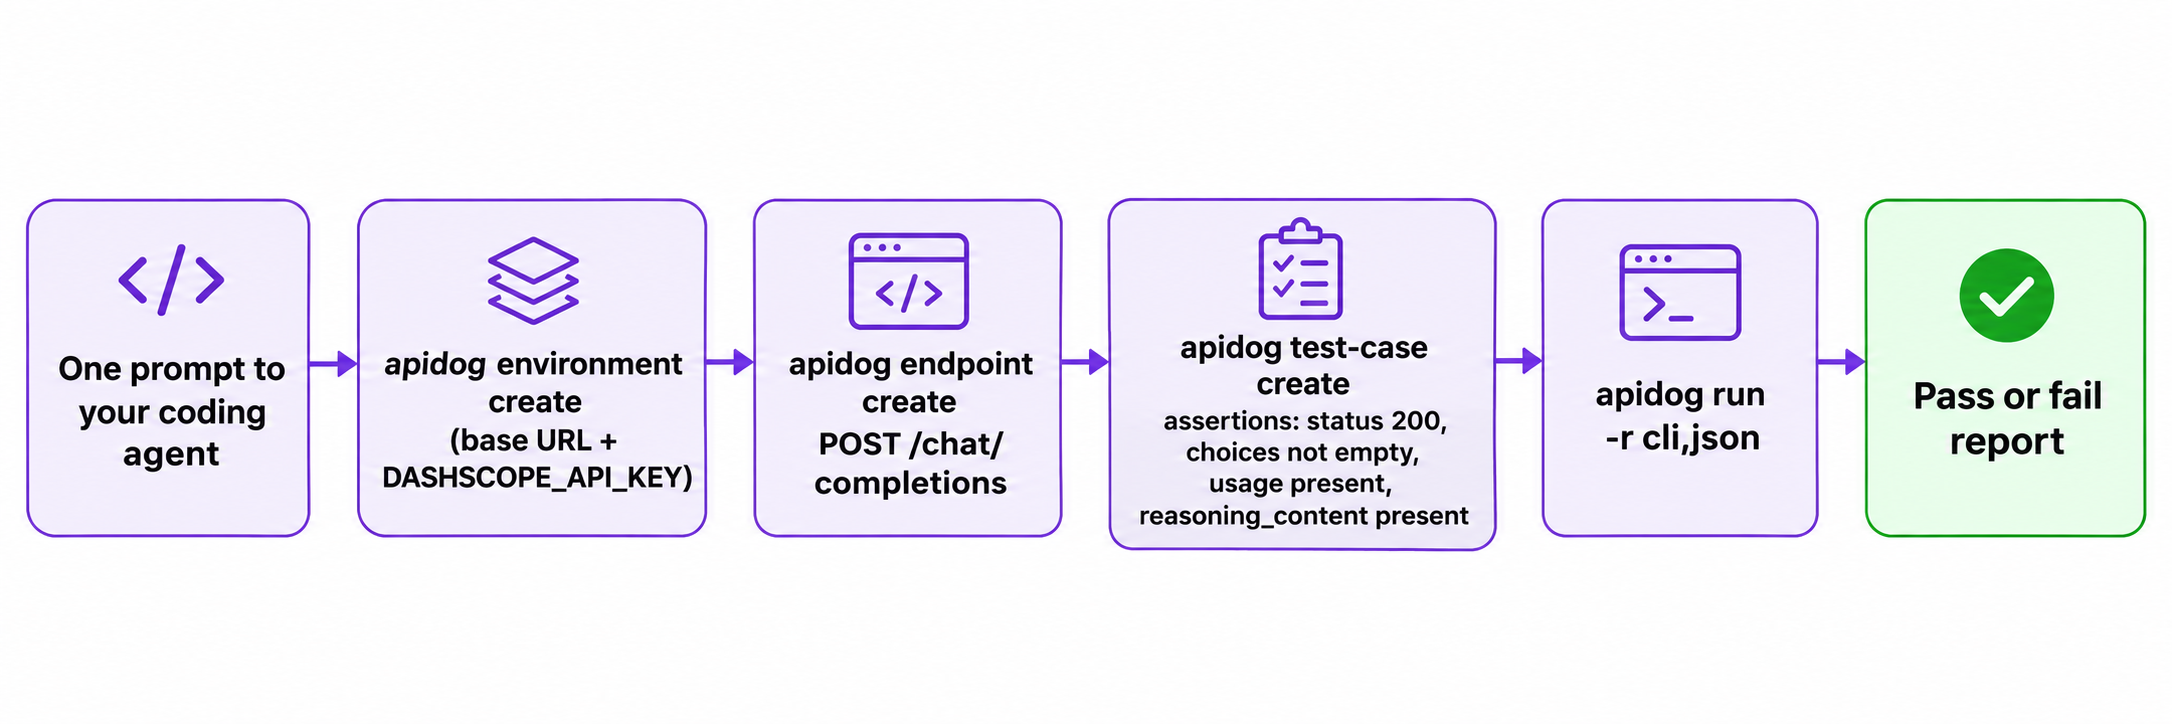
Kodlama ajanınız entegrasyonu yazıyorsa regresyon testini de yazsın. Apidog CLI, uç noktayı kaydetmesini, anahtarı saklamasını ve doğrulamaları çalıştırmasını sağlar.
Tek seferlik kurulum:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ardından ajanınıza tek bir komut verin:
In Apidog project <projectId>, create an environment "Qwen Singapore" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable DASHSCOPE_API_KEY. Add POST /chat/completions with a Bearer auth header,
model qwen4-max and enable_thinking true. Create a test case asserting status 200,
a non-empty choices array, a usage object, and reasoning_content present on the
first choice's message. Run it and summarize any failures.
Ajan, yazmadan önce her payload şemasını okur ve ardından testi çalıştırır:
apidog environment create "Qwen Singapore" --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get environment-update
apidog environment update <envId> --project <projectId> --file env.json
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
cli raporlayıcısı geçti veya kaldı çıktısı verir; json ise ajanın okuyabileceği bir rapor yazar. Aynı apidog run ... -r junit komutunu Apidog CLI CI/CD rehberiyle CI'a taşıyın; daha fazla komut örneği için Claude Code'da Apidog CLI yazısına bakın. Apidog'un Ücretsiz planı 4 kullanıcıya kadar kapsar.
SSS
Qwen4-Max API'nin model kimliği nedir?
Sabit kimlik qwen4-max'tir. Önceki qwen4-max-preview kimliği, 11 Kasım 2026'da başlayan önizleme süresince yalnızca Token Planı için kullanılıyordu.
Qwen4-Max API OpenAI uyumlu mu?
Evet. Chat Completions ve Responses API için OpenAI SDK'sını /compatible-mode/v1 temel URL'siyle kullanın. Ayrıca Anthropic uyumlu bir uç nokta ve DashScope API de mevcuttur.
Qwen4-Max API'de düşünmeyi nasıl kapatırım?
extra_body={"enable_thinking": False} gönderin. reasoning_content alanını kaybedersiniz, ancak gecikme ve çıktı tokenları azalır. Modelleri karşılaştırıyor musunuz? Qwen4-Max vs Qwen3.8 yazısına bakın.
Qwen4-Max API'nin maliyeti nedir?
Milyon girdi tokenı başına 1,50 $ ve milyon çıktı tokenı başına 4,50 $; önbelleğe alınmış okumalar milyonda 0,075 $.
Token Planı anahtarımı token başına ödeme API'siyle kullanabilir miyim?
Hayır. Token Planı anahtarları (sk-sp-) yalnızca token-plan.maas.qwencloudapi.com üzerinde çalışır; kullandıkça öde anahtarları ise yalnızca kendi bölgesinin alan adında çalışır.