
Mistral Large 4 açık ağırlıkları 29 Ekim 2026'da Hugging Face'te yayınlandı. Mistral'in API'sinde sunduğu aynı 1.05T parametreli modeli, değiştirilmiş MIT lisansı altında, FP8 ve NVFP4 kontrol noktaları ile topluluk GGUF nicelemeleri olarak elde edersiniz. Onay adımı olmadan indirebilir, vLLM veya SGLang ile 8 veri merkezi GPU'sunda sunabilir veya donanımı atlayıp Mistral API'sinde mistral-large-4'ü milyon giriş token'ı başına $0.70 karşılığında çağırabilirsiniz.
Aşağıda: 6 Ekim önizlemesinden bu yana neler değişti, indirme boyutları, rotaya göre donanım ve lisans. Model genel bakışı için Mistral Large 4 lansman analizimizi okuyun; istek formatları ve SDK kodu için Mistral Large 4 API kılavuzuna bakın.
Mistral Large 4 açık ağırlıkları nedir?
Mistral Large 4 açık ağırlıkları, Mistral'in amiral gemisi modelinin indirilebilir kontrol noktalarıdır ve takma adı "Le Chonk"tur. Yaklaşık 1.05T toplam parametreye, token başına yaklaşık 49B aktif parametreye (gömme ve çıktı katmanları dahil 52B), 1.6B görüntü kodlayıcıya ve 1M token bağlam penceresine sahip çok modlu bir uzman karışımı modelidir; Mistral Ekosistemi Açık Ağırlık Lisansı altında yayınlanmıştır.
Resmi model kartı 72 metin katmanı ve 128 yönlendirilmiş uzman listeler; token başına 4 uzman seçilir artı 1 paylaşılan uzman.
Sürüm, önizlemenin donmuş bir kopyası değil. Mistral'in açık ağırlık duyurusu, ağırlıklar yayınlanmadan önce modelin kodlama ve siber güvenliğe odaklanan üç hafta daha pekiştirmeli öğrenme aldığını söylüyor.
6 Ekim önizlemesinden bu yana neler değişti
Önizleme sırasında Large 4'ü test ettiyseniz, artık dört şey farklı.
| Alan | 6 Ekim önizlemesi | 29 Ekim açık sürümü |
|---|---|---|
| Ağırlıklar | Yalnızca API, ağırlıklar sonra vaat edildi | Hugging Face'te FP8 ve NVFP4, kapısız |
| Akıl yürütme modları | high veya none |
low, medium, high (varsayılan high); low, none'un yerini alır |
| Terminal-Bench 4.0 (Mistral tarafından bildirilen) | 28% | 41%, yaklaşık %30 daha az çıktı token'ı ile |
| B3 Ajan Güvenliği saldırı direnci (Mistral tarafından bildirilen) | 93.3% | 97.1% |
| 1M token başına API fiyatı | Önizleme indirimiyle gösterildi | $0.70 giriş, $0.07 önbelleklenmiş giriş, $2.10 çıktı |
Akıl yürütme değişikliği kodu bozar. Önizleme entegrasyonunuz reasoning_effort: "none" gönderiyorsa, bunu "low" olarak değiştirin: Hugging Face lansman yazısı, Transformers'ın none'u high olarak çalıştırdığını belirtiyor, bu nedenle eski bir ayar başarısız olmak yerine token'a mal oluyor.
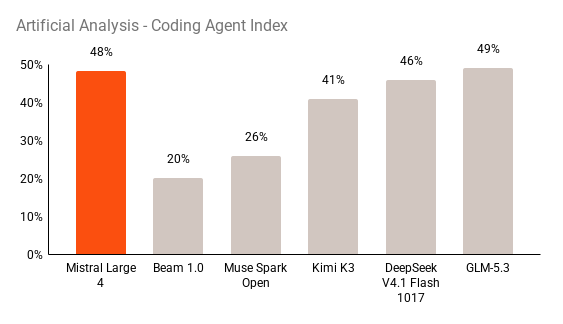
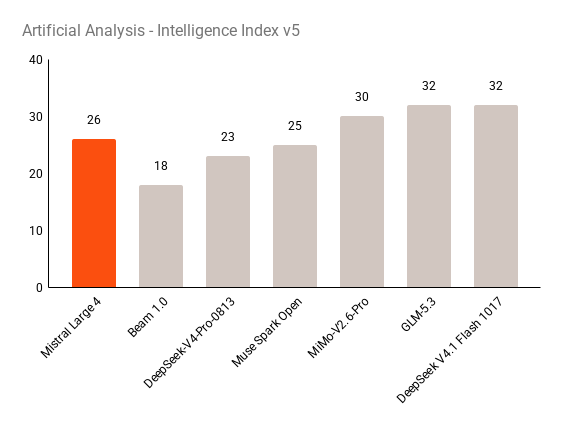
Bu yazıdaki tüm kıyaslama sayıları satıcı tarafından bildirilmiştir. Mistral ayrıca Cognition'ın özel FrontierCode 2.0 kıyaslamasında %19.7, grafiğindeki en yüksek açık ağırlık puanı ve Artificial Analysis Coding Agent Index'te %48 iddia ediyor, kabaca GLM-5.3 ile başa baş. 2 Kasım'da kontrol ettiğimizde bağımsız çoğaltma hâlâ beklemedeydi.
Mistral Large 4'ü çalıştırmanın üç yolu
Üç rotanız var ve doğru olanı ne kadar donanımı kontrol ettiğinize bağlıdır.
- Mistral API'sini çağırın. Model kimliği
mistral-large-4, milyon token başına $0.70 giriş, $0.07 önbelleklenmiş giriş ve $2.10 çıktı. GPU yok. - Barındırılan bir sağlayıcı kullanın. Mistral, OpenRouter, NVIDIA tarafından barındırılan uç noktalar ve bir NIM konteyneri ile Azure'da özel dağıtımlar da sunan Microsoft Foundry'yi listeliyor.
- Ağırlıkları kendiniz barındırın. Hugging Face'ten indirin ve kendi makinelerinizde vLLM, SGLang, Transformers veya llama.cpp ile sunun.
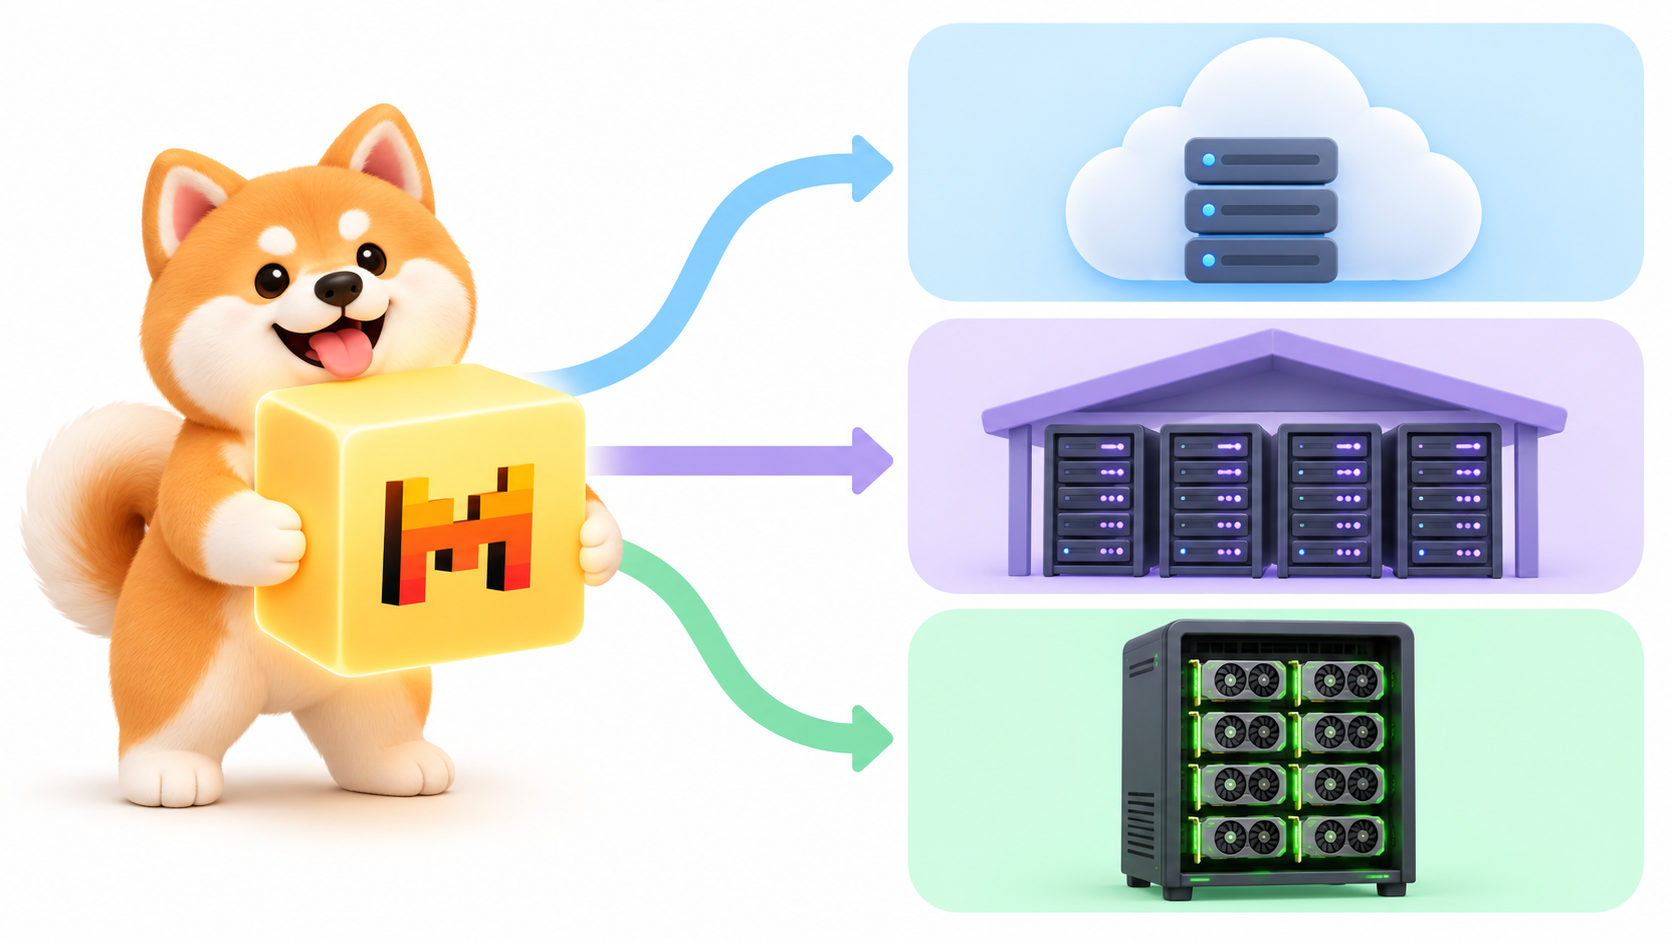
1. veya 2. rota ile başlayın. 3. rotaya somut bir nedenle geçin: ağınızdan çıkamayan veriler, sahip olmanız gereken bir ince ayar veya 8-GPU'luk bir düğümü meşgul eden hacim.
Mistral Large 4 nasıl indirilir
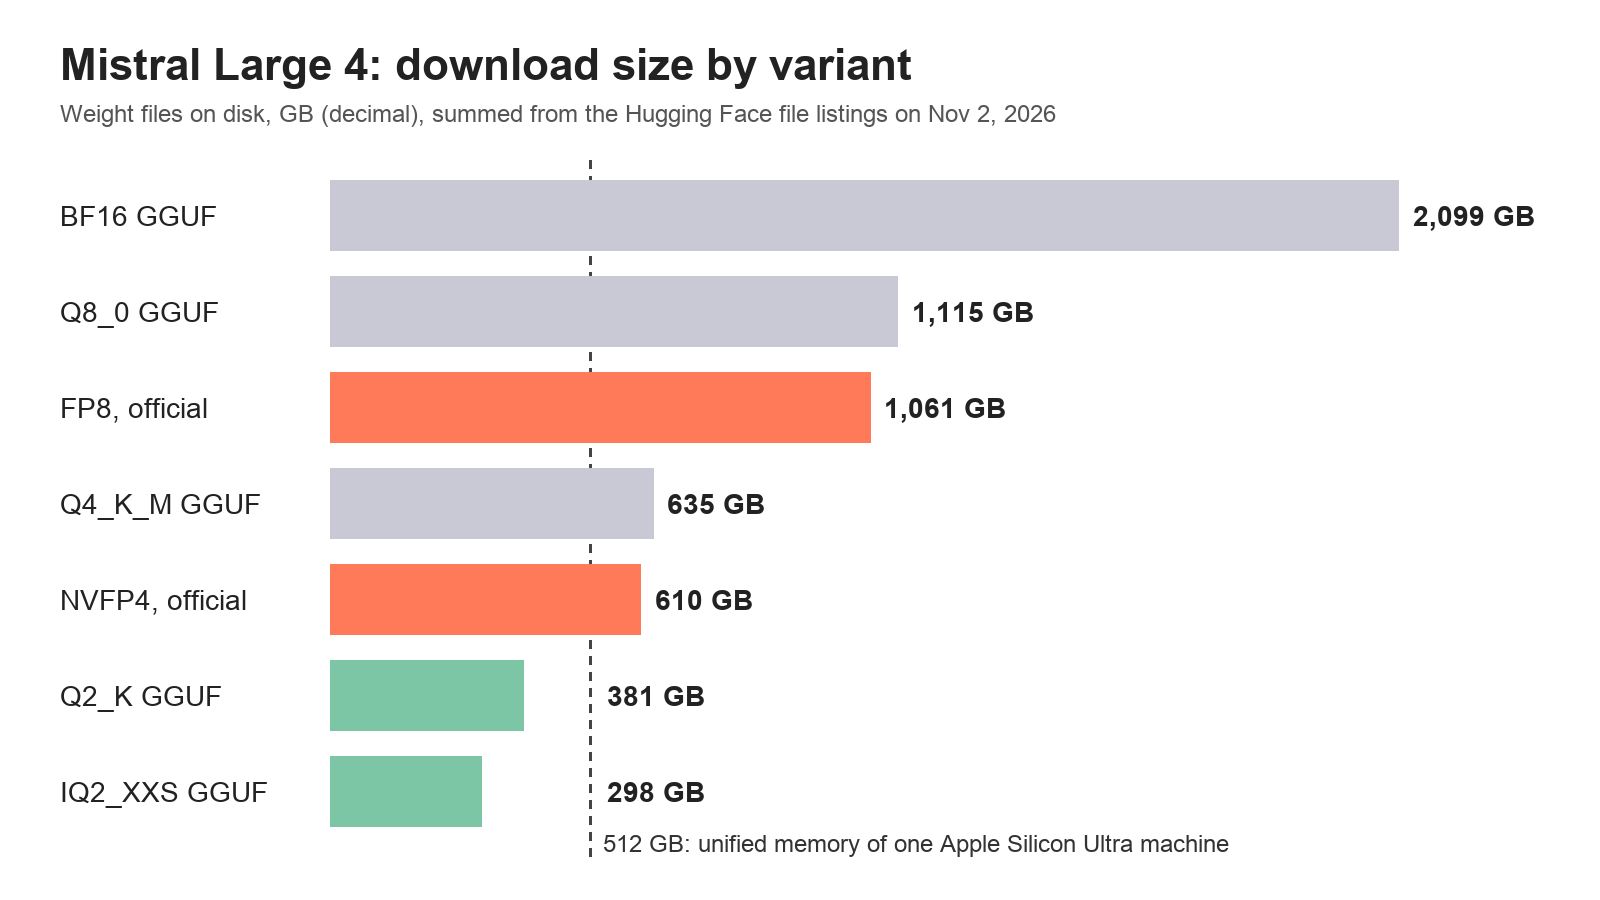
Resmi depolar kapılı değildir (Hugging Face API her ikisi için gated: false bildirir), bu nedenle herhangi bir hesap veya anonim istemci bunları çekebilir. Gerçek kapı boyuttur.
| Depo | Biçim | Diskteki boyut |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8, resmi | yaklaşık 1.061 GB |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4, resmi | yaklaşık 610 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | yaklaşık 1.115 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | yaklaşık 635 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | yaklaşık 381 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | yaklaşık 298 GB |
Bunları 2 Kasım 2026'da her deponun dosya listesinden topladık. Unsloth ayrıca unsloth/Mistral-Large-4-1T-A52B-GGUF altında GGUF nicelemeleri yayınlıyor.
Hugging Face CLI ile yalnızca ihtiyacınız olan dosyaları indirin:
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
FP8 indirmesi sürdürülebilir 1 Gbps hızında iki saatten biraz fazla sürer.
Mistral Large 4 nasıl kendiniz barındırılır
Her resmi sunum örneği, 8 GPU'lu bir düğüm ve 8 tensor paralelliği varsayar. İşte her motorun beklediği şey.
| Motor | Kontrol noktası | Resmi örneklerdeki donanım |
|---|---|---|
| vLLM | FP8 | 8 GPU, --tensor-parallel-size 8; Hugging Face Inference Endpoints 8x H200 kullanır |
| vLLM | NVFP4 | 8 NVIDIA Blackwell GPU |
| SGLang | FP8 | 8 GPU, --tp-size 8 |
| Transformers | FP8 | 8 GPU, torchrun ile |
| llama.cpp | Q2_K GGUF | 512 GB birleşik belleğe sahip bir Apple Silicon Ultra makinesi |
vLLM
Model kartı vLLM'i önerir ve özel bir Docker imajı sunar:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
Her iki ayrıştırıcı bayrağını da koruyun, aksi halde düşünme metni content içine düşer ve araç çağrıları ham metin olarak gelir. Daha hızlı kod çözme için kart, isteğe bağlı bir DSpark spekülatif kod çözücüyü belgeler: --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}' ekleyin.
8x H200'de bu taslaklayıcı ile Hugging Face, tek bir istek için saniyede yaklaşık 65 token ve yük altında 1.000 ShareGPT konuşması boyunca toplamda saniyede yaklaşık 480 token ölçtü.
SGLang da çalışır: model kartının sglang serve örneği --tp-size 8, --speculative-algorithm DSPARK ve auto akıl yürütme ve araç çağrısı ayrıştırıcılarını kullanır.
Mac'te llama.cpp
llama.cpp ekibi day-0 desteği yayınladı. Q2_K nicelemesi (381 GB), 512 GB birleşik belleğe sahip bir Apple Silicon Ultra makinesine sığar:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
Hugging Face, bir M3 Ultra'da saniyede yaklaşık 90 token ön doldurma ve 15 token üretim bildiriyor: özel deneyler için uygun, bir ajan döngüsü için yavaş. 2-bit niceleme de kaliteyi düşürür, bu nedenle önce kendi görevlerinizde test edin.
Mistral'in önerdiği örnekleme, her akıl yürütme düzeyinde temperature=1.0 ve top_p=0.95'tir.
Kendi barındırdığınız modeli çağırma
vLLM ve SGLang, OpenAI uyumlu bir sunucu sunar, bu nedenle istek herhangi bir sohbet tamamlama ile aynı görünür:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
Barındırılan API'de, aynı gövdeyi https://api.mistral.ai/v1/chat/completions adresine "model": "mistral-large-4" ve bir Bearer anahtarı ile gönderin. vLLM OpenAI uyumlu sunucu belgeleri kabul ettiği alanları listeler.
Claude Code'un her iki uç noktayı da Apidog CLI ile test etmesine izin verin
Kendi barındırılan bir model sessizce başarısız olur: eksik bir ayrıştırıcı bayrağı akıl yürütmeyi content içine sızdırır veya bir araç çağrısı düz metin olarak geri döner. Kodlama ajanınızın her iki rotayı da Apidog CLI ile kontrol etmesine izin verin, curl komutlarını elle yapıştırmak yerine.
Bir kez kurun:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
Sonra Claude Code'a bir istem verin:
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
Ajan her şemayı okur, yükünü doğrular ve senaryoyu çalıştırır:
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
Çalıştırmayı Apidog uygulamasında görüntülemek için --upload-report ekleyin veya aynı apidog run ... -r junit satırını CI'ya koyun, böylece bir vLLM yükseltmesi bozuk araç çağrılarıyla gönderilemez. Claude Code'da Apidog CLI kılavuzumuz kurulumu daha ayrıntılı ele alır. Apidog'un Ücretsiz planı 4 kullanıcıya kadar kapsar.
Lisans: neler yapabilir ve yapamazsınız
Mistral Ekosistemi Açık Ağırlık Lisansı, bir ek koşulla birlikte MIT'dir.
Yapabilirsiniz: telif hakkı ve izin bildirimini kopyalarda tuttuğunuz sürece, ticari ve ticari olmayan kullanım için modeli ve türevlerini çalıştırabilir, dağıtabilir, ince ayar yapabilir ve değiştirebilirsiniz.
Mistral'den ayrı bir ticari lisans almanız gerekir, eğer: onu bir "Hizmet Olarak Model" olarak çalıştırırsanız; lisans bunu, bir üçüncü tarafa çıkarım veya eğitim sonrası için model veya türevlerine erişim sağlamak olarak tanımlar.
Bu koşul şunlar için geçerli değildir: dahili kullanım, modelin belirli özellikler veya koşum takımları içinde yer aldığı son kullanıcı ürünleri, istekleri başka birinin barındırdığı bir modele iletmek ve Mistral'in kendi ürünleri aracılığıyla kullanım.
Dahili bir kodlama asistanı veya model üzerine inşa edilmiş bir ürün özelliği sorun değil; ham çıkarımı yeniden satmak bir anlaşma gerektirir. Bu bir özettir, hukuki tavsiye değildir.
Başka bir açık ağırlık modeli için benzer bir kılavuz için GLM-5.3 kendi kendine barındırma kılavuzumuza bakın.
Kendiniz mi barındırmalısınız yoksa API'yi mi çağırmalısınız?
Hacminiz mütevazı olduğunda, sunucu limitlerini ayarlamadan 1M bağlamı istediğinizde veya zaten 8-GPU düğümleri çalıştırmadığınızda API'yi çağırın. Milyon token başına $0.70 giriş ve $2.10 çıktı ile, ayda 100 milyon giriş token'ı artı 20 milyon çıktı token'ı, herhangi bir önbellekleme indirimi öncesinde $112'ye gelir.
Verileriniz ağınızdan çıkamadığında, bir ince ayara sahip olmak istediğinizde (Hugging Face, 8x B300 düğümünde TRL ile LoRA eğitimini gösterir) veya istikrarlı hacim bir düğümü meşgul ettiğinde kendiniz barındırın. Mistral'in Forge hizmeti, kendi verileriniz üzerinde ayar yapmak için yönetilen seçenektir.
SSS
Mistral Large 4 açık ağırlıkları indirmek ücretsiz mi?
Evet. Hugging Face'teki her iki resmi depo da kapısızdır, bu nedenle erişim istemeden indirebilirsiniz. Maliyet onları çalıştırmaktır: resmi FP8 kontrol noktası yaklaşık 1.061 GB'dır ve sunum örnekleri 8 veri merkezi GPU'su kullanır.
Mistral Large 4'ü tek bir GPU'da çalıştırabilir miyim?
Hiçbir resmi tarif tek bir GPU'yu kapsamaz. Her vLLM, SGLang ve Transformers örneği tensor paralelliği ile 8 GPU kullanır. Belgelenmiş en küçük kurulum, 512 GB birleşik belleğe sahip bir Apple Silicon Ultra makinesinde 381 GB Q2_K nicelemesi ile llama.cpp'dir.
Mistral Large 4 açık kaynak mı?
Açık ağırlıktır, OSI anlamında açık kaynak değildir. Ağırlıkları, ticari kullanıma izin veren değiştirilmiş bir MIT lisansı altında alırsınız, ancak modeli üçüncü taraflara çıkarım veya eğitim sonrası hizmeti olarak sunmak Mistral'den ayrı bir ticari lisans gerektirir.
Açık ağırlıklı model API modeliyle aynı mı?
Mistral, yayınlanan kontrol noktasının 6 Ekim önizlemesinden sonra üç hafta daha pekiştirmeli öğrenme aldığını ve API'nin güncellenmiş modeli mistral-large-4 olarak sunduğunu söylüyor. Akıl yürütme modları da değişti: low, medium veya high kullanın.
Mistral Large 4 API'si ne kadar?
Mistral, 2 Kasım 2026 itibarıyla milyon giriş token'ı başına $0.70, milyon önbelleklenmiş giriş token'ı başına $0.07 ve milyon çıktı token'ı başına $2.10 listeliyor.