
Moonshot’un Kimi K2.7 Code'u, çoğu geliştiricinin aslında para ödediği iki modele karşı yapılan kıyaslamalarla geldi: Claude Opus ve GPT-5.5. Kısa versiyonu, kapalı öncü modelin çoğu kodlama görevinde hala daha yüksek puan aldığı, ancak fiyatının düşündürdüğü kadar büyük bir farkla olmadığıdır. Kimi, indirebileceğiniz ve kendi sunucunuzda barındırabileceğiniz açık ağırlıklı bir modeldir ve sadece kiralayabileceğiniz modellerden birkaç puan farkla yer almaktadır.
Bu karşılaştırma, rakamları yan yana getirir, maliyet ve açıklıkla karşılaştırır ve hangi iş için hangisini seçeceğinizi söyler.
button
ÖZET
- Ham kodlama kalitesi: GPT-5.5 ve Claude Opus çoğu test paketinde liderdir. Kimi K2.7 Code birkaç puan geride kalır.
- Maliyet: Kimi çok daha ucuzdur (milyon token başına 0,95$/4,00$) ve kendi sunucunuzda ücretsiz olarak barındırılabilir. Kapalı modellerin maliyeti daha yüksektir ve kendi donanımınızda barındırılamazlar.
- Açıklık: Kimi, değiştirilmiş bir MIT lisansı altında açık ağırlıklarla gelir. Opus ve GPT-5.5 kapalıdır.
- Karar: En yüksek tek seferlik kalite için öncü modeli seçin; maliyet, hacim veya veri kontrolü son birkaç puandan daha önemli olduğunda Kimi'yi seçin.
Adaylara bir Bakışta
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| Tip | Açık ağırlık (değiştirilmiş MIT) | Kapalı | Kapalı |
| Mimari | MoE, Toplam 1T / Aktif 32B | Açıklanmadı | Açıklanmadı |
| Bağlam penceresi | 256K token | Büyük | Büyük |
| Kendi kendine barındırma | Evet | Hayır | Hayır |
| Fiyatlandırma (M token başına) | Giriş 0,95$ / Çıkış 4,00$ | Daha yüksek, sadece kiralık | Daha yüksek, sadece kiralık |
Yapısal fark manşet niteliğindedir. Kimi size tam olarak ne olduğunu söyler ve kendinizin çalıştırmasına olanak tanır. Diğer ikisi ise çağırdığınız hizmetlerdir.
Kodlama kıyaslamaları
Bunlar Moonshot'ın bildirdiği puanlardır. Birkaç test paketi Moonshot'ın kendi olduğu için bunları satıcının bakış açısı olarak değerlendirin, ancak model tutarlıdır ve okunmaya değerdir.
| Kıyaslama | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5 ilk ikisinde liderliği alırken; Claude Opus MLS Bench Lite'ta lider ve diğer her yerde yakın kalıyor. Kimi her birinde bir basamak altta yer alıyor. Fark gerçek, ancak Kimi Code Bench v2'de küçük, Program Bench'te ise daha geniş. İşiniz o ikinci kıyaslamaya benziyorsa, öncü model kendini amorti eder.
Agentik ve araç kullanım kıyaslamaları
Kodlama ajanları sadece kod üretmekle kalmaz, araç çağrılarıyla yaşar veya ölür. Burada tablo daha da netleşiyor.
| Kıyaslama | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
MCP Mark Verified'da Kimi aslında Claude Opus'u geride bırakıyor, ancak GPT-5.5 oldukça önde. MCP Atlas'ta üçü yaklaşık beş puan içinde yer alıyor. Agentik iş yükleri için Kimi, ham kodlama puanlarının gösterdiğinden daha çok yarışa yakın, ki bu önemli çünkü token maliyetleri tam da burada birikiyor.
Kimi'nin kazandığı nokta maliyettir
Kıyaslamalar kaliteyi ölçer. Faturayı ölçmezler. Kimi K2.7 Code, milyon giriş tokenı başına 0,95$ ve milyon çıkış tokenı başına 4,00$ maliyetle çalışır, önbellek isabetleri ise milyon başına 0,19$'dır. Kapalı öncü modeller token başına önemli ölçüde daha pahalıdır ve bunları barındırarak bu durumdan kaçamazsınız; indirme seçeneği yoktur.
Tasarrufu artıran iki faktör:
- Açık ağırlıklar sıfır token seçeneği anlamına gelir. Kendi donanımınızda kendi kendine barındırma yapın ve token başına maliyet tamamen ortadan kalkar. Bunun yerine GPU süresi harcarsınız.
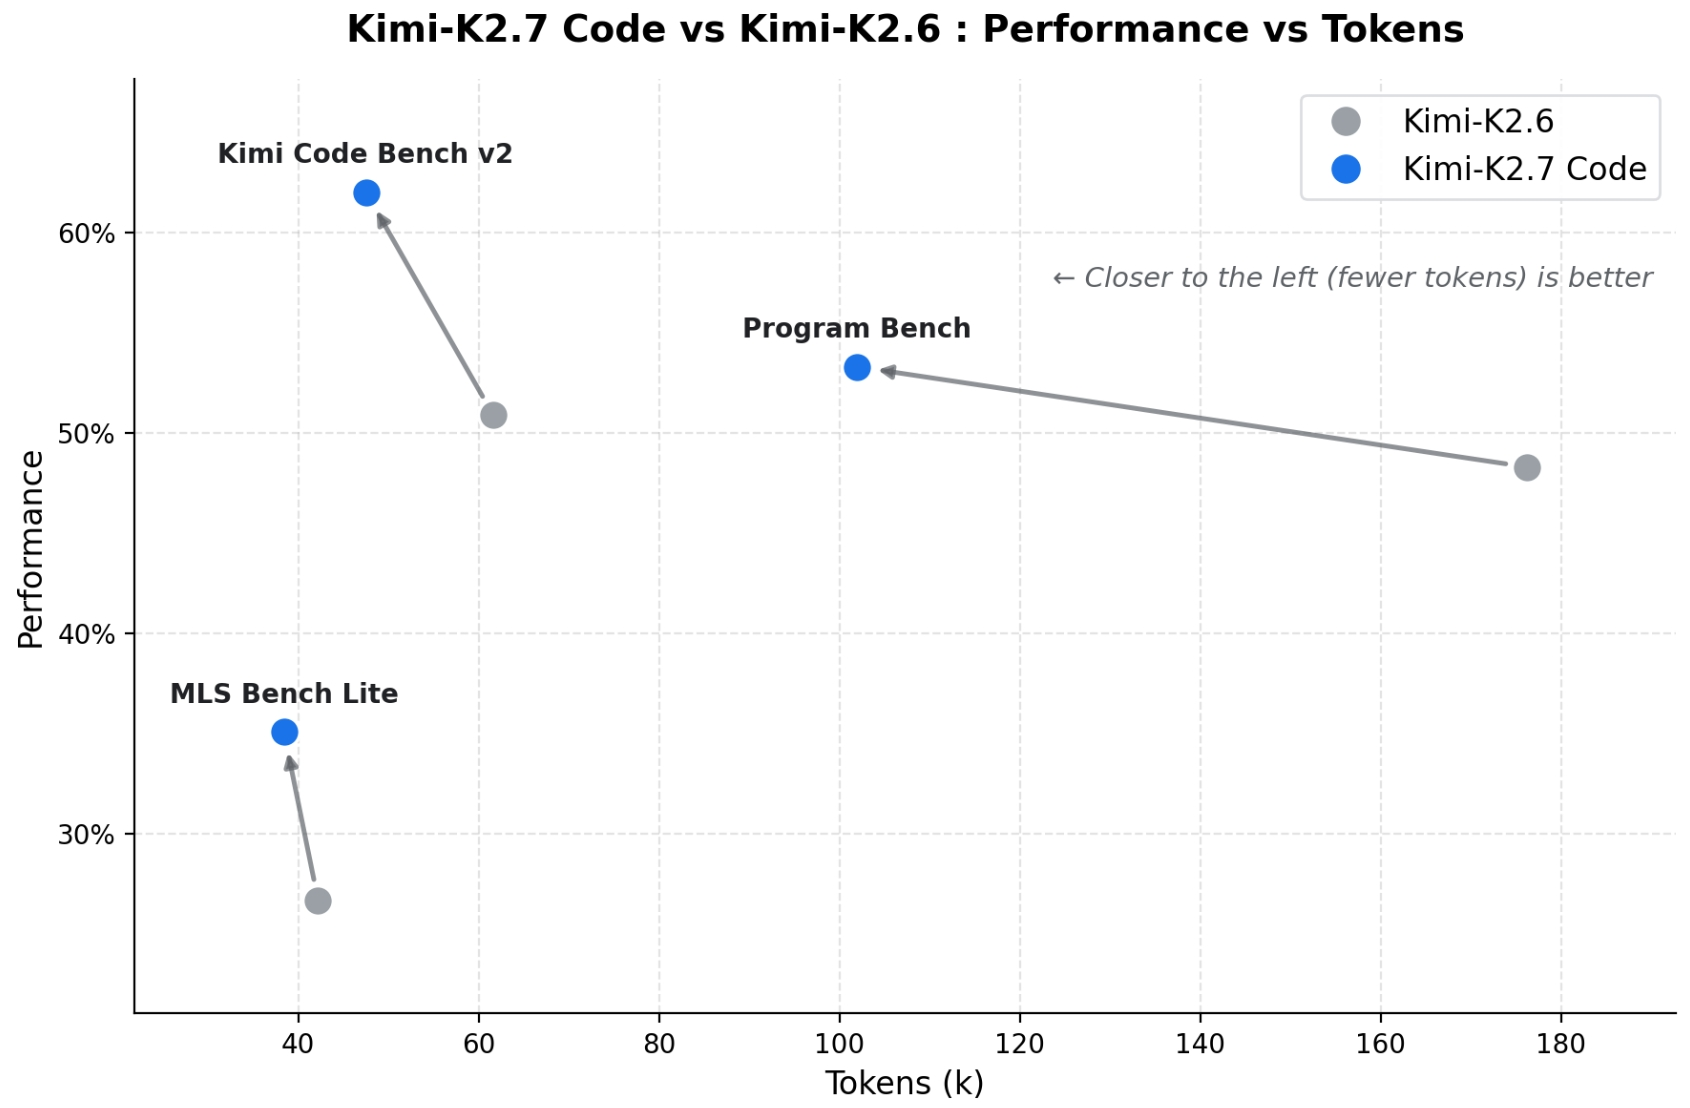
- Daha az karmaşık akıl yürütme. K2.7 Code, aynı iş için K2.6'dan yaklaşık %30 daha az düşünme tokenı kullanır, bu nedenle her ajan adımı daha az faturalandırılır. Ajan token maliyetlerini düşürme rehberimiz, bunun neden biriktiğini daha derinlemesine açıklar.
Görev başına yüzlerce araç çağrısı yapan bir ajan için, fiyatının çok küçük bir kısmına %90 oranında iyi olan bir model, toplam değer açısından sıklıkla kazanır.
Bağlam ve açıklık
Üçü de uzun bağlamı iyi idare eder; Kimi'nin penceresi 256K token olup, tek bir istemde tam bir hizmet ve testleri için yeterlidir. Daha büyük farklılaştırıcı ise lisanstır. Kimi'nin değiştirilmiş MIT ağırlıkları, modeli ince ayarlamanıza, denetlemenize ve air-gapped olarak çalıştırmanıza olanak tanır. Uyumluluk veya veri yerleşimi kuralları olan ekipler için bu, "olmasa da olur" bir özellik değil; belirleyici faktördür ve kapalı modeller kesinlikle seçenek dışıdır.
Her birini ne zaman seçmeli
GPT-5.5 veya Claude Opus'u şu durumlarda seçin:
- En yüksek tek seferlik kodlama kalitesine ihtiyacınız varsa ve birkaç kıyaslama puanı maliyeti haklı çıkarıyorsa.
- Yönetilen bir SLA'ya sahip kapalı bir hizmeti kiralamaktan memnunsanız.
- En zorlu görevleriniz, farkın en geniş olduğu Program Bench gibi görünüyorsa.
Kimi K2.7 Code'u şu durumlarda seçin:
- Token maliyetinin uygunluğu belirlediği yüksek hacimli ajan iş yükleri çalıştırıyorsanız.
- Verilerin kendi altyapınızda kalması gerekiyorsa.
- Modeli ince ayarlamak veya denetlemek istiyorsanız.
- Liderlik tablosunun zirvesini değil, toplam değeri optimize ediyorsanız.
Daha geniş bir alan için, MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 karşılaştırmamız diğer açık ağırlıklı rakipleri kapsar ve kodlama için DeepSeek V4 vs Claude Opus başka bir açık-kapalı eşleşmeyi inceler. Modellerden ziyade ajanları karşılaştırıyorsanız, Claude Code vs OpenAI Codex'e bakın.
Karşılaştırmayı kendiniz deneyin
Kıyaslamalar bir başlangıç noktasıdır, kod tabanınız için bir karar değildir. Dürüst test, üçünü de kendi görevlerinizde çalıştırmak ve sonuçları okumaktır. Kimi Code CLI size ajanı ücretsiz olarak sunar ve ham çıktıları karşılaştırmak için her modelin API'sini doğrudan çağırabilirsiniz.
Bunu yaptığınızda, uç noktaları Apidog'da test edin: her modele aynı istemi gönderin, çağrıları yan yana kaydedin ve yanıt kalitesini, gecikmeyi ve token kullanımını tek bir yerde karşılaştırın. Karşılaştırmayı çalıştırmak için Apidog'u indirin.
Sıkça Sorulan Sorular
Kimi K2.7 Code, Claude Opus veya GPT-5.5'ten daha mı iyi? Moonshot'ın bildirdiği kodlama kıyaslamalarına göre hayır; kapalı modeller çoğu test paketinde daha yüksek puan alıyor. Kimi'nin avantajı, birkaç puan içinde kalırken açık ağırlıklar ve çok daha düşük maliyetidir.
Kimi ne kadar daha ucuz? Milyon giriş tokenı başına 0,95$ ve milyon çıkış tokenı başına 4,00$ maliyetle ve kendi sunucunuzda ücretsiz olarak barındırılabilir. Kapalı öncü modeller token başına daha pahalıdır ve kendi kendine barındırılamaz.
Kimi K2.7 Code'u kendim çalıştırabilir miyim? Evet. Ağırlıklar değiştirilmiş bir MIT lisansı altında açıktır; bunları vLLM, SGLang veya KTransformers ile sunun.
Kodlama ajanları için hangisi en iyisi? Ham kalite için GPT-5.5 liderdir. Maliyet açısından verimli yüksek hacimli ajanlar için Kimi daha iyi bir değerdir ve agentik kıyaslamalarda yakındır.
Bu kıyaslamalar tarafsız mı? Birkaç test paketi Moonshot'ın kendi olduğu için bunları satıcının bakış açısı olarak okuyun. Öncü modele olan tutarlı fark, kesin rakamlar değil, faydalı bir sinyaldir.
Özet
Kimi K2.7 Code, çoğu kodlama kıyaslamasında Claude Opus veya GPT-5.5'i geçmez ve Moonshot da böyle olduğunu iddia etmez. Çok daha düşük maliyetle ve kendi başınıza çalıştırabileceğiniz açık ağırlıklarla gelirken birkaç puan daha düşük puan alır. Mümkün olan en yüksek kalite için kapalı öncü model hala kazanır. Yüksek hacimli ajanlar, özel dağıtımlar veya tablonun zirvesi yerine toplam değeri tartmak isteyen herkes için Kimi daha akıllı bir seçimdir. Üçünü de kendi kodunuz üzerinde çalıştırın, çıktıları Apidog'da karşılaştırın ve iş yükünüzün karar vermesine izin verin.
button