DeepSeek, DeepSeek-V4.1-Flash ağırlıklarını 10 Eylül 2026'da, modelin API üzerinde Genel Kullanıma sunulduğu aynı gün, MIT lisansı altında Hugging Face'e koydu. Bu sıra dışı bir zamanlama. Çoğu laboratuvar önce barındırılan uç noktayı sunar ve ağırlıkları haftalar sonra, eğer yayınlarsa, yayımlar.
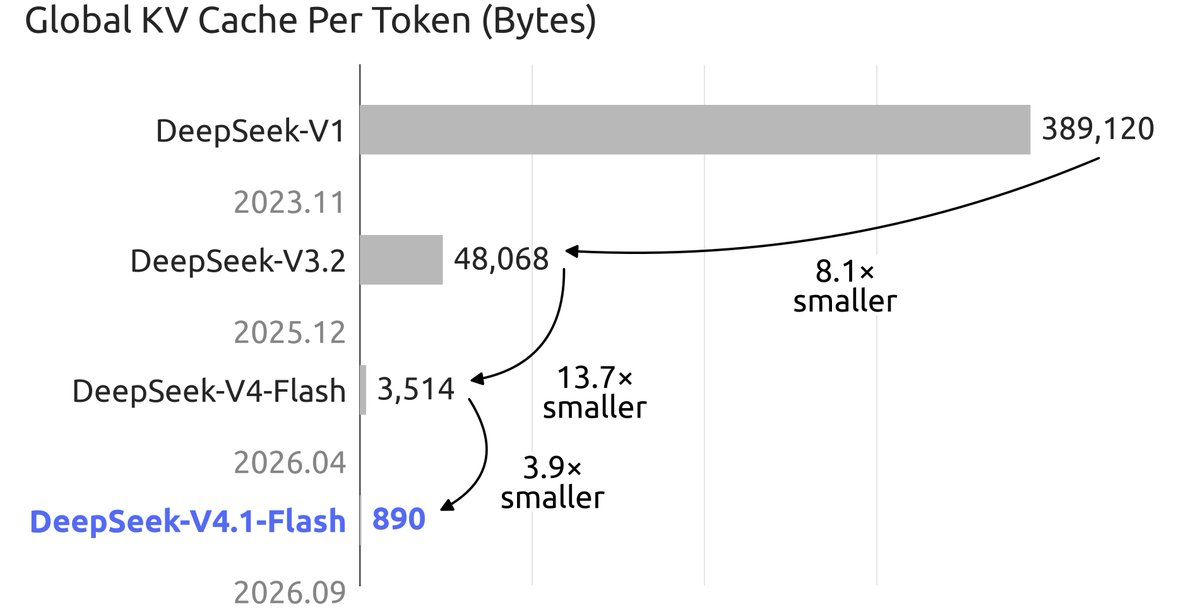
Manşet rakamı çoğu okuyucuyu korkutacaktır: omurgada 552 milyar parametre, görüş kodlayıcıyla birlikte 763 milyar. Ancak alttaki tasarım, boyutunun önerdiğinden daha fazla kendi kendine barındırmaya elverişlidir. Ön doldurma sırasında yalnızca 8 milyar, kod çözme sırasında ise 16 milyar parametre aktiftir ve yeni FP4 KV önbelleği jeton başına 890 bayt maliyetle, V4-Flash'in ihtiyaç duyduğunun yaklaşık dörtte biri kadardır. Hesaplama ucuz. Bellek ise engel.
Yine de insanlar deneyecek. Bu kılavuz size bellek matematiğini, her donanım katmanındaki gerçekçi yolları, genel kurulum komutlarını ve yerel bir OpenAI uyumlu uç noktayı Apidog'daki barındırılan API'ye karşı test etme yöntemini sunar. Önce modelin genel bakışını isterseniz, DeepSeek-V4.1-Flash Nedir? başlıklı yazıyı okuyun ve geri gelin.
TL;DR
- Ağırlıklar: 552B MoE omurgası, MIT lisansı. Yalnızca omurga için 8-bit'te yaklaşık 552 GB, 4-bit'te yaklaşık 280 GB.
- KV önbelleği: Jeton başına 890 bayt. Tam 1M jetonluk bir bağlam yaklaşık 0.9 GB gerektirir. Bu kısım çözüldü.
- Gerçekçi 4-bit sunumu, 80 GB sınıfında 4 ila 8 GPU gerektirir. Bunun altındaki her şey CPU veya SSD boşaltmasıdır ve yavaştır.
- Barındırılan API, zirve dışı zamanlarda 1M önbellek-kaçırma giriş jetonu başına 0.15 dolar ücret alır. Çoğu ekip için bu, sadece elektrik faturasını bile geride bırakır.
Ne indiriyorsunuz
Model kartı, yeni bir Nedensel Kodlayıcı-Kod Çözücü düzenine sahip 552B parametreli Uzman Karışımı (Mixture-of-Experts) omurgasını tanımlar: 40 katman, 20 kodlayıcı ve 20 kod çözücü olarak ayrılmıştır. Her katman 384 uzman artı 1 paylaşılan uzman arasında yönlendirme yapar. DeepSeek-ViT görüş kodlayıcı, tam kontrol noktasını 763B parametreye çıkarır ve sadece metne ihtiyacınız olsa bile hepsini indirirsiniz.
Yerel çıkarım için üç önemli detay var:
- Aktif parametreler küçük. Ön doldurma sırasında 8B, kod çözme sırasında 16B aktif. Jeton başına FLOP'lar orta boyutlu yoğun bir modele benziyor. Sorun şu ki, 552B parametrenin her birinin ileri geçişin ulaşabileceği bir yerde bulunması gerekiyor.
- KV önbelleği FP4. Yayın notu, önbelleğin önceki neslin HBM'sinin 1/4'ünü ve SSD depolama alanının 1/8'ini kullandığını belirtiyor. Jeton başına 890 bayt ile uzun bağlam artık eskisi gibi bir bellek sorunu değil.
- Dikkat tasarımı gereği seyrek. Üç statik modlu Sıkıştırılmış Seyrek Dikkat 2 (Compressed Sparse Attention 2), 64K bağlamda eğitildi ve 45T jetonluk çalıştırmanın sonlarında 1M'ye kadar genişletildi. Bu nedenle 1M'de KV sayıları küçük kalıyor.
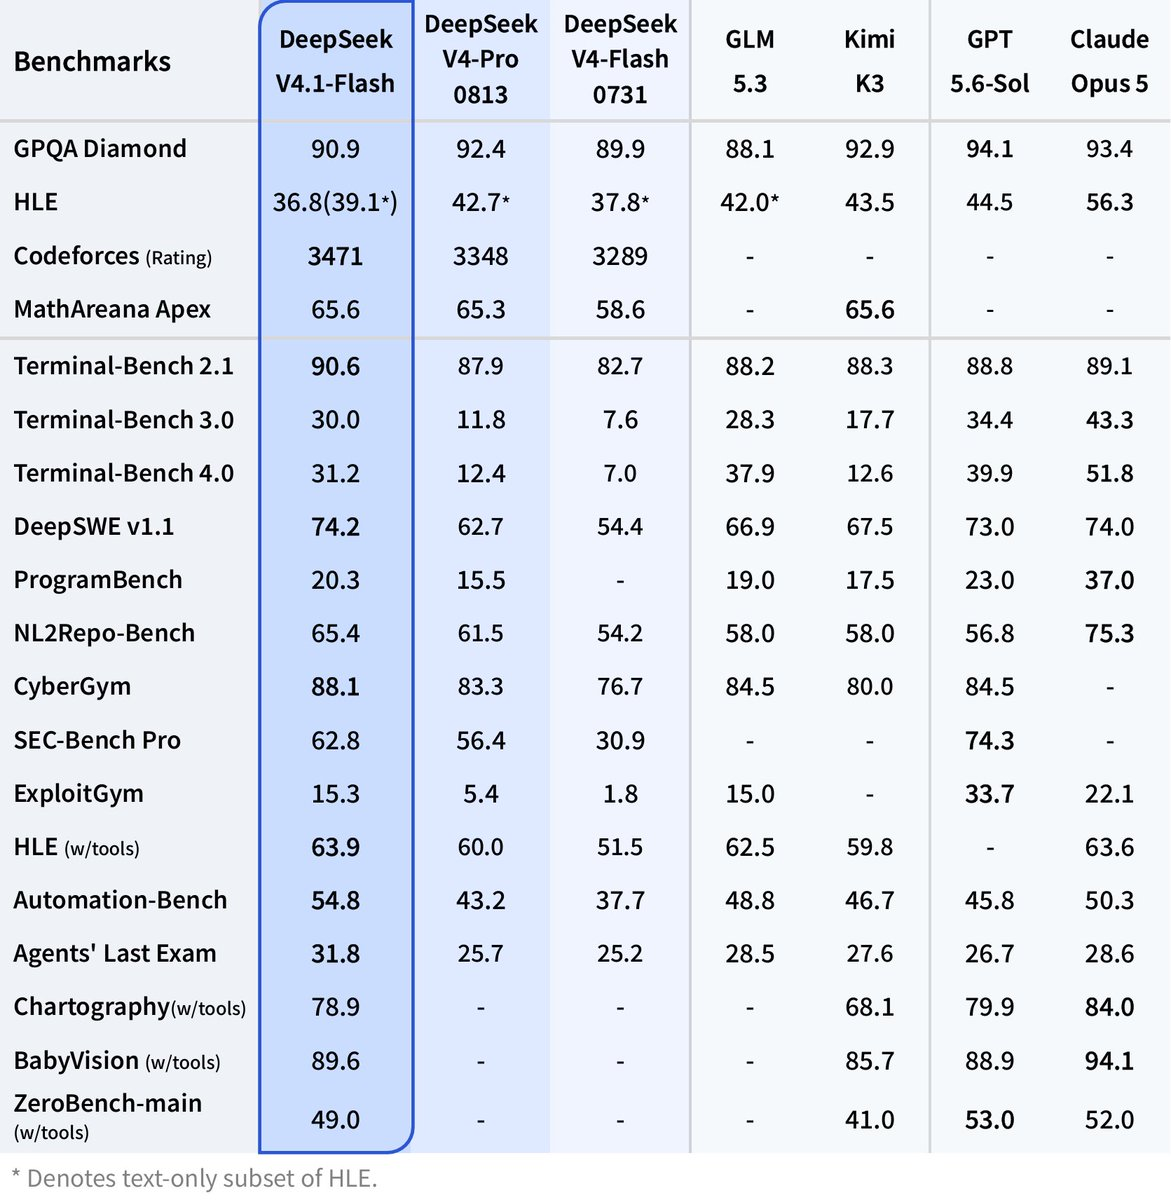
Teknik rapor mimariyi tüm detaylarıyla ele alıyor. Kart üzerindeki her karşılaştırma rakamı DeepSeek tarafından rapor edilmiştir; bunları iddia olarak kabul edin.
Bellek matematiği
Aşağıdaki sayılar doğrudan çarpımdır, ölçüm değildir ve motor ek yükünü, aktivasyonları ve görüş kodlayıcıyı içermezler.
| Bileşen | Boyut | Nasıl hesaplanır |
|---|---|---|
| Omurga ağırlıkları, 8-bit | ~552 GB | 552B parametre x 1 bayt |
| Omurga ağırlıkları, 4-bit | ~280 GB | 552B parametre x 0.5 bayt |
| KV önbelleği, jeton başına | 890 bayt | Model kartından |
| 128K bağlamda KV önbelleği | ~0.11 GB | 890 x 128.000 |
| 1M bağlamda KV önbelleği | ~0.89 GB | 890 x 1.000.000 |
İki şey dikkat çekiyor. Birincisi, KV önbelleği yuvarlama hatasıdır. 1M jetonluk bir oturum bir gigabaytın altında sığar, bu da ağırlık bütçesine dokunmadan onlarca uzun oturumu yerleşik tutabileceğiniz anlamına gelir. İkinci olarak, ağırlıklar tüm sorundur. Hiçbir niceleme hilesi 552B parametrenin tek bir tüketici GPU'suna sığmasını sağlamaz ve 8B aktif tasarım yardımcı olmaz, çünkü MoE yönlendirme hala her uzmanın yüklenmesini ve adreslenebilir olmasını gerektirir.
Boşaltılmış kurulumların dengesiz hissettirmesinin nedeni de budur. Ön doldurma, tüm istem boyunca gruplar halinde işlenir ve hesaplama kısıtlı kalır. Kod çözme, her jeton için RAM veya SSD'den 16B aktif parametreyi çağırır. Jeton/saniye hızınızı FLOP'lar değil, bant genişliği belirler.
Gerçekçi donanım katmanları
Burada verim sayıları yok. DeepSeek dışındaki hiç kimse, güvenilir karşılaştırmalar yayınlayacak kadar ağırlıklara uzun süre sahip olmadı.
Katman 1: çoklu GPU sunucusu, 80 GB sınıfında 4 ila 8 kart. Dört adet 80 GB kart size 320 GB sağlar; bu, KV önbelleği ve motor ek yükü için küçük bir marjla 4-bit ağırlıklar için yeterlidir. Sekiz kart size 640 GB sağlar; bu da 8-bit kontrol noktası veya büyük gruplarla rahat bir 4-bit dağıtım için yeterlidir. Burası, "yerelde çalıştırmak"ın tensör paralelliği ile üretim düzeyinde hizmet anlamına geldiği tek katmandır ve bu beş veya altı haneli bir satın alma veya saatlik çok dolarlı bir bulut kiralamasıdır.
Katman 2: CPU boşaltmalı tek yüksek bellekli iş istasyonu. 512 GB veya daha fazla sistem RAM'ine ve bir veya iki GPU'ya sahip bir kutu, 4-bit ağırlıkları RAM'de tutabilir ve talep üzerine uzman katmanlarını GPU'ya aktarabilir. Çalışır, ancak yavaştır, çünkü kod çözme bant genişliği HBM yerine DDR5 veriyolunuzdur. Bunu etkileşimli sohbet için değil, toplu işler ve gece boyu değerlendirmeler için kullanın.
Katman 3: SSD akışı ile Apple Silicon. Hobi yolu. 512 GB'lık bir Mac Studio, 4-bit ağırlıkları birleşik bellekte tutar, bu da eğer zaten bir tane sahibiyseniz gerçek bir seçenektir. Bunun altında, Kimi K3 HN konu başlığı bölgesindesiniz: harici SSD'lere bölünmüş ağırlıklar, ağır işi mmap yapıyor, yaklaşık saniyede 1 jeton. Modelin çalıştığını kanıtlar, o makinede kullanışlı olduğunu değil. Kimi K3'ü yerelde çalıştırma kılavuzumuz daha büyük bir modelde aynı ödünleşimleri kapsar ve DeepSeek V4'ü yerelde çalıştırma önceki nesli kapsar.
Kurulum yolu
Donanım hazır olduğunda akış şöyledir: indir, OpenAI uyumlu bir uç noktanın arkasında sun, test et.
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
1 Gbps'lik bir hat üzerinde, her 100 GB tam hızda yaklaşık 15 dakika sürer. Bir saat veya daha fazla bütçe ayırın.
Sunum, uyarı noktasının olduğu yerdir. vLLM, SGLang, llama.cpp ve Ollama'da CED mimarisi ve CSA2 dikkat mekanizması için Sıfırıncı Gün desteği [DOĞRULANMALI]; yeni bir katman türü genellikle ağırlıklar yüklenmeden önce bir motor yaması gerektirir ve yayın notunda belirli motorlar belirtilmez. İndirmeye başlamadan önce her projenin değişiklik günlüğünde "DeepSeek-V4.1" araması yapın. Destek mevcut olduğunda, 8 GPU üzerinde vLLM ile sunum şöyle görünür:
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
Bir GGUF dönüştürmesi mevcut olduğunda, bir llama.cpp llama-server veya bir Ollama modeli aynı http://localhost:8000/v1 tarzı uç noktayı sunar, bu nedenle herhangi bir OpenAI SDK istemcisi tek bir satır değiştirerek çalışır:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
temperature=1.0 ve top_p=0.95 değerleri, model kartının önerilen ayarlarıyla eşleşir. Ollama için Ollama kılavuzumuz Modelfile akışını, vLLM kılavuzumuz ise çoklu GPU bayraklarını derinlemesine kapsar.
Pragmatik alternatif: barındırılan API
Zirve dışı saatlerde, fiyatlandırma sayfası deepseek-flash için 1M önbellek-kaçırma giriş jetonu başına 0.15 dolar, 1M önbellek-isabeti giriş jetonu başına 0.003 dolar ve 1M çıkış jetonu başına 0.60 dolar fiyat listeler. Zirve saatleri bu fiyatları ikiye katlar. Yani ayda 1 milyar giriş jetonu artı 200 milyon çıkış jetonu, önbellek isabetleri giriş tarafını daha da düşürmeden önce, zirve dışı yaklaşık 270 dolar ve zirve saatlerinde 540 dolar maliyetlidir. 80 GB sınıfında 8 GPU'lu bir sunucu, donanımı amorti etmeden veya birine bakıcılık ücreti ödemeden önce, sürekli yük altında sadece elektrik ve soğutma için aylık bu fiyattan daha fazlasına mal olur. Bir veri yerleşimi kuralınız veya zaten boşta duran donanımınız yoksa, API maliyet açısından kazanır. Geçiş tek bir base_url değişikliğidir; DeepSeek-V4.1-Flash API kılavuzumuz bunu adım adım açıklar.
Kısıtlamanın para olmadığı durumlarda yerel kurulum kazanır: hava boşluklu ortamlar, hiçbir yere gönderemeyeceğiniz istem verileri veya ağırlıkları değiştirmeyi gerektiren araştırmalar.
Yerel bir uç noktayı Apidog'da barındırılan API'ye karşı test edin
Hangi yolu seçerseniz seçin, trafiği yerel sunucuya yönlendirmeden önce referans gibi davrandığını kanıtlayın. Niceleme kayması, yanlış bir sohbet şablonu veya eksik bir durdurma jetonu, hepsi çıktıdaki ince farklılıklar olarak ortaya çıkar. İşte Apidog'daki iş akışı:
- İki ortam oluşturun. Biri
base_url'ihttp://localhost:8000/v1olarak ayarlanmışlocaladında, diğeribase_url'ihttps://api.deepseek.comve gerçek anahtarınızla ayarlanmışhostedadında. Her istek{{base_url}}/chat/completionsveBearer {{api_key}}kullanır. - Küçük bir istem kümesini istek olarak kaydedin. İş yükünüzü temsil eden beş ila on istem: bir JSON çıkarma, bir kod düzeltme, uzun bağlamlı bir özet. Hepsinde
model'ideepseek-flasholarak ayarlayın; her iki sunucuda da çalışır. - Onaylar ekleyin. JSON görevi için, yanıtın ayrıştırıldığını ve gerekli bir anahtarın bulunduğunu onaylayın. Her istek için, kötü bir bağlam ayarından kaynaklanan kesmeyi yakalayan
finish_reason'ınstop'a eşit olduğunu onaylayın. - Kümeyi her iki ortama karşı çalıştırın. Ortam açılır menüsünü
hosted'danlocal'e geçirin ve aynı test senaryosunu yeniden çalıştırın. Yalnızcalocal'de görünen bir hata, tek tıklamayla yalıtılmış niceleme veya şablon sorununuzdur. - Akışı izleyin.
stream: trueayarlayın ve olayların teker teker gelmesini görmek için SSE görünümünü kullanın. Tüm yanıtı göndermeden önce arabelleğe alan yerel bir sunucu, akışsız bir çağrıda iyi görünür ancak burada yanlış görünür. - CI'ya ekleyin. Her motor yükseltmesinde
apidog-cliile senaryoyu çalıştırın, böylece bozuk bir sohbet şablonu bir kullanıcı yerine bir pipeline'ı bozar.
Apidog'u indirin ve tüm akış tek bir projeden çalışır.
SSS
- DeepSeek-V4.1-Flash'i bir dizüstü bilgisayarda çalıştırabilir miyim? Faydalı bir şekilde değil. 4-bit omurga yaklaşık 280 GB'tır. Bir dizüstü bilgisayar, Kimi K3 deneyinin yaptığı gibi, saniyede yaklaşık 1 jeton hızında SSD'den akış yapabilir, bu bir demodan ibarettir, bir iş akışı değil. API'yi veya DeepSeek-V4.1-Flash'i ücretsiz nasıl kullanacağınız seçeneklerinden birini kullanın.
- 8 milyar aktif parametre, sadece 8 GB VRAM'e ihtiyacım olduğu anlamına mı geliyor? Hayır. Aktif parametreler, bellek değil, jeton başına hesaplamayı belirler. MoE yönlendirmesi, herhangi bir jeton için katman başına 384 uzmandan herhangi birini seçebilir, bu nedenle 552 milyar parametrenin tamamı yüklenmeli ve erişilebilir olmalıdır.
- 1M bağlam ne kadar bellek gerektirir? Jeton başına 890 bayt ile yaklaşık 0.89 GB KV önbelleği. Bu modelin ucuz kısmı burasıdır. Ağırlıklar ise pahalı kısmıdır.
- Lisans ticari kullanım için güvenli mi? Evet. Ağırlıklar, Hugging Face model kartına göre MIT lisanslıdır.
Bu durum sizi nerede bırakıyor
DeepSeek-V4.1-Flash, yasal ve teknik açıdan önemli olan yollarla açıktır: MIT ağırlıkları, halka açık bir teknik rapor ve 1M jetonluk oturumları bellek açısından neredeyse ücretsiz hale getiren bir KV önbelleği tasarımı. Masa altındaki makinenizde çalıştırmanıza izin veren şekilde açık değildir. Çoğu ekip için doğru hareket, zirve dışı 1M giriş jetonu başına 0.15 dolarlık barındırılan API'dir, yerel dağıtım ise binayı terk edemeyen veriler için ayrılmıştır.
Her iki durumda da, güvenmeden önce test edin. Apidog'u her iki uç noktaya da yöneltin, aynı kaydedilmiş istekleri çalıştırın ve onayların yerel yapınızın referansla eşleşip eşleşmediğini size söylemesine izin verin.