
GPT-Live-1.1 fiyatlandırması token bazlı değil, zaman bazlıdır. OpenAI ses oturumunu etkin dakika başına 0,05 $ ve bekleme dakikası başına 0,02 $ üzerinden faturalandırır; saniye bazında ücretlendirme yapılır ve dakikaya yukarı yuvarlama yapılmaz. Arka uç modeli ve araç çağrıları normal oranlarıyla ayrı olarak faturalanır. Kesintisiz bir saatlik konuşma ses ücreti olarak 3,00 $ tutarındadır; beklemede geçirilen bir saat ise 1,20 $ tutarındadır.
Fiyat listesi kısadır. Asıl önemli olan, bu fiyatlandırmanın gerçek bir uygulamada nasıl davrandığıdır; arayanlar duraklar, arka uçlar düşünür ve oturumlar gereğinden uzun süre açık kalır. Aşağıda üç örnek hesaplama ve faturayı öngörülebilir tutan ayarlar bulacaksınız.
GPT-Live-1.1 fiyatlandırmasına hızlı bakış
GPT-Live-1.1'in iki ses ücreti ve arka uç için ayrı bir faturası vardır. 20 Kasım 2026 itibarıyla GPT-Live-1.1 model sayfasının ve OpenAI fiyatlandırma sayfasının listeledikleri şöyle:
| Ücret | Oran | Saatlik | Notlar |
|---|---|---|---|
| Etkin oturum süresi | Dakika başına 0,05 $ | 3,00 $ | Konuşma, boşta kalma zaman aşımından önceki sessizlik, arka uç işlerinin beklenmesi |
| Bekleme oturum süresi | Dakika başına 0,02 $ | 1,20 $ | Yalnızca WebRTC, çıkarım duraklatılmışken |
| Arka uç Responses modeli | Normal token oranları | Değişken | Devretme için seçtiğiniz model |
| Barındırılan araçlar | Normal araç oranları | Değişken | Web araması, dosya arama, Code Interpreter ve diğerleri |
Başlıktaki oranlardan daha önemli üç ayrıntı:
- Saniye bazlı faturalandırma. 90 saniyelik bir çağrı 0,10 $ değil 0,075 $ tutarındadır; süre bir tam dakikaya yukarı yuvarlanmaz.
- GPT-Live-1 ile aynı fiyat. Her iki model de aynı oranları paylaşır, dolayısıyla yükseltme ses faturasını değiştirmez.
- 15 saniyelik başlangıç ücreti. Bir WebRTC oturumu oluştururken başlatma sırasında 15 saniye faturalanır; oturum çalışmaya başladığında bu ücret iade edilir. Yalnızca oluşturup terk ettiğiniz oturumlar için ek maliyet doğar.
Ses yığınları hakkında arka plan bilgisi için GPT-Live vs GPT-Realtime yazısına bakın.
Neler etkin, neler bekleme dakikası sayılır?
Etkin dakikalar, çıkarımın çalıştığı tüm sürelerdir. Bekleme dakikaları ise bir WebRTC oturumunun çıkarım duraklatılmışken, konuşmayı bekleyerek bağlı kaldığı süredir. İkisi arasındaki dakika başına 0,03 $ fark, ses faturanızın büyük kısmını belirler.
OpenAI'ın maliyet rehberi etkin kaleme giren durumları şöyle sıralıyor:
- Kullanıcının veya modelin konuştuğu süre.
- Boşta kalma zaman aşımınız dolana kadar geçen sessizlik.
- Çıkarım çalışırken arka uç işlerinin beklenmesiyle geçen süre.
Mikrofonu kapatmak bekleme modunu tetiklemez; oturum dakika başına 0,05 $ üzerinden faturalanmaya devam eder.
Bekleme modu, oturum oluşturulurken canlı konuşmalar rehberinde belgelenen iki ayar gerektirir:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech", oturuma çıkarımı başlatmadan önce konuşmayı beklemesini söyler. idle_timeout_s 5 ile 60 arasında tam bir sayı alır ve bu kadar saniye boyunca giriş veya çıkış transkripti olmadığında oturumu tekrar bekleme moduna geçirir. Zaman aşımını belirtmezseniz çıkarım, oturum sona erene kadar etkin kalır ve bekleme oranını hiçbir zaman elde edemezsiniz.
İki uyarı: bekleme modu yalnızca WebRTC'de çalışır, dolayısıyla WebSocket ve SIP oturumları bağlı geçen her saniyeyi etkin oranla faturalar; ayrıca bekleme sonrasındaki ilk yanıt daha uzun sürebilir.
Örnek maliyet hesaplamaları
Ses oranları yayımlanmış oranlardır; arka uç token sayıları temsili varsayımlardır. Arka uç fiyatları OpenAI fiyatlandırma sayfasından alınmıştır: gpt-6-luna için 1M token başına 0,10 $ giriş ve 0,50 $ çıkış, gpt-6-sol için 1M token başına 2,00 $ giriş ve 10,00 $ çıkış (standart katman, kısa bağlam). OpenAI'ın devretme rehberi, gpt-6-luna ile başlamayı ve daha zor arka uç görevleri için gpt-6-sol'u denemeyi öneriyor.
Örnek 1: bir müşteri destek hattı
Telefon veya WebSocket destek çağrısı 6 dakika sürüyor. Bekleme modu uygulanmaz, dolayısıyla 6 dakikanın tamamı etkin olarak faturalanır. GPT-Live, 4 sorguyu gpt-6-luna'ya devreder; her biri yaklaşık 6.000 giriş ve 400 çıkış tokeni kullanır.
| Kalem | Hesap | Maliyet |
|---|---|---|
| Ses | 6 dk x 0,05 $ | 0,30 $ |
| Arka uç girişi | 24.000 token x 0,10 $ / 1M | 0,0024 $ |
| Arka uç çıkışı | 1.600 token x 0,50 $ / 1M | 0,0008 $ |
| Çağrı başına | 0,3032 $ |
Ayda 10.000 çağrıda bu yaklaşık 3.032 $ eder ve bunun 3.000 $'ı ses süresidir. Ortalama çağrıdan 30 saniye kısaltmak, arka uç faturasının tamamından daha fazla tasarruf sağlar.
Örnek 2: tarayıcıda bir dil eğitmeni
idle_timeout_s 15 olarak ayarlanmış, 30 dakikalık bir WebRTC eğitmen oturumu. Öğrenci uzun süreler okuyup düşündüğü için oturum 18 dakika etkin ve 12 dakika beklemede çalışıyor. Eğitmen, 10 açıklamayı her biri yaklaşık 8.000 giriş ve 600 çıkış tokeniyle gpt-6-sol'a devrediyor.
| Kalem | Hesap | Maliyet |
|---|---|---|
| Etkin ses | 18 dk x 0,05 $ | 0,90 $ |
| Bekleme sesi | 12 dk x 0,02 $ | 0,24 $ |
| Arka uç girişi | 80.000 token x 2,00 $ / 1M | 0,16 $ |
| Arka uç çıkışı | 6.000 token x 10,00 $ / 1M | 0,06 $ |
| Oturum başına | 1,36 $ |
Bekleme modu olmasaydı, aynı 30 dakikalık ses süresi 1,14 $ yerine 1,50 $ tutacaktı; yani bekleme modu ses faturasını %24 azaltıyor.
Örnek 3: sürekli açık bir masaüstü asistanı
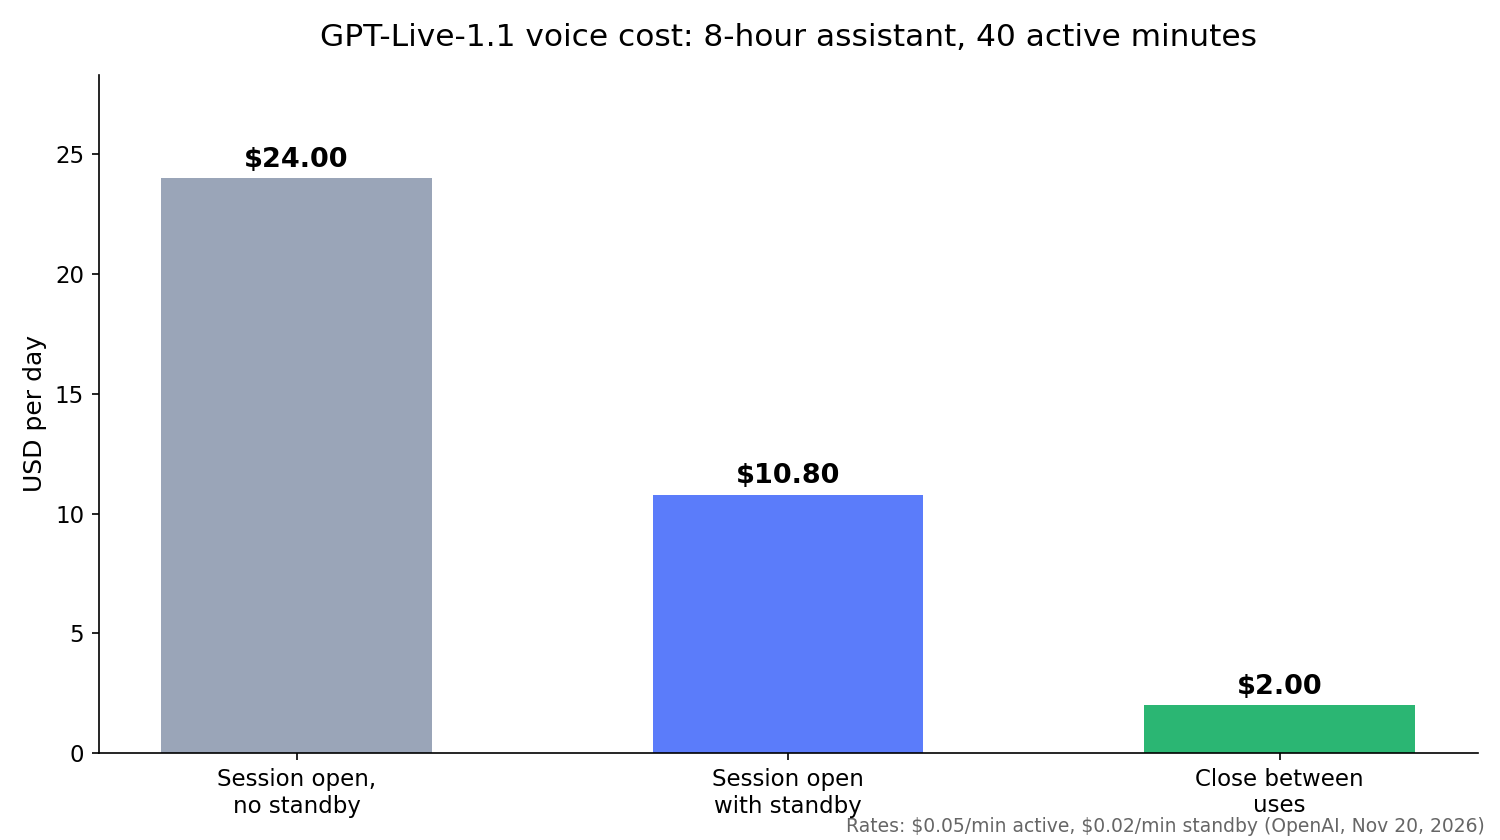
Bir asistan 8 saatlik iş günü boyunca açık kalıyor, ancak kullanıcı yalnızca kısa aralıklarla toplam 40 dakika konuşuyor. Burada seçtiğiniz strateji faturayı 10 kattan fazla değiştiriyor:
| Strateji | Hesap | Günlük | 22 günlük ayda |
|---|---|---|---|
| Oturum açık, bekleme yok | 480 dk x 0,05 $ | 24,00 $ | 528,00 $ |
| Oturum bekleme ile açık | 40 x 0,05 $ + 440 x 0,02 $ | 10,80 $ | 237,60 $ |
| Kullanımlar arasında kapatma | 40 dk x 0,05 $ | 2,00 $ | 44,00 $ |
Bekleme modu yine de boşta geçen saat başına 1,20 $ tutuyor. OpenAI'ın rehberi, uzun boşluklar sırasında oturumu kapatmayı ve kullanıcı döndüğünde kaydedilmiş geçmişle beslenmiş yeni bir oturum başlatmayı öneriyor. 15 saniyelik başlangıç ücreti, yeni oturum çalışmaya başladığında iade edildiği için, yalnızca ses ücretleri üzerinden kapatmak kazanır. Bunun karşılığında anında uyanma özelliğinden vazgeçersiniz: kapatılmış bir oturum kullanıcıyı duyamaz, dolayısıyla push-to-talk ya da kendi uyanma tetikleyicinize ihtiyacınız var.
Boşta kalma zaman aşımı faturanızı nasıl etkiler?
Boşta kalma zaman aşımı tetiklenene kadar her duraklama etkin süreye mal olur. Daha kısa bir zaman aşımı, daha düşük bekleme oranına daha hızlı ulaşır; karşılığında daha çok duraklat-sürdür döngüsü ve her döngüden sonra daha yavaş ilk yanıt olur.
Her duraklamanın primi, zaman aşımı süresinin iki oran arasındaki 0,03 $ farkla faturalanmasıdır. Bir oturumda veya bir günde 100 duraklama üzerinden:
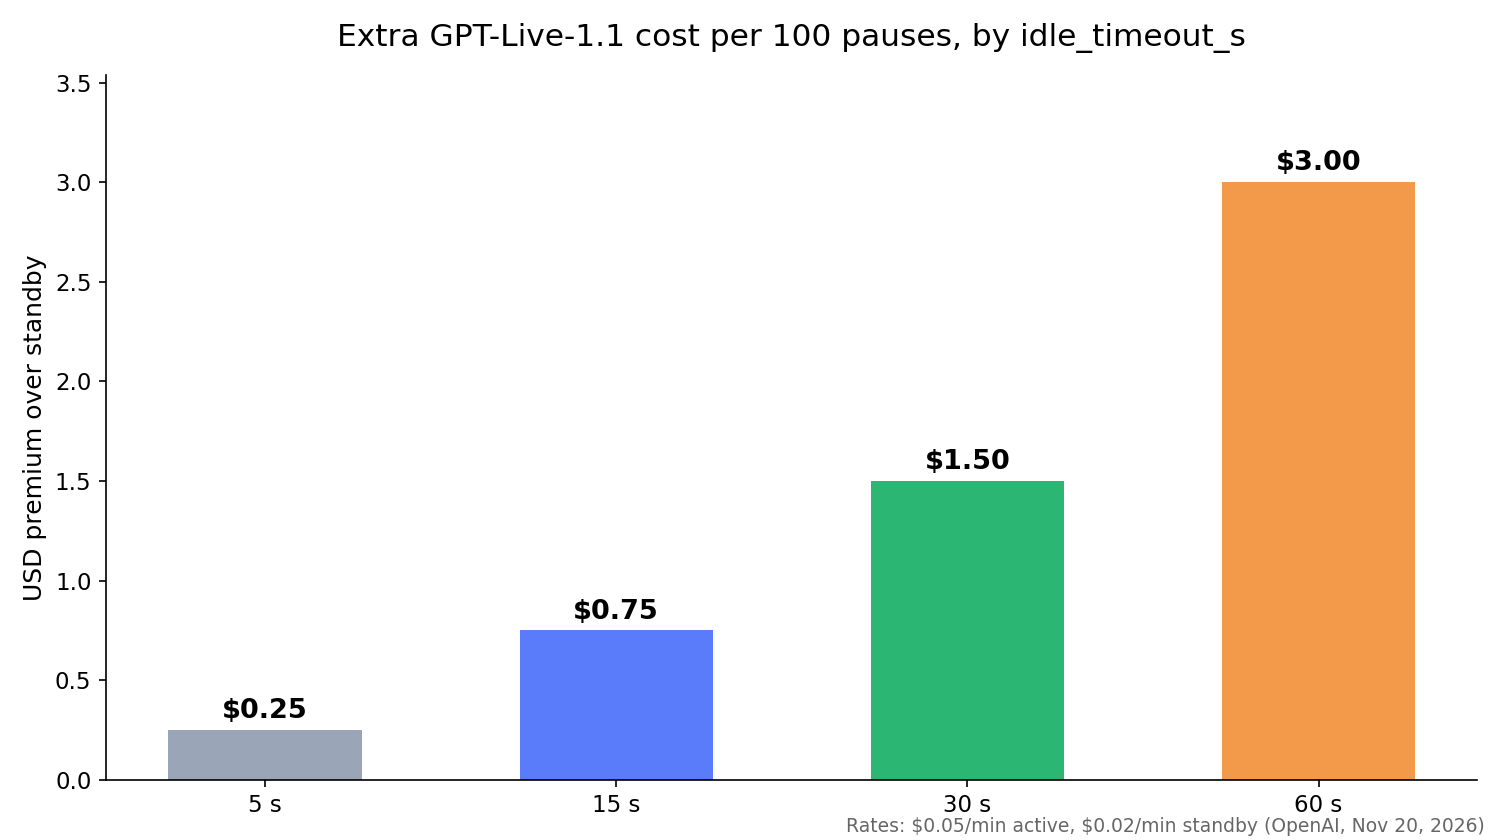
idle_timeout_s |
Duraklama başına etkin saniye | Beklemeye göre prim, 100 duraklamada |
|---|---|---|
| 5 | 5 | 0,25 $ |
| 15 | 15 | 0,75 $ |
| 30 | 30 | 1,50 $ |
| 60 | 60 | 3,00 $ |
Küçük rakamlar — asıl mesele de bu: zaman aşımı büyük ölçüde bir kullanıcı deneyimi ayarıdır. Kullanıcıyı düşüncesinin ortasında kesmeyen bir değer seçin; uzun boşlukları bekleme modu, çok uzun olanlarını da oturumu kapatma karşılasın.
GPT-Live-1.1 fiyatlandırması GPT-Realtime ile nasıl karşılaştırılır?
GPT-Live-1.1 dakika bazında; GPT-Realtime modelleri ise token bazında faturalanır. OpenAI fiyatlandırma sayfası, gpt-realtime-2.1 ses için 1M giriş tokeni başına 32,00 $ ve 1M çıkış tokeni başına 64,00 $; gpt-realtime-2.1-mini ses için ise 10,00 $ ve 20,00 $ listeliyor.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Faturalama birimi | Oturum saniyeleri | Giriş ve çıkış tokenleri |
| Ses oranı | Etkin dk başına 0,05 $, bekleme dk başına 0,02 $ | 1M ses tokeni başına 32 $ / 64 $ |
| Akıldırma ve araçlar | Ayrı arka uç modeli | Aynı modelin içinde |
| Maliyet eğrisi | Dakika başına sabit | Bağlam büyüdükçe tur başına artar |
OpenAI'ın maliyet rehberi, bir Realtime oturumunun her yanıtta konuşmanın tamamını modele gönderdiğini, dolayısıyla sonraki turların daha pahalıya geldiğini belirtir. Bir GPT-Live dakikası, 2. dakikada da 40. dakikada da aynı tutarındadır; bu da tahmin yapmayı kolaylaştırır. Token tabanlı kurulumu GPT-Realtime-2 API rehberimizde ele alıyoruz.
Kullanımı izleyin ve sürpriz faturalardan kaçının
GPT-Live, kümülatif ses kullanımını saniye cinsinden session.usage.updated olaylarıyla bildirir:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
Her güncelleme önceki toplamın yerini alır, dolayısıyla asla bunları toplamayın. session.close gönderin, session.closed için bekleyin ve son usage.seconds değerini kaydedin. Etkin ile bekleme süresini ayırmak için session.paused ve session.resumed olayları arasındaki boşlukları sayarak ölçün.
Maliyeti sabit tutan alışkanlıklar:
- Bitmiş oturumları kapatın. Terk edilmiş açık bir oturum faturalanmaya devam eder.
- Arka ucu hızlandırın. Devredilmiş bir görevi beklemek etkin süredir; bir dakika erken bitirmek 0,05 $ tasarruf eder.
- Uzun işler sırasında kapatın. Arka uç çalışırken sesi kapatın, sonuç hazır olduğunda yeniden açın.
- Eşzamanlılığı planlayın. Limitler eşzamanlı oturumları sayar ve GPT-Live-1.1, GPT-Live-1'den ayrı bir limite sahiptir; GPT-Live-1'in yayımlanan limitleri 50 (Build), 300 (Launch) ve 500 (Grow) şeklindedir. Free katmanı desteklenmiyor.
Codex'in maliyet defterinizi Apidog CLI ile test etmesine izin verin
Kullanım defteriniz kendi yazdığınız bir koddur ve buradaki bir hata her çağrıyı yanlış fiyatlandırır. Her commit'te, ses oturumu açmadan, 0 $ ses süresiyle test edin; testleri kodlama ajanınızın Apidog CLI ile çalıştırmasına izin verin.
CLI'ı kurun, giriş yapın ve Apidog yeteneğini ajanınıza ekleyin:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ardından Codex'e tek bir istem verin:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
Ajan şemayı okur, yükünü doğrular, test senaryolarını oluşturur ve çalıştırır:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
-r cli,json yerine -r junit yazın ve aynı çalıştırma CI'a düşer; bkz. CI/CD hattında Apidog CLI çalıştırma. Ajan kurulumunu Codex'te Apidog CLI rehberi ele alıyor. Apidog'un Free planı 4 kullanıcıya kadar ekipleri kapsıyor.
SSS
GPT-Live-1.1 dakikada ne kadar tutar? Etkin dakika başına 0,05 $ ve bekleme dakikası başına 0,02 $, saniye bazında faturalanır. Arka uç kullanımı ekstradır.
GPT-Live-1.1, GPT-Live-1'den daha pahalı mı? Hayır. OpenAI her ikisini de aynı etkin ve bekleme oranlarıyla listeliyor.
Bekleme modu telefon çağrılarında çalışıyor mu? Hayır. Düşük bekleme oranı yalnızca çıkarımın duraklatıldığı WebRTC oturumlarında geçerlidir. WebSocket ve SIP oturumları bağlı süreyi etkin oranla faturalar.
Arka uç model çağrıları dakika başı fiyata dahil mi? Hayır. Devredilen Responses çağrıları, seçilen modelin token oranlarıyla ve ayrıca araç ücretleriyle faturalanır.
Temmuz ayındaki GPT-Live API sorusuna ne oldu? O zamanlarda GPT-Live, API'si olmayan bir ChatGPT ses özelliğiydi; GPT-Live API açıklamamız bu durumdan o sırada bahsetmişti. GPT-Live-1.1, API modelidir ve v1/live/sessions üzerinde sunulur.