
GPT-6 Astra, Qwen3.5-0.8B’nin MATH-500 puanını herhangi bir eğitim olmadan %7.9’dan %48.1’e çıkardı. Modelin ağırlıklarını okudu, modelin düşünmesinde döngüye girmesine neden olan bir yön buldu ve bunu iki MLP katmanından çıkardı. Bu düzenleme 131,072 ağırlığa, yani modelin %0.016’sına dokundu. Rakamlar, dört MIT CSAIL araştırmacısının 2 Kasım tarihli yazısından geliyor ve düzenlenmiş model herkese açık, yani iddiayı kendiniz kontrol edebilirsiniz.
Aşağıda: ağırlık uzayı programlamanın ne olduğu, Astra’nın neyi değiştirdiği, yöntemin nerede işlemeyi bıraktığı ve kodlama ajanınıza her iki modeli Apidog CLI ile nasıl karşılaştırtacağınız.
Ağırlık uzayı programlama nedir?
Ağırlık uzayı programlama, genel amaçlı bir LLM’in bir sinir ağının ağırlıklarını doğrudan okuması ve yazmasıdır; sade bir dille ifade edilmiş bir hedefle yönlendirilir, gradyan inişi ve eğitim döngüsü yoktur. Model, ağın her bir parçasının ne hesapladığı üzerine akıl yürütür, ardından sayıları bir programcının kaynak kodunu düzenlemesi gibi elle değiştirir.
Terim, Rikiya Takehi, Jayden Teoh, Alex Zhang ve Omar Khattab tarafından yazılan ve 2 Kasım 2026’da yayımlanan Sparks of Weight-Space Programming adlı çalışmadan geliyor. Yazarlar her sonucu “çok erken” olarak nitelendiriyor ve birkaçı tek veya birkaç çalıştırmadan geliyor. Düzenlemeyi yapan model hakkında arka plan için GPT-6 Astra uygulamalı incelemesi sayfasına bakın.
GPT-6 Astra, Qwen3.5-0.8B’yi nasıl düzeltti
Manşet sonuç Deney 8. Araştırmacılar GPT-6 Astra’dan Qwen3.5-0.8B’yi ağırlıklarını düzenleyerek matematikte daha iyi hale getirmesini istedi. Adım adım olanlar şöyle:
- Kurulum. Astra’ya modelin ağırlıklarının yüklü olduğu bir Python oturumu (not defteri gibi), GPU yok ve eğitim setlerinden 7,469 GSM8K artı 7,275 MATH alıştırma problemi verildi. Test setlerini hiç görmedi.
- Bütçe. Eğitim yerine Astra 10, 25 veya 50 ileri geçiş harcayabilirdi. Bir ileri geçiş, modelin 512 probleme kadar yanıt vermesini veya 1,024 metne kadar okumasını sağlıyordu.
- Teşhis. Astra, temel modelin döngüye girdiğini gördü: ilk 96 alıştırma yanıtından 85’i bir yanıta ulaşmadan 32,768 token sınırına dayandı. Yazarlar, Qwen’in kendi model kartının bu modelin düşünme döngülerine yatkın olduğu konusunda uyardığını belirtiyor.
- İzleme. Astra, döngüyü 15. ve 19. katmanların MLP’leri tarafından yazılan bir yöne kadar izledi.
- Düzenleme. Bu yönü iki katmanın her birinde
down_proj’un 64 çıktı sütunundan çıkardı. Bu, 0.8 milyar içinde 131,072 ağırlık demek.
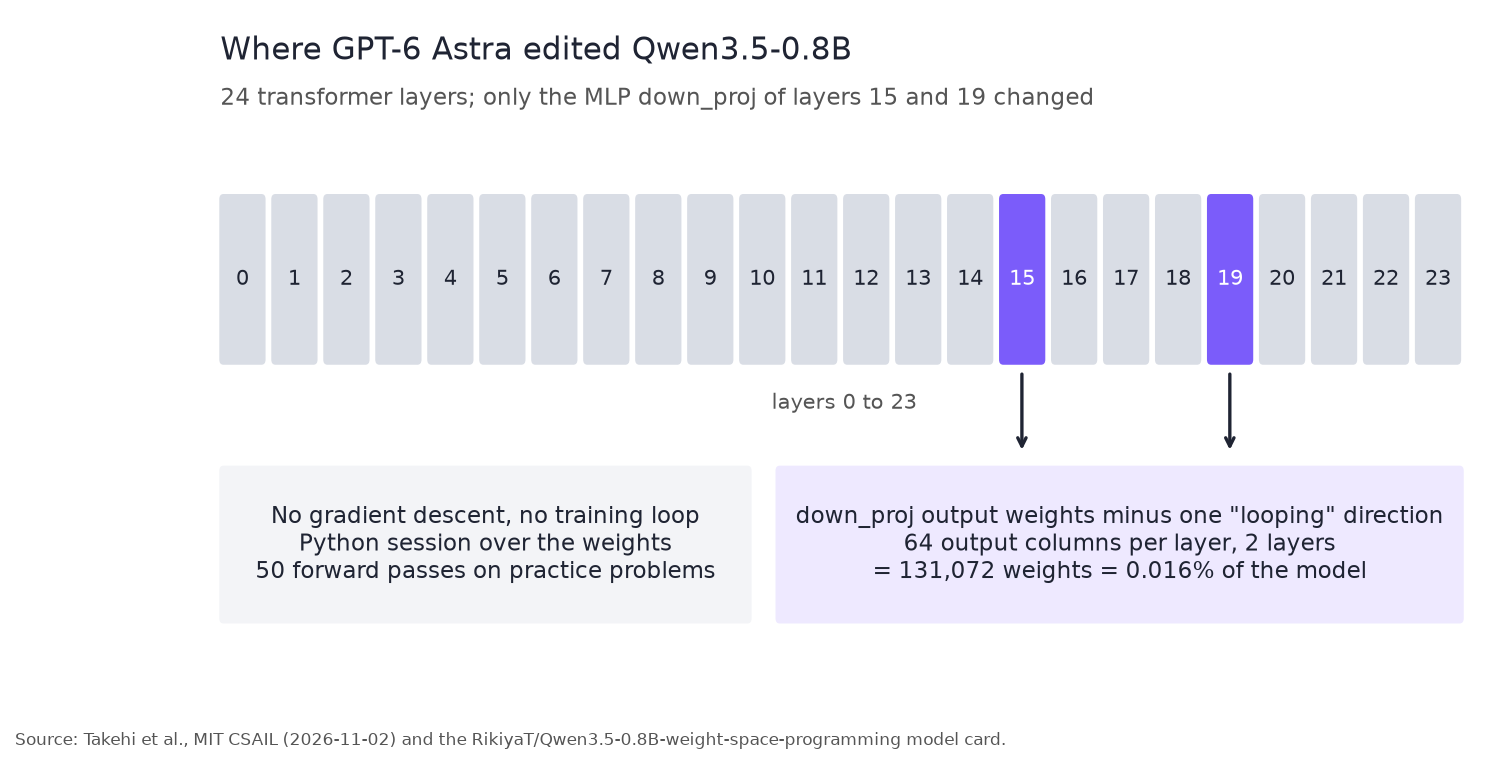
Hugging Face model kartına göre, temel Qwen/Qwen3.5-0.8B kontrol noktasından yalnızca bu iki down_proj tensörü farklı ve yeniden oluşturulan her tensör, yazarların değerlendirdiği tensöre karşı sha256 ile doğrulanmış. Düzenlenmiş model Apache 2.0 altında dağıtılıyor.
Sonuçlar: temel ve düzenlenmiş Qwen3.5-0.8B
Buradaki her rakam yazarların yazısından alınmıştır (düşünme açık, 32,768 token’a kadar, problem başına birkaç örnek). “Token sınırına ulaştı”, token’ı tükenen MATH-500 yanıtlarının oranıdır.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Token sınırına ulaştı |
|---|---|---|---|---|
| Temel | 7.9% | 13.8% | 21.0% | 93.0% |
| Düzenlenmiş, 10 ileri geçiş | 12.3% | 25.7% | 49.0% | 87.2% |
| Düzenlenmiş, 25 ileri geçiş | 14.1% | 25.1% | 39.9% | 86.4% |
| Düzenlenmiş, 50 ileri geçiş | 48.1% | 67.1% | 62.3% | 33.1% |
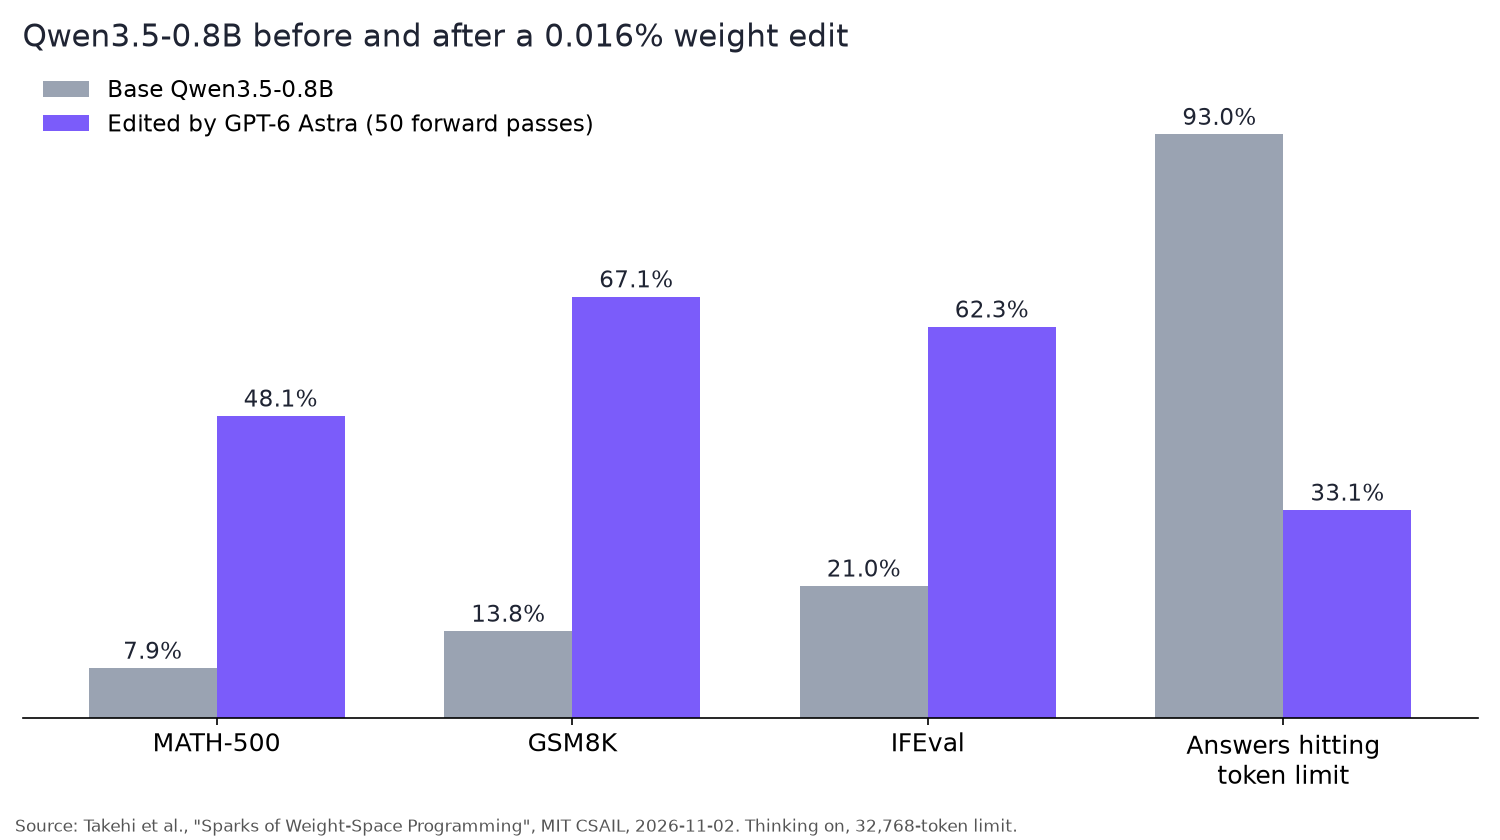
- Düzeltme genelleşti. Döngü matematiğe özgü değil, bu yüzden IFEval de kabaca üçe katlandı.
- Bütçe önemliydi. 10 veya 25 ileri geçişte döngüler neredeyse hiç ortadan kalkmadı.
- Başka biri bunu yeniden üretti. Hugging Face’te Ahsen Khaliq, kontrol noktasını günlüklerden yeniden oluşturdu ve tam MATH-500’ü yeniden çalıştırdı (500 problem, her biri için 4 örnek). Düzenlenmiş model %51.0 puan aldı ve yanıtların %31.6’sı sınıra ulaştı. Temel modelin 25 problemli bir hızlı testi %5.0 verdi.
demo Space, bir problem yazıp her iki modelin yanıtını izlemenizi sağlar.
Ağırlıkları düzenlemenin yapamayacakları
Yazarlar, manşetten daha önemli bir kontrol çalıştırdı. Aynı yaklaşımı, nadiren döngüye giren bir model olan Gemma 3 270M üzerinde denediler (yanıtlarının %8.5’i sınıra ulaştı; Qwen için bu oran %93’tü).
| Gemma 3 270M | MATH-500 |
|---|---|
| Temel | 6.8% |
| En iyi düzenleme (25 ileri geçiş) | 7.7% |
Gemma’nın hataları, yanlış aritmetik gibi sıradan hatalardı ve kapatılacak tek bir bileşen yoktu. Yazarların sonucu: düzenleme, bir yeteneği gizleyen bir engeli kaldırdı, ancak modelin sahip olmadığı bir yeteneği ekleyemedi. Qwen birçok yanıtı zaten çözebiliyordu. Sadece onları hiç bitiremiyordu.
Yani bu “eğitim bitti” değil. Bu, bir sınır modelinin tek bir yerde yaşayan tek bir başarısızlığı bulup kaldırmasıdır.
Ağırlık uzayı programlama makalesinin geri kalanı
Deney 8, sekiz deneyden biri. Diğerleri çok daha küçük ağlar kullanıyor:
- Ağırlıkları okuma. Astra, yalnızca ham ağırlıklardan 4 PPO ile eğitilmiş oyun politikasının 4’ünün de hangi oyun olduğunu ve 3 küçük karakter düzeyinde dil modelinin 3’ünün de eğitim dilini adlandırdı.
- Bir politikayı düzeltme. 256 bölümün 256’sında başarısız olan bir Kinetix araba politikası, Astra tek bir yanıtta ağırlıklarının %3.5’ini düzenledikten sonra 1,024 bölümün 1,024’ünde başarılı oldu.
- Ağırlıkları sıfırdan yazma. Astra, 500 milyon adım boyunca eğitilmiş PPO’nun 25.3’üne karşı 517.4 puan alan MinAtar Breakout ağırlıklarını yazdı. Seaquest’te 88.9’a karşı 53.1 ile kaybetti.
- Go. Sıfırlardan 1.48 milyon ağırlıklı bir 9x9 Go ağı yazdı ve 50 ileri geçişle eşit büyüklükteki bir PPO ağını yendi.
- Bir isabetsizlik. Yalnızca ağırlıklardan, iki Gemma 3 270M kopyasından hangisinin dalkavuk olacak şekilde eğitildiğini söyleyemedi. Dikkat desenlerine erişimle, üç çiftin üçünde de dalkavuğu seçti.
Tam deney günlükleri her istemi, Astra’nın akıl yürütme özetlerini ve çalıştırdığı her kod parçasını içeriyor.
Qwen3.5-0.8B düşünme döngüsü düzeltmesini kendiniz kontrol edin
En temiz test, her iki kontrol noktasını da aynı OpenAI uyumlu API’nin arkasında sunmak ve onlara aynı istemleri göndermektir. vLLM bunu model başına tek komutla yapar:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
Her iki sunucu da qwen adına yanıt verir, böylece tek bir istek gövdesi her iki bağlantı noktasında da çalışır. --max-model-len 34816, model kartındaki örnekle eşleşir.
Her istek, yazarların örnekleme ayarlarını yansıtır ve düşünmeyi açar:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
Son \boxed{} değeri yanıttır ve finish_reason modelin durduğunu (stop) mu yoksa token’ının mı tükendiğini (length) söyler. length bitişi bir döngüdür.
Bir GPU çalıştırmayı tercih etmiyorsanız, GPT-6 Astra API’sini aynı şekilde test edebilir veya küçük Qwen modellerini yerel olarak ücretsiz Qwen3.5 Ollama kurulumu ile karşılaştırabilirsiniz.
Kodlama ajanınızın her iki modeli Apidog CLI ile test etmesini sağlayın
Yirmi uzun üretimi elle değerlendirmek, kodlama ajanınızın işidir. Apidog CLI, ajana ortamlar, test senaryoları, veri güdümlü çalıştırmalar ve raporlar verir ve makinenizde çalışır, böylece localhost uç noktaları çalışır.
Kurun ve ajanınıza beceriyi verin:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ardından Claude Code, Codex, Cursor veya OpenCode’a tek bir istem verin:
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
Ajan yük şemasını okur, JSON’unu doğrular ve ardından şu komutları çalıştırır:
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d, her CSV satırını bir yineleme olarak besler. --timeout-request milisaniye cinsindendir ve döngüye giren bir yanıtın 32,768 token’ı tüketmesi dakikalar alabilir. -r cli,json bir özet yazdırır ve ajanın diff’leyebileceği bir JSON raporu yazar. 10 soru GSM8K test bölümünden gelir.
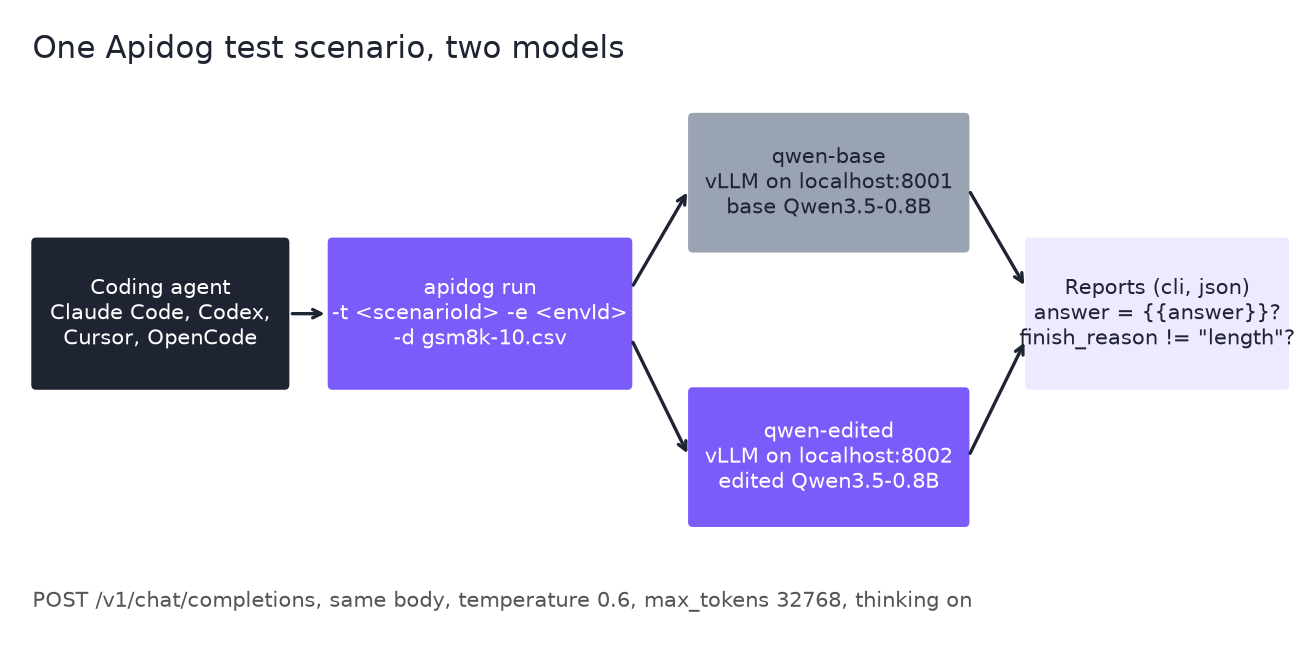
Çalıştırmanız yazarlarınkine benziyorsa, çoğu temel yanıt finish_reason doğrulamasında başarısız olur ve çoğu düzenlenmiş yanıt bunu geçer. On soru bir hızlı testtir, kıyaslama değildir; bu yüzden bir farkı puan değil sinyal olarak değerlendirin. Çalıştırmayı uygulamada görüntülemek için --upload-report ekleyin ve tüm bayraklar için apidog run komut referansına bakın.
Aynı senaryo, herhangi bir model değişimi için regresyon testi olarak çalışır; Apidog CLI CI/CD kılavuzu -r junit kurulumunu gösterir.
Küçük modeller yayınlıyorsanız bu ne anlama gelir
- Yalnızca doğruluğu değil, kesilmeyi de ölçün. Qwen’in %7.9’u, çoğunlukla hiç bitirmeyen bir modeli gizliyordu. Bir
finish_reasonkontrolü bunu yakalar. - Tek nedene bağlı başarısızlıkları arayın. Döngüler ve tekrar, bir ağın dar bir bölümünde yaşayabilir.
- Kontrolü hatırlayın. Modeliniz takılmak yerine yanlışsa, bunun gibi bir düzenleme yardımcı olmaz.
Ajan işi için bir GPT-6 katmanı mı seçiyorsunuz? GPT-6 Luna vs Sol vs Astra sayfasına bakın.
SSS
GPT-6 Astra, Qwen3.5-0.8B’yi eğitti mi? Hayır. Yazarlar gradyan inişine ve eğitim döngüsüne izin vermedi. Astra, bir Python oturumunda ağırlıkları düzenledi ve modeli yalnızca 10, 25 veya 50 ileri geçişle gözlemledi.
Düzenleme kaç ağırlığı değiştirdi? Yazarların modelin %0.016’sı olarak belirttiği 131,072 ağırlık. Değişiklikler, 15. ve 19. katmanlardaki MLP’lerin down_proj matrislerinde, her birinde 64 çıktı sütununda yer alıyor.
Düzenlenmiş model mevcut mu? Evet, Hugging Face’te Apache 2.0 altında RikiyaT/Qwen3.5-0.8B-weight-space-programming olarak, değiştirilen iki tensörün hash’leri ve bağımsız bir yeniden çalıştırmayla (MATH-500’de %51.0) birlikte.
Matematik puanları neden bu kadar arttı? Çünkü temel model döngüye giriyordu. MATH-500’de yanıtlarının %93.0’ü 32,768 token sınırına ulaştı. Düzenleme bunu %33.1’e düşürdü, böylece model zaten çözebildiği yanıtları bitirdi. Yeni matematik öğrenmedi.
Ağırlık uzayı programlama herhangi bir modelde çalışır mı? Yazarların kendi ifadesine göre henüz değil. Nadiren döngüye giren Gemma 3 270M’de en iyi düzenleme MATH-500’ü %6.8’den %7.7’ye taşıdı. Yazarlar tüm sonuçlarını çok erken olarak nitelendiriyor.
Düzenlenmiş modeli kod yazmadan test edebilir miyim? Evet. Hugging Face demo Space, yazdığınız bir problem üzerinde her iki modeli de çalıştırır. Tekrarlanabilir bir kontrol için yukarıda gösterildiği gibi vLLM artı Apidog CLI kullanın.