
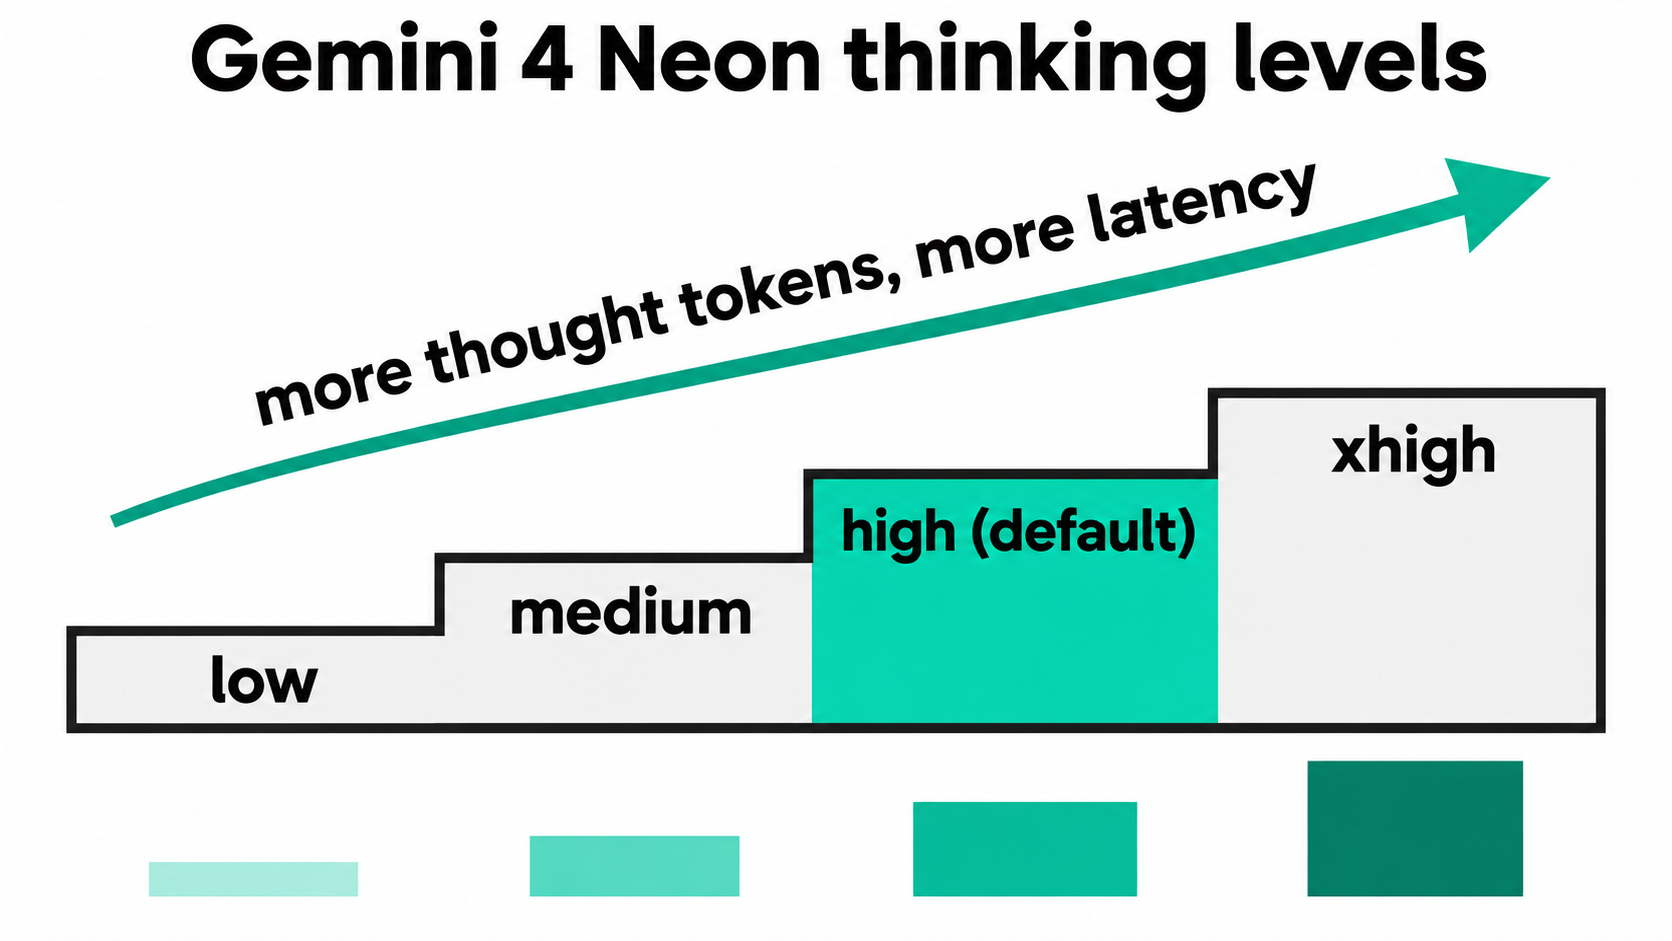
Gemini 4 Neon düşünme seviyeleri, modelin yanıt vermeden önce ne kadar yoğun akıl yürüteceğine dair dört ayar sunar: low, medium, high ve xhigh. Neon varsayılan olarak high kullanır. Google, karmaşık işlerin çoğu için high seviyesinde kalmanızı ve yalnızca high zor, çok adımlı problemlerde yetersiz kaldığında xhigh seviyesine geçmenizi önerir; çünkü xhigh daha fazla token tüketir ve daha uzun sürer.
Gemini 4 Neon düşünme seviyeleri nedir?
Düşünme seviyeleri, gemini-4-neon modelinin yanıt yazmadan önce ne kadar içsel akıl yürütme yapacağını belirleyen thinking_level parametresinin değerleridir. Neon dört seviyeyi destekler: low, medium, high (varsayılan) ve xhigh. Yüksek seviyeler daha fazla düşünme token'ı kullanır ve gecikme ekler; düşük seviyeler daha hızlı yanıt verir ve daha az maliyetlidir.
Google'ın düşünme rehberinde Neon için her seviyenin nasıl tanımlandığı aşağıda yer alıyor:
thinking_level |
Token kullanımı | Google'ın önerdiği kullanım |
|---|---|---|
low |
En az token, en düşük gecikme | Hızlı sohbet, yüksek verimli işleme; ajan tabanlı görevlerde hâlâ yetenekli |
medium |
Daha az token kullanımı, daha hızlı yanıtlar | Etkileşimli kodlama, canlı arayüz prototipleme, gecikmeye duyarlı araç çağrıları |
high (varsayılan) |
Dengeli zeka ve hız | Karmaşık kodlama, ajan tabanlı yürütme, araç çağırma, çok modlu bilgi çalışması |
xhigh |
En fazla token, en derin akıl yürütme | Zorlu çok adımlı mühendislik, high'ın yetersiz kaldığı analitik ve bilimsel problemler |
Bekleyebileceğiniz iki değer eksik. Neon, minimal değerini bir hatayla reddeder; bu nedenle Gemini 3 Flash uygulamasından kopyalanan kod bu değeri gönderirse bozulur. Eski thinkingBudget token sayısı ise Gemini 4'te kullanımdan kaldırılmıştır: tek başına gönderildiğinde bir uyarıyla en yakın seviyeye eşlenir; thinkingLevel ile birlikte gönderildiğinde ise 400 döndürür.
Neon'un varsayılanı diğer Gemini 4 modelleriyle nasıl karşılaştırılır?
Neon, daha büyük kardeşlerinden bir adım yüksekten başlar. Gemini 4 Neon sürüm notlarına göre Neon ve Hydrogen varsayılan olarak high kullanır ve xhigh'ı destekler; Carbon ve Argon ise medium kullanır ve high'da tavan yapar.
| Model | Varsayılan seviye | Desteklenen seviyeler |
|---|---|---|
gemini-4-neon |
high |
low, medium, high, xhigh |
gemini-4-hydrogen |
high |
low, medium, high, xhigh |
gemini-4-carbon |
medium |
low, medium, high |
gemini-4-argon |
medium |
low, medium, high |
Bu, model değiştirdiğinizde önem kazanır. Bir Carbon iş yükünü thinking_level ayarlamadan Neon'a taşırsanız her istek medium akıl yürütmeden high seviyesine sıçrar ve bu da token sayınızı değiştirir. Daha büyük modelleri değerlendiriyorsanız Gemini 4 Carbon ve Argon karşılaştırmamız bu ayrımı ele alıyor.
Gemini API'de thinking_level nasıl ayarlanır?
Neon, hem Interactions API'nin hem de generateContent'in ücretli katmanında çalışır. Alan adı ikisi arasında farklılık gösterir.
Interactions API: thinking_level değerini generation_config içine yerleştirin.
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent: generationConfig.thinkingConfig içinde thinkingLevel kullanın.
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
Python SDK'da Interactions çağrısı generation_config={"thinking_level": "high"} alır, generateContent çağrısı ise thinking_config=types.ThinkingConfig(thinking_level="low") alır. temperature, top_p ve top_k değerlerini dışarıda bırakın: Google, Neon'un aralık içi değerleri yok saydığını ve aralık dışı değerleri 400 ile reddettiğini belirtiyor. Aynı API tasarımıyla ilk istek için tam bir adım adım kılavuz için Gemini 4 Hydrogen API kılavuzumuza göz atın.
high ve xhigh ne zaman kullanılmalı?
Varsayılan olarak high kullanın ve bir görevi ancak high kalite çubuğunuzu geçemezse xhigh seviyesine yükseltin. Google'ın lansman yazısı xhigh'ı "en zorlu mühendislik, analitik ve bilimsel iş yükleri için daha derin, çok adımlı akıl yürütme" olarak tanımlıyor.
Şu durumlarda xhigh seçin:
- Görevde birbirine bağlı çok sayıda adım varsa ve erken bir hata sonucu mahvediyorsa; örneğin çok dosyalı bir yeniden düzenleme veya eşzamanlılık denetimi.
highkendinden emin ama yanlış bir yanıt verdiyse; yalnızca daha yavaş değil, değerlendirme setinizde kalite açısından başarısız olduysa.- Gecikme çok önemli değilse; arka plan işleri, gecelik incelemeler veya toplu analiz gibi.
- Yanlış bir yanıtın maliyeti token'lardan yüksekse; güvenlik yamaları veya finansal hesaplamalar gibi.
Şu durumlarda high seviyesinde kalın (veya daha altına inin):
- İpucu çıkarma veya biçimlendirme ise. Google,
xhigh'ın "metin veya JSON çıkarma gibi daha basit ipuçlarında aşırı düşünmeye veyamax_output_tokens'ı tüketmeye yol açabileceği" uyarısında bulunuyor. - Bir kullanıcı bekliyorsa. Sohbet, otomatik tamamlama ve canlı araç çağrıları
mediumveyalowseviyesine uygundur. - Yüksek hacimle çalışıyorsanız. Her ek düşünme token'ı faturalandırılır ve fark istekler arasında katlanarak büyür.
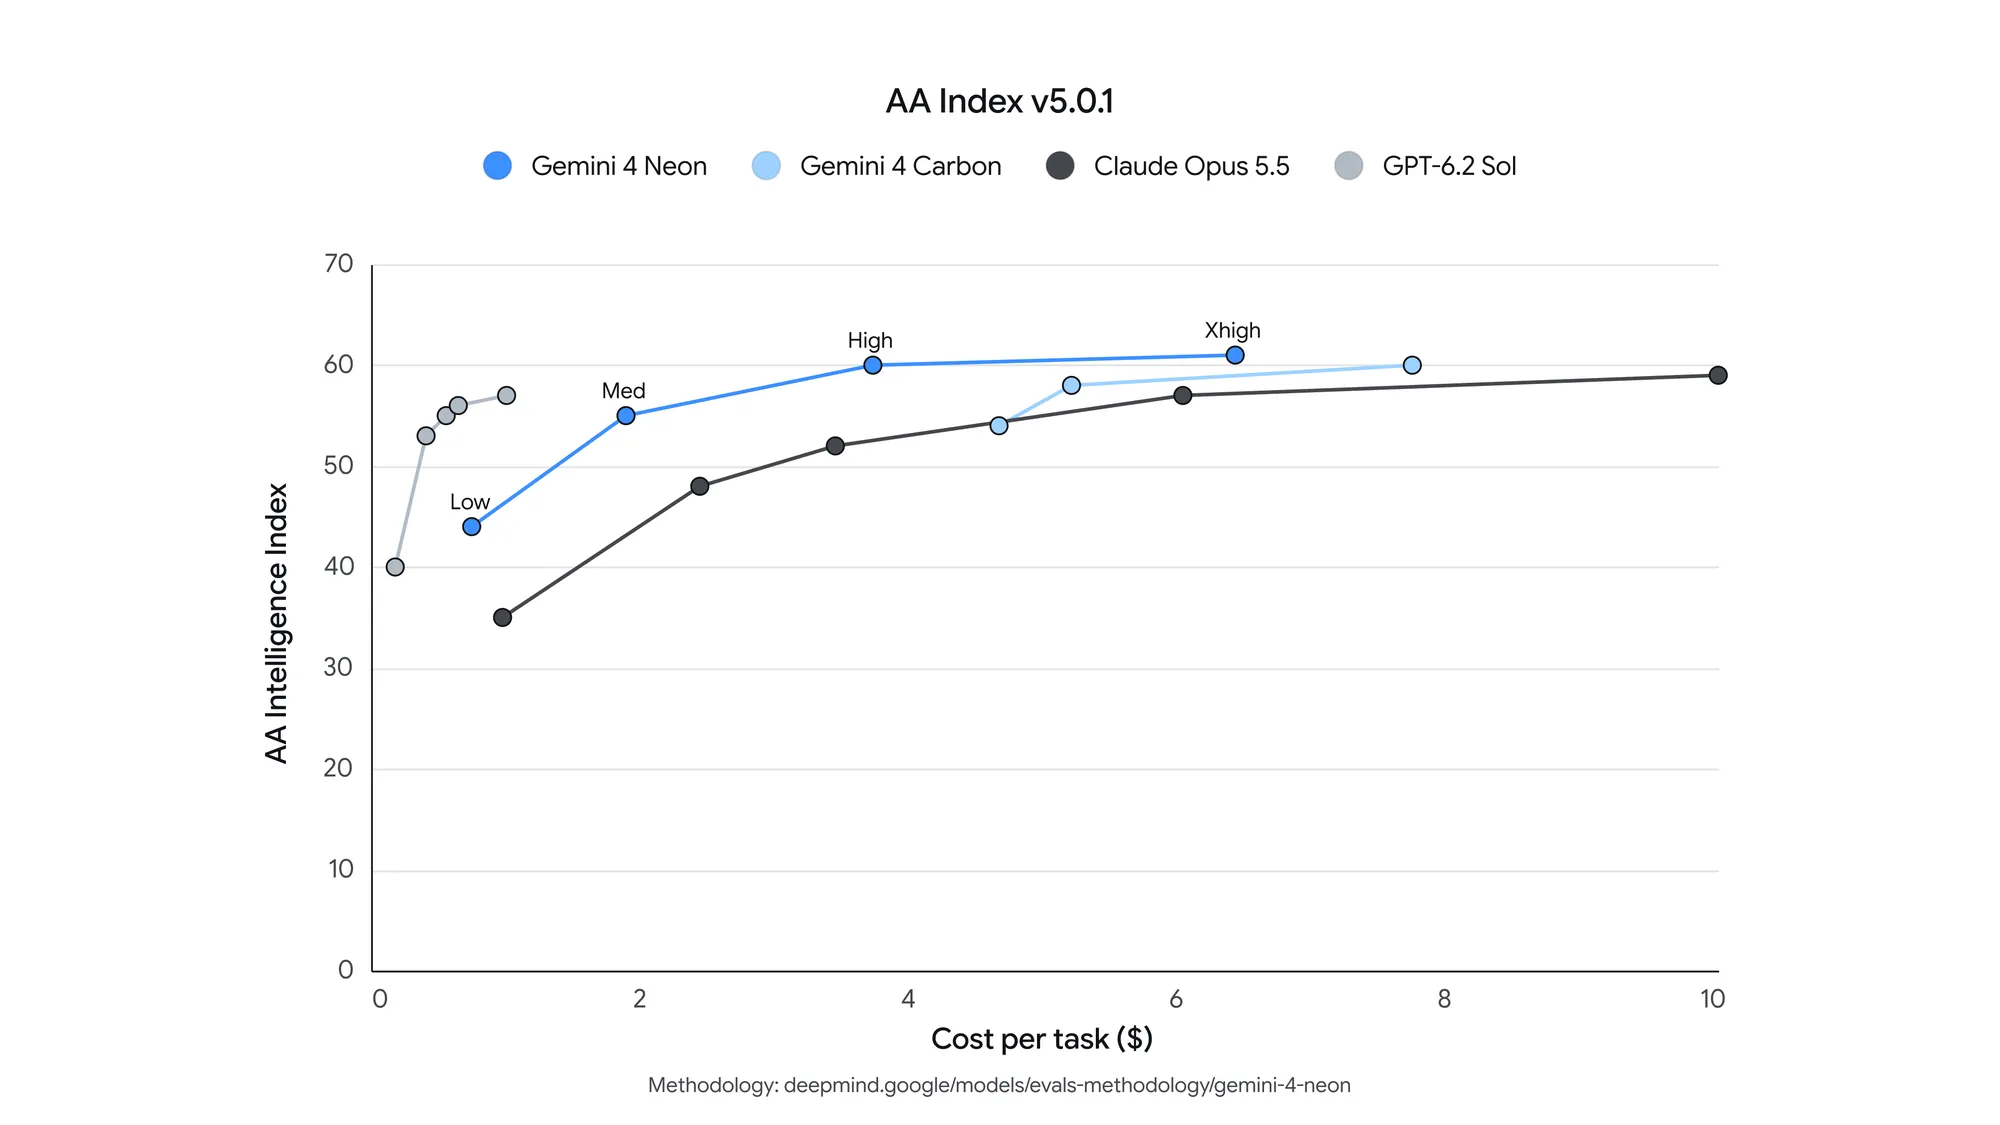
Google'ın kıyaslama sonuçları bu ayrımı destekliyor. Lansman duyurusunda Neon, xhigh seviyesinde Artificial Analysis Intelligence Index'te 61 puanla üçüncü sırada yer alıyor. Varsayılan high seviyesinde Google, Carbon'a göre görev başına %32 daha düşük maliyet bildiriyor. Bunlar bizim testlerimiz değil Google'ın rakamları, ancak dengeyi gösteriyorlar: xhigh Neon'un en yüksek puanını satın alır, high ise verimliliği.
Her düşünme seviyesi ne kadar maliyetli?
Her seviyenin token başına fiyatı aynıdır; değişen, kaç token için ödeme yaptığınızdır. Neon, 1M giriş token'ı başına $3,00 ve 1M çıkış token'ı başına $15,00 tutarındadır ve Google'ın fiyatlandırma sayfası çıkış ücretine düşünme token'larının dahil olduğunu belirtir. Önbelleğe alınmış giriş, örtük önbellekleme yoluyla 1M başına $0,15'e düşer (Neon'da açık önbellekleme desteklenmez). Bu model için ücretsiz katman yoktur.
Yani bir seviyenin maliyeti, eklediği düşünme token'larının milyon başına $15 ile çarpımıdır. 2.000 giriş token'ı ve 800 token'lık görünür yanıt içeren tek bir istek için hesaplama şöyle. Düşünme token sayıları varsayımsaldır; matematik göstermek için seçilmiştir, ölçülmemiştir:
| Düşünme token'ları (varsayımsal) | Giriş maliyeti | Çıkış + düşünme maliyeti | İstek başına toplam | 10.000 istek başına |
|---|---|---|---|---|
| 500 | $0,006 | $0,0195 | $0,0255 | $255 |
| 2.000 | $0,006 | $0,042 | $0,048 | $480 |
| 8.000 | $0,006 | $0,132 | $0,138 | $1.380 |
Düşünme, faturanın hızla büyük kısmını oluşturur. 8.000 düşünme token'ında akıl yürütme, isteğin maliyetinin %87'sidir. Bu yüzden Google'ın kendi tavsiyesi, değerlendirmenizi dört seviyede de çalıştırmanız ve "kalite çubuğunuzu karşılayan en düşük thinking_level değerini seçmenizdir." Karşılaştırmak isterseniz Gemini 3.8 Flash düşünme seviyeleri kılavuzumuz daha ucuz bir modelde aynı dengeyi ele alıyor.
Seviye başına token'lar ve gecikme nasıl ölçülür?
Aynı ipucunu her seviyede çalıştırın ve kullanım bloğunu okuyun. Interactions API'de yanıtın usage nesnesi total_input_tokens, total_output_tokens ve total_thought_tokens değerlerini ayrı ayrı raporlar. generateContent'te düşünme token'ları usageMetadata.thoughtsTokenCount olarak görünür.
Bu döngü, aynı ipucunu dört seviyede de gönderir ve düşünme token'ları ile gerçek geçen süreyi yazdırır:
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
Gerçek iş yükünüzden 10 ila 20 ipucu üzerinde çalıştırın. Tek bir ipucu size az şey söyler; bir set, high ve xhigh seviyelerinin kalite konusunda nerede ayrışmaya başladığını gösterir.
Test ederken HTTP istemci zaman aşımınızı yüksek ayarlayın. Google'ın geçiş notları zor ipuçlarının birkaç dakika sürebileceğini ve en az 15 dakikalık bir zaman aşımı veya arka plan yürütme önerdiğini belirtir.
xhigh neden bazen boş bir yanıt döndürür?
max_output_tokens, düşünme ve görünür çıkışı birlikte sınırlar. Neon tüm bütçeyi akıl yürütmeye harcarsa etkileşim incomplete durumuyla durur ve kesilmiş veya boş bir yanıt döndürür; üstelik oluşturduğu düşünme token'ları için yine ödeme yaparsınız.
Google'ın belgelerindeki üç kural bunu önler:
- Eski düşük sınırları kaldırın. Uygulamanız 8.192 gibi bir değeri sabit kodlamışsa, varsayılan senkron sınır olan 65.536'ya yükseltin.
- Seviyeyi düşürün, sınırı değil. Maliyeti veya gecikmeyi azaltmak için
max_output_tokens'ı küçültmek yerinemediumveyalowseviyesine inin. - Uzun işler için arka plana geçin. 65.536 token'ın üzerindeki yanıtlar için
backgrounddeğerinitruevemax_output_tokensdeğerini girişinizi çıkardıktan sonra kalan 1.048.576'ya kadar ayarlayın. Giriş, düşünme ve çıkış tek bir 1M token'lık pencereyi paylaşır. Gemini 4 Argon uzun çıkış kılavuzumuz yoklama düzenini adım adım anlatıyor.
Kodlama ajanınızın dört seviyeyi de Apidog CLI ile kıyaslamasına izin verin
O döngüyü elle yeniden çalıştırmak can sıkıcı hale gelir. Bunun yerine kodlama ajanınızın (Claude Code, Codex, Cursor) Apidog CLI ile yeniden kullanılabilir tek bir test oluşturmasına ve her yeni sayı istediğinizde her seviyede yeniden çalıştırmasına izin verin.
Bir kez kurun:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ardından ajanınıza tek bir ipucu verin:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
Ajan her yük şemasını okur, JSON'unu doğrular, kaynakları yazar ve çalıştırmayı döngüye alır:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
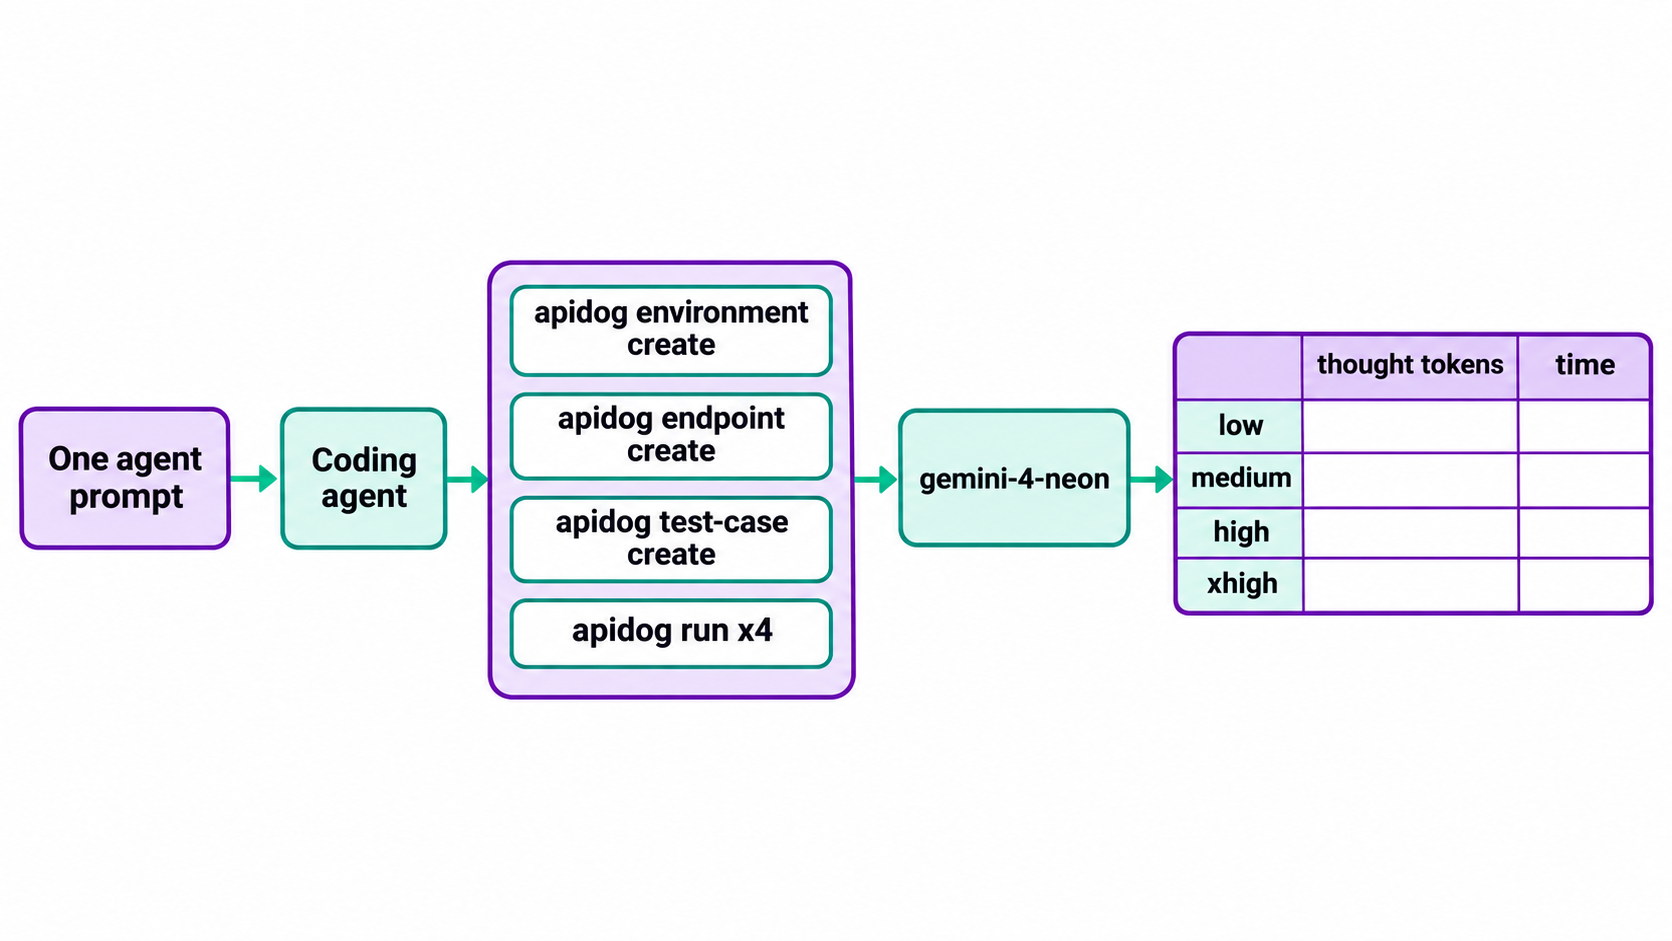
status is "completed" doğrulaması, önceki bölümdeki incomplete tuzağını yakalar; böylece bütçesi tükenen bir seviye boş bir dize döndürmek yerine yüksek sesle başarısız olur. -r cli,json ifadesini -r junit ile değiştirin ve aynı çalıştırma CI'ya girer; Apidog CLI CI/CD kılavuzu iş akışını gösterir, Claude Code'da Apidog CLI ise ajan kurulumunu ele alır. Apidog'un Ücretsiz planı 4 kullanıcıya kadar kapsar.
SSS
Gemini 4 Neon için varsayılan düşünme seviyesi nedir? high. Bunu elde etmek için thinking_level göndermenize gerek yok. Carbon ve Argon varsayılan olarak medium kullanır; bu yüzden onlardan geçiş yaparken seviyeyi açıkça belirtin.
Gemini 4 Neon minimal düşünmeyi destekliyor mu? Hayır. Neon low, medium, high ve xhigh seviyelerini destekler ve minimal değerini bir hatayla reddeder. En hızlı ve en ucuz yanıtlar için low kullanın.
Gemini 4 Neon'da düşünme token'ları faturalandırılıyor mu? Evet. Düşünme token'ları 1M çıkış başına $15,00 ücretiyle faturalandırılır. Google, modelin işlediği her token'ı, düşünme token'ları dahil, sayar.
Gemini 4 Neon ile thinkingBudget'ı hâlâ kullanabilir miyim? Gemini 4 modellerinde kullanımdan kaldırılmıştır. Tek başına gönderildiğinde en yakın thinkingLevel değerine eşlenir ve bir uyarı döndürür. thinkingLevel ile birlikte gönderildiğinde istek 400 ile başarısız olur.
xhigh her zaman high'dan daha doğru mudur? Her zaman değil. Google, xhigh'ın metin veya JSON çıkarma gibi basit ipuçlarında aşırı düşünebileceğini ve max_output_tokens'ı tüketebileceğini belirtiyor. Her ikisini de kendi ipuçlarınızda test edin ve geçen en düşük seviyeyi koruyun.
Gemini 4 Neon düşünme seviyelerini ücretsiz kullanabilir miyim? Hayır. Gemini 4 Neon, Gemini API ücretsiz katmanında mevcut değildir. Google AI Studio ve Google Antigravity'de ücretli Google AI Pro ve Ultra planlarına bağlıdır.