
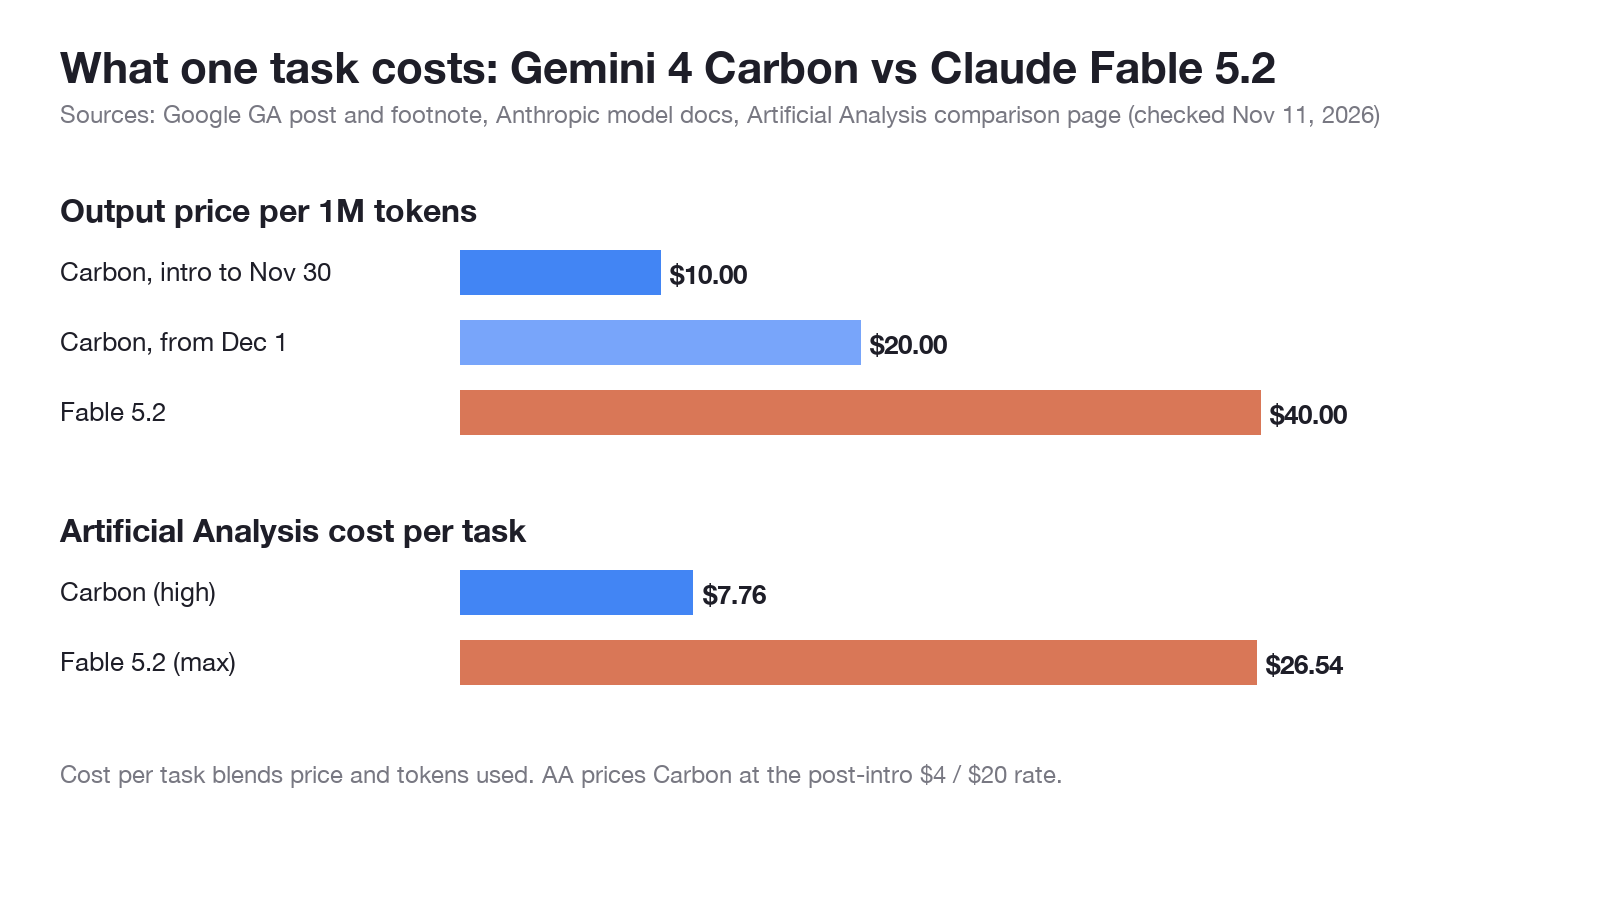
11 Kasım 2026 itibarıyla Google'ın Gemini 4 Carbon modeli daha ucuz, Claude Fable 5.2 ise yayınlanmış kodlama ve ajan kıyaslamalarının çoğunda daha güçlü model durumunda. Carbon, 30 Kasım'a kadar 1M giriş/çıkış tokenı başına 2 $ / 10 $ (sonrasında 4 $ / 20 $), Fable 5.2 ise 8 $ / 40 $ fiyatlandırılıyor; Artificial Analysis, görev başına maliyeti 7,76 $ ile 26,54 $ olarak hesaplıyor.
İkisi bir gün arayla piyasaya çıktı (Fable 5.2, 9 Kasım; Carbon GA, 10 Kasım) ve her satıcının tablosu kendi modelini avantajlı gösteriyor. Bu rehber her sayıyı kimin ölçtüğüne göre ayırıyor, ardından kendi istekleriniz üzerinde ikisini nasıl A/B testine sokacağınızı gösteriyor.
Gemini 4 Carbon vs Claude Fable 5.2: hızlı değerlendirme
Görev başına maliyet en önemli konuysa, iş otomasyonu akışları veya güvenlik çalışmaları için Gemini 4 Carbon'u seçin. Zor kodlama, terminal ve bilgisayar kullanımı görevlerinde en yüksek skoru istiyorsanız ve görev başına yaklaşık 3,4 kat daha fazla ödeyebiliyorsanız Claude Fable 5.2'yi seçin. Günlük mühendislik işleri için her iki satıcı da önce daha ucuz bir varsayılan modele yönlendiriyor.
Google'ın GA duyurusu "Argon, yazılım mühendisliği ve bilgi işlerinin çoğunluğu için hâlâ ideal seçim" diyor ve Carbon'u, keşfetme ve doğrulama için daha fazla token harcadığı zor görevlere konumlandırıyor. Anthropic'in model dokümantasyonu da aynı şeyi kendi ifadeleriyle söylüyor: çoğu iş yükü için Claude Opus 5.5 ile başlayın ve zorlayıcı akıl yürütme ile uzun vadeli ajan işleri için Fable 5.2'ye geçin.
Yani varsayılanınız yetersiz kaldığında ikisinden birine başvurursunuz. Hâlâ bir varsayılan mı seçiyorsunuz? Önce Gemini 4 Carbon vs Argon yazısını okuyun.
Gemini 4 Carbon ile Claude Fable 5.2 fiyat ve özellikler açısından nasıl kıyaslanır?
Her satıcının yayınladığı bilgiler, her satırın kaynağıyla birlikte aşağıda.
| Özellik | Gemini 4 Carbon | Claude Fable 5.2 | Kaynak |
|---|---|---|---|
| Model kimliği | gemini-4-carbon |
claude-fable-5-2 |
Google, Anthropic |
| Yayın tarihi | GA 10 Kasım 2026 | 9 Kasım 2026 | Google, Anthropic |
| 1M token başına giriş fiyatı | 30 Kasım'a kadar 2 $, sonrasında 4 $ | 8 $ (hızlı modda 16 $) | Google dipnotu, Anthropic |
| 1M token başına çıkış fiyatı | 30 Kasım'a kadar 10 $, sonrasında 20 $ | 40 $ (hızlı modda 80 $) | Google dipnotu, Anthropic |
| Bağlam penceresi | 1M token | 1M token | AI Studio model kartı, Anthropic dokümanları |
| Maksimum çıkış | 65K / listelenen 1M [DOĞRULAYIN] | 128K token | AI Studio model kartı, Anthropic dokümanları |
| Düşünme | Yapılandırılabilir düşünme düzeyi | Uyarlanabilir, her zaman açık, varsayılan çaba high |
Google hızlı başlangıç, Anthropic dokümanları |
| Nereden erişilir | Gemini API ücretli katmanı, AI Studio, Android Studio, Gemini for business, Antigravity, CodeMender, Google AI Ultra | Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure | Google, Anthropic |
| Ücretsiz API katmanı | Belirtilmemiş | Belirtilmemiş | Google, Anthropic |
Google'ın GA duyurusu Vertex AI, Gemini CLI veya GitHub Copilot'tan bahsetmiyor, bu yüzden henüz bunlara göre plan yapmayın. Carbon'un tanıtım fiyatı Argon'unkiyle aynı; bu da Kasım ayını değerlendirmenizi yapmak için en ucuz ay yapıyor.
Tam fiyat listeleri için Claude Fable 5.2 fiyatlandırması ve Google'ın Gemini 4 Carbon duyurusuna bakın.
Kıyaslamalarda hangi model önde?
Kimin tablosunu okuduğunuza bağlı, bu yüzden üç tabloyu birbirinden ayrı tutuyoruz.
Anthropic'in tablosu (Fable 5.2 ile birlikte yayınlandı)
Anthropic'in Fable 5.2 lansman yazısı bir Gemini 4 Carbon sütunu içeriyor. Sayfa, Carbon sayılarını kimin çalıştırdığını belirtmiyor, bu yüzden bunları satıcı tarafından raporlanmış olarak değerlendirin.
| Kıyaslama (Anthropic'in tablosu) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | %69,9 | %61,2 |
| FrontierCode 2.0 | %49,1 (xhigh çaba) | %41,1 (medium çaba) |
| Terminal-Bench-Science 0.1 | %74,6 | %64,8 |
| OSWorld 2.1 (çevrimdışı set, kısmi) | %89,3 | %81,5 |
| AA-Briefcase v1.1 (rubrik) | %66,1 | %61,8 |
| Chartography (araçsız) | %73,4 | %72,5 |
| AutomationBench | %51,4 | %53,9 |
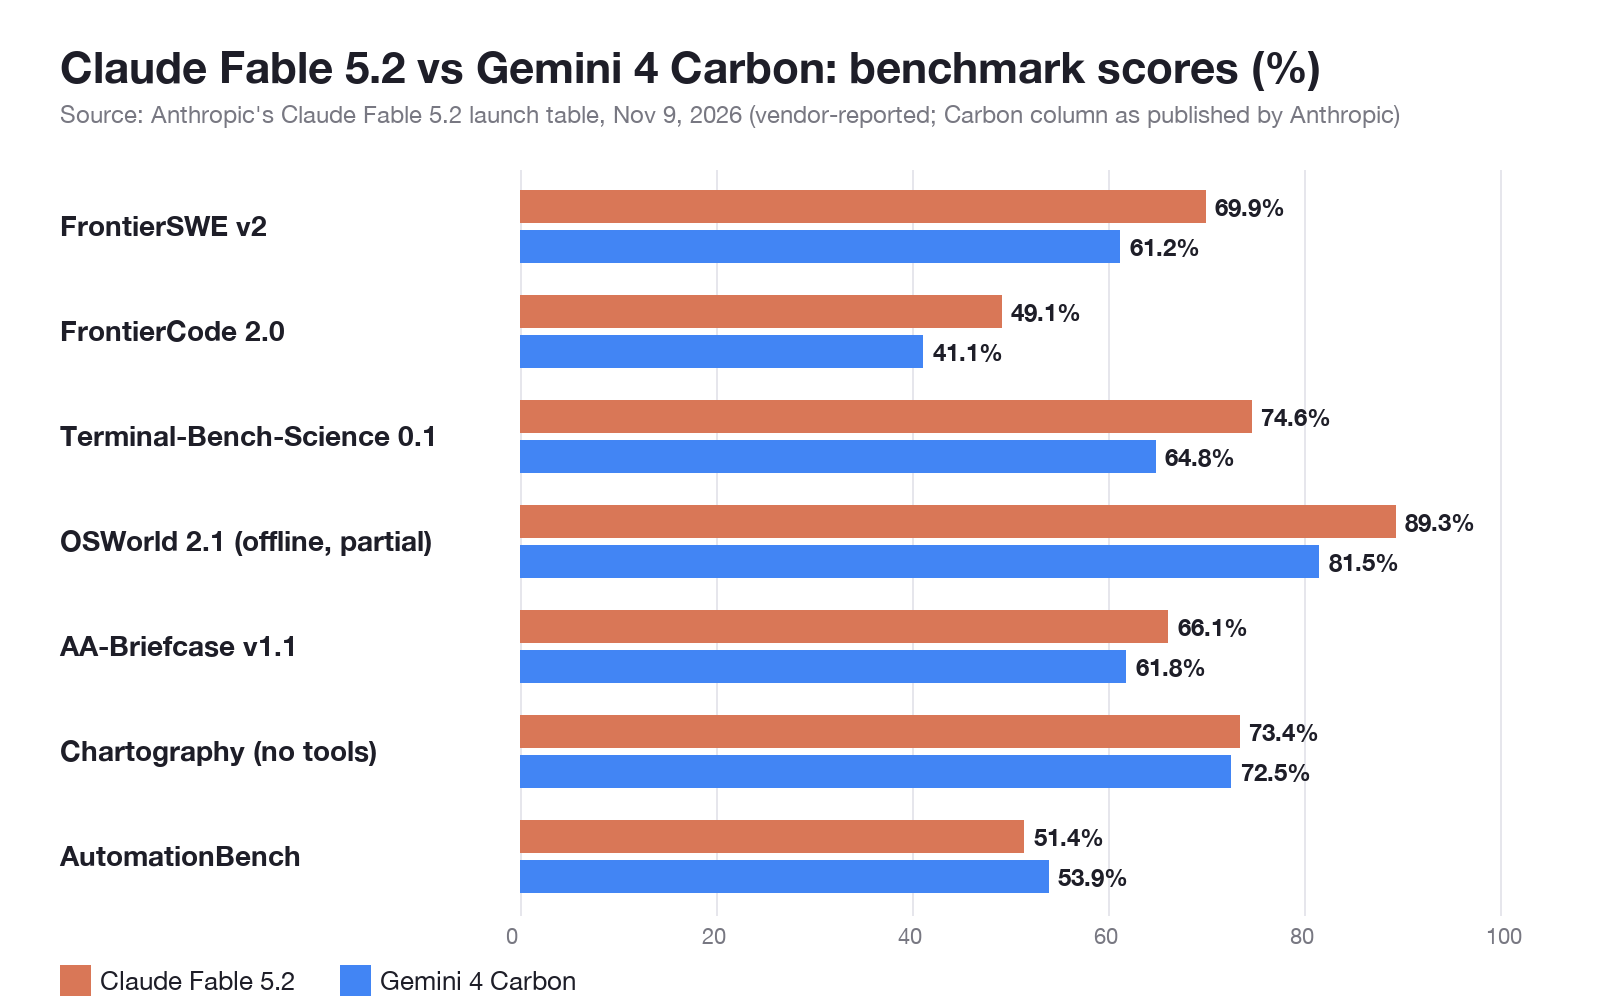
FrontierCode satırına dikkat: Fable xhigh çabada, Carbon medium çabada çalıştırılmış. Ayarlardaki bu fark, skorlardaki fark kadar önemli.
Google'ın tablosu (Carbon GA ile birlikte yayınlandı)
Google, Fable 5.2 ile doğrudan bir karşılaştırma yayınlamıyor. Bunun yerine partner sıralamalarını raporluyor: Carbon, "en iyi harici modele kıyasla görev başına 2X'ten fazla düşük maliyetle" CursorBench 4.0, Perplexity'nin WANDR'ı ve Zapier'in AutomationBench'inde birinci sırada. Multimodal Knowledge Agent kıyaslamasında ise zirvedeki modele göre görev başına ortalama 6 katından fazla düşük maliyetle ikinci sırada. Google bu iddialarında rakip modelleri isimlendirmiyor.
Artificial Analysis (bağımsız)
Artificial Analysis karşılaştırma sayfası, her iki modeli de aynı Intelligence Index v5.0.1'den geçiriyor:
| Metrik (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| Intelligence Index | 65 | 60 |
| Görev başına maliyet | 26,54 $ | 7,76 $ |
| Tüm indeksin çalıştırma maliyeti | 22.191 $ | 8.240 $ |
| Çıkış hızı | 103 token/s | 82 token/s |
Fable 5.2 (max), o indekste bugün zirvede. Carbon, görev başına maliyetin yaklaşık %29'u karşılığında 5 puan düşük skor alıyor. Artificial Analysis, Carbon'u 4 $ / 20 $, yani Kasım sonrası fiyatla değerlendiriyor; yani maliyet rakamları zaten Aralık fiyatını yansıtıyor.
Claude Fable 5.2 nerede önde?
Fable 5.2, Anthropic'in rakamlarına göre en zor kodlama ve bilgisayar kullanımı görevlerinde önde:
- Depo ölçeğinde kodlama: FrontierSWE v2'de %69,9'a karşı %61,2.
- Terminal ve araştırma işleri: Terminal-Bench-Science 0.1'de %74,6'ya karşı %64,8.
- Bilgisayar kullanımı: OSWorld 2.1'de %89,3'e karşı %81,5.
- Bağımsız indeks: Artificial Analysis'te 65'e karşı 60 — hiçbir satıcının çalıştırmadığı tek skor.
- Çıkış uzunluğu: istek başına belgelenmiş 128K maksimum çıkış.
Başarısız bir görev bir mühendisin öğleden sonrasına mal oluyorsa, FrontierSWE'de 8 puanlık bir kazanım token faturasını aşabilir. Kurulum için Claude Fable 5.2 API rehberine bakın.
Gemini 4 Carbon nerede önde?
Carbon, görev başına maliyette ve Google'ın onu geliştirdiği iş yüklerinde önde:
- Görev başına maliyet: Artificial Analysis'te 7,76 $'a karşı 26,54 $ — yaklaşık 3,4 kat daha ucuz.
- İş otomasyonu: AutomationBench'te %53,9'a karşı %51,4 — Anthropic'in kendi tablosunda.
- Güvenlik: Google'a göre SEC-bench Pro, ExploitGym ve CWE-bench v1'de önde; ayrıca Fairwind Programı üzerinden savunmacılar için kısıtlı erişimli bir siber güvenlik Carbon modeli.
- Kasım fiyatı: 30 Kasım'a kadar 2 $ / 10 $ — giriş ve çıkışta Fable'ın fiyatının çeyreği.
- Ajan ekipleri: Google Antigravity'deki /swarm önizlemesi tek bir istemi koordineli bir ekibe dönüştürüyor; Carbon planlama ve denetim yaparken daha hafif modeller paralel çalışıyor.
Modele yeni mi başlıyorsunuz? Gemini 4 Carbon nedir yazısıyla başlayın.
Bir görev aslında ne kadar tutuyor?
Liste fiyatı size tarifeyi söyler, faturayı değil. Bir görevin maliyeti, fiyat ile modelin harcamayı seçtiği token sayısının çarpımıdır ve Google, Carbon'un keşfetme ve doğrulama için daha fazla token harcadığını söylüyor.
50.000 giriş tokenı ve 10.000 çıkış tokenı içeren tek bir istek ele alalım:
- Carbon, tanıtım fiyatı: (0,05 x 2 $) + (0,01 x 10 $) = 0,20 $
- Carbon, 1 Aralık'tan itibaren: (0,05 x 4 $) + (0,01 x 20 $) = 0,40 $
- Fable 5.2: (0,05 x 8 $) + (0,01 x 40 $) = 0,80 $
Bu hesap, ikisinin de 10.000 token ürettiğini varsayar. Ama üretmeyecekler. Carbon, Fable'ın 10.000 token yazdığı yerde 30.000 token akıl yürütme yazarsa, Carbon'un Aralık maliyeti 0,80 $'a çıkar ve fark kapanır. Artificial Analysis, tüm test paketi boyunca gerçek durumu ölçtü ve yine de Carbon'u görev başına yaklaşık 3,4 kat daha ucuz buldu — kendi ölçümünüzü yapana kadar elinizdeki en güçlü sinyal bu.
Gemini 4 Carbon ve Claude Fable 5.2'yi kendi isteklerinizde nasıl A/B testine sokarsınız?
Kıyaslamalar başkalarının görevleridir. Adil test, aynı istemi her iki API'ye gönderip token ve gecikmeyi yan yana kaydetmektir.
Her iki çağrı da düz HTTP'dir. İşte Carbon'un isteği — Google'ın Interactions API hızlı başlangıcından derlendi, model adı bir değişkende:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2 ise Anthropic'in Messages API'sinden, model olarak claude-fable-5-2 ile geçer.
A/B testini kodlama ajanınıza Apidog CLI ile koşturun
İstek çiftlerini elle çalıştırmak hızla sıkıcılaşır. Bunun yerine Claude Code, Codex veya Cursor'a Apidog CLI'yı kullandırın. Kurulum üç komut alıyor:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sonra ajanınıza tek bir istem verin:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
Ajan şemayı kontrol eder, senaryoları yazar ve çalıştırır. Aşağıdaki bayraklar CLI 2.2.12'deki apidog run --help çıktısından alındı:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5, her senaryoyu beş kez tekrarlar; böylece tek bir yavaş yanıt sonucu belirlemez. Çalıştırmaları Apidog uygulamasında görmek için --upload-report ekleyin. Bu bir iş akışı şablonudur; Carbon'a karşı bu makineden çalıştırmadık. Claude Code'da Apidog CLI rehberi ajan kurulumunu, Gemini 4 Argon API rehberi ise Gemini istek tarafını ele alıyor.
Apidog'un Ücretsiz planı 4 kullanıcıya kadar kapsıyor; bu karşılaştırmayı çalıştırmak için yeterli.
SSS
Gemini 4 Carbon, Claude Fable 5.2'den daha mı iyi?
Her alanda değil. Fable 5.2, Anthropic'in kıyaslamalarının çoğunda ve Artificial Analysis indeksinde (65'e karşı 60) daha yüksek skor alıyor. Carbon ise görev başına maliyette (7,76 $'a karşı 26,54 $) ve AutomationBench'te önde.
Gemini 4 Carbon, Claude Fable 5.2'den ne kadar daha ucuz?
Liste fiyatında Carbon, 30 Kasım 2026'ya kadar 4 kat (1M token başına 2 $ / 10 $ ile 8 $ / 40 $), 1 Aralık'tan itibaren 2 kat daha ucuz (4 $ / 20 $). Artificial Analysis'ın görev başına ölçümünde yaklaşık 3,4 kat daha ucuz.
Her iki modelin de 1M token bağlam penceresi var mı?
Evet. Google'ın AI Studio model kartı Carbon için 1M token, Anthropic'in dokümanları Fable 5.2 için 1M token listeliyor. Fable'ın maksimum çıkışı 128K token; Carbon'un tam çıkış sınırı için Google'ın geliştirici rehberine bakın.
Gemini 4 Carbon veya Claude Fable 5.2 için API'de ücretsiz bir katman var mı?
Hiçbir satıcı bir ücretsiz katman belirtmiyor. Carbon, Gemini API ücretli katmanında ve Google AI Ultra uygulamalarında yer alıyor; Fable 5.2 ise token başına faturalandırılıyor.
Varsayılan modelimi ikisinden birine değiştirmeli miyim?
Large muhtemelen hayır. Google, çoğu yazılım mühendisliği ve bilgi işi için Argon'un doğru seçim olmaya devam ettiğini söylüyor; Anthropic de çoğu iş yükü için Opus 5.5'i öneriyor. Yalnızca varsayılanınızın başaramadığı görevleri Carbon veya Fable'a yönlendirin, sonra sonuçları kendi istekleriniz üzerinde kıyaslayın.