
Henüz herkese açık bir Gemini 4 Argon API'si yok ve Google bir model kimliği yayınlamadı. Google, Argon'u 30 Eylül 2026'da duyurdu ve bugün itibarıyla sadece Fairwind Programı savunucularına sunuluyor: bazı Fairwind ortakları onu Gemini Enterprise üzerinde yönetilen bir model olarak kullanıyor. Artificial Analysis, Argon'un tek API sağlayıcısı olarak Google AI Studio'yu listeliyor, ancak hız veya gecikme verisi bulunmuyor, bu da kaydolabileceğiniz bir uç nokta yerine izin verilen ön-sürüm erişimine uygun. Google, daha geniş kapsamlı dağıtım başladığında "ücretli API müşterileri ve Google AI Ultra aboneleriyle" başlayacağını söylüyor, bu nedenle ücretli bir Gemini API anahtarı sizi ilk sıraya koyar.
Duyuru ile erişim arasındaki bu boşluk, kullanabileceğiniz bir zamandır. Bu kılavuz, Google'ın Argon API hakkında doğruladıklarını doğrulamadıklarından ayırır, ardından Argon'a geçişin tek değişkenli bir değişiklik haline gelmesi için bugün Gemini 3.8 Flash üzerinde çalıştırabileceğiniz kodları açıklar. İsteği oluşturacak, bir yayın alarmı kuracak, yanıtı Apidog'da taklit edecek ve Argon'un fiyatlarıyla bir maliyet tavanı ekleyeceksiniz. Modelin kendisi için, Gemini 4 Argon'un ne olduğuna bakın; dağıtım aşamaları için ise Gemini 4 Argon çıkış tarihi kılavuzuna göz atın.
Gemini 4 Argon API hakkında doğrulananlar ve doğrulanmayanlar
Google'ın lansman yazısı fiyatları ve bir çıktı sınırını veriyor. Bir entegrasyonun ihtiyaç duyduğu hemen hemen her şey henüz yayınlanmadı.
| Öğe | Durum | Detay |
|---|---|---|
| Giriş fiyatı | Doğrulandı | 1M token başına 2$ (giriş), giriş süresi sonrası 4$ |
| Çıktı fiyatı | Doğrulandı | 1M token başına 10$ (giriş), sonra 20$ |
| Önbelleğe alınmış giriş | Doğrulandı | Girişte %95 indirim: giriş için 0,10$, standart 0,20$ |
| Çıktı limiti | Doğrulandı | 64K'dan 1M token'a yükseltildi |
| API yüzeyi | Sinyal Verildi | Google'ın belgeleri tüm yeni modellerin Interactions API'de başlatılacağını söylüyor |
| Model ID'si | Yayınlanmadı | Modeller sayfasında, fiyatlandırma sayfasında ve değişiklik günlüğünde yok |
| Giriş bağlam penceresi | Yayınlanmadı | Google'ın uzun bağlam değerlendirmesi 1M token'a kadar istemler kullandı, ancak bu bir spesifikasyon değil |
| Düşünme seviyeleri | Yayınlanmadı | Değerlendirmeler "en yüksek düşünme ayarlarında" çalıştı; adları ve varsayılanları bilinmiyor |
| Oran limitleri | Yayınlanmadı | Seviyeler açıklanmadı |
| Toplu destek | Yayınlanmadı | Toplu veya Esnek fiyatlandırma yok |
| Uzun istem seviyesi | Yayınlanmadı | 3.1 Pro, 200K'nın üzerinde daha fazla ücret alır; Argon'un kuralı belirtilmemiştir |
| Giriş süresi uzunluğu | Yayınlanmadı | 2$/10$ için bitiş tarihi yok |
İki satır daha yakından incelenmeyi hak ediyor. API yüzey satırı, yeni modellerin "Interactions API'de başlatılacağını" belirten Interactions API belgelerinden geliyor. Argon yeni bir model, bu yüzden ilk olarak orada bekleyin; Google generateContent'in onu sunup sunmayacağını söylemedi. Çıktı satırı, Google'ın model için belirttiği sınırdır, ancak Vals AI, test ettiği yapılandırma için maksimum 262K çıktı listeledi, bu yüzden her uç noktanın ilk günden itibaren tam bir milyon sunacağını varsaymayın. 1M çıktı tokenleri kılavuzumuz, bu sınırın akış, zaman aşımları ve depolama üzerinde ne gibi etkileri olduğunu ele alıyor.
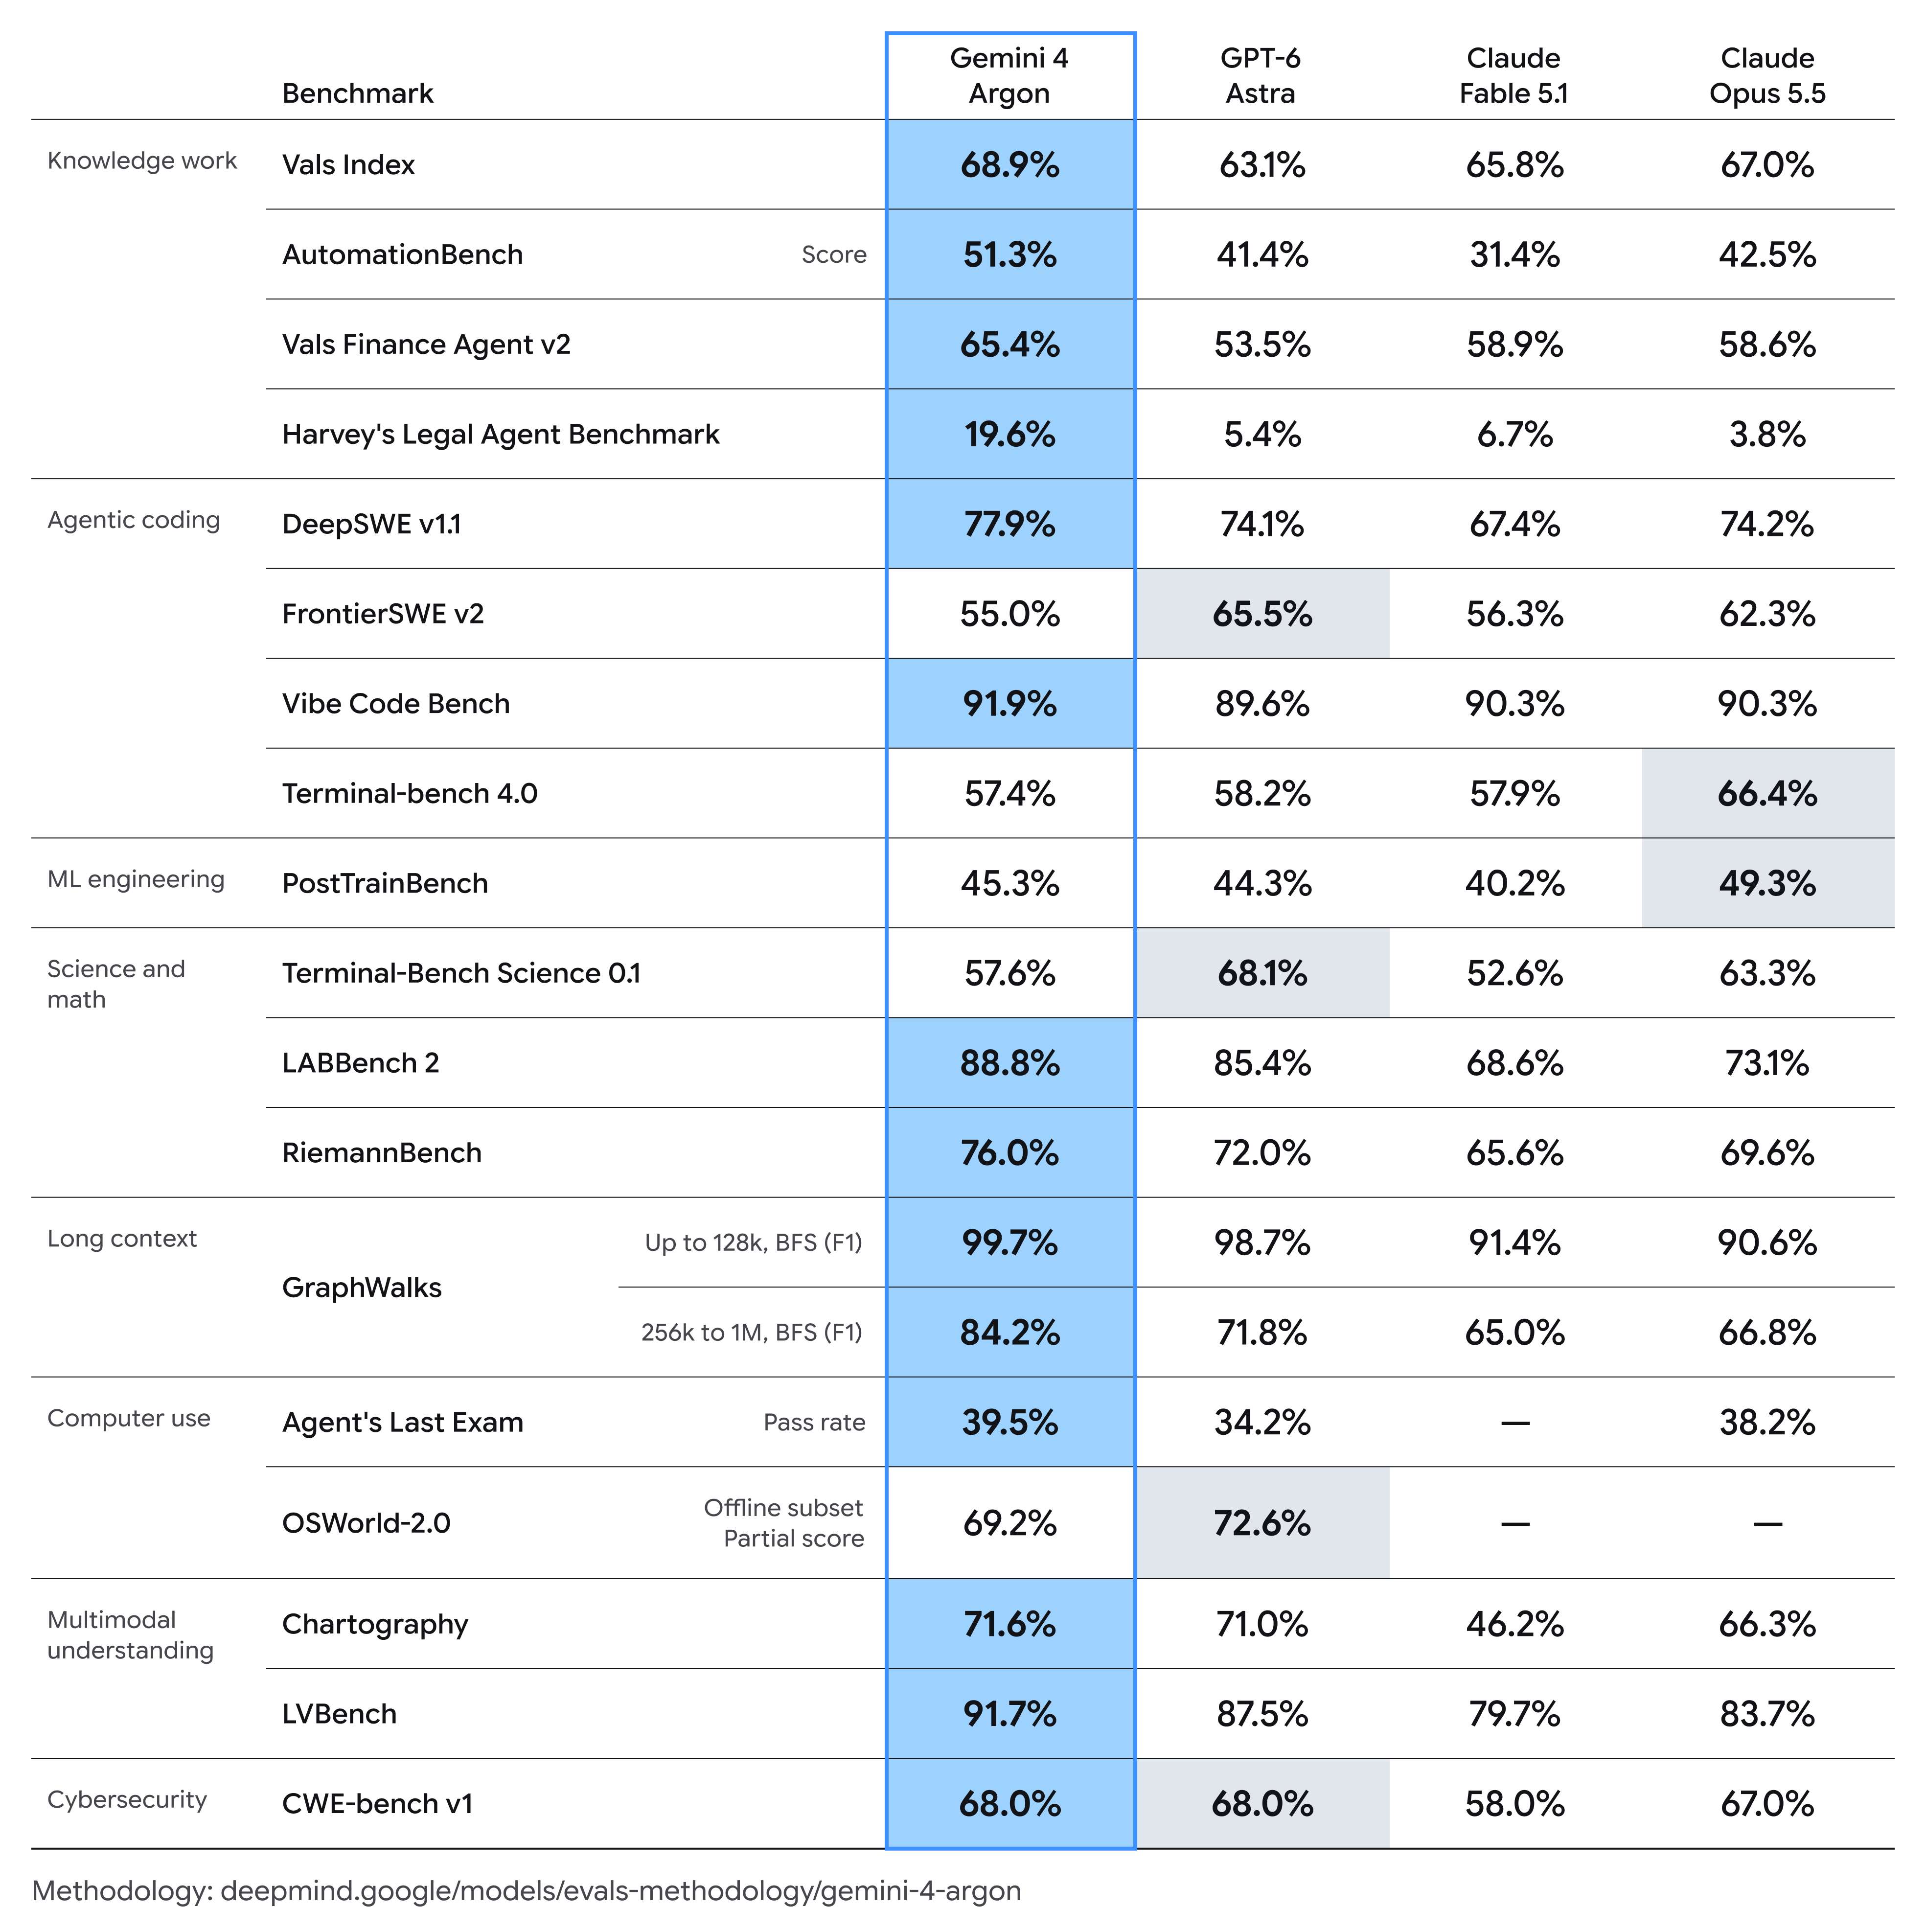
Fiyat konusunda, burada bir paragraf yeterli. 20.000 tokenlik bir istem ve 5.000 çıktı tokeni içeren bir istek, giriş fiyatlarıyla 20.000 x 2$/1M + 5.000 x 10$/1M = 0,04$ + 0,05$ = 0,09$ tutarındadır ve standart 4$/20$ fiyatlarla 0,18$ olur. Argon'un giriş çıktı fiyatı (10$), Gemini 3.1 Pro Preview'ın 12$'ının altındadır ve standart fiyatı Claude Opus 5.5 ile tamamen eşleşir. Gemini 4 Argon fiyatlandırma dökümü, önbelleğe alınmış giriş ve maksimum 1M tokenlik yanıt dahil olmak üzere tüm senaryoları kapsar.
Çevrimiçi bulduğunuz bir model kimliğini koda sabit kodlamayın
Argon model kimliğini aradığınızda, karşılaştırma sitelerinde, toplayıcılarda ve açık kaynaklı pull request'lerde dizeler bulacaksınız. Bunlar yer tutuculardır. Vals AI, model sayfası için kendi slug'ını kullanır, bir GitHub pull request'i bir kimliği "geçici olarak" ekler ve OpenRouter tarzı yol, bulunamadı sayfasına çıkarır. Google bunların hiçbirini doğrulamadı ve birçok kaynak tahminleri sabit kodlamaya karşı açıkça uyarıyor.
Tahmini bir kimlik en az yararlı şekilde başarısız olur: dağıtım gününde üretimde bir 404 hatası veya sarmalayıcınız hataları çok geniş bir şekilde yakalarsa sessiz bir geri dönüş. Bunun yerine model adını yapılandırmada tutun. Aşağıdaki her örnekte, model varsayılan olarak bugün arayabileceğiniz kararlı bir model olan `gemini-3.8-flash` olan `GEMINI_MODEL` ortam değişkeninden gelir. Google, Argon'un kimliğini yayınladığında, tek bir değeri değiştirirsiniz.
Kodunuzu Gemini 3.8 Flash üzerinde hazır hale getirin
Gemini 3.8 Flash (`gemini-3.8-flash`), Argon'un kullanması beklenen aynı uç noktalar, başlıklar ve yanıt şekilleri üzerinde çalışır ve 31 Aralık 2026'ya kadar 1M token başına 0,75$/3,75$ fiyatla sunulur. Anahtarınız `GEMINI_API_KEY` içinde yaşar; asla koda yapıştırmayın. Tam kurulum, Gemini 3.8 Flash API kılavuzumuzda yer almaktadır.
Adım 1: Bir Interactions API isteği gönderin
Interactions API, Google'ın birincil API'sidir ve Haziran 2026'dan beri Genel Kullanıma açıktır. Hem modeli hem de düşünme seviyesini değişkenlerde tutun, çünkü Argon'un seviye adları yayınlanmadı.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"Bir REST istemcisinin HTTP 429 için uyması gereken yeniden deneme kurallarını listele.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
Python SDK'sı, Interactions API için `google-genai` 2.3.0 veya sonraki bir sürüme ihtiyaç duyar:
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # GEMINI_API_KEY'yi ortamdan okur
interaction = client.interactions.create(
    model=MODEL,
    input="Bir REST istemcisinin HTTP 429 için uyması gereken yeniden deneme kurallarını listele.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
3.8 Flash'ta geçerli seviyeler `low`, `medium` (varsayılan) ve `high`'dır; `minimal` HTTP 400 döndürür. Düşünme seviyeleri kılavuzumuz, ödünleşimleri açıklar. Çoklu tur çalışmaları için, önceki yanıtın ID'sini `previous_interaction_id` olarak geçirin ve sunucu tarafı depolamadan vazgeçmek için `store: false` gönderin.
Adım 2: generateContent yolunu çalışır durumda tutun
Mevcut kodların çoğu, Google'ın tamamen desteklendiğini belirttiği eski generateContent uç noktasını çağırır. İşte aynı istek:
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"Bir REST istemcisinin HTTP 429 için uyması gereken yeniden deneme kurallarını listele.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
Düşüncenin nerede yaşadığına dikkat edin: Interactions üzerinde `generation_config.thinking_level`, burada ise `generationConfig.thinkingConfig.thinkingLevel`. Eğer istemciniz ikisini de sarıyorsa, yeni modelleri varsayılan olarak Interactions üzerinden yönlendirin. Araç tanımları aynı özeni gerektirir; Gemini 3.8 Flash fonksiyon çağırma bölümüne bakın.
Adım 3: models.list ile bir yayın öncesi kontrolü planlayın
Değişiklik günlüğünü yenilemeyin. API'ye sorun. Modeller uç noktası, mevcut modelleri token limitleri ve desteklenen yöntemleriyle döndürür:
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # başarısız bir çalıştırma uyarıdır
Üretim uygulamanızın kullandığı anahtarla bunu cron'dan veya bir CI programından saatlik olarak çalıştırın. 1 Ekim 2026'da ücretli bir proje anahtarıyla bu çağrıyı çalıştırdığımızda, 61 model, `nextPageToken` yok ve "argon" içeren bir ad döndürmedi. Eşleştiği gün, giriş size üç şeyi birden söyleyecek: gerçek model adı, `outputTokenLimit`'in tam 1M olup olmadığı ve hangi yöntemlerin listelendiği.
Adım 4: Yanıtı taklit edin, böylece istemci erişimden önce oluşturulur
Argon'u tüketen kodu oluşturmak için Argon'a ihtiyacınız yok. Adım 2 isteğini Apidog'da `GEMINI_API_KEY` ve `GEMINI_MODEL` ortam değişkenleri olarak kaydedin, bir kez 3.8 Flash'a karşı gönderin ve gerçek yanıtı uç noktaya bir yanıt örneği olarak çıkarın. Apidog'un varsayılan Akıllı Taklit'i şemadan veri üretir, bu nedenle projenin varsayılan taklit yöntemini "Önce Yanıt örneği" (Proje Ayarları, Özellik Ayarları, Taklit Ayarları) olarak ayarlayın. Taklit URL'si daha sonra kaydedilmiş yanıtınızı döndürür, böylece ön uç, kuyruk çalışanları ve ayrıştırıcılarınız token harcamadan ona karşı çalışabilir.
Bu taklidin ne olduğu konusunda net olun: mevcut Gemini yanıt şeması, Argon'a özgü bir şema değil, çünkü Google böyle bir şey yayınlamadı. Argon'un aynı API'de beklendiği için bu hala doğru bir tahmindir. Yoğun bir Argon yanıtını prova etmek için, örneğin `usageMetadata`'sını büyük sayılara düzenleyin ve faturalandırma ile uyarı kodunuzun tepki verdiğini onaylayın.
Adım 5: usageMetadata ve bir maliyet tavanı üzerinde onaylama yapın
Her generateContent yanıtı `usageMetadata` içerir. Apidog'a, bir faturanın gelmesinden önce bir testin başarısız olması için her yanıtı Argon'un standart oranlarında fiyatlandıran bir işlem sonrası betik ekleyin:
// Apidog işlem sonrası: bu yanıtı Gemini 4 Argon'un standart oranlarında fiyatlandır
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // Giriş süresi sonrası giriş tokeni başına USD
const OUT = 20 / 1e6; // Çıktı tokeni başına USD; mevcut Gemini modellerinde düşünme çıktı olarak faturalandırılır
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata mevcut", () => pm.expect(u).to.be.an("object"));
pm.test("Argon oranlarında maliyet 0,10$'ın altında", () => pm.expect(cost).to.be.below(0.10));
Tavanı istek başına seçin; 0,10$ bunun gibi kısa bir istem için uygundur. Google, Argon'un düşünme tokenlerini nasıl faturalandırdığını belirtmedi, bu nedenle betik mevcut Gemini kuralını varsayar. Aynı kaydedilmiş isteği tutun ve şimdi 3.8 Flash'a, daha sonra Argon'a karşı çalıştırın: token sayılarındaki ve maliyetteki fark, regresyon karşılaştırmanızdır.
SSS
Gemini 4 Argon API'si mevcut mu? Herkese açık değil. Argon sadece Fairwind Programı ortaklarına sunuluyor, onlar da Gemini Enterprise aracılığıyla kullanıyor. Ücretli API müşterileri ve Google AI Ultra aboneleri daha sonra gelecek, bir tarih yok.
Gemini 4 Argon model kimliği nedir? Google henüz bir tane yayınlamadı. Üçüncü taraf sitelerdeki dizeler yer tutuculardır, bu yüzden modeli bir ortam değişkeninde tutun ve models.list'i izleyin.
Gemini 4 Argon API'si ne kadar maliyetli olacak? Belirtilmeyen bir giriş süresi boyunca 1M token başına 2$ giriş ve 10$ çıktı, sonra 4$ ve 20$. Önbelleğe alınmış giriş %95 indirimli. Gemini 4 Argon fiyatlandırmasına bakın.
Argon generateContent ile çalışacak mı? Google söylemedi. Belgeleri, tüm yeni modellerin Interactions API'de başlatılacağını belirtiyor, bu nedenle Interactions üzerine inşa edin ve generateContent'i bir yedek olarak ele alın.
Google AI Ultra bana API erişimi sağlıyor mu? Hayır. AI Ultra bir tüketici aboneliğidir, bir API anahtarı değil. Google, API erişiminin ücretli API müşterileriyle başladığını söylüyor.
Bir Sonraki Adımınız
Her ortamda `GEMINI_MODEL`'i ayarlayın, models.list kontrolünü planlayın ve Interactions ve generateContent isteklerini maliyet onayı eklenmiş olarak kaydedin. Bu istekleri, taklitleri ve testleri tek bir çalışma alanında tutmak için Apidog'u indirin, ardından Google kimliği yayınladığında tek bir değişkeni değiştirin.