DeepSeek, DeepSeek-V4.1-Flash için model kartını 10 Eylül 2026'da yayınladı ve rakamlar V4-Pro müşterileri için can sıkıcı. Daha küçük, daha ucuz model, DeepSeek'in listelediği her kodlama ve aracı benchmark'ında amiral gemisi modelden daha yüksek puan alıyor, token başına %70 ila %77 daha az maliyetli ve 14 Eylül'de V4-Pro'yu tamamen içine alıyor: her deepseek-v4-pro isteği V4.1-Flash'a yönlendirilecek ve Flash oranlarından faturalandırılacak.
Bu, olağan küçük-büyük değişimi değil. Bu, son tarihi olan bir karşılaştırma. Eğer üretimde V4-Pro kullanıyorsanız, yönlendirme gerçekleştiğinde neyin değişeceğini öğrenmek için dört gününüz var. Eğer V4-Flash kullanıyorsanız, değişiklik zaten oldu: deepseek-v4-flash adı bugün V4.1-Flash tarafından sunuluyor.
Aşağıda: mimari, DeepSeek'in bildirdiği benchmark'lar, USD fiyatlandırması ve verimlilik açısından her üç model, ardından çıktıları, gecikmeyi ve kullanım sayımlarını karşılaştırmak için geçiş öncesinde Apidog'da hem deepseek-v4-pro hem de deepseek-flash üzerinden bir istem kümesini çalıştırmak için bir iş akışı. Mimari derinlemesine inceleme için önce DeepSeek-V4.1-Flash nedir yazısını okuyun; geçiş kontrol listesi için V4-Pro emeklilik kılavuzuna bakın.
TL;DR
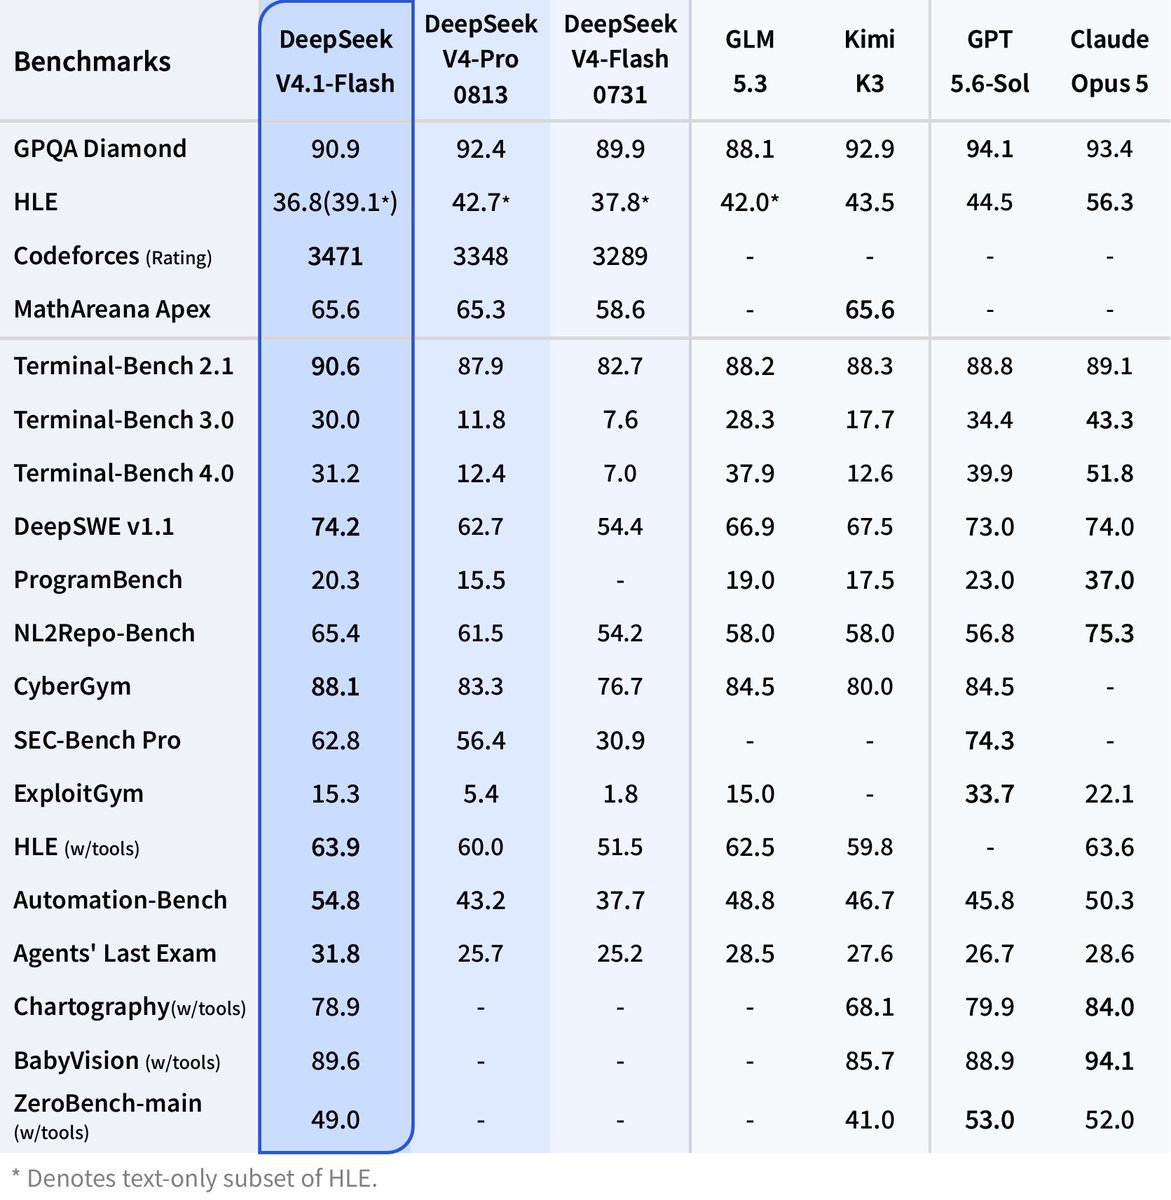
- V4.1-Flash, DeepSeek'in kendi benchmark'larında kazanıyor. DeepSWE v1.1 manşet: V4-Pro için 62.7 ve V4-Flash için 54.4'e karşı 74.2.
- Üçünün en ucuzu. Tepe önbellek-kaçırma girişi, V4-Pro için 1M token başına 1.32 dolara ve eski V4-Flash için 0.44 dolara karşı 0.30 dolar.
- Verimlilik için tasarlandı. Ön doldurmada 8 milyar aktif parametre, token başına 890 baytlık bir KV önbellek ve 2.500 eşzamanlılık sınırı.
- 14 Eylül'den sonra tek bir seçenek var. V4-Pro trafiği V4.1-Flash'a yönlendiriliyor. Sorun ne kazandığınız ve ne kaybettiğiniz, hangisini seçeceğiniz değil.
Özellikler yan yana
V4.1 jenerasyonu yeni bir mimari, yeniden eğitim sonrası bir sürüm değil. DeepSeek buna Nedensel Kodlayıcı-Çözücü (CED) diyor: 20 kodlayıcı ve 20 çözücü olmak üzere 40 katman, her katmanda 384 yönlendirilmiş uzman artı bir paylaşılan uzman. Model kartı ana yapıyı 552 milyar parametre (görsel kodlayıcı ile 763 milyar) olarak belirtiyor.
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| Mimari jenerasyonu | V4 MoE | V4 MoE | V4.1 Nedensel Kodlayıcı-Çözücü, 40 katman |
| Toplam parametreler | 284B (OpenRouter'ın görsel derlemenin listesi) | Burada açıklanmadı | 552B ana yapı, görsel kodlayıcı ile 763B |
| Aktif parametreler | 13B | Burada açıklanmadı | Ön doldurmada 8B, çözmede 16B |
| Bağlam penceresi | 1M token | 1M token | 1M token |
| Maksimum çıktı | 384K token | 384K token | 384K token |
| Görsel | Ayrı Vision-Exp derlemesi | Burada açıklanmadı | Doğal, DeepSeek-ViT kodlayıcı |
| Lisans | Burada ele alınmadı | Burada ele alınmadı | MIT, Hugging Face'te ağırlıklar |
| Eşzamanlılık sınırı | 2,500 | 500 | 2,500 |
| API durumu | Kullanımdan kaldırıldı, V4.1-Flash tarafından hizmet veriliyor | 14 Eylül'de V4.1-Flash'a yönlendirilecek | 10 Eylül'den beri GA, model kimliği deepseek-flash |
Dikkat edilmesi gereken ayrıntı, bölünmüş aktif parametre sayısıdır: V4-Flash her token için 13B kullanırken, V4.1-Flash girişte 8B ve kalitenin olduğu çıkışta 16B harcıyor.
Benchmark'lar: 11.5 puan nereden geliyor
Aşağıdaki her sayı DeepSeek tarafından model kartından rapor edilmiştir. Bağımsız çalışmalar yayınlanmamıştır ve emeklilik bildirimindeki "birden fazla tarafça yapılan testler" ifadesi bunları isimlendirmiyor. Bunları satıcı iddiaları olarak kabul edin ve kendi istemlerinizde doğrulayın.
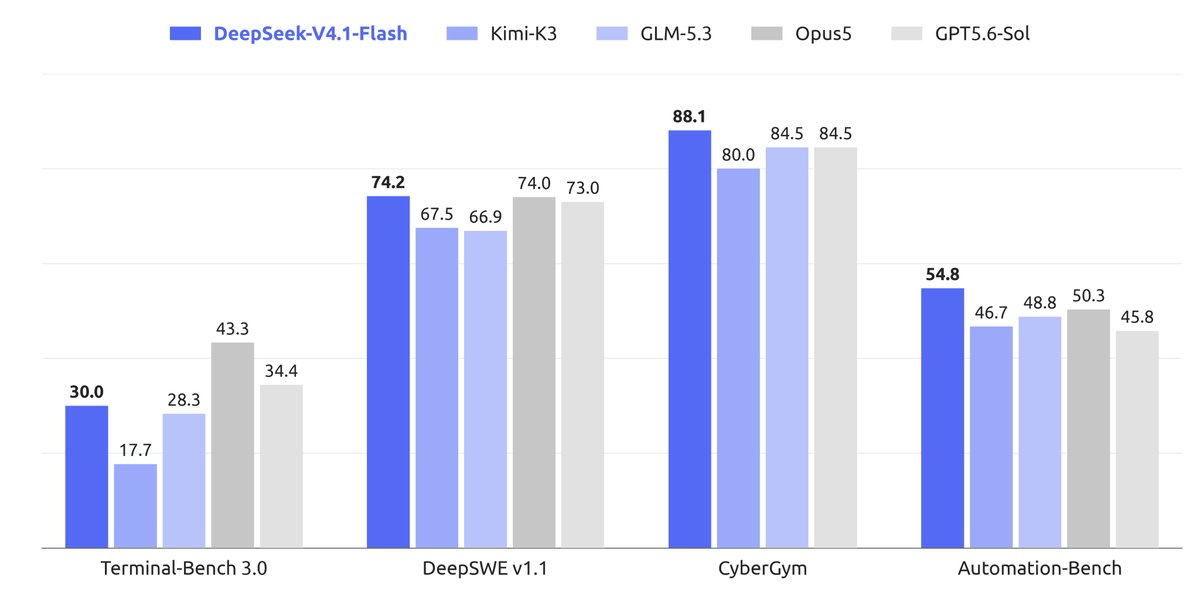
DeepSWE v1.1 (Pro'dan +11.5, V4-Flash'tan +19.8). Manşet, ve kararları değiştirecek kadar büyük tek fark. DeepSWE, çok dosyalı yazılım mühendisliği görevlerini ölçer; kodlama aracıların tüm gün boyunca yürüttüğü iş yükü. Eğer sizin repolarınızda da tutarsa, V4.1-Flash, dört kat daha pahalı olan modeli geride bırakıyor.
Terminal-Bench 2.1 (+2.7). Kabuk tabanlı aracı görevleri. V4-Flash-0731, Temmuz ayında V4-Pro-Preview'i burada zaten geçmişti; V4.1, liderliği üç puanın altına indiriyor. Gerçek, ama belirleyici değil.
HumanEval (+2.6) ve GSM8K (+0.4). Her ikisi de doygunluğa yakın: her model GSM8K'da 90'ı geçiyor ve HumanEval üretim kodu hakkında çok az şey söylüyor. Bu satırları fazla önemsemeyin.
MiniMax M3 vs DeepSeek V4 vs Qwen 3.7, V4 jenerasyonunun diğer açık modellerle karşılaştırmalı sayılarını içerir; hiçbiri henüz V4.1'i içermez.
Maliyet: üç model, altı fiyat kademesi
Tepe saatler Pazartesi'den Cuma'ya, 01:00 ile 04:00 ve 06:00 ile 10:00 UTC arasıdır; diğer tüm zamanlar yarı fiyatına yoğun olmayan saatlerdir. Oranlar, 10 Eylül'den itibaren geçerli olan fiyatlandırma sayfasından 1M token başına. V4-Flash satırları, "önceki" sütunu olarak 21 Ağustos 2026 USD oranlarını kullanır.
| Model ve kademe | Giriş, önbellek isabeti | Giriş, önbellek kaçırma | Çıktı |
|---|---|---|---|
| V4-Flash, yoğun olmayan (21 Ağustos oranları) | $0.007 | $0.22 | $0.66 |
| V4-Flash, yoğun (21 Ağustos oranları) | $0.014 | $0.44 | $1.32 |
| V4-Pro, yoğun olmayan | $0.022 | $0.66 | $1.98 |
| V4-Pro, yoğun | $0.044 | $1.32 | $3.96 |
| V4.1-Flash, yoğun olmayan | $0.003 | $0.15 | $0.60 |
| V4.1-Flash, yoğun | $0.006 | $0.30 | $1.20 |
V4-Flash'a kıyasla, V4.1 önbellek isabeti girişini yaklaşık %57, önbellek kaçırma girişini yaklaşık %32 ve çıktıyı yaklaşık %9 oranında azaltıyor. V4-Pro'ya kıyasla, tepe saatlerde önbellek kaçırma girişinde %77 ve çıktıda %70 indirim var.
Hesaplanan bir ay. Bir kodlama aracı, ayda 2 milyar giriş token'ı işlerken %70 önbellek isabet oranıyla (sistem istemi ve depo bağlamı dönüşler arasında yeniden kullanılır) ve 300 milyon çıkış token'ı üretirken, bunların hepsi tepe saatlerde gerçekleşir.
| V4-Pro, yoğun | V4-Flash, yoğun | V4.1-Flash, yoğun | V4.1-Flash, yoğun olmayan | |
|---|---|---|---|---|
| 1.4B önbellek isabetli giriş | $61.60 | $19.60 | $8.40 | $4.20 |
| 600M önbellek kaçırmalı giriş | $792.00 | $264.00 | $180.00 | $90.00 |
| 300M çıktı | $1,188.00 | $396.00 | $360.00 | $180.00 |
| Aylık toplam | $2,041.60 | $679.60 | $548.40 | $274.20 |
Bu, V4-Pro'dan %73 daha az ve toplu işleri yoğun olmayan saatlere taşımak maliyeti bir kez daha yarıya düşürüyor. Çıkış token'ları her sütuna hakim, bu nedenle %70'lik çıktı kesintisi, önbellek isabeti başlığından daha önemli. V4.1-Flash fiyatlandırma dökümü, önbellek isabeti matematiğini kapsıyor.
Hız ve verimlilik
DeepSeek saniye başına token rakamı yayınlamıyor, bu nedenle verimlilik hikayesi üç mimari gerçeğe ve bir anekdota dayanıyor.
- Token başına 890 baytlık KV önbellek. FP4 ana KV önbellekleme, genel önbelleği V4-Flash'ın kapladığı alanın yaklaşık dörtte birine düşürüyor. Sürüm notu, önceki neslin HBM'sinin 1/4'ü ve SSD depolamasının 1/8'i olduğunu belirtiyor. Tam 1 milyon token'lık bir bağlam için yaklaşık 0.9 GB önbellek gerekiyor.
- Ön doldurmada 8 milyar aktif parametre. V4-Flash'ın 13 milyarına kıyasla giriş token'ı başına daha az hesaplama, bu nedenle büyük bağlamlarda ilk token'a kadar geçen süre düşmeli.
- Eşzamanlılık 2.500'e karşı 500. Yönlendirilen V4-Pro trafiği, Flash sınırını miras alıyor, bu da aracı filoları için 5 kat kazanç sağlıyor.
- Bir kullanıcının raporu: "neredeyse 400 t/s". Bir X kullanıcısı bunu beta sırasındaki video testlerinden paylaştı; bu bir anekdot, benchmark değil. HN beta başlığı çoğunlukla aynı coşkuyu yansıtıyor.
Bunlardan herhangi birine güvenmeden önce kendi p50 ve p95 değerlerinizi ölçün.
14 Eylül'den sonra ne kaybeder ve kazanırsınız
Kesintiden sonra "hangi modeli seçmeliyim" diye bir şey yok. deepseek-v4-pro bir takma ad haline geliyor, bu yüzden dürüst çerçeveleme bir defterdir.
Kazançlarınız: listelenen her benchmark'ta daha yüksek puanlar, %70 ila %77 daha düşük tepe fiyatları, 5 kat eşzamanlılık, ayrı bir vizyon model kimliğine ihtiyaç duymadan doğal görüntü girişi ve DeepSeek'in 1'den 100'e kadar sürekli kontrol edilebilir olarak tanımladığı bir akıl yürütme çabası ayarı.
Kaybettikleriniz: bir V4 nesli kontrol noktasını sabitleme yeteneği. V4-Pro'nun stiline, ayrıntı düzeyine veya araç çağırma formatına göre ayarlanmış istemler kayabilir. Çıktı uzunluğu ve akıl yürütme token sayıları değişebilir, bu da faturalama tablosunun göstermediği şekillerde faturanızı değiştirir. Ve yeniden yönlendirme DeepSeek'in takviminde gerçekleşir, sizin değil.
Bu ikinci liste, 14'ünden önce değil, sonra farkları neden karşılaştırmanız gerektiğini açıklıyor.
Geçiş öncesi Apidog'da V4-Pro'yu V4.1-Flash ile karşılaştırın
Apidog API katmanını test eder, bu nedenle her iki model kimliği üzerinden bir istem kümesini çalıştırmak ve geri gelenleri karşılaştırmak için doğru yerdir.
- Uç noktayı ekleyin. Bir proje oluşturun ve
POST https://api.deepseek.com/chat/completionsekleyin veya bir OpenAPI spec içe aktarın. - Anahtarı ve model kimliğini ortamlara yerleştirin.
DEEPSEEK_API_KEYve birMODELdeğişkenini saklayın.MODEL=deepseek-v4-proile birv4-proveMODEL=deepseek-flashile birv41-flasholmak üzere iki ortam oluşturun ve bunları başlıktaBearer {{DEEPSEEK_API_KEY}}ve gövdede"model": "{{MODEL}}"olarak referans gösterin. - Gerçek istemlerinizi istek olarak kaydedin. Üretimi temsil eden 20 ila 30 istem seçin: sistem isteminiz, bir araç çağırma dönüşü, uzun bağlam özetleme, çok dosyalı kod düzenleme. Her birini
stream: falseile kaydedin, böyleceusagenesnesi yanıt gövdesine düşer. - Faturanızı değiştiren alanlar üzerinde onaylama yapın. Kaydedilen isteklerden bir test senaryosu oluşturun ve
usage.prompt_tokens,usage.completion_tokensveusage.prompt_cache_hit_tokensüzerinde onaylamalar ekleyin. Adım başına yanıt süresini kaydedin ve çalıştırmaların etiketlenmesi için ortam adını bir başlığa yazdıran bir ön istek betiği ekleyin. - Her ortam için bir kez çalıştırın, ardından farkları karşılaştırın. Senaryoyu
v4-proaltında, ardındanv41-flashaltında çalıştırın. Tamamlama token sayılarını (yönlendirme çıktı faturanızı değiştirir), adım başına gecikmeyi ve formatlama kayması için içeriğin kendisini karşılaştırın. - 14'ünde CI'da yeniden çalıştırın. Aynı senaryoyu
apidog-cliile geçiş sırasında pipeline'ınızda çalıştırın. Yönlendirmenin bozduğu her şey, bir destek bileti yerine başarısız bir onaylama olarak görünür.
Aynı karşılaştırma bir betik olarak:
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Ödeme hizmetindeki ödeme denemelerini idempotent yapın. Birleşik bir fark döndürün."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
Yoğun ve yoğun olmayan saatlerde çalıştırın ve çıktıları saklayın. Farkları, onaylamaları ve çalışma geçmişini tek bir yerde tutmak için Apidog'u indirin.
Sıkça Sorulan Sorular
V4.1-Flash kodlamada V4-Pro'dan daha mı iyi? DeepSeek'in bildirdiği rakamlara göre evet: DeepSWE v1.1'de 74.2'ye karşı 62.7 ve Terminal-Bench 2.1'de 90.6'ya karşı 87.9. V4 neslinin kodlama için Claude ile nasıl karşılaştırıldığına bakmak için Kodlama için DeepSeek V4 vs Claude Opus makalesine bakın.
V4-Pro entegrasyonuma 14 Eylül'de ne olacak? 04:00 UTC'den itibaren, her deepseek-v4-pro isteği V4.1-Flash tarafından karşılanacak ve Flash oranlarından faturalandırılacak. Kodunuz çalışmaya devam edecek; arkasındaki model değişecek. Geçiş kılavuzunda tam kontrol listesi bulunmaktadır.
deepseek-v4-flash adını deepseek-flash olarak değiştirmem gerekiyor mu? Bugün değil. deepseek-v4-flash ve deepseek-v4-flash-vision-exp hala kabul ediliyor ve V4.1-Flash tarafından sunuluyor. DeepSeek bir kaldırma tarihi vermedi, bu nedenle yapılandırmaya bir dahaki dokunuşunuzda deepseek-flash'e geçin.
V4.1-Flash, V4-Pro'dan daha mı hızlı? DeepSeek öyle söylüyor ama rakam yayınlamıyor. Mimari bu iddiayı destekliyor: ön doldurmada 8 milyar aktif parametre ve V4-Flash'ın dörtte biri büyüklüğünde bir KV önbellek. Kendi ölçümlerinizi yapın.
V4-Pro'yu hala bir yerde çalıştırabilir miyim? 14'ünden sonra DeepSeek'in API'sinde hayır. V4 neslinin geçmişi DeepSeek V4 Nedir makalesinde; V4.1-Flash ağırlıkları Hugging Face'te MIT lisansı altında bulunuyor.
Kısa versiyon
V4.1-Flash aynı anda daha küçük, daha ucuz ve daha yüksek puanlı, en azından satıcının tablosuna göre, ve bu tablo istemleriniz için daha iyi olup olmadığını söyleyemez. Bu hafta Apidog'da her iki model kimliğini aynı istem kümesi üzerinden çalıştırın, farkları saklayın ve kullanıcılarınızdan önce 14 Eylül'de neyin değişeceğini öğrenin.