
Claude Fable 5.2 vs Opus 5.5 karşılaştırmasında günlük kodlama ve bilgi işleri için Opus 5.5 ile başlayın. Zorlayıcı akıl yürütme, belirsiz migrations veya uzun agent projeleri Opus temelinizi aştığında Fable 5.2'yi deneyin. Tüm iş yükünüzü taşımadan önce effort ayarlarını ve kabul edilen sonuç başına maliyeti karşılaştırın.
Bu öneri, 10 Kasım 2026 tarihinde doğrulanan Anthropic'in Fable 5.2 duyurusunu temel alıyor. Bu, kaynaklara dayalı bir karşılaştırmadır; bağımsız bir başa baş benchmark çalıştırmadık. Daha önceki Opus 5 vs Fable 5 karşılaştırmamız eski nesli kapsıyor. Aşağıdaki fiyatlar, varsayılanlar ve kanıtlar bu yeni sürümler için geçerlidir.
Claude Fable 5.2 vs Opus 5.5: bir bakışta
| Karar noktası | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| Başlangıç rolü | Zorlayıcı akıl yürütme ve uzun agent işleri | Çoğu iş yükü için varsayılan |
| Claude API model kimliği | claude-fable-5-2 |
claude-opus-5-5 |
| Standart girdi, milyon token başına | $8 | $4 |
| Standart çıktı, milyon token başına | $40 | $20 |
| API varsayılan effort | High | Medium |
| Bağlam penceresi | 1M token | 1M token |
| Maksimum çıktı | 128K token | 128K token |
| Karşılaştırmalı gecikme etiketi | Orta | Orta |
Kaynak: güncel Claude modellerine genel bakış. Her iki model de metin ve görsel kabul eder, metin üretir, araçları destekler ve her zaman açık olan adaptive thinking kullanır. Bu nedenle daha büyük bir bağlam penceresi onları ayırt etmez. Onları ayırt eden şey, sizin belirli görevinizi tamamlama yetenekleridir.
Fable'ın standart token fiyatları, Opus'ununkilerin iki katı. Bu, her iki model de benzer token hacminde kabul kriterlerinizi karşıladığında Opus'u mantıklı bir başlangıç noktası yapar. Ancak akıl yürütme derinliği, yeniden denemeler ve araç çağrıları farklılaştığında hangisinin daha düşük fatura çıkaracağını göstermez.
Hangi kodlama görevleri Fable 5.2'ye geçmeyi hak eder?
Net kontrollere sahip, sınırlı değişiklikler için Opus'u kullanın. Agent'ın sorunu keşfetmesi, birbiriyle bağımlı birkaç değişikliği koordine etmesi veya başarısız olan bir yaklaşımdan kurtulması gerektiğinde Fable'ı test edin. Bunlar, Anthropic'in konumlandırmasından ve sonuçlarından çıkarılan iş yükü önerileridir; deponuz için ölçülmüş garantiler değildir.
| Göreviniz | Başlangıç seçimi | Yükseltmeyi hak eden kanıt |
|---|---|---|
| Belgelenmiş bir endpoint eklemek | Opus 5.5 | Tekrarlayan contract veya entegrasyon hataları |
| Küçük bir refactor sonrası testleri güncellemek | Opus 5.5 | Agent, değişen invariant'ı tespit edemiyor |
| Aralıklı görünen hizmetler arası bir hatayı ayıklamak | Opus, sonra Fable | Opus, rakip nedenleri test etmeden düzeltmeleri tekrarlıyor |
| Bağımlılıkları belirsiz bir hizmeti taşımak | İkisini de karşılaştırın | Fable, bütçe dahilinde daha fazla kabul edilen değişiklik tamamlıyor |
| Uzun bir teknik projeyi koordine etmek | Fable'ı deneme amaçlı kullanın | Daha iyi planlama, uygulama ve incelemeden sağ çıkıyor |
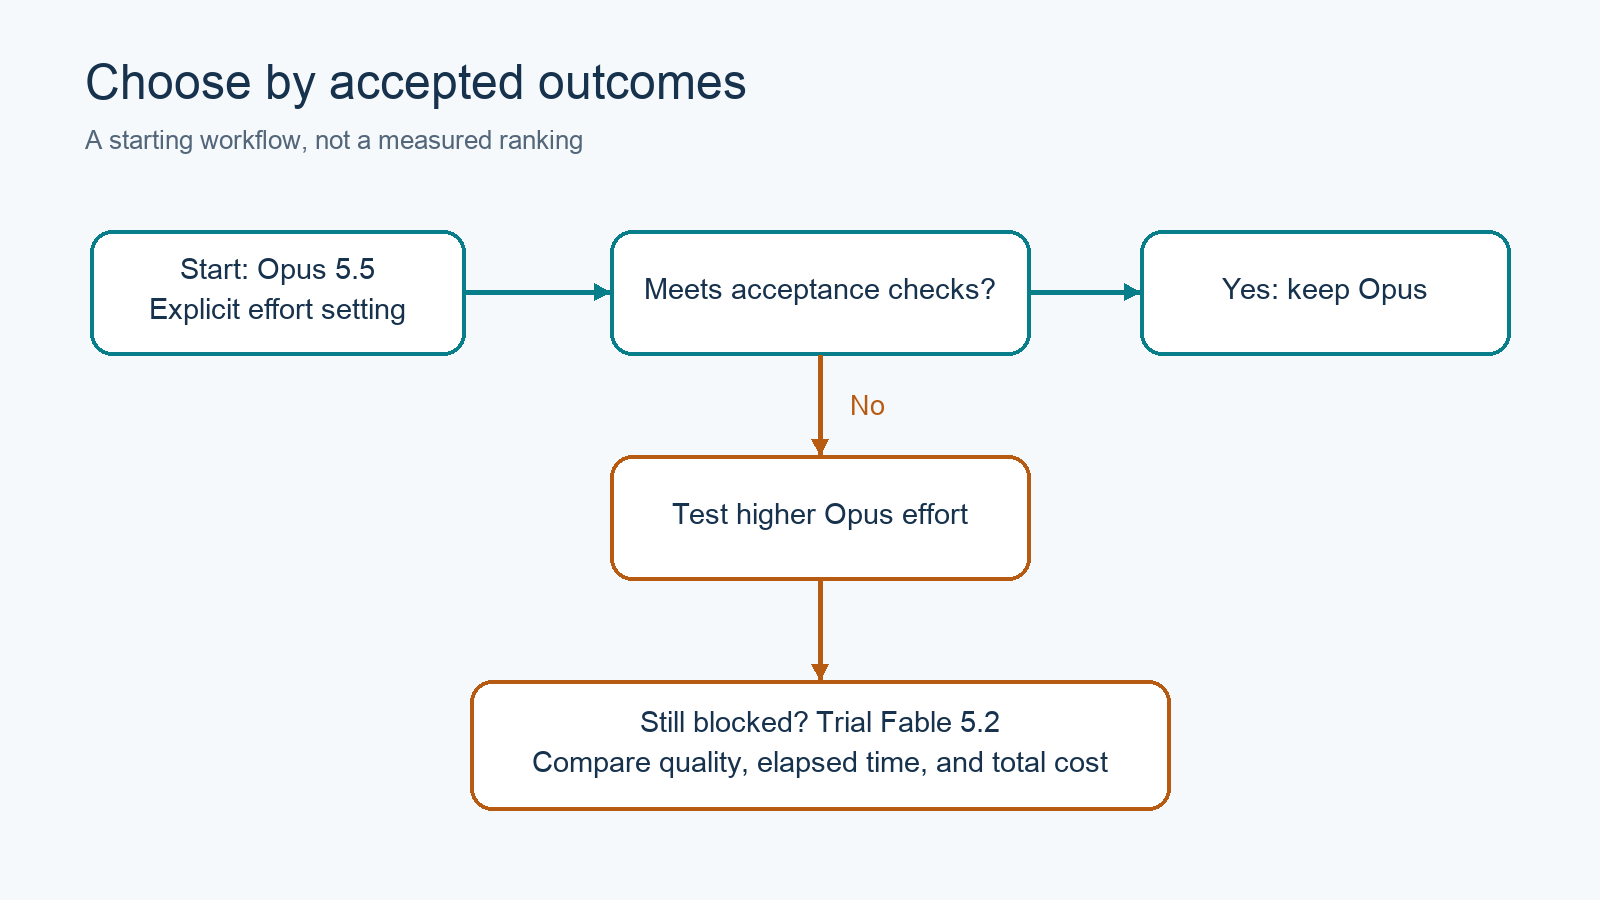
Seçici yükseltme: rutin görevleri temelinizde tutun, zor işleri kontrollerinizi geçen modele gönderin.
Aralıklı olarak bir olayı iki kez işleyen bir ödeme webhook'unu düşünün. Gerekli düzeltme zaten tanımlanmışsa, Opus için sınırlı bir kodlama görevi söz konusudur. Agent'ın yeniden denemeler, depolama ve aşağı akış hizmetleri arasındaki eşzamanlılığı yeniden kurması gerekiyorsa, soruşturma bir Fable denemesi için daha güçlü bir adaydır.
Her iki modele de aynı olay kanıtlarını ve kısıtlamaları verin. Daha pahalı bir model, eksik logları, erişilemeyen bağımlılıkları veya yanlış davranışı ödüllendiren bir kabul testini telafi edemez.
Anthropic'in benchmark'ları ne gösteriyor?
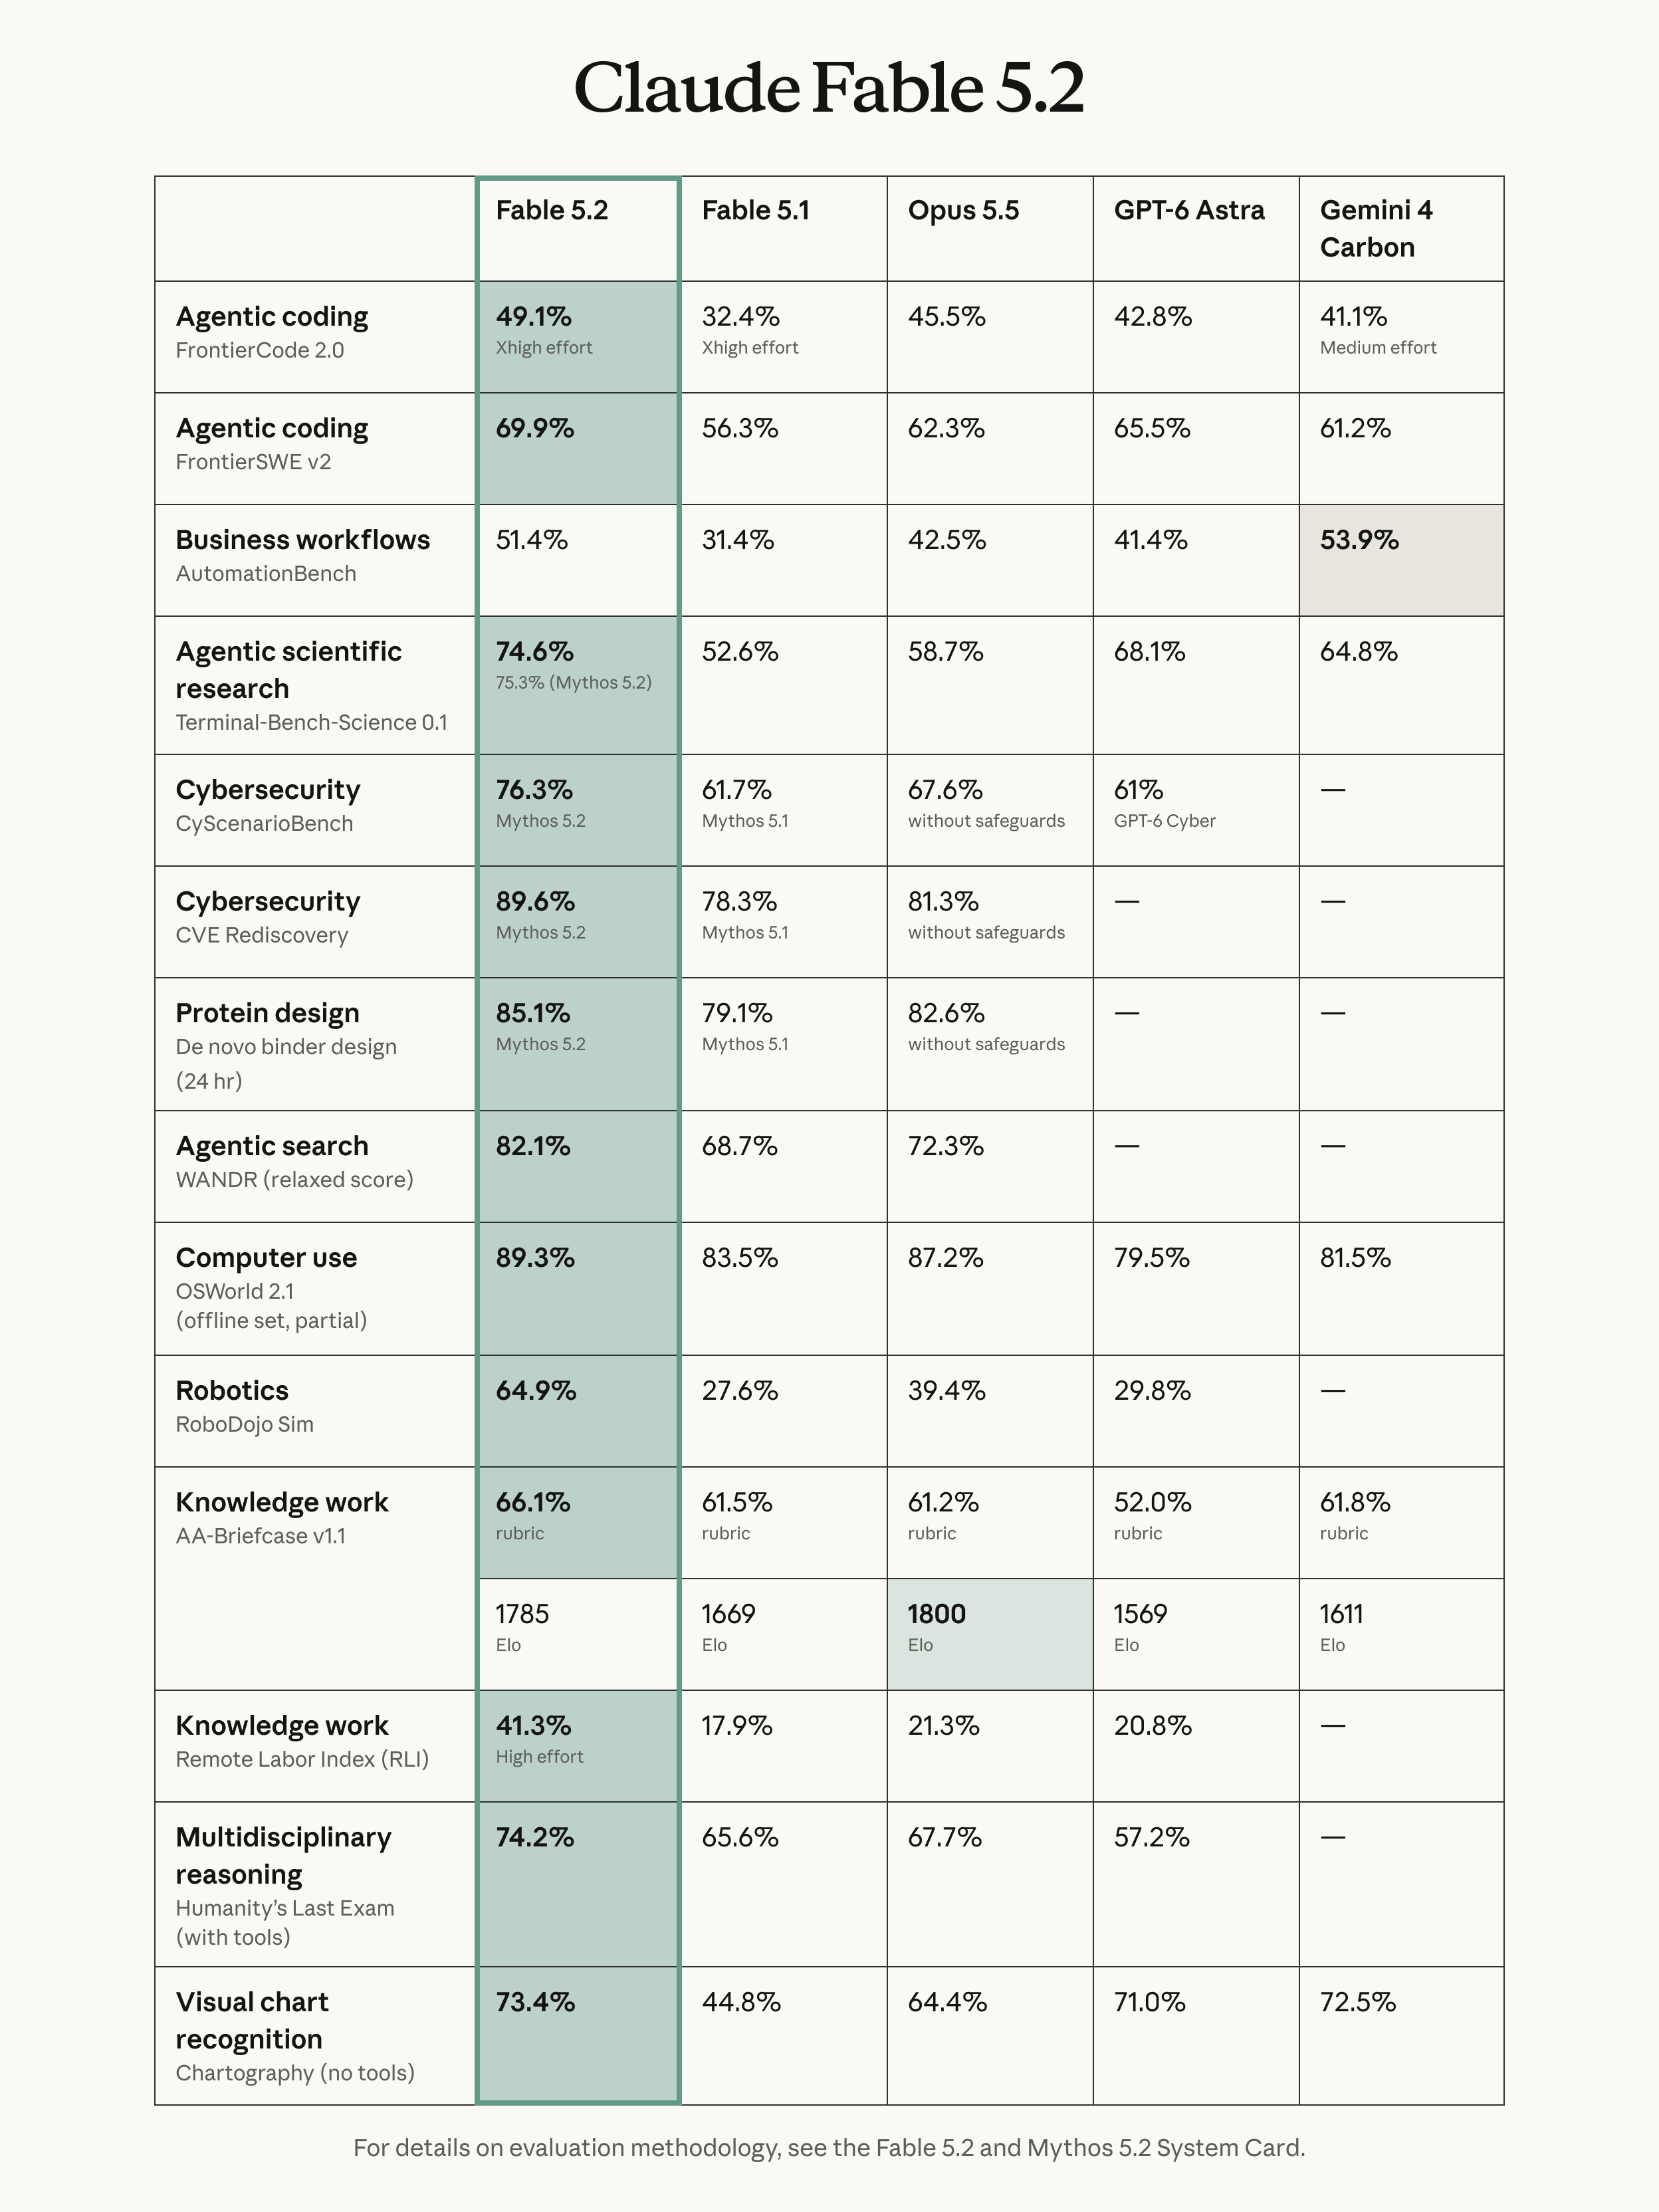
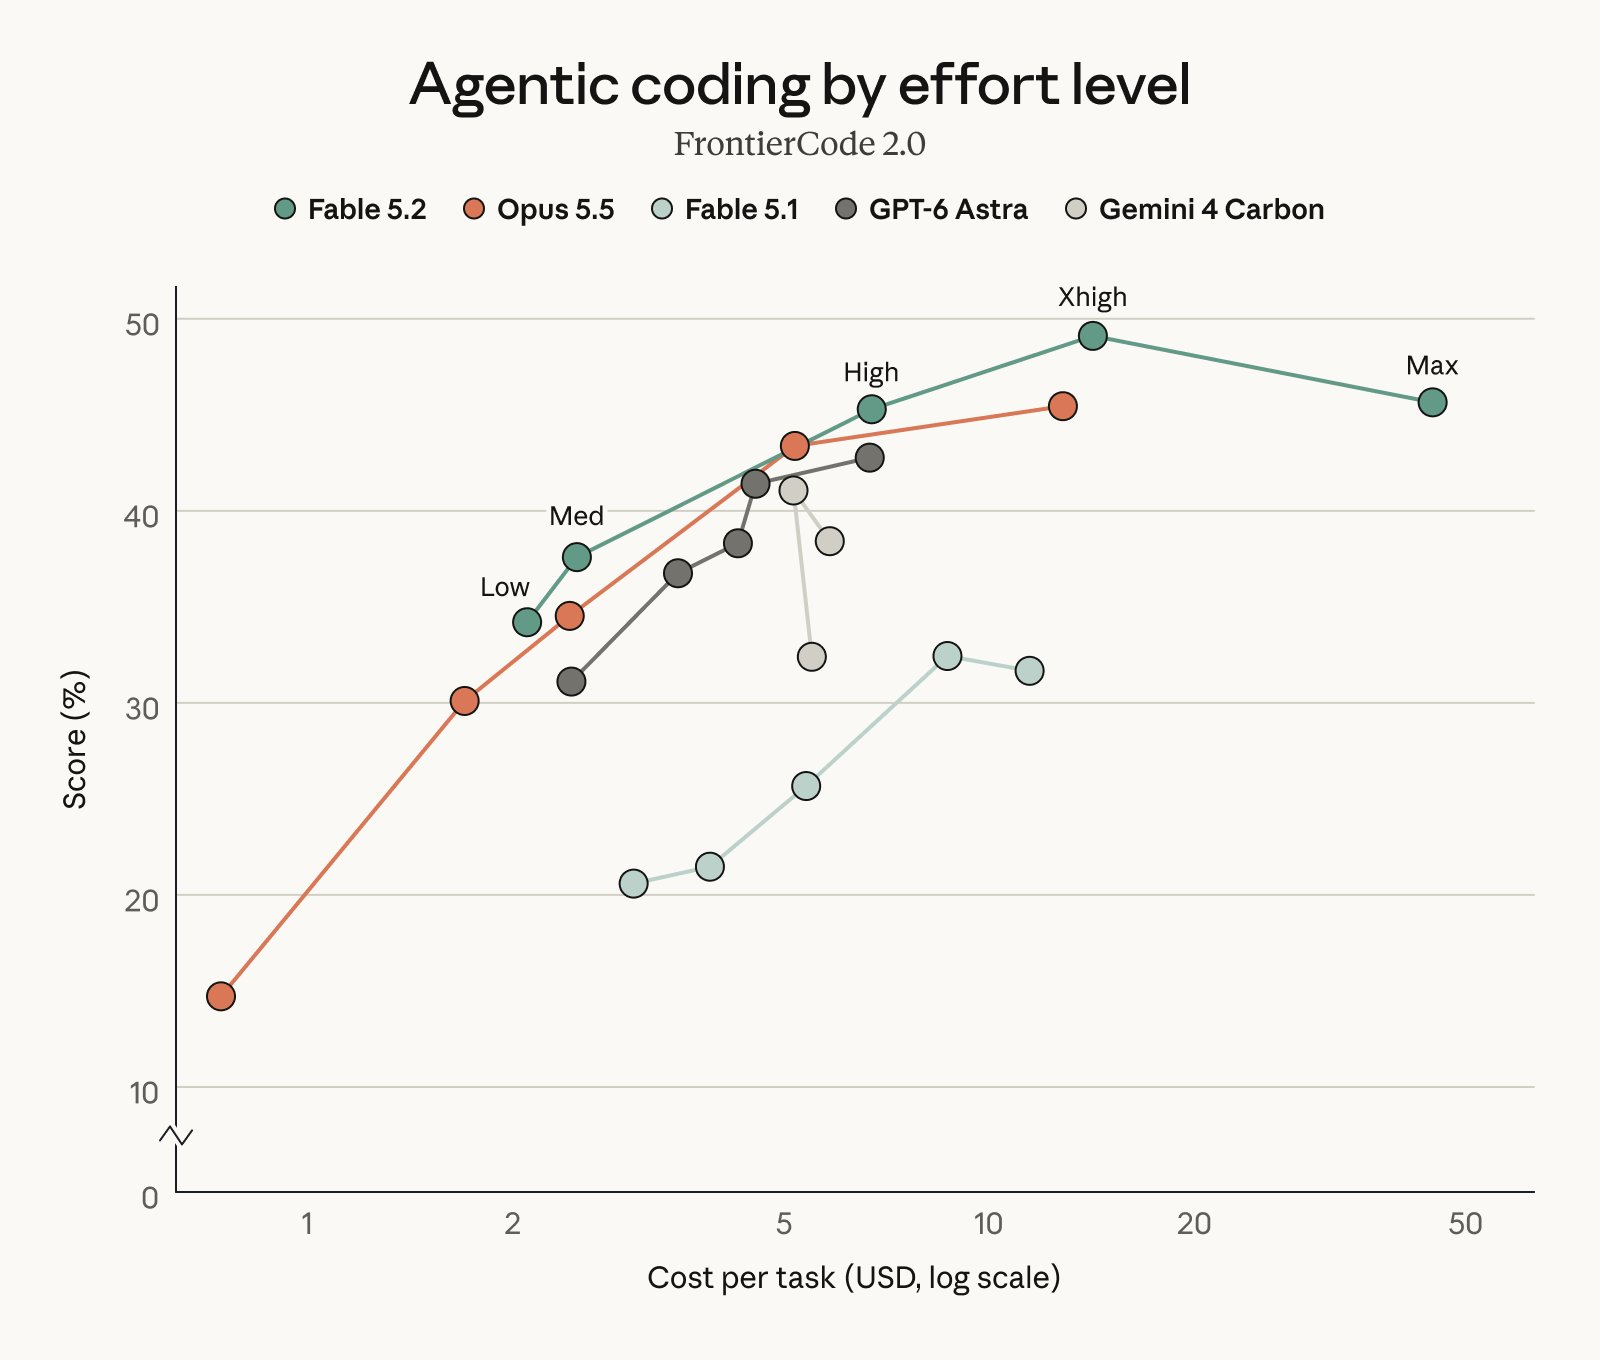
Anthropic, Fable 5.2'nin birkaç kodlama ve akıl yürütme değerlendirmesinde daha yüksek puanlar aldığını raporluyor. En güçlü pratik sinyal, effort-maliyet sonucudur: Anthropic'in erken testlerinde Fable High ayarında, Opus Max ayarını FrontierCode 2.0'da görev başına yaklaşık yarı maliyette neredeyse eşleşiyor.
| Satıcı tarafından raporlanan değerlendirme | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0, agent tabanlı kodlama | Xhigh'da %49,1 | %45,5 |
| FrontierSWE v2, agent tabanlı kodlama | %69,9 | %62,3 |
| WANDR, agent tabanlı arama, gevşek puan | %82,1 | %72,3 |
| OSWorld 2.1, kısmi çevrimdışı set | %89,3 | %87,2 |
Bu rakamlar duyurudan geliyor; duyuruda, aksi belirtilmedikçe puanların mevcut en yüksek effort ile alındığı söyleniyor. Bunlar Anthropic'in değerlendirme koşullarını anlatıyor; varsayılan ayarları veya sizin görevlerinizde beklenen başarı oranını değil.
Maliyet karşılaştırması daha da dardır. Fable High ayarında %45,3 alırken, Opus'un en iyi puanı %45,5'tir. Bu, o değerlendirme için daha ucuz yapılandırmayı test etmeyi destekler. Her Fable iş akışının Opus'un yarısı kadar maliyeti olacağı anlamına gelmez.
Benchmark yüzdesini verimlilik tahminine dönüştürmekten kaçının. Bir kodlama puanı, inceleme kuyruğunuzu, dağıtım riskinizi veya yanlış bir migration'ı onarmak için harcanan süreyi ölçmez. Ayrıca Mythos'a özel siber güvenlik ve biyoloji sonuçlarını Fable'ın karnesine eklemeyin: duyuru, paylaşılan bir temel modelden bahsediyor ancak farklı güvenlik önlemleri ve erişimden bahsediyor.
Effort ayarları karşılaştırmayı değiştirir
Modelleri karşılaştırırken effort'ı açıkça ayarlayın. API varsayılanları Fable 5.2 için High, Opus 5.5 için Medium'dur. Anthropic'in duyurusu ayrıca Medium'u Claude uygulamaları ve Claude Code'da varsayılan olarak tanımlıyor. Tek bir varsayılanın her yerde geçerli olduğunu varsaymak yerine ürünü ve ayarı kaydedin.
Effort dokümantasyonu, her iki model için de low, medium, high, xhigh ve max değerlerini tanımlıyor. Effort; yanıt metnini, araç argümanlarını ve thinking'i etkiler. Bu, katı bir harcama sınırı değil, davranışsal bir sinyaldir.
Çalışan Opus yapılandırmanızla başlayın. Yetersiz kalırsa, daha yüksek bir Opus effort'unu Medium veya High ayarındaki Fable ile karşılaştırın. Xhigh ve Max denemelerini, ek akıl yürütmenin makul bir fayda sağladığı ve harcamayı tolere edebildiğiniz görevler için saklayın.
Eşit-effort karşılaştırması tek bir soruyu yanıtlar: bu modeller aynı adlandırılmış ayar altında nasıl davranır? Maliyet-eşleştirilmiş karşılaştırma başka bir soruyu yanıtlar: hangi yapılandırma bütçeniz için en güçlü kabul edilebilir sonucu üretir? Hiçbiri diğerinin yerini almaz.
Gecikme: tüm görevi ölçün
Her iki model de Anthropic'in genel bakışında Orta karşılaştırmalı gecikme etiketi taşıyor. Bu etiketten evrensel bir kazanan çıkmıyor. Çıktı hızını tüm geliştirme iş akışınızın hızı olarak kabul etmek yerine; araçlar ve yeniden denemeler dahil, incelenmiş bir sonuca kadar geçen süreyi ölçün.
Anthropic, Fable 5.2'nin çıktıyı Fable 5.1'e kıyasla %30'a kadar daha hızlı ürettiğini söylüyor. Bu karşılaştırma, selefine karşı yapılmıştır, Opus 5.5'e karşı değil. Opsiyonel fast mode, token üretim hızında 2,5 kata kadar artış sunuyor; bu da yine satıcı iddiasıdır, görev sürenizde ölçülmüş bir kısalma değil.
Derleme veya yavaş bir veritabanı tarafından domine edilen bir görev, daha hızlı token üretimiyle orantılı olarak hızlanmaz. Tersine, iki başarısız yaklaşımdan kaçınan bir agent, daha yavaş token üreterek bile daha erken bitebilir. Hız primi ödemeden önce bunları ayrı ayrı takip edin.
Kabul edilen sonuç başına maliyeti karşılaştırın
Karar metriğiniz olarak, toplam iş akışı harcamasını kabul edilen sonuçlara bölün. Token fiyatları oranı belirler; ancak token hacmi, önbellekleme, başarısız denemeler, araçlar ve inceleme ne satın aldığınızı belirler. Aşağıdaki aritmetik örnek niteliğindedir; iki modelin davranışının bir ölçümü değildir.
Tek bir isteğin, standart global yönlendirme ve ek araç ücreti olmadan 100.000 önbelleğe alınmamış girdi token'ı ve 10.000 çıktı token'ı tükettiğini varsayalım:
| Yapılandırma | Girdi maliyeti | Çıktı maliyeti | Toplam |
|---|---|---|---|
| Opus 5.5 standart | $0,40 | $0,20 | $0,60 |
| Fable 5.2 standart | $0,80 | $0,40 | $1,20 |
| Opus 5.5 fast | $0,80 | $0,40 | $1,20 |
| Fable 5.2 fast | $1,60 | $0,80 | $2,40 |
Fiyatlar 10 Kasım 2026'da Anthropic'in fiyatlandırma dokümantasyonundan doğrulandı. Abonlik kotaları bu API fiyatlarından ayrıdır. Bulut sağlayıcılar, önbellekleme, veri konumu seçenekleri ve diğer özellikler faturayı değiştirebilir.
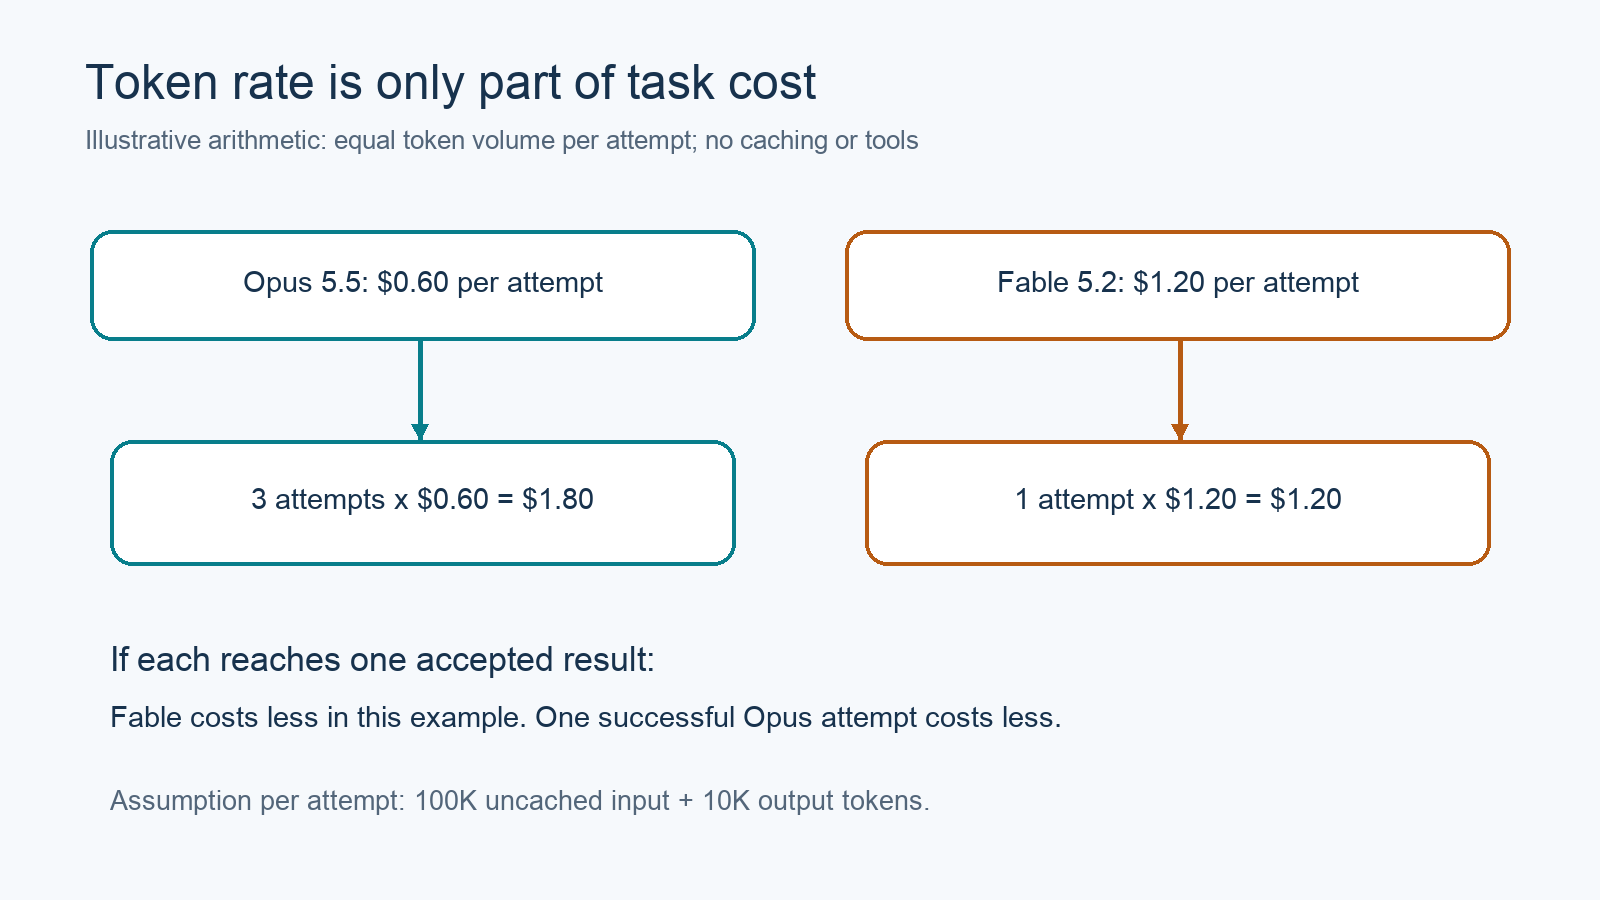
Başarılı bir sonuç için gereken tüm denemeleri, yeniden denemeler ve inceleme dahil, karşılaştırın.
Bu basitleştirilmiş örnekte, aynı hacimde üç Opus denemesi $1,80'e mal olurken; tek bir Fable denemesi $1,20'ye mal oluyor. Bu, Fable'ı yalnızca o tek denemede kabul edilen sonuca ulaşıyorsa daha ucuz yapar. Tek başarılı Opus denemesi yine de daha ucuz kalır. Gerçek yeniden denemeler genellikle farklı hacimler tükettiği için, tahmini bir ortalama çarpmak yerine kaydedilmiş kullanım verilerini kullanın.
Mühendislik inceleme süresini API harcamasının yanına koyun. Testleri geçen ancak önemli düzeltme gerektiren bir yama, incelemeye hazır bir yama ile aynı barı geçmemiştir.
Kodlama agent'ınızın API'yi Apidog CLI ile kontrol etmesine izin verin
Kodlama agent'ınızın tekrarlanabilir API kontrolleri oluşturup çalıştırması için Apidog CLI'yı kullanın. Bu kontroller, model değiştirdiğinizde istek veya yanıt regresyonlarını ortaya çıkarabilir. Bir agent'ın depo değişikliklerinin doğru olup olmadığını belirlemezler; depo testlerini ve insan incelemesini de yanlarında tutun.
CLI'yi kurun, ardından agent'ınızın resmi kurulum kılavuzunu okumasını sağlayın:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
Claude Code'a veya tercih ettiğiniz agent'a şu istemi verin:
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
Agent şemayı kontrol eder, geçerli bir test senaryosu kategorisi seçer, case.json dosyasını oluşturur, sonra bunun gibi komutları çalıştırır. Bayraklar, kurulu CLI 2.2.12 yardımıyla doğrulandı:
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
Yer tutucuları kendi proje kaynaklarınızla değiştirin. Bu bir iş akışı şablonudur, yürütülmüş bir model karşılaştırması değildir. Agent kurulumu için Claude Code'da Apidog CLI kılavuzunu veya Codex entegrasyon kılavuzunu takip edin.
SSS
Fable 5.2, tüm kodlama işleri için Opus 5.5'ten daha mı iyi?
Hayır. Anthropic, çoğu kodlama ve bilgi işi için Opus 5.5'yi öneriyor. Zor işler bu temeli aştığında Fable'ı test etmeye değer. Daha yüksek satıcı benchmark puanları, her görevde daha iyi bir sonuç garanti etmez.
Fable 5.2 iki katı mı maliyetli?
Standart girdi ve çıktı token fiyatları, Opus 5.5'ninkilerin iki katıdır. Yapılandırmalar farklı tokenlar tükettiği ve farklı sayıda deneme gerektirdiği için toplam görev maliyeti farklı olabilir.
Her zaman maksimum effort kullanmalı mıyım?
Hayır. Ayarları kabul kriterleriniz ve bütçenize göre karşılaştırın. Daha yüksek effort daha fazla token harcamasına izin verir; sınırlı bir görev için faydalı bir iyileşme garanti etmez.
Fable 5.2, Opus 5.5'ten daha mı hızlı?
Burada incelenen kaynaklar, evrensel bir başa baş gecikme kazananını ortaya koymuyor. İkisi de Orta gecikme etiketi taşıyor. Gerçek iş akışınızı ölçün ve fast mode'u ayrı bir yapılandırma olarak değerlendirin.
Apidog hangi modelin daha iyi kod yazdığına karar verebilir mi?
Apidog CLI, agent'ınızın API kontrolleri çalıştırmasına ve yanıt kanıtları toplamasına yardımcı olabilir. Kod kalitesi yine de depo testlerine ve incelemeye ihtiyaç duyar. Hangi model ve effort ayarının maliyetini hak ettiğine karar vermek için bu kabul edilen sonuçları kullanın.