
Cerebras tek bir sayı satıyor: hız. İddia şu: wafer ölçeğindeki çipleri, token'ları bir GPU kümesinin asla başaramayacağı kadar hızlı dışarı çıkarıyor ve ücretsiz katman, şirketin dikkatinizi çekme yöntemi. Ancak "hızlı", bir satıcının sözüne güvenerek kabul etmeniz gereken bir şey değildir. Bu, kendi bağlantınızda, kendi prompt'unuzla ölçtüğünüz ve Cerebras yeni bir model yayınladığında veya bir limiti değiştirdiğinde yeniden çalıştırabileceğiniz bir kayıt olarak sakladığınız bir şeydir.
Bu kılavuz bu ölçümü sizinle birlikte yapar. Bir Cerebras API anahtarı alacak, OpenAI uyumlu uç noktaya karşı gerçek bir sohbet tamamlama çağrısı yapacak, ilk token'ın ve tam yanıtın süresini ölçecek ve kodlama ajanınızın tüm isteği bir Apidog CLI testine dönüştürmesini sağlayacaksınız, böylece bir sonraki model değişimine kadar dayanacaktır.
TL;DR
Cerebras yeni hesaplara bir Ücretsiz Deneme katmanı verir: verildikten 30 gün sonra süresi dolan 5$ kredi, Cerebras'ın yayımladığı hız limitlerine göre her biri dakikada 5 istek ve dakikada 30K önbelleğe alınmamış token ile sınırlandırılmış iki modelle (gpt-oss-120b ve qwen-3.8-27b) sınırlıdır. API, https://api.cerebras.ai/v1 adresinde OpenAI uyumludur, dolayısıyla mevcut bir OpenAI istemcisini ona yönlendirip üç satırı değiştirebilirsiniz. Aşağıda, bir pazarlama sayfasına güvenmek yerine, ilk token'a kadar geçen süreyi ve saniye başına token'ları kendiniz ölçen bir istek oluşturacaksınız.
Ücretsiz katmanın belgelediği ve belgelemediği şeyler
Cerebras'ın fiyatlandırma sayfası sayılarını istemci tarafında oluşturur, bu da ücretli kullanım için milyon token başına tam dolar oranının sayfanın statik bir getirmesiyle alınabilecek bir şey olmadığı anlamına gelir. Bu rakamı tahmin etmeyin. İhtiyacınız olduğunda, Cerebras Cloud konsolunun faturalandırma sekmesini kendiniz açın, çünkü güncel oranın doğru olduğunun garanti edildiği tek yer orasıdır.
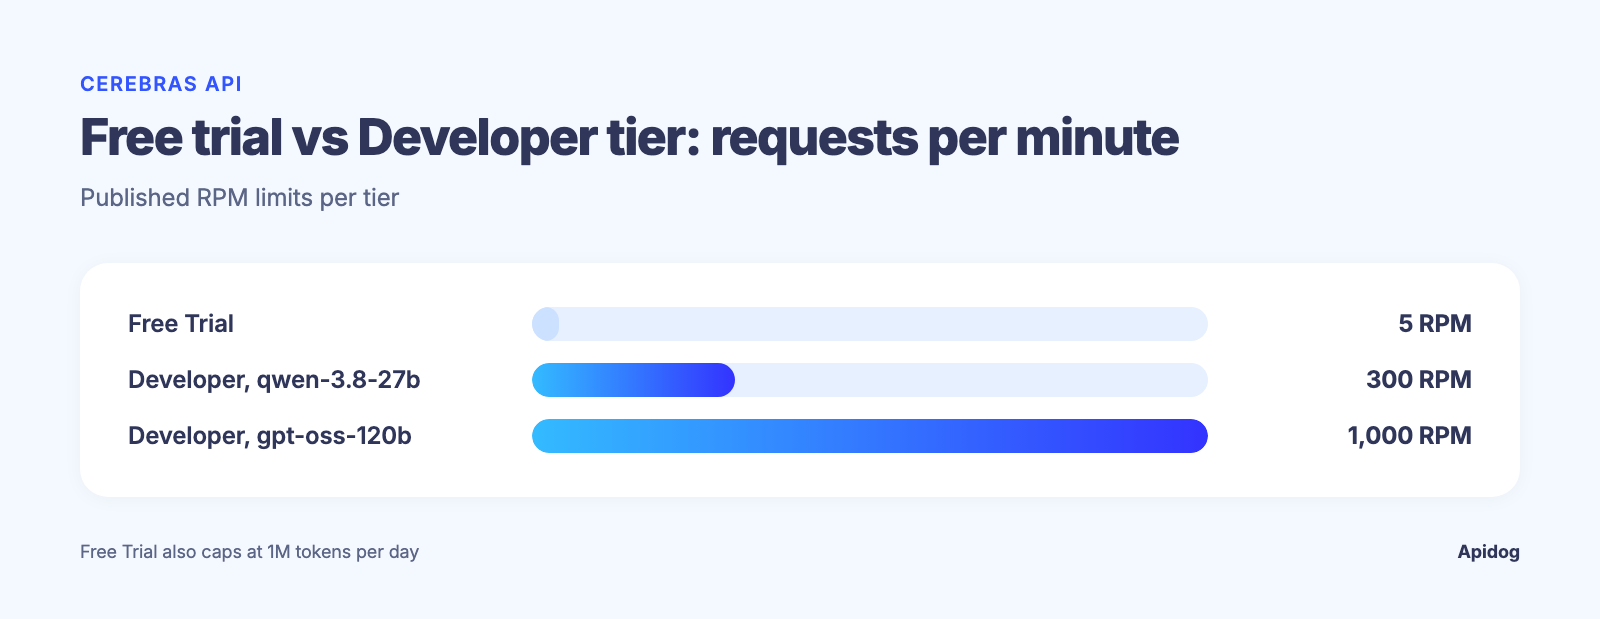
Belgelerin destek hız limitleri sayfasında açıkça belirttiği şey, Ücretsiz Deneme katmanının şeklidir:
| Katman | Modeller | RPM | Önbelleğe alınmamış TPM | Toplam TPM | TPH | TPD |
|---|---|---|---|---|---|---|
| Ücretsiz Deneme | gpt-oss-120b, qwen-3.8-27b |
5 | 30K | 90K | 1M | 1M |
Geliştirici (gpt-oss-120b) |
kullandıkça öde | 1.000 | 1M | 3M | yok | yok |
Geliştirici (qwen-3.8-27b) |
kullandıkça öde | 300 | 150K | 450K | yok | yok |
Burada iki şey önemlidir. Birincisi, "önbelleğe alınmamış TPM" gerçek tavandır: tam hesaplama gerektiren token'lardır ve önbellek isabetleri sayıldığında toplam TPM izniniz bunun yaklaşık üç katıdır. İkincisi, Ücretsiz Deneme hesabı sonsuza kadar istekle sınırlı değil, kredi ve zamanla sınırlıdır: 5$ tükendiğinde veya 30 gün geçtiğinde, bir ödeme yöntemi ekleyene kadar hesap katmanının izin verdiği seviyeye düşersiniz. Bu tablonun ötesindeki her şey (token başına fiyatlandırma, koltuk fiyatlandırması, kurumsal koşullar) JavaScript ile oluşturulan fiyatlandırma sayfasının ve konsolun arkasında yaşar, statik belgelerin değil, bu yüzden bütçelemeden önce orayı kontrol edin.
Başka bir sağlayıcıda bunun gibi bir duvara çarptıysanız, kalıp 429 rate-limit-exceeded yanıtı aldığınızda ne yapılacağına dair kılavuzumuzda ele alınan kalıpla aynıdır: hata gövdesini okuyun, geri çekilin ve API'nin bozuk olduğunu varsaymadan önce panoyu kontrol edin.
Bir anahtar alın ve gerçek bir çağrı yapın
cloud.cerebras.ai adresinde kaydolun, API Keys'i açın ve bir tane oluşturun. Cerebras'ın kendi hızlı başlangıç kılavuzu, anahtarı bir ortam değişkeni olarak ayarlamanızı söyler, böylece asla elle bir istek gövdesine girmez:
export CEREBRAS_API_KEY="your-key-here"
Temel URL https://api.cerebras.ai/v1'dir ve sohbet tamamlama uç noktası, OpenAI'nin şekliyle doğrudan eşleşir: bir model ve bir messages dizisiyle POST /v1/chat/completions. Bu uyumluluk API referansında belgelenmiştir ve OpenAI'nin istemci kütüphanesi için yazılmış koda Cerebras'ı yalnızca temel URL'yi ve anahtarı değiştirerek bırakabilmenizin nedenidir. Ham bir curl çağrısı şöyle görünür:
curl https://api.cerebras.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${CEREBRAS_API_KEY}" \
  -d '{
    "model": "qwen-3.8-27b",
    "messages": [
      {"role": "user", "content": "Explain time-to-first-token in two sentences."}
    ]
  }'
Çalıştırın; yanıt, tamamlama metninden daha fazlasını taşır. Bir usage bloğu (prompt_tokens, completion_tokens, total_tokens) ve Cerebras'ın her çağrıda döndürdüğü bir time_info bloğu (queue_time, total_time) içerir.
Ekibiniz birden fazla model veya sağlayıcı test ediyorsa, tek seferlik curl komutlarına güvenmeyi bırakmak için iyi bir an. Aşağıdaki Apidog CLI bölümü, kodlama ajanınızın bu çağrıyı Cerebras bir model eklediğinde veya bir limiti değiştirdiğinde yeniden çalıştırdığı bir teste dönüştürmesini sağlar.
Hız iddiasını ölçün: ilk token'a kadar geçen süre ve saniye başına token
İki sayı, "hızlı"nın iş yükünüz için gerçek olup olmadığını söyler: ilk token'a kadar geçen süre (TTFT) ve saniyede üretilen token'lar. İkisi de API yanıtında manşet metrik olarak görünmez, bu yüzden onları çağrının size verdiklerinden hesaplarsınız.
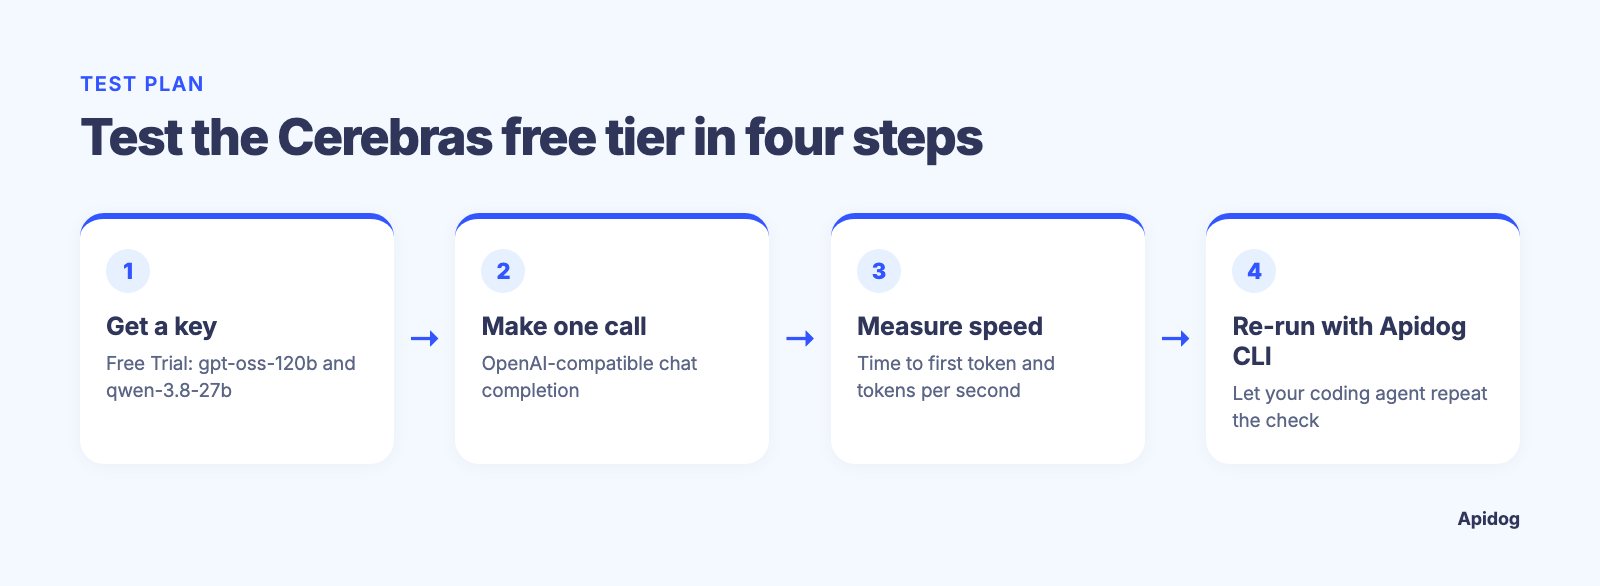
TTFT için yanıtı akış halinde alın ve isteği göndermekle ilk parçayı almak arasındaki gerçek zaman farkını kaydedin:
import time
from cerebras.cloud.sdk import Cerebras

client = Cerebras()
start = time.perf_counter()
first_token_at = None

stream = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Write a haiku about wafer-scale chips."}],
    stream=True,
)

for chunk in stream:
    if first_token_at is None and chunk.choices[0].delta.content:
        first_token_at = time.perf_counter() - start
        print(f"Time to first token: {first_token_at:.3f}s")
Saniye başına token için, akışsız bir çağrı kullanın ve tamamlama token'larını Cerebras'ın time_info içinde bildirdiği total_time değerine bölün:
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Explain the CS-3 wafer-scale engine in 100 words."}],
)

tokens = response.usage.completion_tokens
seconds = response.time_info.total_time
print(f"{tokens / seconds:.1f} tokens/sec")
Bunu ürününüzün gönderdiğine yakın bir prompt ile farklı saatlerde birkaç kez çalıştırın. Her iki betiği de elinizin altında tutun ve Cerebras ücretsiz katmana bir model eklediğinde yeniden çalıştırın, çünkü saniye başına token sayısı yalnızca sağlayıcıya göre değil, modele göre değişir.
Limitleri onlar sizi okumadan önce okuyun
Cerebras'ın hız limiti tasarımının, bir şeyi betiklemeden önce bilmeye değer bir inceliği vardır: kuruluş başına iki ayrı token kovası, önbelleğe alınmamış TPM ve toplam TPM izler ve ikisini aynı anda uygular. Kısa, tekrarlayan prompt'lardan oluşan bir patlama, token tavanına yaklaşmadan önce dakikada istek tavanına çarpabilir; tam olarak API hız sınırlamasının nasıl çalıştığına dair daha geniş yazımızda açıklanan tuzak.
Belgelerde dürüst bir boşluk var: Cerebras, bazı sağlayıcıların yaptığı gibi bir dizi x-ratelimit-* yanıt başlığı yayımlamaz. API referansı hiçbirini listelemez ve hız limitleri sayfası da listelemez. Bu, her çağrıda kalan kota başlıkları döndüren OpenAI'nin kendi sohbet tamamlama API'sinden farklıdır; bu kalıp OpenAI hız limitleri kılavuzumuzda daha ayrıntılı olarak ele alınmıştır. Cerebras ile gerçek durumunuzu kontrol edilecek iki yer, Cloud konsolunun Limits bölümü ve 429 yanıtının gövdesidir; burada önbelleğe alınmamış mı yoksa toplam token tavanını mı aştığınız belirtilir. Yeniden deneme mantığınızı, önce bir başlığın size söyleyeceğini varsaymak yerine bu hata gövdesi etrafında kurun.
Kodlama ajanınızın Apidog CLI ile yeniden çalıştırmasına izin verin
Bir karalama dosyasındaki ölçüm gelecek ay hiçbir şeyi kanıtlamaz. Kodlama ajanınızın çağrıyı Apidog CLI aracılığıyla yeniden çalıştırabileceği bir teste dönüştürmesini sağlayın. Bir kez kurun:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Token, Apidog içindeki Account Settings, API Access Token'dan gelir. Ardından ajana tek bir prompt verin:
Use Apidog CLI on project <id>. Create a Cerebras environment with base URL
https://api.cerebras.ai/v1 and add POST /chat/completions with Bearer auth from
{{CEREBRAS_API_KEY}} and model set to {{MODEL}}. Create a test case asserting
status 200 and time_info.total_time under {{MAX_TOTAL_TIME}}, run it for
gpt-oss-120b and qwen-3.8-27b, and report completion tokens per second for each.
Çalıştırdığı komutlar, Apidog CLI 2.2.7 ile doğrulanmıştır:
apidog environment create Cerebras --project <id> --base-url https://api.cerebras.ai/v1
apidog endpoint create --project <id> --file cerebras-chat.json
apidog cli-schema validate test-case-create --file speed-case.json
apidog test-case create --project <id> --file speed-case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d models.csv \
  --delay-request 12000 --env-var "CEREBRAS_API_KEY=$CEREBRAS_API_KEY" -r cli,json
models.csv bir MODEL sütunu tutar, böylece tek bir çalıştırma her iki modeli kapsar ve Cerebras'ın bir sonraki gönderdiği şey bir satır daha olur. --delay-request 12000, Ücretsiz Deneme'nin dakikada 5 istek sınırının altında kalmak için çağrıları 12 saniye aralıklarla yerleştirir. 429 yolu için, bu sınırın kasıtlı olarak üzerine çıkan ve hata gövdesi üzerinde doğrulama yapan ikinci bir vaka isteyin, böylece üretimde yeniden keşfedilmek yerine yakalanır ve sürümlenir. Bu bir iş akışıdır, tek seferlik bir karşılaştırma değil; seçenekleri karşılaştırıyorsanız ajan ve LLM iş yükleri için oluşturulmuş API test araçları derlememize ve ajan tarafı için Claude Code'da Apidog CLI'ya bakın.
Ücretsiz katman mı Geliştirici katmanı mı: ne zaman geçmeli
Ücretsiz Deneme katmanı tam olarak bu kılavuzun ele aldığı şey için oluşturulmuştur: bir kart taahhüt etmeden önce hız iddiasını ve istek şeklini doğrulamak. Cerebras'a karşı gerçekten geliştirmeye başladığınızda, Geliştirici katmanının gpt-oss-120b üzerinde 5 RPM'den 1.000 RPM'ye sıçraması, kararı genellikle zorlayan sayıdır, token başına fiyat değil. Prompt hacminiz düzenli olmaktan çok ani ise, taahhüt etmeden önce Cerebras'ın sayılarını alternatiflerle karşılaştırın; OpenRouter alternatifleri listemiz ve Groq'un ücretsiz API katmanı incelememiz, yukarıdaki tabloyla yan yana okumaya değerdir, çünkü çıkarım hızı ve ücretsiz katman tavanları çoğu karşılaştırma yazısının kabul ettiğinden sağlayıcılar arasında daha fazla değişir. Seçmeden önce bilmeye değer bir fark: Groq, model bazında Ücretsiz Plan limitlerini doğrudan belgeler, örneğin openai/gpt-oss-120b için 30 RPM, 1.000 RPD, 8K TPM ve 200K TPD ve her çağrıda x-ratelimit-* yanıt başlıkları döndürür, böylece kalan bütçenizi her zaman yanıtın kendisinden bilirsiniz. Cerebras size ikisini de vermez; durumunuzu Cloud konsolundan okursunuz veya yukarıda ele alındığı gibi bir 429 gövdesinden çıkarırsınız.
SSS
Cerebras'ın ücretsiz katmanı kredi kartı gerektiriyor mu? Ücretsiz Deneme katmanı, yinelenen bir ücretsiz plan yerine kredi tabanlıdır (30 gün sonra süresi dolan 5$) ve Cerebras'ın kendi belgeleri, bu ayrıntı statik belgelerden bağımsız olarak değişebileceğinden, güncel kayıt gereksinimleri için sizi Cloud konsoluna yönlendirir.
Ücretsiz katmanda hangi modeller mevcut? Güncel hız limitleri belgelerine göre iki tane: gpt-oss-120b ve qwen-3.8-27b. Her ikisi de aynı Ücretsiz Deneme limitlerini paylaşır (5 RPM, 30K önbelleğe alınmamış TPM).
Mevcut OpenAI SDK kodumu Cerebras ile kullanabilir miyim? Evet. İstemcinin temel URL'sini https://api.cerebras.ai/v1 adresine yönlendirin ve Cerebras anahtarınızı takın; API referansına göre /v1/chat/completions şekli eşleşir.
Token bütçemin altında olmama rağmen neden 429 aldım? Cerebras, önbelleğe alınmamış TPM, toplam TPM ve RPM'yi ayrı tavanlar olarak uygular. Küçük isteklerden oluşan bir sağanak, herhangi bir token kovası dolmadan çok önce RPM limitine takılabilir; bu, rate-limit-exceeded sorun giderme kılavuzumuzda ele alınan aynı başarısızlık modudur.
Önce bir duvara çarpmadan mevcut kullanımımı nasıl kontrol ederim? Cerebras kalan kota yanıt başlıkları döndürmez, bu yüzden API yanıtlarından çıkarmak yerine doğrudan Cloud konsolundaki Limits bölümünü kontrol edin. Groq'un ücretsiz planı tam tersi yaklaşımı benimser ve her çağrıda x-ratelimit-* başlıkları döndürür, bu yüzden başlık tabanlı izleme kurulumunuz için önemliyse bu farkı tartın.
Cerebras'ın gerçek avantajı bir pazarlama manşetinde değil, kendi çağrılarınızdaki time_info bloğunda ortaya çıkar.