
ทีม Qwen ของ Alibaba ได้โอเพนซอร์ส Qwen-Image-2.1 เมื่อวันที่ 20 กันยายน 2026 เป็นโมเดลเดียวที่สามารถสร้างภาพจากข้อความและแก้ไขภาพได้ มีพารามิเตอร์ 7 พันล้านตัวในส่วนประกอบการสร้างภาพ และสามารถส่งออกไฟล์ PNG โปร่งใสได้โดยตรงจากคำสั่ง (prompt) โดยไม่ต้องสร้างภาพปลอมด้วยการลบพื้นหลัง โพสต์เปิดตัว ระบุการเปลี่ยนแปลงสี่ประการ: สถาปัตยกรรมที่เบาขึ้นและเร็วขึ้น, การรองรับความโปร่งใสแบบเนทีฟ, การแก้ไขด้วยภาพอ้างอิงสูงสุด 10 ภาพ, และการปรับปรุงการพิมพ์และรายละเอียดภาพบุคคล น้ำหนักโมเดล (weights) มีอยู่บน Hugging Face และ ModelScope ส่วนโค้ดอยู่บน GitHub
ข้อความบรรทัดหนึ่งใน Model Card มีความสำคัญมากกว่าคุณสมบัติใดๆ นั่นคือใบอนุญาตเป็น Qwen Research License ไม่ใช่ Apache 2.0 การใช้งานเชิงพาณิชย์ต้องมีข้อตกลงแยกต่างหาก หากคุณกำลังประเมินเวอร์ชัน 2.1 สำหรับผลิตภัณฑ์ โปรดอ่านส่วนนั้นก่อนดูผลการทดสอบ หากคุณต้องการใช้งาน คู่มือการใช้งาน Qwen-Image-2.1 มีโค้ด diffusers และ HTTP wrapper ที่คุณสามารถทดสอบได้ใน Apidog หากคุณกำลังพิจารณาเปรียบเทียบกับ Qwen Image 3.0 API ที่เป็นแบบโฮสต์ การเปรียบเทียบ 2.1 vs 3.0 คือหน้าตัดสินใจของคุณ
Qwen-Image-2.1 โดยสรุป
| รายการ | รายละเอียด (โพสต์เปิดตัว, Model Card, GitHub README) |
|---|---|
| วันที่เผยแพร่ | 20 กันยายน 2026 |
| ทำอะไรได้บ้าง | สร้างภาพจากข้อความและแก้ไขภาพในโมเดลเดียว รวมถึงการส่งออกภาพแบบโปร่งใส (RGBA) |
| ตัวสร้างภาพ (Visual generator) | 32 เลเยอร์ Single-Stream DiT, 7 พันล้านพารามิเตอร์ |
| ตัวเข้ารหัสข้อความ (Text encoder) | Qwen3-VL 8B |
| VAE | 64-channel RGBA autoencoder, การบีบอัดเชิงพื้นที่ 16 เท่า |
| ผลลัพธ์เริ่มต้น | 2048 x 2048; อัตราส่วนภาพเจ็ดแบบสูงสุด 2752 x 1536 |
| ภาพอ้างอิง | สูงสุด 10 ภาพต่อการแก้ไข |
| การแก้ไขเฉพาะจุด | วงกลม, การทำเครื่องหมายด้วยสี, หรือภาพมาสก์แยกต่างหาก |
| โมเดลเสริม | โมเดล Qwen-Image-2.1-PE-T2I และ PE-I2I สำหรับการเขียนพรอมต์ใหม่ (Qwen3.5-VL 9B fine-tunes) |
| ใบอนุญาต | Qwen Research License Agreement; การใช้งานเชิงพาณิชย์ต้องมีใบอนุญาตแยกต่างหาก |
| ทดลองใช้ | Hugging Face Space, Qwen Chat, ComfyUI (รองรับแบบเนทีฟตั้งแต่วันเปิดตัว) |
ตำแหน่งในสายผลิตภัณฑ์ Qwen-Image
Qwen-Image ดั้งเดิมเปิดตัวในเดือนสิงหาคม 2025 ในฐานะโมเดล MMDiT ขนาด 20B ที่ขึ้นชื่อเรื่องการสร้างข้อความ พร้อมกับ Qwen-Image-Edit ซึ่งเป็นโมเดลแก้ไขแยกต่างหาก ตลอดช่วงปลายปี 2025 สายผลิตภัณฑ์ได้แยกย่อยออกไปอีก: 2512 refresh สำหรับความสมจริง, Edit-2511 สำหรับความสอดคล้องของบุคคลหลายคน, และ Qwen-Image-Layered ในเดือนธันวาคมสำหรับเลเยอร์โปร่งใส Qwen-Image-2.0 ในเดือนกุมภาพันธ์ 2026 ได้รวมการสร้างและการแก้ไขเข้าไว้ในโมเดล 7B เดียวกัน พร้อมการส่งออก 2K แบบเนทีฟ
เวอร์ชัน 2.1 ยังคงขนาดและการออกแบบรวมของ 2.0 และนำความสามารถในการโปร่งใสของโมเดล Layered มาใช้ ทำให้เช็คพอยต์เดียวครอบคลุมสิ่งที่เคยต้องใช้ถึงสามโมเดล นอกจากนี้ยังได้รับเส้นทางการอนุมานใหม่ (รายละเอียดเพิ่มเติมด้านล่าง) และอินเทอร์เฟซการแก้ไขที่สร้างขึ้นรอบๆ มาสก์และภาพอ้างอิงหลายภาพ ในขณะเดียวกัน Alibaba ยังดำเนินการผลิตภัณฑ์แบบโฮสต์: Qwen Image 3.0 และ 3.0 Pro เปิดตัวในเดือนกรกฎาคม 2026 ในฐานะโมเดล API ที่ไม่มีน้ำหนักโมเดลเผยแพร่ ดังนั้นการตั้งชื่อจึงเป็นการแยกสาย ไม่ใช่ลำดับต่อเนื่อง 2.1 คือโมเดลโอเพนซอร์สที่คุณดาวน์โหลด ส่วน 3.0 คือโมเดลที่คุณเช่าใช้
มีอะไรใหม่ใน 2.1
สถาปัตยกรรมที่เบาลงและเส้นทางการแก้ไขที่เร็วขึ้น
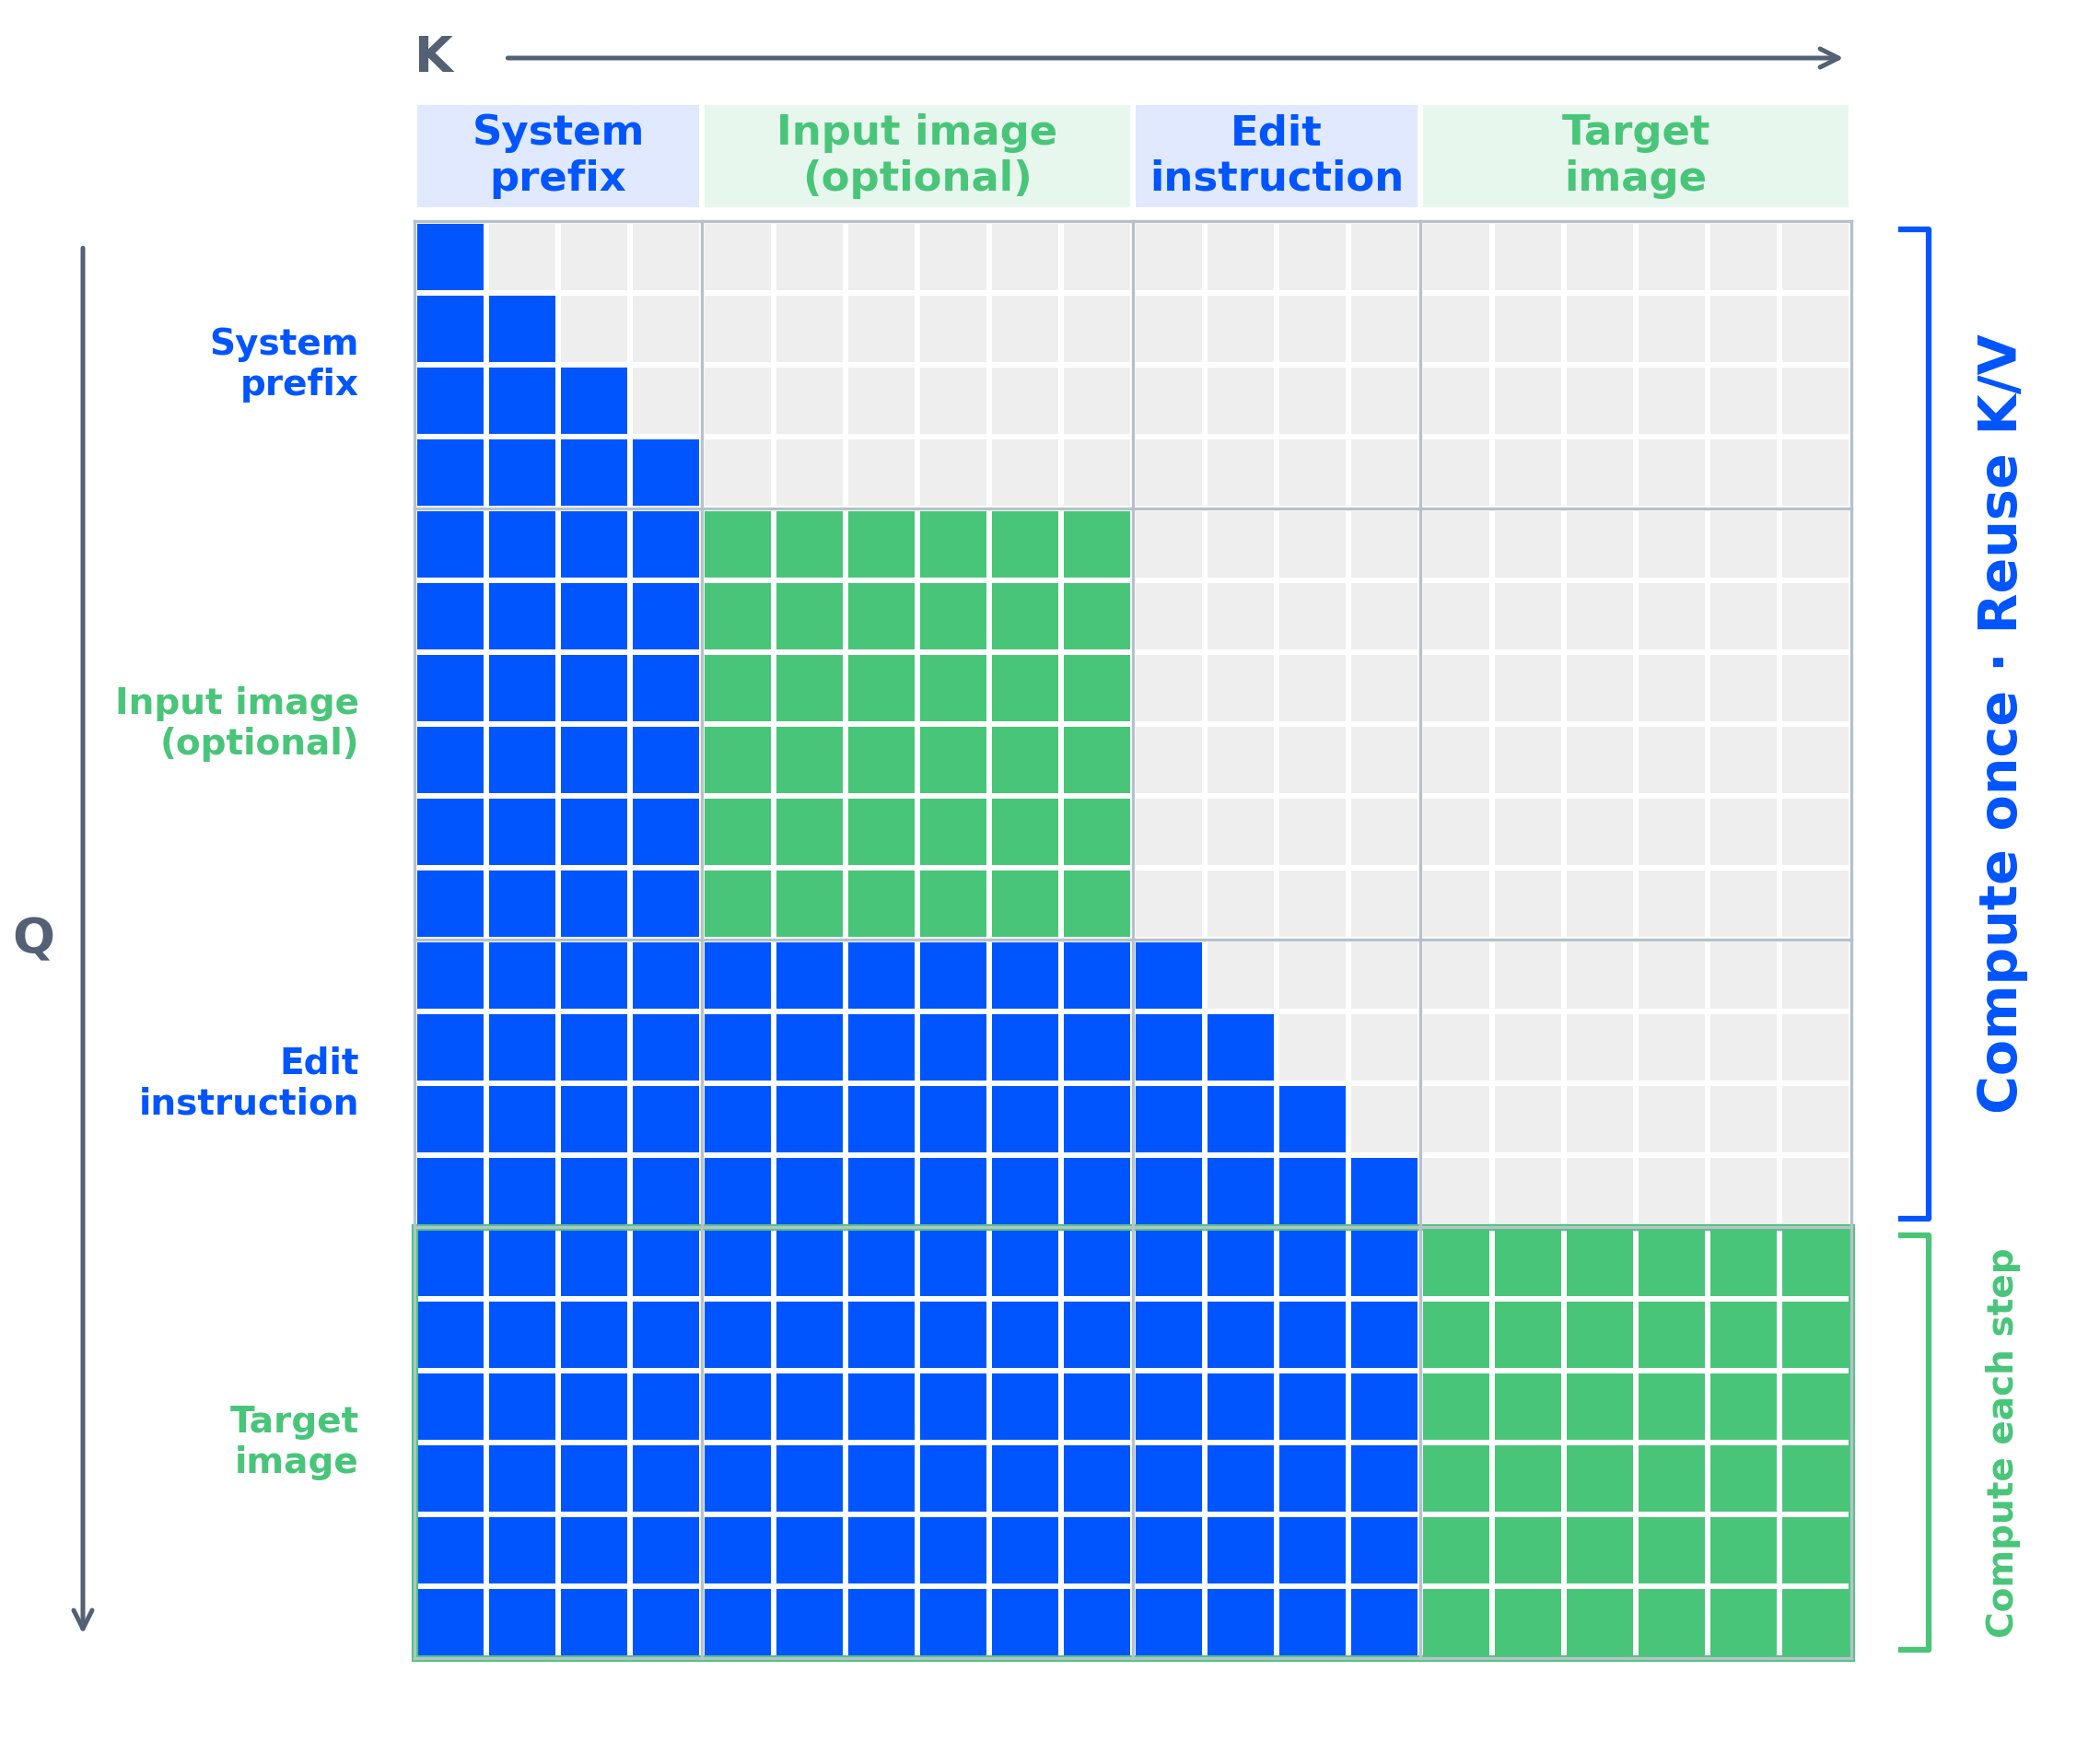
ตัวสร้างภาพ (visual generator) คือ 32 เลเยอร์ Single-Stream DiT ที่มีพารามิเตอร์ 7B จับคู่กับตัวเข้ารหัส Qwen3-VL 8B และ VAE ที่มีช่องอัลฟ่าแบบเนทีฟ วิศวกรรมที่น่าสนใจอยู่ในส่วนของ attention Qwen เรียกว่า mixed-granularity: โทเค็นข้อความ (คำนำหน้าของระบบและคำสั่งการแก้ไขของคุณ) ใช้ token-level causal mask ในขณะที่การสร้างภาพใช้ chunk-level mask เนื่องจากภาพอินพุตและคำสั่งเป็นแบบคงที่ตลอดขั้นตอนการ denoising โมเดลจึงคำนวณ key-value cache เพียงครั้งเดียวในขั้นตอนแรกและนำกลับมาใช้ใหม่ Qwen ระบุว่าผลตอบแทนคือความหน่วงที่ต่ำลงและหน่วยความจำที่น้อยลงเมื่อแก้ไขด้วยภาพอ้างอิงหลายภาพ ซึ่งเป็นภาระงานที่หนักขึ้นเมื่อมีข้อจำกัด 10 ภาพ
Scheduler เป็นแบบ flow matching โดยใช้ Euler discrete steps และโค้ดอ้างอิงจะทำงาน 40 steps โดยค่าเริ่มต้น
ความโปร่งใสแบบเนทีฟในโมเดลเดียวกัน
นี่คือหัวข้อหลัก คุณสามารถขอภาพโปร่งใสในพรอมต์และโมเดลจะส่งคืน RGBA วลีที่แนะนำจาก README นั้นตรงไปตรงมา: เริ่มต้นด้วย “This is an RGBA image with transparency” (นี่คือภาพ RGBA ที่มีความโปร่งใส) และระบุว่าพื้นหลังโปร่งใส โพสต์เปิดตัวแสดงภาพวัตถุเดี่ยว, ภาพองค์ประกอบหลายอย่าง, และกรณีการแก้ไขสามกรณีบนอินพุตโปร่งใส: การเปลี่ยนการแสดงออกของวัตถุโดยยังคงอัลฟ่าไว้, การแทนที่ข้อความภายในเลเยอร์โปร่งใส, และการแยกวัตถุจากภาพถ่าย RGB ธรรมดาให้เป็นภาพคัตเอาท์ RGBA
สำหรับทีมผลิตภัณฑ์ สิ่งนี้จะแทนที่ไปป์ไลน์สองโมเดล (สร้างแล้วมาสก์) ด้วยการเรียกเพียงครั้งเดียว นอกจากนี้ยังช่วยขจัดปัญหา halo artifacts ที่เครื่องมือลบพื้นหลังทิ้งไว้รอบๆ เส้นผมและกระจก เนื่องจากค่าอัลฟ่าถูกสร้างขึ้นมาโดยตรง ไม่ได้อนุมานภายหลัง ไม่ว่าขอบจะคมชัดที่ความละเอียด 2K บนสินทรัพย์ของคุณเองหรือไม่นั้นเป็นสิ่งที่คุณต้องทดสอบแทนที่จะสันนิษฐาน คู่มือแบบฟรี แสดงวิธีรันการทดสอบเหล่านั้นโดยไม่ต้องใช้ GPU
การแก้ไขด้วยภาพอ้างอิงสูงสุด 10 ภาพและการควบคุมพื้นที่จริง
คุณสมบัติการแก้ไขสามอย่างที่โดดเด่นในตัวอย่างการเปิดตัว:
- ภาพอ้างอิงหลายภาพ ภาพบุคคลหกภาพกลายเป็นภาพหมู่หนึ่งภาพ; แบบจำลอง, เสื้อผ้า, รองเท้า, กระเป๋า และหมวก กลายเป็นชุดที่สมบูรณ์; ภาพเฟอร์นิเจอร์สิบภาพกลายเป็นห้องที่ตกแต่งแล้ว มีข้อจำกัดที่ 10 ภาพอินพุต
- การแก้ไขเฉพาะจุดสามวิธี วาดวงกลมสีและระบุแต่ละจุดด้วยสีในพรอมต์ (“ลบนาฬิกาในวงกลมสีน้ำเงิน”), ระบายสีทับบริเวณ, หรือส่งภาพต้นฉบับที่ไม่ถูกแตะต้องพร้อมมาสก์แยกต่างหากเป็นอินพุตสองอย่างเพื่อไม่ให้สิ่งใดในแหล่งที่มาถูกปกปิด
- ความแม่นยำ (Fidelity) Qwen ระบุว่าอัตลักษณ์ใบหน้าและข้อความ, พื้นผิว, และรูปร่างของผลิตภัณฑ์ยังคงอยู่ได้ดีกว่าในเวอร์ชัน 2.0 โพสต์แสดงคู่ภาพก่อนและหลัง แต่ไม่มีตัวเลขเมตริก ดังนั้นจึงถือว่าเป็นข้อเรียกร้องที่ต้องตรวจสอบด้วย SKU ของคุณเอง
เส้นทางการแก้ไขเดียวกันนี้สามารถจัดการภาพพาโนรามาจากเซลฟี่, อินโฟกราฟิกจากภาพถ่ายสินค้า, และสตอรี่บอร์ดจากแผ่นตัวละครสามมุม การแก้ไขเฉพาะจุดแบบลำดับสามารถนำมารวมกันเป็นแอนิเมชั่นสั้นๆ ซึ่งโพสต์สาธิตด้วยคลิปคาปิบาร่า
คุณภาพการพิมพ์และภาพบุคคล
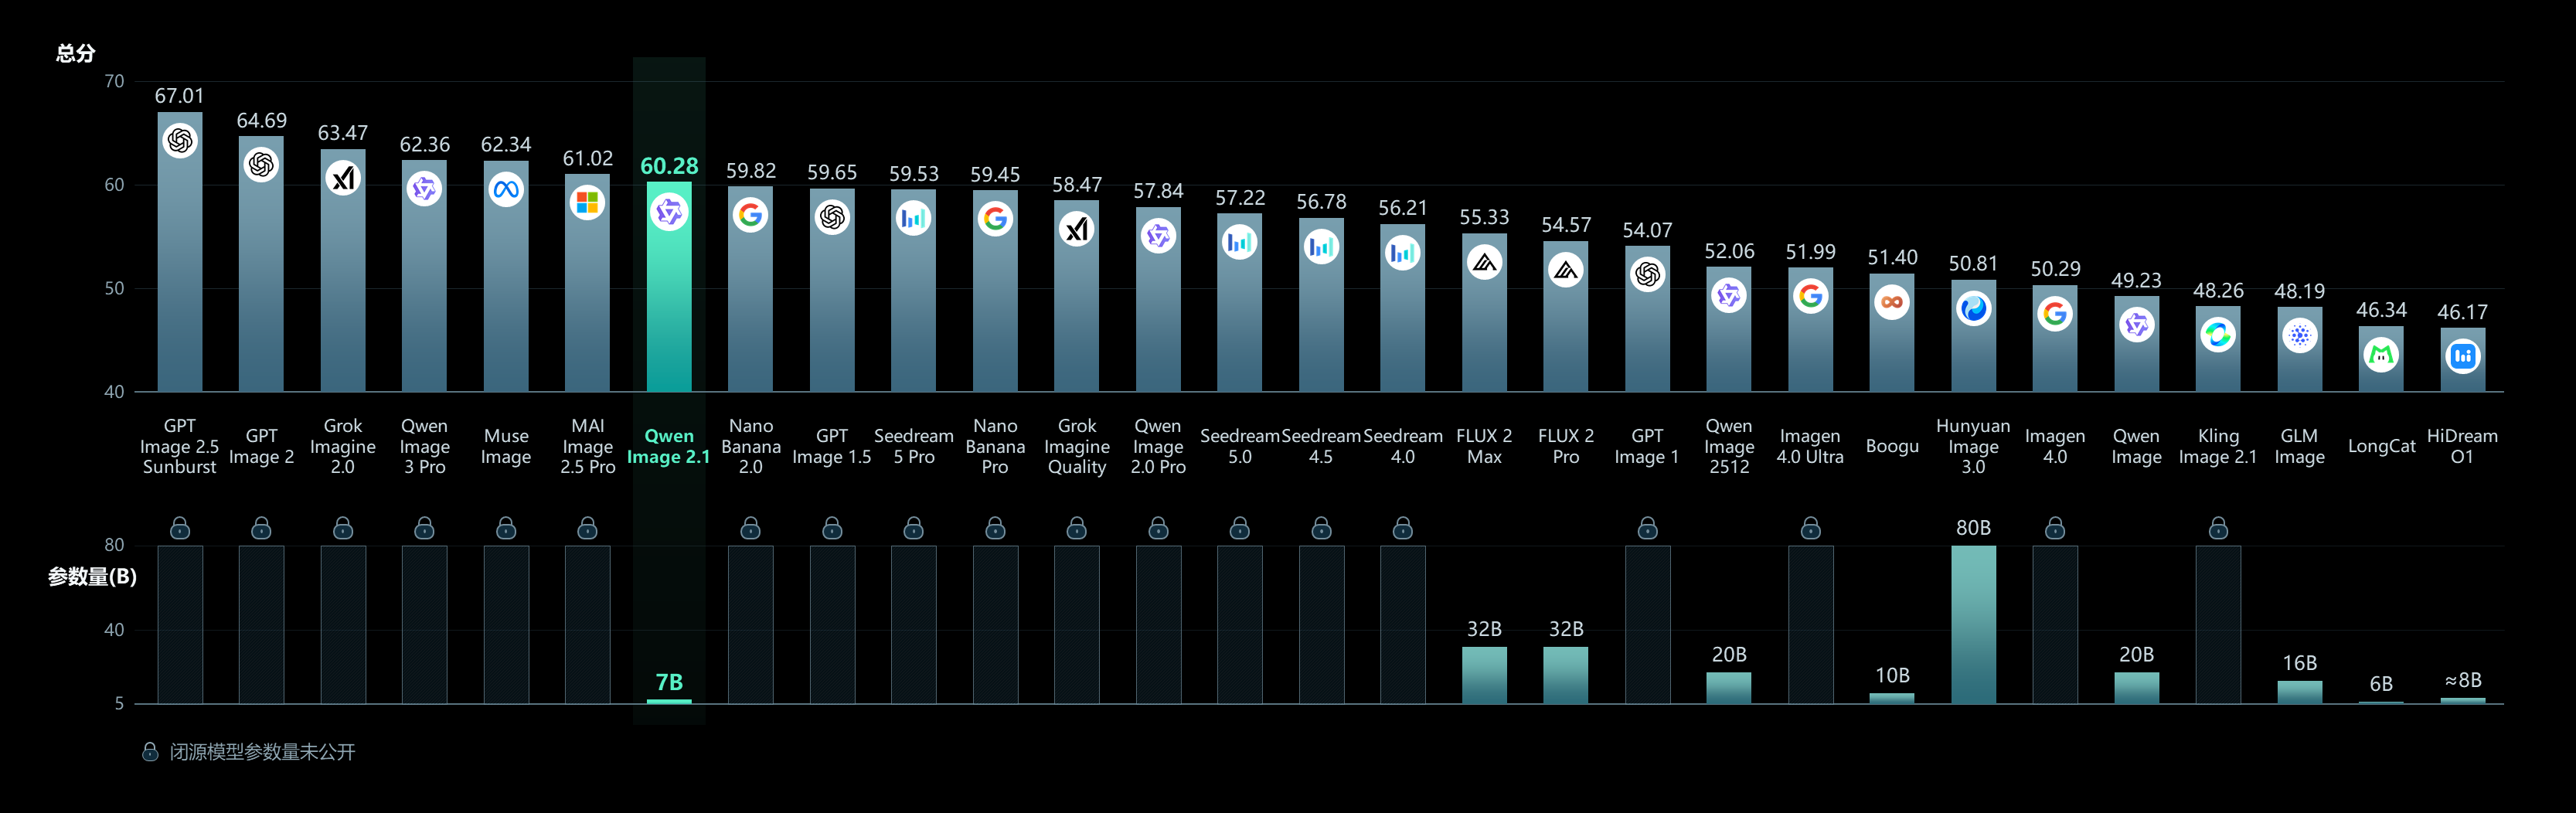
Qwen เป็นผู้นำในการสร้างข้อความแบบโอเพนซอร์สมาตั้งแต่ Qwen-Image รุ่นแรก และ 2.1 ได้ขยายความสามารถนี้ไปสู่สไตล์ตัวอักษร, การจัดวาง, และการจัดตำแหน่งข้อความในองค์ประกอบ ไม่ใช่แค่การสะกดเท่านั้น แสงภาพบุคคลและรายละเอียดปลีกย่อยก็ได้รับการปรับปรุงเช่นกัน โพสต์เปิดตัวสนับสนุนสิ่งนี้ด้วยแผนภูมิ Qwen-Image-Bench ที่เปรียบเทียบกับโมเดลแบบโอเพนซอร์สและแบบปิด; แผนภูมิดังกล่าวเป็นภาพและโพสต์ไม่ได้ระบุตัวเลขใดๆ ดังนั้นเราจึงไม่ได้อ้างอิงตัวเลขใดๆ ที่นี่
ใบอนุญาต: Open Weights, เงื่อนไขสำหรับการวิจัย
Qwen-Image ดั้งเดิมอยู่ภายใต้ใบอนุญาต Apache 2.0 ส่วน Qwen-Image-2.1 เผยแพร่ภายใต้ Qwen Research License Agreement และ ข้อความใบอนุญาต นั้นสั้นและชัดเจนในประเด็นสำคัญ:
- คุณไม่สามารถใช้โมเดล “เพื่อวัตถุประสงค์เชิงพาณิชย์ใดๆ โดยไม่ได้รับใบอนุญาตเชิงพาณิชย์แยกต่างหาก” ซึ่งต้องขอผ่านอีเมลจาก Qwen
- การเผยแพร่ซ้ำและงานที่ดัดแปลงต้องระบุใบอนุญาต, ข้อความ “Built with Qwen” หรือ “Improved using Qwen” และบรรทัดลิขสิทธิ์ที่ระบุชื่อ Hangzhou Tongyi Laboratory
- คุณไม่สามารถใช้ “Qwen” เป็นชื่อหลักของงานที่ดัดแปลง
- ข้อตกลงนี้อยู่ภายใต้กฎหมายจีน โดยมีเขตอำนาจศาลในหางโจว
โมเดลเสริมสำหรับการเขียนพรอมต์ก็อยู่ภายใต้เงื่อนไขเดียวกัน สำหรับโปรเจกต์งานอดิเรก, เอกสารวิจัย, หรือการประเมินภายใน สิ่งนี้ใช้ได้ดี สำหรับคุณสมบัติของ SaaS มันหมายถึงการสนทนากับ Alibaba ก่อน หรือการใช้ 3.0 API ที่เป็นแบบโฮสต์ ซึ่งมาพร้อมกับเงื่อนไขเชิงพาณิชย์ทั่วไปและราคาต่อภาพ
สองโมเดลเขียนพรอมต์ใหม่
นอกเหนือจากตัวสร้างภาพ Qwen ได้เผยแพร่ Qwen-Image-2.1-PE-T2I และ Qwen-Image-2.1-PE-I2I PE-T2I เป็น Qwen3.5-VL 9B ที่ได้รับการปรับแต่ง (fine-tuned) ซึ่งรับคำขอสั้นๆ ในภาษาใดก็ได้ และส่งคืน JSON พร้อมพรอมต์ภาษาอังกฤษโดยละเอียดและอัตราส่วนภาพที่แนะนำ PE-I2I เป็นคู่หูสำหรับการแก้ไข [ตรวจสอบ] โมเดลเหล่านี้เป็นทางเลือก และเป็นวิธีที่ Demo Space สร้างพรอมต์ที่มีโครงสร้างยาวๆ จากอินพุตบรรทัดเดียว หากคุณกำลังสร้าง API รอบ 2.1 นี่คือขั้นตอน “การปรับปรุงพรอมต์” ที่ผลิตภัณฑ์อย่าง ChatGPT Images ทำโดยไม่แสดงให้เห็น
สิ่งที่การเปิดตัวไม่ได้กล่าวถึง
- ไม่มีตัวเลข VRAM ตามความละเอียด README ชี้ไปที่
enable_model_cpu_offload(), vLLM-Omni พร้อม FP8, SGLang, และ LightX2V สำหรับการให้บริการที่เบาหรือเร็วขึ้น รวมถึงการรองรับ AMD แต่ไม่มีตาราง - ไม่มีตัวเลขผลการทดสอบที่เผยแพร่ มีเพียงแผนภูมิเท่านั้น
- ยังไม่มี Hosted API สำหรับ 2.1 บน Model Studio ณ วันที่เปิดตัว [ตรวจสอบ]; สายผลิตภัณฑ์แบบโฮสต์คือ 3.0
- ไม่มีการอ้างสิทธิ์ความเร็วการอนุมานที่แน่นอน มีเพียง “ประสิทธิภาพที่ดีขึ้น” จากการนำ KV cache กลับมาใช้ใหม่
การนำไปใช้งานผ่าน API และการทดสอบ
ทีมส่วนใหญ่จะไม่เรียกใช้ diffusers pipeline จากโค้ดแอปพลิเคชัน พวกเขาจะห่อมันไว้ในบริการ HTTP บนเครื่อง GPU และเรียกใช้บริการนั้น เมื่อมันกลายเป็น endpoint มันก็คือ API เหมือนกับ API อื่นๆ และ Apidog คือที่ที่คุณออกแบบและทดสอบมัน: กำหนด schema ของคำขอ (prompt, ภาพอ้างอิงเสริม, อัตราส่วนภาพ, แฟล็กความโปร่งใส), ส่งการเรียกจริง, ตรวจสอบว่าการตอบกลับเป็น PNG ที่มีช่องอัลฟ่า, และเปลี่ยนกรณีที่ดีให้เป็นชุดทดสอบ regression ที่คุณจะรันใหม่ทุกครั้งที่อัปเดตโมเดล คุณยังสามารถ mock endpoint ได้เพื่อให้ทีม frontend สร้างตามสัญญาที่เสถียรในขณะที่ GPU กำลังทำงาน คู่มือ how-to guide จะแนะนำขั้นตอนการใช้ wrapper และการทดสอบ Apidog ทีละขั้นตอน
ดาวน์โหลด Apidog เพื่อทำตาม
คำถามที่พบบ่อย
Qwen-Image-2.1 สามารถใช้งานเชิงพาณิชย์ได้ฟรีหรือไม่? ไม่ได้ หากไม่ได้รับใบอนุญาตเชิงพาณิชย์แยกต่างหากจาก Qwen น้ำหนักโมเดลสามารถดาวน์โหลดและใช้งานได้ฟรีเพื่อวัตถุประสงค์ในการวิจัยและไม่ใช่เชิงพาณิชย์ ดูส่วนใบอนุญาตด้านบนและ คู่มือแบบฟรี สำหรับวิธีทดลองใช้โดยไม่มีค่าใช้จ่าย
2.1 แตกต่างจาก Qwen-Image-2.0 อย่างไร? ขนาด 7B เท่ากันและการออกแบบการสร้างภาพและการแก้ไขที่รวมเป็นหนึ่งเดียวเหมือนกัน สิ่งใหม่ใน 2.1 คือ: การส่งออกและแก้ไข RGBA แบบเนทีฟ, ภาพอ้างอิงสูงสุด 10 ภาพ, การแก้ไขเฉพาะจุดที่ขับเคลื่อนด้วยมาสก์และคำอธิบาย, เส้นทางการ attention แบบ mixed-granularity พร้อมการนำ KV cache กลับมาใช้ใหม่เพื่อการแก้ไขภาพหลายภาพที่เร็วขึ้น, และการปรับปรุงการพิมพ์และรายละเอียดภาพบุคคล
มันเหมือนกับ Qwen Image 3.0 หรือไม่? ไม่ 3.0 และ 3.0 Pro เป็นโมเดล API แบบโฮสต์ที่เปิดตัวในเดือนกรกฎาคม 2026 โดยไม่มีน้ำหนักโมเดลแบบโอเพนซอร์ส ส่วน 2.1 เป็นโมเดลแบบโอเพนซอร์ส การเปรียบเทียบ ครอบคลุมความแตกต่างด้านราคาและความสามารถ
ต้องใช้ฮาร์ดแวร์อะไรบ้าง? Qwen ไม่ได้เผยแพร่ข้อกำหนด VRAM โค้ดอ้างอิงโหลด pipeline ใน bfloat16 บนอุปกรณ์ CUDA หนึ่งตัวและมีการทำ CPU offload; stack การให้บริการของชุมชนเพิ่ม FP8 คาดว่าต้องใช้ GPU ระดับ data-center หรือ high-end consumer สำหรับการส่งออก 2K ที่ 40 steps
สามารถแก้ไขภาพโปร่งใสได้ ไม่ใช่แค่สร้างภาพเท่านั้นใช่หรือไม่? ใช่ ตัวอย่างการเปิดตัวแสดงการเปลี่ยนการแสดงออกของวัตถุและการแทนที่ข้อความภายในเลเยอร์โปร่งใสโดยยังคงช่องอัลฟ่าไว้ และการแยกวัตถุ RGBA ออกจากภาพถ่าย RGB
จะไปที่ไหนต่อดี
Qwen-Image-2.1 เป็นโมเดลแก้ไขแบบโอเพนซอร์สที่แข็งแกร่งพร้อมคุณสมบัติหนึ่งเดียวที่ไม่มีใครอื่นมีในเช็คพอยต์เดียว นั่นคือความโปร่งใสแบบเนทีฟ และข้อจำกัดหนึ่งที่ตัดสินใจว่าคุณสามารถใช้งานได้หรือไม่ นั่นคือใบอนุญาตสำหรับการวิจัย รันมันแบบโลคอลด้วย คู่มือการใช้งาน, ลองใช้โดยไม่ต้องมี GPU ผ่าน ตัวเลือกฟรี, และเปรียบเทียบ Hosted 3.0 API ก่อนที่คุณจะตัดสินใจ ไม่ว่าคุณจะเลือกตัวใดก็ตาม ให้ทำการทดสอบ endpoint ใน Apidog เพื่อให้การเปลี่ยนโมเดลไม่ทำให้ผลิตภัณฑ์ของคุณเสียหายโดยที่คุณไม่รู้ตัว