
OpenAI LifeVal คือ benchmark ของงานในชีวิตประจำวัน 169 งาน เช่น การ enroll ลูกเข้าโรงเรียน การจัดการงบประมาณครัวเรือน หรือการติดต่อหน่วยงานราชการ ซึ่ง AI agent ทำจนสำเร็จด้วย browser use, computer use และ connectors โดยมี rubric ให้คะแนนแต่ละครั้งที่ลอง และคะแนนคือค่าเฉลี่ย reward ตั้งแต่ 0 ถึง 1 GPT-6 Astra ได้ 80.6% ที่ effort ระดับ xhigh
นั่นคือเวอร์ชันย่อ ด้านล่างคุณจะพบว่า OpenAI สร้าง LifeVal อย่างไร คะแนนของทุกโมเดลที่เผยแพร่ (รวมถึงตัวเลขแยกตาม effort ที่อยู่แค่ในกราฟแบบอินเทอร์แอกทีฟของหน้านั้น) ตัวเลขเหล่านั้นบอกอะไรเกี่ยวกับ reasoning effort และ benchmark นี้ละอะไรไว้บ้าง
OpenAI LifeVal คืออะไร?
LifeVal เป็น benchmark ของ OpenAI Research ที่วัดว่าโมเดลทำงานบ้านในชีวิตประจำวันได้ดีแค่ไหน แทนที่จะเป็นงานเขียนโค้ดหรือตอบข้อสอบ งานทั้ง 169 งานเป็นแบบ agentic คือโมเดลจะ browse ใช้คอมพิวเตอร์ และเรียก connectors โดยมี rubric เฉพาะสถานการณ์เป็นตัวให้คะแนนผลลัพธ์
OpenAI ระบุกลุ่มงานไว้เจ็ดกลุ่ม:
- การดูแลผู้ป่วย/ผู้อยู่ในความดูแล
- สุขภาพ
- การศึกษา
- การบริหารจัดการครัวเรือน
- การเงินส่วนบุคคล
- การช้อปปิ้ง
- การเข้าถึงบริการภาครัฐ
ตัวชี้วัดหลักคือค่าเฉลี่ย reward โดยแต่ละคะแนนจะเฉลี่ยการลองทั้งหมดภายในงานหนึ่งงาน แล้วจึงเฉลี่ยค่าเฉลี่ยของทั้ง 169 งานด้วยน้ำหนักเท่ากัน คะแนน 80.6% หมายถึง reward 0.806 หมายเหตุในกราฟเขียนว่า “No WTP weighting” ซึ่งเราจะกลับมาพูดถึงทีหลัง
OpenAI สร้างชุดงาน LifeVal อย่างไร
OpenAI ไม่ได้คิดรายการงานขึ้นมาใหม่ทั้งหมด แต่เริ่มจากวิธีที่ผู้คนใช้เวลาจริง โดยใช้ชุดข้อมูลสาธารณะสองชุดและแบบสำรวจของตัวเองอีกหนึ่งชุด:
- American Time Use Survey จาก US Bureau of Labor Statistics ซึ่งบันทึกว่าคนอเมริกันทำอะไรบ้างเป็นรายชั่วโมง
- Multinational Time Use Study ซึ่งทำให้ไดอารี่การใช้เวลาข้ามประเทศเป็นมาตรฐานเดียวกัน
- แบบสำรวจของตัวเองกับผู้ตอบ 3,995 คนที่เป็นตัวแทนเชิงประชากรศาสตร์ โดยถามว่าอยากให้ AI ช่วยตรงไหน
ข้อมูลการใช้เวลาบอก OpenAI ว่ากิจกรรมใดบ้างที่เติมเต็มวันของผู้คน ส่วนแบบสำรวจบอกว่ากิจกรรมใดบ้างที่ผู้คนอยากมอบให้ agent ทำ ส่วนที่ทับซ้อนกันกลายเป็น 169 สถานการณ์
หน้านี้แสดงการ์ดงานตัวอย่างห้าใบ แต่ละใบมีคะแนนกำกับ เหล่านี้คือตัวอย่างที่ OpenAI เลือกเอง ไม่ใช่การสุ่ม:
| งานตัวอย่าง (ที่ OpenAI เลือก) | คะแนน |
|---|---|
| Enroll in the right kindergarten after moving | 93.1% |
| Manage volunteers ahead of a flood | 98.0% |
| Find a new home for my family | 100% |
| Watch a game with grandma from far away | 96.3% |
| Meal prep for a parent with a new diabetes diagnosis | 90.4% |
คะแนน LifeVal: ทุกโมเดลของ OpenAI
กราฟแรกของ OpenAI พล็อตแต่ละโมเดลที่ reasoning effort ระดับ xhigh เทียบกับวันเปิดตัว GPT-6 Astra ใช้ “การตั้งค่า xhigh จากบล็อกเปิดตัว”
| โมเดล | วันเปิดตัว | LifeVal average reward (xhigh) |
|---|---|---|
| GPT-5.2 | 2025-12-11 | 49.3% |
| GPT-5.4 | 2026-03-05 | 73.0% |
| GPT-5.5 | 2026-04-23 | 77.4% |
| GPT-5.6 | 2026-07-09 | 80.0% |
| GPT-6 Astra | 2026-09-03 | 80.6% |
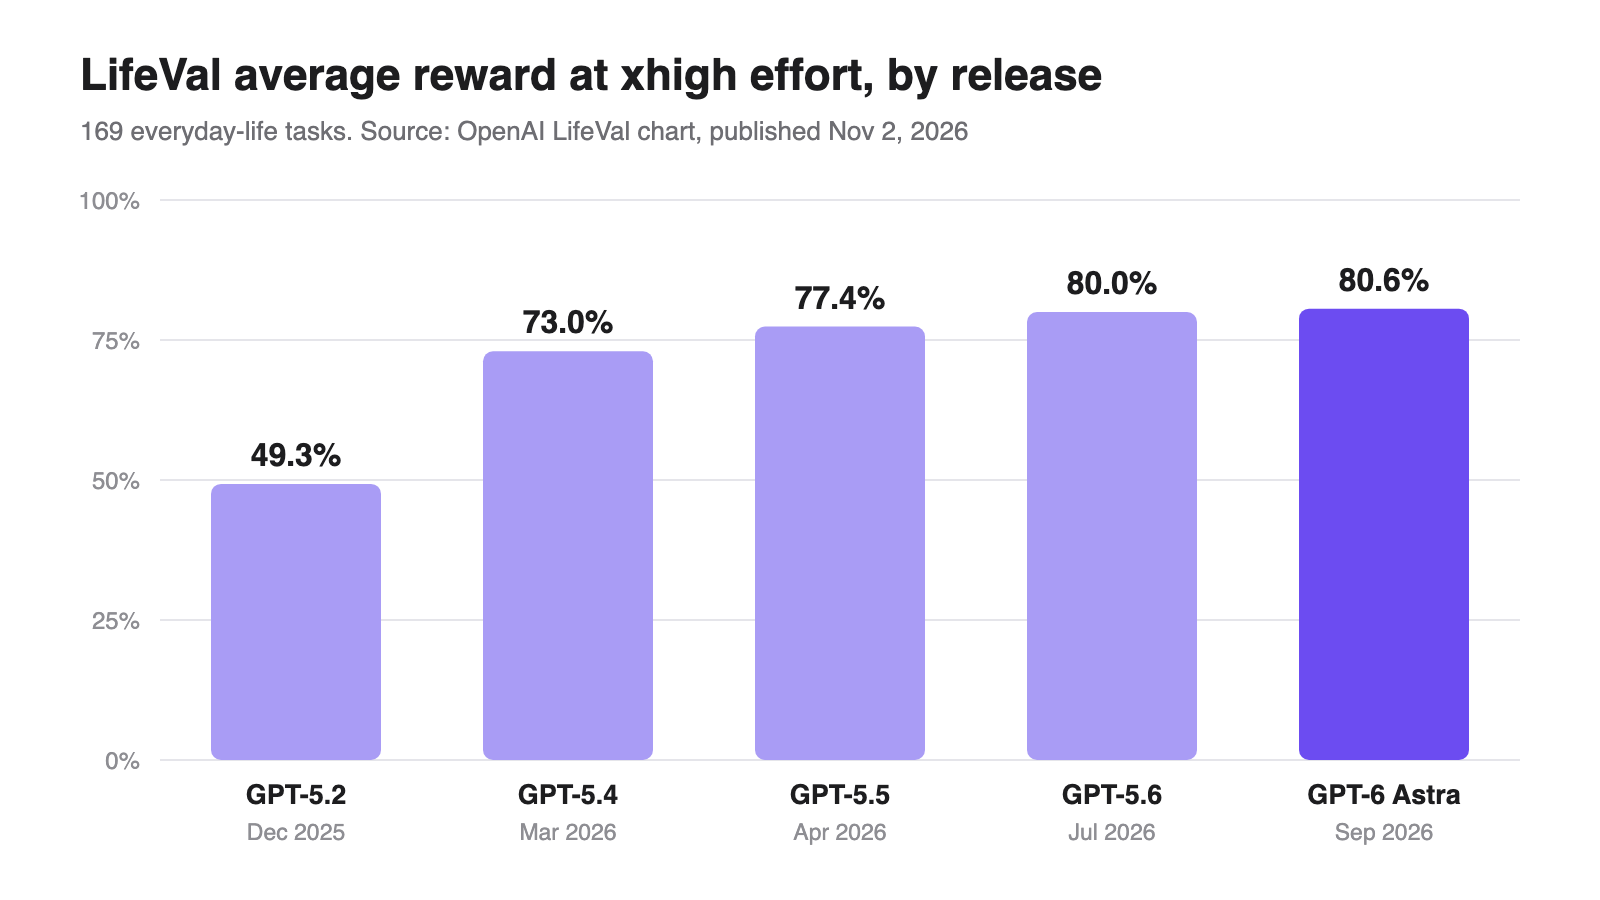
เส้นโค้งชันแล้วก็แบน GPT-5.2 ถึง GPT-5.4 เพิ่มขึ้น 23.7 คะแนนในสามเดือน สามเวอร์ชันถัดมาเพิ่มรวมกัน 7.6 คะแนน และ GPT-6 Astra ชนะ GPT-5.6 อยู่ 0.6
การกระโดดของ GPT-5.4 ไม่ได้เกี่ยวกับคุณภาพอย่างเดียว ที่ xhigh ค่าเฉลี่ย latency ลดจาก 121.0 วินาทีเหลือ 16.7 วินาที และจำนวน token ที่สร้างลดจาก 202.0K เหลือ 30.6K ต่องาน โมเดลใหม่ได้คำตอบที่ดีกว่ามากด้วย output ประมาณหนึ่งในเจ็ด
GPT-6.1 Sol และ GPT-6.1 Terra ไม่ปรากฏในกราฟทั้งสองอัน แม้ว่าทั้งคู่จะวางจำหน่ายแล้ว ไทม์ไลน์หยุดที่วันที่ 3 กันยายน 2026 ถ้าคุณกำลังเลือกระหว่าง GPT-6.1 Sol กับ Astra สำหรับผลิตภัณฑ์ agent แล้วล่ะก็ LifeVal ยังช่วยคุณไม่ได้
LifeVal แยกตาม reasoning effort
กราฟที่สองมีประโยชน์กว่า และคุณจะเห็นได้แค่เมื่อเอาเมาส์ไปวางเท่านั้น โดยแยกทุกโมเดลตาม reasoning effort พร้อมตัวเลขสี่ค่าต่อจุด ได้แก่ reward, latency, จำนวน token ที่สร้าง และ API cost นี่คือ reward ของแต่ละระดับ:
| โมเดล | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| GPT-5.2 | 27.7% | 37.2% | 45.2% | 49.3% | n/a |
| GPT-5.4 | 62.8% | 70.1% | 72.0% | 73.0% | n/a |
| GPT-5.5 | 57.1% | 71.3% | 75.6% | 77.4% | n/a |
| GPT-5.6 | 63.9% | 75.0% | 78.8% | 80.0% | 82.6% |
| GPT-6 Astra | 66.6% | 77.6% | 80.7% | 80.6% | 82.5% |
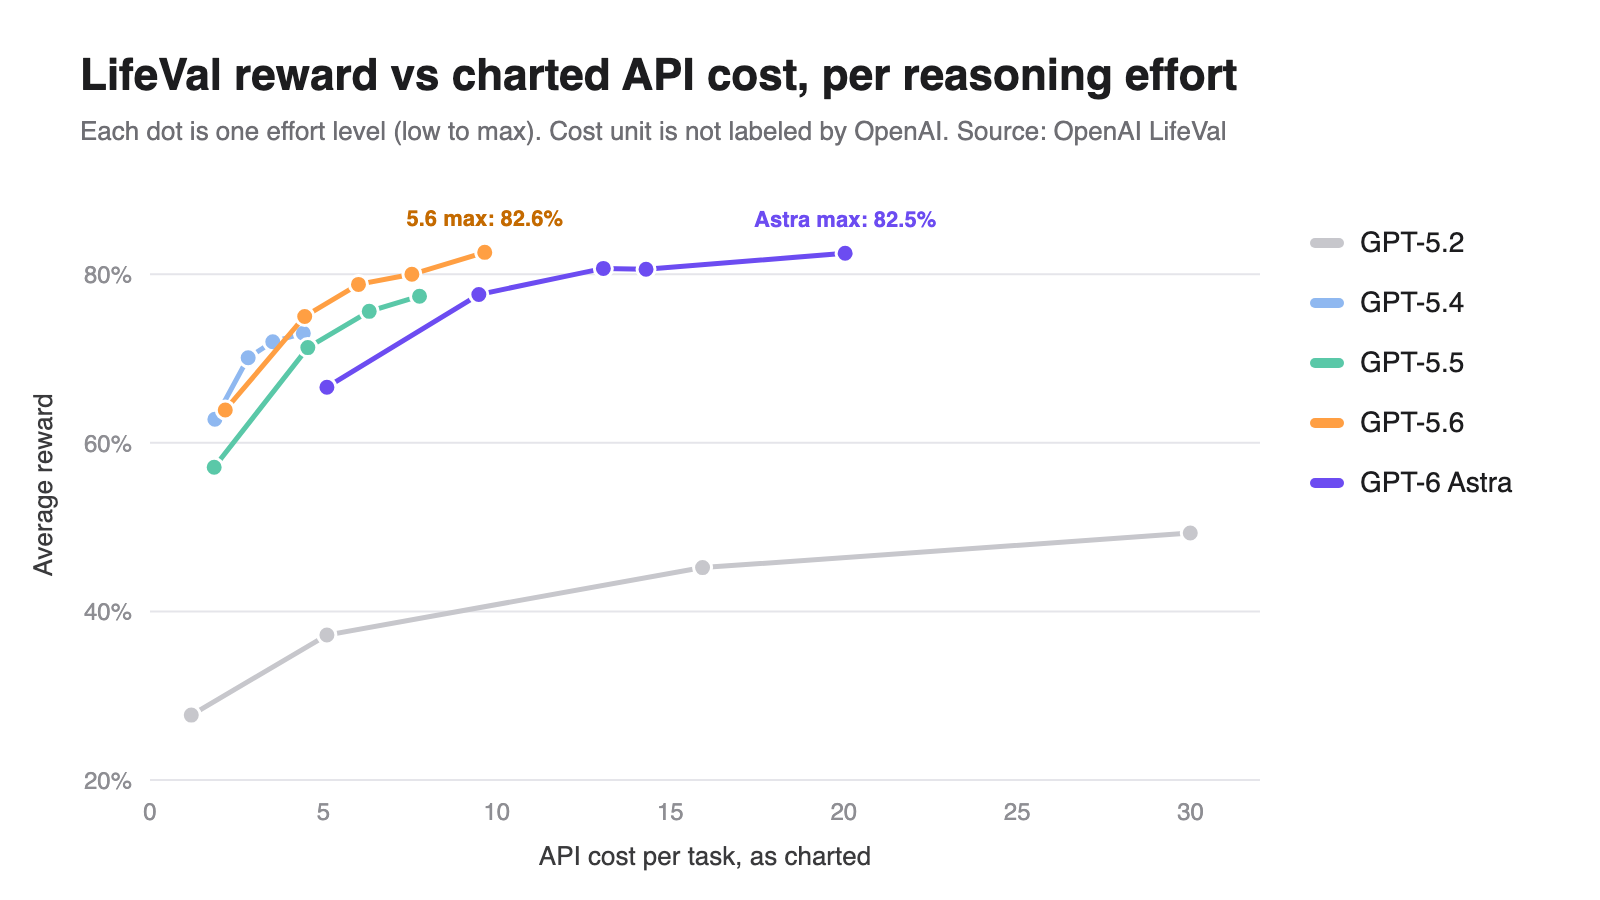
หมายเหตุเรื่องคอลัมน์ cost OpenAI ติดป้ายว่ามันคือ API cost แต่ไม่ได้ระบุหน่วย ดังนั้นขอให้ถือว่าตัวเลขด้านล่างนี้เป็น “API cost ต่องานตามที่แสดงในกราฟ” ซึ่งมีประโยชน์สำหรับดูสัดส่วน ไม่ใช่ค่าเป็นดอลลาร์
GPT-5.6 ที่ max เทียบเท่า GPT-6 Astra ที่ max
| การตั้งค่า | Reward | Latency | Tokens | Charted cost |
|---|---|---|---|---|
| GPT-5.6, max | 82.6% | 22.2 s | 29.7K | 9.65 |
| GPT-6 Astra, max | 82.5% | 20.6 s | 26.3K | 20.04 |
| GPT-5.6, xhigh | 80.0% | 17.5 s | 20.7K | 7.55 |
| GPT-6 Astra, high | 80.7% | 13.6 s | 12.4K | 13.07 |
GPT-5.6 ที่ max เฉือน Astra ที่ max อยู่ 0.1 คะแนน ด้วยต้นทุนตามกราฟประมาณครึ่งเดียว ที่ effort ระดับเดียวกัน ส่วนต่างของ Astra เหนือ GPT-5.6 น้อยกว่าสามคะแนนในทุกการตั้งค่า คือ 0.6 ที่ xhigh และหายไปเลยที่ max Astra เร็วกว่าเล็กน้อยและใช้ token น้อยกว่า แต่กับงานเหล่านนี้คุณจ่ายแพงกว่าประมาณสองเท่า บทความ GPT-5.6 pricing breakdown และ GPT-6 Astra API guide ของเรามีอัตราค่าบริการต่อ token หากคุณอยากเทียบสัดส่วนนั้นกับทราฟฟิกของคุณเอง
การเพิ่ม reasoning เกิน “high” แทบไม่ได้อะไรเลย
ใน GPT-6 Astra ระดับ high ได้ 80.7% และ xhigh ได้ 80.6% effort ที่เพิ่มขึ้นต้องแลกด้วยเวลาเพิ่ม 1.4 วินาทีและ token เพิ่ม 2.1K เพื่อคะแนนที่ต่ำลงเล็กน้อย GPT-5.4 ก็มีลักษณะเดียวกัน คือได้เพิ่มแค่หนึ่งคะแนนจาก high ไป xhigh
กำไรก้อนใหญ่อยู่ช่วงล่างของเส้นโค้ง การเลื่อน GPT-5.5 จาก low ไป medium เพิ่ม 14.2 คะแนน การเลื่อนจาก high ไป xhigh เพิ่ม 1.8 คะแนน ถ้า agent ของคุณทำงานในชีวิตประจำวันแบบนี้ medium หรือ high คือระดับที่ควรลองก่อน reasoning guide ของ OpenAI อธิบายว่าพารามิเตอร์ effort ทำงานอย่างไรใน Responses API
LifeVal ละอะไรไว้บ้าง
LifeVal เป็นสัญญาณที่มีประโยชน์ แต่เป็นสัญญาณที่ผู้ขายรายงานเอง ก่อนจะอ้างอิงมัน ควรรู้ข้อจำกัด
- มันไม่เปิดเผยต่อสาธารณะ ไม่มีชุดงานให้ดาวน์โหลด ไม่มี leaderboard สาธารณะ และ OpenAI ก็ไม่ได้เผยแพร่ rubric หรือวิธีการปรับเทียบ grader ของตัวเอง คุณจึงรันซ้ำไม่ได้
- มันให้คะแนนแค่โมเดลของ OpenAI ไม่มี Claude, Gemini หรือโมเดล open-weight ปรากฏอยู่เลย มันจึงไม่ได้บอกอะไรเกี่ยวกับว่า GPT-6.1 Sol เทียบกับ Claude Sonnet 5.5 เป็นอย่างไร หรือการเทียบข้ามผู้ขายอื่น ๆ
- มีเวอร์ชันถ่วงน้ำหนักอยู่ที่ไหนสักแห่ง กราฟเขียนว่า “No WTP weighting” โดย WTP ย่อมาจาก willingness to pay นั่นแสดงว่า OpenAI คำนวณหรือพิจารณาเวอร์ชันที่ถ่วงน้ำหนักด้วยสิ่งที่ผู้คนยินดีจ่ายสำหรับแต่ละงาน และไม่ได้เผยแพร่มัน
- การ์ดตัวอย่างถูกคัดมือ การ์ดห้าใบในหน้าได้คะแนน 90.4% ถึง 100% แต่ค่าเฉลี่ย 169 งานของโมเดลที่ดีที่สุดคือ 80.6% ตัวอย่างแสดงวันที่ดีที่สุดของ benchmark ไม่ใช่วันทั่วไป
ทั้งหมดนี้ไม่ได้ทำให้ LifeVal ผิด มันแค่ทำให้มันเป็น vendor benchmark ให้อ่านแบบที่คุณอ่านกราฟเปิดตัวใด ๆ นั่นคือเป็นคำกล่าวอ้างที่คุณทดสอบได้บนงานของคุณเอง
รันการทดสอบ reasoning effort ของคุณเองด้วย Apidog CLI
ตารางแยกตาม effort ของ LifeVal คือเส้นโค้ง reward เทียบกับ cost คุณวาดเส้นโค้งแบบเดียวกันสำหรับ prompt ของตัวเองได้ แทนที่จะยิง request ด้วยมือ ลองมอบงานให้ coding agent ของคุณแล้วให้มันขับ Apidog CLI
ติดตั้ง CLI ล็อกอิน แล้วเพิ่ม Apidog skill ให้ agent ของคุณ:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นส่ง prompt เดียวให้ Claude Code, Codex หรือ Cursor:
In Apidog project <projectId>, add a POST https://api.openai.com/v1/responses
endpoint that sends {{model}}, reasoning.effort = {{effort}} and my test prompt.
Create a test case that asserts status 200 and saves latency,
usage.output_tokens and usage.output_tokens_details.reasoning_tokens.
Add a test data set with effort = low, medium, high, xhigh, run the case
once per row against environment <envId>, and give me a table of
latency, tokens and estimated cost per effort.
agent จะอ่าน schema ของ payload แต่ละอัน ตรวจสอบ JSON ของมัน แล้วเขียนว่า:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json

apidog test-case category --project <projectId>
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json

apidog cli-schema validate test-data-create --file efforts.json
apidog test-data create --project <projectId> --file efforts.json

apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d <testDataId> -r cli,json --out-dir ./effort-runs
แฟล็ก -d จะรันหนึ่งรอบต่อหนึ่งแถวข้อมูล และ -r cli,json จะให้รายงาน JSON กับ agent เพื่อสร้างตาราง เพิ่ม --upload-report ถ้าอยากไปดูการรันในแอป Apidog ทีหลัง apidog run command reference มีแฟล็กทั้งหมด และ Claude Code setup guide ครอบคลุมฝั่ง agent
รันกับ prompt จริงของคุณห้าถึงสิบอัน ไม่ใช่แค่อันเดียว LifeVal เฉลี่ยจาก 169 งานก็เพราะเหตุนี้ prompt อันเดียวจะบอกคุณเรื่องความแปรปรวนมากกว่าเรื่อง effort
คุณควรเชื่อ LifeVal ตอนเลือกโมเดลไหม?
ใช้มันเพื่อหาทิศทาง ไม่ใช่เพื่อตัดสินใจ LifeVal บอกคุณสามอย่างที่เอาไปใช้ได้จริง: โมเดลของ OpenAI เก่งขึ้นมากกับงานหลายขั้นตอนในชีวิตประจำวันระหว่างเดือนธันวาคม 2025 ถึงมีนาคม 2026, กำไรหลังจากนั้นก็น้อย, และ reasoning effort ที่สูงกว่า high แทบไม่คุ้มกับงานแบบนี้
สิ่งที่มันบอกไม่ได้คือโมเดลที่ไม่ใช่ของ OpenAI จะได้คะแนนเท่าไร งานของคุณเทียบกับ 169 งานของ OpenAI เป็นอย่างไร หรือ grader ให้รางวัลกับอะไร สำหรับเรื่องนั้น ให้รัน effort sweep ของคุณเองตามด้านบน แล้วเทียบตัวเลขที่คุณเห็นได้ GPT-6 Astra hands-on test ของเราเป็นจุดเริ่มต้นสำหรับการตรวจสอบแบบที่ควรทำ
คำถามที่พบบ่อย
LifeVal ย่อมาจากอะไร?
OpenAI ไม่ได้ขยายชื่อนี้ในหน้าเว็บ มันคือการประเมิน (“Val”) ของงานในชีวิตประจำวัน (“Life”) ได้แก่ 169 สถานการณ์แบบ agentic ในหมวดการดูแล, สุขภาพ, การศึกษา, การบริหารครัวเรือน, การเงินส่วนบุคคล, การช้อปปิ้ง และบริการภาครัฐ
GPT-6 Astra ได้คะแนน LifeVal เท่าไร?
80.6% average reward ที่ effort ระดับ xhigh ซึ่งเป็นการตั้งค่าที่ OpenAI ใช้ในบล็อกเปิดตัว Astra ที่ effort ระดับ max Astra ได้ 82.5% และที่ high ได้ 80.7%
ฉันรัน LifeVal เองได้ไหม?
ไม่ได้ OpenAI ไม่ได้เผยแพร่ชุดงาน, rubric หรือ grader คุณสามารถประมาณการวิเคราะห์ effort เทียบกับ cost บน prompt ของตัวเองได้ด้วย test harness อย่าง Apidog CLI แต่คุณไม่สามารถทำซ้ำคะแนน LifeVal ได้
LifeVal รวม Claude หรือ Gemini ไหม?
ไม่ กราฟทั้งสองอันมีแค่โมเดลของ OpenAI ตั้งแต่ GPT-5.2 ถึง GPT-6 Astra และ GPT-6.1 Sol กับ GPT-6.1 Terra ก็หายไปด้วย
คอลัมน์ cost ของ LifeVal เป็นดอลลาร์ไหม?
OpenAI ติดป้ายว่ามันคือ API cost แต่ไม่ได้ระบุหน่วย ใช้มันเพื่อเทียบการตั้งค่าต่าง ๆ กัน เช่น GPT-5.6 max ที่ 9.65 เทียบกับ Astra max ที่ 20.04 มากกว่าจะใช้เป็นตัวเลขดอลลาร์ต่องาน
ควรใช้ reasoning effort ระดับไหนสำหรับงาน agent ในชีวิตประจำวัน?
บน LifeVal ระดับ medium หรือ high เก็บกำไรได้เกือบทั้งหมด GPT-6 Astra ได้ 80.7% ที่ high และ 80.6% ที่ xhigh ดังนั้นลองทดสอบ medium และ high กับงานของคุณเองก่อนที่จะจ่ายแพงขึ้น