
Jev คือโมเดลรูปแบบใหม่จาก TypeSafe AI ไม่ได้เขียนข้อความ แต่คุณเพียงส่งสถานะของโปรแกรม ระบุคำถามที่คุณต้องการคำตอบ และจะได้รับคำตอบที่มีประเภทพร้อมความน่าจะเป็นที่ปรับเทียบแล้ว: ความน่าจะเป็นใช่/ไม่ใช่, ตัวเลือกจากรายการ หรือคะแนนตามเกณฑ์ TypeSafe เรียกสิ่งนี้ว่า “System One Model” และแนวคิดก็เรียบง่าย: การเรียกใช้ AI ส่วนใหญ่ภายในซอฟต์แวร์ไม่ได้ต้องการข้อความ แต่ต้องการการตัดสินใจ หากคุณเคยเชื่อมโยง LLM เข้ากับตัวแยกประเภทและเขียนตัวแยกวิเคราะห์เพื่อดึงป้ายกำกับจากการตอบกลับ Jev ถูกสร้างขึ้นมาเพื่อภารกิจนั้นโดยเฉพาะ เช่นเดียวกับที่ structured outputs เป็นก้าวแรกสู่สิ่งนั้น
Jev เปิดตัวบน Vercel AI Gateway เมื่อวันที่ 16 กันยายน 2026 ซึ่งเป็นจุดที่ทำให้ Jev เป็นที่รู้จักในหมู่นักพัฒนาส่วนใหญ่ คู่มือนี้ครอบคลุมถึง Jev คืออะไร, แตกต่างจากโมเดลภาษาอย่างไร, ประเภทคำถามสามประเภท, วิธีเรียกใช้โดยตรงและผ่าน Gateway, และวิธีทดสอบและจำลอง (mock) ใน Apidog ก่อนที่จะเชื่อมโยงกับตรรกะการเราต์ของคุณ
Jev คืออะไร
โพสต์เปิดตัวของ TypeSafe อธิบาย Jev ว่าเป็น “การเรียกฟังก์ชันปัญญาขั้นสูง: สถานะที่ไม่มีโครงสร้างเข้า, การตัดสินใจเชิงความน่าจะเป็นที่มีประเภทออก” ซึ่งมีสามคุณสมบัติที่กำหนดมัน
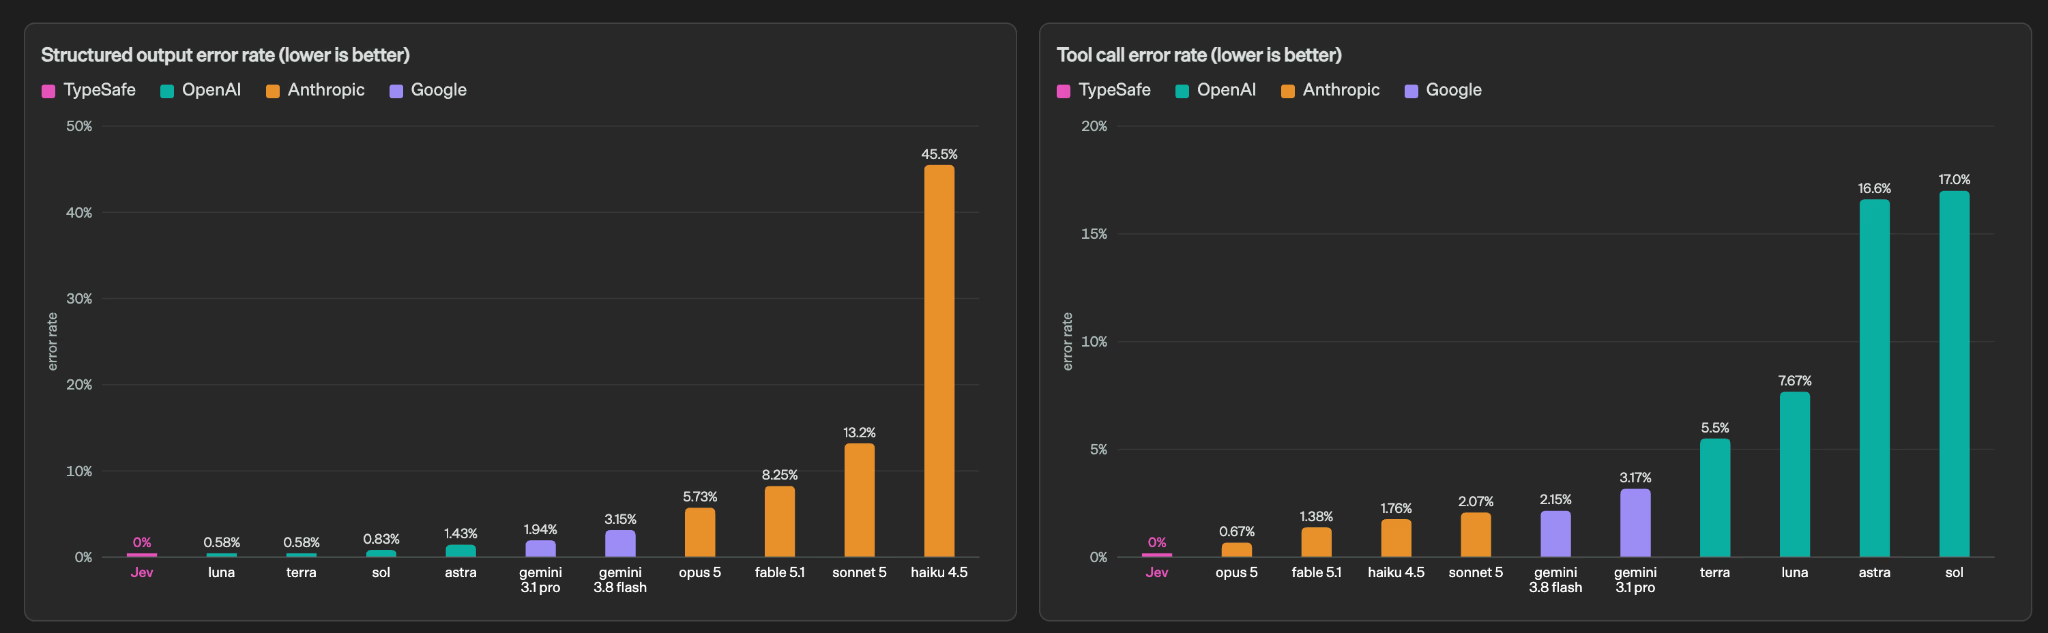
ผลลัพธ์มีประเภทและถูกประกาศก่อนการเรียกใช้ คุณกำหนดรูปแบบของแต่ละคำถามล่วงหน้า โมเดลสามารถตอบได้เฉพาะภายในรูปแบบนั้นเท่านั้น จึงไม่มีอะไรต้องแยกวิเคราะห์และไม่มีความไม่ตรงกันของ schema ให้ต้องแก้ไข TypeSafe กล่าวถึงสิ่งนี้ว่า Jev “ไม่เคยเกิดข้อผิดพลาดด้านประเภท”
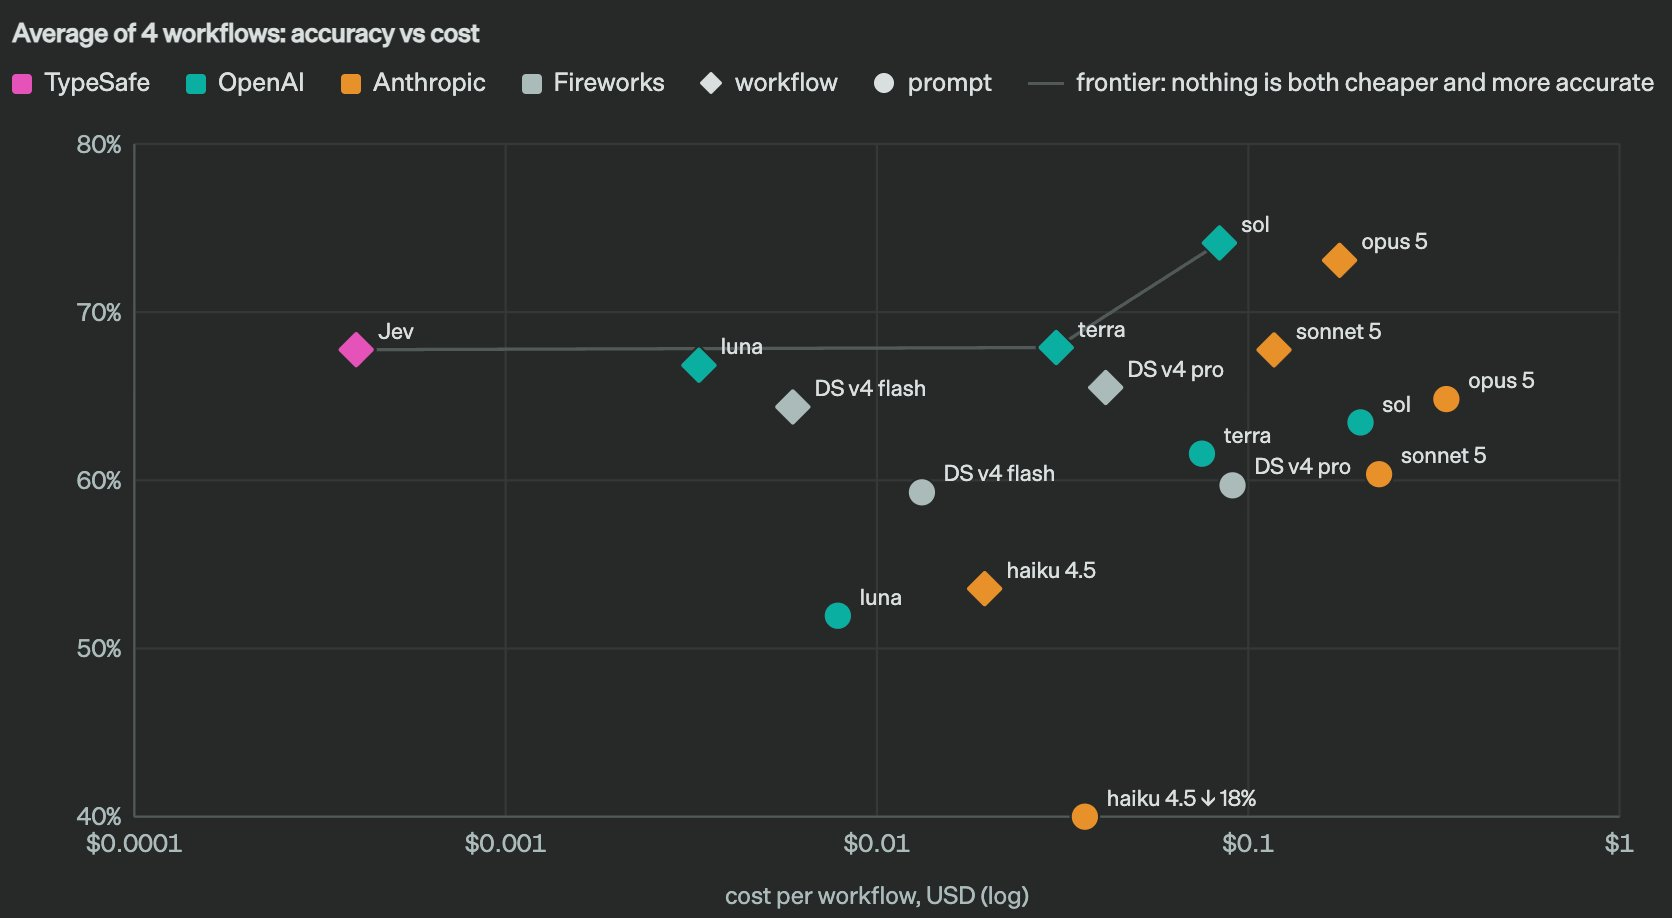
ทุกคำตอบมีความน่าจะเป็น คำถามใช่/ไม่ใช่ไม่ได้คืนค่า true; แต่คืนค่าเป็นตัวเลข เช่น 0.97 ตัวเลือกจะคืนค่าการกระจายเต็มรูปแบบของตัวเลือกทั้งหมด TypeSafe ฝึกโมเดลด้วยวิธีการที่เรียกว่า Reinforcement Learning for Calibrated Decisions และข้ออ้างคือความมั่นใจที่สูงขึ้นหมายถึงความแม่นยำที่สูงขึ้น ดังนั้นคุณสามารถกำหนดเกณฑ์: ทำให้กรณีที่ชัดเจนเป็นอัตโนมัติ และส่งกรณีที่ไม่แน่ใจไปยังมนุษย์
คำถามทั้งหมดจะได้รับคำตอบแบบขนานในการร้องขอเดียว โมเดลภาษาจะผลิตโทเค็นทีละหนึ่ง Jev จะประเมินคำถามที่ประกาศไว้ทั้งหมดพร้อมกันกับสถานะเดียวกัน ซึ่งเป็นเหตุผลที่ TypeSafe อ้างว่าเวลาตอบสนองแบบ end-to-end อยู่ที่ 70ms ถึง 500ms ตัวเลขเหล่านี้เป็นของทางผู้ขายเอง ควรพิจารณาว่าเป็นข้ออ้างที่ต้องตรวจสอบกับปริมาณงานของคุณ ไม่ใช่เกณฑ์มาตรฐาน
Jev แตกต่างจากโมเดลภาษาอย่างไร
| โมเดลภาษา | Jev | |
|---|---|---|
| ผลลัพธ์ | ข้อความอิสระที่คุณต้องแยกวิเคราะห์ | ค่าที่มีประเภทที่คุณประกาศไว้ |
| การสุ่มตัวอย่าง | ตามลำดับ, โทเค็นต่อโทเค็น | ทุกคำถามพร้อมกัน |
| ความมั่นใจ | ไม่เปิดเผยโดยค่าเริ่มต้น | ความน่าจะเป็นในทุกคำตอบ |
| ดีที่สุดสำหรับ | การเขียน, แชท, สรุป | การตัดสินใจ, การจัดเส้นทาง, การให้คะแนน, การตรวจสอบ |
| อินพุต | ข้อความ | สถานะที่มีโครงสร้าง: สตริง, ออบเจกต์ หรืออาร์เรย์ |
| รูปภาพ | มักจะรองรับ | ข้อความเท่านั้น, สำหรับตอนนี้ |
การแลกเปลี่ยนเป็นไปอย่างชัดเจน: Jev ยอมแพ้การสร้างสตริงโดยสิ้นเชิง ไม่ใช่โมเดลแชทและจะไม่สรุปเอกสาร Jev เหมาะสำหรับ “คำสั่ง if-statement อัจฉริยะ” ภายในแอปพลิเคชัน: ทีมใดควรจัดการตั๋วนี้, ข้อผิดพลาดนี้รุนแรงแค่ไหน, การตอบกลับนี้ปลอดภัยที่จะส่งหรือไม่, การสร้างสำเร็จหรือไม่
ประเภทคำถามสามประเภท
API โดยตรงของ Jev เปิดเผยค่าพื้นฐานสามประเภท แต่ละประเภทเป็นอ็อบเจกต์ JSON ภายใต้คีย์ที่คุณเลือก
Noul: ความน่าจะเป็นใช่/ไม่ใช่ ชื่อของ TypeSafe สำหรับประเภทบูลีน ซึ่งจะคืนค่าความน่าจะเป็นที่คำตอบคือใช่ และคุณสามารถกำหนดเกณฑ์ในโค้ด
{ "is_urgent": { "type": "noul", "instructions": "Does this message express urgency?" } }
การตอบสนอง: { "type": "noul", "noul": 0.99 }
Choice: เลือกหนึ่งตัวเลือกจากชุดที่กำหนด criteria จะแมปชื่อตัวเลือกกับคำอธิบาย สูงสุด 255 ตัวเลือก คำตอบจะแสดงตัวเลือกอันดับแรกพร้อมกับการกระจายเต็มรูปแบบและค่าความมั่นใจ
{ "department": { "type": "choice", "instructions": "Which team should handle this?",
  "criteria": { "billing": "Charges, invoices, payment problems",
                "shipping": "Delivery status, delays, lost packages",
                "returns":  "Exchanges, refunds, damaged items" } } }
การตอบสนอง: { "type": "choice", "choice": "returns", "confidence": 1.0, "probabilities": { "returns": 1.0, "shipping": 0.0, "billing": 0.0 } }
Score: ตำแหน่งบนมาตราส่วนเรียงลำดับ criteria เป็นอาร์เรย์ของคำอธิบายระดับ 2 ถึง 10 ระดับ โดยเริ่มจากต่ำสุด คะแนนคือตำแหน่งที่ถ่วงน้ำหนักด้วยความน่าจะเป็น ดังนั้นจึงสามารถอยู่ระหว่างช่วงคะแนนได้
{ "bug_severity": { "type": "score", "instructions": "How severe is the reported issue?",
  "criteria": [ "Cosmetic; no impact to functionality",
                "Broken feature, but a workaround exists",
                "Blocking issue; no workaround" ] } }
การตอบสนอง: { "type": "score", "score": 1.3, "confidence": 0.54, "probabilities": { "0": 0.0, "1": 0.7, "2": 0.3 }, "legend": { "0": "Cosmetic...", "1": "Broken...", "2": "Blocking..." } }
ข้อสังเกตเล็กน้อยเกี่ยวกับชื่อ: ผ่าน Vercel AI SDK ประเภทใช่/ไม่ใช่เรียกว่า boolean และช่องคำตอบคือ probability ในขณะที่ API ของ TypeSafe เองเรียกว่า noul เป็นแนวคิดเดียวกันแต่ใช้คีย์ต่างกัน
สองวิธีในการเรียกใช้ Jev
โดยตรง รับคีย์ที่ console.typesafe.ai/settings/keys จากนั้นส่ง `POST https://api.typesafe.ai/v1/systemone` พร้อมกับโทเค็น `Bearer` รหัสโมเดลคือ `jev-latest` ซึ่งปัจจุบันหมายถึง `jev-1.13.0`; `jev-preview` จะชี้ไปยังรุ่นล่าสุด ไม่ว่าจะเป็นทางการหรือไม่ก็ตาม มี SDK สำหรับ Python และ JavaScript ตาม quickstart แต่เอนด์พอยต์ดิบเป็นเพียงการร้องขอ POST ครั้งเดียว ซึ่งเป็นรูปแบบที่เราจะใช้ใน Apidog
ผ่าน Vercel AI Gateway รหัสโมเดลคือ `typesafe-ai/jev` และคุณสามารถเรียกใช้ด้วย `experimental_evaluate` จาก AI SDK (เวอร์ชัน 7 หรือใหม่กว่า) ข้อควรระวังหนึ่งจาก เอกสารประกอบการประเมิน: การประเมินสามารถใช้ได้ผ่าน AI SDK เท่านั้น ไม่ใช่ผ่านเอนด์พอยต์ที่เข้ากันได้กับ OpenAI หรือ Anthropic ของ Gateway หากคุณกำหนดเส้นทางโมเดลผ่าน Gateway อยู่แล้ว ดังตัวอย่างใน คู่มือ GPT-5.6 Sol บน AI Gateway ของเรา นี่คือเส้นทางที่เป็นธรรมชาติ; คู่มือ Vercel AI SDK ของเราครอบคลุมการตั้งค่า
import { experimental_evaluate as evaluate } from 'ai';

const result = await evaluate({
  model: 'typesafe-ai/jev',
  state: 'The support agent issued a full refund to the customer.',
  questions: { refunded: { type: 'boolean', instructions: 'Was a refund issued?' } },
});
// result.answers.refunded -> { type: 'boolean', probability: 0.99 }
การร้องขอครั้งแรกของคุณด้วย curl
นี่เป็นการจัดลำดับความสำคัญข้อความสนับสนุนด้วยประเภทคำถามทั้งสามในหนึ่งการเรียก:
export TYPESAFE_API_KEY="..."

curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "My card was charged twice for one order and I need this fixed today.",
    "questions": {
      "department": { "type": "choice", "instructions": "Which team handles this?",
        "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
      "urgency": { "type": "score", "instructions": "How urgent is this?",
        "criteria": ["low", "medium", "high"] },
      "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
    }
  }'
การตอบกลับจะมี model, อ็อบเจกต์ answers ที่มีคีย์เป็น ID คำถามของคุณ, และ usage ที่มี input_tokens และ output_tokens อ่านค่า answers.department.choice, answers.urgency.score, และ answers.wants_refund.noul จากนั้นใช้เกณฑ์ของคุณ
ทดสอบและจำลอง Jev ใน Apidog
โมเดลที่คืนค่าความน่าจะเป็นจะเปลี่ยนลักษณะการทดสอบไป คุณไม่ได้ยืนยันสตริงอีกต่อไป แต่คุณกำลังยืนยันว่าตัวเลขผ่านเกณฑ์ Apidog ทำให้สิ่งนี้เป็นการตรวจสอบที่บันทึกและทำซ้ำได้ แทนที่จะเป็นการเรียกใช้ curl เพียงครั้งเดียว
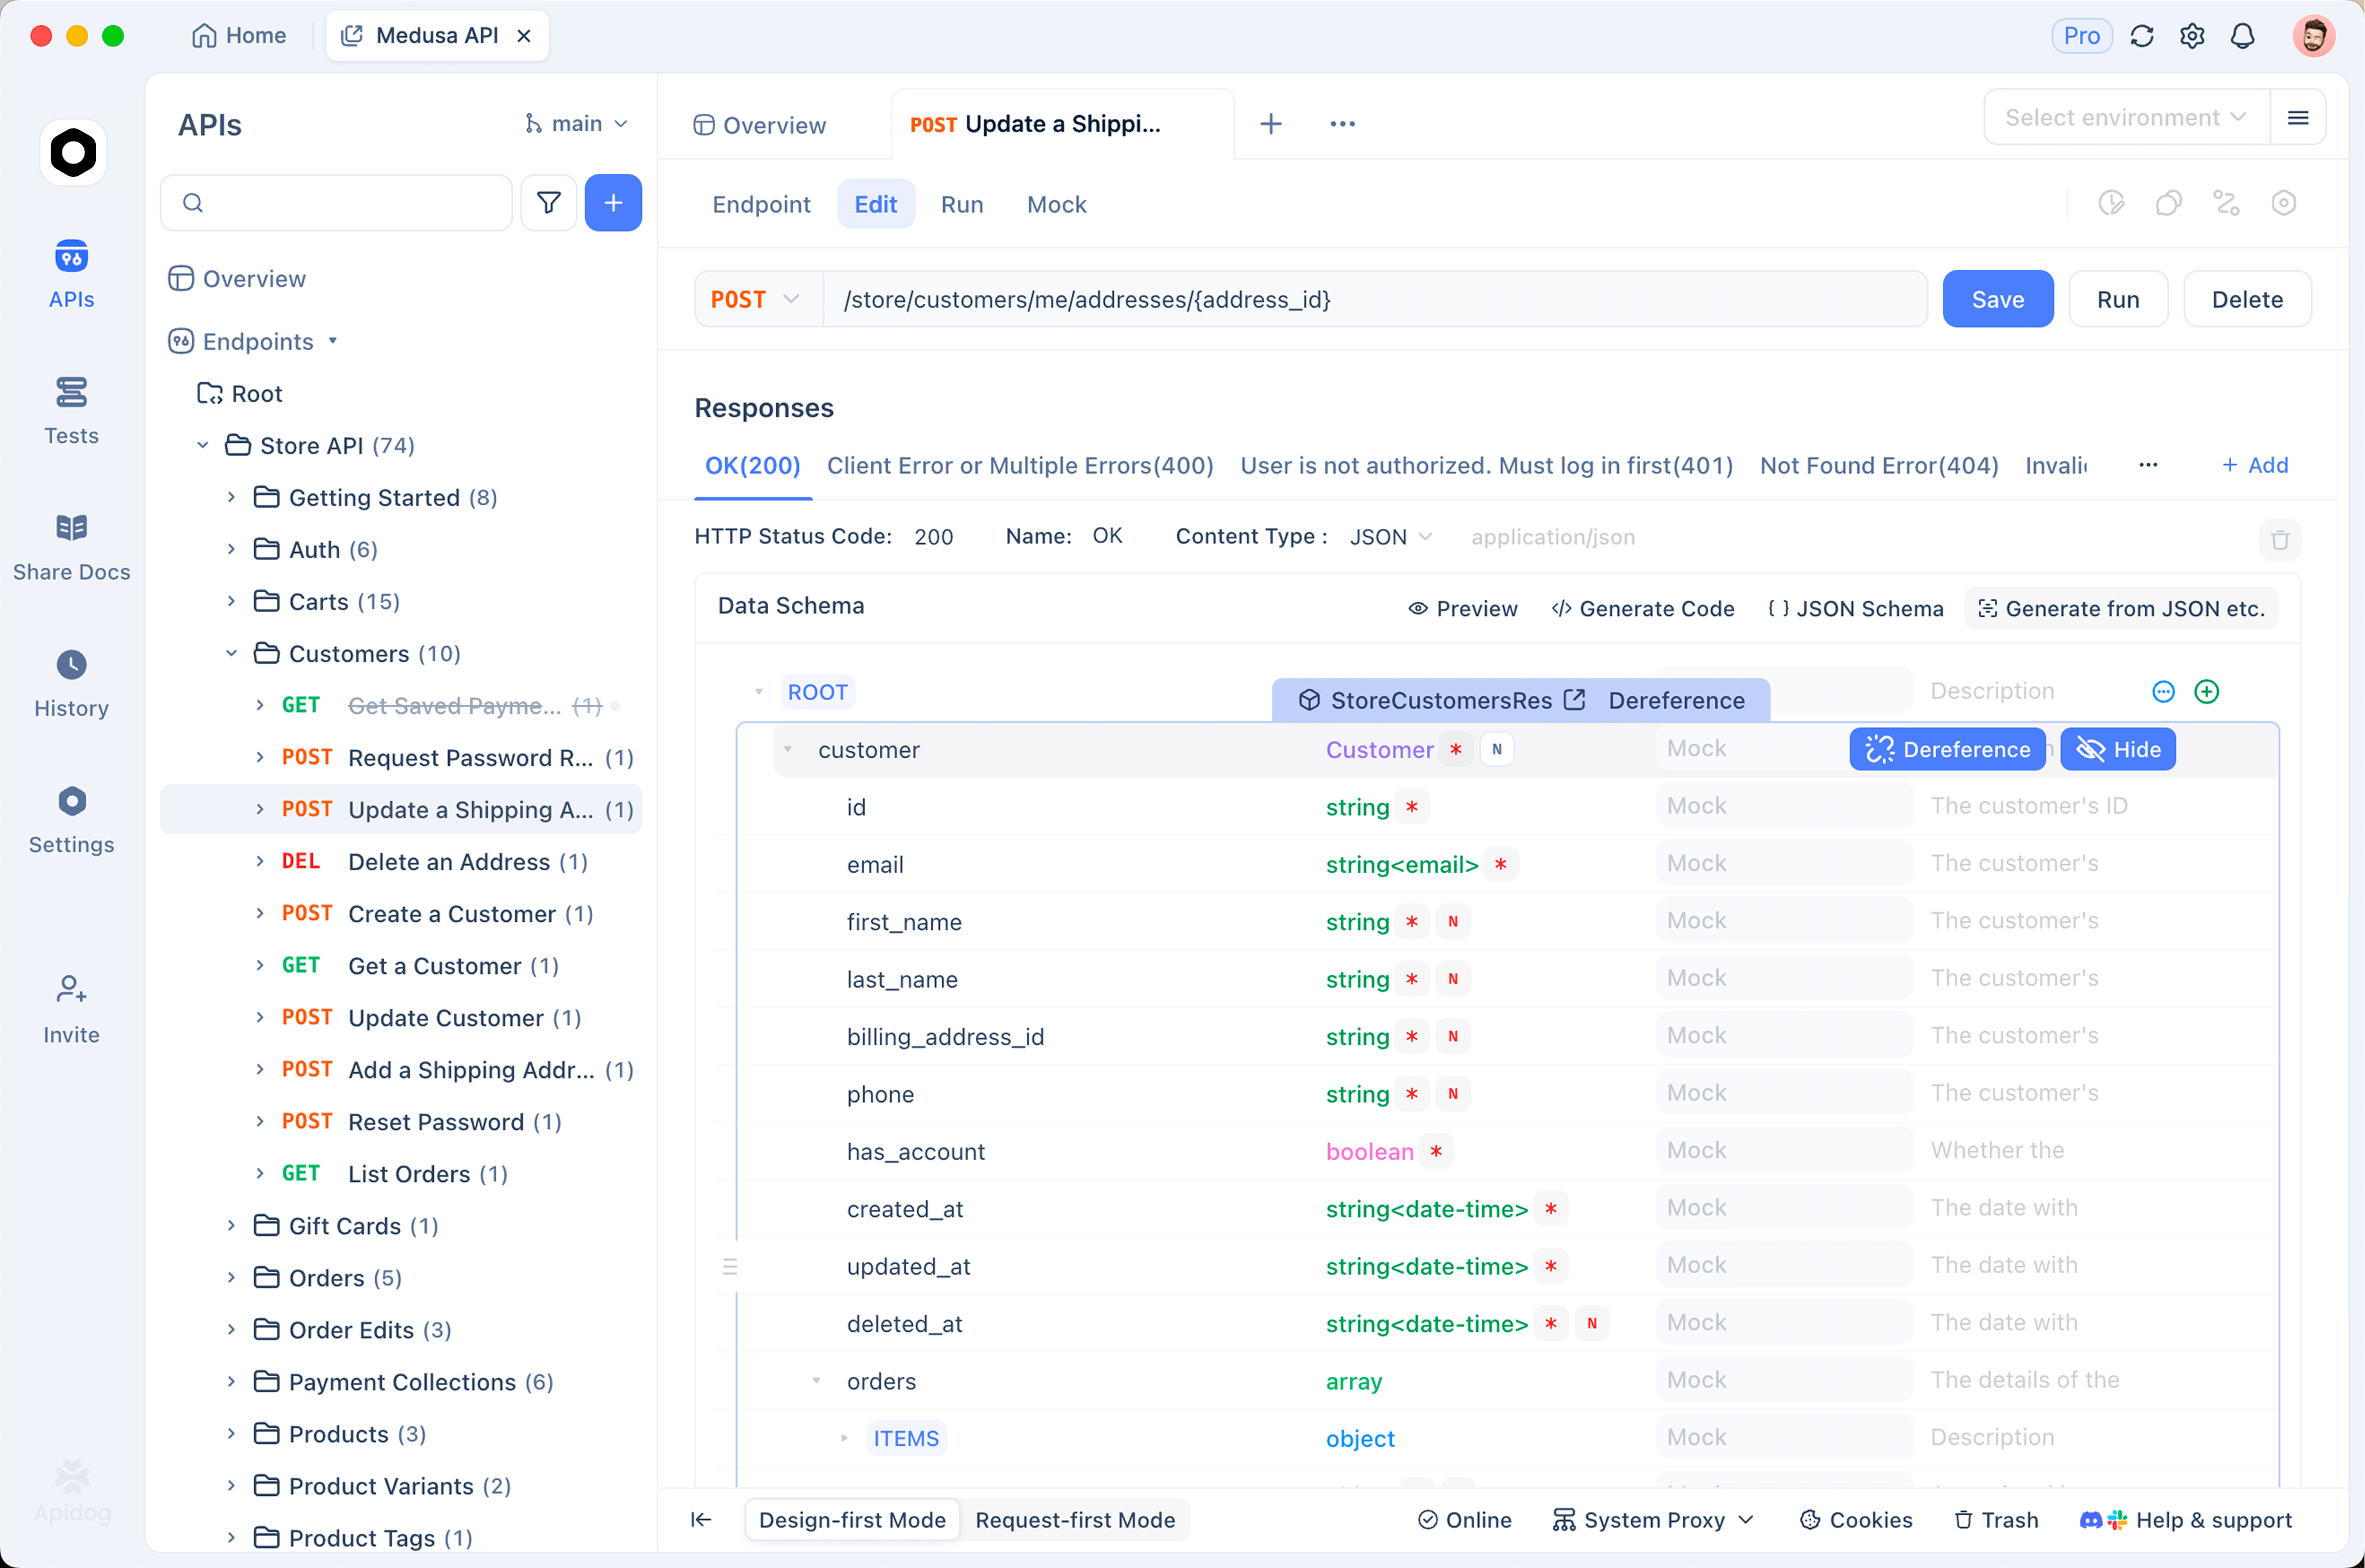
จัดเก็บคีย์ เปิด Environment Management สร้าง environment ที่ชื่อว่า TypeSafe และเพิ่ม TYPESAFE_API_KEY ด้วยค่าจริงในช่อง local เพื่อให้คีย์ยังคงอยู่ในเครื่องของคุณและไม่ซิงค์กับทีม คู่มือของเราเกี่ยวกับ environments และ secret variables ครอบคลุมกฎขอบเขต
สร้างคำขอ คำขอใหม่ `POST https://api.typesafe.ai/v1/systemone` ประเภทการยืนยันตัวตน Bearer Token พร้อม `{{TYPESAFE_API_KEY}}` ตัวเนื้อหา JSON จากตัวอย่าง curl ส่งและอ่านคำตอบในแผงการตอบสนอง
ยืนยันการตัดสินใจ ไม่ใช่ข้อความ เพิ่มการยืนยันหลังการประมวลผล เช่น answers.department.choice เท่ากับ billing, answers.wants_refund.noul มากกว่า 0.9 และ answers.urgency.score มากกว่า 1.5 ตอนนี้ข้อบกพร่องในการทำงานของ Jev หรือในคำพูดเกณฑ์ของคุณ จะทำให้การทดสอบล้มเหลว แทนที่จะเกิดการจัดเส้นทางตั๋วผิดพลาดโดยไม่รู้ตัว
จำลองสำหรับส่วนหน้า บันทึกการตอบกลับเป็น mock และ UI สำหรับตั๋วของคุณสามารถสร้างและแสดงตัวอย่างกับออบเจกต์ answers ที่เสถียรได้โดยไม่ต้องใช้โทเค็นหรือรอโมเดลทำงาน เนื่องจากรูปร่างถูกประกาศไว้ mock และการตอบสนองจริงจึงไม่สามารถแยกออกจากกันได้
บันทึกเป็นสถานการณ์ เชื่อมโยงสถานะต่างๆ เข้าด้วยกัน เช่น ข้อความที่สงบ ข้อความที่แสดงความโกรธ ข้อความที่กำกวม และยืนยันว่าความมั่นใจลดลงในกรณีที่กำกวม นั่นคือการตรวจสอบที่บอกคุณว่าเกณฑ์ของคุณทำงานได้ดี ดาวน์โหลด Apidog เพื่อตั้งค่านี้ แผนฟรีครอบคลุมทีมสี่คน
ราคา, ข้อจำกัด และข้อผิดพลาด
จาก หน้าโมเดล ของ TypeSafe:
- ราคา: 0.042 ดอลลาร์ต่อล้านโทเค็นอินพุต โทเค็นเอาต์พุตไม่คิดค่าใช้จ่าย Gateway แสดงราคาเดียวกันที่ 0.042 ดอลลาร์ต่อล้านอินพุต
- อัตราขีดจำกัด: 250,000 โทเค็นต่อวินาที และ 1,200 คำขอต่อนาที ปรับเปลี่ยนแบบไดนามิก
- บริบท: 64k โทเค็นต่อคำขอ โดย 32k สำหรับ
stateบวกกับคำถามที่ยาวที่สุด - อินพุต: เฉพาะข้อความเท่านั้น สตริง อ็อบเจกต์ JSON หรืออาร์เรย์ของข้อความ ไม่มีรูปภาพ เสียง หรือวิดีโอ
- ภาษา: ภาษาอังกฤษดีที่สุด ภาษาอื่น ๆ ทำงานได้แต่มีความแม่นยำต่ำกว่า
ข้อผิดพลาดจะส่งคืนเป็นรหัสสถานะ HTTP: `401` สำหรับคีย์ที่หายไปหรือไม่ถูกต้อง, `422` เมื่อเนื้อหาล้มเหลวในการตรวจสอบความถูกต้อง (เช่น Score ที่มีระดับเดียว, Choice ที่ไม่มีเกณฑ์), `429` สำหรับอัตราขีดจำกัด, และ `529` เมื่อบริการโอเวอร์โหลด ให้ชะลอและลองใหม่สำหรับสองกรณีหลัง; SDKs จะทำเช่นนี้โดยค่าเริ่มต้น
คำถามที่พบบ่อย
Jev เป็นสิ่งทดแทน LLM ได้หรือไม่
ไม่ได้ Jev แทนที่ส่วนหนึ่งของการเรียกใช้ LLM ที่คุณกำลังขอการตัดสินใจและแยกวิเคราะห์ข้อความเพื่อรับสิ่งนั้น การสร้างข้อความ, การสนทนา และการสรุปยังคงต้องการโมเดลภาษา
Jev สามารถสร้างข้อมูลที่ผิดพลาดได้หรือไม่
มันอาจผิดพลาดได้ แต่มันไม่สามารถผลิตคำตอบที่อยู่นอกเหนือโครงสร้างที่คุณประกาศได้ ข้อโต้แย้งของ TypeSafe คือการจับคู่ Schema ได้รับการรับประกัน ดังนั้นป้ายกำกับที่ “สร้างข้อมูลที่ผิดพลาด” จึงเป็นไปไม่ได้; ป้ายกำกับที่ผิดพลาดซึ่งมีความมั่นใจต่ำยังคงเป็นไปได้ ซึ่งเป็นเหตุผลว่าทำไมความน่าจะเป็นจึงมีความสำคัญ
“Calibrated” หมายถึงอะไรในทางปฏิบัติ
หากโมเดลบอกว่า 0.9 หมายความว่ามันควรจะถูกต้องประมาณ 90% ของเวลาในคำถามประเภทนั้น นั่นคือสิ่งที่ช่วยให้คุณสามารถเลือกเกณฑ์และทำให้เป็นอัตโนมัติเหนือกว่าเกณฑ์นั้น ทดสอบกับข้อมูลของคุณเองก่อนที่จะเชื่อตัวเลข การบันทึกสถานการณ์ใน Apidog ที่มีสถานะติดป้ายกำกับเป็นวิธีที่ประหยัดในการทำเช่นนั้น
ฉันจำเป็นต้องใช้ Vercel เพื่อใช้ Jev หรือไม่
ไม่จำเป็น API โดยตรงที่ api.typesafe.ai ทำงานได้ด้วยตัวเองด้วยคีย์ Bearer ส่วน Vercel AI Gateway เป็นความสะดวกหากคุณใช้ AI SDK อยู่แล้ว และเป็นเส้นทางเดียวที่รองรับ `experimental_evaluate` ไม่ว่ากรณีใดก็ตาม พื้นฐาน JSON Schema ที่อยู่เบื้องหลังรูปร่างที่ประกาศไว้ก็น่าเรียนรู้
Jev เหมาะกับอะไร
เลือกใช้ Jev เมื่อคำถามมีชุดคำตอบที่แน่นอนและคุณต้องการความน่าจะเป็นร่วมด้วย: การจัดเส้นทาง (routing), การจัดหมวดหมู่ (classification), การให้คะแนน (scoring), การยืนยัน (verification), การกำหนดข้อจำกัด (guardrails) เก็บโมเดลภาษาไว้สำหรับทุกสิ่งที่ต้องใช้คำศัพท์ ประกาศรูปร่าง ทดสอบเกณฑ์ใน Apidog และให้ตัวเลขความมั่นใจเป็นตัวตัดสินว่าสิ่งใดควรเป็นอัตโนมัติ