
GPT-Live-1.1 คือโมเดลเสียงแบบ full-duplex ของ OpenAI ที่เปิดให้ใช้งานผ่าน API ตั้งแต่วันที่ 20 พฤศจิกายน 2026 โมเดลนี้ฟังไปพร้อมกับพูด ส่งงานด้านการใช้เหตุผลและการเรียกใช้ tool ให้โมเดล backend ที่คุณเลือกจัดการ และคิดค่าบริการเป็นรายนาที: นาทีละ $0.05 สำหรับช่วง active และนาทีละ $0.02 สำหรับช่วง standby คุณเรียกใช้งานผ่าน endpoint เดียวคือ v1/live/sessions ไม่ใช่ Realtime API
บทความก่อนหน้าของเราเกี่ยวกับ GPT-Live คืออะไร ได้พูดถึงฟีเจอร์เสียงของ ChatGPT ก่อนที่นักพัฒนาจะเรียกใช้งานได้ บทความนี้จะกล่าวถึงโมเดล API: มีอะไรใหม่ ราคาเท่าไร session ทำงานอย่างไร และเปรียบเทียบกับ GPT-Realtime อย่างไร
GPT-Live-1.1 คืออะไร?
GPT-Live-1.1 เป็นโมเดลเสียงที่สนทนาด้วยเสียงแบบเรียลไทม์ ขณะที่โมเดล backend แยกต่างหากทำหน้าที่คิดแทน โมเดลนี้รับข้อมูลทั้งเสียงและข้อความ ส่งกลับทั้งเสียงและข้อความ และฟังต่อเนื่องขณะพูด ผู้โทรจึงสามารถขัดจังหวะหรือเพิ่มรายละเอียดกลางประโยคได้ Model ID ของมันคือ gpt-live-1.1 และรองรับการสตรีมและ function calling
หน้าโมเดล GPT-Live-1.1 อธิบายว่าเป็น “Full-duplex voice model สำหรับการสนทนาหลายภาษา” คำว่า full duplex หมายความว่าเสียงไหลไปมาพร้อมกันทั้งสองทิศทาง เหมือนการโทรศัพท์ ไม่ใช่แบบวอล์กกี้ทอล์กี้ที่ฝ่ายหนึ่งต้องรอ
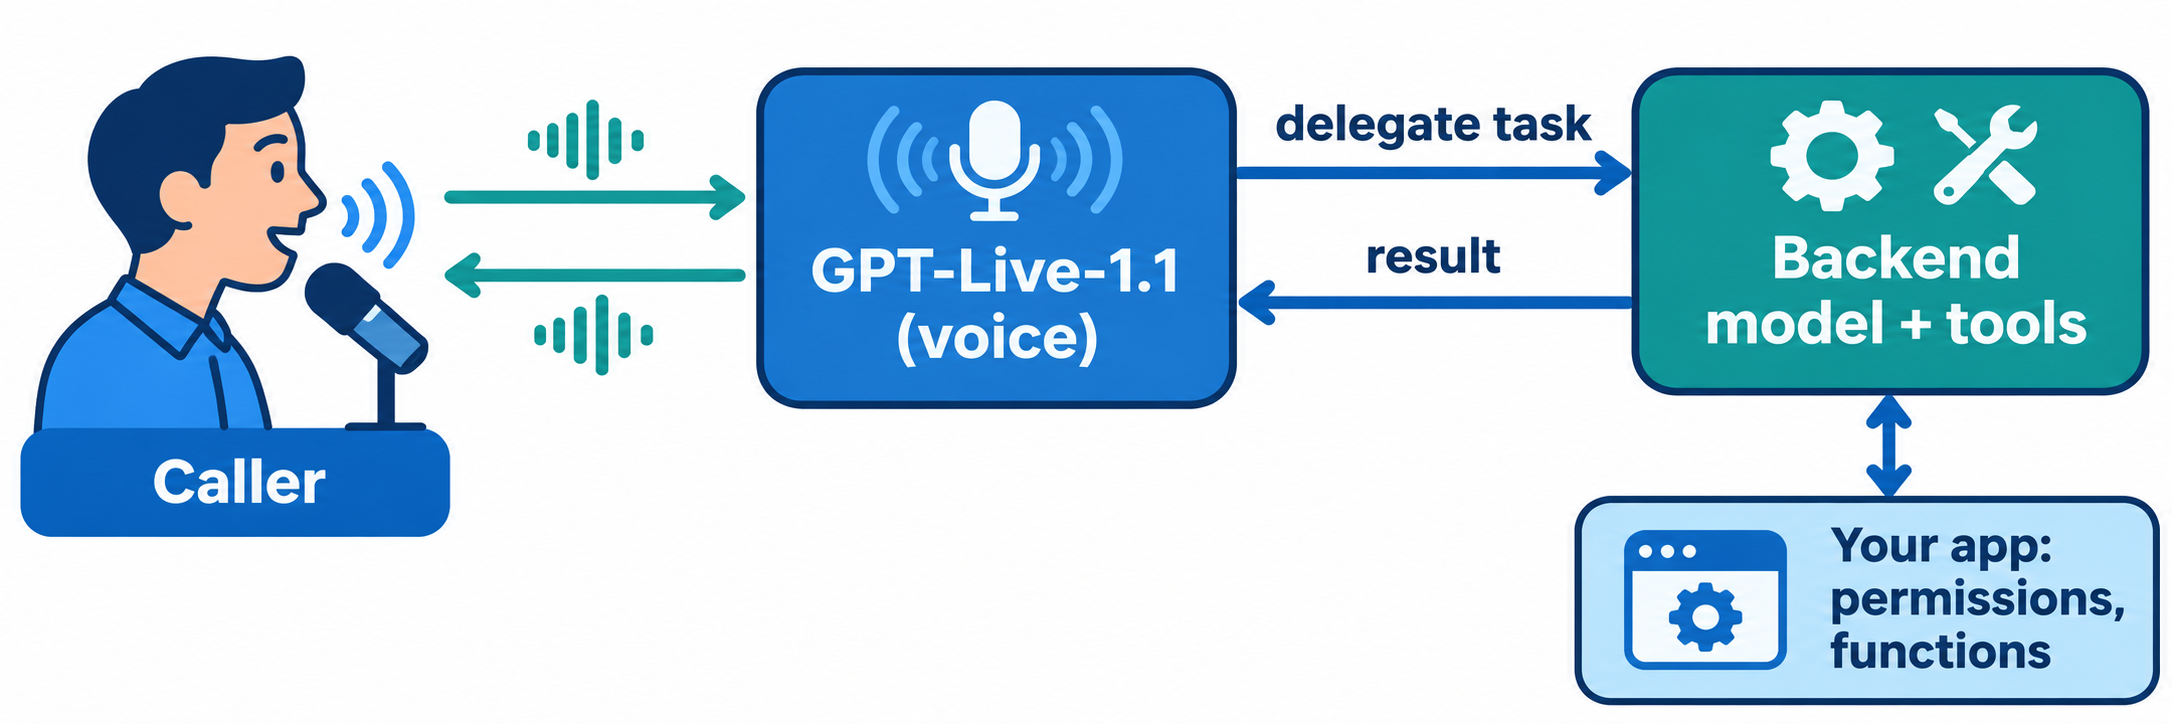
อีกครึ่งหนึ่งของการออกแบบคือ delegation (การมอบหมายงาน) GPT-Live จะตัดสินใจว่าคำขอใดต้องใช้การประมวลผลจริง จึงส่งต่อไปยัง backend (โมเดล Responses ของ OpenAI หรือ agent ของคุณเอง) แล้วพูดคุยต่อไปขณะ backend ทำงาน จากนั้นจึงสรุปผลลัพธ์ออกมาเป็นเสียงพูด
อะไรเปลี่ยนไปจาก GPT-Live-1
GPT-Live-1.1 ยังคงใช้ endpoint ราคา และชุดฟีเจอร์เดิมกับ GPT-Live-1 สิ่งที่เปลี่ยนคือคุณภาพเสียงและการจัดการงาน นี่คือสิ่งที่ OpenAI ระบุไว้ในเอกสารโมเดลและในประกาศบน X:
| ด้าน | GPT-Live-1 | GPT-Live-1.1 |
|---|---|---|
| การถอดเสียงพูด | ระดับพื้นฐาน | แม่นยำขึ้น ตามหน้าโมเดล |
| สำเนียงและเสียงข้ามภาษา | ระดับพื้นฐาน | สม่ำเสมอขึ้น ตามหน้าโมเดล |
| Session แบบว่าง | มีอัตรา standby ระบุไว้ในหน้าของตัวเอง | Standby ประกาศเป็นตัวเลือกใหม่ $0.02/นาที |
| การทำงานสำเร็จของงาน (Task completion) | ระดับพื้นฐาน | “ทำงานสำเร็จได้เชื่อถือได้มากขึ้น” ตามประกาศของ OpenAI |
| Endpoint | v1/live/sessions |
v1/live/sessions |
| ราคา (active) | $0.05/นาที | $0.05/นาที |
| Rate limits | จำนวน session พร้อมกัน | จำกัด session พร้อมกันแยกต่างหาก |
OpenAI ยังไม่ได้เผยแพร่ตัวเลข benchmark สำหรับการพัฒนาด้านการถอดเสียงหรือความน่าเชื่อถือ จึงควรถือว่าเป็นข้ออ้างจากผู้ให้บริการจนกว่าคุณจะวัดผลเอง นอกจากนี้ ประกาศของ OpenAI ระบุว่า standby เป็นฟีเจอร์ใหม่ในรุ่นนี้ ขณะที่หน้า GPT-Live-1 ตอนนี้ก็ระบุอัตรา standby เดียวกันคือ $0.02 ไว้แล้ว
ทั้งสองโมเดลใช้ endpoint และราคาร่วมกัน การเปลี่ยนใช้จึงเริ่มจากการตั้งค่า model ของ session เป็น gpt-live-1.1 จากนั้นรัน voice eval ของคุณเองซ้ำเพื่อยืนยันว่าได้ผลลัพธ์ดีขึ้นกับ traffic ของคุณจริง
ราคาของ GPT-Live-1.1
GPT-Live-1.1 คิดค่าบริการ voice session ตามระยะเวลา ไม่ใช่ตาม token อัตราต่อไปนี้มาจากหน้าราคาของ OpenAI เช็คเมื่อวันที่ 20 พฤศจิกายน 2026:
| เกณฑ์ | ราคา |
|---|---|
| เวลา session แบบ active | $0.05 ต่อนาที |
| เวลา session แบบ standby | $0.02 ต่อนาที |
| โมเดล backend และ tools | คิดค่าบริการแยกตามอัตราปกติของโมเดลนั้น |
รายละเอียดการคิดค่าบริการบางประการที่สำคัญเมื่อคุณประมาณต้นทุน:
- คิดค่าบริการเป็นวินาที ระยะเวลาไม่ได้ถูกปัดขึ้นเป็นนาทีเต็ม
- Standby ใช้ได้เฉพาะ WebRTC อัตราที่ถูกกว่าใช้กับ session แบบ WebRTC ขณะที่ inference ถูกหยุดชั่วคราว
- ค่าบริการเริ่มต้นระบบ (Initialization charge) การสร้าง WebRTC session จะถูกคิดค่าบริการ 15 วินาทีระหว่างการตั้งค่า และจะถูกหักออกจากค่าบริการตามระยะเวลาเมื่อ session เริ่มทำงาน
- Backend เป็นใบเสร็จที่สอง token จาก Responses ที่ถูกมอบหมายและการเรียกใช้ tool ก็ถูกคิดค่าบริการเช่นกัน
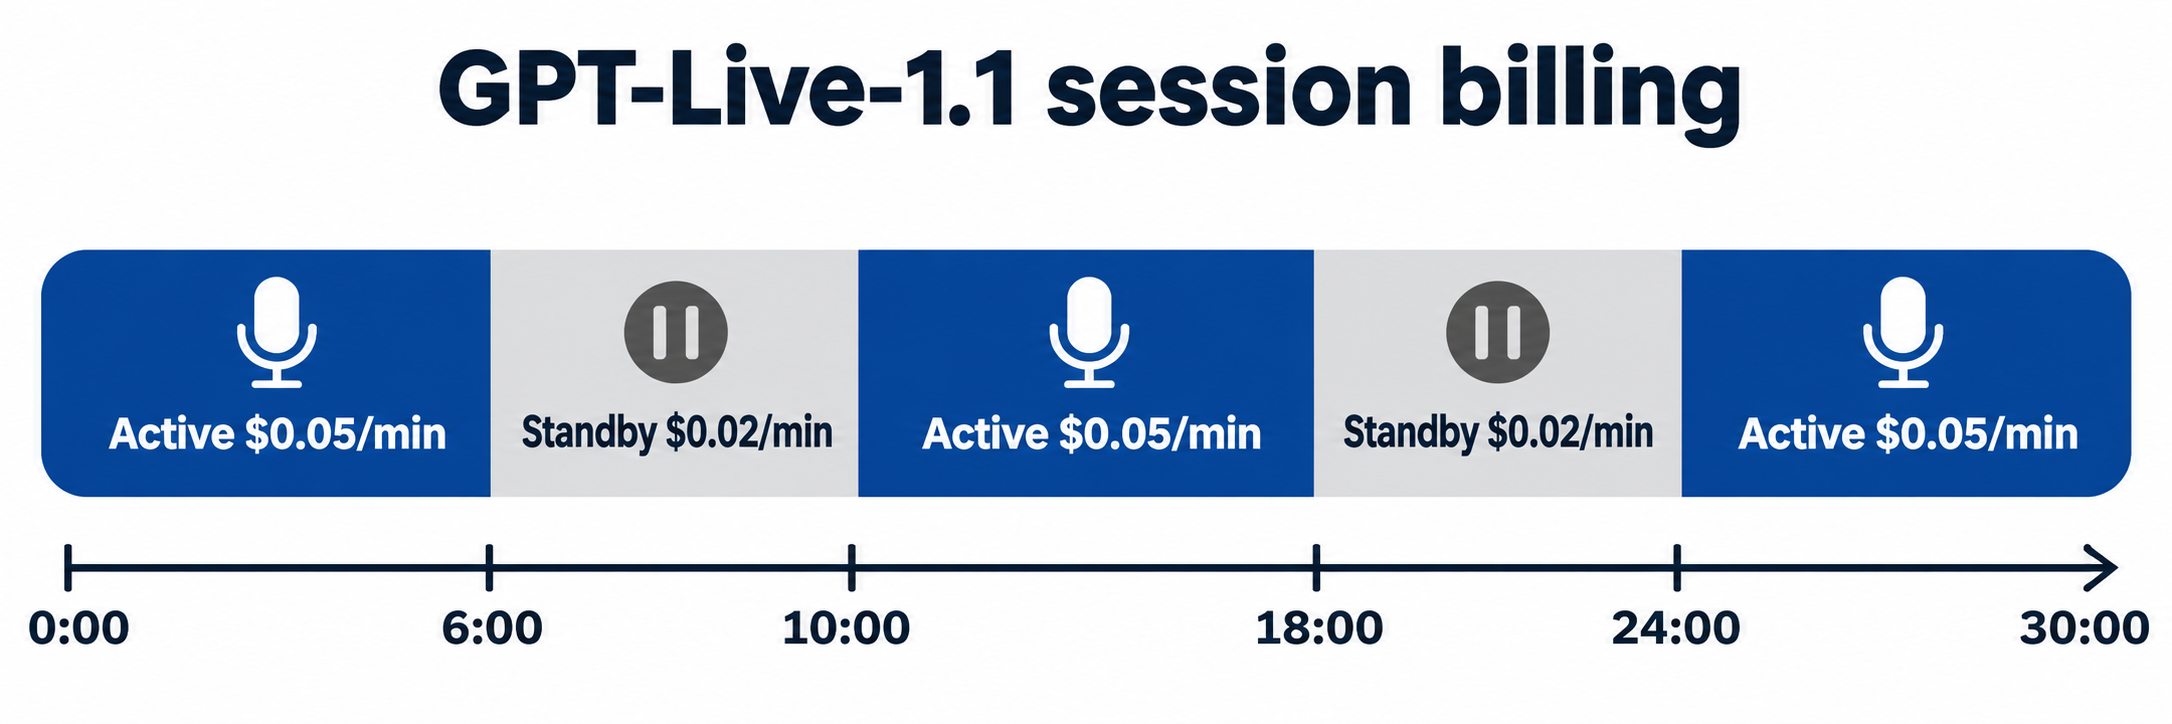
ตัวอย่างการคำนวณจากไทม์ไลน์ด้านบน: session สนับสนุนลูกค้านาน 30 นาที ใช้เวลา active 20 นาที และ standby 10 นาทีขณะผู้โทรค้นหาข้อมูล ค่าใช้จ่ายด้านเสียง: 20 x $0.05 + 10 x $0.02 = $1.20 หากไม่มี standby session เดียวกันจะมีค่าใช้จ่าย 30 x $0.05 = $1.50 เพิ่มเติมด้วยค่าใช้จ่ายของโมเดล backend ในงานที่ถูกมอบหมาย
GPT-Live-1.1 ทำงานอย่างไร: เสียงบวกกับการมอบหมายงาน
แอปพลิเคชัน GPT-Live มีสองส่วน คู่มือเริ่มต้นใช้งาน แบ่งส่วนเหล่านี้ดังนี้:
- GPT-Live ดูแลการสนทนา มันฟัง พูด และตัดสินใจว่าเมื่อไรควรขอความช่วยเหลือจาก backend คุณจะให้ prompt สั้น ๆ ว่าด้วยสไตล์การพูดและเงื่อนไขการมอบหมายงาน
- Backend ดูแลงานที่ถูกมอบหมาย มันคิดเหตุผล เรียกใช้ tools และส่งผลลัพธ์กลับให้ GPT-Live พูดออกมาเป็นเสียง คำสั่งที่ละเอียด กฎทางธุรกิจ และ workflow ของ tools อยู่ส่วนนี้
- แอปพลิเคชันของคุณเป็นเจ้าของส่วนที่มีความเสี่ยง มันตรวจสอบสิทธิ์ เก็บการยืนยัน รันฟังก์ชันที่สัมผัสระบบของคุณ และบันทึกความคืบหน้าของงาน
คุณเลือกโหมดการมอบหมายงานหนึ่งในสองโหมดตอนสร้าง session และไม่สามารถเปลี่ยนโหมดกลาง session ได้:
| โหมด | ใครรัน backend | เลือกใช้เมื่อ |
|---|---|---|
| Responses delegation | OpenAI เรียกโมเดล Responses ที่คุณตั้งค่าไว้ และส่งต่อบริบทและผลลัพธ์ | คุณต้องการให้ GPT-Live จัดการคำขอไปยัง backend ให้คุณ |
| Client delegation | แอปพลิเคชันของคุณรันโมเดล agent หรือบริการใดก็ได้ แล้วส่งผลลัพธ์กลับ | คุณต้องตรวจสอบ ปกปิด หรือรวมผลลัพธ์ หรือใช้ backend ที่ไม่ใช่ OpenAI |
คู่มือ delegation แนะนำให้เริ่มด้วย Responses delegation ส่วน Client delegation เหมาะกับทีมที่ต้องการเพิ่มเสียงให้ text agent ที่มีอยู่แล้ว
สร้าง GPT-Live-1.1 session แรกของคุณ
GPT-Live มี endpoint ของตัวเอง หน้าโมเดลระบุว่ารองรับ v1/live/sessions และระบุว่าไม่รองรับ Chat Completions, Responses และ v1/realtime OpenAI แนะนำให้ใช้ WebRTC สำหรับเสียง โดยมี WebSockets และ SIP เป็นทางเลือก
ขั้นตอน WebRTC จากquickstart ทำงาน 5 ขั้นตอน:
- เบราว์เซอร์ขอสิทธิ์เข้าถึงไมโครโฟนและเพิ่ม track ของตัวเองไปยัง peer connection
- มันสร้าง data channel แล้วสร้าง SDP offer
- เบราว์เซอร์ส่ง offer ไปยังเซิร์ฟเวอร์ของคุณ
- เซิร์ฟเวอร์ของคุณส่ง
sessionและtransport: { type: "webrtc", sdp }ไปที่POST /v1/live/sessionsพร้อม API key ของคุณ - เบราว์เซอร์นำ SDP answer ที่ได้รับกลับมาใช้ และรอ
session.started
นี่คือการเรียกจากฝั่งเซิร์ฟเวอร์จากตัวอย่าง TypeScript ของ OpenAI ตัดให้เหลือเฉพาะ session config:
const result = await client.live.create({
  session: {
    model: "gpt-live-1.1",
    instructions:
      "Be concise. Delegate requests needing current information to the backend, which can search the web.",
    delegation: {
      type: "responses",
      responses: {
        model: "gpt-5.6-terra",
        instructions:
          "Use web search when current facts are needed. Return concise, grounded results for a spoken conversation.",
        tools: [{ type: "web_search" }],
        tool_choice: "auto",
      },
    },
  },
  transport: { type: "webrtc", sdp: request.body.sdp },
});
ให้ API key อยู่ฝั่งเซิร์ฟเวอร์ และอย่าส่ง session.start บน data channel: คำขอ HTTP ได้เริ่ม session ไปแล้ว OpenAI ยังเผยแพร่ OpenAI Live Console ซึ่งเป็นแอปตัวอย่างแบบ local สำหรับดูการสนทนา การมอบหมายงาน และกิจกรรมของ backend tools
โหมด Standby: ลดต้นทุนช่วงที่ไม่มีการใช้งาน
Standby ทำให้การเชื่อมต่อ WebRTC ยังคงเปิดอยู่ขณะไม่มีใครพูด แล้วกลับมาทำ inference ต่อเมื่อมีคนพูด การเชื่อมต่อและ session ID ยังคงเดิม และประวัติการสนทนาจะกลับมาเมื่อ session กลับมาทำงาน
คุณเปิดใช้งานด้วยสองฟิลด์ของ session:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 20
  }
}
wake_policy.type: "speech"รอเสียงพูดก่อนเริ่ม inferenceidle_timeout_sรับค่าจำนวนเต็มตั้งแต่ 5 ถึง 60 หลังจากไม่มี transcript ขาเข้าหรือขาออกนานเท่ากับจำนวนวินาทีดังกล่าว session จะเปลี่ยนเป็น standbyvad_thresholdมีค่าตั้งแต่ 0 ถึง 1 ค่าเริ่มต้น 0.5 ค่าที่สูงขึ้นต้องการหลักฐานการพูดที่ชัดเจนกว่าจึงจะตื่น
ฟัง event session.paused และ session.resumed เพื่อติดตามสถานะ และให้ track ไมโครโฟนทำงานต่อเนื่อง ข้อแลกเปลี่ยนหนึ่งจากคู่มือจัดการ session: คำตอบแรกสำหรับข้อความสั้น ๆ หลังจาก standby อาจใช้เวลานานขึ้น สำหรับช่วงเว้นวรรคที่ยาวนาน การปิด session แล้วเริ่มใหม่อาจถูกกว่า standby
GPT-Live-1.1 เทียบกับ GPT-Realtime
คู่มือ voice agents ของ OpenAI อธิบายการเลือกใช้ด้วยมุมมองสถาปัตยกรรม GPT-Live เหมาะกับการสนทนาแบบ full-duplex ที่มี backend แยกต่างหาก Realtime API เหมาะกับโมเดลเดียวที่ฟัง คิด เรียกใช้ tools และพูดใน session เดียว
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Endpoint | v1/live/sessions |
v1/realtime |
| การออกแบบ | Frontend เสียง บวกกับ backend แบบมอบหมายงาน | โมเดล speech-to-speech เดี่ยว |
| อินพุต | เสียง, ข้อความ | ข้อความ, เสียง, รูปภาพ |
| การคิดค่าบริการ | $0.05/นาที active, $0.02/นาที standby | ตาม token: $32 ขาเข้า, $64 ขาออก ต่อ audio token 1M |
| ค่า backend | คิดค่าบริการแยก | รวมอยู่ในราคา token |
| เหมาะกับ | การเพิ่มเสียงให้ text agent ที่มีอยู่แล้ว | Voice agent แบบสมบูรณ์ในตัวเอง |
การคิดค่าบริการรายนาทีทำให้ค่าใช้จ่ายเสียงของ GPT-Live คาดการณ์ได้ง่ายสำหรับสายที่ยาวนาน การคิดค่าตาม token บน Realtime ติดตามปริมาณเสียงและข้อความที่ไหลผ่าน และรวมค่าการคิดเหตุผลไว้ในราคาเดียว ดูบทวิเคราะห์เปรียบเทียบฉบับก่อนหน้าเพิ่มเติมได้ที่ GPT-Live vs GPT-Realtime และคู่มือ GPT-Realtime-2 API ของเรา
Rate limits และการเข้าถึง
Rate limits ของ GPT-Live นับจำนวน session พร้อมกัน ไม่ใช่ token GPT-Live-1.1 และ GPT-Live-1 มีขีดจำกัดแยกกันซึ่งใช้กับทุก inference region หน้า GPT-Live-1 ระบุว่ามี 50 session พร้อมกันใน tier Build, 300 ใน Launch และ 500 ใน Grow โดยระบุว่า tier Free ไม่รองรับ หน้า GPT-Live-1.1 ยังไม่เผยแพร่ตารางของตัวเอง จึงควรตรวจสอบหน้า limits ขององค์กรคุณก่อนวางแผนรองรับโหลด
ทดสอบเซิร์ฟเวอร์ session ของคุณด้วย Apidog CLI
การเชื่อมต่อ GPT-Live ของคุณมีส่วน HTTP ที่คุณเป็นเจ้าของ: endpoint /api/session ที่แลกเปลี่ยน SDP offer ตัวอย่างของ OpenAI คืน 403 สำหรับ origin ที่ไม่คาดคิด และ 400 สำหรับ SDP offer ที่ขาดหาย เส้นทางเหล่านี้ไม่เคยไปถึง OpenAI คุณจึงทดสอบได้ทุก commit โดยไม่มีค่าใช้จ่ายด้านเสียง ให้ coding agent ของคุณเขียนและรันเทสต์ด้วย Apidog CLI
ติดตั้ง CLI, ล็อกอิน และเพิ่ม Apidog skill ให้ agent ของคุณ:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง agent ด้วย prompt เดียว:
In Apidog project <projectId>, add POST /api/session for my GPT-Live-1.1 server.
Create test cases that assert: a request with a wrong Origin header returns 403,
a request with no sdp field returns 400. Run them against the local environment
and summarize any failures.
Agent จะอ่าน schema, ตรวจสอบ payload, สร้าง endpoint และ test case แล้วรัน:
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file ./endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
apidog run คำสั่งเดียวกันเมื่อใส่ -r junit จะใช้ใน CI ได้ทันที ดูการรัน Apidog CLI ใน CI/CD pipeline หากคุณใช้ Claude Code คู่มือ Apidog CLI ใน Claude Code จะพาไปทีละขั้นตอนการตั้งค่า แผน Free ของ Apidog รองรับทีมได้ถึง 4 ผู้ใช้
คำถามที่พบบ่อย
GPT-Live-1.1 ใช้งานผ่าน API ได้หรือไม่? ได้ OpenAI เปิดให้ใช้ GPT-Live-1.1 ผ่าน API เมื่อวันที่ 20 พฤศจิกายน 2026 ด้วย model ID gpt-live-1.1 บน endpoint v1/live/sessions บทความ GPT-Live API ก่อนหน้าของเราตีพิมพ์ก่อนรุ่นนี้ออก
GPT-Live-1.1 ราคาเท่าไร? $0.05 ต่อนาที active และ $0.02 ต่อนาที standby คิดเป็นรายวินาที ค่าใช้จ่ายโมเดล backend และการใช้ tool คิดแยกตามอัตราปกติของแต่ละตัว
GPT-Live-1 กับ GPT-Live-1.1 ต่างกันอย่างไร? GPT-Live-1.1 ถอดเสียงพูดได้แม่นยำขึ้น คงสำเนียงและคุณภาพเสียงให้สม่ำเสมอขึ้นข้ามภาษา และเพิ่มตัวเลือก standby สำหรับ session ที่ว่าง ราคาและ endpoint เหมือนเดิม
GPT-Live-1.1 มองเห็นรูปภาพได้หรือไม่? ไม่โดยตรง ให้ส่งรูปภาพไปยังโมเดล backend ที่รองรับ vision ซึ่งจะคืนข้อความให้ GPT-Live นำไปใช้
GPT-Live-1.1 รองรับ function calling หรือไม่? รองรับ หน้าโมเดลระบุว่ารองรับ streaming และ function calling ในทางปฏิบัติ backend ของคุณเป็นผู้จัดการ tool calls ผ่าน delegation และแอปพลิเคชันของคุณรัน custom functions ต่าง ๆ