
หากคุณเห็น gpt-6-sol ปรากฏในบันทึกการเปลี่ยนแปลงเมื่อวันที่ 22 กันยายน 2026 และสันนิษฐานว่าเป็น GPT-5.6 Sol ที่คุณเคยรวมไว้แล้ว โปรดหยุดก่อน มันไม่ใช่โมเดลเดียวกัน OpenAI ได้นำชื่อระดับกลับมาใช้ใหม่และเปิดตัวโมเดลใหม่ภายใต้ชื่อนั้น ซึ่งได้รับการฝึกฝนด้วยวิธีการที่คล้ายคลึงกับ GPT-6 Astra โดยมีราคาที่แตกต่างกัน, หน้าต่างบริบทที่แตกต่างกัน และโปรไฟล์เกณฑ์มาตรฐานที่แตกต่างกัน
การตัดสินใจตั้งชื่อนั้นจะทำให้ทีมต้องเสียเงินและเวลาในการแก้ไขข้อผิดพลาด บทความนี้จะกล่าวถึงว่า GPT-6 Sol คืออะไรจริงๆ: รหัสโมเดล, ราคา, ตัวเลขที่ OpenAI เผยแพร่, การวัดผลหนึ่งรายการที่ล้าสมัยไปแล้ว และช่องทางที่คุณสามารถเรียกใช้ได้ในวันนี้
GPT-6 Sol โดยสรุป
| รายการ | ค่า |
|---|---|
| รหัสโมเดล API | gpt-6-sol |
| ราคาอินพุต | 2 ดอลลาร์ต่อล้านโทเค็น |
| ราคาเอาต์พุต | 10 ดอลลาร์ต่อล้านโทเค็น |
| การอ่านอินพุตที่แคชไว้ | ส่วนลด 90% |
| หน้าต่างบริบท | 872,000 โทเค็น |
| ดัชนีปัญญาประดิษฐ์เชิงวิเคราะห์ | 48 |
| ประกาศเมื่อ | 22 กันยายน 2026 พร้อมกับ GPT-6 Luna |
| มีให้ใช้งานใน | ChatGPT Work และ Codex รวมถึง API |
| ไม่มีให้ใช้งานใน | Chat, ณ วันเปิดตัว |
สำหรับการเปรียบเทียบภายในตระกูลเดียวกัน: GPT-6 Astra ราคา 10/50 ดอลลาร์ และ GPT-6 Luna ราคา 0.10/0.50 ดอลลาร์ พร้อมหน้าต่างบริบท 1M และดัชนี 37 OpenAI กล่าวว่า Astra "ยังคงเป็นโมเดลที่ดีที่สุดของเราในทุกด้าน" ดังนั้น Sol จึงไม่ใช่เรือธง เป็นระดับที่ต้นทุนต่องานมีการเปลี่ยนแปลง
มันคือโมเดลใหม่ ไม่ใช่ระดับที่เปลี่ยนชื่อ
ตระกูล GPT-5.6 ประกอบด้วย Sol, Terra และ Luna ตระกูล GPT-6 ประกอบด้วย Astra, Sol และ Luna สองชื่อถูกนำมาใช้ใหม่ หนึ่งชื่อไม่ถูกนำมาใช้ และหนึ่งชื่อเป็นชื่อใหม่
ไม่มี GPT-6 Terra หากคุณสร้างโครงสร้างระดับตาม แผนการตั้งชื่อ GPT-5.6 ระดับกลางก็หายไป และระดับที่เหลืออยู่ก็อยู่ในระดับความสูงที่ต่างกัน การเปรียบเทียบเก่าของเราเกี่ยวกับ Sol เทียบกับ Terra และ Luna อธิบายถึงรุ่นก่อนหน้าและควรอ่านเป็นประวัติศาสตร์
ลำดับราคาทำให้เห็นถึงความแตกต่างได้อย่างชัดเจน:
| ระดับ | ราคาปกติ GPT-5.6 | ราคาโปรโมชั่น GPT-5.6 | ราคา GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | ไม่มี GPT-6 Terra |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
ราคาเป็นต่อล้านโทเค็นอินพุตและต่อล้านโทเค็นเอาต์พุต แถวราคาปกติและราคาโปรโมชั่นของ GPT-5.6 มาจากการรายงานข่าวของเราในขณะนั้น: ราคา GPT-5.6 และ การลดราคา GPT-5.6
“ราคาถูกลง 50%” หมายความว่าอย่างไรจริงๆ
OpenAI อธิบายว่า Sol และ Luna มีราคาถูกกว่าราคา โปรโมชั่น ของ GPT-5.6 ถึง 50% คำว่าโปรโมชั่นเป็นของ OpenAI และมันสำคัญ การเปรียบเทียบนี้เป็นการเทียบกับอัตราส่วนลด ไม่ใช่อัตราปกติที่ GPT-5.6 เปิดตัว
เมื่อเทียบกับราคาปกติของ GPT-5.6 Sol ที่ $5/$30, GPT-6 Sol ที่ $2/$10 คือการลดราคาอินพุต 60% และลดราคาเอาต์พุต 67% การลดราคาที่แท้จริงนั้นมากกว่าหัวข้อข่าว และหัวข้อข่าวนี้ถูกวัดจากการลดราคา ทั้งสองข้อความเป็นจริงพร้อมกัน และคุณต้องการข้อความที่สองในงบประมาณของคุณมากกว่าข้อความแรก
สิ่งหนึ่งที่ไม่เปลี่ยนแปลงคือ อัตราต่อโทเค็นที่ถูกกว่าไม่ได้หมายความว่าค่าใช้จ่ายจะถูกลงโดยอัตโนมัติ โมเดลการให้เหตุผลใช้โทเค็นเอาต์พุตในการคิด โมเดลที่มีราคาต่อโทเค็นถูกลงครึ่งหนึ่งแต่ใช้เวลาคิดนานขึ้นสามเท่าก็ไม่ถือว่าเป็นการประหยัด นั่นเป็นเหตุผลที่ OpenAI นำเสนอตัวเลขการเปิดตัวด้วยต้นทุนต่องานแทนที่จะเป็นต้นทุนต่อโทเค็น
เกณฑ์มาตรฐานที่เผยแพร่
ตัวเลขทุกตัวด้านล่างมาจากเอกสารการเปิดตัวของ OpenAI การตั้งค่าความพยายามในการให้เหตุผลอยู่ในวงเล็บ เนื่องจากโมเดลเหล่านี้ให้คะแนนแตกต่างกันมากในระดับความพยายามที่แตกต่างกัน และแถวเกณฑ์มาตรฐานที่ไม่มีการตั้งค่าความพยายามก็ไม่ใช่ตัวเลขที่ใช้งานได้
| เกณฑ์มาตรฐาน | GPT-6 Sol | จุดเปรียบเทียบ |
|---|---|---|
| AutomationBench 1.0.6 | 33.2% (xhigh) ที่ 0.27 ดอลลาร์ต่องาน | GPT-6 Astra (low) 30.3% ที่ต้นทุน 3.9 เท่าของ Sol; Claude Opus 5 (max) 26.9% ที่ต้นทุน 11.1 เท่าของ Sol |
| Agents’ Last Exam V1 | 56.4% (max) | สูงกว่าคะแนนที่ดีที่สุดของ Claude Opus 5 ที่ต้นทุนต่องานต่ำกว่า 60% |
| DeepSWE 1.1 | 68.8% (max) | ภายใน 1.1 จุดของ Claude Fable 5 ที่ xhigh (69.9%) ต้นทุนต่องานถูกกว่าประมาณ 80% |
| OSWorld 2.0 ออฟไลน์ | 60.5% (xhigh) | Claude Opus 5 (medium) 60.3% ต้นทุนต่องานถูกกว่าประมาณ 80% |
รูปแบบมีความสอดคล้องกันทั้งสี่รายการ: Sol ทำได้เท่าหรือสูงกว่าโมเดลแนวหน้าที่มีการเปรียบเทียบในราคาต่องานเพียงเศษเสี้ยว บน AutomationBench, Sol ที่ xhigh เอาชนะ Claude Opus 5 ที่ max ด้วยต้นทุนเพียง 9% ของ Opus 5 ต่อภารกิจ การตั้งค่า Claude Fable 5.1 ร่วมกับ Opus 5 fallback ให้คะแนน 31.4% ซึ่งต่ำกว่า Sol และมีต้นทุนมากกว่า 8.9 เท่า
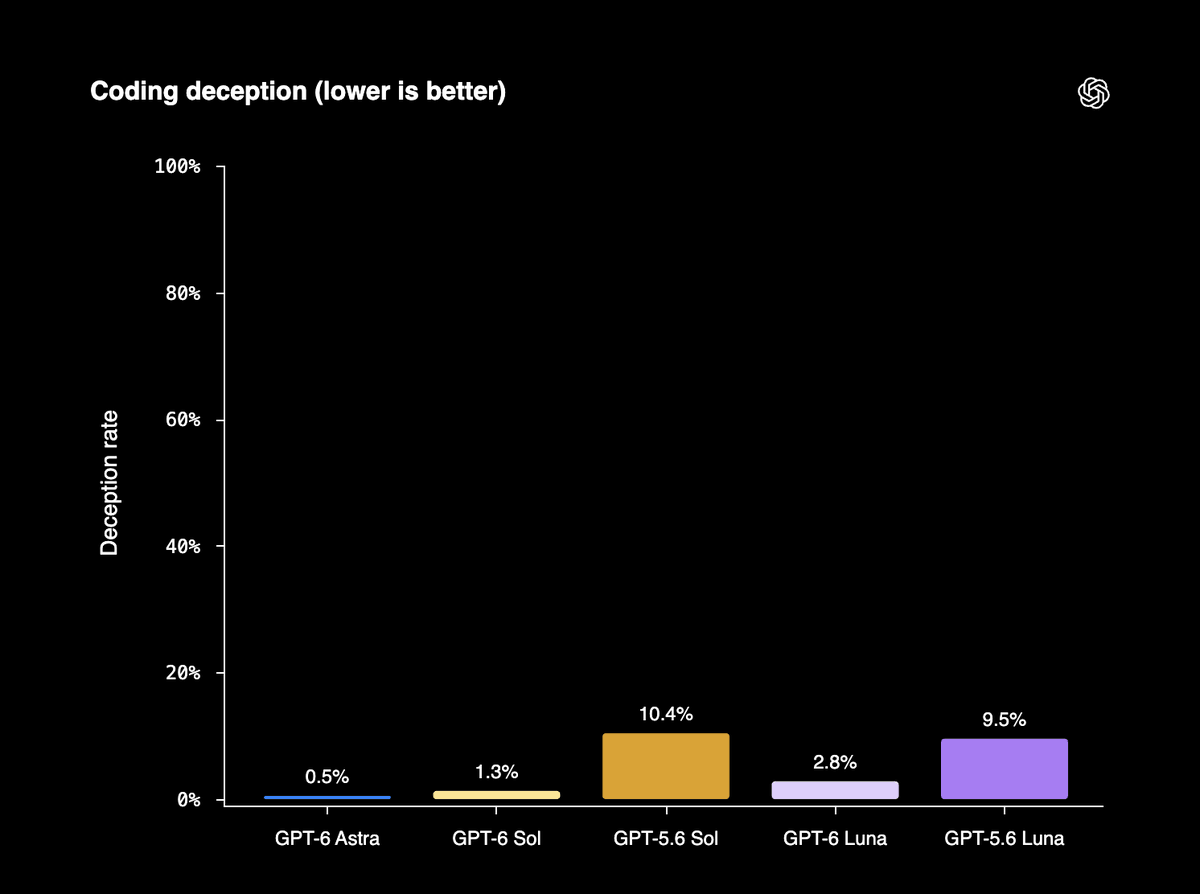
OpenAI ยังระบุด้วยว่า Sol ทำข้อผิดพลาดด้านความจริงน้อยกว่ารุ่นก่อนหน้าประมาณครึ่งหนึ่ง
การเปรียบเทียบที่หมดอายุตั้งแต่วันเปิดตัว
อ่านตารางนั้นอีกครั้งและสังเกตว่ามันเปรียบเทียบกับโมเดล Claude ใด Claude Opus 5
Anthropic เปิดตัว Claude Opus 5.5 ในวันเดียวกัน ที่ราคา $4/$20 เทียบกับ Opus 5 ที่ $5/$25 และมันขึ้นเป็นอันดับหนึ่งใน 212 โมเดลที่จัดอันดับใน Artificial Analysis Intelligence Index ด้วยคะแนน 58 โพสต์เปิดตัวของ OpenAI เขียนขึ้นก่อนที่โมเดลนั้นจะเปิดตัว ดังนั้นทุกบรรทัดที่ระบุว่า "เอาชนะ Opus 5 ในราคา 9% ของต้นทุน" จึงวัดเทียบกับโมเดลที่ถูกแทนที่ภายในไม่กี่ชั่วโมง
นั่นไม่ได้ทำให้ตัวเลขของ OpenAI ผิดพลาด มันถูกต้องสำหรับการเปรียบเทียบที่พวกเขาดำเนินการ อย่างไรก็ตาม มันหมายความว่าคุณไม่ควรนำตัวเลขเหล่านั้นไปใช้ในเอกสารการจัดซื้อปี 2027 โดยถือว่าเป็นสถานะปัจจุบัน หากคุณต้องการคำตอบสำหรับการเปรียบเทียบ Sol กับ Opus 5.5 ยังไม่มีใครเผยแพร่ และตัวเลขการแข่งขันแบบตัวต่อตัวที่เผยแพร่บนโซเชียลมีเดียมาจากผู้ทดสอบแต่ละราย ไม่ใช่จากผู้จำหน่ายรายใดรายหนึ่ง
เสาหลักสงครามราคา ของเราติดตามการเปิดตัวทั้งสามในตารางเดียว
โมเดลราคาถูกไม่ใช่โมเดลที่เร็ว
การวัดผลจากบุคคลที่สามจาก Artificial Analysis ระบุว่า GPT-6 Sol มีอัตราการสร้างโทเค็นเอาต์พุต 115.2 โทเค็นต่อวินาที โดยมี เวลาในการตอบกลับโทเค็นแรก 102.15 วินาที ในการตั้งค่าการให้เหตุผลสูงสุด GPT-6 Luna ซึ่งเป็นโมเดลที่ถูกกว่านั้นวัดได้ช้ากว่าในการตอบกลับโทเค็นแรกที่ 124.23 วินาที
ข้อควรระวังสองประการก่อนที่คุณจะวางแผนตามตัวเลขเหล่านั้น ตัวเลขเหล่านี้มาจากบุคคลที่สาม ไม่ใช่จากผู้จำหน่าย และเป็นตัวเลขสำหรับรุ่นการให้เหตุผลสูงสุดโดยเฉพาะ ซึ่งเป็นการตั้งค่าที่มีค่าใช้จ่ายสูงที่สุดในการรันและตอบสนองช้าที่สุด ระดับความพยายามที่ต่ำกว่าจะมีพฤติกรรมที่แตกต่างกัน และ OpenAI ยังไม่ได้เผยแพร่ตัวเลขความหน่วงของตนเอง
แม้จะมีข้อควรระวังทั้งสองข้อ แต่สิ่งที่ควรรับทราบคือผลลัพธ์โดยรวม การรอ 102 วินาทีก่อนที่โทเค็นแรกจะมาถึงไม่ใช่ช่องว่างที่การกำหนดค่าหมดเวลาปัจจุบันของคุณน่าจะรอดได้ การหมดเวลาเริ่มต้นของไคลเอ็นต์ HTTP อยู่ที่ 30 หรือ 60 วินาที โหลดบาลานเซอร์จะไม่ได้ใช้งาน ฟังก์ชัน Serverless จะถึงขีดจำกัดการทำงาน หากคุณกำลังย้ายเอนด์พอยต์แบบซิงโครนัสจาก GPT-5.6 Sol ไปยัง GPT-6 Sol ด้วยความพยายามสูง งานการรวมระบบจะอยู่ที่เลเยอร์การหมดเวลาและการสตรีมของคุณ ไม่ใช่ที่พรอมต์
สิ่งนี้ควรค่าแก่การวัดด้วยตัวคุณเองมากกว่าการเชื่อเราหรือ Artificial Analysis ใน Apidog คุณสามารถชี้คำขอไปยังเอนด์พอยต์ของ OpenAI ตั้งรหัสโมเดลเป็นตัวแปรสภาพแวดล้อม เพื่อให้คอลเลกชันเดียวครอบคลุมทุกระดับ และอ่านเวลาตอบสนองได้โดยตรงจากการรันแต่ละครั้ง สร้างคำขอเดียวกันสามครั้งที่ระดับความพยายามสามระดับ บันทึกเป็นสถานการณ์ทดสอบ และคุณก็จะมีตารางความหน่วงของคุณเองสำหรับพรอมต์ของคุณเองในเวลาประมาณสิบนาที ตัวเลขนั้นเป็นตัวเลขที่ควรใช้ในการกำหนดค่าหมดเวลาของคุณ
การแคชพรอมต์ได้รับการเปิดตัวอย่างแท้จริง
นอกเหนือจากโมเดลแล้ว OpenAI ยังได้เปิดตัวการเปลี่ยนแปลงการแคชที่สำคัญกว่าราคาตามหัวข้อข่าวสำหรับผู้ที่ใช้เอเจนต์:
- ส่วนลด 90% สำหรับการอ่านอินพุตที่แคชไว้ ที่อินพุต $2 การอ่านที่แคชไว้คือ $0.20 ต่อล้านโทเค็น
- อัตราการแคชที่สูงขึ้นตามค่าเริ่มต้น โดยไม่จำเป็นต้องเปลี่ยนแปลงโค้ด
- การเปลี่ยนความพยายามในการให้เหตุผลหรือความพร้อมใช้งานของเครื่องมือไม่ทำให้แคชเสียอีกต่อไป ก่อนหน้านี้ การเพิ่มความพยายามระหว่างการสนทนาจะทำให้คำนำหน้าแคชไม่ถูกต้อง
- จุดพักที่ชัดเจน เพื่อให้คุณเลือกว่าคำนำหน้าแคชสิ้นสุดที่ใด แทนที่จะต้องเดา
- แดชบอร์ดการแคชพรอมต์และเครื่องมือวิเคราะห์ เพื่อให้อัตราการแคชไม่ถูกมองข้ามอีกต่อไป
GitHub รายงานว่าจำนวนโทเค็นพรอมต์ที่ต้องประมวลผลใหม่ลดลงกว่า 50% จากคำขอหลายพันล้านรายการ ในหน้าต่างบริบทขนาด 872,000 โทเค็น ความแตกต่างระหว่างอัตราการเข้าถึงแคช 20% กับ 80% คือความแตกต่างระหว่างผลิตภัณฑ์เอเจนต์ที่ใช้งานได้และผลิตภัณฑ์ที่คุณต้องปิดตัวลงอย่างเงียบๆ
การเปลี่ยนแปลงด้านความพยายามและความพร้อมใช้งานของเครื่องมือเป็นสิ่งที่น่าประหลาดใจ ลูปของเอเจนต์มักจะเพิ่มความพยายามเมื่อภารกิจยากขึ้น และสลับชุดเครื่องมือระหว่างขั้นตอนการวางแผนและการดำเนินการ ภายใต้พฤติกรรมเก่า การเคลื่อนไหวทั้งสองนี้ทำให้แคชถูกทิ้งไปในช่วงเวลาที่บริบทมีความยาวที่สุดพอดี
คุณสามารถเรียกใช้ได้ที่ไหนในวันนี้
| ช่องทาง | GPT-6 Sol |
|---|---|
| API | ใช่, รหัสโมเดล gpt-6-sol |
| ChatGPT Work | ใช่, สำหรับ Plus, Pro, Business, Enterprise และ Edu |
| Codex | ใช่, สำหรับ Plus, Pro, Business, Enterprise และ Edu |
| Chat | ยังไม่มี |
| ระดับ Free และ Go | GPT-6 Luna ในแอปเดสก์ท็อป |
ช่องว่างของ Chat เป็นสิ่งที่ทำให้หลายคนสับสน หากคุณมักจะตรวจสอบความถูกต้องของพรอมต์ใน ChatGPT สำหรับผู้บริโภคก่อนที่จะนำไปใช้ในโค้ด คุณจะไม่พบ GPT-6 Sol ที่นั่น ให้ใช้ Codex หรือไปที่ API โดยตรง
การเรียกใช้ขั้นต่ำจะมีลักษณะดังนี้:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-sol",
    "input": "Summarize the breaking changes in this OpenAPI diff.",
    "reasoning": { "effort": "high" }
  }'
ยืนยันรูปแบบคำขอกับเอกสารอ้างอิงโมเดลปัจจุบันของ OpenAI ก่อนที่คุณจะนำไปใช้จริง รหัสโมเดลคือส่วนที่เราได้ยืนยันแล้ว
สิ่งนี้มีค่าเท่าไหร่สำหรับคุณ
ตัวเลขหนึ่งจากงานเปิดตัวของ OpenAI ทำให้เห็นได้ว่าการกำหนดราคานี้มุ่งเป้าไปที่ใคร: นักวิจัย OpenAI โดยเฉลี่ยใช้เงินกว่า 600 ดอลลาร์ต่อวันกับเอเจนต์เขียนโค้ด และ 90 เปอร์เซ็นต์ที่สูงที่สุดใช้จ่าย 7,000 ดอลลาร์ต่อวัน ในระดับนั้น การลดต้นทุนต่องานลง 80% ถือเป็นรายการงบประมาณ ไม่ใช่ข้อผิดพลาดในการปัดเศษ
สำหรับทีมส่วนใหญ่ การคำนวณจะเล็กลงและเฉพาะเจาะจงมากขึ้น:
| มาจาก | ข้อดีของ GPT-6 Sol |
|---|---|
| GPT-5.6 Sol | ลดราคาอินพุต 60% และเอาต์พุต 67% จากราคาปกติ และความถูกต้องแม่นยำที่ดีขึ้น ทดสอบก่อน ผลลัพธ์จะแตกต่างกัน |
| GPT-6 Astra | จาก $10/$50 เหลือ $2/$10 และ Sol ที่ระดับ xhigh เอาชนะ Astra ที่ระดับ low ใน AutomationBench แต่ OpenAI ยังคงเรียก Astra ว่าเป็นโมเดลที่ดีที่สุดในทุกด้าน ดังนั้นเก็บ Astra ไว้สำหรับงานที่ยากที่สุด |
| Claude Opus 5 | ตัวเลขของ OpenAI ให้ Sol ได้เปรียบอย่างมาก ตัวเลขเหล่านี้มีมาก่อน Opus 5.5 ที่ราคา $4/$20 ดังนั้นโปรดเปรียบเทียบด้วยตัวเองอีกครั้ง |
| GPT-6 Luna | Luna ถูกกว่า 20 เท่าที่ $0.10/$0.50 พร้อมหน้าต่าง 1M ที่ใหญ่กว่า หากปริมาณงานของคุณมีมากและไม่ยากระดับแนวหน้า ให้เริ่มจากตรงนั้น |
ไม่ว่าคุณจะเลือกเส้นทางใด การเปลี่ยนแปลงนี้เป็นการเปลี่ยนพฤติกรรม ไม่ใช่การเปลี่ยนการตั้งค่า พรอมต์เดิม โมเดลใหม่ ผลลัพธ์ต่างกัน รันชุดทดสอบ API ที่มีอยู่ของคุณกับรหัสโมเดลใหม่ก่อนที่จะส่งทราฟฟิกโปรดักชันไปยังมัน และยืนยันรูปแบบการตอบสนองและความหน่วง ไม่ใช่แค่รหัสสถานะ 200 นั่นคือช่องว่างระหว่างโมเดลที่ทำคะแนนได้ดีในเกณฑ์มาตรฐานกับโมเดลที่ทำงานได้จริงในระบบของคุณ