
Gemini 4 Hydrogen คือโมเดล Gemini 4 รุ่นเร็วและราคาถูกกว่าของ Google เปิดตัวเมื่อวันที่ 12 พฤศจิกายน 2026 และถูกออกแบบมาเพื่องานเขียนโค้ดและงาน agent ในชีวิตประจำวัน โดยมีราคา $1.50 ต่อ input token ล้านตัว และ $7.50 ต่อ output token ล้านตัว ใน context ขนาด 1 ล้าน token มีระดับ thinking ให้เลือก 4 ระดับ (low, medium, high, xhigh) และสามารถใช้ได้ฟรีใน free tier ของ Gemini API
ถ้าคุณใช้ Gemini 3.8 Flash อยู่ Hydrogen คือตัวเลือกอัปเกรดที่ Google แนะนำ ถ้าคุณจ่ายเงินใช้ Carbon หรือ Argon ในขั้นตอนงานทั่วไป Hydrogen ถูกออกแบบมาเพื่อรับช่วงงานเหล่านั้น บทความนี้จะพาไปดูว่ามีอะไรใหม่ ใช้ตรงไหนได้ และอะไรที่ยังเป็นคำถามค้างคา
Gemini 4 Hydrogen คืออะไร?
Gemini 4 Hydrogen (gemini-4-hydrogen) คือโมเดลระดับความเร็วสูงในตระกูล Gemini 4 ของ Google โดย Google เรียกมันว่า “daily driver สำหรับ agentic workflow” นั่นคือโมเดลที่เขียนโค้ด เรียก tools รันเทสต์ และอ่านเอกสารได้อย่างรวดเร็ว ทั้งใช้เดี่ยวๆ หรือทำหน้าที่เป็นเครื่องยนต์ประมวลผลเบื้องหลังของโมเดลระดับ frontier อย่าง Gemini 4 Carbon
ข้อเท็จจริงโดยสรุป จากโพสต์เปิดตัวของ Google และคู่มือ “What’s new” ของ AI Studio:
| ข้อมูลจำเพาะ | Gemini 4 Hydrogen |
|---|---|
| Model ID | gemini-4-hydrogen |
| วันเปิดตัว | 12 พฤศจิกายน 2026 |
| ราคา (แบบเสียเงิน) | $1.50 / 1M input, $7.50 / 1M output (คิดเหมาะจรทั้งช่วง context) |
| Cached input | $0.075 / 1M token ผ่าน implicit caching |
| Context window | 1,048,576 token แบ่งใช้ระหว่าง input, thinking และ output |
| Output ต่อคำขอ | 65,536 token แบบ synchronous; สูงสุดถึง 1M ด้วย background execution |
| ระดับ thinking | low, medium, high (ค่าเริ่มต้น), xhigh |
| Input ที่รองรับ | ข้อความ, รูปภาพ, PDF, สเปรดชีต, กราฟ, เสียง, วิดีโอ |
| Free tier | มี จำกัดอัตราการเรียกใช้ ใน AI Studio และ Gemini API |
| API | generateContent และ Interactions API |
Output token รวม thinking token ด้วย ดังนั้นคำขอที่ระดับ xhigh จะแพงกว่าคำขอเดียวกันที่ระดับ low แม้คำตอบที่มองเห็นจะยาวเท่ากันก็ตาม
Hydrogen vs Carbon vs Argon: แต่ละตัวเหมาะกับงานแบบไหน
โมเดล Gemini 4 ทั้งสามตัวใช้ unified context ขนาด 1M เหมือนกัน ใช้สถาปัตยกรรม long-decode เหมือนกัน และมี built-in tools เหมือนกัน สิ่งที่ต่างกันคือปริมาณการคิด (thinking) ต่อรอบ และต้นทุน
| Hydrogen | Argon | Carbon | |
|---|---|---|---|
| บทบาท | ประมวลผลเร็ว, เขียนโค้ดประจำวัน | งานระยะยาวส่วนใหญ่ ใช้ token น้อยกว่า Carbon | โมเดล frontier ที่แข็งแกร่งที่สุด |
| Thinking เริ่มต้น | high |
medium |
medium |
| Thinking สูงสุด | xhigh |
high |
high |
| Non-streaming hop | 65,536 token | 32,768 token (REST) | 32,768 token (REST) |
| คำแนะนำของ Google | เส้นทางอัปเกรดจาก 3.8 Flash | งานระยะยาวขั้นสูง | งานสถาปัตยกรรมยากๆ, ความปลอดภัย, งานวิทยาศาสตร์ |
แนวทางที่ Google แนะนำคือใช้ร่วมกัน: ให้ Carbon วางแผน interface หรือไล่บั๊กที่ยาก แล้วส่งงานแก้โค้ด การทำงานแบบ subagent ขนาน และการรันเทสต์ ไปให้ Hydrogen จัดการ การสลับโมเดลภายในบทสนทนาเดียวทำได้ผ่าน previous_interaction_id ใน Interactions API โดยไม่ต้องแก้ schema ของคำขอเลย
หากอยากเจาะลึกความต่างระหว่างสองโมเดล frontier นี้ อ่านได้ที่ Gemini 4 Carbon vs Argon ส่วนเรื่องราคา ดูได้จากบทวิเคราะห์ ราคา Carbon และ ราคา Argon
สี่ระดับ thinking
ระดับ thinking ของ Hydrogen คือตัวควบคุมหลักของคุณระหว่างความเร็ว คุณภาพ และค่าใช้จ่าย ตั้งค่าผ่าน field thinking_level และ Google แนะนำให้เริ่มจากค่าเริ่มต้นก่อน แล้วค่อยปรับเมื่อผล eval ของคุณบอกว่าควรปรับ
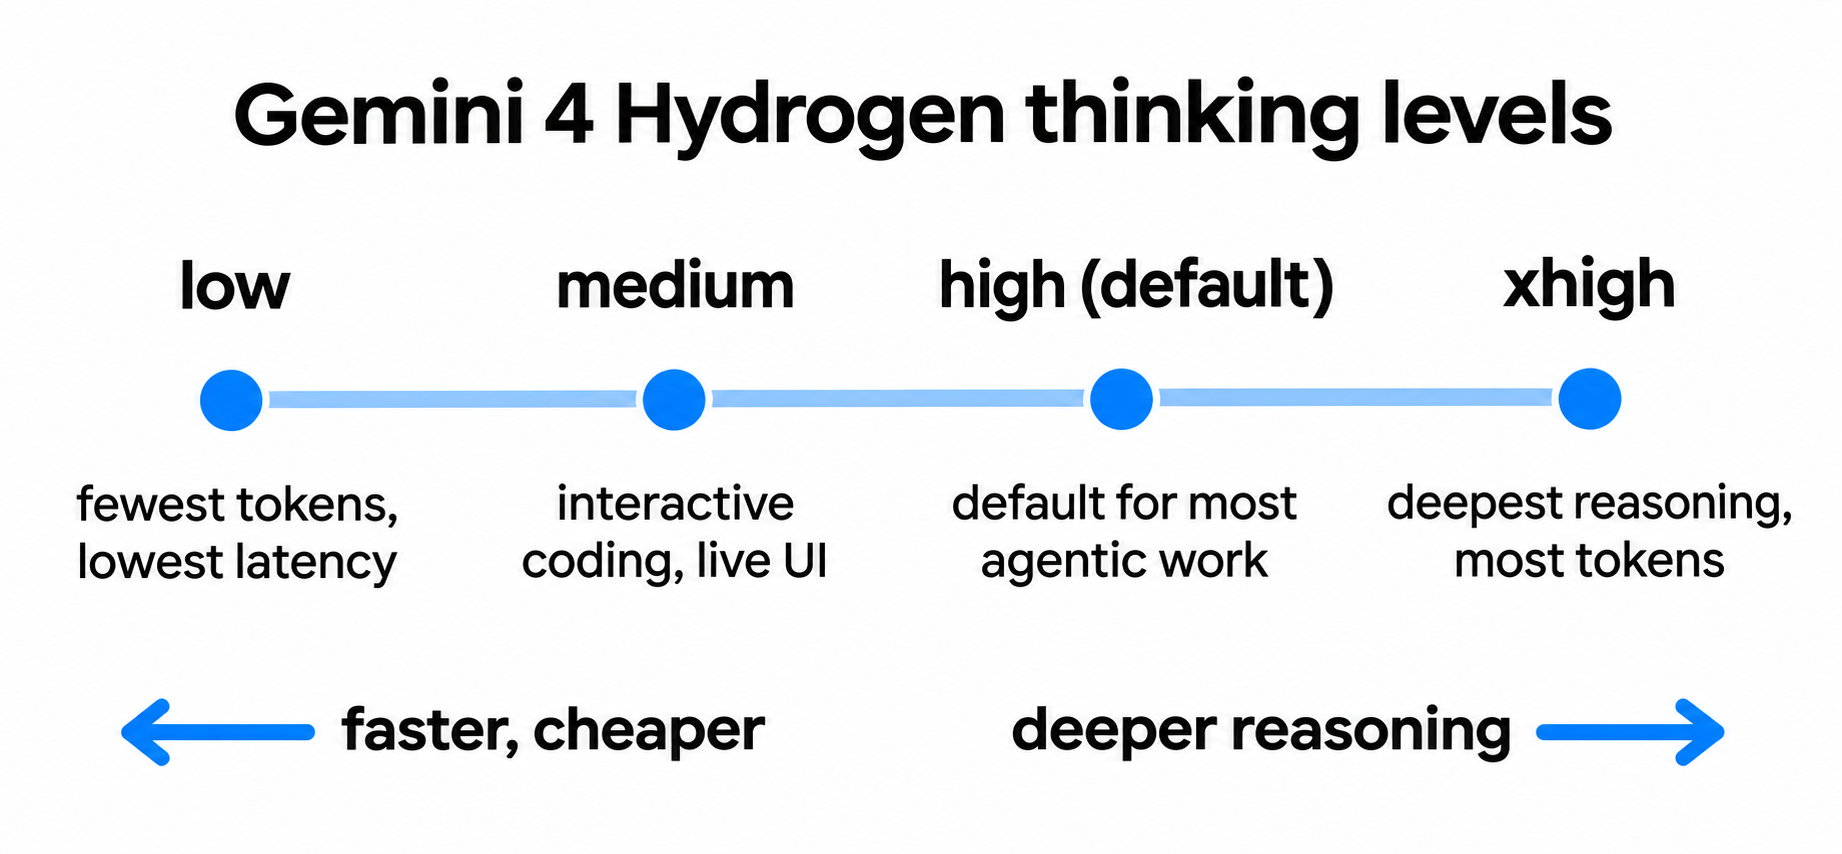
low: ใช้ token น้อยที่สุด latency ต่ำที่สุด เหมาะกับแชทเร็วๆ และการประมวลผลปริมาณสูงmedium: เขียนโค้ดแบบ interactive, ทำ live UI prototype และเรียก tool ที่ไวต่อ latencyhigh(ค่าเริ่มต้น): เขียนโค้ดที่ซับซ้อน, agentic execution, tool calling และงานเอกสาร multimodalxhigh: มาใหม่กับ Hydrogen สำหรับปัญหาหลายขั้นตอนที่ยากซึ่งhighทำไม่ได้ดีพอ
Google เตือนว่า xhigh อาจคิดมากเกินควรกับ prompt ง่ายๆ ทำให้ latency และ token เพิ่มขึ้นโดยไม่ได้คำตอบที่ดีขึ้น คำแนะนำคือ: รัน eval suite ของคุณทั้งสี่ระดับด้วย max_output_tokens ที่เผื่อเยอะๆ แล้วเลือกระดับต่ำสุดที่ผ่านเกณฑ์คุณภาพของคุณ ถ้ากำลังย้ายจาก 3.8 Flash โปรดทราบว่า Hydrogen จะปฏิเสธ minimal ด้วย error และใช้ค่าเริ่มต้นเป็น high แทนที่จะเป็น medium คู่มือราคา Hydrogen มีรายละเอียดต้นทุนของแต่ละระดับ
ผล benchmark ของ Gemini 4 Hydrogen
ตัวเลขทั้งหมดด้านล่างมาจาก Google เผยแพร่ตอนเปิดตัว การทดสอบซ้ำโดยอิสระยังมีน้อยหลังเปิดตัวหนึ่งวัน จึงควรถือว่าเป็นข้ออ้างสิทธิ์ของผู้ผลิต
เทียบกับ Argon และการตั้งค่าต่างๆ ของมันเอง
- Artificial Analysis Intelligence Index: ได้ 51 ที่ระดับ
highนำ Argon ที่ได้ 50 และได้ 54 ที่ระดับxhigh
เทียบกับ Gemini 3.8 Flash
- เร็วกว่า 2.5 เท่าที่ค่าเริ่มต้น
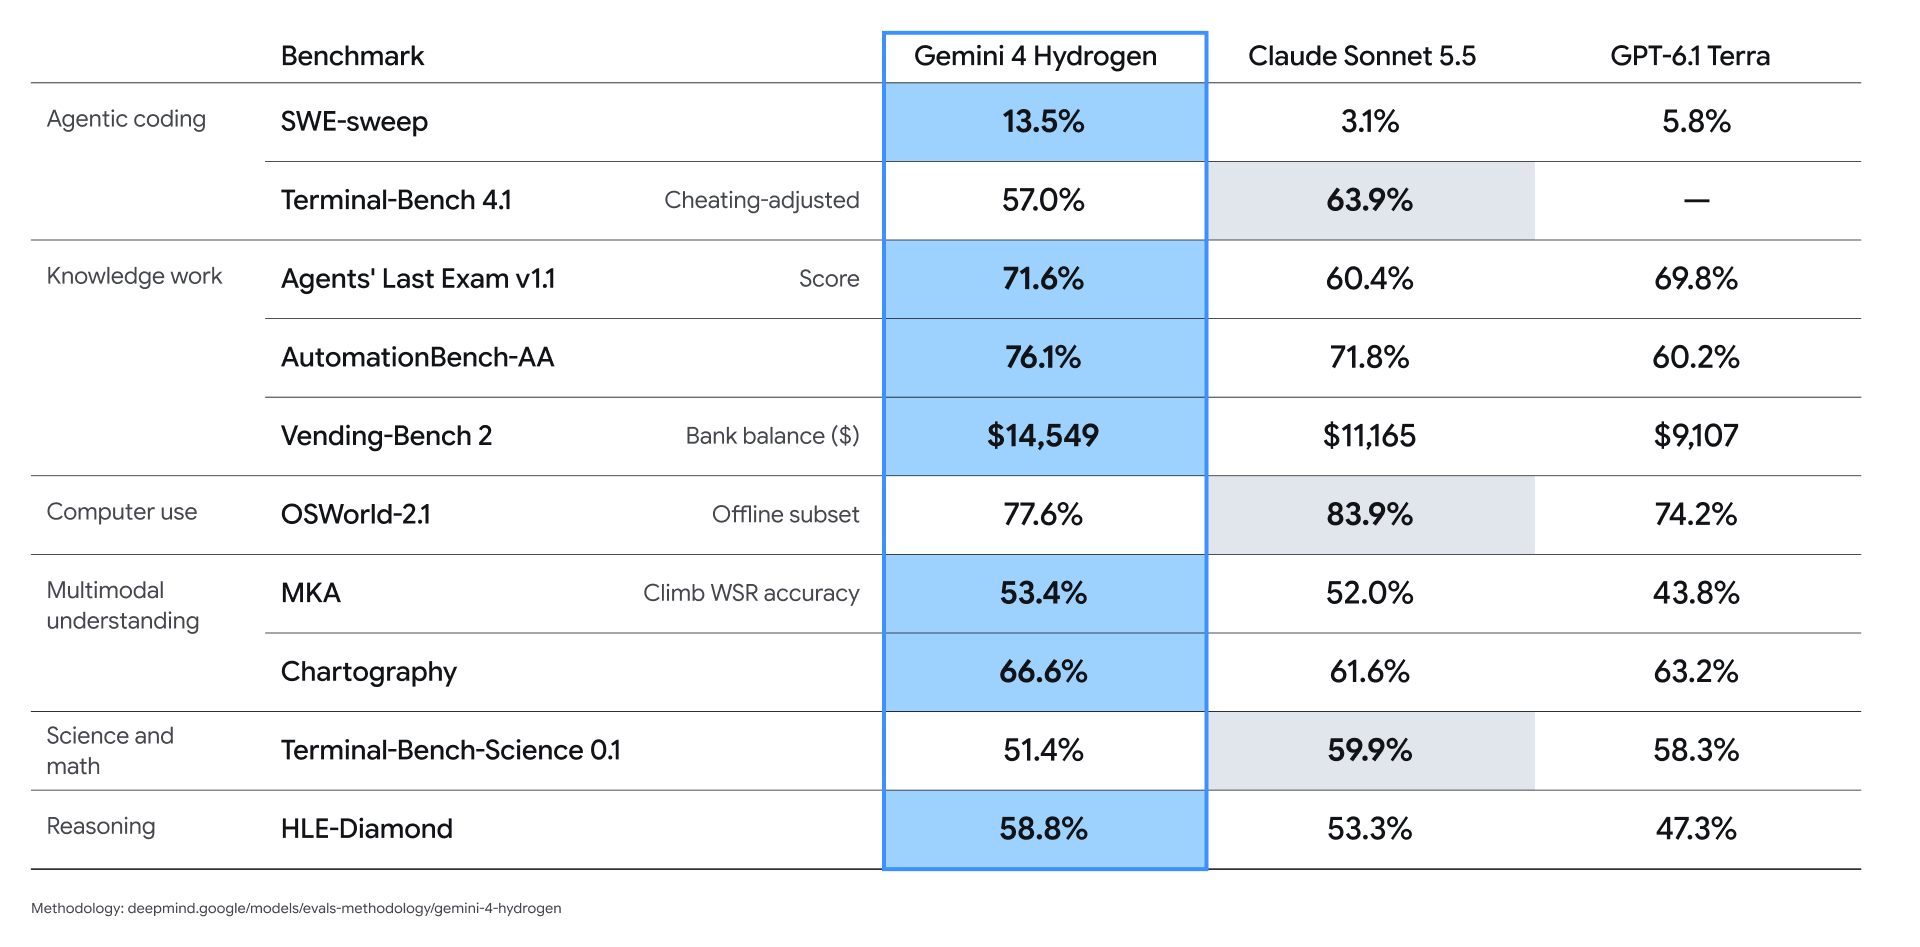
high - Terminal-Bench 4.1: 57% เทียบกับ 18.2%
- ข้อความสมมุติ (fabricated claims) น้อยกว่ามากกว่า 5 เท่า
- พันธมิตรที่เปิดตัวร่วมรายงานว่ารันเร็วขึ้น 2 ถึง 2.8 เท่า และใช้ token น้อยลง 12% ถึง 23% ในงานที่เกี่ยวกับ graph, SQL และข้อมูลจำนวนมาก
งาน agentic และงานเฉพาะด้าน
- HLE-Diamond: 58.8% ซึ่ง Google บอกว่าเป็นอันดับหนึ่งในกลุ่มของมัน
- Vals Tax Agent Bench: อันดับ #1 ที่ 52.3%
- Vals Legal Research Bench: อันดับ #1 ร่วมที่ 55.8%
- Agent Arena (arena.ai): อันดับ #5
- Multimodal Knowledge Agent (MKA): 53.4%
- Agents’ Last Exam v1.1: 71.6%
ความปลอดภัย ตามข้อมูลของ Google
- การละเมิดขอบเขต (overreach) น้อยลงสูงสุด 81% และการให้บริการน้อยเกินไป (under-service) น้อยลงสูงสุด 79% ในงาน agentic
- การกระทำที่เบี่ยงเบนจากความตั้งใจและการทางลัดในงาน น้อยลง 12 เท่า จาก eval ด้าน tool-use และ coding
- ได้ 96.7% ในการประเมินความซื่อสัตย์ของ agent ภายในของ Google
- ทนทานต่อ indirect prompt injection มากกว่า 2.3 เท่าบน benchmark Gray Swan IPI
แนวโน้มโดยรวมสำคัญกว่าคะแนนเดี่ยวๆ: Hydrogen เทียบเท่า Argon อย่างมากในด้าน intelligence ทั่วไป และกระโดดข้ามไปอีกขั้นจาก 3.8 Flash ในด้าน agentic coding ทดสอบกับ workload ของคุณก่อนไว้ใจมัน model card มีรายละเอียดการประเมินทั้งหมดของ Google
ใช้ Gemini 4 Hydrogen ได้ที่ไหนแล้ววันนี้
Google เปิดตัว Hydrogen ครอบคลุมทั้งผลิตภัณฑ์นักพัฒนา ธุรกิจ และผู้ใช้ทั่วไปในวันเปิดตัว:
- Gemini API, Google AI Studio และ Android Studio: ทุก tier ทั้งฟรีและเสียเงิน free tier มีการจำกัดอัตรา คู่มือ Hydrogen ฟรี อธิบายว่าคุณได้อะไรโดยไม่ต้องใช้บัตร
- Gemini สำหรับธุรกิจ: ผ่าน API, model dropdown, Antigravity และ Gemini ใน Google Sheets สำหรับแผนธุรกิจที่รองรับ
- แอป Gemini: ใน model dropdown ผู้ใช้ฟรีใช้ Hydrogen ได้ผ่าน auto model selection เท่านั้น ซึ่ง Gemini จะตัดสินเองว่าเหมาะกับ prompt นั้นหรือไม่
- Google Search: เป็นพลังขับเคลื่อนคำตอบสำหรับผู้ใช้ทุกคน
- Google Sheets: เริ่มจากสมาชิก Google AI Pro และ Ultra
- Google Antigravity: สำหรับสมาชิกแบบเสียเงิน Google AI Pro และ Ultra
Hydrogen ยังเป็นโมเดลเริ่มต้นเบื้องหลัง Antigravity agent ใน Gemini Managed Agents แล้ว ดังนั้นใครก็ตามที่เรียก agent ตัวนี้ผ่าน API ก็ใช้ Hydrogen อยู่แล้ว หากไม่ได้ตั้งค่าเป็นโมเดลอื่น
Orchestrator: Hydrogen และ Carbon ในเซสชันเดียว
Orchestrator คือตัวเลือกโมเดลใหม่ใน Google Antigravity ที่สลับระหว่าง Carbon และ Hydrogen ภายในงานเดียว ทั้งสองทิศทาง Carbon สำรวจและวางแผน Hydrogen เขียนการแก้โค้ด อัปเดตแพ็กเกจ และรันเทสต์ เมื่อ Hydrogen เจอปัญหา มันจะส่งการควบคุมกลับไปให้ Carbon ซ่อมแผน ตัวนี้มาแทน static router ที่เดาระดับความยากเพียงครั้งเดียวจาก prompt แรกของคุณ
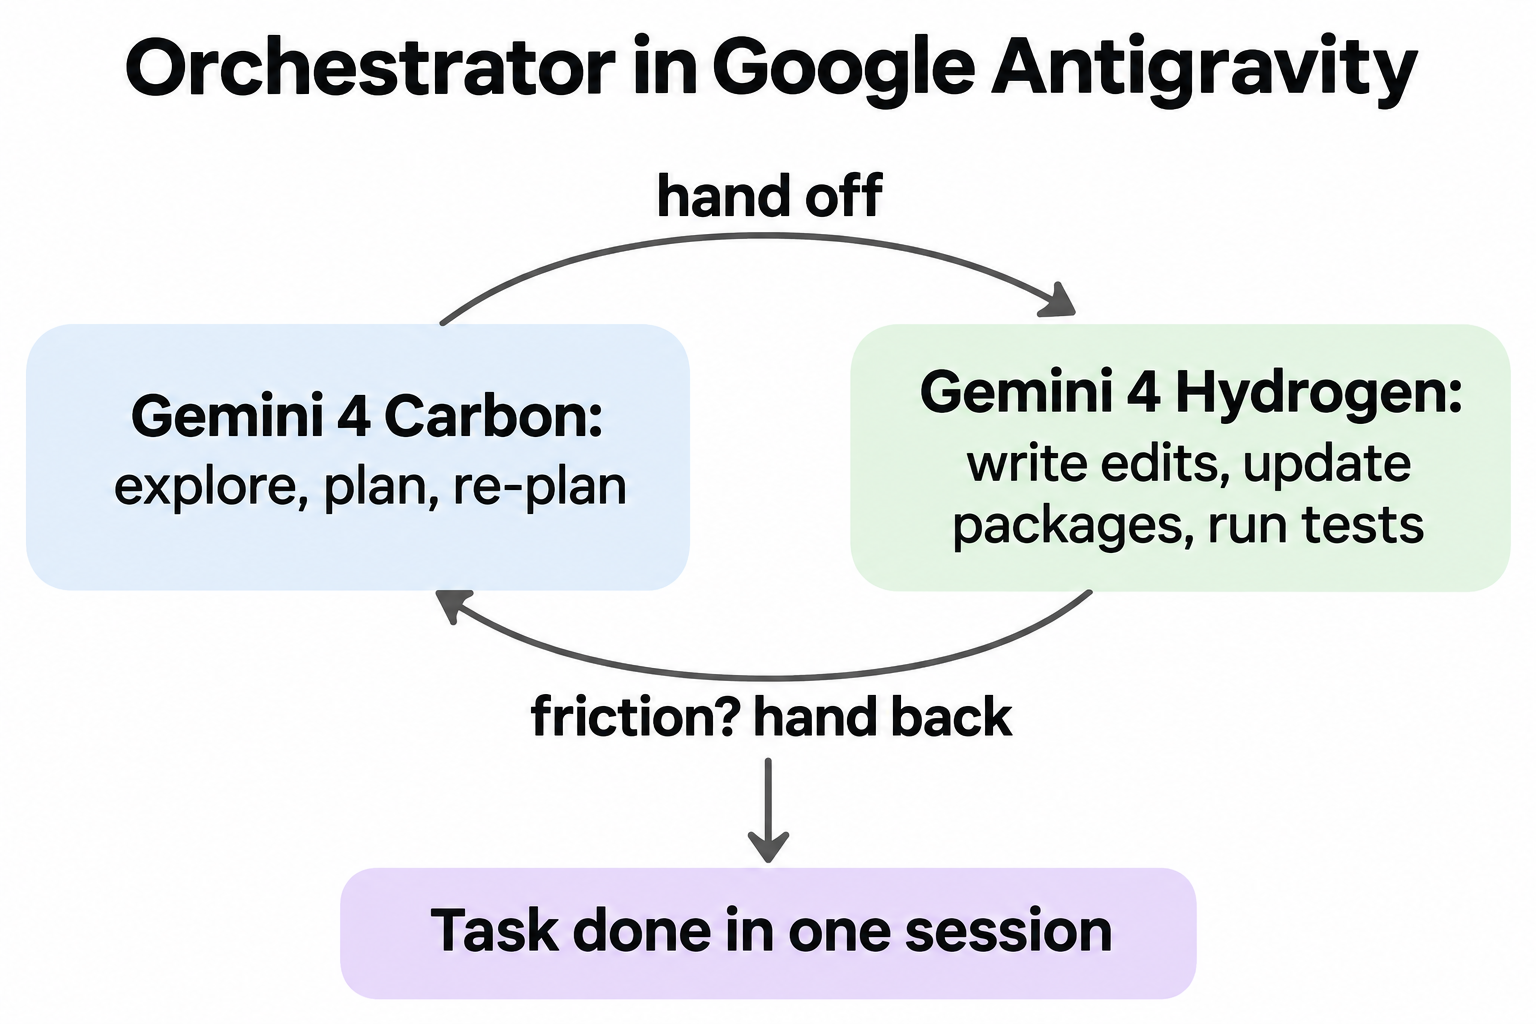
บน Terminal-Bench Google บอกว่า Orchestrator ทำได้ใกล้เคียง Carbon ในแง่อัตราความสำเร็จ โดยใช้ quota น้อยลง 24% และเสร็จเร็วขึ้นโดยเฉลี่ย 19% โปรดทราบว่าโพสต์เปิดตัวสองชิ้นของ Google อ้างเวอร์ชัน benchmark ไม่ตรงกันสำหรับผลนี้ (4.0 ในโพสต์หลัก, 4.1 ในโพสต์ Antigravity)
ความพร้อมใช้งานแบ่งตาม tier สมาชิก Ultra ได้ Orchestrator (Carbon) และ Orchestrator (Argon); สมาชิก Pro แบบเสียเงินได้ Orchestrator (Argon) ถ้าคุณอยากกำหนดบทบาทเอง Antigravity SDK ให้คุณระบุ agent Hydrogen และ Carbon อย่างชัดเจนได้ คู่มือ Gemini 4 Hydrogen Orchestrator เจาะลึกกว่านั้น
ข้อจำกัดและคำถามที่ยังไม่มีคำตอบ
หลังเปิดตัวหนึ่งวัน วางแผนโดยคำนึงถึงสิ่งเหล่านี้:
- Benchmark เป็นการรายงานเอง ตัวเลขทั้งหมดข้างต้นมาจาก Google หรือพันธมิตรเปิดตัว
- ไม่มี explicit caching
cachedContentsและcaches.createยังไม่รองรับ มีเพียง implicit cache สำหรับ prompt ตั้งแต่ 4,096 token ขึ้นไปเท่านั้น - พารามิเตอร์ sampling ถูกเมิน
temperature,top_pและtop_kไม่มีผล คุณจึงปรับความสุ่มด้วยวิธีนี้ไม่ได้ - ขีดจำกัด free tier อยู่ในหน้าแยก Google ชี้ไปที่หน้า rate limits แทนที่จะระบุตัวเลขของ Hydrogen ไว้ในคู่มือเปิดตัว
- Orchestrator มีเฉพาะใน Antigravity ไม่มี Orchestrator ระดับ API ในโค้ดของคุณเองต้อง route โมเดลเอง
ทดสอบ Gemini 4 Hydrogen ด้วย Apidog CLI และ coding agent ของคุณ
เพื่อตัดสินว่า Hydrogen แทน 3.8 Flash ได้จริงไหม ให้ยิงคำขอเดียวกันไปที่ทั้งสองตัวแล้วเทียบกัน ปล่อยให้ coding agent ทำให้ แล้วการสลับโมเดลจะกลายเป็นผลทดสอบ ไม่ใช่การเดา คำขอนี้ใช้รูปแบบ generateContent ตามเอกสารของ Google ซึ่งเรายังไม่ได้รันจริงเพื่อเขียนโพสต์นี้:
MODEL="${GEMINI_MODEL:-gemini-4-hydrogen}"

curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"contents": [{"parts": [{"text": "List three checks a CI job should run before a release."}]}]}'
Apidog CLI มอบวิธีสร้างและรัน API test ผ่าน command line ให้กับ Claude Code, Codex, Cursor หรือ OpenCode ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง agent ของคุณด้วย prompt เดียว:
In Apidog project <id>, create an environment for the Gemini API with a MODEL
variable set to gemini-4-hydrogen and a GEMINI_API_KEY variable. Add a test case
for POST /v1beta/models/{MODEL}:generateContent that asserts HTTP 200, a non-empty
candidates array, and that usageMetadata is present. Run it for gemini-4-hydrogen
and gemini-3.8-flash and compare response time and token counts.
Agent จะสร้าง environment ตรวจสอบ payload ของ test case กับ schema แล้วรันหนึ่งครั้งต่อโมเดล:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-4-hydrogen" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> --env-var "MODEL=gemini-3.8-flash" -r cli,json
นำคำสั่ง apidog run ... -r junit เดียวกันไปใส่ใน CI พร้อมคู่มือ Apidog CLI CI/CD หรือเริ่มจากApidog CLI ใน Claude Code ตัวอย่างคำขอแบบเต็ม ดูได้ที่คู่มือ Gemini 4 Hydrogen API แผน Free ของ Apidog รองรับผู้ใช้สูงสุด 4 คน
คำถามที่พบบ่อย
Gemini 4 Hydrogen ฟรีไหม? ฟรี ภายใต้ข้อจำกัด Google ให้ Hydrogen อยู่ใน free tier ของ Gemini API และใน Google AI Studio โดยมีการจำกัดอัตราการใช้งาน การใช้แบบเสียเงินมีราคา $1.50 ต่อ input token ล้านตัว และ $7.50 ต่อ output token ล้านตัว
Model ID ของ Gemini 4 Hydrogen คืออะไร? gemini-4-hydrogen ใช้ได้ทั้งกับ generateContent และ Interactions API
Gemini 4 Hydrogen ดีกว่า Gemini 4 Argon ไหม? ตามตัวเลขของ Google Hydrogen ได้ 51 บน Artificial Analysis Intelligence Index ที่ระดับ high เทียบกับ Argon ที่ 50 และ 54 ที่ระดับ xhigh แต่ Argon ยังถูกวางตำแหน่งสำหรับงานระยะยาวขั้นสูงส่วนใหญ่ จึงควรทดสอบทั้งสองตัวกับ workload ของคุณเอง
ระดับ thinking xhigh คืออะไร? เป็นระดับ thinking ที่สี่ มาใหม่กับ Hydrogen อยู่เหนือค่าเริ่มต้น high ใช้ token มากที่สุดเพื่อการใช้เหตุผลที่ลึกที่สุด Google แนะนำให้ใช้เฉพาะปัญหาหลายขั้นตอนที่ยากซึ่ง high ทำไม่ได้ดีพอ
Gemini 4 Hydrogen แทน Gemini 3.8 Flash ได้ไหม? Google เรียกมันว่าตัวอัปเกรดที่แนะนำจาก 3.8 Flash เปลี่ยน model ID, ปรับเพดาน max_output_tokens ที่ตั้งต่ำไว้, ลบ explicit caching และพารามิเตอร์ sampling ออก แล้วทดสอบระดับ thinking ใหม่
ใช้ Orchestrator ผ่าน Gemini API ได้ไหม? ไม่ได้ Orchestrator เป็นตัวเลือกโมเดลภายใน Google Antigravity สำหรับสมาชิกแบบเสียเงิน AI Pro และ Ultra ใน API คุณต้อง route ระหว่าง Carbon และ Hydrogen เอง เช่น ใช้ previous_interaction_id ควบคู่ไปกับแต่ละรอบ