
Together AI, Fireworks AI และ Groq ต่างขายข้อเสนอเดียวกัน: ชี้ไคลเอนต์ OpenAI ที่คุณมีอยู่ไปยัง base URL ใหม่ เปลี่ยนคีย์ แล้วได้โมเดล open-weight ในราคาเพียงเศษเสี้ยว ข้อเสนอนั้นเป็นจริง สิ่งที่ไม่จริงคือการเปรียบเทียบ free tier ของพวกมันนั้นง่ายพอ ๆ กับการเรียงตัวเลขสามตัววางข้างกัน เพราะสองในสามผู้ให้บริการไม่ได้เผยแพร่ตัวเลขตายตัวเลย
Groq เป็นข้อยกเว้น: หน้า rate-limits ของมันเผยแพร่ตัวเลข Free Plan จริง รายโมเดล ในแท็บที่ผู้อ่านส่วนใหญ่เลื่อนผ่านไปยังแท็บ Developer Plan ที่อยู่ถัดจากนั้น Together AI บอกเราตรง ๆ ในเอกสารของตัวเองว่าไม่มีขีดจำกัดต่อโมเดลแบบตายตัวให้เผยแพร่ เพดานของคุณจะขยับตามการใช้งานของคุณ Fireworks AI ผูกการเข้าถึงฟรีไว้กับยอดเครดิตแบบครั้งเดียวแทนที่จะเป็นระดับแผน สามดีไซน์ที่ต่างกัน และบทความ “free tier ไหนใหญ่กว่า” ก็ยังลดทอนสิ่งนั้นเหลือตัวเลขเดียวไม่ได้
สรุปสั้น
Groq, Together AI และ Fireworks AI ต่างเปิด endpoint ที่เข้ากันได้กับ OpenAI ดังนั้นการสลับระหว่างกันจึงเป็นแค่ base URL และ API key ไม่ใช่การเขียนใหม่ทั้งหมด Groq แยกการเข้าถึงออกเป็น Free Plan และ Developer Plan แบบเสียเงิน และต่างจากอีกสองรายตรงที่มันเผยแพร่ตัวเลข Free Plan ต่อโมเดลจริง เช่น 30 RPM / 1K RPD / 8K TPM / 200K TPD บน gpt-oss-120b และ gpt-oss-20b Together AI ไม่เผยแพร่ตัวเลข free-tier แบบตายตัว เอกสารของมันบอกว่าขีดจำกัดเคลื่อนที่แบบไดนามิกตามความจุสดและ successful usage ล่าสุดของคุณ Fireworks AI ให้เครดิตแบบครั้งเดียวแก่บัญชีใหม่ ($1 ตามหน้าตาราคาของมัน) แทนที่จะเป็นโควตาฟรีแบบต่อเนื่อง การตัดสินใจที่สำคัญกว่าตัวเลขพาดหัวคือคุณต้องการโมเดลอะไรจริง ๆ และเพดานของแต่ละผู้ให้บริการมีพฤติกรรมอย่างไรเมื่อคุณชนมันเข้า Apidog ให้คุณบันทึกคำขอไว้หนึ่งรายการแล้วสลับ base URL และคีย์ตาม environment เพื่อให้คุณวัดทั้งสามรายได้เองแทนที่จะเชื่อตาราง
API รูปแบบเดียว สามคีย์
ผู้ให้บริการทั้งสามจงใจทำตาม schema ของ OpenAI Chat Completions นั่นคือเหตุผลที่คู่มือการย้ายสำหรับเครื่องมือเหล่านี้มักอ่านเหมือนกันทุกครั้ง: เปลี่ยน base_url เปลี่ยน header Authorization และเก็บโค้ดที่เหลือไว้เหมือนเดิม base URL ที่เข้ากันได้กับ OpenAI ของ Groq คือ https://api.groq.com/openai/v1/ ของ Together AI คือ https://api.together.ai/v1 ซึ่งยืนยันได้โดยตรงในเอกสาร quickstart ของมัน ของ Fireworks AI คือ https://api.fireworks.ai/inference/v1 ตามคู่มือ OpenAI-compatibility ของมัน
รูปร่างที่ใช้ร่วมกันนี้คือเหตุผลที่การทดสอบแบบเทียบตรง ๆ คุ้มค่าที่จะทำ: การเพิ่มผู้ให้บริการรายที่สี่หรือห้าใช้เวลาไม่กี่นาที ไม่ใช่การออกแบบใหม่ เราครอบคลุมกลไกของการจัดการการตั้งค่าหลายผู้ให้บริการแบบนั้นไว้ใน วิธีจัดการ base URL ข้าม environment ใน Apidog และถ้าคุณกำลังชั่งน้ำหนักตัวเลือกการ routing ในวงกว้างขึ้น สรุปทางเลือกอื่นของ OpenRouter ของเราครอบคลุมว่าทั้งสามรายนี้เข้ากับภาพนั้นตรงไหน
สิ่งที่คุณตรวจสอบได้จริงเกี่ยวกับแต่ละ free tier
นี่คือการเปรียบเทียบที่สร้างจากเฉพาะสิ่งที่แต่ละผู้ให้บริการระบุต่อสาธารณะ ณ กันยายน 2026 ในกรณีที่ผู้ให้บริการไม่เปิดเผยตัวเลข ตารางจะบอกเช่นนั้นแทนการเดา
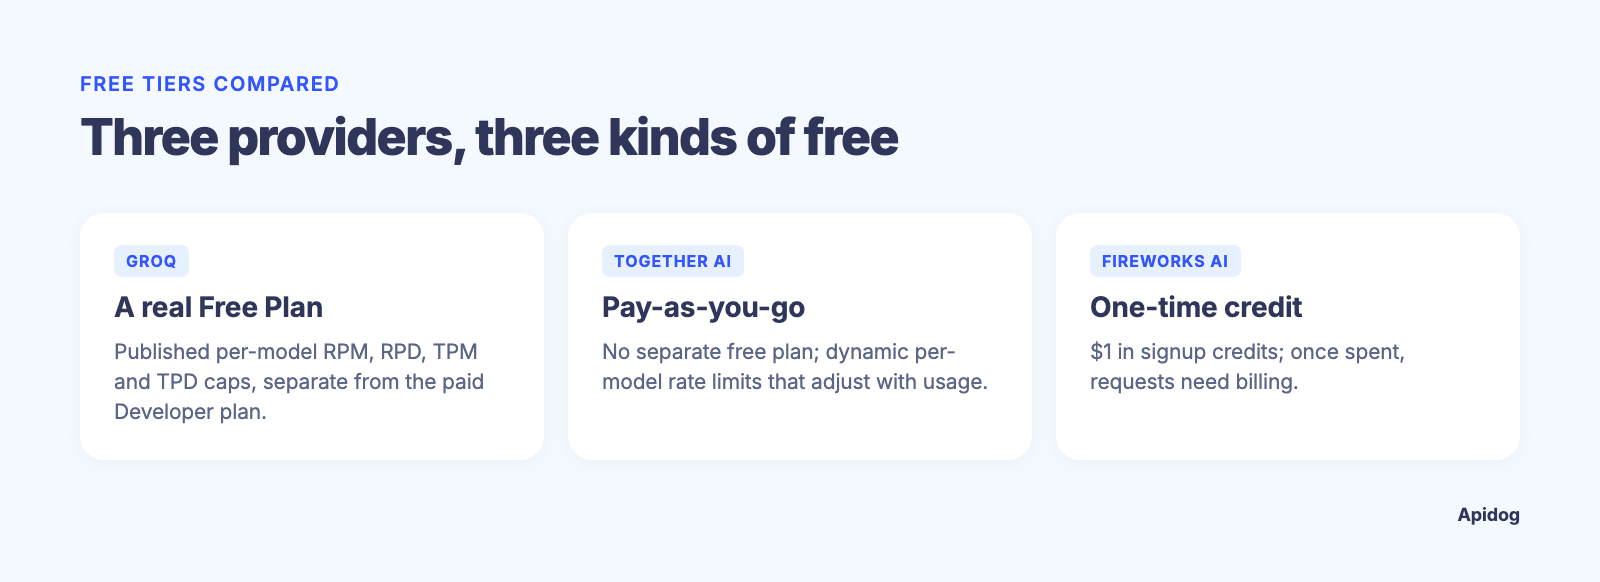
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| รูปแบบการเข้าถึงฟรี | Free Plan (แยกจาก Developer Plan แบบเสียเงิน) | Pay-as-you-go ตั้งแต่สมัคร ไม่มีชื่อ “free plan” แยกต่างหาก | เครดิตสมัครครั้งเดียว |
| โควตาฟรีที่ระบุในเอกสาร | เผยแพร่รายโมเดล: gpt-oss-120b/gpt-oss-20b 30 RPM, 1K RPD, 8K TPM, 200K TPD; compound 30 RPM, 250 RPD, 70K TPM (ตามขีดจำกัดอัตราของ Groq, อ่านเมื่อ 2026-09-15) |
ไม่เผยแพร่เป็นตัวเลขตายตัว อธิบายว่าเป็นแบบไดนามิกต่อองค์กร | เครดิตฟรี $1 ตามราคาของ Fireworks |
| ขีดจำกัดถูกกำหนดอย่างไร | เพดาน RPM/RPD/TPM/TPD ต่อโมเดล บังคับใช้ที่ระดับองค์กร | อัตราแบบไดนามิกต่อโมเดล ปรับตามความจุสดและ successful usage ล่าสุดของคุณ | อิงตามการใช้จ่าย เมื่อใช้เครดิตหมด คำขอจะต้องเปิดการเรียกเก็บเงิน |
| ตรวจสอบตัวเลขของคุณเองได้ที่ไหน | console.groq.com/settings/limits |
Header ของคำตอบในการเรียกจริง เช่น x-ratelimit-reset |
แดชบอร์ดบัญชีและหน้าการเรียกเก็บเงิน |
| โทเค็นที่แคชไว้นับรวมในขีดจำกัดหรือไม่? | ไม่ ตามเอกสารของ Groq เอง | ไม่ได้ระบุไว้ในหน้าที่เราตรวจสอบ | ไม่ได้ระบุไว้ในหน้าที่เราตรวจสอบ |
มีสองสิ่งที่โดดเด่นเมื่อคุณอ่านหน้าต้นทางจริงแทนที่จะอ่านสรุปจาก spec sheet อย่างแรก ตัวเลข Free Plan ของ Groq ข้างต้นเป็นค่าเริ่มต้นที่เผยแพร่ หน้าเดียวกันยังมีแท็บ Developer Plan ที่มีเพดานสูงกว่า และ console.groq.com/settings/limits คือแหล่งอ้างอิงหากตัวเลขของคุณแตกต่าง อย่างที่สอง การจำกัดอัตราของ Together AI ไม่ใช่ตารางเลย หน้า rate-limits ของมันระบุตรง ๆ ว่า “ไม่มีขีดจำกัดต่อโมเดลแบบตายตัวที่เผยแพร่” และเพดานของคุณจะเพิ่มขึ้นตาม “ปริมาณการรับส่งที่ต่อเนื่องและสำเร็จ” นั่นเป็นโมเดลที่แตกต่างอย่างมีความหมายจากแถว free-tier แบบคงที่ และหมายความว่าคำตอบที่ซื่อสัตย์ต่อคำถาม “free RPM ของ Together เท่าไร” คือ “ตรวจ header ของคำตอบคุณ” ไม่ใช่ตัวเลขที่ดึงมาจากตาราง
หากคุณต้องการเจาะลึกรายผู้ให้บริการพร้อมตัวเลขที่ตรวจสอบได้ทีละผลิตภัณฑ์ ดูบทความคู่ของเราเกี่ยวกับ free tier ของ Groq API และ free tier ของ Cerebras API บทความนี้เป็นศูนย์รวม ส่วนสองบทความนั้นเจาะลึกรายผู้ให้บริการอย่างเต็มรูปแบบ
คำขอ vs โทเค็น, ตายตัว vs ไดนามิก
ความแตกต่างเชิงออกแบบที่แท้จริงระหว่างสามรายนี้ไม่ใช่ขนาดของโควตาฟรี แต่เป็นรูปร่างของเพดาน
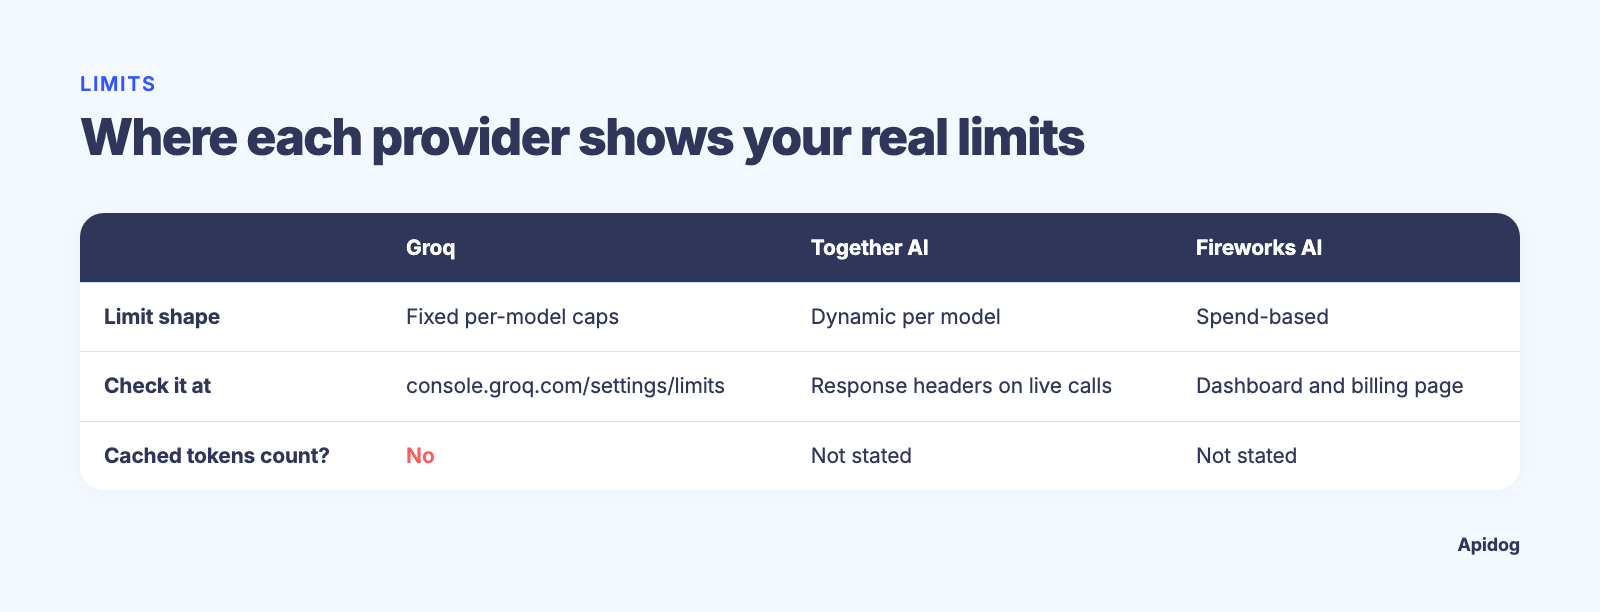
โมเดลของ Groq คือแบบที่นักพัฒนาส่วนใหญ่รู้จักอยู่แล้วจากการทำงานกับ rate limits ที่อื่น: เพดานตายตัวต่อช่วงเวลา แยกเป็น RPM, RPD, TPM และ TPD และมันมีผลที่ระดับองค์กรไม่ใช่ต่อ API key ซึ่งหมายความว่าถ้าคุณสร้างสามคีย์สำหรับสามบริการภายใต้บัญชี Groq เดียว พวกมันจะแชร์พูลเดียวกัน คู่มือทั่วไปของเราเกี่ยวกับ ขีดจำกัดอัตราของ GPT API ครอบคลุมโครงสร้าง RPM/TPM แบบเดียวกันนี้ในเชิงลึกกว่า หากคุณยังไม่เคยทำงานกับเพดานที่อิงโทเค็นมาก่อน
โมเดลของ Together AI ให้รางวัลกับปริมาณการรับส่งที่สม่ำเสมอและสำเร็จ แทนที่จะลงโทษปริมาณแบบ burst ด้วยกำแพงแข็ง บัญชีที่เงียบและบัญชีที่ใช้งานหนักแต่มีพฤติกรรมดีจะไม่ได้เพดานเดียวกัน เพราะเพดานจะปรับตามประวัติล่าสุดของบัญชีคุณเองและความจุสดของโมเดล ณ ขณะนั้น นั่นเป็นข่าวดีหาก workload ของคุณเชื่อถือได้ และเป็นสิ่งที่ไม่รู้จริง ๆ หากปริมาณการรับส่งของคุณเป็นแบบ burst โดยธรรมชาติ
Fireworks AI หลบเลี่ยงการออกแบบ rate-limit เกือบทั้งหมดสำหรับผู้ใช้ใหม่ โดยผูกช่วงฟรีไว้กับยอดคงเหลือเป็นดอลลาร์แทนที่จะเป็นหน้าต่างอัตราคำขอ คุณไม่ได้ถูกจำกัดด้วยความเร็วในการเรียก API แต่ถูกจำกัดด้วยต้นทุนการเรียกของคุณก่อนที่ยอดคงเหลือจะหมด สิ่งนี้พลิกคำถามในการวางแผนจาก “กี่คำขอต่อนาที” เป็น “$1 ซื้อได้กี่โทเค็นที่ราคาต่อโทเค็นของโมเดลนี้” ซึ่งขึ้นอยู่กับโมเดลที่คุณเลือกทั้งหมด
สิ่งเหล่านี้เป็นการเดิมพันที่ต่างกันว่าการใช้งานแบบใดที่ free tier ควรป้องกัน: ปริมาณต่อเนื่อง, การพุ่งแบบ burst หรือการใช้จ่ายรวม ไม่ว่าคุณจะสร้างบนแบบไหน ในที่สุดคุณจะชน 429 และวิธีที่ผู้ให้บริการส่งสัญญาณช่วงเวลานั้นสำคัญพอ ๆ กับตัวเลขที่ทำให้เกิดมัน คู่มือแก้ไขปัญหา rate limit exceeded ของเราอธิบายการอ่าน header ของคำตอบเหล่านั้นและการสร้างตรรกะ retry ที่ไม่ทำให้ปัญหาแย่ลง
พิสูจน์ด้วยตัวเองในห้านาที
เมื่อข้อมูลเหล่านี้จำนวนมากอยู่หลังหน้าล็อกอินหรือ header ของคำตอบสด เส้นทางที่เร็วที่สุดสู่คำตอบจริงไม่ใช่บทความ spec sheet อีกชิ้น แต่เป็นการทดสอบหนึ่งครั้งที่ coding agent ของคุณรันกับทั้งสามราย ด้วย Apidog CLI นั่นคือพรอมป์เดียว ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
โทเค็นได้จาก Apidog ใต้ Account Settings, API Access Token จากนั้นให้พรอมป์เดียวกับ agent:
Use Apidog CLI on project <id>. Create Groq, Together and Fireworks environments
with the OpenAI-compatible base URLs from this article and a comparable model id
in a MODEL variable. Add POST /chat/completions with Bearer auth from {{API_KEY}}
and one test case with an identical prompt and max_tokens. Run it once per
environment with that provider's key, then compare status, latency and the
x-ratelimit headers.
คำสั่งที่มันรัน ตรวจสอบกับ Apidog CLI 2.2.7:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog environment create Together --project <id> --base-url https://api.together.ai/v1
apidog environment create Fireworks --project <id> --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project <id> --file chat-case.json
apidog run --test-case <caseId> --project <id> -e <togetherEnvId> \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
การสลับผู้ให้บริการตอนนี้เป็นแค่ environment ID ไม่ใช่การเขียนใหม่ทั้งหมด Header คือจุดที่เพดานไดนามิกของ Together AI ปรากฏขึ้นแบบเรียลไทม์ และเป็นจุดที่คุณยืนยันได้ว่า org ของ Groq ตรงกับตาราง Free Plan ที่เผยแพร่ เก็บ latency ไว้ในการเปรียบเทียบด้วย: โมเดลที่ในทางเทคนิคฟรีแต่ช้าไม่ถูกกว่าจริง ๆ เมื่อคุณนับเวลาที่ใช้ในการหลบเลี่ยงมัน สิ่งนี้เปลี่ยนหน้าด้านการตลาดสามหน้าให้เป็นชุดข้อมูลเดียวที่เปรียบเทียบได้จากบัญชีของคุณเอง กำลังรันการเปรียบเทียบอย่างต่อเนื่องภายใน agent build ขนาดใหญ่กว่าอยู่หรือไม่? คู่มือของเราเกี่ยวกับ เครื่องมือทดสอบ API สำหรับ AI agents ครอบคลุมเรื่องนั้น และ Apidog CLI ใน Cursor แสดงการตั้งค่า agent
free tier ไหนเหมาะกับกรณีการใช้งานของคุณ
จากเฉพาะสิ่งที่ตรวจสอบได้ในวันนี้ นี่คือคำแนะนำที่ซื่อสัตย์ไม่กี่ข้อ:
- เพดานต่อโมเดลที่คาดเดาได้และอ่านได้โดยไม่ต้องล็อกอิน: Groq เผยแพร่ตัวเลข Free Plan จริง (30 RPM / 1K RPD / 8K TPM / 200K TPD บนโมเดล
gpt-oss) และหน้าต่าง context 131,072 โทเค็นของมันครอบคลุมllama-3.1-8b-instant,llama-3.3-70b-versatileและโมเดลopenai/gpt-ossซึ่งรองรับ workload แบบ open-weight ได้หลากหลายบน endpoint เดียว - ปริมาณการรับส่งที่สม่ำเสมอและมีพฤติกรรมดี ไม่สนใจการติดตาม rate limits: โมเดลไดนามิกของ Together AI เข้ากับรูปแบบนั้น การใช้งานที่สำเร็จอย่างต่อเนื่องจะเพิ่มเพดานของคุณเองเมื่อเวลาผ่านไป แทนที่จะจำกัดคุณไว้ที่ตัวเลขที่ตั้งไว้ตั้งแต่วันแรก
- ไม่มีความยุ่งยากในการตั้งค่า และสบายใจที่จะชนกำแพงการใช้จ่าย: การเข้าถึงฟรีแบบอิงเครดิตของ Fireworks AI ทดสอบราคาต่อโทเค็นจริงตั้งแต่การเรียกครั้งแรก มีประโยชน์เมื่อคำถามจริงคือต้นทุนในระดับสเกลมากกว่าจำนวนคำขอ
ทั้งสามรายโฮสต์โมเดล open-weight คนละชุดย่อย และโมเดลที่เหมาะกับงานของคุณบนผู้ให้บริการรายหนึ่งอาจไม่มีอยู่บนอีกราย
คำถามที่พบบ่อย
Together AI, Fireworks AI และ Groq ใช้ OpenAI SDK ทั้งหมดหรือไม่? ใช่ ทั้งสามรายมีเอกสาร endpoint ที่เข้ากันได้กับ OpenAI ดังนั้นไลบรารีไคลเอนต์ openai มาตรฐานจึงใช้กับรายใดก็ได้เมื่อคุณเปลี่ยน base URL และคีย์
ผู้ให้บริการรายใดมี free tier ใหญ่ที่สุด? ไม่มีในแบบที่คุณเปรียบเทียบได้โดยตรง Groq เผยแพร่ตัวเลข Free Plan จริงต่อโมเดล (30 RPM / 1K RPD / 8K TPM / 200K TPD บน gpt-oss-120b/gpt-oss-20b) Together AI ไม่ได้ตั้งตัวเลขตายตัวเลย และ Fireworks AI ผูกการเข้าถึงฟรีไว้กับยอดเครดิตครั้งเดียวแทนที่จะเป็นโควตา ตรวจสอบ console.groq.com/settings/limits หากตัวเลขของคุณแตกต่าง
rate limits มีผลต่อ API key หรือต่อบัญชี? สำหรับ Groq ขีดจำกัดมีผลที่ระดับองค์กร ดังนั้นหลายคีย์ภายใต้บัญชีเดียวจะแชร์พูลเดียวกัน ตามเอกสาร rate-limits ของมันเอง Together AI และ Fireworks AI ไม่ได้ระบุสิ่งนี้อย่างชัดเจนในหน้าที่เราตรวจสอบ ตรวจสอบในแดชบอร์ดของคุณเองก่อนสันนิษฐานเป็นอย่างอื่น
เกิดอะไรขึ้นเมื่อฉันชน rate limit บนผู้ให้บริการเหล่านี้? คุณจะได้รับคำตอบ HTTP 429 รายละเอียดแตกต่างกัน ดูคู่มือ rate limit exceeded ของเราเกี่ยวกับวิธีอ่าน header การ retry ที่ API ที่เข้ากันได้กับ OpenAI ส่วนใหญ่ส่งกลับ และสร้างตรรกะ backoff แทนการเดา
มีวิธีเปรียบเทียบที่เร็วกว่าการอ่านเอกสารทุกหน้าด้วยตัวเองไหม? ให้ coding agent ของคุณรัน test case ของ Apidog CLI หนึ่งรายการกับสาม environment ตามที่อธิบายข้างต้น ยี่สิบนาทีกับ Apidog CLI จะบอกคุณเกี่ยวกับ workload จริงของคุณได้มากกว่าตารางเปรียบเทียบใด ๆ รวมถึงตารางนี้