
หากต้องการรัน Qwen 3.8 27B ในเครื่อง ให้ติดตั้ง Ollama แล้วรัน ollama pull qwen3.8:27b ตามด้วย ollama run qwen3.8:27b ตัวดีฟอลต์เป็นไฟล์ดาวน์โหลด 4-bit ขนาด 18 GB ดังนั้นคุณจะต้องมี GPU ที่มี VRAM 24 GB ขึ้นไป หรือ Mac ที่มี unified memory 32 GB เนื่องจาก weights เผยแพร่ภายใต้สัญญาอนุญาต Apache-2.0 ตัวโมเดลเองจึงไม่มีค่าใช้จ่าย ค่าใช้จ่ายเดียวของคุณคือฮาร์ดแวร์และค่าไฟ
นั่นคือเวอร์ชันสั้น ๆ ส่วนที่เหลือของคู่มือนี้จะพูดถึงตัวรันที่น่าใช้ทั้ง 4 ตัว (Ollama, LM Studio, llama.cpp และ MLX), ความต้องการหน่วยความจำของแต่ละ quant, ความเร็วที่คาดหวังบนฮาร์ดแวร์จริง และวิธีให้ coding agent ของคุณทดสอบ endpoint ในเครื่องด้วย Apidog CLI เมื่อรันขึ้นแล้ว
ยังไม่คุ้นเคยกับตระกูลนี้ใช่ไหม? บทความ Qwen 3.8 คืออะไร จะพูดถึงเรือธง Max ที่มีพารามิเตอร์ 2.4T ส่วนคู่มือนี้เกี่ยวกับน้องตัวเลขที่เป็น dense model ซึ่งมีขนาดเล็กพอที่จะวางไว้บนโต๊ะคุณได้
Qwen 3.8 27B คืออะไร?
Qwen 3.8 27B เป็น vision-language model แบบ dense ขนาด 27 พันล้านพารามิเตอร์จากทีม Qwen ของ Alibaba เผยแพร่ในเดือนสิงหาคม 2026 ภายใต้สัญญาอนุญาต Apache-2.0 โมเดลนี้อ่านได้ทั้งข้อความ รูปภาพ และวิดีโอ คิดก่อนตอบเป็นค่าเริ่มต้น และมี context window แบบ native 262,144 token ที่ขยายได้ถึง 1 ล้าน token ด้วยการใช้ YaRN scaling
model card อย่างเป็นทางการ ระบุสเปกเหล่านี้ไว้:
| สเปก | Qwen 3.8 27B |
|---|---|
| พารามิเตอร์ | 27B dense (Hub ระบุ 28B รวม vision encoder ด้วย) |
| เลเยอร์ | 64 เลเยอร์ เป็นการผสมผสานระหว่างบล็อก Gated DeltaNet และ Gated Attention |
| Context | 262,144 แบบ native ขยายได้ถึง 1,000,000 ด้วย YaRN |
| อินพุต | ข้อความ รูปภาพ วิดีโอ |
| Thinking | เปิดใช้เป็นค่าเริ่มต้น reasoning_effort มีให้เลือก xhigh, medium หรือ low |
| ฟีเจอร์เสริม | เลเยอร์ Multi-token prediction (MTP) |
| สัญญาอนุญาต | Apache-2.0 |
ในตาราง benchmark ของ Qwen เอง โมเดลนี้ได้คะแนน 61.7 บน SWE-bench Pro, 73.0 บน Terminal Bench 2.1 และ 89.2 บน GPQA Diamond ซึ่งเป็นตัวเลขจากผู้ผลิต บทความ วิเคราะห์ benchmark ของ Qwen 3.8 ของเราอธิบายวิธีอ่านตารางนี้ รวมถึงว่าแถวไหนที่ Qwen ทดสอบเองภายในองค์กร
ทำไมเรื่องนี้จึงสำคัญเมื่อรันในเครื่อง: โมเดล dense ขนาด 27B ที่ 4-bit ใส่ลง GPU สำหรับผู้ใช้ทั่วไปได้เพียงตัวเดียว โดยมี tool calling, vision และ thinking อยู่ในไฟล์เดียวกัน
ต้องใช้ RAM และ VRAM เท่าไรสำหรับ Qwen 3.8 27B?
วางแผนตามขนาดไฟล์ของ quant ที่เลือก บวกเพิ่มอีก 3 ถึง 6 GB สำหรับ KV cache และ runtime สำหรับ Q4_K_M ซึ่งเป็นค่าดีฟอลต์ หมายความว่าต้องมี VRAM 24 GB บน GPU หรือ Mac ที่มีหน่วยความจำ 32 GB
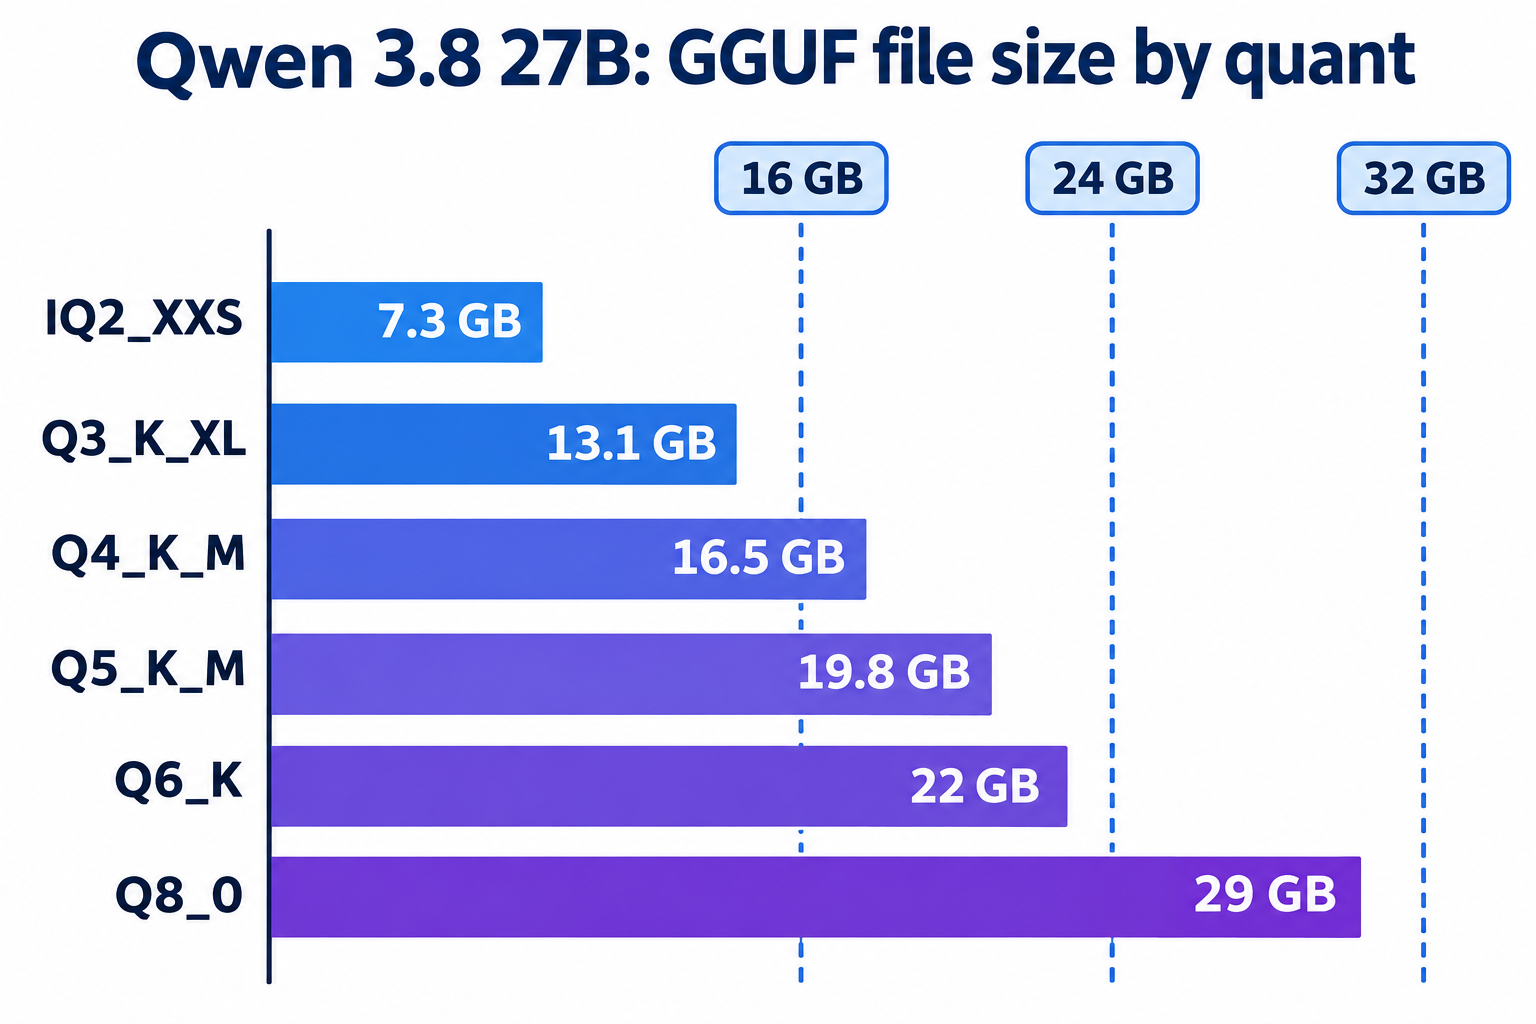
นี่คือขนาดไฟล์ GGUF จาก repo quant ของ unsloth ตรวจสอบเมื่อวันที่ 9 พฤศจิกายน 2026:
| Quant | ขนาดไฟล์ | ฮาร์ดแวร์ที่เหมาะสม |
|---|---|---|
| UD-IQ2_XXS | 7.27 GB | Mac 16 GB หรือ GPU 12 GB คุณภาพลดลงชัดเจน |
| UD-Q3_K_XL | 13.1 GB | GPU 16 GB, Mac 24 GB |
| UD-Q4_K_M | 16.5 GB | GPU 24 GB, Mac 32 GB (จุดที่ดีที่สุด) |
| UD-Q5_K_M | 19.8 GB | GPU 24 GB กับ context สั้น, Mac 32 GB |
| UD-Q6_K | 22 GB | GPU 32 GB, Mac 48 GB |
| Q8_0 | 29 GB | GPU 48 GB, Mac 64 GB |
Vision projector (mmproj-F16.gguf) เพิ่มอีก 928 MB หากต้องการรับอินพุตรูปภาพ แท็ก qwen3.8:27b ดีฟอลต์ของ Ollama มีขนาด 18 GB เพราะรวม vision มาให้แล้ว
ความยาว context คือต้นทุนที่มักถูกมองข้าม การคำนวณวางแผนของ llm-speed ระบุว่า Q4_K_M ใช้ประมาณ 21.9 GB เมื่อใช้ context 32,000 token นั่นคือเหตุผลที่การ์ด 24 GB ถือเป็นเพดานขั้นต่ำที่ใช้งานได้จริงสำหรับ Q4 และที่ไม่ควรโหลด context เต็ม 262K เว้นแต่คุณมีหน่วยความจำเหลือเฟือ
บน Mac อย่าลืมว่า macOS จะเก็บ unified memory ส่วนหนึ่งไว้ใช้กับระบบ Mac 24 GB สามารถโหลด Q4_K_M ได้ในทางเทคนิค แต่คุณจะเหลือพื้นที่น้อยมากสำหรับ context หรือเบราว์เซอร์ เราแนะนำให้ใช้ Q3_K_XL ในกรณีนี้
Qwen 3.8 27B รันในเครื่องเร็วแค่ไหน?
คาดว่าจะได้ประมาณ 38 ถึง 44 token ต่อวินาทีบน RTX 3090 หรือ 4090 ที่ Q4_K_M ด้วย llama.cpp และ 65 ถึง 75 บน RTX 5090 ส่วน Mac Studio ที่ใช้ M3 Ultra จะ decode ได้ราว 25 ถึง 27 token ต่อวินาที
เราไม่ได้ทดสอบ benchmark เอง ตัวเลขเหล่านี้มาจากการรันจริงที่ llm-speed เผยแพร่ พร้อมระบุฮาร์ดแวร์และ runtime ที่ใช้:
| ฮาร์ดแวร์ | Quant / runtime | Decode tok/s | Prefill tok/s |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M, llama.cpp | 38.6 (แชทสั้น, ctx 4K) | 482 |
| RTX 4090 24 GB | Q4_K_M, llama.cpp | 43.4 (แชทสั้น, ctx 4K) | 448 |
| RTX 5090 32 GB | Q4_K_M, llama.cpp | 75.2 (แชทสั้น, ctx 4K) | 563 |
| L40S 45 GB | Q4_K_M, llama.cpp | 34.3 (แชทสั้น) | 569 |
| M3 Ultra 96 GB | Q4_K_M, llama.cpp | 25.2 (แชทสั้น) | 45 |
| M3 Ultra 96 GB | 4-bit, MLX 0.31.3 | 27.3 (แชทสั้น) | 12 |
ความเร็ว decode บน GPU แทบไม่ลดลงแม้ context ยาวขึ้น: 4090 ยังทำได้ 39.0 tok/s หลังจากรับ prompt 33,133 token ส่วน Prefill คือจุดที่ Mac ตกขบหน่วยลง จาก prompt 11,827 token ตัว M3 Ultra ประมวลผลได้ราว 283 tok/s เทียบกับประมาณ 2,000 ถึง 3,000 บน 4090 ดังนั้น codebase ขนาดใหญ่จะต้องรอหลายสิบวินาทีกว่าจะได้ token แรก
โหมด thinking ก็กินเวลาของคุณเช่นกัน เมื่อ Simon Willison สั่งให้ Qwen 3.8 27B ในเครื่องระบุเกมจาก model weights ดิบ คำตอบหนึ่งใช้เวลา 46 นาทีและ reasoning tokens 43,506 token สำหรับงานทั่วไป ควรลด reasoning_effort เป็น low หรือปิด thinking ไปเลย
รัน Qwen 3.8 27B ด้วย Ollama
Ollama เป็นทางที่เร็วที่สุดบนทุกระบบปฏิบัติการ ติดตั้งจาก ollama.com แล้วทำดังนี้:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
บน Apple Silicon ให้ลองใช้แท็ก qwen3.8:27b-mlx ซึ่งใช้ MLX backend ที่ขนาด 18 GB เท่ากัน
Context ดีฟอลต์ของ Ollama มีขนาดเล็ก ซึ่งจะทำให้เซสชัน agent ที่ยาวพัง ให้เพิ่มค่านี้ก่อนเริ่มเซิร์ฟเวอร์:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
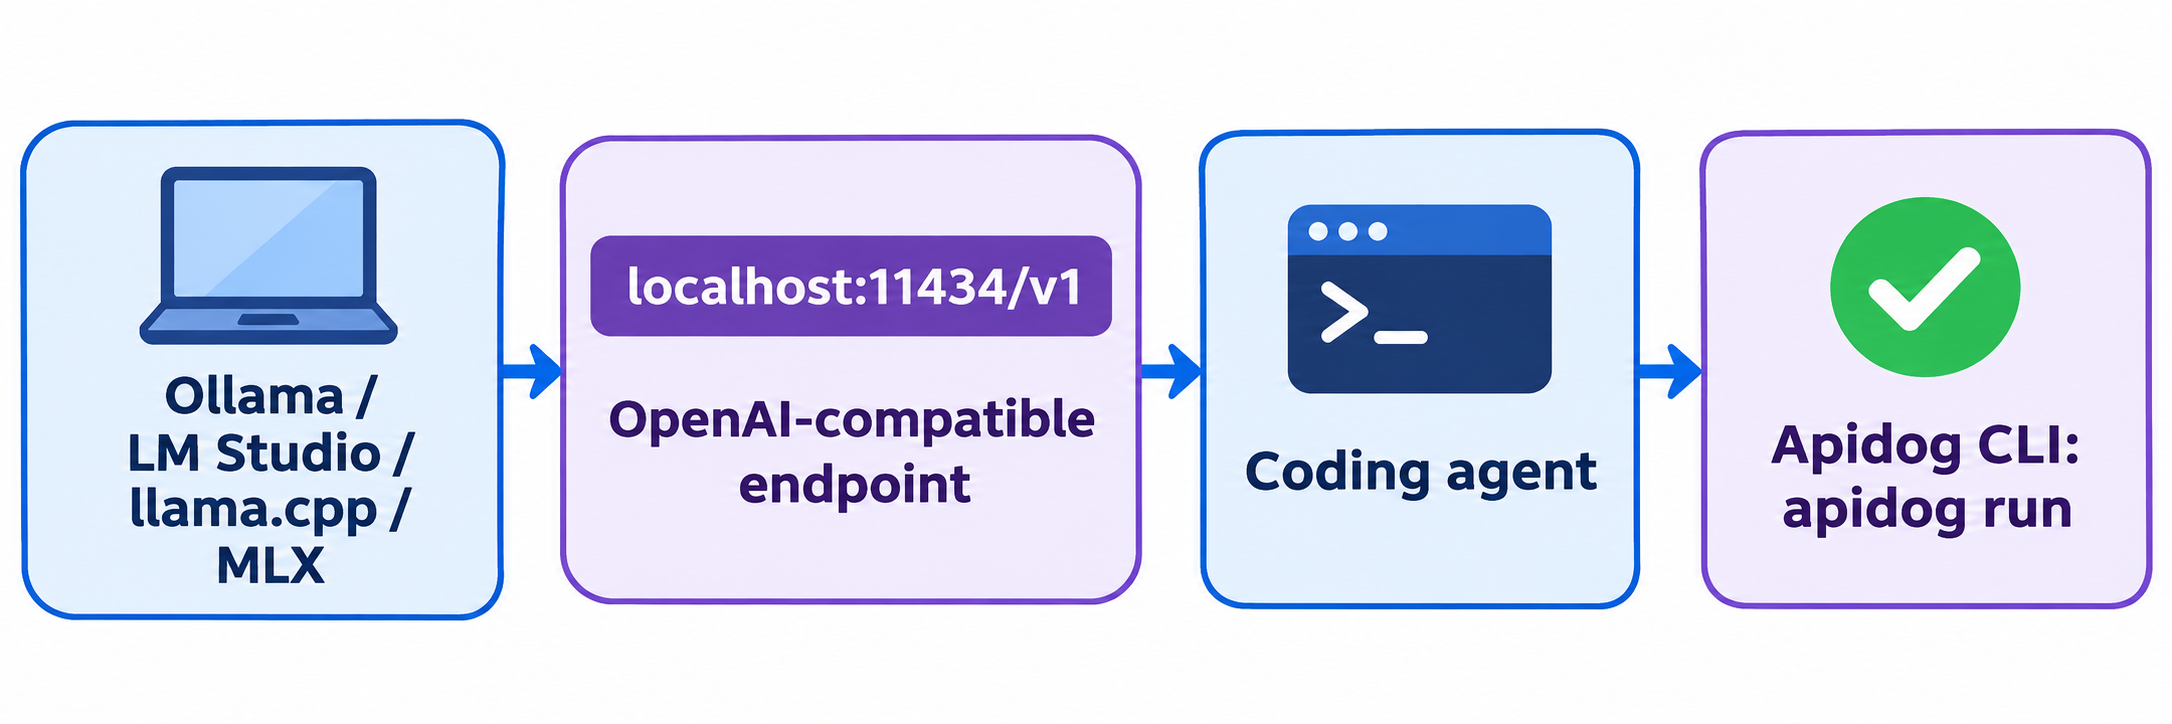
Ollama ยังเปิด API ที่รองรับ OpenAI ที่ http://localhost:11434/v1 ดังนั้น OpenAI SDK ตัวไหนก็ใช้ได้โดยแค่เปลี่ยน base URL:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
อยากใช้ภายใน coding agent? Ollama มีคำสั่งลัดสำหรับเปิดโปรแกรม: ollama launch claude --model qwen3.8 จะเริ่ม Claude Code โดยชี้ไปที่โมเดลในเครื่อง และ ollama launch opencode --model qwen3.8 ทำแบบเดียวกันสำหรับ OpenCode
รันด้วย LM Studio
LM Studio เป็นตัวเลือกที่ดีหากคุณต้องการ GUI และตั้งค่าการโหลดแบบรายโมเดล ให้ค้นหา Qwen 3.8 27B ดาวน์โหลด build lmstudio-community/Qwen3.8-27B-GGUF ที่ Q4_K_M (16.8 GB) แล้วโหลดขึ้นมา
มีตัวเลือกหนึ่งที่สำคัญ: ให้เพิ่มความยาว context ตอนโหลดโมเดล Simon Willison พบว่า context ดีฟอลต์ 8,192 token เกิด error กับ prompt ยาวของเขา และต้องโหลดด้วย context ที่ใหญ่ขึ้น
จากนั้นเปิดแท็บ Developer แล้วเริ่มเซิร์ฟเวอร์ในเครื่อง หรือรัน lms server start จากเทอร์มินัล ซึ่ง endpoint ที่รองรับ OpenAI จะอยู่ที่ http://localhost:1234/v1
รันด้วย llama.cpp
llama.cpp ให้การควบคุมสูงสุด และเป็นตัวขับเคลื่อนผลการรัน benchmark ส่วนใหญ่ข้างต้น บน macOS หรือ Linux:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf ดาวน์โหลด quant ตรงจาก Hugging Face, --jinja ใช้ chat template ของโมเดล (จำเป็นสำหรับ tool call และ thinking), -c ตั้งค่า context และ -ngl 99 วางทุกเลเยอร์ลง GPU ค่า sampling เหล่านี้เป็นคำแนะนำของ Qwen สำหรับโหมด thinking ส่วนโหมด non-thinking model card แนะนำ temperature 0.7, top_p 0.8, top_k 20 และ presence_penalty 1.5
หากต้องการปิด thinking สำหรับคำขอเดียว ให้ส่ง "chat_template_kwargs": {"enable_thinking": false} ใน body
รันด้วย MLX บน Mac
MLX เป็น array framework ของ Apple เอง และมักเป็น runtime ที่ decode เร็วที่สุดบน Apple Silicon ติดตั้ง mlx-lm และใช้ เวอร์ชันแปลง 4-bit จาก mlx-community:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server เปิด route /v1/chat/completions ที่รองรับ OpenAI องค์กร mlx-community ยังเผยแพร่เวอร์ชัน 8-bit, mxfp4 และ MTP หากคุณอยากแลกหน่วยความจำกับคุณภาพหรือความเร็ว
ให้ coding agent ของคุณทดสอบ endpoint ในเครื่องด้วย Apidog CLI
ทุกตัวรันให้บริการในรูปแบบ OpenAI-compatible เหมือนกัน แต่แต่ละตัวจัดการ thinking block, tool call และ timeout แตกต่างกัน ก่อนชี้แอปไปที่ localhost ให้ coding agent ของคุณสร้างชุดทดสอบที่รันซ้ำได้ด้วย Apidog CLI เพื่อให้เจอ template ที่พังหรือ context cap ได้ในไม่กี่วินาที ไม่ใช่กลางงาน
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง Claude Code, Codex หรือ Cursor ด้วย prompt เดียว:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
Agent จะอ่าน schema ของ payload แต่ละอัน ตรวจสอบ JSON สร้าง resource และรัน test case:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
ค่า --timeout-request ที่ยาวสำคัญมากในจุดนี้: โมเดล 27B ในโหมด thinking อาจใช้เวลาหลายนาทีบน Mac เปลี่ยน base URL เป็น http://localhost:1234/v1 หรือ :8080/v1 แล้ว test case เดียวกันก็ตรวจ LM Studio, llama.cpp หรือ MLX ได้ สำหรับการตั้งค่า agent เพิ่มเติม ดูได้ที่ Apidog CLI ใน Claude Code และ คู่มือคำสั่ง apidog run แผน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน
รันในเครื่อง vs API Qwen 3.8 แบบโฮสต์
การรันในเครื่องช่วยให้ prompt อยู่บนเครื่องคุณ ใช้งานออฟไลน์ได้ และไม่มีค่าใช้จ่ายต่อ token ข้อแลกเปลี่ยนคือความเร็วและสเกล: endpoint แบบโฮสต์ให้บริการ Qwen 3.8-Max ที่ใหญ่กว่ามาก พร้อม context 1M และไม่ต้องรอ prefill หากต้องการเรือธง อ่าน คู่มือ Qwen 3.8 API ของเรา หรือ วิธีใช้ฟรี สำหรับ agentic coding กับทั้งสองขนาด Qwen 3.8 สำหรับการเขียนโค้ด เปรียบเทียบการตั้งค่า harness ให้ดู
คำถามที่พบบ่อย
รัน Qwen 3.8 27B ในเครื่องได้ฟรีไหม? ได้ weights เผยแพร่บน Hugging Face ภายใต้ Apache-2.0 และ Ollama, LM Studio, llama.cpp และ MLX ล้วนฟรี คุณจ่ายเฉพาะค่าฮาร์ดแวร์และค่าไฟเท่านั้น
รัน Qwen 3.8 27B บน Mac 16 GB ได้ไหม? ได้เฉพาะ quant ระดับ 2-bit อย่าง UD-IQ2_XXS (7.27 GB) กับ context สั้น ๆ และคุณภาพจะลดลงชัดเจน Mac 32 GB ที่รัน Q4_K_M คือการตั้งค่าที่สบายใจที่สุด
Qwen 3.8 27B รันบน RTX 3090 ได้ไหม? ได้ Q4_K_M ใส่ใน 24 GB ได้พร้อมที่เหลือสำหรับ context 16K ถึง 32K และ llm-speed วัดได้ประมาณ 38 token ต่อวินาทีบน llama.cpp
ปิดโหมด thinking ทำอย่างไร? ส่ง "chat_template_kwargs": {"enable_thinking": false} บน llama.cpp หรือ vLLM หรือลด reasoning_effort เป็น low Qwen แนะนำ temperature 0.7 และ top_p 0.8 สำหรับโหมด non-thinking
โมเดลในเครื่องรองรับรูปภาพไหม? รองรับ แท็ก 18 GB ของ Ollama รวม vision มาให้แล้ว สำหรับ llama.cpp ให้ดาวน์โหลดไฟล์ mmproj-F16.gguf มาไว้คู่กับโมเดล
Qwen 3.8 27B กับ Qwen 3.8-Max ต่างกันอย่างไร? Max เป็นเรือธงแบบ mixture-of-experts ขนาด 2.4T พารามิเตอร์ ที่ให้บริการผ่าน API ของ Alibaba ส่วน 27B เป็น dense model ที่เล็กพอสำหรับ GPU ตัวเดียวหรือ Mac 32 GB