
คุณสามารถรัน NVIDIA Nemotron 3.5 Transcribe ใหม่บน GPU ตัวเดียวและถอดเสียงบันทึกยาวหนึ่งชั่วโมงใน 40 ภาษาด้วยกัน โดยไม่ต้องจ่ายต่อนาทีหรือส่งเสียงให้ใคร มันเป็นโมเดลน้ำหนักเปิดชั้นนำบน Hugging Face Open ASR Leaderboard มาพร้อมสัญญาอนุญาต OpenMDW-1.1 ที่ใช้เชิงพาณิชย์ได้ และ NVIDIA ได้เผยแพร่น้ำหนัก BF16, FP8 และ NVFP4 ในวันเปิดตัว 28 ตุลาคม 2026
คู่มือนี้ครอบคลุมฮาร์ดแวร์ที่คุณต้องการ วิธีการรันสามวิธี (vLLM, SGLang-Omni และ Transformers) คำสั่งที่แน่นอนจาก การ์ดโมเดลอย่างเป็นทางการ และการตั้งค่าที่มักทำให้ผู้คนสับสน คำสั่งทั้งหมดคัดลอกจาก การ์ดเมื่อวันที่ 29 ตุลาคม 2026
เพิ่งรู้จักโมเดลนี้? คู่มือฟรี ของเราอธิบายว่ามันทำอะไรและจัดอันดับอย่างไร ไม่มี GPU? API โฮสต์ มีค่าใช้จ่าย $0.002 ต่อนาที
ทำไมต้องรันในเครื่อง
- ไม่มีบิลต่อนาที ที่ DeepInfra คิด $0.002 ต่อนาที 10,000 ชั่วโมงมีค่าใช้จ่าย $1,200 บน GPU ของคุณเอง ค่าใช้จ่ายคือค่าไฟฟ้า
- ความเป็นส่วนตัว สายลูกค้า การบันทึกทางการแพทย์ และการบันทึกทางกฎหมายจะไม่ออกจากเครือข่ายของคุณ
- ชุดคุณสมบัติเต็ม เส้นทาง vLLM รองรับการประทับเวลาแบบคำ การแยกผู้พูด การแปล และพรอมต์บริบท ปลายทางโฮสต์บางแห่งเปิดเผยเพียงบางส่วนเท่านั้น
- การปรับแต่งละเอียด โพสต์เปิดตัวของ NVIDIA แสดงให้เห็นการปรับแต่งละเอียดทางการแพทย์ที่ลด WER จาก 30.8% เป็น 11.8% คุณทำเช่นนั้นได้เฉพาะกับน้ำหนักเท่านั้น
ฮาร์ดแวร์: อะไรที่รันมันได้
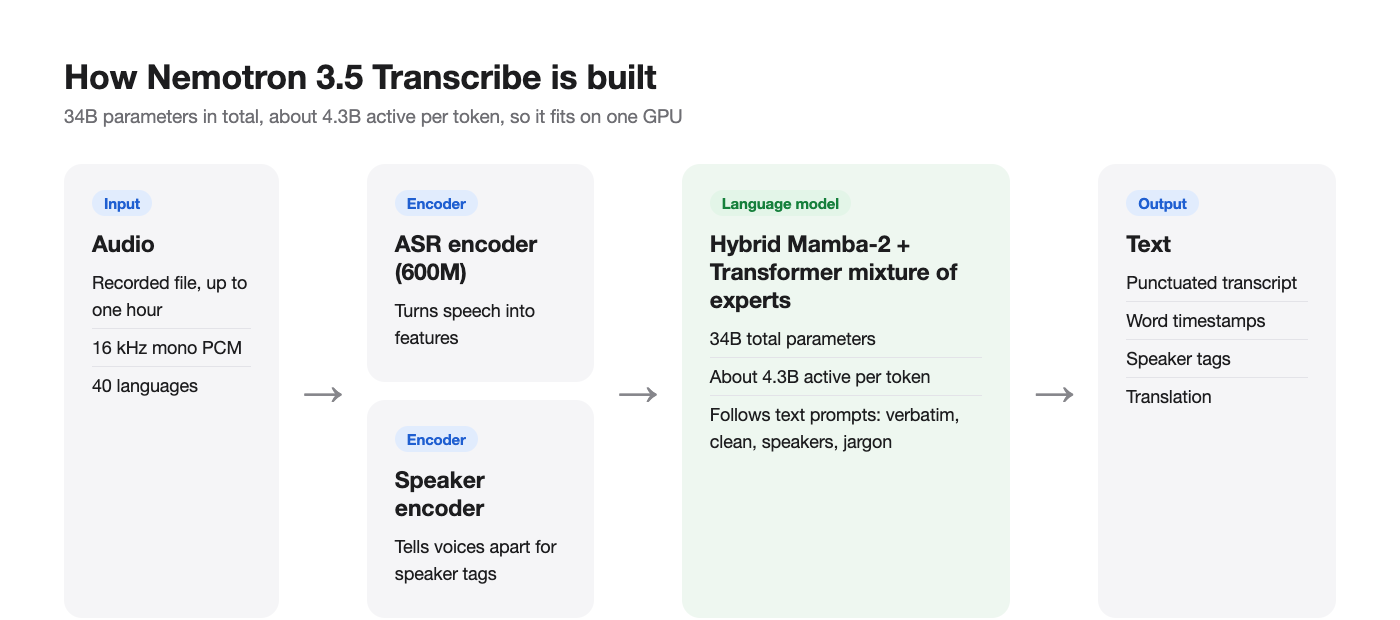
โมเดลนี้มีพารามิเตอร์ทั้งหมด 34B และแอ็กทีฟประมาณ 4.3B ดังนั้นน้ำหนักจึงมีขนาดใหญ่แม้ว่าการคำนวณต่อโทเค็นจะน้อย เป้าหมายอ้างอิงของ NVIDIA คือ หนึ่ง H100 80 GB ใน BF16 ตารางความเข้ากันได้บนการ์ดโมเดล:
| GPU | ความแม่นยำ | รันไทม์ |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | NVFP4 เท่านั้น | vLLM 0.32.0, Transformers, GGML |
เลือกเช็กพอยต์สำหรับการ์ดของคุณ:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
การ์ด 24 GB อย่าง RTX 4090 ไม่ได้อยู่ในรายการ และ Apple Silicon ไม่รองรับ ระบบปฏิบัติการคือ Linux หรือ Windows ผ่าน WSL2 GGML ยังรันบน Windows แบบเนทีฟได้ แต่โพสต์เปิดตัวของ NVIDIA กล่าวว่า บิลด์โลคัล NeMo-Speech.cpp ยัง "เร็วๆ นี้"
ตัวเลือกที่ 1: เซิร์ฟเวอร์ vLLM (แนะนำ)
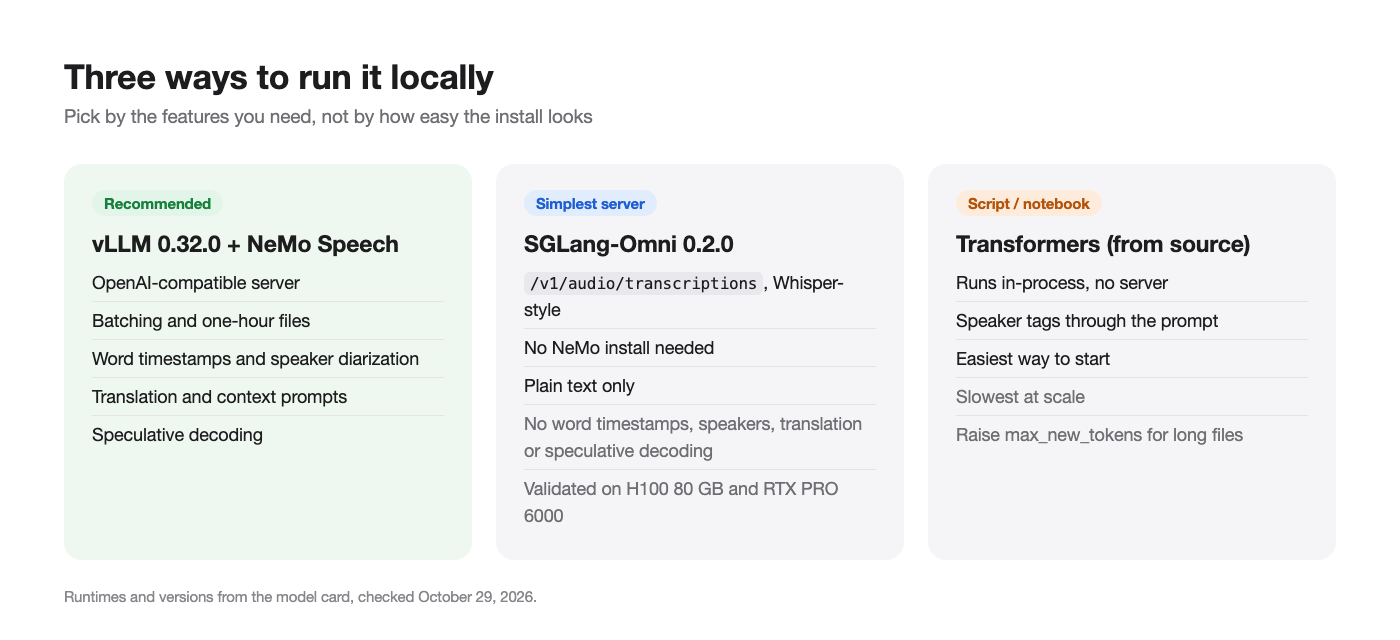
vLLM ให้ปลายทางที่เข้ากันได้กับ OpenAI พร้อมการแบตช์ ไฟล์ยาวหนึ่งชั่วโมง การถอดรหัสแบบคาดเดา และการประทับเวลาแบบคำ ต้องใช้ vLLM 0.32.0 และสาขาหลัก NeMo Speech ล่าสุด ซึ่งให้ปลั๊กอิน vLLM ของโมเดล
ติดตั้ง
การ์ดใช้ uv และ Python 3.13:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
PyAV (av) ช่วยให้ถอดรหัส M4A และรูปแบบบีบอัดอื่นๆ ได้โดยไม่ต้องใช้ FFmpeg ของระบบ OpenCV มีอยู่เพราะ vLLM ต้องการมัน และการตั้งค่าดependencyของ NeMo ไม่ได้รวมมาให้
เริ่มเซิร์ฟเวอร์
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
แฟล็กที่ควรทำความเข้าใจ:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600เพิ่มขีดจำกัดเสียงของ vLLM จาก 600 วินาทีเป็นหนึ่งชั่วโมง หากลืม ไฟล์ยาวจะล้มเหลวVLLM_USE_V2_MODEL_RUNNER=0คงตัวรัน V1 ซึ่งการประทับเวลาแบบคำต้องการ--speculative-configเปิดการทำนายหลายโทเค็นด้วยโทเค็นร่างแปดตัว (MTP8) บน H100 NVIDIA วัด RTFx ภาษาอังกฤษแบบแบตช์ได้ 270 ด้วย MTP8 และ 410 ด้วย MTP2 ดังนั้นลอง"num_speculative_tokens":2หากคุณสนใจปริมาณงานมากกว่าความหน่วง--middleware ... ctc_timestamp_middlewareและ--trust-request-mm-kwargsช่วยให้คำขอขอการประทับเวลาแบบคำได้- การตั้งค่าเหล่านี้มุ่งเป้าไปที่ H100 80 GB บนการ์ดอื่น ให้ลด
--gpu-memory-utilization,--max-model-lenหรือ--max-num-seqs
เซิร์ฟเวอร์ฟังบน 127.0.0.1:8000 เพิ่ม --host 0.0.0.0 เพื่อเข้าถึงจากเครื่องอื่นในเครือข่ายของคุณ
ส่งไฟล์
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
เปลี่ยนคำสั่งข้อความสำหรับพรอมต์งานใดๆ สำหรับการประชุมที่มีหลายเสียง:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
คำขอประทับเวลาแบบคำมีกฎ: หนึ่งไฟล์บันทึกต่อคำขอ stream=false และ n=1 การตอบกลับจะมีออบเจ็กต์ ctc_timestamps พร้อมคำ เวลาเริ่มต้นและสิ้นสุดเป็นวินาที และแท็กผู้พูด
ตัวเลือกที่ 2: SGLang-Omni สำหรับการถอดเสียงแบบธรรมดา
หากคุณต้องการเพียงข้อความจากไฟล์ทั้งหมด SGLang-Omni 0.2.0 นั้นง่ายกว่าและไม่ต้องใช้ NeMo มันได้รับการตรวจสอบบน H100 80 GB หนึ่งตัวและ RTX PRO 6000 Blackwell หนึ่งตัวกับเช็กพอยต์ BF16 หรือ FP8
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
เส้นทาง /v1/audio/transcriptions นั้นตรงกับรูปแบบที่ Whisper API ของ OpenAI ใช้ ดังนั้นโค้ดไคลเอนต์ Whisper ที่มีอยู่มักต้องการเพียง base URL ใหม่ ข้อแลกเปลี่ยน: ไม่มีการประทับเวลาแบบคำ ป้ายผู้พูด การแปล หรือการถอดรหัสแบบคาดเดาในการผสานรวมนี้
ตัวเลือกที่ 3: Transformers ในสคริปต์
สำหรับโน้ตบุ๊กและงานครั้งเดียว ให้รันในโปรเซสด้วย Hugging Face Transformers ที่ติดตั้งจากซอร์ส:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
เป็นวิธีที่ง่ายที่สุดในการเริ่มต้นและวิธีที่ช้าที่สุดในการรันในระดับสเกล เพิ่ม max_new_tokens สำหรับไฟล์ยาว: หนึ่งชั่วโมงที่หนาแน่นสามารถสร้างได้ประมาณ 20,000 โทเค็น
มันเร็วแค่ไหนบน GPU ของคุณเอง?
ตัวเลขพาดหัวของ NVIDIA คือ 2,238 วินาทีของเสียงต่อวินาทีบน RTX PRO 6000 Blackwell หนึ่งตัว ด้วยน้ำหนัก NVFP4 และการถอดรหัสแบบคาดเดา DFlash2 และ 0.13 วินาทีในการส่งคืนคลิป 30 วินาที อ่านเชิงอรรถ: ตัวเลขเหล่านั้นมาจาก NIM ที่ปรับให้เหมาะสม ซึ่งการเปลี่ยนแปลงการให้บริการยังไม่โอเพนซอร์ส การ์ดกล่าวว่าการผสานรวม vLLM แบบเปิดคาดว่าจะช้ากว่าประมาณสองเท่า
สำหรับการถอดเสียงภาษาอังกฤษแบบแบตช์บน H100 ใน BF16 การ์ดระบุตัวเลข RTFx เหล่านี้ (วินาทีของเสียงต่อวินาทีของการคำนวณ):
| การถอดรหัสแบบคาดเดา | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
แม้แต่แถวที่ช้าที่สุดก็เคลียร์เสียงหนึ่งชั่วโมงได้ในเวลา GPU ต่ำกว่า 15 วินาทีสำหรับงานแบบแบตช์ หากคุณต้องการโมเดลร่าง DFlash2 โปรดทราบว่า vLLM 0.32.0 ต้องมีแพตช์เล็กน้อยจากการ์ด DFlash2 ปิดการประทับเวลาแบบคำ และคุณไม่ควรใช้ร่วมกับ MTP
ปัญหาทั่วไปและวิธีแก้ไข
- ไฟล์ยาวถูกตัดที่ 10 นาที คุณข้าม
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600 - ไม่มีการประทับเวลาในการตอบกลับ ตรวจสอบ
VLLM_USE_V2_MODEL_RUNNER=0, แฟล็ก--middlewareและคำขอมีstream=falseและหนึ่งไฟล์บันทึก - หน่วยความจำไม่พอบนการ์ดขนาดเล็ก เปลี่ยนไปใช้เช็กพอยต์ FP8 หรือ NVFP4 และลด
--max-num-seqs - วลีซ้ำที่ส่วนท้ายของบทถอดเสียง การ์ดแนะนำตัวป้องกันลูปการสร้างบนเอาต์พุตสุดท้าย จำกัด
max_tokensและตัดส่วนซ้ำ - สะกดชื่อผิด เพิ่ม
Context terms: <names>ลงในพรอมต์ - เสียงพื้นหลังในบทถอดเสียง ลองพรอมต์ near-field แบบทดลองจากการ์ด ซึ่งลด WER บนเสียงผสมจาก 27.32% เป็น 4.78% ในการทดสอบของ NVIDIA
หากคุณเพิ่งรู้จัก vLLM เอง คำอธิบาย vLLM ของเราครอบคลุมวิธีการแบตช์คำขอและจัดการหน่วยความจำ GPU
ให้เอเจนต์เขียนโค้ดของคุณทดสอบเซิร์ฟเวอร์โลคัลด้วย Apidog CLI
โมเดลโลคัลจะมีประโยชน์ก็ต่อเมื่อปลายทางของมันยังคงถูกต้องผ่านการอัปเกรด vLLM การปรับพรอมต์ และการสลับเช็กพอยต์ ให้เอเจนต์เขียนโค้ดของคุณดูแลสิ่งนั้นด้วย Apidog CLI โดยรันการตรวจสอบกับ http://127.0.0.1:8000 จากเครื่องเดียวกัน
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้พรอมต์หนึ่งอย่างกับเอเจนต์ของคุณ:
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
เอเจนต์อ่านสคีมา ตรวจสอบเพย์โหลด เขียนกรณีทดสอบ และรัน它们:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
รันมันหลังจากอัปเกรดเซิร์ฟเวอร์ทุกครั้ง หรือเชื่อม apidog run ... -r junit เข้ากับ CI ดังที่แสดงใน Apidog CLI ใน CI/CD pipeline สำหรับการตั้งค่าเอเจนต์ ดู Apidog CLI ใน Claude Code
คำถามที่พบบ่อย
ฉันสามารถรัน Nemotron 3.5 Transcribe บน RTX 4090 ได้หรือไม่? มันไม่อยู่ในรายการความเข้ากันได้ของ NVIDIA การ์ดสำหรับผู้บริโภคที่เล็กที่สุดที่ระบุคือ RTX 5090 กับเช็กพอยต์ NVFP4
มันรันบน Mac ได้หรือไม่? ไม่มีรันไทม์อย่างเป็นทางการที่รองรับ Apple Silicon ณ วันที่ 29 ตุลาคม 2026
การใช้ในเครื่องฟรีสำหรับผลิตภัณฑ์เชิงพาณิชย์หรือไม่? สัญญาอนุญาต OpenMDW-1.1 อนุญาตให้ใช้เชิงพาณิชย์และไม่เชิงพาณิชย์ อ่านข้อความสัญญาอนุญาตสำหรับเงื่อนไขการระบุที่มา before shipping.
มันถอดเสียงสดได้หรือไม่? ไม่ได้ มันเป็นโมเดลออฟไลน์สำหรับไฟล์ที่บันทึกไว้ NVIDIA มีโมเดล Nemotron 3.5 ASR Streaming แยกต่างหากสำหรับการใช้งานสด
อันไหนเร็วกว่า vLLM หรือ SGLang-Omni? NVIDIA ไม่ได้เผยแพร่การเปรียบเทียบแบบตัวต่อตัว ใช้ vLLM เมื่อคุณต้องการการประทับเวลา ผู้พูด หรือการแปล และ SGLang-Omni สำหรับเซิร์ฟเวอร์ข้อความล้วนที่ง่ายที่สุด
มันจัดอันดับอย่างไรเมื่อเทียบกับโมเดลโลคัลอื่นๆ? มันนำหน้าโมเดลน้ำหนักเปิดทุกตัวบน Open ASR Leaderboard วันที่ 28 ตุลาคม รายการ โมเดลแปลงเสียงเป็นข้อความโอเพนซอร์สที่ดีที่สุด ของเราเปรียบเทียบ它与 Qwen3-ASR, Granite Speech, Canary-Qwen, Voxtral และ Whisper
รันมัน
ดาวน์โหลดเช็กพอยต์ที่เข้ากับ GPU ของคุณ เริ่ม vLLM ด้วยขีดจำกัดเสียงหนึ่งชั่วโมงและมิดเดิลแวร์ประทับเวลา และส่งไฟล์ WAV ผ่านไคลเอนต์ OpenAI จากนั้นให้เอเจนต์ของคุณรันการตรวจสอบ Apidog กับปลายทางโลคัล เพื่อให้ทุกการอัปเกรดพิสูจน์ว่ายังถอดเสียงได้ก่อนที่คุณจะไว้วางใจกับบันทึกจริง