
กำลังมองหาโมเดลภาษา AI ขนาดกะทัดรัดที่ให้ประสิทธิภาพที่แข็งแกร่งบนฮาร์ดแวร์ในเครื่องของคุณอยู่ใช่ไหม? Google Gemma 3 270M เป็นโมเดลที่เล็กที่สุดในซีรีส์ Gemma โดยมีพารามิเตอร์ 270 ล้านตัวและความสามารถที่แข็งแกร่ง โดยไม่ต้องใช้ทรัพยากรมากเท่าโมเดลขนาดใหญ่ เหมาะสำหรับนักพัฒนาที่สร้างคุณสมบัติ AI ที่ปลอดภัยและมีความหน่วงต่ำ Gemma 3 270M รองรับการสร้างข้อความ, Q&A, การสรุป และอื่นๆ อีกมากมาย—ทั้งหมดนี้บนอุปกรณ์ของคุณเอง
เคล็ดลับ: ผสานรวม Gemma 3 270M เข้ากับแอปพลิเคชันที่ขับเคลื่อนด้วย API ของคุณได้อย่างราบรื่นด้วย Apidog—แพลตฟอร์มแบบครบวงจรสำหรับการออกแบบ, ทดสอบ, จำลอง, และจัดทำเอกสาร API ที่เชื่อมต่อกับโมเดล AI ในเครื่องของคุณ Apidog ช่วยเร่งการพัฒนาและรับประกันว่าคุณสมบัติ AI ของคุณจะเชื่อถือได้ตั้งแต่ต้นแบบไปจนถึงการใช้งานจริง
ทำไมต้องใช้ Gemma 3 270M สำหรับงาน AI ในเครื่อง?
Gemma 3 270M ได้รับการออกแบบมาสำหรับนักพัฒนาที่ให้ความสำคัญกับ:
- ความเป็นส่วนตัวบนอุปกรณ์: ข้อมูลไม่เคยออกจากฮาร์ดแวร์ของคุณ
- ความหน่วงต่ำ: การตอบสนองทันที เหมาะสำหรับคุณสมบัติแบบเรียลไทม์
- ประสิทธิภาพของทรัพยากร: ทำงานบนแล็ปท็อป, เดสก์ท็อป, หรือแม้แต่อุปกรณ์มือถือ
ด้วยหน้าต่างบริบทสูงสุด 32,000 โทเค็นและตัวเลือกการ Quantization เช่น Q4_0 QAT, Gemma 3 270M สร้างความสมดุลระหว่างความแม่นยำกับข้อกำหนดด้านหน่วยความจำและการประมวลผลที่น้อยที่สุด บรรลุผลลัพธ์ที่เกือบจะมีความแม่นยำเต็มที่ในขณะที่ใช้หน่วยความจำน้อยกว่า 200MB ในโหมด INT4—ซึ่งเป็นข้อได้เปรียบที่สำคัญสำหรับการปรับใช้บน Edge และมือถือ
สถาปัตยกรรม Gemma 3 270M: อะไรคือสิ่งที่ทำให้มีประสิทธิภาพ?
Google Gemma 3 270M สร้างขึ้นบนเฟรมเวิร์กที่อิงตาม Transformer พร้อมด้วย:
- พารามิเตอร์ 170 ล้านตัวสำหรับการฝัง (รองรับคลังคำศัพท์ 256,000 โทเค็น)
- พารามิเตอร์ 100 ล้านตัวสำหรับบล็อก Transformer
- รองรับหลายภาษา และปรับให้เข้ากับงานเฉพาะทาง
- INT4 quantization, Rotary Position Embeddings, และ Group Query Attention เพื่อความเร็วและประสิทธิภาพ
โมเดลนี้มีความโดดเด่นในการปฏิบัติตามคำสั่ง, การดึงข้อมูล, และงานสร้างสรรค์ เช่น การสรุปหรือการตรวจสอบการปฏิบัติตามข้อกำหนด ผลการทดสอบแสดงให้เห็นว่า Gemma 3 270M มีคะแนน F1 สูงใน IFEval ทำให้เป็นตัวเลือกที่แข็งแกร่งสำหรับทั้งโครงการทางเทคนิคและโครงการสร้างสรรค์—โดยเฉพาะอย่างยิ่งในกรณีที่การใช้หน่วยความจำและแบตเตอรี่เป็นข้อกังวลหลัก
ประโยชน์หลักของการเรียกใช้ Gemma 3 270M ในเครื่อง
- ความเป็นส่วนตัวของข้อมูล: การประมวลผลทั้งหมดอยู่บนอุปกรณ์ของคุณ ลดความเสี่ยงในการเปิดเผยข้อมูล
- ความหน่วงต่ำ: เวลาตอบสนองระดับมิลลิวินาที แม้แต่งานที่ซับซ้อน
- ไม่มีค่าใช้จ่ายคลาวด์: กำจัดค่าใช้จ่ายที่เกิดขึ้นซ้ำสำหรับ API AI บนคลาวด์
- ประสิทธิภาพพลังงาน: ใช้พลังงานเพียง 0.75% ของแบตเตอรี่ Pixel 9 Pro สำหรับการสนทนาที่ถูก Quantize แบบ INT4 จำนวน 25 ครั้ง
- การปรับแต่งที่ง่ายดาย: ปรับโมเดลให้เข้ากับชุดข้อมูลของคุณโดยใช้วิธีการแบบน้ำหนักเบาเช่น LoRA
- ทีมที่มีศักยภาพ: ทีมขนาดเล็กและนักพัฒนาเดี่ยวสามารถทดลองและทำซ้ำได้โดยไม่ต้องพึ่งพาระบบคลาวด์
ข้อกำหนดของระบบ: คุณต้องการฮาร์ดแวร์อะไร?
Gemma 3 270M สามารถเข้าถึงได้สำหรับนักพัฒนาส่วนใหญ่:
- การอนุมานแบบ CPU เท่านั้น: RAM 4GB และโปรเซสเซอร์สมัยใหม่ (เช่น Intel Core i5)
- การเร่งความเร็ว GPU: VRAM 2GB บนการ์ด NVIDIA (สำหรับโมเดลที่ถูก Quantize)
- Apple Silicon: ประสิทธิภาพสูงผ่าน MLX-LM (650+ โทเค็น/วินาที บน M4 Max)
- การปรับแต่ง: แนะนำ RAM 8GB และ GPU ที่มี VRAM 4GB สำหรับชุดข้อมูลขนาดเล็ก
- ระบบปฏิบัติการ: Windows, macOS, หรือ Linux
- ซอฟต์แวร์: Python 3.10+ สำหรับความเข้ากันได้ของไลบรารี
- พื้นที่เก็บข้อมูล: ~1GB สำหรับไฟล์โมเดล
การเลือกเครื่องมืออนุมานในเครื่องของคุณ: การเปรียบเทียบอย่างรวดเร็ว
เฟรมเวิร์กหลายตัวทำให้การเรียกใช้ Gemma 3 270M ในเครื่องเป็นเรื่องง่าย:
- Hugging Face Transformers: ความยืดหยุ่นสูงสุด, การเขียนสคริปต์ Python, และตัวเลือกการผสานรวม
- LM Studio: GUI ที่ใช้งานง่ายสำหรับการจัดการโมเดลอย่างง่ายดาย—เหมาะสำหรับผู้ที่ไม่ใช่โปรแกรมเมอร์
- llama.cpp: อิงตาม C++, ปรับให้เหมาะสมสำหรับประสิทธิภาพและการปรับแต่งระดับต่ำ
- MLX (Apple): ปรับให้เหมาะสมสำหรับชิป Apple M-series
เหมาะสมที่สุดสำหรับ:
- ผู้เริ่มต้น: LM Studio
- นักพัฒนา/วิศวกร: Transformers หรือ llama.cpp
ทีละขั้นตอน: การเรียกใช้ Gemma 3 270M ด้วย Hugging Face Transformers
1. ติดตั้งไลบรารีที่จำเป็น
pip install transformers torch
2. โหลดโมเดลใน Python
from transformers import AutoTokenizer, AutoModelForCausalLM

model_name = "google/gemma-3-270m"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto")
3. เรียกใช้การอนุมาน
input_text = "Explain quantum computing in simple terms."
inputs = tokenizer(input_text, return_tensors="pt").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=200)
response = tokenizer.decode(outputs[0], skip_special_tokens=True)
print(response)
4. เปิดใช้งาน Quantization (ลดการใช้หน่วยความจำ)
from transformers import BitsAndBytesConfig
quant_config = BitsAndBytesConfig(load_in_4bit=True)
model = AutoModelForCausalLM.from_pretrained(model_name, quantization_config=quant_config)
5. เข้าถึง Gated Model (หากจำเป็น)
from huggingface_hub import login
login(token="your_hf_token")
รับโทเค็นของคุณจากบัญชี Hugging Face ของคุณ
ทีละขั้นตอน: การเรียกใช้ Gemma 3 270M ด้วย LM Studio
LM Studio นำเสนอวิธีการที่มองเห็นได้สำหรับการจัดการโมเดล AI ในเครื่อง
1. ดาวน์โหลด LM Studio จาก lmstudio.ai และติดตั้ง
2. ค้นหา "gemma-3-270m" ในศูนย์กลางโมเดล
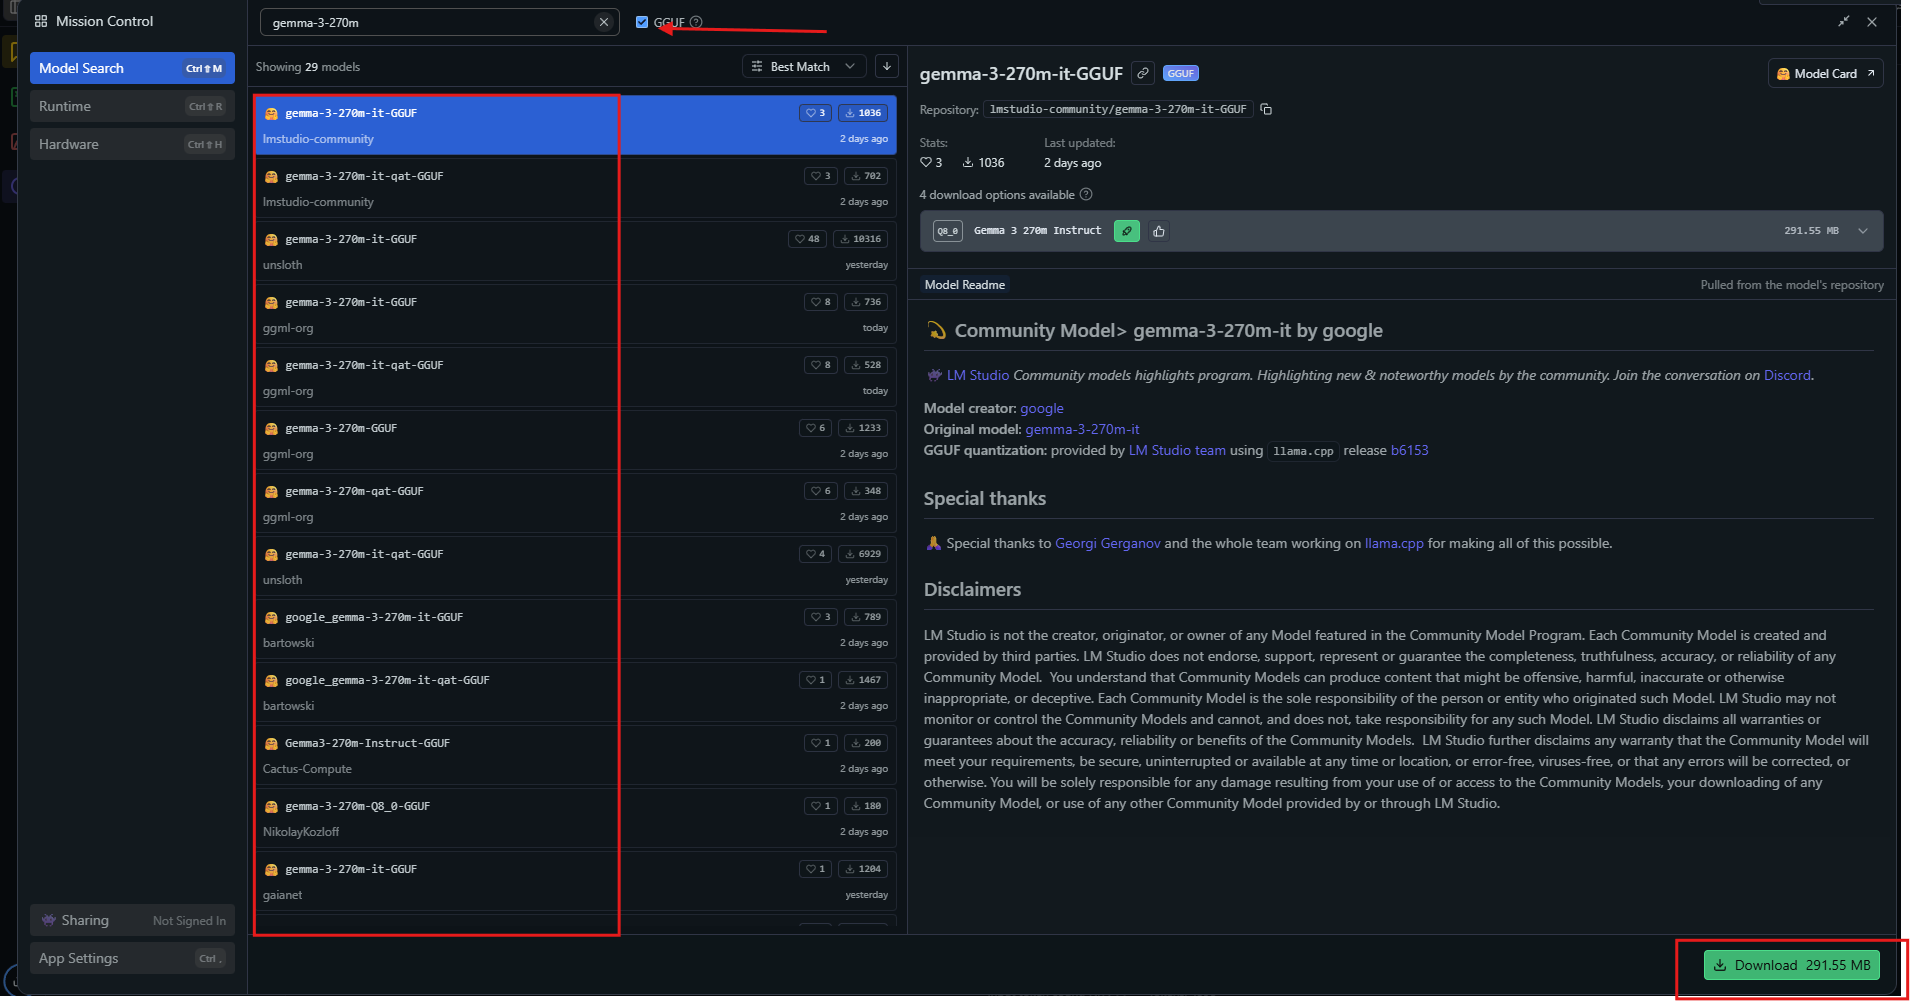
3. ดาวน์โหลดเวอร์ชันที่ถูก Quantize (เช่น Q4_0)
4. โหลดโมเดล, ตั้งค่าพารามิเตอร์ (บริบท: 32k, อุณหภูมิ: 1.0), และเริ่มแชท
5. เปิดใช้งาน GPU offloading เพื่อความเร็วที่ดีขึ้น หากมี
LM Studio เหมาะอย่างยิ่งสำหรับการสร้างต้นแบบอย่างรวดเร็วหรือทีมที่กำลังมองหาอินเทอร์เฟซแบบไม่ใช้โค้ด
ทีละขั้นตอน: การเรียกใช้ Gemma 3 270M ด้วย llama.cpp
เพื่อประสิทธิภาพสูงสุด โดยเฉพาะอย่างยิ่งบนระบบฝังตัวหรือระบบที่มีทรัพยากรจำกัด ลองใช้ llama.cpp
1. โคลนคลัง llama.cpp:
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make -j
2. ดาวน์โหลดไฟล์ GGUF จาก Hugging Face:
huggingface-cli download unsloth/gemma-3-270m-it-GGUF --include "*.gguf"
3. เรียกใช้โมเดล:
./llama-cli -m gemma-3-270m-it-Q4_K_M.gguf -p "Build a simple AI app."
4. (ไม่บังคับ) คอมไพล์ด้วย CUDA สำหรับ NVIDIA GPUs:
make GGML_CUDA=1
ตั้งค่าพารามิเตอร์เช่น --n-gpu-layers 999 เพื่อการใช้งาน GPU อย่างเต็มที่
ตัวอย่างในโลกจริง: Gemma 3 270M ในเวิร์กโฟลว์ API
ผสานรวม Gemma 3 270M เข้ากับสแต็ค API ของคุณสำหรับ:
1. การวิเคราะห์ความรู้สึก
prompt = "Classify: This product is amazing!"
inputs = tokenizer(prompt, return_tensors="pt")
outputs = model.generate(**inputs)
print(tokenizer.decode(outputs[0]))
# Output: Positive.
2. การสรุป
text = "Long article here..."
prompt = f"Summarize: {text}"
# ใช้โมเดลเพื่อสร้างสรุป
3. การตอบคำถาม
ข้อความพร้อมต์:อะไรคือสาเหตุของการเปลี่ยนแปลงสภาพภูมิอากาศ?
โมเดลจะส่งคืนคำอธิบายที่กระชับซึ่งเหมาะสำหรับแชทบอทหรือ API ฐานความรู้
4. การดึงข้อมูลเอนทิตีด้านการดูแลสุขภาพ
ป้อนบันทึกทางคลินิกและดึงเอนทิตีหลักเพื่อการวิเคราะห์ที่มีโครงสร้าง—เหมาะสำหรับการประมวลผลในเครื่องที่สอดคล้องกับ HIPAA
เคล็ดลับมือโปร: ใช้ Apidog เพื่อออกแบบ, จำลอง, และทดสอบ API ที่เชื่อมต่อปลายทางโมเดลเหล่านี้ เพื่อให้มั่นใจถึงการผสานรวม AI ที่แข็งแกร่งและพร้อมใช้งานในการผลิต
การปรับแต่ง Gemma 3 270M สำหรับงานเฉพาะทาง
ปรับ Gemma 3 270M ให้เข้ากับโดเมนเฉพาะทางผ่านการปรับแต่งที่มีประสิทธิภาพด้านพารามิเตอร์ (LoRA):
pip install peft
from peft import LoraConfig, get_peft_model
lora_config = LoraConfig(r=16, lora_alpha=32, target_modules=["q_proj", "v_proj"])
model = get_peft_model(model, lora_config)

from transformers import Trainer, TrainingArguments
trainer = Trainer(model=model, args=TrainingArguments(output_dir="./results"))
trainer.train()
- ฝึกด้วยชุดข้อมูลขนาดเล็กบนฮาร์ดแวร์ที่ไม่แพง
- บันทึกและโหลดอะแดปเตอร์ซ้ำเพื่อการเปลี่ยนงานที่รวดเร็ว
- ป้องกันการ Overfitting โดยการตรวจสอบค่า Loss และความแม่นยำในการตรวจสอบ
เคล็ดลับการเพิ่มประสิทธิภาพ
- Quantize เป็น 4-bit หรือ 8-bit เพื่อการแลกเปลี่ยนความเร็ว/หน่วยความจำที่ดีที่สุด
- Inference แบบ Batch เพื่อเพิ่มปริมาณงานสูงสุด
- ปรับแต่งพารามิเตอร์การสร้าง: temperature=1.0, top_k=64, top_p=0.95
- เปิดใช้งาน Mixed Precision บน GPU ที่เข้ากันได้
- ตรวจสอบการใช้ VRAM (
nvidia-smi) - อัปเดตไลบรารี เป็นประจำเพื่อประสิทธิภาพล่าสุด
หลีกเลี่ยงข้อผิดพลาด: อย่าแทรกโทเค็น BOS สองครั้งในข้อความพร้อมต์; จัดการหน้าต่างบริบทเพื่อป้องกันการถูกตัดทอน
บทสรุป: สร้างแอป AI ที่รวดเร็วและปลอดภัยในเครื่อง
ด้วย Gemma 3 270M คุณได้รับอิสระในการปรับใช้ AI ขั้นสูงตามเงื่อนไขของคุณเอง—ไม่มีการผูกขาดกับคลาวด์, ไม่มีการประนีประนอมเรื่องความเป็นส่วนตัว ไม่ว่าคุณจะใช้พลังงานกับแชทบอท, การดึงข้อมูล, หรือการเร่งเวิร์กโฟลว์ภายใน, Gemma 3 270M มอบความเข้าใจภาษาที่มีประสิทธิภาพและเชื่อถือได้บนฮาร์ดแวร์ในเครื่อง
สำรวจว่า Apidog สามารถปรับปรุงวงจรการพัฒนา API ของคุณให้ราบรื่นยิ่งขึ้นได้อย่างไร—เชื่อมต่อโมเดล AI ในเครื่องของคุณเข้ากับแบ็กเอนด์, ฟรอนต์เอนด์, หรือการผสานรวมกับบุคคลที่สามได้อย่างไร้รอยต่อ