
หากต้องการรัน ERNIE 5.5 Flash บนเครื่องของคุณเอง ให้ติดตั้ง vLLM 0.32.0 พร้อมปลั๊กอิน vLLM-ERNIE ของ Baidu จากนั้นรัน vllm serve baidu/ERNIE-5.5-Flash-Base ด้วย data parallelism และ expert parallelism บนโหนดที่มี GPU หลายตัว คุณจะได้เซิร์ฟเวอร์ที่รองรับ OpenAI-compatible บนพอร์ต 8000 แต่มีข้อควรรู้คือ: weights แบบ open ในตอนนี้คือโมเดล Base ซึ่งเป็น checkpoint จากการ pretraining ที่ทำหน้าที่ต่อเนื่องข้อความ ไม่ใช่โมเดลแชท
ด้านล่างนี้: สิ่งที่คุณดาวน์โหลดได้, สเปกฮาร์ดแวร์ที่ Baidu ระบุไว้, คำสั่ง serve ที่แน่นอน และวิธีทดสอบ endpoint คำสั่งและตัวเลขทั้งหมดด้านล่างมาจาก Hugging Face model card ของ Baidu และ repository vLLM-ERNIE ตรวจสอบเมื่อวันที่ 12 พฤศจิกายน 2026
ยังไม่คุ้นเคยกับโมเดลนี้? เริ่มจาก ERNIE 5.5 Flash คืออะไร ถ้าคุณต้องการโมเดลแชทโดยไม่มีคลัสเตอร์ GPU คู่มือ ERNIE 5.5 Flash API จะเป็นทางเลือกที่เร็วกว่า
วันนี้คุณรันอะไรบนเครื่องตัวเองได้บ้าง?
คุณสามารถรัน ERNIE 5.5 Flash Base ที่เปิดตัวบน Hugging Face ในรูปแบบ FP8 และ BF16 ได้ โมเดลนี้เป็น sparse mixture-of-experts ขนาด 280 พารามิเตอร์ พร้อม 14B พารามิเตอร์ที่ใช้งานจริงต่อ token ฝึกด้วยข้อมูล 33.5T tokens ส่วน ERNIE 5.5 Flash Preview ที่ปรับแต่งสำหรับแชทยังใช้ได้เฉพาะผ่าน API เท่านั้น Baidu ระบุว่า weights จะเปิดให้ใช้ "เร็ว ๆ นี้" ภายใต้สัญญาอนุญาต Apache 2.0
เปรียบเทียบการเปิดตัวทั้งสองรุ่นสำหรับการ self-host:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| สิ่งที่มันคือ | Checkpoint ณ จุดสิ้นสุด pretraining | โมเดลแรกหลัง post-training (แชท, reasoning, agent) |
| Weights | Hugging Face และ ModelScope, FP8 และ BF16 | ยังไม่เปิดให้ดาวน์โหลด ณ วันที่ 12 พ.ย. 2026 |
| Endpoint ที่เรียกใช้ | /v1/completions (ต่อเนื่องข้อความ) |
Chat completions พร้อม reasoning และเครื่องมือ |
| สัญญาอนุญาต | ERNIE 5.5 Flash Base Model License v1.0 | Apache 2.0 (ระบุว่าจะใช้เมื่อเปิดตัว) |
| ใช้งานที่ไหนได้ตอนนี้ | GPU ของคุณเอง | Qianfan API, OpenRouter |
ณ ตอนนี้ คอลเลกชัน ERNIE-5.5-Flash ของ Baidu มีเพียง checkpoint Base สองตัวเท่านั้น และ README ของ vLLM-ERNIE ระบุโมเดลแชทว่า "Coming soon" โพสต์เปิดตัว Preview ไม่ได้ระบุวันที่
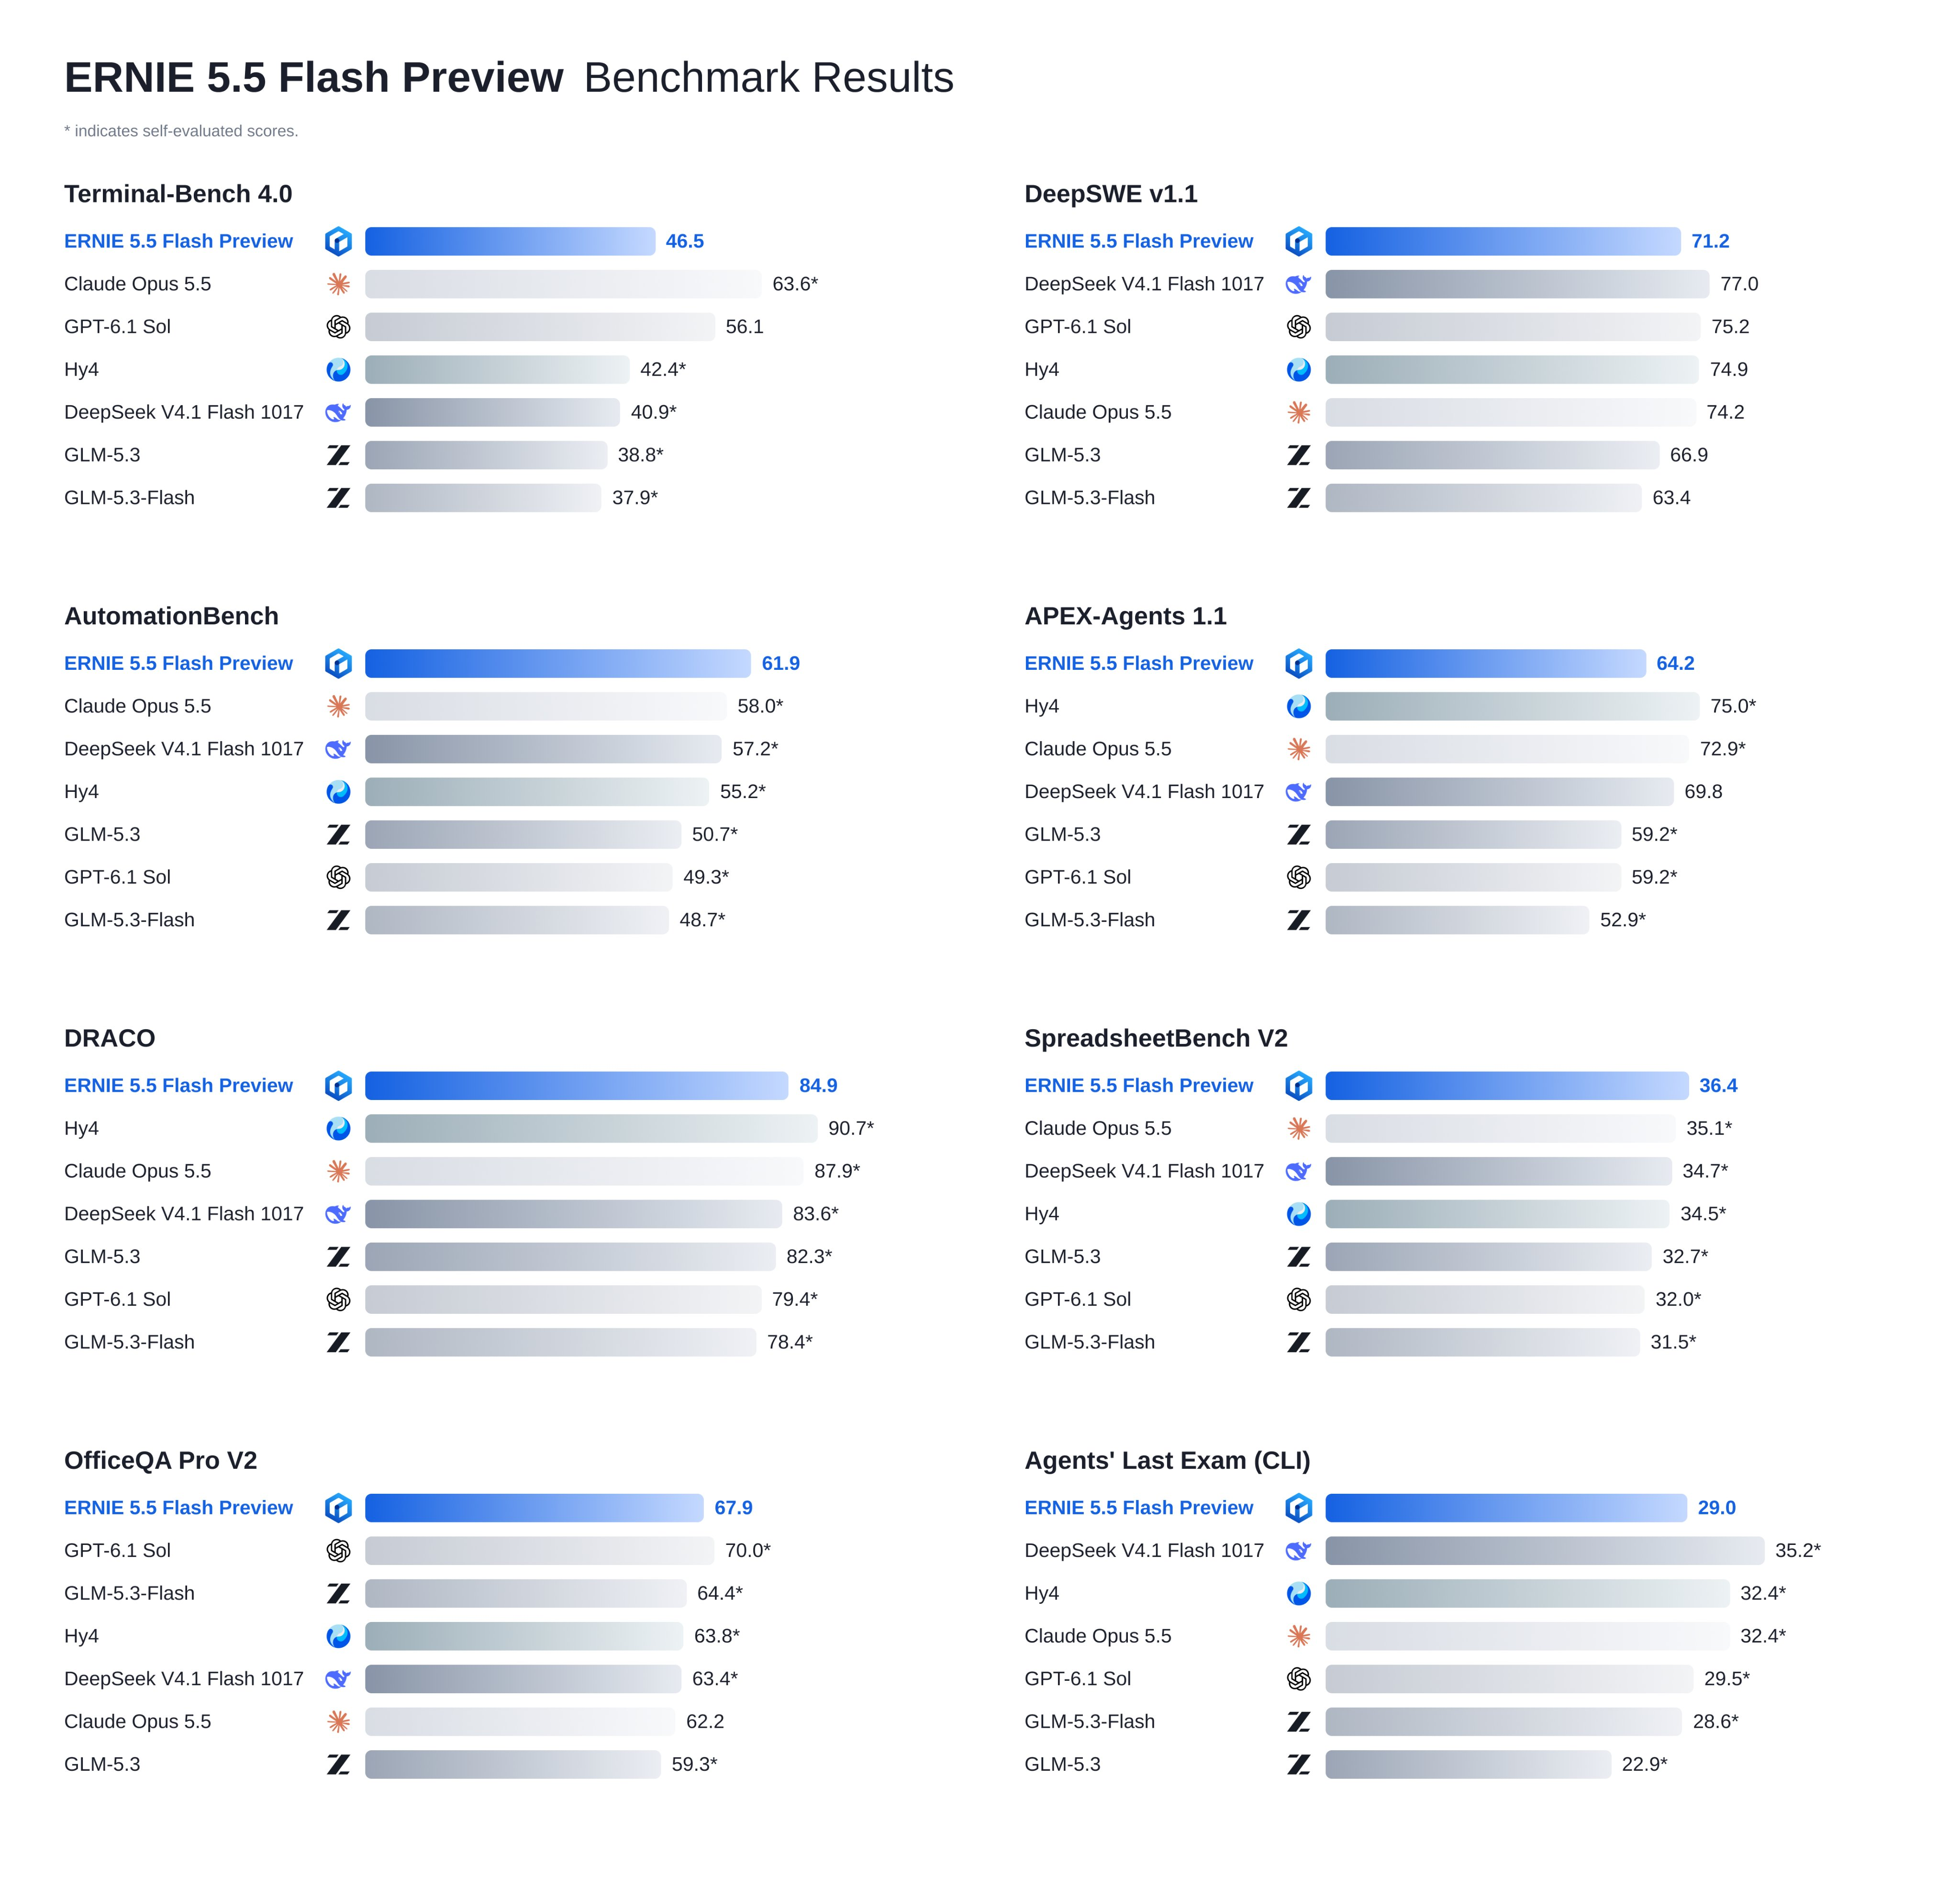
ถ้าคุณต้องการผู้ช่วยเขียนโค้ดในวันนี้ โมเดล Base บนเครื่อง local จะไม่ตอบโจทย์ แต่ถ้าต้องการจุดเริ่มต้นสำหรับ fine-tuning หรืองานวิจัย few-shot Base คือสิ่งที่ Baidu สร้างมันขึ้นมาเพื่อจุดประสงค์นั้น
ความต้องการฮาร์ดแวร์ของ ERNIE 5.5 Flash
Weights แบบ FP8 ใช้ GPU memory ประมาณ 280 GB และแบบ BF16 ประมาณ 560 GB ดังนั้นงานนี้ต้องใช้เซิร์ฟเวอร์หลาย GPU ไม่ใช่งานสำหรับแล็ปท็อป README ของ vLLM-ERNIE ระบุจำนวน GPU ขั้นต่ำที่สามารถรองรับ weights ได้ และปลั๊กอินนี้ทำงานบน NVIDIA GPU เท่านั้น
| GPU memory ต่อการ์ด | FP8 (weights ~280 GB) | BF16 (weights ~560 GB) |
|---|---|---|
| 288 GB | 2 GPU | 4 GPU |
| 192 GB | 4 GPU | 8 GPU (หรือ 2 โหนด x 4 GPU) |
| 80 GB | 8 GPU | 2 โหนด x 8 GPU |
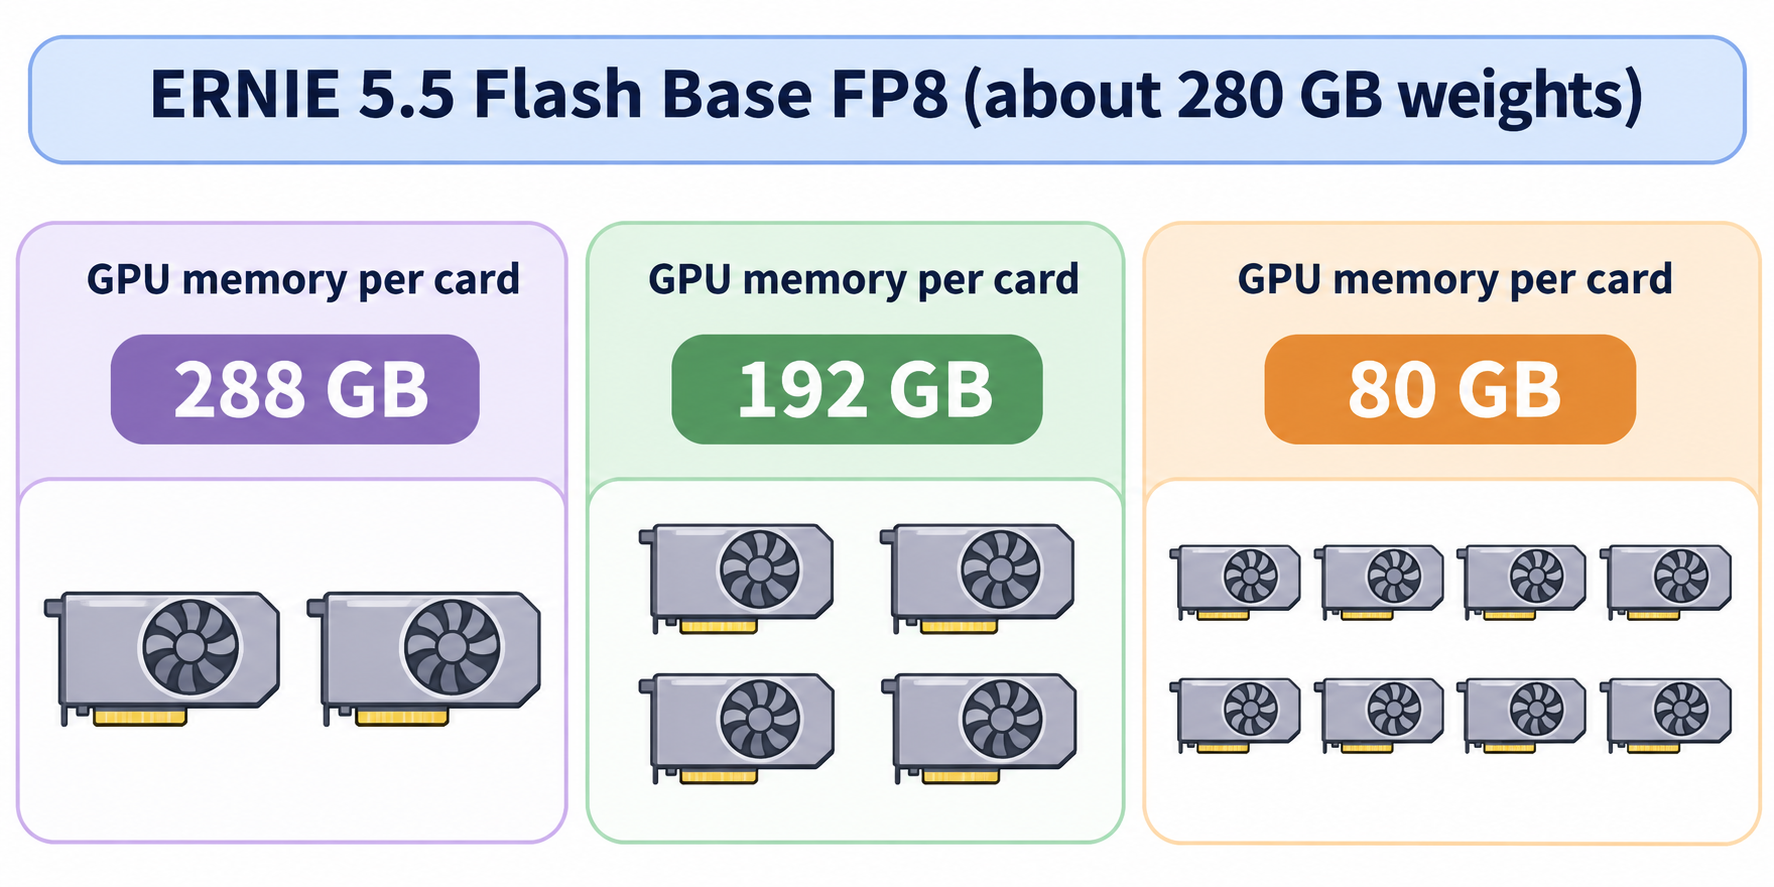
นั่นคือจำนวนขั้นต่ำสำหรับโหลด weights KV cache ยังต้องมีพื้นที่เพิ่มอีก ซึ่งเป็นเหตุผลที่ความยาว context ที่คุณให้บริการได้ขึ้นอยู่กับการ์ดของคุณ:
- GPU 80 GB: serve FP8 บน 8 GPU ด้วย
--data-parallel-size 8และ--gpu-memory-utilization 0.93รองรับได้สูงสุด 262,144 tokens; 1M ไม่พอ - Context 1M token: ค่าที่ Baidu ระบุมาสำหรับ GPU ที่มีหน่วยความจำ 184 GiB โดยลด utilization เหลือ 0.85 เพราะ prefill แบบ 1M token ต้องใช้หน่วยความจำชั่วคราวหลายสิบ GB
- สถาปัตยกรรม GPU มีผล: คำสั่ง FP8 ส่ง
--moe-backend hummingซึ่งรองรับ activation แบบ SiTU ของโมเดลด้วย weights FP8 บน GPU ตระกูล Blackwell บน GPU ตระกูล Hopper ให้ตัด flag นี้ออกและใช้ MoE kernel ค่าเริ่มต้นของ vLLM
"บนเครื่องตัวเอง" ในที่นี้หมายถึงฮาร์ดแวร์ที่คุณควบคุมได้: โหนด 8 GPU เช่า, เซิร์ฟเวอร์ในองค์กร หรือคลัสเตอร์ในห้องแล็บ
ติดตั้ง vLLM และปลั๊กอิน ERNIE
vLLM ไม่รองรับสถาปัตยกรรม ERNIE 5.5 (Ernie5_5_MoeForCausalLM) ตั้งแต่แรก Baidu จัดส่งในรูปแบบปลั๊กอินที่ทำงานบน wheel vLLM 0.32.0 ที่เปิดตัวโดยไม่ต้องแก้ไข สร้าง environment Python 3.12 แล้วติดตั้งทั้งสองอย่าง:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
ปลั๊กอินจะถูกโหลดผ่าน entry point vllm.general_plugins ในทุกกระบวนการ vLLM หาก vllm serve รายงานว่า Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported ภายหลัง แสดงว่าปลั๊กอินไม่ได้ติดตั้งใน environment ที่รัน vllm หรือ VLLM_PLUGINS ถูกตั้งค่าโดยไม่มี ernie อยู่ในนั้น
หากต้องการดึง weights จาก ModelScope แทน Hugging Face ให้ตั้งค่า VLLM_USE_MODELSCOPE=True ชื่อ repo เหมือนกันทั้งสองแพลตฟอร์ม ถ้าคุณยังไม่คุ้นเคยกับ vLLM ภาพรวมของ vLLM ของเราจะอธิบายเซิร์ฟเวอร์และ OpenAI-compatible API
คำสั่ง vllm serve สำหรับ ERNIE 5.5 Flash
นี่คือคำสั่ง FP8 จาก README ของ vLLM-ERNIE สำหรับโหนด 4 GPU เดียวที่ context 128K แบบ training พร้อมเปิด speculative decoding แบบ ECHO:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
แต่ละตัวเลือกทำอะไร ตามบันทึกของ Baidu:
- Data parallel attention คู่กับ expert parallel MoE (
--data-parallel-size 4 --enable-expert-parallel) รองรับ KV cache ได้มากที่สุดและให้ throughput สูงสุด Tensor parallelism (--tensor-parallel-size2, 4 หรือ 8) ลด latency ที่ concurrency ต่ำ แต่รองรับ KV cache ได้น้อยกว่า - KV cache แบบ FP8 (
--kv-cache-dtype fp8) เก็บ cache ในรูปแบบ FP8;autoเก็บเป็น BF16 - Speculative decoding แบบ ECHO นำ final layer ของโมเดลเองมาใช้เป็น draft model ในตัว ที่นี่กำหนด draft 2 ขั้น; ใช้ 1 หรือ 3 ก็ได้เช่นกัน ตัด
--speculative-configออกเพื่อ serve โดยไม่มี draft
Model card แสดงตัวแปรที่สั้นกว่าบนพอร์ต 30000 โดยไม่มี speculative config
ปิดช่องโหว่ความปลอดภัยด้วย คำสั่งเหล่านี้ bind ที่ 0.0.0.0 โดยไม่มีการยืนยันตัวตน README ของ Baidu แนะนำให้เพิ่ม --api-key <key> หรือ bind ที่ 127.0.0.1 เว้นแต่เครือข่ายนั้นน่าเชื่อถือ ทำอย่างใดอย่างหนึ่งก่อนเปิดพอร์ตสู่ภายนอก
BF16 และ context 1M
BF16 ทำงานข้ามสองโหนด 4 GPU (DP8 บวก EP8) ด้วย --data-parallel-size 8, --data-parallel-size-local 4, --data-parallel-address ${HEAD_IP} และ --data-parallel-hybrid-lb; โหนดที่สองเพิ่ม --data-parallel-start-rank 4 คัดลอกคำสั่งเต็มจาก README ซึ่งยังกำหนด network interface ระหว่างโหนดด้วย
สำหรับหน้าต่าง context เต็ม 1,048,576 token ให้ส่ง --max-model-len 1048576 และ --gpu-memory-utilization 0.85 และลด --max-num-seqs เพื่อให้ KV cache ของแต่ละ rank รองรับ request แบบ 1M token ได้ทั้งชุด
เรียก endpoint ที่รองรับ OpenAI
vLLM เปิดเส้นทางแบบ OpenAI แต่โมเดล Base ไม่มี chat template ดังนั้นคุณต้องเรียก /v1/completions ด้วย prompt ดิบ สำหรับการใช้งาน few-shot ให้ใส่ตัวอย่างใน prompt และหยุดที่ท้ายคำตอบหนึ่งครั้ง:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
README ของ Baidu ระบุว่าข้อความ completion ที่ได้กลับมาคือ 36 มีสามจุดที่มักทำให้สับสน:
- ส่ง
"temperature": 0เพื่อใช้ greedy decodinggeneration_config.jsonของโมเดลตั้งค่าdo_sample=false,temperature=1.0และtop_p=0.95vLLM ใช้ค่า temperature และ top_p แต่ไม่สนใจdo_sampleดังนั้นจะมีการ sampling เสมอ เว้นแต่คุณ override เอง - อย่าเพิ่ม
<|ERNIE_MASK|>เอง tokenizer จะ prepend ให้อัตโนมัติ (token id 2) ใน completion prompts - ใช้ชื่อโมเดลให้ถูกต้อง ใช้
baidu/ERNIE-5.5-Flash-Base-BF16เมื่อ serve weights แบบ BF16
OpenAI SDK ตัวไหนก็ใช้ได้ ถ้าชี้ base_url ไปที่ http://<host>:8000/v1 และเรียก completions ไม่ใช่ chat completions
Base กับ Preview: ควรใช้ตัวไหน?
ใช้ Base เมื่อคุณวางแผนจะเทรนต่อบนมัน; ใช้ Preview เมื่อคุณต้องการผู้ช่วยที่พร้อมใช้งานตอนนี้ Base ให้การควบคุมเต็มที่และข้อมูลที่ไม่เคยออกจากเซิร์ฟเวอร์ของคุณ Preview ให้แชท, reasoning และ tool calling ผ่าน Qianfan หรือ OpenRouter เท่านั้น
เมื่อ weights ของ Preview เปิดให้ใช้ ปลั๊กอินรองรับเรียบร้อยแล้ว README อธิบาย flags เพิ่มเติมที่ระบุว่า "Coming soon": --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice พร้อม DSpark draft model สำหรับ speculative decoding ส่วน thinking จะกลับมาใน reasoning_content และ tool calls ใน message.tool_calls ดังนั้นเซิร์ฟเวอร์ที่คุณสร้างวันนี้จะกลายเป็น chat backend ได้เพียงเปลี่ยน weights และเพิ่มสาม flags
สัญญาอนุญาตคือความต่างอีกจุดหนึ่ง Base เปิดให้ใช้ภายใต้ ERNIE 5.5 Flash Base Model License Agreement v1.0 ไม่ใช่ Apache 2.0 อ่านสัญญาฉบับเต็มก่อนสร้างผลิตภัณฑ์บนมัน ณ วันที่ 12 พฤศจิกายน 2026 มีเนื้อหาดังนี้:
- การใช้งานไม่เชิงพาณิชย์ฟรี โดยไม่ต้องแจ้งล่วงหน้า
- การใช้เชิงพาณิชย์ที่ผลิตภัณฑ์ที่เกี่ยวข้องมีรายได้ไม่เกิน 50 ล้านดอลลาร์สหรัฐต่อปี ไม่มีค่าใช้จ่ายใบอนุญาต แต่ต้องแสดงข้อความ "Powered by ERNIE" และแจ้ง Baidu เป็นครั้งเดียว
- หากรายได้เกิน 50 ล้านดอลลาร์สหรัฐต่อปี ต้องได้รับอนุญาตเป็นลายลักษณ์อักษรจาก Baidu ก่อน
- ขอบเขต "Territory" ของสัญญาไม่รวมสหภาพยุโรป สหราชอาณาจักร และเกาหลีใต้
สำหรับโมเดล open-weights ขนาดเล็กกว่าที่ self-host ได้ด้วย GPU น้อยกว่า ดูคู่มือ self-hosting GLM-5.3 ของเรา
ให้ coding agent ของคุณทดสอบ endpoint ด้วย Apidog CLI
การ deploy vLLM ใหม่ควรมี smoke test ที่รันซ้ำได้หลังทุกการแก้ flag: สถานะ, schema ของ response และ tokens ต่อวินาที มอบหมายให้ coding agent และ Apidog CLI แทนการพิมพ์ curl ซ้ำ ๆ
ตั้งค่า CLI ครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นสั่ง Claude Code, Codex หรือ Cursor ด้วย prompt เดียว:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
Agent จะอ่าน schema ของ payload ตรวจสอบความถูกต้อง เขียน test case และรันมัน:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
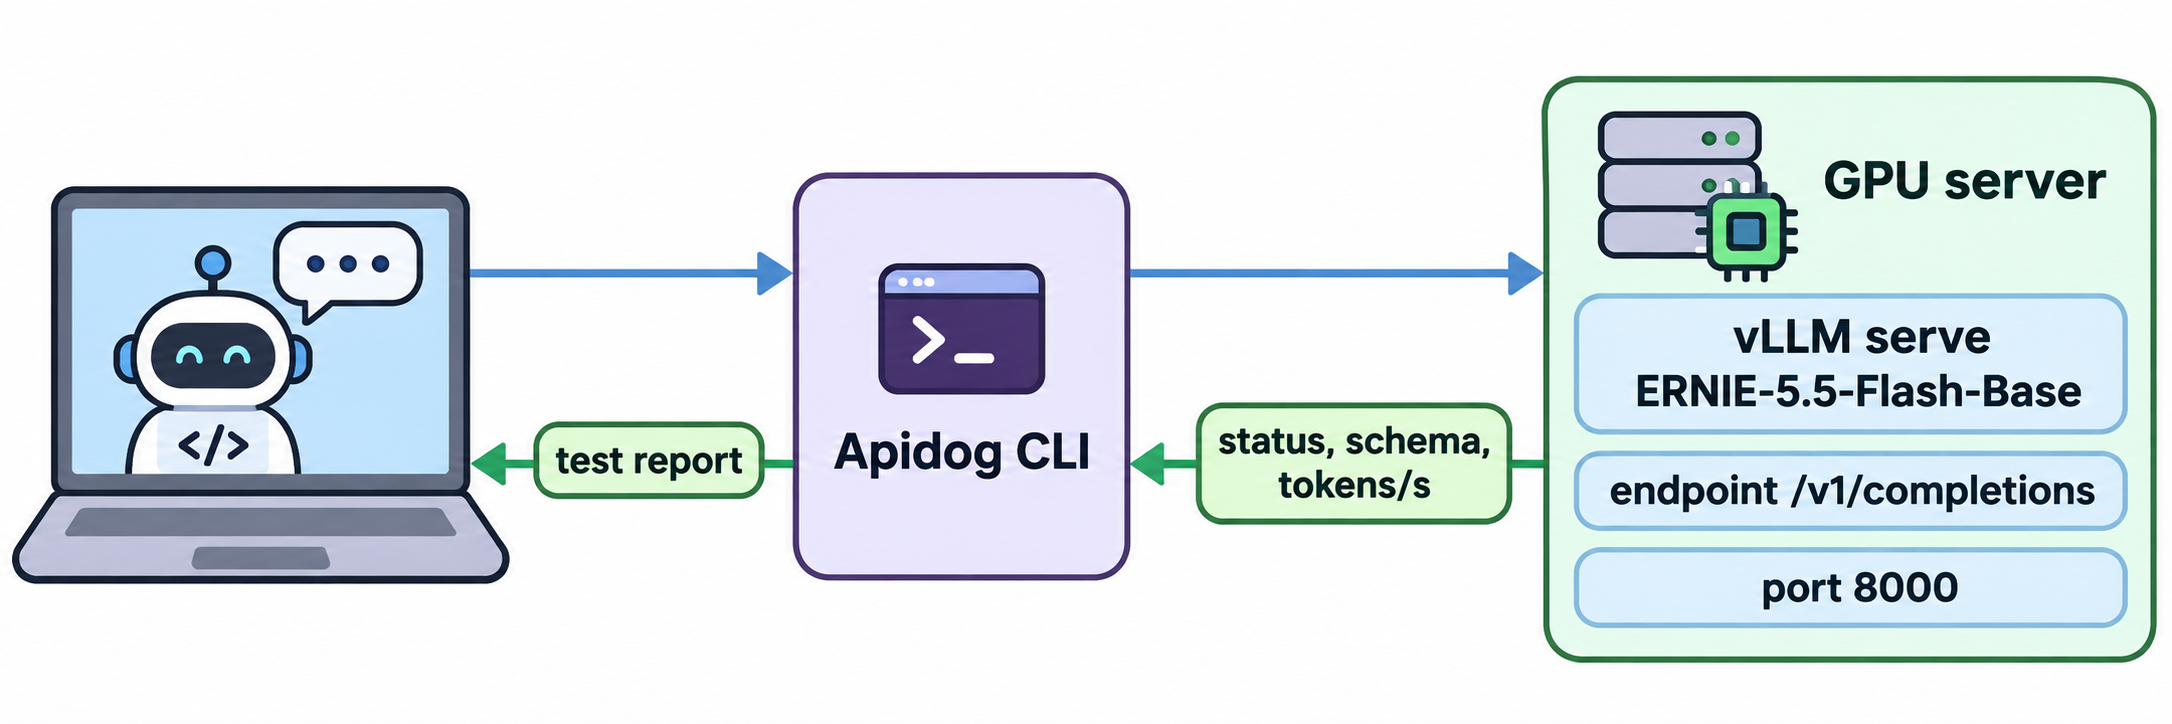
รัน CLI จากเครื่องที่เข้าถึงพอร์ต 8000 ได้ ถ้าคุณตั้ง --api-key บนเซิร์ฟเวอร์ ให้ agent เก็บไว้เป็น environment variable และส่งเป็น Bearer token รัน test case เดิมหลังจากเปลี่ยน --tensor-parallel-size ตัด speculative decoding ออก หรือเพิ่ม --max-model-len แล้วคุณจะได้การเปรียบเทียบที่เท่าเทียมกัน เพิ่ม -r junit เพื่อส่งผลรันเดียวกันเข้าสู่ CI ดูขั้นตอนตั้งค่า agent อย่างละเอียดได้ที่ Apidog CLI in Claude Code แผน Apidog Free รองรับผู้ใช้ได้สูงสุด 4 คน
คำถามที่พบบ่อย
รัน ERNIE 5.5 Flash บน GPU สำหรับผู้ใช้ทั่วไปตัวเดียวได้ไหม? ไม่ได้ Weights FP8 มีขนาดประมาณ 280 GB และการตั้งค่าเล็กที่สุดที่ Baidu ระบุคือ 2 GPU แบบ 288 GB ต่อตัว ถ้าใช้การ์ด 80 GB ต้องมี 8 ตัว ใช้ Preview ผ่าน API ถ้าไม่มีฮาร์ดแวร์ระดับนั้น
Weights ของ ERNIE 5.5 Flash Preview เปิดให้ใช้แล้วหรือยัง? ยัง ณ วันที่ 12 พฤศจิกายน 2026 Baidu ระบุว่าจะ open-source ภายใต้ Apache 2.0 เร็ว ๆ นี้ และปลั๊กอิน vLLM-ERNIE ระบุโมเดลแชทว่า "Coming soon" บน Hugging Face มีเพียง weights Base (FP8 และ BF16)
ทำไม /v1/chat/completions ถึงล้มเหลวกับโมเดล Base? Base ไม่ได้ผ่านการเทรนแบบแชทและไม่มี chat template Baidu ให้บริการผ่าน /v1/completions ด้วย text prompt ดิบ ใส่ตัวอย่าง few-shot ใน prompt และใช้ stop sequence
vLLM รองรับ ERNIE 5.5 ตอนนี้หรือยัง? ไม่ ใน core vLLM คุณต้องใช้ปลั๊กอิน vLLM-ERNIE ของ Baidu บน vLLM 0.32.0 ซึ่งทำงานบน NVIDIA GPU เท่านั้น SGLang ก็ให้บริการโมเดลนี้ผ่าน Docker image เฉพาะที่ระบุชื่อไว้ใน model card
ใช้ ERNIE 5.5 Flash Base เชิงพาณิชย์ได้ไหม? ได้ ภายใต้เงื่อนไข ผลิตภัณฑ์ที่มีรายได้ไม่เกิน 50 ล้านดอลลาร์สหรัฐต่อปีใช้ได้โดยไม่มีค่าใช้จ่ายใบอนุญาต โดยต้องระบุ "Powered by ERNIE" และแจ้ง Baidu เป็นครั้งเดียว หากเกินกว่านั้นต้องได้รับอนุญาตเป็นลายลักษณ์อักษร และขอบเขตของสัญญาไม่รวม EU, สหราชอาณาจักร และเกาหลีใต้