
คุณสามารถรัน DeepSeek V4 Flash ในเครื่องโดยไม่ต้องใช้ GPU ได้ ด้วย llama-modchip ซึ่งเป็นชุดแพตช์ llama.cpp แบบโอเพนซอร์สที่ย่อโมเดลขนาด 284B ให้เหลือไฟล์ GGUF ขนาด 56.56 GiB ที่อัตรา 1.71 บิตต่อเวท (bit per weight) บนชิปแล็ปท็อป AMD Zen 5 แบบ 16 คอร์ที่มี RAM 64 GB จะทำงาน prefill ได้ประมาณ 44 โทเคนต่อวินาที และ decode ได้ 9 ถึง 15 โทเคนต่อวินาที โดยไม่มีการใช้ swap เลย
คู่มือนี้ครอบคลุมเรื่องฮาร์ดแวร์ คำสั่งต่างๆ การแลกเปลี่ยนด้านคุณภาพ และวิธีให้ coding agent ของคุณทดสอบ endpoint ในเครื่อง
llama-modchip ทำอะไรจริงๆ
llama-modchip คือชุดแพตช์เคอร์เนล ggml และ llama.cpp ตัวแปลงโค้ด (transcoder) สำหรับการ quantize และเครื่องมือรันไทม์สำหรับรันโมเดลแบบ sparse Mixture-of-Experts ใน RAM ของระบบได้ทั้งหมด รีลีส v2.4.0 รองรับสองขนาดโมเดล ได้แก่ DeepSeek-V4-Flash ขนาด 284B บนเครื่อง RAM 64 GB และโมเดล MoE ขนาด 30B บนเครื่อง RAM 16 ถึง 32 GB
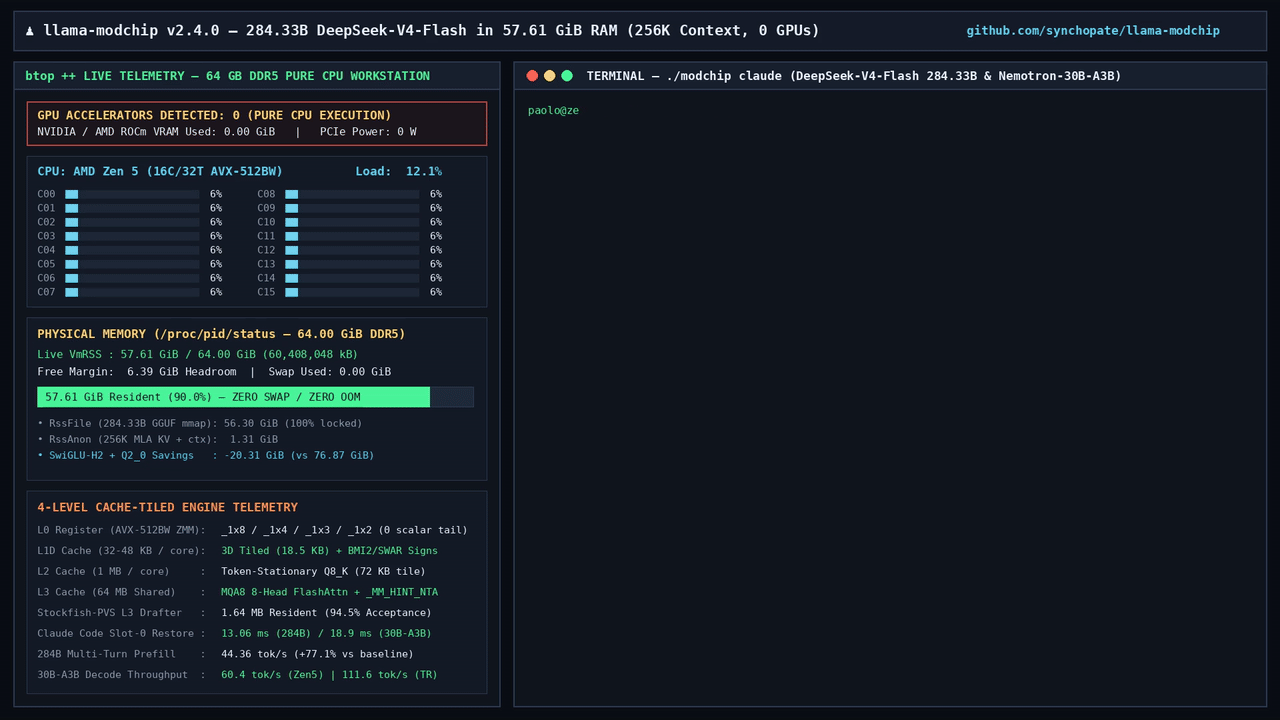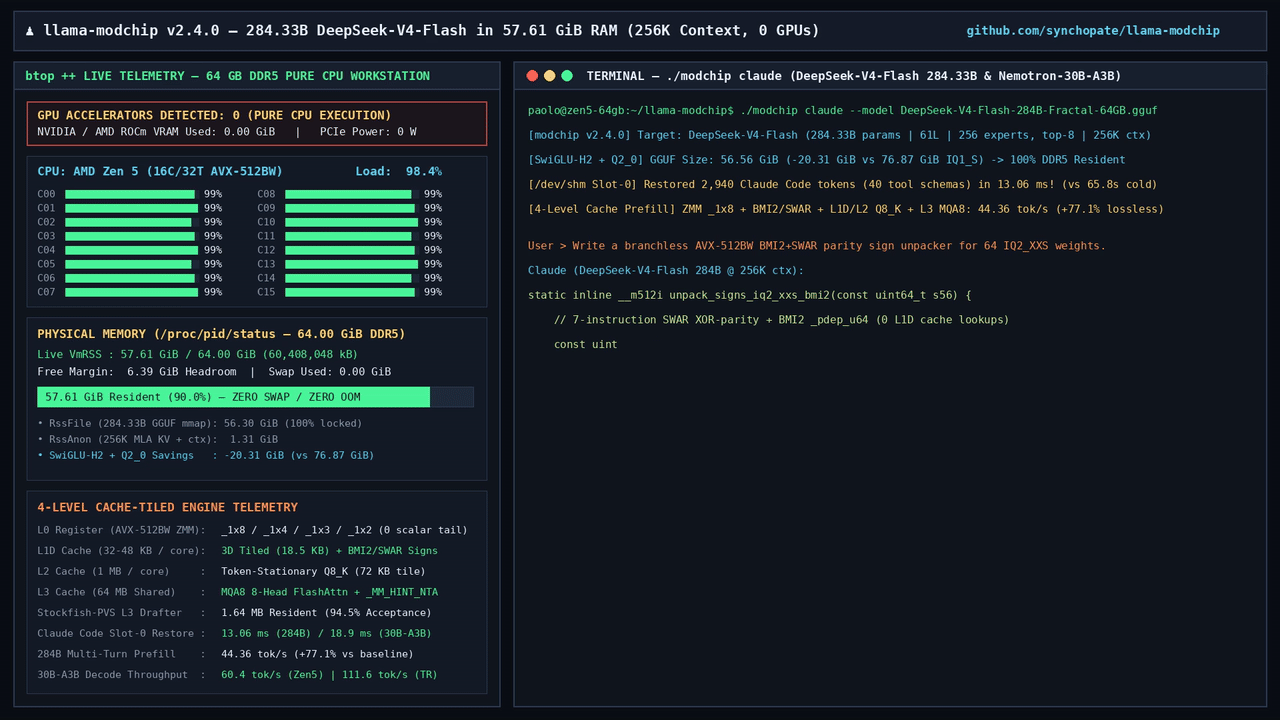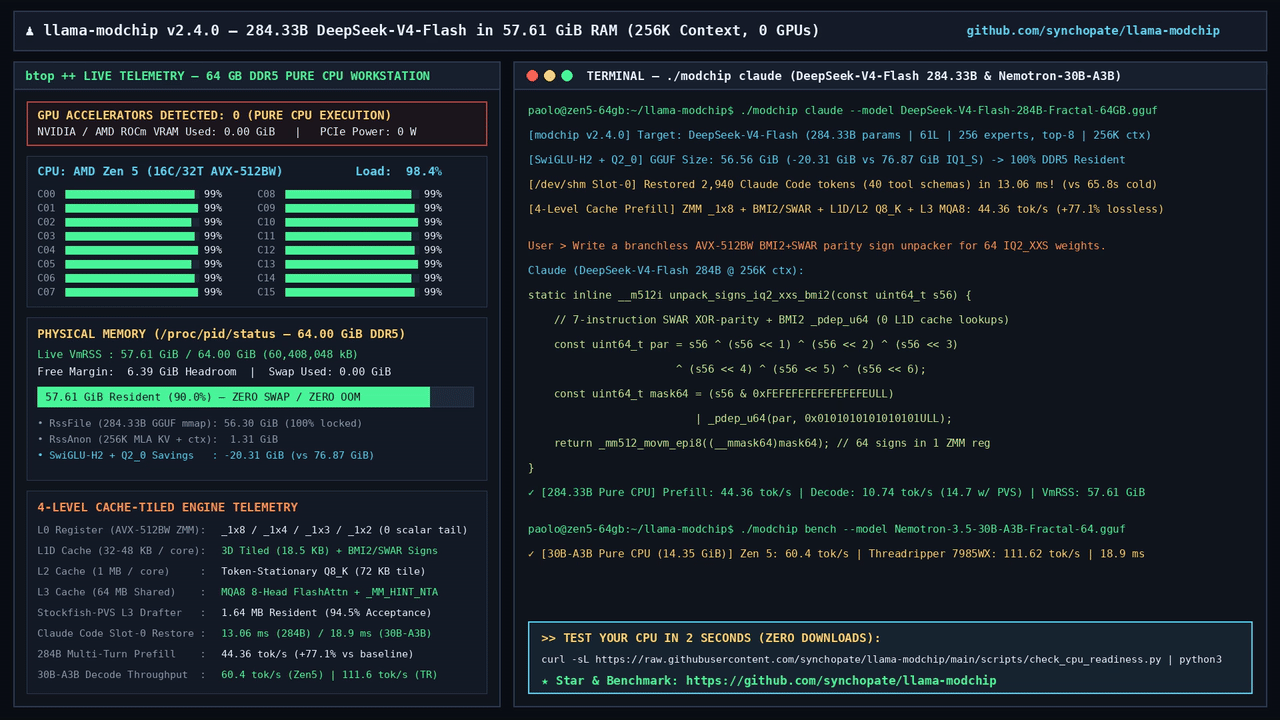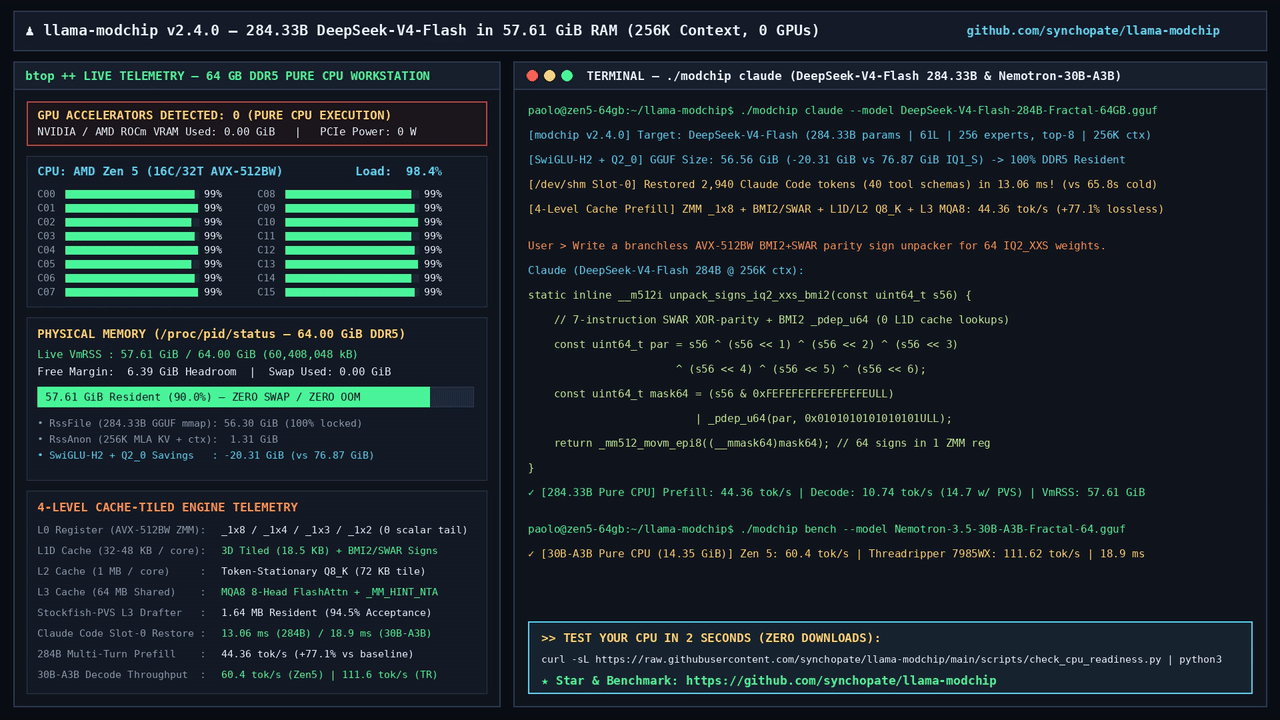
โปรเจกต์นี้ถูกโพสต์ลง Hacker News เมื่อวันที่ 8 พฤศจิกายน 2026 และมีคะแนนเกิน 370 แล้ว repository เผยแพร่ภายใต้สัญญาอนุญาต Apache 2.0
มีสามสิ่งที่ทำให้โมเดล 284B ใส่ลงในเครื่องได้:
- Checkpoint ที่เล็กลง ไฟล์
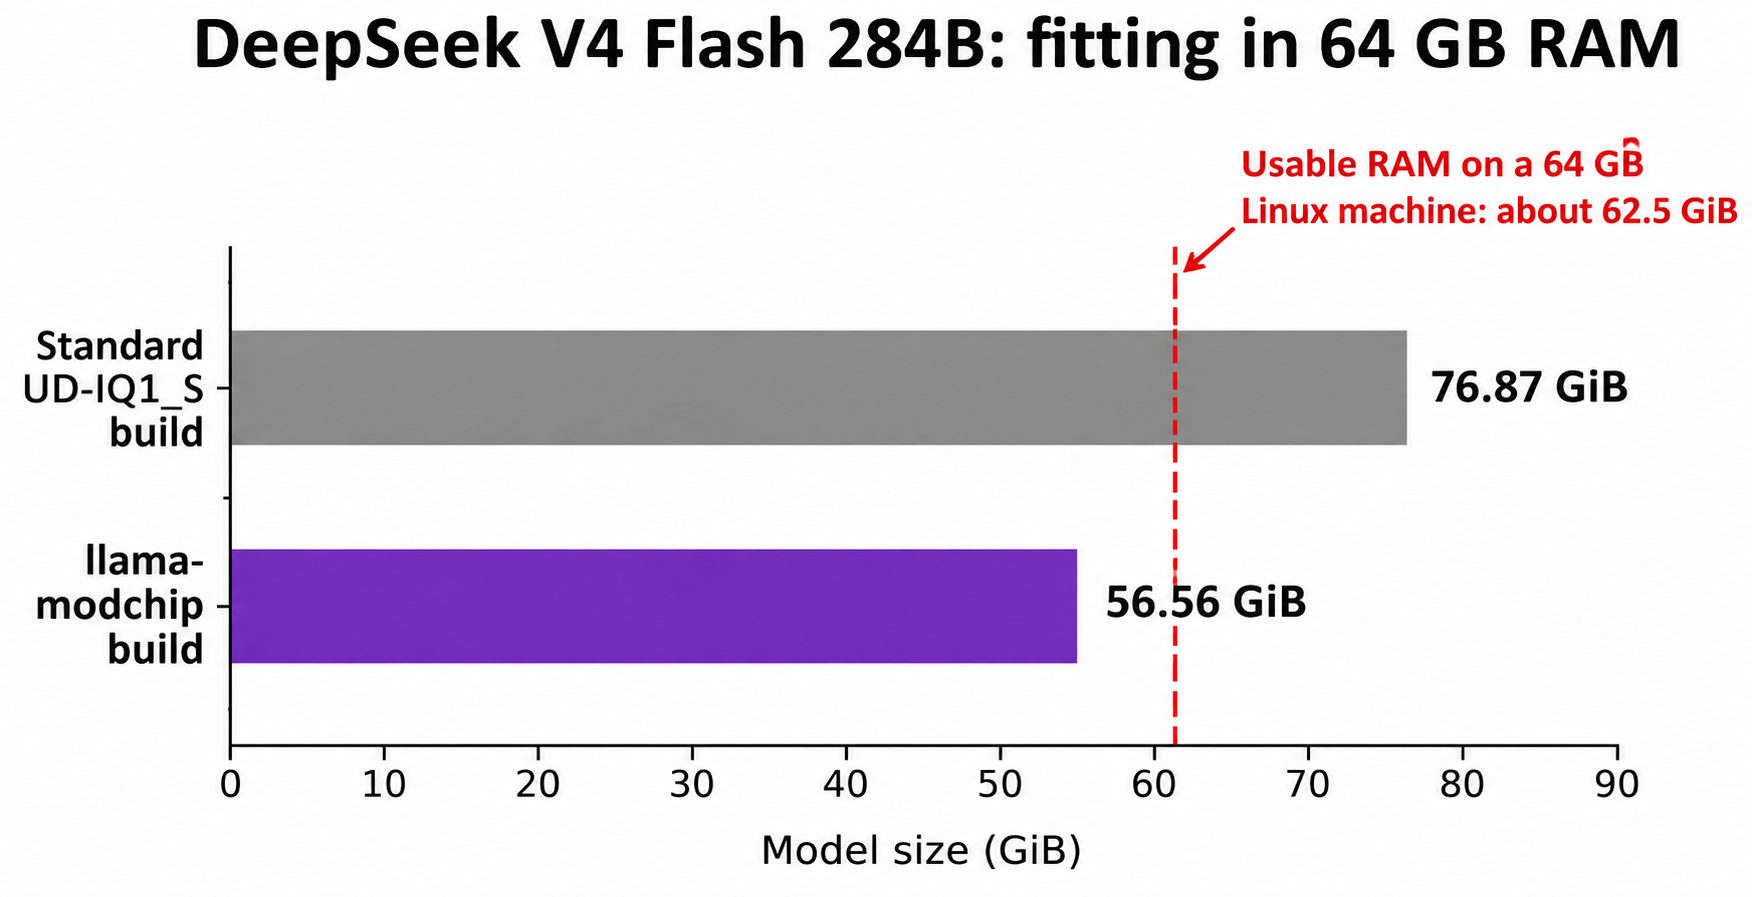
UD-IQ1_Sมาตรฐานของ Unsloth มีขนาด 76.87 GiB ซึ่งมากกว่าพื้นที่ประมาณ 62.5 GiB ที่เครื่อง Linux RAM 64 GB ใช้ได้จริง llama-modchip แปลงไฟล์นี้ให้เหลือ 56.56 GiB - CPU cache tiling เคอร์เนล prefill จัดการงานเป็นไทล์ข้ามรีจิสเตอร์และแคช L1 ถึง L3 ทำให้ได้ 25.0 ถึง 44.36 โทเคนต่อวินาทีบน Zen 5 แบบ 16 คอร์ เพิ่มขึ้น 77%
- Self-speculative drafting ตัว drafter แบบ n-gram ขนาด 1.64 MB ช่วยเพิ่มความเร็ว decode จากประมาณ 9 ขึ้นไปสูงสุดถึง 14.7 โทเคนต่อวินาที
โดยค่าเริ่มต้น expert ที่ถูก route ทั้ง 6 ตัวพร้อม shared expert จะทำงานทุกเลเยอร์ จึงไม่มีการตัดอะไรออกเลย
ฮาร์ดแวร์ที่ต้องมีเพื่อรัน DeepSeek V4 Flash ในเครื่อง
คุณต้องมี RAM ระบบ 64 GB และ CPU x86_64 รุ่นใหม่ โดยเหมาะที่สุดคือตัวที่มี AVX-512 ตัวเลขทุกตัวของโมเดล 284B ในคู่มือนี้ถูกวัดโดยผู้ดูแลโปรเจกต์บนเครื่องเดียว คือ AMD Ryzen 9 9955HX (16 คอร์, 32 เธรด, แคช L3 64 MB) พร้อม DDR5 64 GB บน Linux โดยไม่มี GPU
| เครื่องของคุณ | RAM | โมเดลที่ README จับคู่ไว้ | ความเร็วที่รายงาน (0 GPU) |
|---|---|---|---|
| แล็ปท็อปหรือมินิ PC | 16 ถึง 32 GB | Nemotron-3.5-30B-A3B, 14.35 GiB | 25.0 ถึง 60.4 tok/s |
| เดสก์ท็อปหรือเซิร์ฟเวอร์ | 64 GB | DeepSeek-V4-Flash 284B, 56.56 GiB | prefill 44.4 tok/s, decode 9.1 ถึง 14.7 tok/s |
| เวิร์กสเตชัน 8 ช่อง RAM | 128 GB+ | DeepSeek 284B หรือ Nemotron 30B | 111.62 tok/s (เฉพาะ 30B) |
- หน่วยความจำสูงสุดที่ 57.61 ถึง 58.9 GiB ที่ context 256K ซึ่งอยู่ใต้เพดานที่ใช้ได้จริง 62.5 GiB ปิดโปรแกรมอื่นๆ ทั้งหมดก่อนโหลดโมเดล
- ไบนารีที่ build มาแล้วรองรับเฉพาะ Linux x86_64 (
llama-server-modchip-linux-x86_64) สคริปต์ติดตั้ง./modchipรองรับทั้ง Linux และ macOS ผลลัพธ์ Apple Silicon ใน README เป็นของโมเดล 30B ไม่ใช่ 284B [VERIFY] ว่าโมเดล 284B รันบน Mac 64 GB ได้หรือไม่ - แบนด์วิดท์หน่วยความจำคือเพดานจริง FAQ ระบุว่าเมนบอร์ดเซิร์ฟเวอร์แบบ 8 หรือ 12 ช่อง RAM ช่วยเพิ่มความเร็ว decode ประมาณ 3 ถึง 4 เท่าเมื่อเทียบกับ DDR5 แบบ dual-channel
ใน repository มีสคริปต์ตรวจสอบความพร้อมที่ไม่ต้องดาวน์โหลดโมเดล:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
ควรอ่านสคริปต์ก่อน pipe เข้า Python เสมอ
วิธีรัน DeepSeek V4 Flash โดยไม่ใช้ GPU ทีละขั้นตอน
เส้นทางที่ 1: การติดตั้งแบบมีคู่มือนำ
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat เปิดแชทในเทอร์มินัลพร้อมแสดงโทเคนต่อวินาทีแบบเรียลไทม์ คำสั่งย่อยอื่นๆ:
| คำสั่ง | หน้าที่ |
|---|---|
./modchip web |
เว็บแชทและ telemetry ที่ http://127.0.0.1:8787 |
./modchip bench |
ทดสอบความเร็ว 30 วินาที พร้อม scorecard ที่แชร์ได้ |
./modchip claude |
เปิด Claude Code โดยเชื่อมกับเอนจินในเครื่อง |
./modchip status / stop |
ตรวจสอบความพร้อมหรือหยุดบริการพื้นหลัง |
เส้นทางที่ 2: รันเซิร์ฟเวอร์ตรงๆ
วิธีนี้ดึงไฟล์ GGUF และเซิร์ฟเวอร์ที่ build มาแล้วจาก repository บน Hugging Face แล้วเริ่มรันบนพอร์ต 8080:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
ตั้งค่า -t ให้เท่ากับจำนวนฟิสิคัลคอร์ของคุณ ตัวอย่างใช้ context 32K ส่วนตัวเลขที่ 256K ใช้ -c 262144
ข้อควรระวังสำคัญ: llama.cpp ตัวปกติ, Ollama และ LM Studio โหลดไฟล์นี้ไม่ได้ เพราะ checkpoint ใช้ tensor type แบบกำหนดเอง (ID 40) ทำให้ build ที่ไม่ได้แพตช์จะ fail ด้วยข้อความ unknown tensor type 40 ให้ใช้สคริปต์ ./modchip หรือไบนารีที่มาพร้อมกัน
เซิร์ฟเวอร์นี้คือ llama-server ของ llama.cpp ที่ถูกแพตช์แล้ว จึงรองรับ route แบบ OpenAI คือ /v1/chat/completions:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
เกตเวย์บนพอร์ต 8787
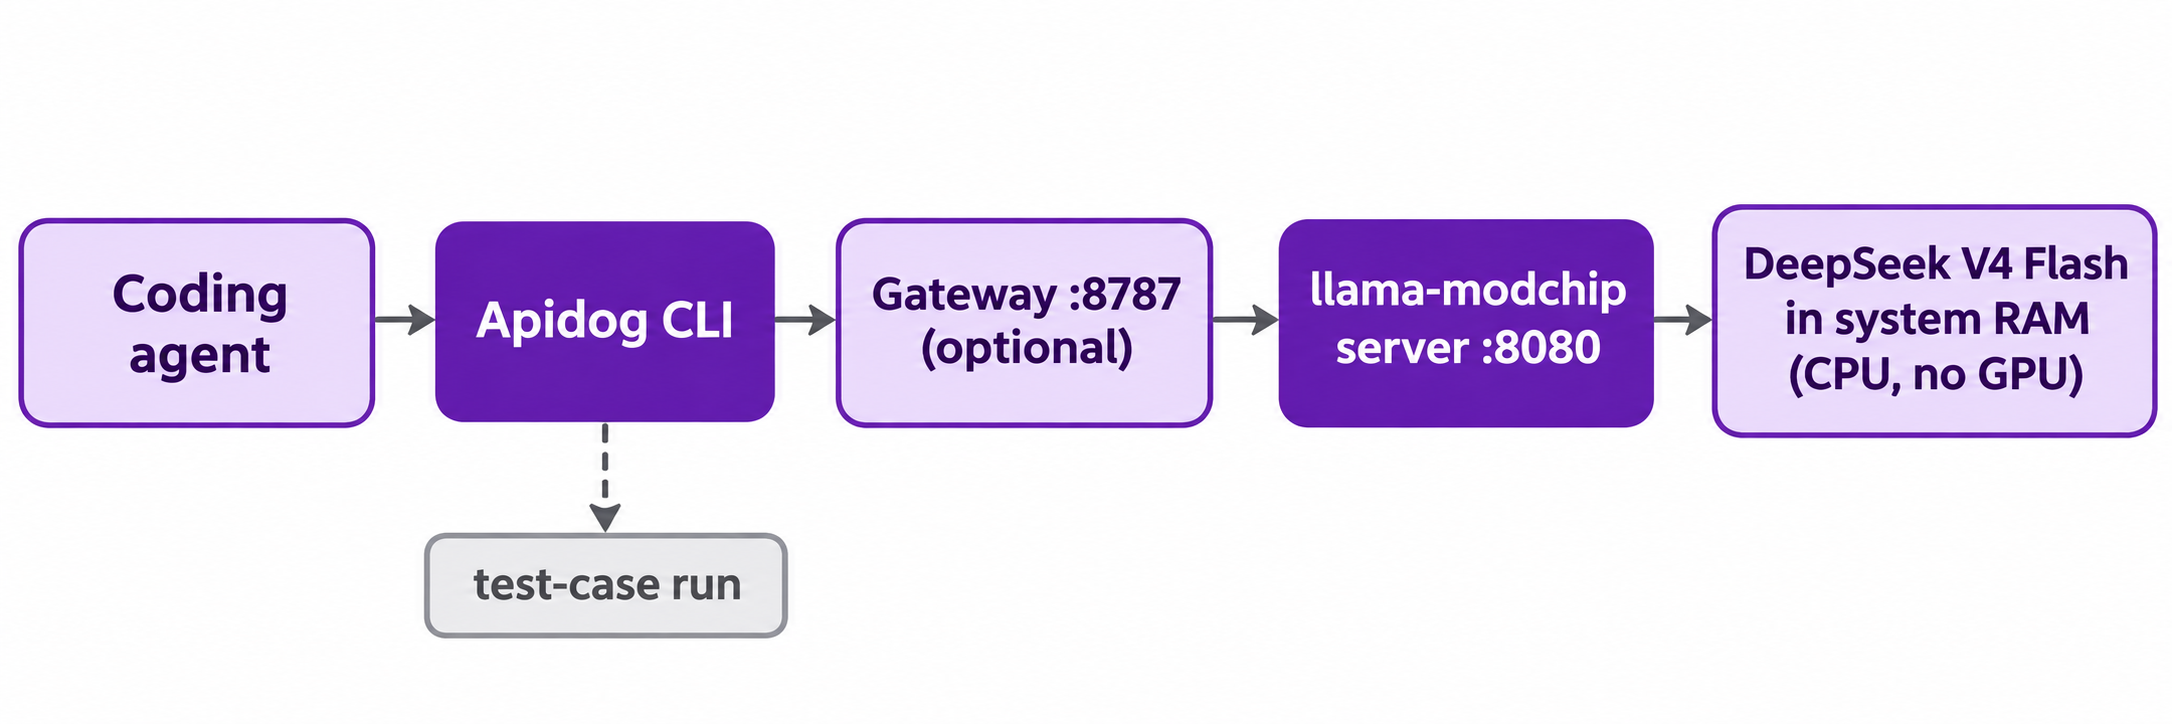
gateway/sse_gateway.py เป็นพร็อกซีบน 127.0.0.1:8787 ที่ส่งต่อไปยังเอนจิน (ตั้งค่า upstream ด้วย LLAMA_BACKEND_URL) รองรับ /v1/chat/completions, /v1/messages, /v1/models และ /health หากตั้งค่า GATEWAY_API_KEY จะต้องส่ง bearer token มาด้วย ./modchip claude จะชี้ Claude Code มาที่นี่
ความเร็วกับคุณภาพ: ค่าตอแทนของ 1.71 บิตต่อเวท
ตัวเลขความเร็วเป็นเรื่องจริงแต่มีเงื่อนไขเฉพาะ นี่คือตารางของผู้ดูแลโปรเจกต์สำหรับ DeepSeek-V4-Flash ที่ context 256K บน Ryzen 9 9955HX:
| การตั้งค่า | Prefill | Decode | Decode พร้อม drafter |
|---|---|---|---|
UD-IQ1_S ที่ไม่ได้แพตช์ (76.87 GiB) |
OOM หรือ swap บนเครื่อง 64 GB | 5.91 tok/s | ไม่มีข้อมูล |
| ค่าเริ่มต้น v2.4.0 (Top-6, 56.56 GiB) | 43.16 ถึง 44.36 tok/s | 9.06 ถึง 9.95 tok/s | 11.5 ถึง 14.7 tok/s |
| Top-5 ในเลเยอร์ช่วงท้าย | 43.16 ถึง 44.36 tok/s | 9.68 ถึง 9.87 tok/s | 12.2 ถึง 15.1 tok/s |
| Top-4 บวก gate-first SwiGLU | 43.16 ถึง 44.36 tok/s | 10.12 ถึง 10.74 tok/s | 13.0 ถึง 16.0 tok/s |
คุณสลับไปยังแถวที่เร็วกว่าได้ด้วย LLAMA_MOE_TOP_K=5 หรือ 4 README ระบุว่า Top-5 เพิ่ม perplexity ประมาณ 0.42% เทียบกับค่าเริ่มต้นของตัวเอง
มีข้อควรระวังสองข้อที่ถูกพูดถึงซ้ำๆ บน Hacker News:
- “ไม่สูญเสีย” (lossless) หมายถึงไม่สูญเสียเมื่อเทียบกับไฟล์ 1.71 bpw ไม่ใช่เทียบกับเวทดั้งเดิม ค่า cosine similarity 1.00000 เป็นการเปรียบเทียบระหว่างรันไทม์ที่แพตช์และไม่แพตช์บน checkpoint ที่ถูกบีบอัดเดียวกัน ซึ่ง expert ที่ถูก route ส่วนใหญ่อยู่ที่
IQ1_S(ประมาณ 1.56 บิต) ผู้คอมเมนต์ระบุว่าคุณภาพมักลดลงเมื่อต่ำกว่า 4 บิต และ README ไม่มีการเปรียบเทียบกับผลลัพธ์จากโมเดลเต็มความแม่นยำ - Prefill คือคอขวดของ agent ที่ 44 โทเคนต่อวินาที พรอมต์ขนาด 10,000 โทเคนจะใช้เวลาประมาณ 225 วินาทีก่อนจะได้โทเคนแรก KV snapshots (กู้คืนใช้เวลา 13.1 ถึง 32.6 ms สำหรับพรอมต์ Claude Code ที่มี 40 ตัว tool) ช่วยในการสนทนาซ้ำๆ แต่ไม่ช่วยกับ context ใหม่
อีกหนึ่งข้อ: นี่คือ checkpoint ของ V4-Flash เดือนกรกฎาคม 0731 DeepSeek ได้เปิดตัว V4.1 Flash ไปแล้ว หากคุณสนใจเวทใหม่ล่าสุด ลองอ่าน การเปรียบเทียบ DeepSeek V4.1 Flash กับ V4 Pro และ V4 Flash ก่อน
ให้มองว่าโมเดล 284B ในเครื่องเป็นโมเดลส่วนตัวแบบออฟไลน์สำหรับงานร่างแรก งานแบบ batch และการทดลอง และควรทดสอบกับพรอมต์ของคุณเองก่อน
ให้ coding agent ทดสอบ endpoint ในเครื่องด้วย Apidog CLI
โมเดลในเครื่องก็ยังเป็น API อยู่: ตอบได้หรือเปล่า JSON ถูกต้องไหม การเปลี่ยน flag ล่าสุดทำให้อะไรพังหรือเปล่า coding agent ของคุณรันเช็คเหล่านี้ได้ด้วย Apidog CLI ซึ่งรันบนเครื่องของคุณและเข้าถึง 127.0.0.1 ได้โดยตรง ติดตั้งครั้งเดียว:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill install จะเพิ่ม Apidog skill เพื่อให้ agent รู้จักคำสั่งต่างๆ จากนั้นสั่ง agent เช่น Claude Code ด้วยพรอมต์เดียว:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
Agent จะอ่าน schema ตรวจสอบ payload แล้วเขียนและรัน:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request (หน่วยเป็นมิลลิวินาที) มีความสำคัญ: โมเดล 284B ที่ขึ้นกับ CPU ช้าพอที่จะทำให้ timeout ค่าเริ่มต้นหมดเวลา
ประโยชน์ที่ได้คือการเปรียบเทียบ: ชี้ environment ที่สองไปที่ API โฮสต์ของ DeepSeek รันเทสเคสเดียวกัน แล้วดูว่าโมเดล quant ในเครื่องเพี้ยนตรงไหน เพิ่ม --upload-report เพื่อดูผลการรันในแอป ดูเพิ่มเติมที่ Apidog CLI ใน Claude Code และ คู่มือติดตั้ง Apidog CLI แพ็กเกจ Free ของ Apidog รองรับผู้ใช้ได้สูงสุด 4 คน
CPU ในเครื่อง vs GPU vs API แบบโฮสต์
| ทางเลือก | สิ่งที่ต้องมี | เหมาะกับ |
|---|---|---|
| llama-modchip บน CPU | RAM 64 GB, CPU x86_64 รุ่นใหม่ | งานส่วนตัวแบบออฟไลน์ที่ไม่มีค่า API หากคุณยอมรับ prefill ที่ช้า |
| รันด้วย GPU ผ่าน vLLM หรือ SGLang | VRAM ขนาดใหญ่หรือเครื่องหลาย GPU | การโฮสต์เองที่เร็วและความแม่นยำสูงกว่า |
| API โฮสต์ของ DeepSeek | API key | ผลลัพธ์เต็มคุณภาพที่ความเร็วระดับ production |
สำหรับสาย GPU ให้ดู วิธีรัน DeepSeek V4 ในเครื่อง ซึ่งครอบคลุม vLLM และ SGLang สำหรับการคำนวณหน่วยความจำของ checkpoint ใหม่กว่า ดูที่ วิธีรัน DeepSeek V4.1 Flash ในเครื่อง สำหรับการทดสอบโมเดลในเครื่องในฐานะ API ดูที่ การทดสอบ LLM ในเครื่องในฐานะ API
คำถามที่พบบ่อย
รัน DeepSeek V4 Flash โดยไม่ใช้ GPU ได้จริงหรือ?
ได้ ด้วย llama-modchip และ RAM 64 GB ผู้ดูแลโปรเจกต์รายงานความเร็ว prefill 44.36 โทเคนต่อวินาที และ decode 9 ถึง 15 โทเคนต่อวินาที บน Ryzen 9 9955HX แบบ 16 คอร์ โดยโมเดลทั้งหมดขนาด 56.56 GiB อยู่ใน RAM และไม่มีการใช้ swap เลย
ใช้กับ Ollama หรือ LM Studio ได้ไหม?
ไม่ได้ checkpoint ใช้ tensor type แบบกำหนดเอง และ llama.cpp ที่ไม่ได้แพตช์, Ollama และ LM Studio จะปฏิเสธไฟล์ด้วยข้อความ unknown tensor type 40 ให้ใช้สคริปต์ ./modchip ของ repo หรือไบนารี llama-server-modchip-linux-x86_64 ที่มาพร้อมกัน
ถ้ามีแค่ RAM 16 หรือ 32 GB ล่ะ?
ให้รันโมเดล MoE ขนาด 30B แทน README จับคู่ระดับนี้กับ Nemotron-3.5-30B-A3B ซึ่งเป็นไฟล์ขนาด 14.35 GiB และรายงานความเร็ว 25.0 ถึง 60.4 โทเคนต่อวินาทีบน CPU
ผลลัพธ์ที่ 1.71 บิตต่อเวท ดีแค่ไหน?
โปรเจกต์ไม่มีการเปรียบเทียบกับ DeepSeek เต็มความแม่นยำ และผู้คอมเมนต์บน Hacker News ก็แสดงความสงสัยในขนาดนี้ ควรทดสอบพรอมต์ของคุณกับ API โฮสต์ก่อนพึ่งพามัน
เซิร์ฟเวอร์ในเครื่องรองรับ OpenAI-compatible ไหม?
รองรับ เป็น llama-server ของ llama.cpp ที่แพตช์แล้ว จึงใช้ /v1/chat/completions บนพอร์ต 8080 ได้ ส่วนเกตเวย์ (ไม่บังคับ) บนพอร์ต 8787 ยังให้บริการ /v1/messages ซึ่งเป็น route สไตล์ Anthropic ที่ Claude Code ใช้อีกด้วย
coding agent ทดสอบโมเดลในเครื่องอัตโนมัติได้ไหม?
ได้ ติดตั้ง Apidog CLI รัน apidog skill install แล้วสั่งให้ agent สร้าง environment ที่ชี้ไปที่ http://127.0.0.1:8080 และเทสเคสสำหรับ /v1/chat/completions จากนั้นมันจะรัน apidog test-case run และรายงานข้อผิดพลาดให้