ทีม Qwen จาก Alibaba Cloud ได้เปิดตัวสองส่วนเสริมที่ทรงพลังสำหรับโมเดลภาษาขนาดใหญ่ (LLM) ของพวกเขา ได้แก่ Qwen3-4B-Instruct-2507 และ Qwen3-4B-Thinking-2507 โมเดลเหล่านี้มาพร้อมความก้าวหน้าครั้งสำคัญในการให้เหตุผล การปฏิบัติตามคำสั่ง และความเข้าใจในบริบทที่ยาวนาน โดยรองรับความยาวบริบท 256K โทเค็นโดยกำเนิด ออกแบบมาสำหรับนักพัฒนา นักวิจัย และผู้ที่ชื่นชอบ AI โมเดลเหล่านี้มีความสามารถที่แข็งแกร่งสำหรับงานตั้งแต่การเขียนโค้ดไปจนถึงการแก้ปัญหาที่ซับซ้อน นอกจากนี้ เครื่องมืออย่าง Apidog ซึ่งเป็นแพลตฟอร์มการจัดการ API ฟรี สามารถช่วยปรับปรุงการทดสอบและการผสานรวมโมเดลเหล่านี้เข้ากับแอปพลิเคชันของคุณได้
ทำความเข้าใจโมเดล Qwen3-4B
ซีรีส์ Qwen3 แสดงถึงวิวัฒนาการล่าสุดในตระกูลโมเดลภาษาขนาดใหญ่ของ Alibaba Cloud ซึ่งต่อจากซีรีส์ Qwen2.5 โดยเฉพาะอย่างยิ่ง Qwen3-4B-Instruct-2507 และ Qwen3-4B-Thinking-2507 ได้รับการปรับแต่งสำหรับการใช้งานที่แตกต่างกัน: แบบแรกโดดเด่นในการสนทนาทั่วไปและการปฏิบัติตามคำสั่ง ในขณะที่แบบหลังได้รับการปรับให้เหมาะสมสำหรับงานการให้เหตุผลที่ซับซ้อน โมเดลทั้งสองรองรับความยาวบริบทดั้งเดิมที่ 262,144 โทเค็น ทำให้สามารถประมวลผลชุดข้อมูลขนาดใหญ่ เอกสารยาวๆ หรือการสนทนาหลายรอบได้อย่างง่ายดาย ยิ่งไปกว่านั้น ความเข้ากันได้กับเฟรมเวิร์กอย่าง Hugging Face Transformers และเครื่องมือการปรับใช้เช่น Apidog ทำให้สามารถเข้าถึงได้สำหรับทั้งแอปพลิเคชันในเครื่องและบนคลาวด์
Qwen3-4B-Instruct-2507: ปรับให้เหมาะสมเพื่อประสิทธิภาพ
โมเดล Qwen3-4B-Instruct-2507 ทำงานในโหมดไม่คิด โดยมุ่งเน้นไปที่การตอบสนองที่มีประสิทธิภาพและคุณภาพสูงสำหรับงานทั่วไป โมเดลนี้ได้รับการปรับแต่งเพื่อเพิ่มประสิทธิภาพในการปฏิบัติตามคำสั่ง การให้เหตุผลเชิงตรรกะ ความเข้าใจข้อความ และความสามารถหลายภาษา โดยเฉพาะอย่างยิ่ง มันไม่ได้สร้างบล็อก <think></think> ทำให้เหมาะสำหรับสถานการณ์ที่ต้องการคำตอบที่รวดเร็วและตรงไปตรงมามากกว่าการให้เหตุผลแบบทีละขั้นตอน
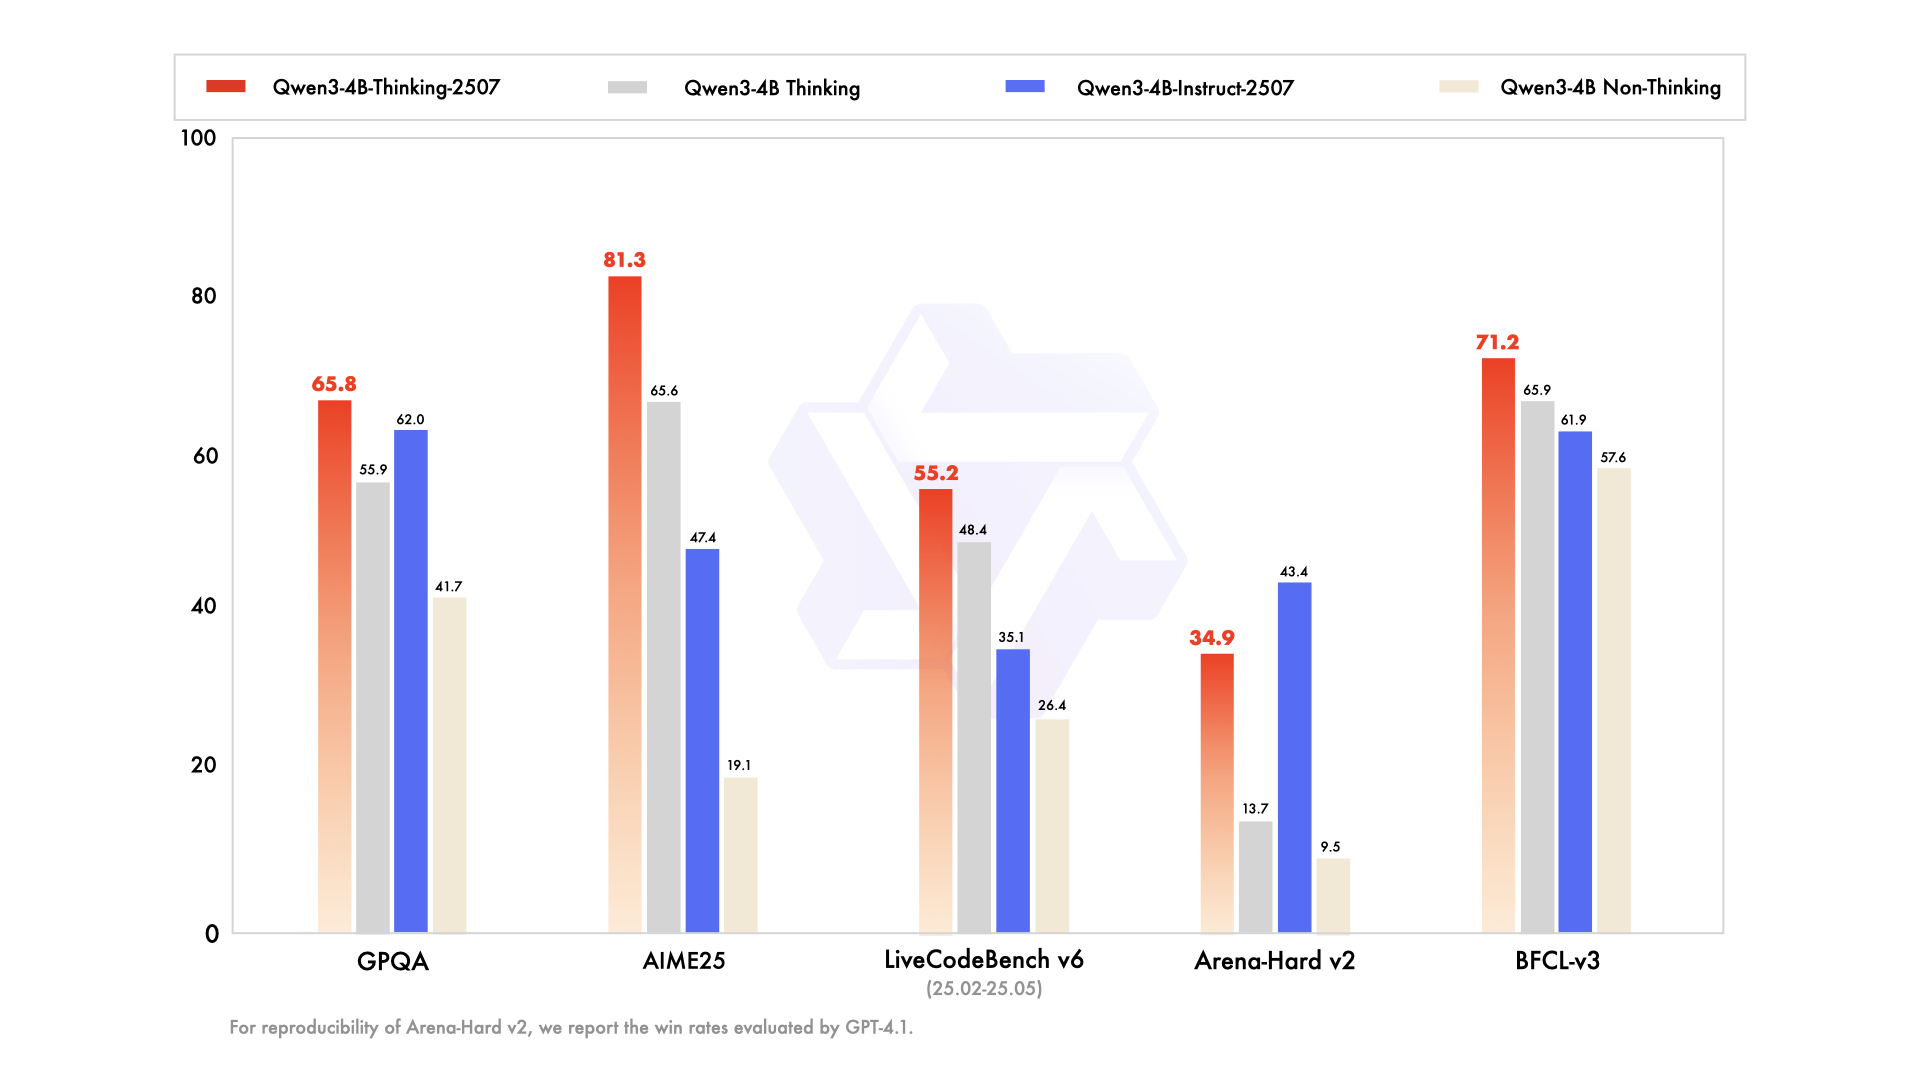
การปรับปรุงที่สำคัญได้แก่:
- ความสามารถทั่วไปที่ได้รับการปรับปรุง: โมเดลแสดงประสิทธิภาพที่เหนือกว่าในด้านคณิตศาสตร์ วิทยาศาสตร์ การเขียนโค้ด และการใช้เครื่องมือ ทำให้มีความหลากหลายสำหรับการใช้งานทางเทคนิค
- การรองรับหลายภาษา: ครอบคลุมมากกว่า 100 ภาษาและภาษาถิ่น ทำให้มั่นใจได้ถึงประสิทธิภาพที่แข็งแกร่งในการใช้งานทั่วโลก
- ความเข้าใจในบริบทที่ยาวนาน: ด้วยความยาวบริบท 256K โทเค็น ทำให้สามารถจัดการอินพุตที่ขยายออกไป เช่น เอกสารทางกฎหมายหรือฐานรหัสที่ยาวนาน โดยไม่มีการตัดทอน
- การจัดแนวกับความต้องการของผู้ใช้: โมเดลให้การตอบสนองที่เป็นธรรมชาติและน่าสนใจยิ่งขึ้น โดย excels ในการเขียนเชิงสร้างสรรค์และการสนทนาหลายรอบ
สำหรับนักพัฒนาที่รวมโมเดลนี้เข้ากับ API นั้น Apidog มีอินเทอร์เฟซที่ใช้งานง่ายสำหรับการทดสอบและจัดการปลายทาง API ทำให้มั่นใจได้ถึงการปรับใช้ที่ราบรื่น ประสิทธิภาพนี้ทำให้ Qwen3-4B-Instruct-2507 เป็นตัวเลือกที่เหมาะสำหรับแอปพลิเคชันที่ต้องการการตอบสนองที่รวดเร็วและแม่นยำ
Qwen3-4B-Thinking-2507: สร้างขึ้นเพื่อการให้เหตุผลเชิงลึก
ในทางตรงกันข้าม Qwen3-4B-Thinking-2507 ได้รับการออกแบบสำหรับงานที่ต้องการการให้เหตุผลอย่างเข้มข้น เช่น การแก้ปัญหาเชิงตรรกะ คณิตศาสตร์ และเกณฑ์มาตรฐานทางวิชาการ โมเดลนี้ทำงานเฉพาะในโหมดคิด โดยรวมกระบวนการ Chain-of-Thought (CoT) โดยอัตโนมัติเพื่อแยกย่อยปัญหาที่ซับซ้อน ผลลัพธ์ของมันอาจรวมถึงแท็กปิด </think> โดยไม่มีแท็กเปิด <think> เนื่องจากเทมเพลตแชทเริ่มต้นจะฝังพฤติกรรมการคิดไว้
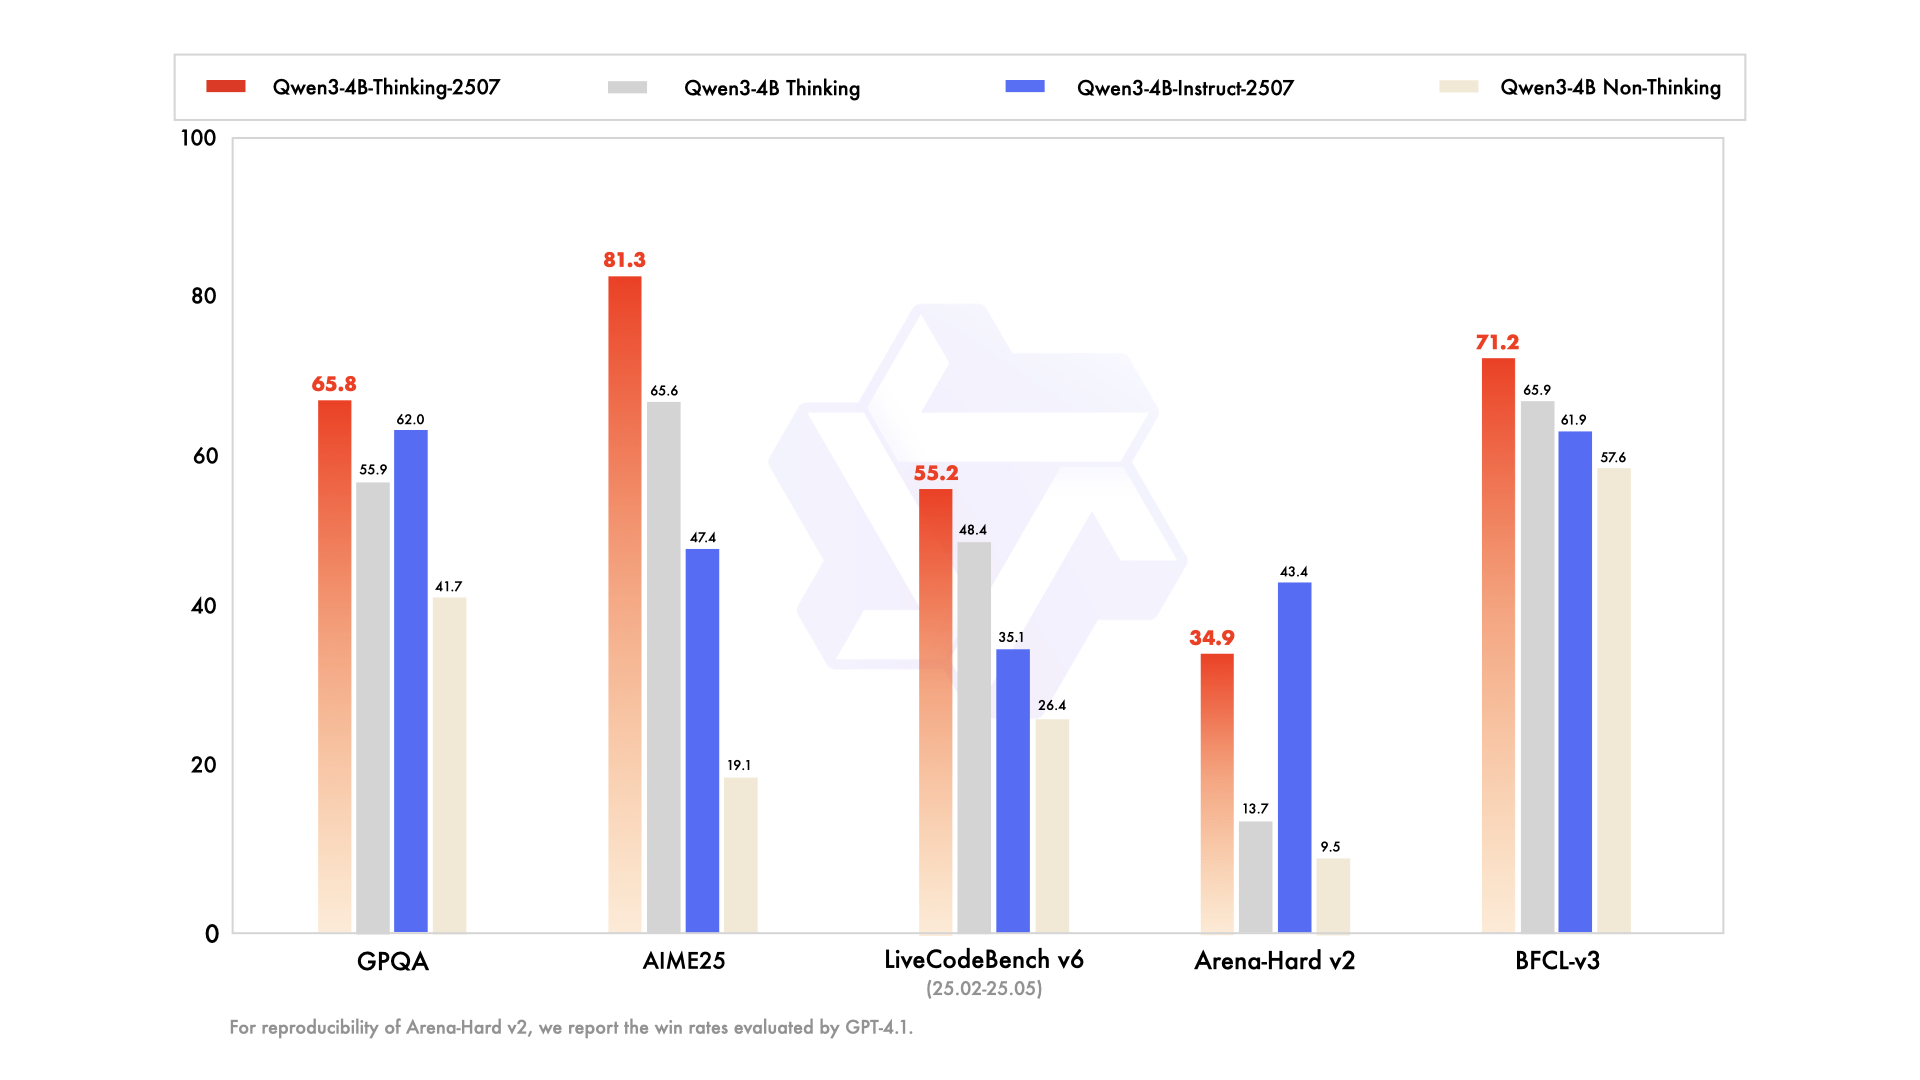
การปรับปรุงที่สำคัญได้แก่:
- ความสามารถในการให้เหตุผลขั้นสูง: โมเดลนี้บรรลุผลลัพธ์ที่ล้ำสมัยในบรรดาโมเดลการคิดแบบโอเพนซอร์ส โดยเฉพาะในสาขา STEM และการเขียนโค้ด
- ความลึกของการคิดที่เพิ่มขึ้น: มัน excels ในงานที่ต้องการการให้เหตุผลระดับผู้เชี่ยวชาญของมนุษย์ ด้วยความยาวการคิดที่ขยายออกไปสำหรับการวิเคราะห์อย่างละเอียด
- ความยาวบริบท 256K: เช่นเดียวกับคู่หู Instruct ของมัน มันรองรับหน้าต่างบริบทขนาดใหญ่ เหมาะสำหรับการประมวลผลชุดข้อมูลขนาดใหญ่หรือการสืบค้นที่ซับซ้อน
- การรวมเครื่องมือ: โมเดลนี้ใช้ประโยชน์จากเครื่องมือเช่น Qwen-Agent สำหรับเวิร์กโฟลว์ตัวแทนที่คล่องตัว เพิ่มประโยชน์ในการทำงานในระบบอัตโนมัติ
สำหรับนักพัฒนาที่ทำงานกับแอปพลิเคชันที่ต้องใช้การให้เหตุผลอย่างเข้มข้น Apidog สามารถอำนวยความสะดวกในการทดสอบ API ทำให้มั่นใจได้ว่าผลลัพธ์ของโมเดลสอดคล้องกับผลลัพธ์ที่คาดหวัง โมเดลนี้เหมาะอย่างยิ่งสำหรับสภาพแวดล้อมการวิจัยและสถานการณ์การแก้ปัญหาที่ซับซ้อน
ข้อมูลจำเพาะทางเทคนิคและสถาปัตยกรรม
โมเดล Qwen3-4B ทั้งสองเป็นส่วนหนึ่งของตระกูล Qwen3 ซึ่งรวมถึงสถาปัตยกรรมแบบหนาแน่น (dense) และแบบผสมผสานผู้เชี่ยวชาญ (MoE) การกำหนด 4B หมายถึงพารามิเตอร์ 4 พันล้านตัว ซึ่งสร้างสมดุลระหว่างประสิทธิภาพการคำนวณและประสิทธิภาพ ด้วยเหตุนี้ โมเดลเหล่านี้จึงสามารถเข้าถึงได้บนฮาร์ดแวร์ระดับผู้บริโภค ซึ่งแตกต่างจากโมเดลขนาดใหญ่กว่าอย่าง Qwen3-235B-A22B ที่ต้องใช้ทรัพยากรจำนวนมาก
จุดเด่นของสถาปัตยกรรม
- การออกแบบโมเดลแบบหนาแน่น: แตกต่างจากโมเดล MoE โมเดล Qwen3-4B ใช้สถาปัตยกรรมแบบหนาแน่น ทำให้มั่นใจได้ถึงประสิทธิภาพที่สอดคล้องกันในทุกงานโดยไม่จำเป็นต้องมีการเปิดใช้งานพารามิเตอร์แบบเลือก
- YaRN สำหรับการขยายบริบท: โมเดลใช้ YaRN เพื่อขยายความยาวบริบทจาก 32,768 เป็น 262,144 โทเค็น ทำให้สามารถประมวลผลบริบทที่ยาวนานได้โดยไม่มีประสิทธิภาพลดลงอย่างมีนัยสำคัญ
- กระบวนการฝึกอบรม: ทีม Qwen ใช้กระบวนการฝึกอบรมสี่ขั้นตอน ซึ่งรวมถึงการเริ่มต้นแบบ Cold Start ด้วย Chain-of-Thought ที่ยาวนาน การเรียนรู้แบบเสริมแรงโดยอิงจากการให้เหตุผล การรวมโหมดการคิด และการเรียนรู้แบบเสริมแรงทั่วไป แนวทางนี้ช่วยเพิ่มทั้งความสามารถในการให้เหตุผลและการสนทนา
- การรองรับ Quantization: โมเดลทั้งสองรองรับการ Quantization แบบ FP8 ซึ่งช่วยลดความต้องการหน่วยความจำในขณะที่ยังคงความแม่นยำ ตัวอย่างเช่น Qwen3-4B-Thinking-2507-FP8 มีให้สำหรับสภาพแวดล้อมที่มีทรัพยากรจำกัด
ข้อกำหนดฮาร์ดแวร์
ในการรันโมเดลเหล่านี้อย่างมีประสิทธิภาพ ให้พิจารณาสิ่งต่อไปนี้:
- หน่วยความจำ GPU: แนะนำ VRAM ขั้นต่ำ 8GB สำหรับโมเดลที่ Quantize แบบ FP8 ในขณะที่โมเดล bfloat16 อาจต้องใช้ 16GB หรือมากกว่า
- RAM: เพื่อประสิทธิภาพสูงสุด หน่วยความจำรวม 16GB (VRAM + RAM) เพียงพอสำหรับงานส่วนใหญ่
- เฟรมเวิร์กการอนุมาน: โมเดลทั้งสองเข้ากันได้กับ Hugging Face Transformers (เวอร์ชัน ≥4.51.0), vLLM (≥0.8.5) และ SGLang (≥0.4.6.post1) เครื่องมือในเครื่องอย่าง Ollama และ LMStudio ก็รองรับ Qwen3 ด้วย
สำหรับนักพัฒนาที่ปรับใช้โมเดลเหล่านี้ Apidog ทำให้กระบวนการง่ายขึ้นโดยการจัดหาเครื่องมือสำหรับตรวจสอบและทดสอบประสิทธิภาพ API ทำให้มั่นใจได้ถึงการรวมเข้ากับเฟรมเวิร์กการอนุมานอย่างมีประสิทธิภาพ
การผสานรวมกับ Hugging Face และ ModelScope
โมเดล Qwen3-4B มีให้ใช้งานทั้งบน Hugging Face และ ModelScope ซึ่งให้ความยืดหยุ่นแก่นักพัฒนา ด้านล่างนี้ เราได้ให้ตัวอย่างโค้ดเพื่อสาธิตวิธีการใช้ Qwen3-4B-Instruct-2507 กับ Hugging Face Transformers

from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "Qwen/Qwen3-4B-Instruct-2507"tokenizer = AutoTokenizer.from_pretrained(model_name)model = AutoModelForCausalLM.from_pretrained(model_name, torch_dtype="auto", device_map="auto")
prompt = "Write a Python function to calculate Fibonacci numbers."messages = [{"role": "user", "content": prompt}]text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
generated_ids = model.generate(**model_inputs, max_new_tokens=16384)output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()content = tokenizer.decode(output_ids, skip_special_tokens=True)print("Generated Code:\n", content)
สำหรับ Qwen3-4B-Thinking-2507 ต้องมีการแยกวิเคราะห์เพิ่มเติมเพื่อจัดการเนื้อหาการคิด:
from transformers import AutoModelForCausalLM, AutoTokenizer
model_name = "Qwen/Qwen3-4B-Thinking-2507"tokenizer = AutoTokenizer.from_pretrained(model_name)model = AutoModelForCausalLM.from_pretrained(model_name, torch_dtype="auto", device_map="auto")
prompt = "Solve the equation 2x^2 + 3x - 5 = 0."messages = [{"role": "user", "content": prompt}]text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)model_inputs = tokenizer([text], return_tensors="pt").to(model.device)
generated_ids = model.generate(**model_inputs, max_new_tokens=32768)output_ids = generated_ids[0][len(model_inputs.input_ids[0]):].tolist()
try:index = len(output_ids) - output_ids[::-1].index(151668)  #  tokenexcept ValueError:index = 0thinking_content = tokenizer.decode(output_ids[:index], skip_special_tokens=True).strip("\n")content = tokenizer.decode(output_ids[index:], skip_special_tokens=True).strip("\n")print("Thinking Process:\n", thinking_content)print("Solution:\n", content)
ตัวอย่างโค้ดเหล่านี้แสดงให้เห็นถึงความง่ายในการรวมโมเดล Qwen เข้ากับเวิร์กโฟลว์ Python สำหรับการปรับใช้ที่ใช้ API นั้น Apidog สามารถช่วยทดสอบปลายทางเหล่านี้ได้ ทำให้มั่นใจได้ถึงประสิทธิภาพที่เชื่อถือได้
การเพิ่มประสิทธิภาพและแนวทางปฏิบัติที่ดีที่สุด
เพื่อให้ได้ประสิทธิภาพสูงสุดจากโมเดล Qwen3-4B ให้พิจารณาคำแนะนำต่อไปนี้:
- พารามิเตอร์การสุ่มตัวอย่าง: สำหรับ Qwen3-4B-Instruct-2507 ให้ใช้
temperature=0.7,top_p=0.8,top_k=20และmin_p=0สำหรับ Qwen3-4B-Thinking-2507 ให้ใช้temperature=0.6,top_p=0.95,top_k=20และmin_p=0หลีกเลี่ยงการถอดรหัสแบบโลภ (greedy decoding) เพื่อป้องกันประสิทธิภาพลดลง - การจัดการความยาวบริบท: หากพบปัญหาหน่วยความจำไม่พอ ให้ลดความยาวบริบทเป็น 32,768 โทเค็น อย่างไรก็ตาม สำหรับงานที่ต้องใช้การให้เหตุผล ให้รักษาความยาวบริบทให้สูงกว่า 131,072 โทเค็น
- Presence Penalty: ตั้งค่า
presence_penaltyระหว่าง 0 ถึง 2 เพื่อลดการซ้ำซ้อน แต่หลีกเลี่ยงค่าสูงๆ เพื่อป้องกันการผสมภาษา - เฟรมเวิร์กการอนุมาน: ใช้ vLLM หรือ SGLang สำหรับการอนุมานที่มีปริมาณงานสูง และใช้ประโยชน์จาก Apidog เพื่อตรวจสอบประสิทธิภาพ API
การเปรียบเทียบ Qwen3-4B-Instruct-2507 และ Qwen3-4B-Thinking-2507
แม้ว่าโมเดลทั้งสองจะมีสถาปัตยกรรมพารามิเตอร์ 4 พันล้านตัวเหมือนกัน แต่ปรัชญาการออกแบบของพวกมันแตกต่างกัน:
- Qwen3-4B-Instruct-2507: ให้ความสำคัญกับความเร็วและประสิทธิภาพ ทำให้เหมาะสำหรับแชทบอท การสนับสนุนลูกค้า และแอปพลิเคชันทั่วไป
- Qwen3-4B-Thinking-2507: มุ่งเน้นไปที่การให้เหตุผลเชิงลึก เหมาะสำหรับงานวิจัยทางวิชาการ การแก้ปัญหาที่ซับซ้อน และงานที่ต้องใช้กระบวนการ Chain-of-Thought
นักพัฒนาสามารถสลับระหว่างโหมดต่างๆ ได้โดยใช้ข้อความแจ้ง /think และ /no_think ซึ่งช่วยให้มีความยืดหยุ่นตามความต้องการของงาน Apidog สามารถช่วยในการทดสอบการสลับโหมดเหล่านี้ในแอปพลิเคชันที่ขับเคลื่อนด้วย API
การสนับสนุนจากชุมชนและระบบนิเวศ
โมเดล Qwen3-4B ได้รับประโยชน์จากระบบนิเวศที่แข็งแกร่ง โดยได้รับการสนับสนุนจาก Hugging Face, ModelScope และเครื่องมืออย่าง Ollama, LMStudio และ llama.cpp ลักษณะโอเพนซอร์สของโมเดลเหล่านี้ ซึ่งได้รับอนุญาตภายใต้ Apache 2.0 ส่งเสริมการมีส่วนร่วมของชุมชนและการปรับแต่ง ตัวอย่างเช่น Unsloth มีเครื่องมือสำหรับการปรับแต่งที่เร็วขึ้น 2 เท่า โดยใช้ VRAM น้อยลง 70% ทำให้โมเดลเหล่านี้เข้าถึงได้สำหรับผู้ชมที่กว้างขึ้น
บทสรุป
โมเดล Qwen3-4B-Instruct-2507 และ Qwen3-4B-Thinking-2507 ถือเป็นก้าวสำคัญในซีรีส์ Qwen ของ Alibaba Cloud โดยนำเสนอความสามารถที่เหนือชั้นในการปฏิบัติตามคำสั่ง การให้เหตุผล และการประมวลผลบริบทที่ยาวนาน ด้วยความยาวบริบท 256K โทเค็น การรองรับหลายภาษา และความเข้ากันได้กับเครื่องมืออย่าง Apidog โมเดลเหล่านี้ช่วยให้นักพัฒนาสามารถสร้างแอปพลิเคชันที่ชาญฉลาดและปรับขนาดได้ ไม่ว่าคุณจะสร้างโค้ด แก้สมการ หรือสร้างแชทบอทหลายภาษา โมเดลเหล่านี้ก็ให้ประสิทธิภาพที่ยอดเยี่ยม เริ่มสำรวจศักยภาพของพวกมันได้แล้ววันนี้ และใช้ Apidog เพื่อปรับปรุงการรวม API ของคุณเพื่อประสบการณ์การพัฒนาที่ราบรื่น