
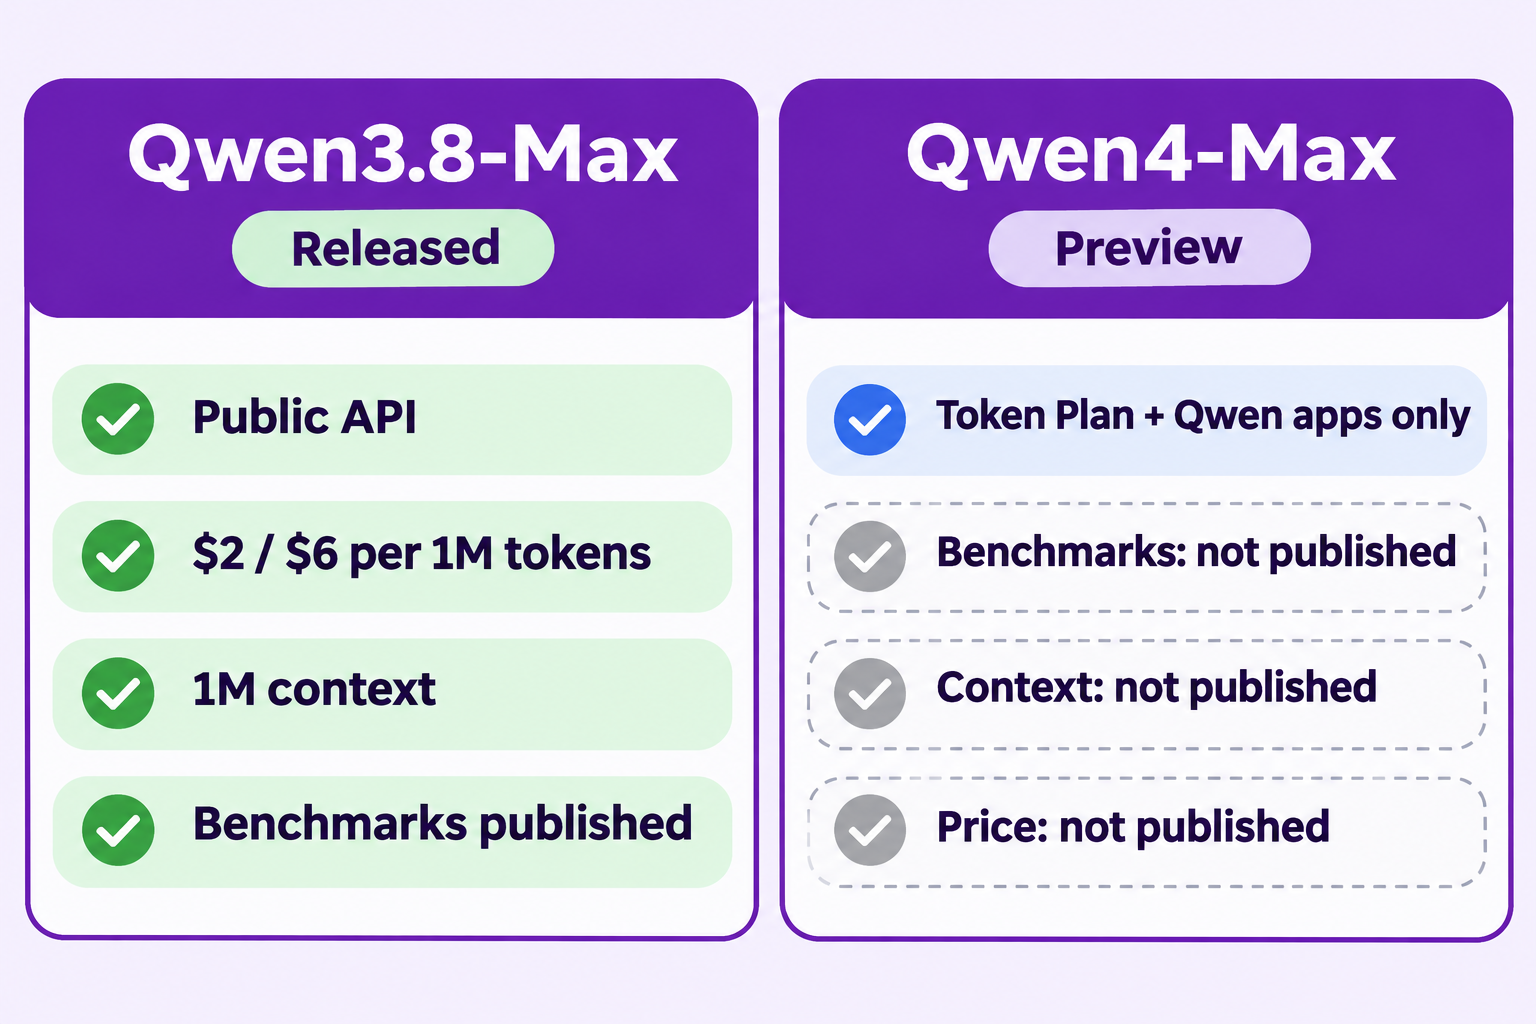
Qwen4-Max vs Qwen 3.8 สรุปได้ว่า: Qwen4-Max เป็นเวอร์ชันตัวอย่าง (preview) ที่ใช้ได้ผ่าน Token Plan ของ Alibaba และแอปของ Alibaba เท่านั้น โดยยังไม่มีการเผยแพร่ค่า benchmark ความยาว context หรือราคาต่อ token ส่วน Qwen3.8-Max เป็นโมเดลที่เปิดตัวแล้ว มี API สาธารณะในราคา $2/$6 ต่อ token ล้านตัว รองรับ context 1 ล้าน token และจำกัด output ที่ 131K ถ้าใช้งานจริงใน production ให้เลือก Qwen 3.8 ส่วน Qwen4-Max ให้ลองทดสอบกับงานของคุณเอง
นี่คือสถานการณ์ ณ วันที่ 11 พฤศจิกายน 2026 วันเดียวกับที่ทีม Qwen ของ Alibaba เปิดตัว Qwen4-Max ในรูปแบบ preview ด้านล่างนี้คือสิ่งที่เปลี่ยนไป สิ่งที่คุณตรวจสอบได้ สิ่งที่ยังตรวจสอบไม่ได้ และการทดสอบแบบลงมือทำจริง หากคุณยังไม่คุ้นเคยกับโมเดลทั้งสอง แนะนำให้เริ่มจากบทความ Qwen4-Max คืออะไร และ Qwen 3.8 คืออะไร
Qwen4-Max vs Qwen 3.8 แบบสรุปเร็ว
ข้อมูลทุกแถวมาจากหน้าเว็บของ Alibaba เอง ตรวจสอบเมื่อวันที่ 11 พฤศจิกายน 2026
| Qwen4-Max (preview) | Qwen3.8-Max | |
|---|---|---|
| สถานะ | Preview ประกาศเมื่อ 11 พ.ย. 2026 | เปิดตัวแล้ว ใช้งานได้ทั่วไปตั้งแต่สิงหาคม 2026 |
| Model ID | qwen4-max-preview (Token Plan) |
qwen3.8-max |
| API แบบจ่ายตาม token | ไม่มีข้อมูล | มี รองรับทั้งแบบ OpenAI และ Anthropic |
| ราคาต่อ token | ไม่มีข้อมูล | $2 input / $6 output ต่อ 1 ล้าน token |
| Context window | ไม่มีข้อมูล | 1 ล้าน token |
| Output สูงสุด | ไม่มีข้อมูล (ค่าเริ่มต้นของ Qwen Code: 32,768) | 131K token |
| อินพุตที่รองรับ | ข้อความและรูปภาพ (แท็กของ Token Plan) | ข้อความ รูปภาพ และวิดีโอ |
| จำนวนพารามิเตอร์ | ไม่มีข้อมูล | 2.4T รวม แบบ Mixture-of-Experts |
| Benchmark ทางการ | ไม่มี | มีตารางจากผู้ให้บริการตอนเปิดตัว |
| บน Token Plan | มี แท็ก “Limited-Time 80% Off” | มี แท็ก “40% Off Nights” |
แหล่งอ้างอิง: หน้าโมเดล Qwen3.8-Max และ หน้าราคา Token Plan Qwen4-Max ยังไม่มีหน้าโมเดล โดย URL คืนค่า 404 ตอนที่เราตรวจสอบ
Alibaba บอกว่า Qwen4-Max เปลี่ยนไปอย่างไร
ประกาศบน X เปิดด้วยประโยค “Qwen4 is coming” พร้อมระบุการปรับปรุง 4 ด้าน ซึ่งเป็นข้ออ้างของทีม Qwen ไม่ใช่ผลที่วัดจริง:
- ความรู้ที่ลึกซึ้งขึ้น ตอบคำถามหัวข้อเฉพาะทางได้ดีขึ้น
- ความเข้าใจโลกรอบตัวที่ดีขึ้น ให้เหตุผลเกี่ยวกับบริบทในโลกจริงได้ดีขึ้น
- ความสามารถด้าน coding และ agentic ที่แข็งแกร่งขึ้น วางแผน ใช้เครื่องมือ และทำงานหลายขั้นตอนได้ดีขึ้น
- สร้างมาเพื่องานในโลกจริง โพสต์ระบุถึง “งาน coding และงานด้านความรู้ที่ซับซ้อน” “การสร้าง front-end” และ “workflow ซอฟต์แวร์ระดับมืออาชีพ”
สังเกตว่าสิ่งเหล่านี้ใกล้เคียงกับจุดขายของ Qwen 3.8 มาก หน้าโมเดล Qwen3.8-Max ก็อธิบายไว้แล้วว่าเป็น “ก้าวกระโดดครบวงจรด้านการ coding และงานระดับมืออาชีพ” และโปรเจกต์อัตโนมัติที่ “ยาวนานกว่า 10 วัน” ทิศทางไม่ได้เปลี่ยน Qwen4-Max เพียงอ้างว่าเดินต่อบนถนนสายเดิมไปไกลกว่าเดิม โพสต์จบด้วยประโยค “ลองทดสอบกับปัญหาจริงดู” ซึ่งก็สมเหตุสมผล เพราะยังไม่มี spec sheet เผยแพร่เลย
สิ่งที่เปรียบเทียบได้จริงในวันนี้
ความแตกต่าง 5 ข้อที่ตรวจสอบได้ในตอนนี้
1. ระยะการเปิดตัว Qwen3.8-Max เป็นโมเดลที่เปิดตัวแล้ว มีเอกสาร rate limit (2,000,000 token ต่อนาที ตามหน้าโมเดล) ส่วน Qwen4-Max เป็น preview พฤติกรรม ข้อจำกัด หรือ ID อาจเปลี่ยนได้ก่อนเปิดตัวเต็มรูปแบบ
2. วิธีเรียกใช้ Qwen 3.8 รันบน API แบบ pay-as-you-go มาตรฐานของ Qwen Cloud จึงนำไปใช้หลัง production backend ได้ ส่วน Qwen4-Max ใช้ได้เฉพาะผ่าน endpoint ของ Token Plan และแอปของ Alibaba Token Plan FAQ ระบุว่าแพ็กเกจ Individual มีไว้สำหรับ “การพัฒนาแบบโต้ตอบส่วนบุคคลผ่านเครื่องมือที่กำหนด” และห้ามใช้ทำ automation สำหรับ production สคริปต์แบบ batch และงานตามกำหนดเวลาเบื้องหลัง
3. ความยาว output ในทางปฏิบัติ Qwen3.8-Max ระบุ output สูงสุด 131K สำหรับ Qwen4-Max ตัวเลขเดียวที่มีบันทึกคือค่าเริ่มต้นของ client: คู่มือตั้งค่า Qwen Code ระบุว่า qwen4-max-preview มีค่าเริ่มต้นของ output limit ที่ 32,768 token ซึ่งปรับเพิ่มได้ด้วย generationConfig.samplingParams.max_tokens ซึ่งเป็นค่าตั้งของเครื่องมือ ไม่ใช่เพดานของโมเดล
4. ประเภทอินพุต Token Plan ติดแท็ก Qwen4-Max เป็น Text Generation, Reasoning Model และ Visual Understanding ส่วนหน้าโมเดล Qwen3.8-Max ระบุรองรับข้อความ รูปภาพ และวิดีโอ
5. ฟีเจอร์ API Qwen3.8-Max มีเอกสารรองรับ function calling, structured outputs, context caching, batch files และ fine-tuning ส่วน Qwen4-Max ยังไม่มีเอกสารฟีเจอร์เหล่านี้เลย
สิ่งที่ยังเปรียบเทียบไม่ได้ในตอนนี้
การเปรียบเทียบ 4 ข้อที่คนอยากรู้ แต่ทำไม่ได้ ณ วันที่ 11 พฤศจิกายน 2026
- Benchmark Alibaba ไม่ได้เผยแพร่คะแนนของ Qwen4-Max สำหรับตัวเลขจากผู้ให้บริการของ Qwen 3.8 ดูได้ที่ วิเคราะห์ benchmark ของ Qwen 3.8 ของเรา
- Context window มีรายงานบางส่วนว่า Qwen4-Max มี context 1 ล้าน token แต่หน้าเว็บของ Alibaba ไม่ได้ระบุ และ deep dive ของ Kie.ai ระบุว่าตัวเลข 1M เป็นของ Qwen3.8-Max
- ราคาต่อ token ยังไม่มีรายการแบบ pay-as-you-go จึงไม่มีอะไรมาเทียบกับราคา $2/$6 ของ Qwen 3.8 Token Plan ก็ไม่ได้ระบุว่า request ไปยัง Qwen4-Max ใช้ Credits เท่าไร
- ขนาดและสถาปัตยกรรม Alibaba ยังไม่เผยแพร่จำนวนพารามิเตอร์ของ Qwen4-Max Qwen3.8-Max เป็นโมเดล Mixture-of-Experts ขนาด 2.4T พารามิเตอร์
ให้ถือว่าบทความใดที่เติมช่องเหล่านี้เป็นการคาดเดา สำหรับรายละเอียดการเข้าถึง ดูที่ วิธีใช้ Qwen4-Max
การเข้าถึงและราคา: Qwen4-Max vs Qwen 3.8
Token Plan เป็นแพ็กเกจเดียวที่มีทั้งสองโมเดล ณ วันที่ 11 พฤศจิกายน 2026 หน้าเว็บภูมิภาคสิงคโปร์แสดงราคารายเดือนของแพ็กเกจ Individual เป็นดอลลาร์สหรัฐดังนี้:
| แพ็กเกจ | ราคาช่วง event | ราคาปกติ | Credits ต่อเดือน | Agents พร้อมกัน |
|---|---|---|---|---|
| Lite | $3.00 | $8.00 | 20,000 | 1-2 |
| Essential | $5.00 | $16.00 | 45,000 | 2-3 |
| Standard | $18.00 | $25.00 | 80,000 | 3-4 |
| Pro | $43.00 | $51.00 | 200,000 | 6-8 |
ราคาช่วง event มีไว้สำหรับลูกค้าใหม่ และหน้าเว็บระบุว่าราคาสุดท้ายคือราคาที่แสดงตอน checkout หลังล็อกอิน ทั้งสองโมเดลใช้ Credits จากพูลเดียวกัน qwen4-max-preview ติดแท็ก “Limited-Time 80% Off” และ qwen3.8-max ติดแท็ก “40% Off Nights”
Qwen 3.8 มีตารางราคาแบบ pay-as-you-go เต็มรูปแบบ: $2 input, $6 output, $0.25 สำหรับ cache hit แบบ implicit และ $1 / $3 สำหรับ batch files ต่อ token ล้านตัว สำหรับการคำนวณต้นทุน Qwen 3.8 แบบเต็ม อ่าน คู่มือ Qwen 3.8 API ของเรา
สำหรับ backend ที่เรียกใช้โมเดล Qwen 3.8 เป็นตัวเลือกเดียวจากทั้งสอง ส่วนการเขียนโค้ดกับ agent Token Plan ให้คุณลองใช้ทั้งคู่ได้ในสมัครสมาชิกเดียว
ทำการทดสอบ Qwen4-Max vs Qwen 3.8 ด้วยตัวเอง
เมื่อไม่มี benchmark ทางการ การทดสอบของคุณเองคือหลักฐานที่ดีที่สุด งานด้าน API เหมาะมาก เพราะ endpoint ผ่านการทดสอบหรือไม่ก็ผ่าน ไม่มีก้ำกึ่ง
config ตัวอย่างในคู่มือ Qwen Code มีทั้งสองโมเดลอยู่บน endpoint Token Plan เดียวกันแล้ว การสลับระหว่างกันจึงเป็นแค่การเลือกจากเมนู:
{
  "$version": 4,
  "env": { "QWENCLOUD_TOKEN_PLAN_API_KEY": "YOUR_API_KEY" },
  "modelProviders": {
    "openai": [
      { "id": "qwen4-max-preview", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" },
      { "id": "qwen3.8-max", "baseUrl": "https://token-plan.maas.qwencloudapi.com/compatible-mode/v1", "envKey": "QWENCLOUD_TOKEN_PLAN_API_KEY" }
    ]
  }
}
นำไปวางไว้ที่ ~/.qwen/settings.json แล้วจัดการทดสอบที่เป็นธรรม:
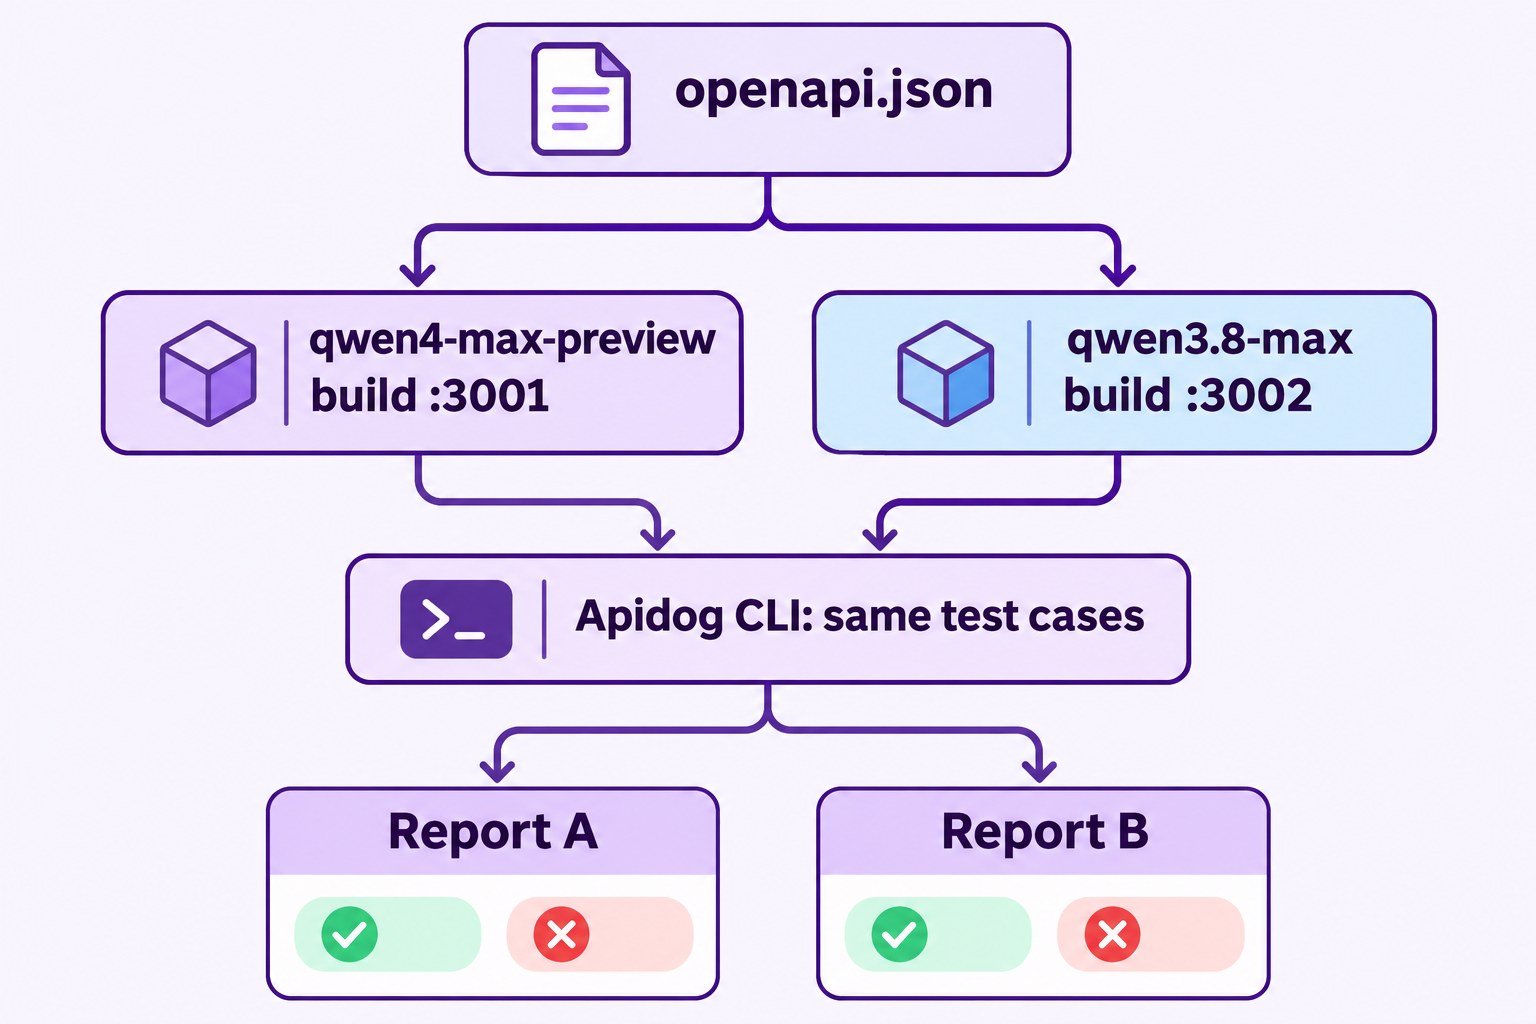
- เขียน contract เพียงครั้งเดียว สร้าง
openapi.jsonหนึ่งไฟล์สำหรับ API เล็ก ๆ เช่นPOST /ordersและGET /orders/{id}พร้อมกฎ validation และ auth ไม่มีโมเดลไหนเขียน spec เอง จึงไม่มีโมเดลไหนตรวจงานตัวเอง - สร้างโฟลเดอร์เปล่าสองโฟลเดอร์ ชื่อ
build-qwen4และbuild-qwen38ใส่สำเนา spec ไว้ในแต่ละโฟลเดอร์ - ส่ง prompt สร้างงานแบบเดียวกัน ในทั้งสองโฟลเดอร์ โดยเลือก
qwen4-max-previewในโฟลเดอร์หนึ่ง และqwen3.8-maxในอีกโฟลเดอร์: “Implement the API in openapi.json with Express. Run it on port 3001 (or 3002). Don’t change the spec.” - บันทึกข้อมูลพื้นฐาน: เวลาจนถึงตอน server รันได้ ไฟล์ที่เขียน และว่าคุณต้องเข้ามาช่วยหรือไม่
แล้วทดสอบผลงานทั้งสองกับ test suite เดียวกัน ตรงนี้แหละที่ Apidog CLI เข้ามามีบทบาท
ให้คะแนนผลงานทั้งสองด้วย Apidog CLI
coding agent ของคุณจะควบคุม Apidog CLI: นำเข้า spec ที่ใช้ร่วมกัน สร้างชุด test case จากมัน แล้วรันชุดนั้นกับผลงานทั้งสอง การทดสอบชุดเดียว สองเป้าหมาย สองรายงาน
ติดตั้ง Apidog CLI เพียงครั้งเดียว
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install สอน agent ของคุณให้ใช้ CLI คู่มือการติดตั้ง อธิบายเรื่อง token
สั่ง agent ของคุณด้วย prompt เดียว
agent ตัวไหนก็ทำหน้าที่กรรมการได้ ไม่จำเป็นต้องเป็นโมเดลของ Qwen
Import ./openapi.json into Apidog project <projectId>. Create two environments:
qwen4 at http://localhost:3001 and qwen38 at http://localhost:3002. From the spec,
create test cases for POST /orders: 201 on a valid order, 400 on a missing
customerId, 401 without a token, plus a GET /orders/{id} 404 case. Run every case
against both environments, save JSON reports, and give me a pass/fail table per model.
Don't modify either build.
คำสั่ง apidog ที่ agent รัน
ทุก flag ด้านล่างมาจาก apidog <command> --help บน Apidog CLI 2.2.12:
apidog import --project <projectId> --format openapi --file ./openapi.json
apidog environment create qwen4 --project <projectId> --base-url http://localhost:3001
apidog environment create qwen38 --project <projectId> --base-url http://localhost:3002
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case-201.json
apidog test-case create --project <projectId> --file ./case-201.json
apidog run --test-case <caseId> --project <projectId> -e <qwen4EnvId> -r cli,json --out-file qwen4-{GENERATE_TIME}
apidog run --test-case <caseId> --project <projectId> -e <qwen38EnvId> -r cli,json --out-file qwen38-{GENERATE_TIME}
cli-schema get ส่งรูปแบบ JSON ที่แน่นอนของ test case ให้ agent และ cli-schema validate ตรวจแต่ละไฟล์ก่อนเขียนอะไรลงไป agent จะทำซ้ำ test-case create และคำสั่ง apidog run สองบรรทัดสำหรับแต่ละ case reporter แบบ cli จะแสดงสรุปผ่าน/ไม่ผ่าน และ json จะบันทึกรายงานไว้ใน apidog-reports ซึ่ง agent จะอ่านเพื่อสร้างตาราง เพิ่ม --upload-report เพื่อดูผลการรันในแอป Apidog
สิ่งที่ควรดูจากรายงาน
นับสามสิ่งต่อโมเดล: case ที่ผ่านตั้งแต่ build แรก จำนวนรอบแก้บั๊กจนกว่าจะเขียวทุกอัน และ case ที่โมเดลเปลี่ยน contract แทนที่จะเปลี่ยนโค้ด รันทั้งหมดสองถึงสามรอบ เพราะการรันครั้งเดียวกับโมเดล preview ไม่บอกอะไรมากนัก สำหรับรูปแบบที่ขับเคลื่อนด้วย agent เพิ่มเติม ดูที่ Apidog CLI agent workflow และ Apidog CLI ใน Claude Code แผน Free ของ Apidog รองรับผู้ใช้สูงสุด 4 คน
วันนี้ควรใช้ตัวไหน?
เลือกโมเดลให้ตรงกับงาน:
- แอปหรือ backend สำหรับ production: Qwen 3.8 มี API สาธารณะ ราคาที่เผยแพร่ และข้อจำกัดที่มีเอกสารกำกับ กฎของ Token Plan ทำให้ Qwen4-Max ใช้ที่นี่ไม่ได้
- เขียนโค้ดกับ agent: ลองทั้งคู่บน Token Plan รันการทดสอบข้างต้นกับงานจาก backlog จริงของคุณ ไม่ใช่งานทดลองเล่น
- การตัดสินใจที่ต้องมีตัวเลข: รอก่อน benchmark ความยาว context และราคาของ Qwen4-Max ยังไม่ออก
เก็บ model ID ไว้ในค่า config เดียว เพื่อให้เปลี่ยนเป็น ID ของ Qwen4-Max ตัวเต็มได้ด้วยการแก้บรรทัดเดียว ดูเพิ่มเติมที่ Qwen 3.8 สำหรับการเขียนโค้ด และ คู่มือโมเดล Qwen ที่ดีที่สุด ของเรา
FAQ
Qwen4-Max ดีกว่า Qwen 3.8 หรือไม่? Alibaba บอกว่ามีความรู้ลึกกว่าและทักษะ coding และ agentic แข็งแกร่งกว่า แต่ยังไม่ได้เผยแพร่ benchmark ยังไม่มีข้อมูลทางการยืนยัน จึงควรทดสอบทั้งคู่กับงานของคุณเอง
เรียกใช้ Qwen4-Max ผ่าน API แบบเดียวกับ Qwen 3.8 ได้ไหม? ไม่ได้ในรูปแบบ pay-as-you-go Qwen4-Max ใช้ได้ผ่าน endpoint ของ Token Plan ด้วย ID qwen4-max-preview สำหรับใช้งานแบบโต้ตอบในเครื่องมือเขียนโค้ด ส่วน Qwen3.8-Max (qwen3.8-max) มี API มาตรฐาน
Qwen4-Max มี context 1 ล้าน token เหมือน Qwen 3.8 หรือไม่? Alibaba ยังไม่ได้ระบุ Qwen3.8-Max มี context 1M ตามเอกสาร ส่วนตัวเลข 1M ของ Qwen4-Max มาจากรายงานของบุคคลที่สามเท่านั้น
Qwen4-Max ราคาเท่าไรเทียบกับ Qwen 3.8? Qwen 3.8 ราคา $2 input และ $6 output ต่อ token ล้านตัว Qwen4-Max ยังไม่มีราคาต่อ token ผ่าน Token Plan ทั้งคู่ใช้พูล Credits ร่วมกันในแพ็กเกจเริ่มต้น $3 (ราคา event ของ Lite, ราคาปกติ $8) ต่อเดือน
ควรย้ายแอปของฉันจาก Qwen 3.8 ไป Qwen4-Max หรือไม่? ยังไม่ควร โมเดล preview อาจเปลี่ยนโดยไม่แจ้งล่วงหน้า และ Token Plan ห้ามใช้ทำ automation สำหรับ production ให้คง Qwen 3.8 ไว้ใน production และรัน Qwen4-Max ควบคู่กันในสภาพแวดล้อม development