
ราคา Qwen4-Max บน API แบบจ่ายตามโทเคนของ QwenCloud อยู่ที่ $1.50 ต่อโทเคนอินพุต 1 ล้านตัว และ $4.50 ต่อโทเคนเอาต์พุต 1 ล้านตัว ในภูมิภาคสิงคโปร์ โดยอินพุตแบบแคชอยู่ที่ $0.075 ต่อ 1 ล้าน โหมด thinking และ non-thinking ราคาเท่ากัน และไม่มีการแบ่งชั้นราคาตามความยาวอินพุต หากคุณต้องการจ่ายค่าบริการรายเดือนแบบเหมาจ่ายสำหรับเครื่องมือเขียนโค้ด โมเดลตัวนี้ก็มีอยู่บน Token Plan เริ่มต้นที่ $6 ต่อเดือน
เนื้อหาด้านล่างนี้ประกอบด้วย: ตารางราคา ต้นทุนจริงของงานต่างๆ การประหยัดจากแคช การเปรียบเทียบ Token Plan กับการจ่ายตามโทเคน และราคาของคู่แข่ง หากคุณยังไม่คุ้นเคยกับโมเดลนี้ เริ่มต้นได้ที่ Qwen4-Max คืออะไร
ราคา API ของ Qwen4-Max ต่อโทเคน 1 ล้านตัว
Qwen4-Max คิดค่าบริการต่อโทเคน 1 ล้านตัว โดยแยกอัตราราคาสำหรับอินพุต เอาต์พุต การเขียนแคช และการอ่านแคช เอาต์พุตครอบคลุมทั้งโทเคนสำหรับการให้เหตุผล ("thinking") และคำตอบ Alibaba เผยแพร่ตารางราคาแยกระหว่างคอลัมน์สิงคโปร์ (International) กับคอลัมน์ปักกิ่ง/Global ที่ราคาต่ำกว่า
| รายการค่าบริการ (ต่อโทเคน 1 ล้านตัว) | สิงคโปร์ (International) | ปักกิ่ง / Global |
|---|---|---|
| อินพุต | $1.50 | $1.413 |
| เอาต์พุต (thinking + คำตอบ) | $4.50 | $4.24 |
| เขียนแคช TTL 5 นาที | $1.875 | $1.767 |
| เขียนแคช TTL 1 ชั่วโมง | $3.00 | $2.827 |
| อ่านแคช (hit แบบ explicit หรือ implicit) | $0.075 | $0.071 |
ที่มา: เอกสารราคาของ QwenCloud และหน้าโมเดล Qwen4-Max โดยตรวจสอบทั้งสองแหล่งเมื่อวันที่ 16 พฤศจิกายน 2026 เอกสารระบุว่าการดีพลอยแบบ Global อยู่ที่แฟรงก์เฟิร์ต ฮ่องกง โตเกียว และสหรัฐฯ (เวอร์จิเนีย)
กฎสำคัญบางข้อที่มีผลต่อค่าใช้จ่าย:
- โทเคน thinking นับเป็นเอาต์พุต เมื่อเปิด
enable_thinkingโทเคนการให้เหตุผลทุกตัวจะถูกคิดค่าบริการที่ $4.50 ต่อ 1 ล้าน - ไม่มีค่าบริการเพิ่มสำหรับ context ยาว คำขอขนาด 900K โทเคนมีราคาต่อโทเคนเท่ากับคำขอขนาด 9K
- การอ่านแคชราคาเท่ากับ 5% ของราคาอินพุต $0.075 เทียบกับ $1.50 คือส่วนลด 95% สำหรับ prefix ที่ใช้ซ้ำ
- ขีดจำกัดต่างๆ: context 1 ล้านโทเคน อินพุตสูงสุด 991K (983K เมื่อเปิด thinking) เอาต์พุตสูงสุด 393K และ 5,000,000 โทเคนต่อนาที
model id คือ qwen4-max หากคุณยังไม่เคยเรียกใช้งาน ไกด์Qwen4-Max API ของเราอธิบายเรื่อง API key, base URL และ request แรกของคุณ
งานจริงหนึ่งงานบน Qwen4-Max มีค่าใช้จ่ายเท่าไร
ราคาต่อโทเคนเป็นตัวเลขที่คนทั่วไปรู้สึกได้ยาก Alibaba ให้ตัวเลขที่จับต้องได้หนึ่งตัวในโพสต์เปิดตัว: ใน benchmark Work360 agent ของบริษัท ต้นทุนเฉลี่ยต่องานลดลงจาก $4.43 บน Qwen3.8-Max เหลือ $1.67 บน Qwen4-Max ลดลง 62% Alibaba ยังรายงานว่า Qwen4-Max ใช้โทเคนน้อยลงราว 24% ที่ระดับความพยายาม Xhigh และน้อยลงราว 35% ที่ระดับ High บน Work360 ซึ่งเป็นตัวเลขจากผู้ให้บริการเอง จึงควรมองว่าเป็นแนวโน้ม ไม่ใช่ใบเสนอราคาสำหรับ workload ของคุณ
คุณสามารถประมาณค่าใช้จ่ายของตัวเองได้ด้วยคณิตศาสตร์ง่ายๆ นี่คือสามตัวอย่างที่คำนวณตามราคาหน้าชีตของสิงคโปร์:
- การแชทสั้นๆ อินพุต 2,000 โทเคน เอาต์พุต 500 โทเคน: 2,000 x $1.50/1M + 500 x $4.50/1M = $0.003 + $0.00225 = $0.0053 หรือราว $5.25 ต่อการเรียก 1,000 ครั้ง
- การเรียกเดียวกันแต่เปิด thinking สมมติว่าโมเดลให้เหตุผล 6,000 โทเคนก่อนตอบ 500 โทเคน เอาต์พุตจะกลายเป็น 6,500 โทเคน การเรียกครั้งนี้จึงมีค่าใช้จ่าย $0.003 + $0.02925 = $0.032 สูงขึ้นราวหกเท่า
- คำถามจากเอกสารยาว อินพุต 300,000 โทเคน เอาต์พุต 2,000 โทเคน: $0.45 + $0.009 = $0.459 หากไม่มีแคช หรือราว $0.032 หากเอกสาร 300K นั้นเป็น cache hit
ตัวอย่างที่ 2 เป็นสิ่งที่หลายคนไม่คาดคิด: การให้เหตุผลสามารถกินค่าใช้จ่ายเป็นส่วนใหญ่ได้ แม้คำตอบจะสั้นก็ตาม สำหรับตัวเลขเชิงลึกเรื่องคุณภาพต่อดอลลาร์ ดูได้ที่วิเคราะห์ benchmark ของ Qwen4-Max
อัตราค่าแคชเปลี่ยนค่าบิลของ Qwen4-Max อย่างไร
Context caching คือจุดที่ราคาของ Qwen4-Max เปลี่ยนแปลงมากที่สุด QwenCloud มีให้สองโหมดสำหรับ qwen4-max บน API แบบจ่ายตามโทเคน และบน Chat Completions, DashScope และ API ที่รองรับ Anthropic ทั้งสองโหมดนี้ใช้ร่วมกันไม่ได้ในหนึ่ง request
| โหมด | วิธีทำงาน | ราคา | รับประกันว่า hit? |
|---|---|---|---|
| Implicit cache | อัตโนมัติ ปิดไม่ได้ นำ prefix ทั่วไปที่ยาว 1,024 โทเคนขึ้นไปมาใช้ซ้ำ | $0.075 ต่อ 1 ล้าน เมื่อ hit | ไม่ ความถูกต้องไม่แน่นอน |
| Explicit cache | คุณกำหนดจุด breakpoint ด้วย cache_control |
เขียน $1.875 (5 นาที) หรือ $3 (1 ชม.) อ่าน $0.075 | ใช่ ตราบใดที่แคชยังไม่หมดอายุ |
เอกสาร context cache ระบุว่าแคช explicit แบบ 5 นาทีจะรีเซ็ตตัวจับเวลาทุกครั้งที่มีการ hit ดังนั้น agent loop ที่ทำงานต่อเนื่องจะทำให้แคชยังอุ่นอยู่
ลองดูตัวอย่าง agent session หนึ่งอัน: system prompt ขนาด 200K โทเคนบวกคำนิยามเครื่องมือและ context ของ repo ใช้ซ้ำตลอด 50 เทิร์น โดยแต่ละเทิร์นมีอินพุตใหม่ 2K และเอาต์พุต 3K
- ไม่มี cache hit เลย: อินพุต 10.1M โทเคน x $1.50 + เอาต์พุต 150K x $4.50 = $15.83
- มี implicit cache hit ตั้งแต่เทิร์นที่ 2: 202K แรกเต็มราคา ($0.30), โทเคนแบบแคช 9.8M ที่ $0.075 ($0.74), โทเคนใหม่ 98K ($0.15) และเอาต์พุต ($0.68) = $1.86
- Explicit cache แบบ 5 นาที: เขียนแคช $0.375 แทน prefix ราคาเต็มครั้งแรก ส่วนการอ่านและเอาต์พุตเท่าเดิม = ราว $1.94 โดยได้รับประกันว่าจะ hit
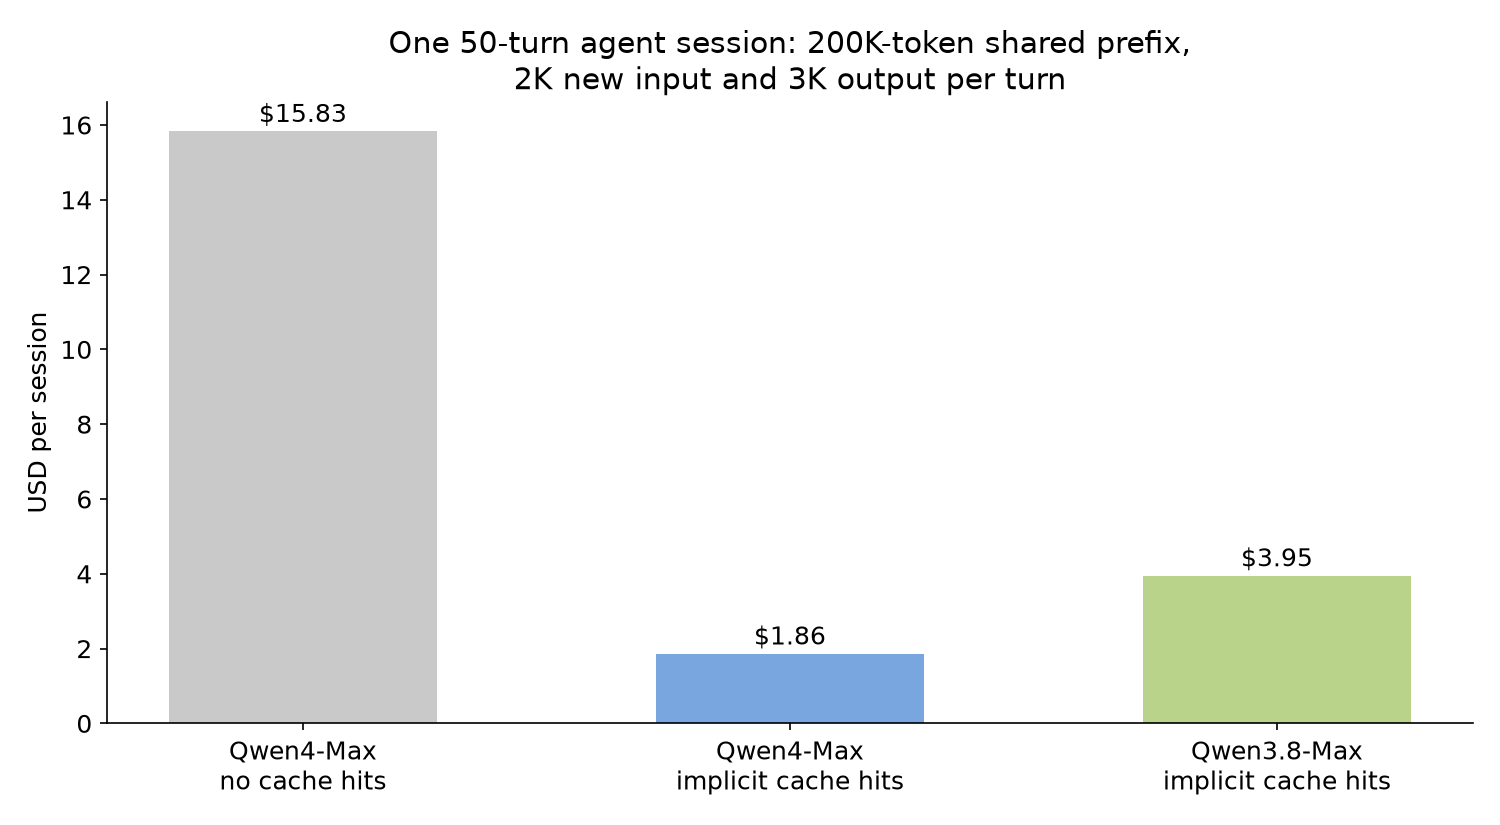
session เดียวกันบน Qwen3.8-Max ที่อัตราอินพุต $2, implicit-cache $0.25 และเอาต์พุต $6 มีค่าใช้จ่าย $3.95 นี่คือจุดที่ข้ออ้างของ Alibaba เรื่อง "การลดราคาอินพุตแบบแคชมากที่สุด" ปรากฏชัด: Qwen3.8-Max คิด $0.25 ต่อ implicit hit ขณะที่ Qwen4-Max คิดเพียง $0.075
ใช้ explicit caching เมื่อคุณต้องการการ hit ที่คาดการณ์ได้ และใช้ implicit caching สำหรับกรณีอื่นทั้งหมด ตรวจสอบผลลัพธ์ที่ได้ใน usage.prompt_tokens_details.cached_tokens และ cache_creation_input_tokens หากกำลังพิจารณาเศรษฐศาสตร์ของแคชเทียบหลายผู้ให้บริการ บทความการคำนวณ prompt caching ของ Claude Opus 5.5 ของเราใช้วิธีการเดียวกัน
Qwen4-Max มีส่วนลดแบบ Batch หรือไม่
มี แต่ใช้ได้เฉพาะในภูมิภาคเดียว Batch API ของ QwenCloud โดยปกติคิดค่าอินพุตและเอาต์พุตที่ 50% ของราคาแบบ real-time สำหรับ qwen4-max เอกสาร batch ระบุไว้เฉพาะภายใต้ China North 2 (ปักกิ่ง) ที่ อินพุต $0.707 และเอาต์พุต $2.12 ต่อโทเคน 1 ล้านตัว สำหรับ Batch File ส่วน Batch Chat ในปักกิ่งระบุไว้ที่ $1.413 / $4.24
Batch ไม่รองรับ context caching ไม่ใช้ร่วมกับส่วนลดอื่น และไม่อยู่ในโควตาฟรี หากมีอัตรา cache hit สูง API แบบ real-time อาจถูกกว่า batch ได้
Qwen4-Max: จ่ายตามโทเคน vs Token Plan
Token Plan คือแพ็กเกจรายเดือนของ QwenCloud สำหรับเครื่องมือเขียนโค้ดและ agent เช่น Claude Code, Cursor, Qwen Code, Codex และ Qoder โดยคิดค่าบริการเป็น Credits ไม่ใช่โทเคน และใช้ API key แบบ sk-sp- เฉพาะของตัวเอง qwen4-max อยู่ในรายการโมเดลที่รองรับ แพ็กเกจรายบุคคล ตามเอกสาร Token Plan ณ วันที่ 16 พฤศจิกายน 2026:
| แพ็กเกจ | ราคาต่อเดือน | Credits ต่อเดือน | Agent ที่ทำงานพร้อมกัน |
|---|---|---|---|
| Lite | $6 ($3 ราคาพิเศษช่วงจำกัดสำหรับผู้ใช้ใหม่) | 20,000 | 1-2 |
| Essential | $10 ($5 ราคาพิเศษช่วงจำกัดสำหรับผู้ใช้ใหม่) | 45,000 | 2-3 |
| Standard | $18 | 80,000 | 3-4 |
| Pro | $43 | 200,000 | 6-8 |
Credit Pack เพิ่มเติมราคา $15 สำหรับ 20,000 Credits (ซื้อได้สูงสุดครั้งละ 5 แพ็ก) เมื่อ Credits หมด การเรียกใช้งานจะถูกบล็อก และจะไม่สลับไปคิดแบบจ่ายตามโทเคน
วิธีเลือก:
- เลือก Token Plan หากคุณเป็นคนเดียวที่ใช้โมเดลผ่าน coding agent ทุกวัน และต้องการค่าใช้จ่ายรายเดือนที่คงที่
- เลือกจ่ายตามโทเคน สำหรับผลิตภัณฑ์ งาน backend, batch, fine-tuning หรือทราฟฟิกที่ผันผวน คุณจ่ายเท่าที่ใช้ และยังคงได้ขีดจำกัด 5,000,000 TPM
จำนวน Credits ต่อ request ของ Qwen4-Max ไม่ได้เป็นอัตราส่วนคงที่กับโทเคน จึงควรตรวจสอบใน console หลังใช้งานจริงหนึ่งวัน เราพูดถึงแพ็กเกจนี้อย่างละเอียด รวมถึงว่า Credits คุ้มใช้แค่ไหน ในบทความ Qwen4-Max Token Plan: ค่าใช้จ่ายเท่าไรและคุ้มค่าหรือไม่
ราคา Qwen4-Max เทียบกับ Qwen3.8-Max และโมเดลเรือธงคู่แข่ง
Qwen4-Max ถูกกว่ารุ่นก่อนหน้าทั้งด้านอินพุต เอาต์พุต การอ่านแคช และการเขียนแคชแบบ 5 นาที (Qwen3.8-Max ระบุราคาเขียนแคชไว้ที่ $2.50 เพียงราคาเดียว ส่วนการเขียนแบบ 1 ชั่วโมงของ Qwen4-Max อยู่ที่ $3) นี่คือตำแหน่งของมันเทียบกับโมเดลเรือธงอื่นๆ ที่ราคาหน้าชีตมาตรฐาน โดยตรวจสอบจากหน้าของผู้ให้บริการแต่ละรายเมื่อวันที่ 16 พฤศจิกายน 2026
| โมเดล | อินพุต / 1M | อินพุตแบบแคช / 1M | เอาต์พุต / 1M |
|---|---|---|---|
| Qwen4-Max (สิงคโปร์) | $1.50 | $0.075 | $4.50 |
| Qwen3.8-Max | $2.00 | $0.25 (implicit), $0.17 (explicit read) | $6.00 |
| DeepSeek V4 Pro (ช่วงพีค / นอกพีค) | $1.32 / $0.66 | $0.044 / $0.022 | $3.96 / $1.98 |
| OpenAI gpt-5.6-sol | $4.00 | $0.40 | $20.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
ที่มา: หน้าโมเดล Qwen3.8-Max, ราคา DeepSeek, ราคา OpenAI API และ ราคา Claude
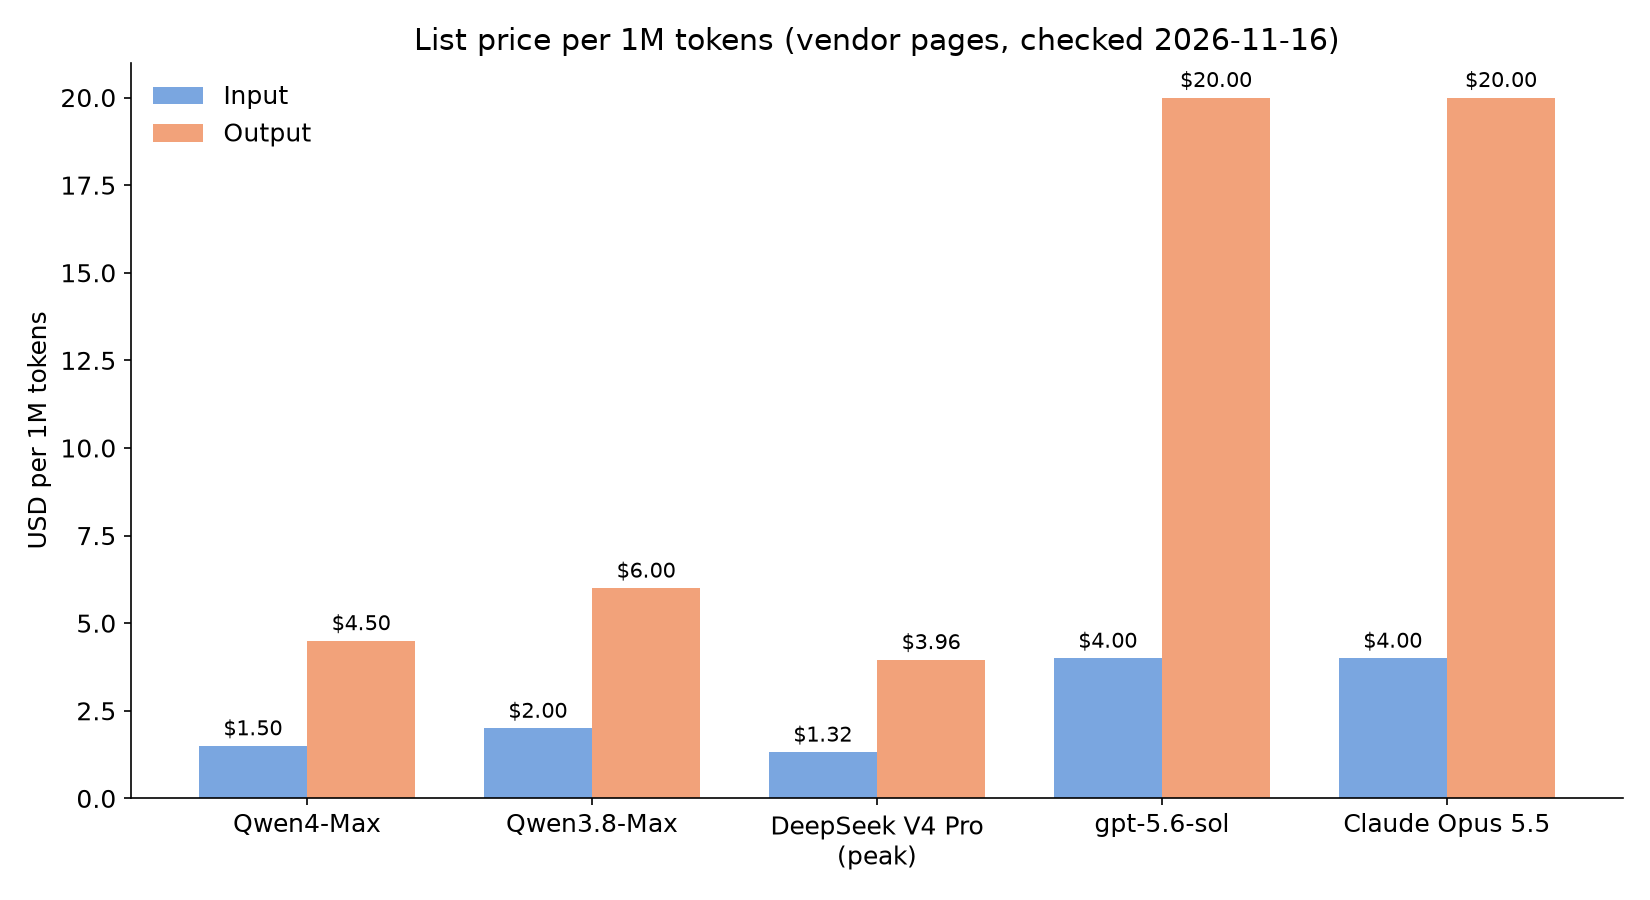
สำหรับงาน agent เอาต์พุตมักเป็นก้อนค่าใช้จ่ายที่ใหญ่ที่สุด และเอาต์พุต $4.50 ของ Qwen4-Max ต่ำกว่าราคา $20 ของ gpt-5.6-sol และ Claude Opus 5.5 อย่างชัดเจน DeepSeek V4 Pro ถูกกว่าต่อโทเคน โดยเฉพาะช่วงนอกเวลาพีค ส่วนต้นทุนต่องานที่เสร็จสมบูรณ์ขึ้นอยู่กับจำนวนโทเคนที่แต่ละโมเดลใช้กับ workload ของคุณ สำหรับรายละเอียดฝั่ง Qwen3.8-Max ดูได้ที่ไกด์ราคา Qwen 3.8 และการเปรียบเทียบ Qwen4-Max กับ Qwen 3.8
ให้ coding agent ของคุณวัดค่าใช้จ่าย Qwen4-Max ด้วย Apidog CLI
การประมาณค่าใช้จ่ายที่เชื่อถือได้เพียงวิธีเดียวคือการวัด usage จาก prompt ของคุณเอง ให้ coding agent ของคุณ (Claude Code, Codex, Cursor หรือตัวอื่นที่คล้ายกัน) สร้างและรันการตรวจสอบนี้ด้วย Apidog CLI ตั้งค่าครั้งเดียวดังนี้:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
จากนั้นสั่ง agent ของคุณด้วย prompt เดียว:
In Apidog project <projectId>, create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable for my DashScope API key. Add a POST /chat/completions endpoint for model
qwen4-max and two test cases: one with enable_thinking true, one false. Assert
status 200, a non-empty choices array and a usage object. Run both and report
prompt_tokens, completion_tokens and cached_tokens side by side.
Agent จะตรวจสอบรูปแบบ payload แต่ละอันกับ CLI schema ก่อนเขียนอะไรก็แล้วแต่ จากนั้นรัน test case:
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-thinking.json
apidog test-case create --project <projectId> --file case-thinking.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
เทียบตัวเลข completion_tokens ของทั้งสองกรณีแล้วคูณด้วย $4.50 ต่อ 1 ล้าน นั่นคือค่าเพิ่มจาก thinking ที่คำนวณจาก prompt ของคุณเอง เพิ่ม --upload-report ในคำสั่ง apidog run เพื่อดูผลการรันในแอป Apidog หรือนำคำสั่งเดียวกันไปใส่ใน CI ด้วย -r junit ตามที่แสดงไว้ในบทความการรัน Apidog CLI ใน CI/CD ยังไม่เคยใช้ CLI? ไกด์ติดตั้ง Apidog CLI และ Apidog CLI ใน Codex จะทำให้คุณเริ่มใช้งานได้ในไม่กี่นาที แพ็กเกจ Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน
คำถามที่พบบ่อย
Qwen4-Max มีราคาต่อโทเคน 1 ล้านตัวเท่าไร? อินพุต $1.50 และเอาต์พุต $4.50 ในภูมิภาคสิงคโปร์ โดยการอ่านแคชอยู่ที่ $0.075 ส่วนคอลัมน์ปักกิ่ง/Global ต่ำกว่าเล็กน้อยที่ $1.413 และ $4.24
โหมด thinking ของ Qwen4-Max แพงกว่าหรือไม่? อัตราราคาเท่ากัน แต่โทเคนการให้เหตุผลถูกคิดเป็นเอาต์พุตที่ $4.50 ต่อ 1 ล้าน ดังนั้นการให้เหตุผลที่ยาวจะทำให้ต้นทุนต่อการเรียกเพิ่มขึ้นหลายเท่า
Qwen4-Max ถูกกว่า Qwen3.8-Max หรือไม่? ใช่ อินพุตลดจาก $2 เหลือ $1.50 เอาต์พุตจาก $6 เหลือ $4.50 และ implicit cache hit จาก $0.25 เหลือ $0.075 ต่อโทเคน 1 ล้านตัว Alibaba ยังรายงานด้วยว่าต้นทุนต่องานบน Work360 ลดจาก $4.43 เหลือ $1.67
ใช้ Qwen4-Max ฟรีได้หรือไม่? QwenCloud มอบโควตาฟรีสำหรับโมเดลใหม่ในภูมิภาคสิงคโปร์ โดยทั่วไปคือ 1 ล้านโทเคนที่ใช้ได้ 90 วัน หลังจากคุณเพิ่มข้อมูลการชำระเงินแล้ว ตรวจสอบหน้า Free Tier ใน console สำหรับ qwen4-max และดูไกด์การใช้ Qwen4-Max ฟรี ของเราสำหรับทุกช่องทางที่ได้ $0
Qwen4-Max รองรับราคาแบบ batch หรือไม่? รองรับเฉพาะภูมิภาคปักกิ่ง: Batch File อยู่ที่อินพุต $0.707 และเอาต์พุต $2.12 ต่อโทเคน 1 ล้านตัว โดยไม่มี context caching
ควรเลือก Token Plan หรือจ่ายตามโทเคนสำหรับ Qwen4-Max? Token Plan เหมาะกับผู้ใช้คนเดียวที่ใช้เครื่องมือเขียนโค้ดทุกวัน เริ่มต้นที่ $6 ต่อเดือน ส่วนการจ่ายตามโทเคนเหมาะกับแอป งาน backend และงาน batch