
สรุปผล benchmark ของ Qwen4-Max ในบรรทัดเดียว: จากกราฟของ Alibaba Qwen4-Max ทำคะแนนดีกว่า Qwen3.8-Max ในทุกการทดสอบ 15 รายการที่ทั้งสองโมเดลปรากฏอยู่ และติดอันดับ 1 โดยรวมใน 4 จาก 16 รายการ แต่ตัวเลขส่วนใหญ่มาจากการทดสอบที่ Alibaba รันเอง บน Work360 ทำคะแนนได้ 52.69 เทียบกับ 47.74 และต้นทุนเฉลี่ยต่องานลดลงจาก $4.43 เหลือ $1.67
Benchmark จะมีประโยชน์เพียงแค่คำตอบของคำถามว่า “ใครรัน และรันอย่างไร” คู่มือนี้ครอบคลุมคะแนนทุกตัวที่ Alibaba เผยแพร่เมื่อวันที่ 16 พฤศจิกายน 2026 แยกออกเป็นแบบรายงานเอง (self-reported) และของบุคคลที่สาม และปิดท้ายด้วยวิธีทดสอบด้วยตัวเองผ่าน Qwen4-Max API สำหรับพื้นฐาน เริ่มจาก Qwen4-Max คืออะไร และ วิธีเข้าถึง
คะแนน benchmark ของ Qwen4-Max แบบสังเขป
โพสต์เปิดตัว ของ Alibaba เปรียบเทียบ Qwen4-Max กับ Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra และ Kimi K3.1 ใน benchmark 16 รายการ
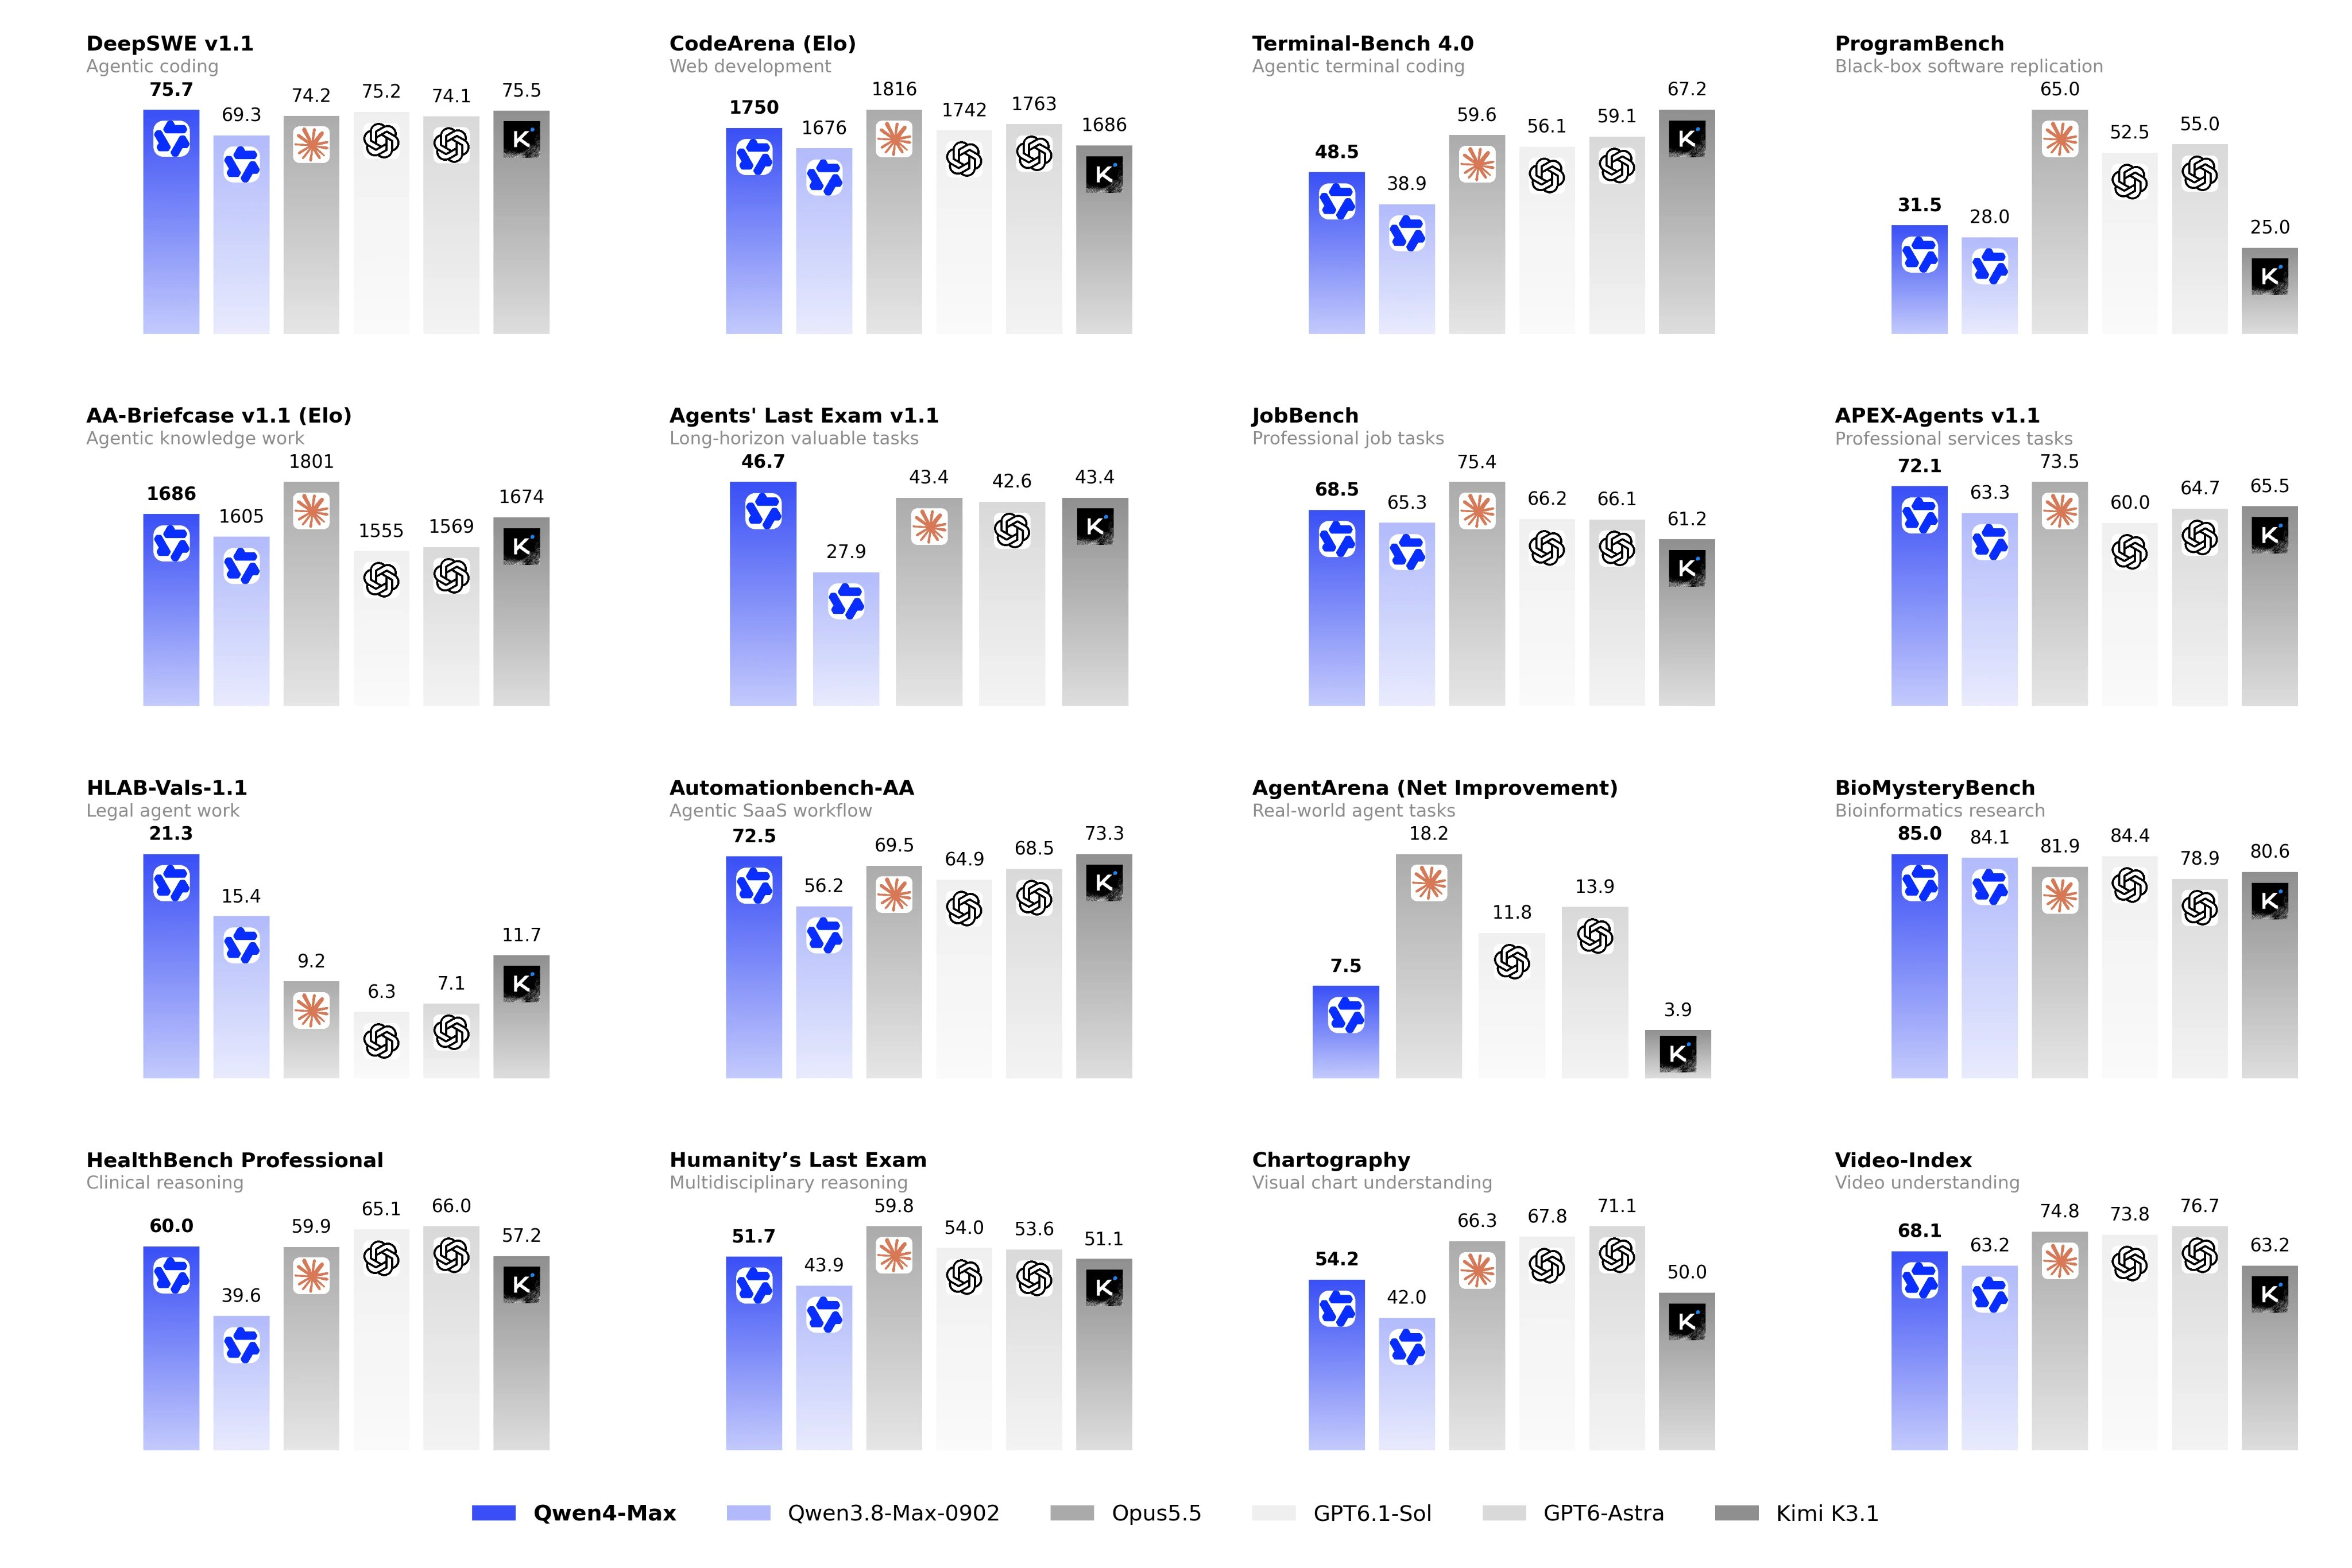
ตัวหนาหมายถึงคะแนนสูงสุดในกราฟ ส่วน “Alibaba” หมายความว่าเชิงอรรถไม่ได้อ้างอิง leaderboard ภายนอกสำหรับการทดสอบนั้น จึงควรถือว่าเป็นผลที่ Alibaba รันเอง (เชิงอรรถของ JobBench และ Chartography อธิบายเพียงการตั้งค่าของ Alibaba เท่านั้น)
รายงานเอง vs บุคคลที่สาม: ใครรันการทดสอบแต่ละรายการ
ใน 16 คะแนนนี้ มี 10 รายการเป็นการรายงานเอง และอีก 6 รายการอ้างอิงจาก leaderboard สาธารณะที่บุคคลอื่นรัน การแบ่งแบบนี้เป็นตัวกรองที่มีประโยชน์ที่สุดที่คุณใช้ได้
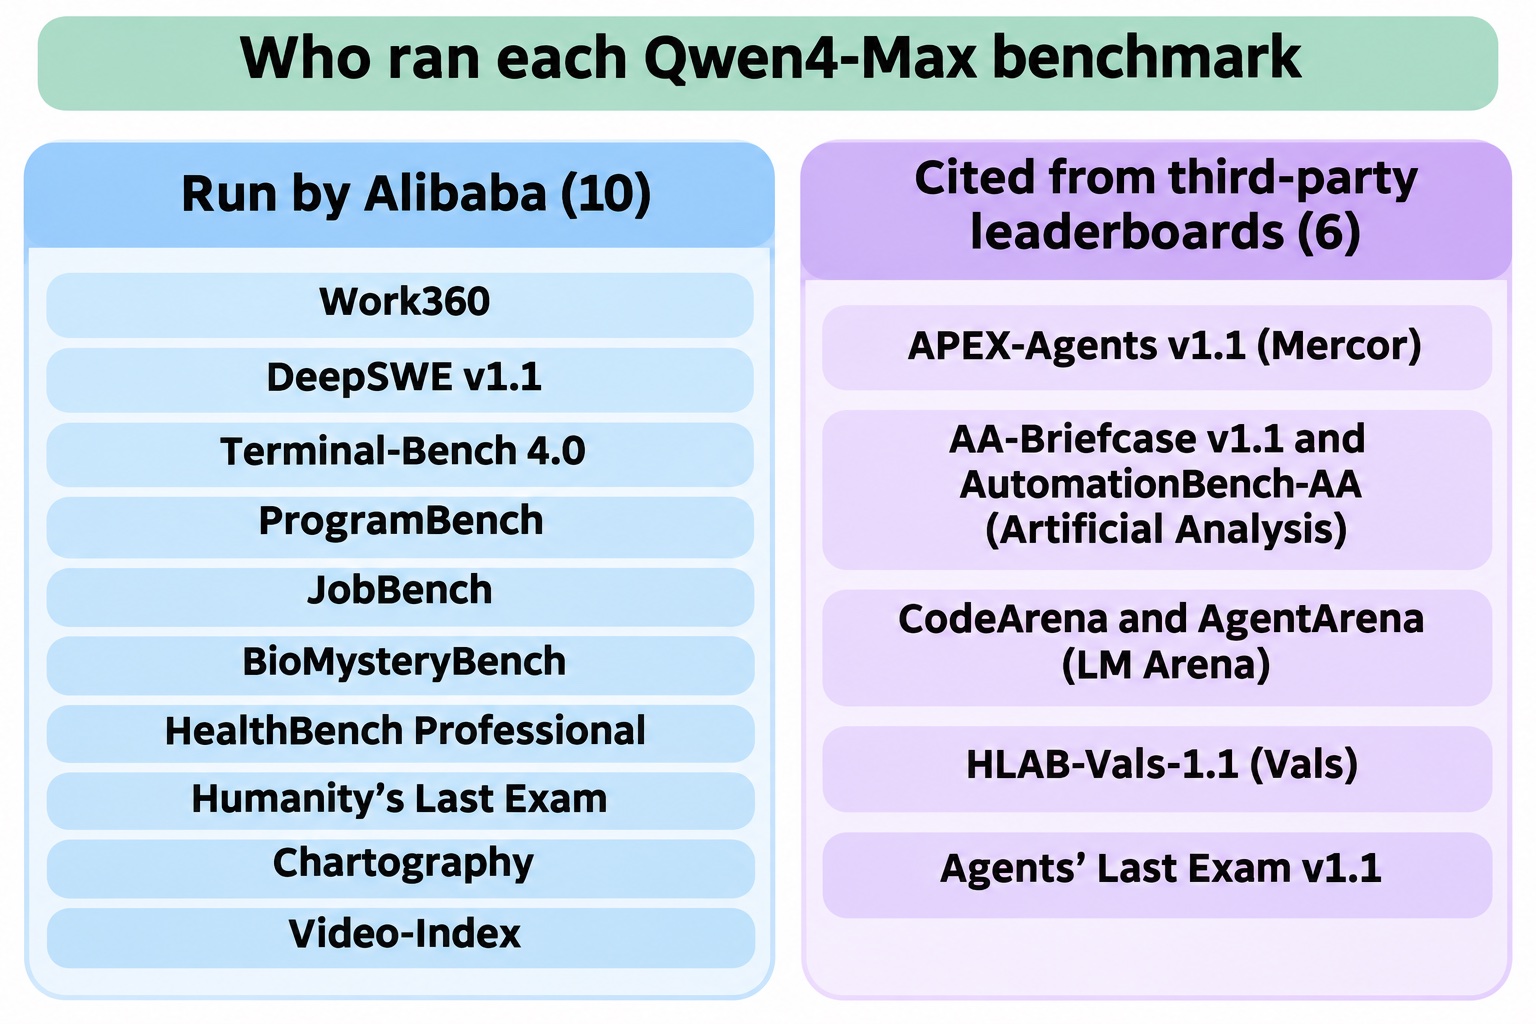
กลุ่มบุคคลที่สาม ตามเชิงอรรถของโพสต์เปิดตัว:
- APEX-Agents v1.1: อ้างอิงจาก Mercor APEX-Agents leaderboard
- AA-Briefcase v1.1 และ AutomationBench-AA: อ้างอิงจาก Artificial Analysis
- CodeArena และ AgentArena: อ้างอิงจาก LM Arena
- HLAB-Vals-1.1: อ้างอิงจาก Vals Index
- Agents’ Last Exam v1.1: อ้างอิงจาก leaderboard ของตัวเอง
ตัวเลขอิสระหนึ่งตัวที่คุณตรวจสอบได้ในวันนี้: Vals Index (เวอร์ชัน 2.2 อัปเดตวันที่ 15 พฤศจิกายน 2026) ระบุ Qwen 4 Max ที่ 63.20% โดยรวม อยู่อันดับ 11 ที่ $9.33 ต่อการทดสอบ ซึ่งต่ำกว่าโมเดลอีกสิบตัว โดยมี Claude Fable 5.2 นำที่ 71.31% และแซง Kimi K3.1 Pro (62.52%) และ Qwen 3.8 Max 0902 (59.05%) เพียงเล็กน้อย ภาพนี้ไม่ค่ึ้อรางเท่ากับกราฟในหน้าแรก
Work360: benchmark งานที่ Alibaba สร้างเอง
Work360 เป็น benchmark สำหรับงานอุตสาหกรรมที่ซับซ้อนของ Alibaba ครอบคลุม 26 โดเมน 182 โดเมนย่อย และ 721 สาขาเฉพาะทาง Qwen4-Max ทำคะแนนได้ 52.69 เพิ่มจาก 47.74 ของ Qwen3.8-Max
ต้องอ่านด้วยความระมัดระวัง: Alibaba เป็นผู้ออกแบบ benchmark และรันโมเดลเอง การเปรียบเทียบที่เผยแพร่ครอบคลุมเพียง Qwen4-Max และ Qwen3.8-Max และยังไม่มี leaderboard สาธารณะสำหรับสิ่งนี้ นี่คือตัวเลขเปรียบเทียบระหว่างเจเนอเรชัน ไม่ใช่การจัดอันดับกับค่ายอื่น
สิ่งที่ Work360 ให้ได้คือตัวเลขต้นทุน: ต้นทุนเฉลี่ยต่องานลดลงจาก $4.43 เหลือ $1.67 คิดเป็นการลดลง 62% มาจากการใช้ token ต่องานที่น้อยลงและราคาที่ถูกลงรวมกัน Qwen4-Max มีราคา $1.50 ต่อ 1M input tokens และ $4.50 ต่อ 1M output tokens ตามหน้าโมเดลของ QwenCloud ดูรายละเอียดเต็มได้ในคู่มือราคา Qwen4-Max ของเรา
Terminal-Bench 4.0 และประสิทธิภาพการใช้ token
Terminal-Bench วัดการที่ agent ทำงานจริงในเทอร์มินัลสำเร็จ Alibaba รายงานคะแนน 48.5 สำหรับ Qwen4-Max บนเวอร์ชัน 4.0 เพิ่มจาก 38.9 ของ Qwen3.8-Max บนกราฟของ Alibaba เอง โมเดลที่ไม่ใช่ Qwen ทั้งสี่ตัวได้คะแนนระหว่าง 56.1 ถึง 67.2 สูงกว่าทั้งหมด
ข้ออ้างที่ใหญ่กว่าคือเรื่องประสิทธิภาพ Alibaba ระบุว่าการใช้ token ลดลงราว 48% ที่ระดับความพยายาม Xhigh และ 49% ที่ระดับ High บน Terminal-Bench 4.0 และลดลงราว 24% (Xhigh) และ 35% (High) บน Work360 กราฟคะแนน-vs-tokens ของ Alibaba แสดงภาพรวมได้ว่า:
- บน Work360 Qwen4-Max ที่ระดับ High แซง Qwen3.8-Max ที่ระดับ Xhigh ไปแล้ว โดยใช้ราว 96K tokens ต่องาน เทียบกับราว 165K (อ่านจากกราฟ จึงเป็นค่าโดยประมาณ)
- บน Terminal-Bench 4.0 Qwen4-Max ที่ระดับ Xhigh ได้ 48.5 ด้วยราว 150K tokens ต่องาน ขณะที่ Qwen3.8-Max ที่ระดับ Xhigh ได้ราว 38 ด้วยราว 290K
ใช้ token น้อยลงแต่ได้คะแนนดีขึ้นเป็นทิศทางที่ถูกต้อง หากคุณจ่ายตามจำนวน token แต่ก็เป็นการรายงานเองเช่นกัน
ข้อควรตรวจสอบที่ควรรู้: Terminal-Bench leaderboard สาธารณะตอนนี้ตั้งค่าเริ่มต้นเป็นเวอร์ชัน 4.1 และ Qwen4-Max ยังไม่ปรากฏในนั้น ณ วันที่ 16 พฤศจิกายน Qwen3.8-Max-0902 ได้ 27.0% บนเวอร์ชัน 4.1 (รันด้วย Claude Code ที่ระดับ max effort) เทียบกับ 38.9 บนกราฟ 4.0 ของ Alibaba เป็นคนละเวอร์ชันและคนละ harness จึงอย่านำมาลบกัน แต่มันแสดงให้เห็นว่าคะแนนเปลี่ยนไปมากเพียงใดตามการตั้งค่า
Qwen4-Max นำที่ไหน และตามหลังที่ไหน
เมื่อเทียบกับโมเดล frontier อื่น ๆ ในกราฟ ภาพรวมเป็นแบบทางเลือก:
นำ (4 จาก 16): DeepSWE v1.1 (75.7 ได้เปรียบ 0.2 คะแนนจาก Kimi K3.1), Agents’ Last Exam v1.1 (46.7), HLAB-Vals-1.1 (21.3) และ BioMysteryBench (85.0 นำ GPT-6.1 Sol ไม่ถึงหนึ่งคะแนน)
รองชนะเลิศอย่างฉิวเฉียด: APEX-Agents v1.1 (72.1 เทียบ 73.5), AutomationBench-AA (72.5 เทียบ 73.3) และ AA-Briefcase (Elo 1686 เทียบ 1801)
ตามหลังชัดเจน: ProgramBench (31.5 เทียบ 65.0), Terminal-Bench 4.0 (48.5 เทียบ 67.2), AgentArena (7.5 เทียบ 18.2), Chartography (54.2 เทียบ 71.1) และ Humanity’s Last Exam (51.7 เทียบ 59.8)
สองในสี่ตำแหน่งที่นำ คือ Agents’ Last Exam และ HLAB-Vals มาจาก leaderboard บุคคลที่สาม จึงเป็นข้ออ้างที่แข็งแกร่งที่สุดในกราฟ ด้าน coding แบ่งเป็น: การนำแบบแคบบน DeepSWE และช่องว่างกว้างบน ProgramBench และ Terminal-Bench หากคุณรัน terminal agent ระยะยาว ควรทดสอบก่อนเปลี่ยน สำหรับสิ่งที่เปลี่ยนแปลงตั้งแต่เจเนอเรชันก่อน ดูที่ Qwen4-Max vs Qwen 3.8
ตัวเลข secure coding และ pre-training
Secure coding. บน Last Secure Code Bench ในโหมด “code reconstruction without security hint” โดยตรวจสอบทั้งความถูกต้องของฟังก์ชันและช่องโหว่ อัตราผ่านระดับฟังก์ชันเพิ่มจาก 22.0% ของ Qwen3.8-Max เป็น 31.8% ส่วนของโค้ดที่ผ่านทั้งสามระดับ (ฟังก์ชัน ไฟล์ และ repository) เพิ่มจาก 8% เป็น 14.7% ผลลัพธ์ระดับฟังก์ชันราวสองในสามยังตกการตรวจสอบอยู่ การรีวิวด้านความปลอดภัยจึงยังเป็นหน้าที่ของคุณ
Pre-training. ในการประเมินภายในครอบคลุมความรู้ โค้ด คำถาม-คำตอบ และ STEM Qwen4-Max-Base มี bits per byte ต่ำกว่า Qwen3.8-Max-Base ราว 5% ถึง 13% ขณะเปิดใช้พารามิเตอร์น้อยลง 25% Alibaba ระบุว่า checkpoint สองตัวในการเปรียบเทียบนั้น (GLM-5.3 และ Kimi-K3.1-Pro) เป็นแบบ post-trained ซึ่งอาจบิดเบือนผล
สิ่งที่ยังขาดหายไป
- การตั้งค่าการประเมินของการทดสอบส่วนใหญ่ โพสต์เปิดตัวไม่ได้ระบุว่าแต่ละแท่งคะแนนมาจากระดับความพยายาม (High หรือ Xhigh) หรือ agent harness ตัวใด
- ความแปรปรวน ไม่มี error bar หรือจำนวนรอบการรัน Leaderboard อย่าง Terminal-Bench รายงานค่าคลาดเคลื่อนราว 3 ถึง 4 คะแนน ซึ่งมากกว่าบางช่องว่างข้างต้น
- การรัน Terminal-Bench และ Work360 อย่างอิสระ ทั้งสองยังไม่ปรากฏบน leaderboard สาธารณะ
รัน benchmark Qwen4-Max ของคุณเองด้วย Apidog CLI
ไม่มี benchmark สาธารณะตัวใดที่ใช้ prompt หรือ schema ของคุณ วิธีตรวจสอบที่ซื่อสัตย์และเร็วที่สุดคือชุดทดสอบเล็ก ๆ จากคำขอของคุณเอง รันด้วยวิธีเดียวกันทุกครั้ง โดยบันทึกการใช้ token เพื่อให้คำนวณต้นทุนต่องานของคุณเองได้
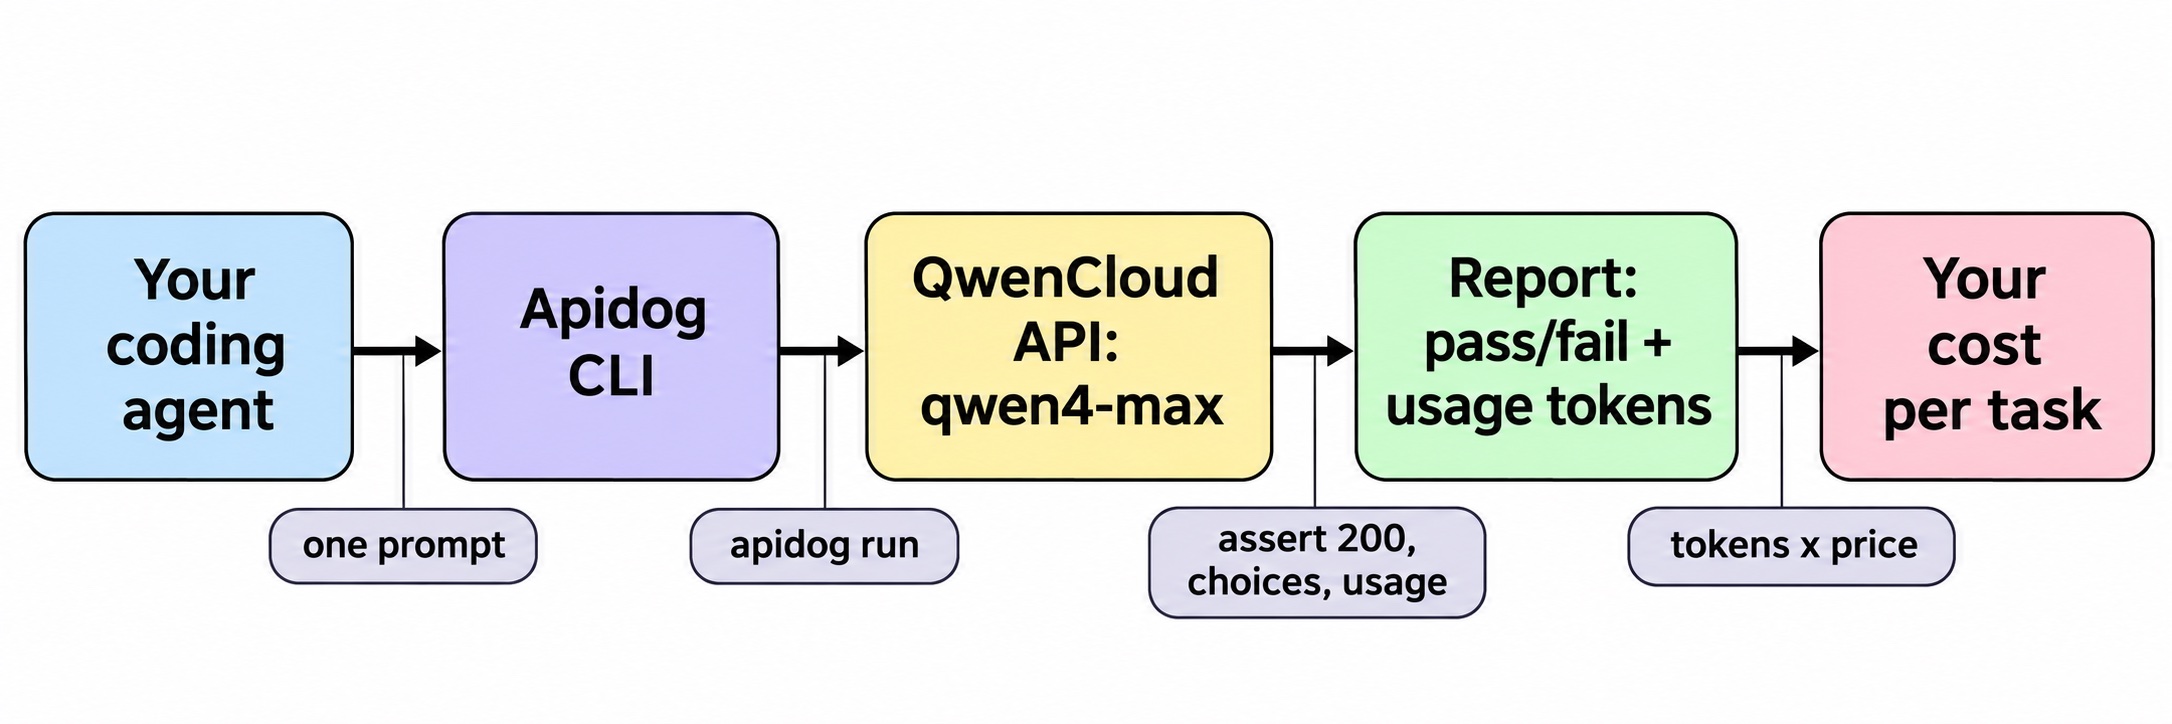
ให้ coding agent ของคุณจัดการการตั้งค่าด้วย Apidog CLI ติดตั้งครั้งเดียว:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install สอนการใช้ CLI ให้ agent ของคุณ ส่วนคู่มือติดตั้งครอบคลุมเรื่อง token จากนั้นให้ prompt เดียว:
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
Agent จะตรวจสอบรูปแบบ payload แต่ละแบบก่อนเขียนอะไรลงไป Flag ทุกตัวด้านล่างมาจาก apidog <command> --help บน Apidog CLI 2.2.12:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
-d รันหนึ่งรอบต่อแถวของไฟล์ prompt ของคุณ และ --env-var ส่งคีย์ตอนรัน เพื่อให้ไม่ต้องเก็บคีย์ไว้ในโปรเจกต์ Agent จะอ่านบล็อก usage แต่ละอันจากรายงาน JSON ใน apidog-reports คูณ prompt tokens ด้วย $1.50 และ completion tokens ด้วย $4.50 ต่อล้าน คุณก็จะได้ต้นทุนต่องานของตัวเองไว้เทียบกับ $1.67 ของ Alibaba
สลับ environment เพื่อรันชุดทดสอบเดิมกับโมเดลที่คุณใช้อยู่ และรันซ้ำสองถึงสามครั้งเพื่อดูความแปรปรวนที่กราฟเปิดตัวไม่ได้แสดง บรรทัด apidog run เดียวกันนี้ใส่ลง CI ได้ด้วย -r junit ดูคู่มือ CI/CD สำหรับการตั้งค่า agent แบบทีละขั้น ดูที่ Apidog CLI in Claude Code แพน Free ของ Apidog รองรับผู้ใช้ได้ถึง 4 คน
คำถามที่พบบ่อย
Benchmark ของ Qwen4-Max เป็นอิสระหรือไม่? ส่วนใหญ่ไม่ ใน 16 คะแนนในกราฟของ Alibaba มีสิบคะแนนเป็นผลที่ Alibaba รันเอง อีกหกคะแนนอ้างอิงจาก leaderboard บุคคลที่สาม: APEX-Agents (Mercor), AA-Briefcase และ AutomationBench-AA (Artificial Analysis), CodeArena และ AgentArena (LM Arena), HLAB-Vals (Vals) และ Agents’ Last Exam
Work360 คืออะไร? Benchmark สำหรับงานอุตสาหกรรมที่ซับซ้อนของ Alibaba เอง ครอบคลุม 26 โดเมน Qwen4-Max ทำคะแนน 52.69 เทียบกับ 47.74 ของ Qwen3.8-Max โดยมีเพียงสองโมเดลนี้ปรากฏในการเปรียบเทียบที่เผยแพร่
Qwen4-Max ทำได้ดีแค่ไหนบน Terminal-Bench 4.0? Alibaba รายงานคะแนน 48.5 เพิ่มจาก 38.9 โดยใช้ token ประมาณครึ่งหนึ่ง โมเดล frontier อื่น ๆ ในกราฟได้คะแนน 56.1 ถึง 67.2
Qwen4-Max รันแล้วถูกกว่า Qwen3.8-Max หรือไม่? จากการประเมิน Work360 ของ Alibaba ต้นทุนเฉลี่ยต่องานลดลงจาก $4.43 เหลือ $1.67 ราคาหน้าร้านคือ input $1.50 และ output $4.50 ต่อ 1M tokens ดูคู่มือ Token Plan สำหรับตัวเลือกสมาชิก และQwen4-Max ฟรี สำหรับวิธีใช้โดยไม่มีค่าใช้จ่าย
Live Delivery ในการเปิดตัว Qwen4-Max คืออะไร? เป็น agent workflow ที่ส่งมอบเวอร์ชันแรกที่ใช้งานได้ให้เร็วที่สุด แล้วปรับปรุงต่อไปขณะที่คุณกำกับอยู่ ไม่ใช่ benchmark ดูรายละเอียดในคู่มือปลั๊กอิน Qwen Live Delivery ของเรา