
Alibaba ได้เปิดตัว Qwen 3.8-Max ในช่วงต้นเดือนสิงหาคม 2026 และหากคุณกำลังใช้งาน qwen3.7-max ในการผลิตอยู่แล้ว คุณก็จะต้องทำการตัดสินใจครั้งสำคัญ โมเดลใหม่นี้แสดงให้เห็นถึงการปรับปรุงที่ยิ่งใหญ่ในด้านการทำงานแบบ agentic และการวิจัย เพิ่มความสามารถในการรับข้อมูลรูปภาพ เปิดตัวด้วยราคาที่ต่ำลง และมาพร้อมกับคำมั่นสัญญาที่ Alibaba ไม่เคยให้ไว้กับรุ่นก่อนหน้า: น้ำหนักโมเดลแบบเปิด (open weights)
แต่การตัดสินใจนั้นไม่ง่ายเหมือนแค่ "โมเดลใหม่ชนะ" Qwen 3.7-Max กำลังจัดโปรโมชันลดราคา 50% แบบจำกัดเวลา ซึ่งทำให้ราคาถูกกว่า 3.8-Max ในแง่ของราคาจริง ความแตกต่างของผลการทดสอบบางส่วนนั้นชัดเจนมาก ในขณะที่บางส่วนแทบไม่มีความแตกต่างเลย บทความนี้จะอธิบายการเปลี่ยนแปลงที่สำคัญทุกประการ เพื่อให้คุณสามารถตัดสินใจได้ว่าจะเปลี่ยนตอนนี้ รอ หรือจะลดระดับลงไปเลย
หากคุณต้องการภาพรวมทั้งหมดของโมเดลใหม่ก่อน โปรดเริ่มต้นด้วย คำอธิบาย Qwen 3.8-Max ของเรา สำหรับข้อมูลเบื้องหลังของเรือธงรุ่นเดิม โปรดดู สิ่งที่ Qwen 3.7 นำเสนอ
ข้อสังเกตเกี่ยวกับวิธีการก่อนจะดูตัวเลข ตัวเลขผลการทดสอบทั้งหมดด้านล่างมาจากตารางของ Alibaba เองใน โพสต์เปิดตัว Qwen 3.8 อย่างเป็นทางการ ซึ่งมีประโยชน์มากในที่นี้: โมเดลทั้งสองถูกประเมินในการรันโดยผู้ขายรายเดียวกัน ดังนั้นความแตกต่างภายในจึงมีความสอดคล้องกัน แม้ว่าการยืนยันจากอิสระยังคงรอการดำเนินการอยู่ แถวการเขียนโค้ดส่วนใหญ่ถูกรันบน Claude Code harness และการทดสอบหลายรายการเป็นแบบภายในของ Qwen
เวอร์ชันย่อ
| สิ่งที่เปลี่ยนไป | Qwen 3.7-Max | Qwen 3.8-Max |
|---|---|---|
| Terminal Bench 2.1 | 74.5 | 86.6 |
| SWE-bench Pro | 60.6 | 67.7 |
| PaperBench | 64.8 | 93.0 |
| IFBench | 79.1 | 82.8 |
| GPQA Diamond | 92.4 | 92.6 |
| HLE | 41.4 | 43.6 |
| ราคาปลีก (ต่อ 1M โทเค็น) | $2.5 รับ / $7.5 ส่ง | $2 รับ / $6 ส่ง |
| ราคาปัจจุบัน (โปรโมชัน) | $1.25 รับ / $3.75 ส่ง | $2 รับ / $6 ส่ง |
| การป้อนภาพ | ไม่ | ใช่ |
| สถาปัตยกรรมที่เปิดเผย | ไม่เปิดเผย | 2.4T ทั้งหมด, 95B MoE ที่ทำงาน |
| น้ำหนักโมเดลแบบเปิด | ไม่เคยเปิดตัว | สัญญาว่าจะเปิดตัว "สัปดาห์หน้า" (~10 ส.ค.) |
| หน้าต่างบริบท | 1M โทเค็น | 1M โทเค็น |
รายละเอียดมีดังนี้
ความแตกต่างของผลการทดสอบ: การก้าวกระโดดที่เป็นจริง
การปรับปรุงที่สำคัญที่สุดมักจะรวมกลุ่มอยู่กับการทำงานแบบ agentic: งานที่มีระยะเวลานานที่โมเดลวางแผน ดำเนินการ และแก้ไขตัวเอง
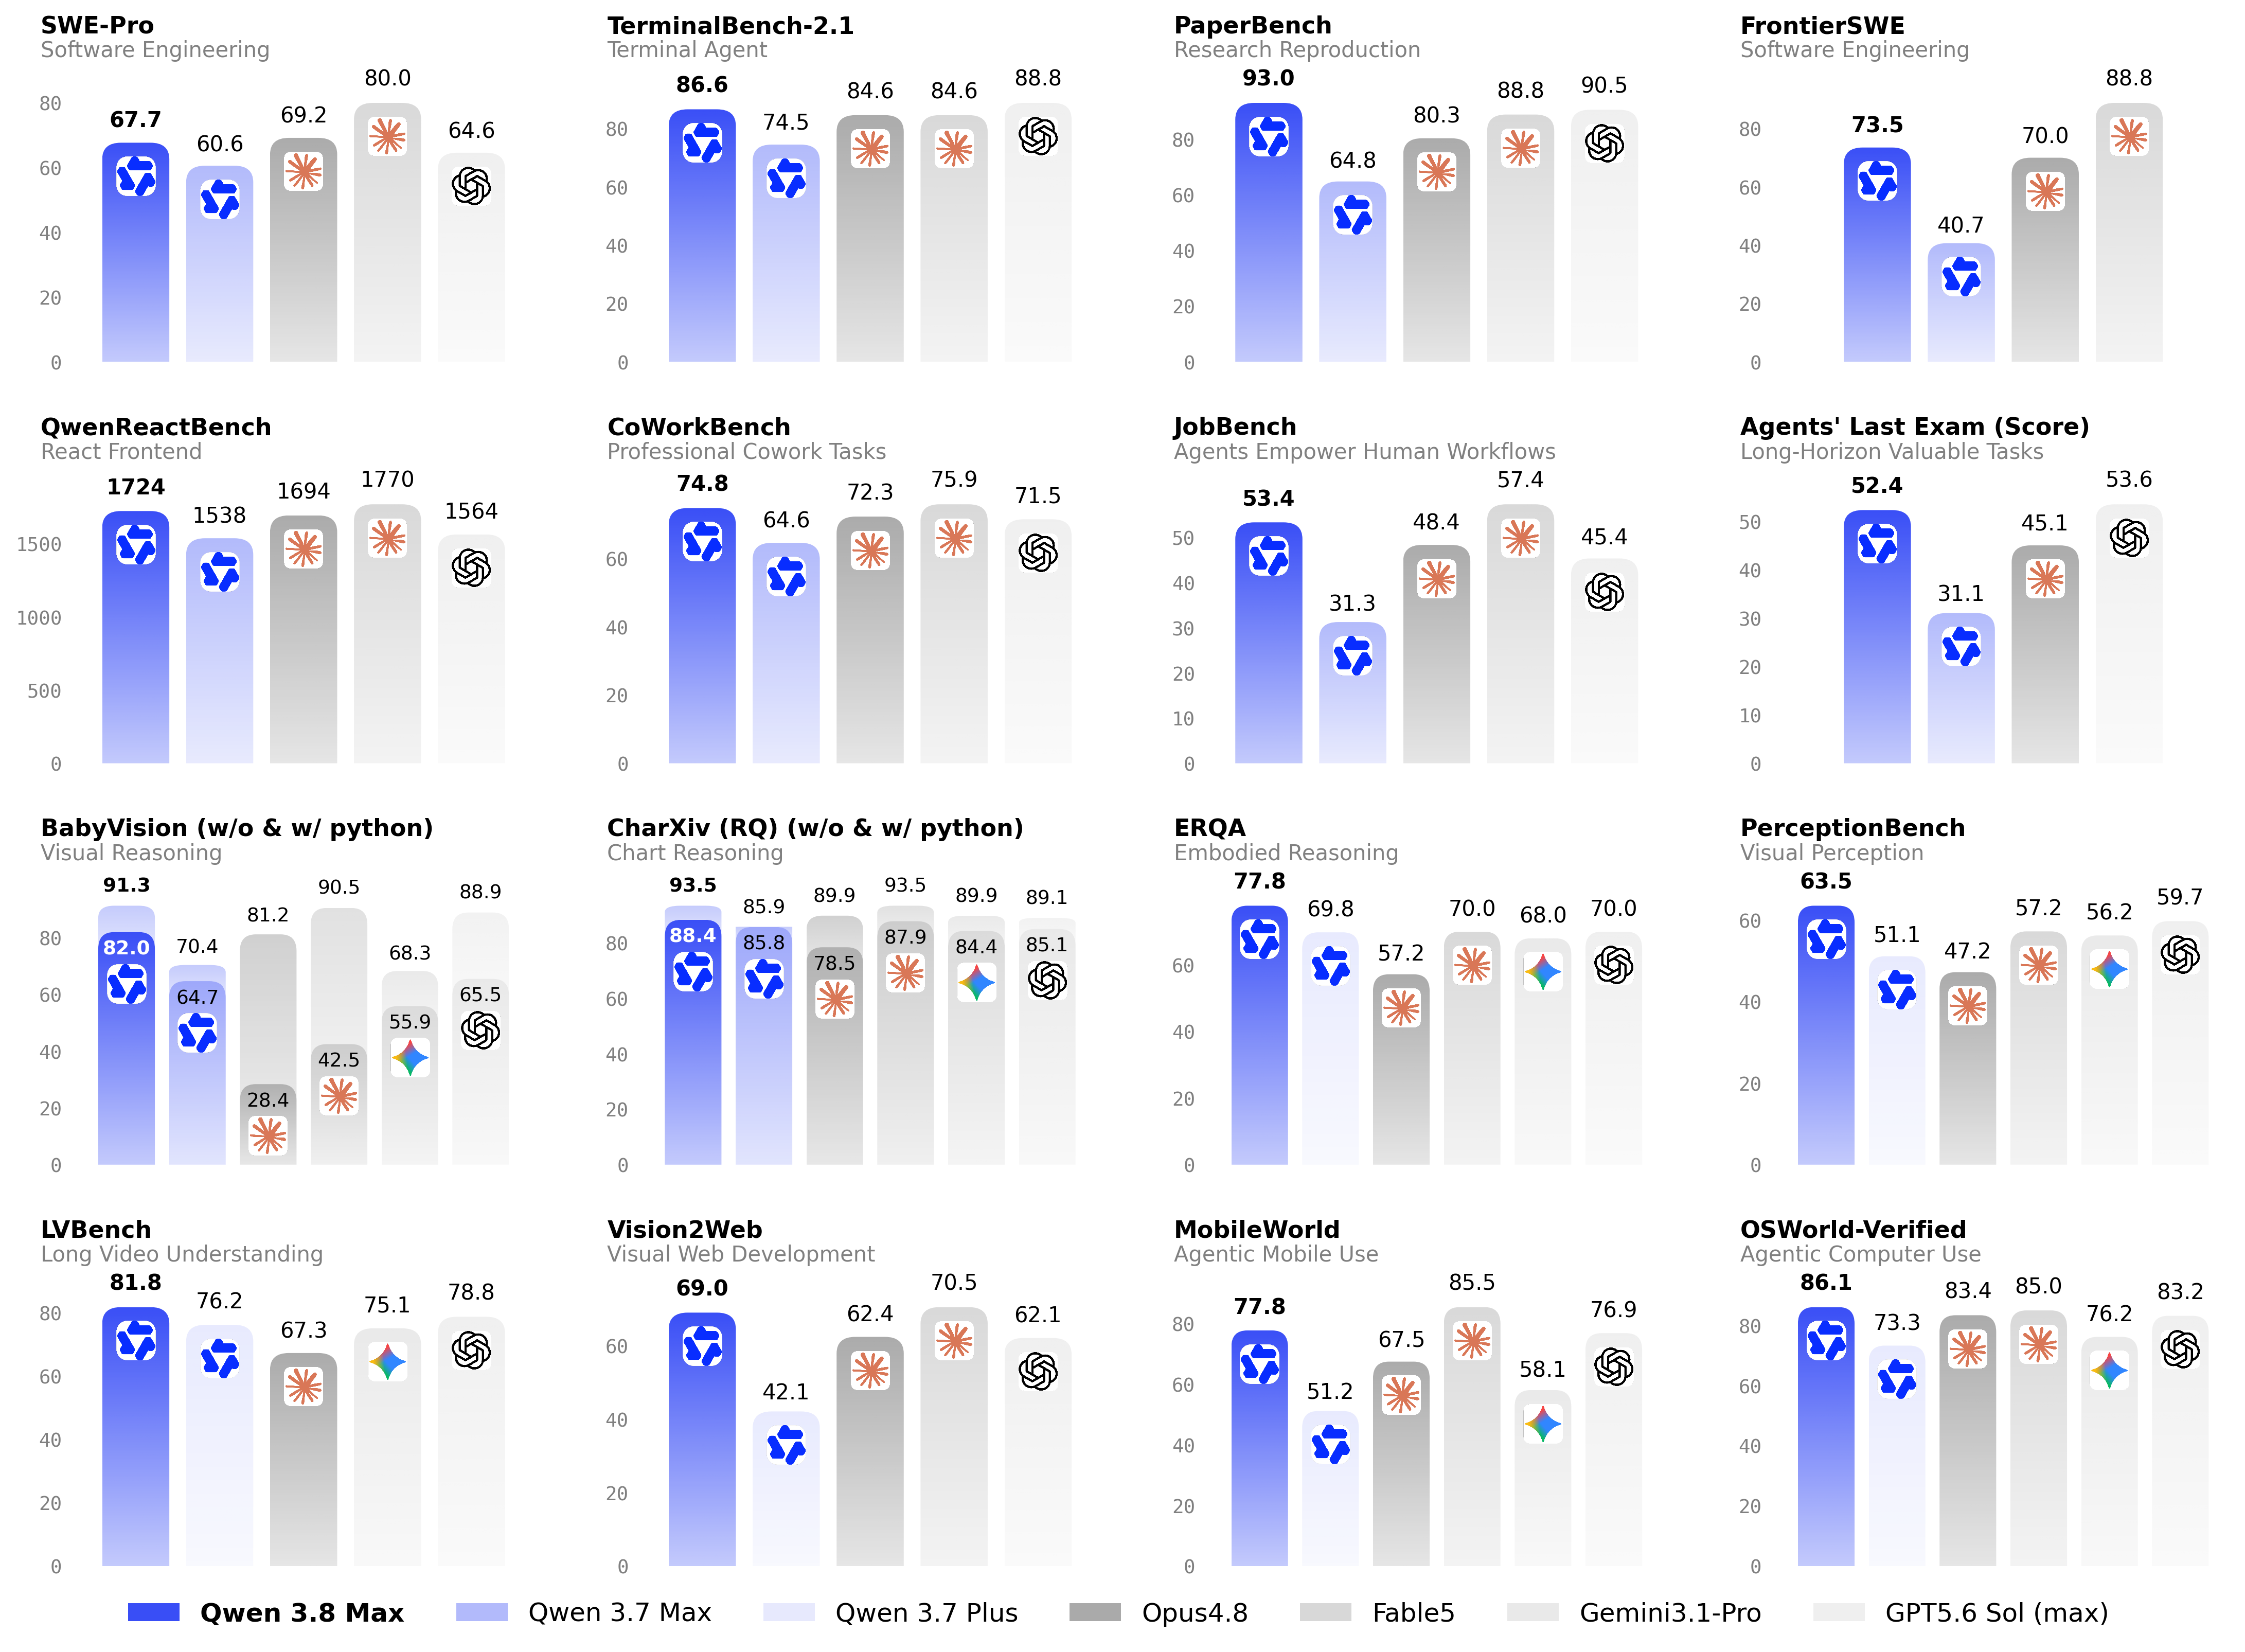
Terminal Bench 2.1: 74.5 ไป 86.6 นี่คือการก้าวกระโดด 12 คะแนนในงาน agentic ที่ขับเคลื่อนด้วยเทอร์มินัล และทำให้ Qwen จากที่ตามหลังอย่างชัดเจนกลายเป็นคู่แข่งที่น่าจับตามองอย่างแท้จริง ในตารางเดียวกัน Alibaba ให้คะแนน Claude Opus 4.8 และ Fable 5 ที่ 84.6 เท่ากัน ซึ่งทำให้ 3.8-Max นำหน้าทั้งคู่ในแถวนี้ GPT-5.6 Sol ยังคงนำอยู่ที่ 88.8
SWE-bench Pro: 60.6 ไป 67.7 ได้เพิ่มขึ้น 7 คะแนนในงานวิศวกรรมซอฟต์แวร์ในโลกแห่งความเป็นจริง มีความสำคัญ แต่ต้องพูดตามตรง: Fable 5 อยู่ที่ 80.0 ในตารางเดียวกัน ดังนั้นนี่คือการตามให้ทัน ไม่ใช่การแซงหน้า หากประสิทธิภาพของ SWE-bench Pro เป็นเกณฑ์หลักในการตัดสินใจซื้อของคุณ ขีดจำกัดความก้าวหน้ายังคงอยู่ที่อื่น
PaperBench: 64.8 ไป 93.0 นี่คือความแตกต่างที่ใหญ่ที่สุดในตาราง โดยมีการก้าวกระโดด 28 คะแนนในการทำซ้ำงานวิจัย AI และยังเป็นผลงานที่ดีที่สุดของ 3.8-Max ในกลุ่มเรือธง นำหน้าคู่แข่งทุกรายในการเปรียบเทียบของ Alibaba หากปริมาณงานของคุณเกี่ยวข้องกับการทำซ้ำงานวิจัย เอกสารทางเทคนิคขนาดยาว หรือการให้เหตุผลทางวิทยาศาสตร์แบบหลายขั้นตอน ตัวเลขนี้ควรดึงดูดความสนใจของคุณ
IFBench: 79.1 ไป 82.8 การปฏิบัติตามคำสั่งปรับปรุงเกือบ 4 คะแนน ที่น่าสังเกตคือ 3.7-Max แข็งแกร่งอยู่แล้วในด้านนี้ (79.1 ชนะ Opus 4.8 และ Fable 5 ในการรันเดียวกัน) ดังนั้นนี่จึงเป็นการขยายความเป็นผู้นำที่มีอยู่แล้ว แทนที่จะเป็นการแก้ไขจุดอ่อน
GPQA Diamond: 92.4 ไป 92.6 แทบไม่เปลี่ยนแปลง การตอบคำถามวิทยาศาสตร์ระดับบัณฑิตศึกษาเกือบถึงจุดอิ่มตัวสำหรับ 3.7-Max แล้ว และโมเดลใหม่ก็ไม่ได้ทำให้ดีขึ้น หากปริมาณงานของคุณดูเหมือน GPQA การอัปเกรดนี้ไม่ได้ช่วยเพิ่มคุณภาพเลย
HLE: 41.4 ไป 43.6 Humanity’s Last Exam ปรับปรุงขึ้น 2 คะแนน แต่ก็ยังตามหลังขีดจำกัดความก้าวหน้า: Fable 5 ทำได้ 53.3 และ GPT-5.6 Sol ทำได้ 47.2 ในตารางเดียวกัน Qwen 3.8-Max ปิดช่องว่างในหลาย ๆ ด้าน แต่ไม่ใช่ในด้านนี้
รูปแบบที่พบ: การปรับปรุงครั้งใหญ่ในด้านการทำงานแบบ agentic และการวิจัย การปรับปรุงเล็กน้อยในการปฏิบัติตามคำสั่ง ไม่มีการเปลี่ยนแปลงในการทดสอบความรู้ที่อิ่มตัว และช่องว่างที่ยังคงมีอยู่ในด้านการประเมินการให้เหตุผลที่ยากที่สุด สำหรับการเจาะลึกตารางฉบับเต็ม รวมถึงรายละเอียดปลีกย่อยเกี่ยวกับ harnesses และการทดสอบภายใน โปรดดู การวิเคราะห์ผลการทดสอบ Qwen 3.8 ของเรา
สถาปัตยกรรม: ในที่สุด Alibaba ก็เปิดเผยตัวเลข
Qwen 3.8-Max เป็นโมเดล mixture-of-experts ที่มีพารามิเตอร์รวม 2.4 ล้านล้านตัว โดยมีพารามิเตอร์ที่ทำงานอยู่ 95B ต่อการส่งข้อมูลไปข้างหน้าแต่ละครั้ง สร้างขึ้นบนพื้นฐานสถาปัตยกรรม Qwen 3.5 นั่นคืออัตราการทำงานประมาณ 4% ซึ่งส่งผลต่อค่าใช้จ่ายในการให้บริการ: คุณจ่ายค่าประมวลผลสำหรับ 95B ไม่ใช่ 2.4T
ความแตกต่างกับ 3.7-Max คือการเปิดเผยข้อมูลนี้ Alibaba ไม่เคยเปิดเผยตัวเลขขนาดที่เทียบเคียงได้สำหรับ Qwen 3.7-Max จำนวนพารามิเตอร์ อัตราการทำงาน การกำหนดค่าผู้เชี่ยวชาญ: ทั้งหมดนี้ไม่เปิดเผย สำหรับ 3.8-Max เอกสารโมเดล Model Studio และโพสต์เปิดตัวระบุสถาปัตยกรรมไว้อย่างชัดเจน ซึ่งทำให้การวางแผนความจุและการจำลองต้นทุนไม่ใช่เรื่องที่ต้องเดาอีกต่อไป
สำหรับบริบทในการแข่งขันโมเดลแบบ open-weight: Kimi K3 มีพารามิเตอร์รวม 2.8T โดยมี 104B ที่ทำงานอยู่ Qwen 3.8-Max มีขนาดเล็กกว่าทั้งสองด้าน
Multimodal: ความสามารถที่ 3.7-Max ไม่เคยมี
Qwen 3.7-Max เป็นโมเดลข้อความ Qwen 3.8-Max สามารถรับข้อมูลภาพได้โดยตรง และ Alibaba ได้เผยแพร่ตารางการทดสอบ multimodal แยกต่างหากซึ่งแสดงให้เห็นว่ามันนำหน้าคู่แข่งส่วนใหญ่เมื่อเทียบกับ Gemini 3.1 Pro และ GPT-5.6 Sol
คะแนนที่โดดเด่นจากตาราง multimodal ของ Alibaba ได้แก่ MathVision ที่ 95.2, LogicVista ที่ 91.9 และ OSWorld-Verified ที่ 86.1 สำหรับงานที่เกี่ยวข้องกับการใช้งานคอมพิวเตอร์ ไม่มีคอลัมน์ 3.7-Max ในตารางนั้นให้เปรียบเทียบ เพราะมันไม่สามารถทำได้: โมเดลรุ่นเก่าไม่สามารถรับภาพได้
ในทางปฏิบัติ หมายความว่าปริมาณงานที่คุณเคยต้องส่งไปยังโมเดลวิชันแยกต่างหาก (เช่น การทำความเข้าใจภาพหน้าจอ รูปภาพเอกสาร การทำงานอัตโนมัติของ UI การแยกข้อมูลจากแผนภูมิ) ตอนนี้สามารถรันบนรหัสโมเดลเดียวกับปริมาณงานข้อความของคุณได้ โพสต์เปิดตัวยังแสดงให้เห็นถึงความสามารถในการทำความเข้าใจเอกสารขนาดยาวและวิดีโอ แม้ว่าสิ่งเหล่านี้เป็นความสามารถที่แสดงในบล็อกมากกว่าประเภทอินพุต API ที่แตกต่างกัน ดังนั้นโปรดตรวจสอบกับเอกสาร API สำหรับกรณีเฉพาะของคุณ
ราคา: โมเดลใหม่ถูกกว่า ยกเว้นตอนนี้
นี่คือจุดที่การคำนวณการอัปเกรดน่าสนใจ
Qwen 3.8-Max เปิดตัวที่ $2 รับ / $6 ส่ง ต่อ 1M โทเค็น ซึ่งเป็นอัตราคงที่เดียวตลอดบริบท 1M ทั้งหมด Qwen 3.7-Max มีราคาอยู่ที่ $2.5 / $7.5 ดังนั้นโมเดลใหม่ที่มีความสามารถมากขึ้นจึงมีราคาต่ำกว่าราคาปลีกของรุ่นก่อนหน้าถึง 20% ซึ่งแทบจะไม่เคยเกิดขึ้นในการเปลี่ยนรุ่นเรือธง
แต่มีข้อแม้: Alibaba กำลังจัดโปรโมชันจำกัดเวลา 50% สำหรับ 3.7-Max ซึ่งทำให้อัตราที่มีประสิทธิภาพอยู่ที่ $1.25 / $3.75 ด้วยราคาปัจจุบัน โมเดลรุ่นเก่ามีราคาถูกกว่าโมเดลใหม่ถึง 38% อัตราทั้งหมดอยู่ใน หน้าเว็บราคา Model Studio อย่างเป็นทางการ
สองสิ่งที่ควรจำไว้:
- โปรโมชันอาจสิ้นสุดลง Alibaba ระบุว่าเป็นแบบจำกัดเวลาและไม่ได้เผยแพร่กำหนดสิ้นสุด หากคุณวางแผนงบประมาณโดยยึดตาม $1.25 / $3.75 งบประมาณของคุณมีความเสี่ยงที่จะหมดอายุโดยที่คุณไม่ทราบ ที่ราคาปลีก 3.8-Max คือโมเดลที่ถูกกว่า
- โทเค็น "ความคิด" ทำให้ค่าใช้จ่ายจริงสูงขึ้น Qwen 3.8-Max ตั้งค่าเริ่มต้นเป็น
reasoning_effort: xhighและโทเค็น "ความคิด" จะถูกคิดค่าใช้จ่ายเป็นเอาต์พุต ค่าใช้จ่ายต่อคำขอของคุณอาจสูงกว่าที่ระบุไว้ในราคา เรามี คู่มือราคา Qwen 3.8 ที่อธิบายเศรษฐศาสตร์ของแคชและการคำนวณต้นทุนต่องานอย่างละเอียด
และหากโมเดล Max ทั้งสองไม่เหมาะกับงบประมาณของคุณ qwen3.7-plus ที่ราคา $0.4 / $1.6 (ปัจจุบันลด 20%) ยังคงเป็นตัวเลือกที่คุ้มค่า การเปรียบเทียบ Plus กับ Max ครอบคลุมว่าเมื่อไหร่ Plus เพียงพอต่อความต้องการ
น้ำหนักโมเดลแบบเปิด: ครั้งแรกสำหรับรุ่น Max
ไม่มีโมเดลคลาส Qwen-Max ใดที่เคยเปิดตัวน้ำหนักโมเดลแบบเปิด Qwen 3.7-Max ก็ไม่เคยทำ และ Alibaba ก็ไม่เคยแนะนำว่าจะทำ Qwen 3.8-Max ทำลายรูปแบบนั้น: โพสต์เปิดตัวให้คำมั่นสัญญาว่าจะเปิดตัวน้ำหนักโมเดลบน Hugging Face และ ModelScope "สัปดาห์หน้า" ซึ่งคาดว่าจะอยู่ราววันที่ 10 สิงหาคม
ณ วันที่เขียนนี้ (3 สิงหาคม 2026) น้ำหนักโมเดลยังไม่สามารถดาวน์โหลดได้ ถือว่าคำสัญญานี้เป็นคำสัญญา อย่างไรก็ตาม ตัวอย่างก่อนหน้านี้ก็สนับสนุน: น้ำหนักของ Kimi K3 มาถึง 11 วันหลังจากการเปิดตัว และ Alibaba มีประวัติยาวนานในการเปิดตัวน้ำหนักโมเดลของ Qwen รุ่นเล็ก แต่การดาวน์โหลดพารามิเตอร์ 2.4T เป็นโครงการโฮสติ้งด้วยตัวเองแบบหลายโหนด แม้ว่าจะทำการควอนไทซ์แล้วก็ตาม ดังนั้นสำหรับทีมส่วนใหญ่ ผลกระทบในทางปฏิบัติคือการเข้าถึงและการกำหนดราคาที่โฮสต์โดยบุคคลที่สาม ไม่ใช่โมเดลที่รันอยู่ในชั้นวางเซิร์ฟเวอร์ของคุณ
หากน้ำหนักโมเดลแบบเปิดมีความสำคัญต่อการจัดซื้อจัดจ้างหรือการปฏิบัติตามข้อกำหนดของคุณ สิ่งนี้เพียงอย่างเดียวอาจช่วยตัดสินคำถามระหว่าง 3.7 กับ 3.8 ได้ โมเดลหนึ่ง (น่าจะ) มี อีกโมเดลหนึ่งจะไม่มีเลย
สิ่งที่ไม่เปลี่ยนแปลง
เป็นสิ่งสำคัญที่ต้องระบุให้ชัดเจน เพราะโพสต์การอัปเกรดมักจะโฆษณาเกินจริง:
- หน้าต่างบริบท: 1M โทเค็นทั้งคู่ ไม่มีการขยาย หากคุณเลือก 3.7-Max สำหรับบริบทขนาดยาว 3.8-Max ก็ยังคงอยู่ที่ 1M เท่าเดิมพร้อมราคาคงที่ตลอดหน้าต่างทั้งหมด
- ช่องทางการเข้าถึง: เหมือนเดิม ทั้งสองโมเดลให้บริการผ่าน Alibaba Cloud Model Studio พร้อม Endpoint ที่เข้ากันได้กับ OpenAI การเปลี่ยนคือการเปลี่ยน ID โมเดล (จาก
qwen3.7-maxเป็นqwen3.8-max) ไม่ใช่โครงการย้ายข้อมูล นอกจากนี้ 3.8-Max ยังเพิ่มส่วนหน้า API ที่เข้ากันได้กับ Anthropic ซึ่งคุ้มค่าที่จะลองใช้ในไคลเอนต์อย่าง Apidog หากเครื่องมือของคุณรองรับโปรโตคอลนั้น - การควบคุมการให้เหตุผล: เป็นทางการแล้ว
reasoning_effortเป็นพารามิเตอร์ที่ได้รับการบันทึกและรองรับบน 3.8-Max มีสามระดับ (xhigh เป็นค่าเริ่มต้น, medium, low) พร้อมกับenable_thinkingและpreserve_thinkingหากคุณปรับแต่ง prompt รอบพฤติกรรมการให้เหตุผลโดยนัยบน 3.7-Max ตอนนี้คุณจะมีตัวปรับที่ชัดเจนแทน
คุณควรอัปเกรดหรือไม่? สามแนวทางที่ซื่อสัตย์
อัปเกรดตอนนี้หาก ปริมาณงานของคุณเน้นการทำงานแบบ agentic หรือการวิจัย ความแตกต่างของ Terminal Bench (74.5 ไป 86.6) และ PaperBench (64.8 ไป 93.0) เป็นการก้าวกระโดดที่คุณสามารถสัมผัสได้ในการผลิต และคุณยังได้รับอินพุตภาพบวกกับราคาปลีกที่ต่ำลงเป็นโบนัส หากคุณกำลังสร้าง agent ที่ทำงานกับเทอร์มินัล ทำซ้ำงานทางเทคนิค หรือประมวลผลภาพหน้าจอ กรณีนี้ชัดเจน
ใช้โปรโมชัน 3.7-Max ต่อไปหาก ปริมาณงานของคุณอยู่ในโซนที่ไม่เปลี่ยนแปลง งานความรู้สไตล์ GPQA เคลื่อนไหวเพียง 0.2 จุด หากปริมาณงานของคุณคือการถามตอบ การสรุป หรือการสนทนาทั่วไป และ 3.7-Max มีคุณภาพตามที่คุณต้องการอยู่แล้ว $1.25 / $3.75 เป็นข้อตกลงที่ดีที่สุดต่อโทเค็นที่โมเดล Max เคยเสนอมา ตั้งการแจ้งเตือนในปฏิทินเพื่อตรวจสอบสถานะโปรโมชันรายเดือน และรู้ว่าราคาสำรองของคุณคือ 3.8-Max ที่ $2 / $6 ไม่ใช่ 3.7-Max ที่ราคาปลีก
ลดระดับไปใช้ qwen3.7-plus หาก คุณคำนึงถึงราคาเป็นหลักและงานของคุณเป็นงานประจำ ที่ราคา $0.4 / $1.6 มันถูกกว่า 3.8-Max ถึง 5 เท่าในส่วนของอินพุต และสำหรับการจำแนกประเภท การสกัดข้อมูล และการสร้างข้อความตามเทมเพลต ความสามารถระดับ Max มักจะเป็นการใช้จ่ายที่สิ้นเปลือง
ทดสอบการสลับก่อนที่คุณจะตัดสินใจ
ผลการทดสอบของผู้ขาย แม้ว่าจะมีความสอดคล้องกันภายในองค์กร ก็ไม่สามารถทำนายได้ว่าโมเดลจะทำงานอย่างไรกับ prompt ของคุณ วิธีที่ง่ายและประหยัดในการตัดสินใจคือการเปรียบเทียบแบบเคียงข้างกันกับปริมาณงานจริงของคุณ
ใน Apidog คุณสามารถตั้งค่านี้ได้ภายในไม่กี่นาที: ชี้ชุด collection หนึ่งไปยัง Endpoint ที่เข้ากันได้กับ OpenAI ของ Model Studio จากนั้นสร้างสภาพแวดล้อมสองชุดที่แตกต่างกันเฉพาะในตัวแปร ID โมเดล โดยตั้งค่าหนึ่งเป็น qwen3.7-max และอีกชุดเป็น qwen3.8-max เรียกใช้ชุดคำขอเดียวกันกับทั้งสองชุด สลับสภาพแวดล้อมด้วยการคลิกเดียว และเปรียบเทียบเอาต์พุต ความหน่วง และการใช้โทเค็นจากตัวแสดงการตอบกลับ เนื่องจากโมเดลทั้งสองใช้พื้นผิว API เดียวกัน ชุด collection เดียวจึงครอบคลุมทั้งคู่ และคุณสามารถบันทึก prompt การผลิตที่เป็นตัวแทนเป็น scenarios การทดสอบและเรียกใช้ซ้ำได้ทุกครั้งที่ Alibaba ออกอัปเดตหรือราคาโปรโมชันเปลี่ยนแปลง
นั่นจะเปลี่ยนคำถามที่ว่า "เราควรอัปเกรดหรือไม่?" จากการถกเถียงเรื่องผลการทดสอบให้กลายเป็นหลักฐานในช่วงบ่าย ดาวน์โหลด Apidog ฟรีและทำการเปรียบเทียบกับปริมาณงานของคุณเองก่อนที่คุณจะเปลี่ยนการกำหนดค่าการผลิต
คำถามที่พบบ่อย
Qwen 3.8-Max ถูกกว่า Qwen 3.7-Max หรือไม่?
ที่ราคาปลีก ใช่: $2 / $6 เทียบกับ $2.5 / $7.5 ต่อ 1M โทเค็น แต่ที่ราคาจริงในปัจจุบัน ไม่: โปรโมชัน 50% แบบจำกัดเวลาของ 3.7-Max ทำให้ราคาอยู่ที่ $1.25 / $3.75 ซึ่งถูกกว่า 3.8-Max ถึง 38% โปรโมชันไม่มีวันสิ้นสุดที่เผยแพร่ไว้ รายละเอียดต้นทุนทั้งหมดอยู่ใน คู่มือราคา Qwen 3.8 ของเรา
ฉันจำเป็นต้องเปลี่ยนโค้ดเพื่อสลับจาก qwen3.7-max เป็น qwen3.8-max หรือไม่?
สำหรับการใช้งานพื้นฐาน ไม่จำเป็น โมเดลทั้งสองให้บริการผ่าน Endpoint ของ Model Studio ที่เข้ากันได้กับ OpenAI เหมือนกัน ดังนั้นการสลับจึงเป็นการเปลี่ยนแค่ ID โมเดล คุณอาจต้องการตั้งค่า reasoning_effort อย่างชัดเจน เนื่องจาก 3.8-Max จะตั้งค่าเริ่มต้นเป็น xhigh และโทเค็น "ความคิด" จะถูกคิดค่าใช้จ่ายเป็นเอาต์พุต หากคุณส่งภาพ นั่นเป็นความสามารถเฉพาะของ 3.8-Max และต้องใช้รูปแบบข้อความอินพุตภาพมาตรฐาน
Qwen 3.7-Max มีน้ำหนักโมเดลแบบเปิดหรือไม่?
ไม่ และจะไม่เคยมีเลยจากประวัติของ Alibaba กับโมเดลสายนี้ Qwen 3.8-Max เป็นโมเดลคลาส Max ตัวแรกที่มีคำมั่นสัญญาว่าจะเปิดน้ำหนักโมเดล ซึ่งคาดว่าจะเปิดตัวบน Hugging Face และ ModelScope ประมาณวันที่ 10 สิงหาคม 2026 ณ วันที่ 3 สิงหาคม ยังไม่สามารถดาวน์โหลดได้
ตอนนี้ Qwen 3.8-Max ดีกว่า Claude หรือ GPT แล้วหรือยัง?
ขึ้นอยู่กับประเภทงาน และโปรดจำไว้ว่านี่คือตัวเลขของ Alibaba เอง ในตารางของพวกเขา 3.8-Max ชนะ Opus 4.8 และ Fable 5 ใน Terminal Bench 2.1 และนำหน้าทุกคนใน PaperBench และ IFBench มันตามหลัง Fable 5 อย่างมากใน SWE-bench Pro (67.7 เทียบกับ 80.0) และตามหลังโมเดลแนวหน้าทุกคนใน HLE ยังไม่มีผลการทดสอบอิสระ ดังนั้นโปรดรอการตัดสินขั้นสุดท้ายจนกว่าผลการประเมินจากบุคคลที่สามจะออกมา