
คำถามเกี่ยวกับ Postman collections vs OpenAPI spec จะเกิดขึ้นทุกครั้งที่ทีมมีวิศวกรเพิ่มขึ้นมากกว่าสองสามคน คุณเปิดคอลเลกชันที่คุณเขียนไว้เมื่อหกเดือนก่อนแล้วพบว่ามันอธิบายถึง endpoint ที่ตอนนี้มีฟิลด์บังคับเพิ่มมาสามฟิลด์, พารามิเตอร์ที่เลิกใช้แล้วสองรายการ, และรูปแบบการตอบกลับที่ไม่ตรงกับสิ่งที่เซิร์ฟเวอร์ส่งคืนมาจริงอีกต่อไป OpenAPI spec ใน Git ระบุไว้อีกอย่าง Swagger UI ของคุณก็ระบุไว้อีกอย่าง ไม่มีใครแน่ใจว่าอันไหนถูกต้อง
ความคลาดเคลื่อนนั้นไม่ใช่ความล้มเหลวของเครื่องมือ หากแต่เป็นความล้มเหลวของเวิร์กโฟลว์ และความแตกต่างนี้มีความสำคัญ Postman เป็นเครื่องมือที่ยอดเยี่ยมสำหรับการดำเนินการคำขอ (request execution), การเขียนสคริปต์, และการทดสอบแบบสำรวจ (exploratory testing) ปัญหาคือเมื่อทีมปฏิบัติต่อคอลเลกชันว่าเป็น API contract เอง แทนที่จะเป็นเพียงส่วนหนึ่งที่ได้มาจาก contract นั้น
เหตุใดคอลเลกชันจึงเกิดความคลาดเคลื่อนตั้งแต่แรก
คอลเลกชัน Postman เป็นสิ่งประดิษฐ์ที่เน้นคำขอเป็นอันดับแรก คุณส่งคำขอ, สังเกตการตอบกลับ, แล้วบันทึกไว้ เมื่อเวลาผ่านไป คุณจะเพิ่มสคริปต์ก่อนคำขอ (pre-request scripts), การแทนที่ตัวแปร (variable substitutions), การยืนยันการทดสอบ (test assertions), และโครงสร้างโฟลเดอร์ที่สะท้อนถึงวิธีที่ทีมของคุณคิดเกี่ยวกับ API ไม่ใช่สิ่งที่ API ระบุไว้อย่างเป็นทางการเสมอไป
ในทางตรงกันข้าม OpenAPI spec ของคุณเป็นสิ่งประดิษฐ์ที่เน้นสัญญาเป็นอันดับแรก มันประกาศเส้นทาง, พารามิเตอร์, สคีมา, และประเภทการตอบกลับในรูปแบบที่เครื่องอ่านได้ ซึ่งเครื่องมือสามารถตรวจสอบ, จำลอง, และสร้างโค้ดจากมันได้
สิ่งประดิษฐ์ทั้งสองตอบคำถามที่ต่างกัน คอลเลกชันตอบว่า "ฉันจะเรียกใช้ endpoint นี้ได้อย่างไรในวันนี้?" Spec ตอบว่า "API นี้ควรจะทำอะไร?" เมื่อทีมดูแลทั้งสองอย่างแยกกัน มันก็จะเกิดความแตกต่างกันอย่างหลีกเลี่ยงไม่ได้ นักพัฒนาคนหนึ่งอัปเดต spec เมื่อรวม pull request อีกคนหนึ่งอัปเดตคอลเลกชันเมื่อพบว่าการทดสอบเสีย ไม่มีใครรวมมันเข้าด้วยกัน ภายในไม่กี่เดือน คุณก็จะมีคำอธิบาย API เดียวกันสองชุดที่ถูกต้องบางส่วน และไม่มีวิธีที่เชื่อถือได้ที่จะบอกได้ว่าอันไหนเป็นปัจจุบันมากกว่า
หลักฐานจากลูกค้าสำหรับรูปแบบนี้ชัดเจน Inventis Korea รายงานปัญหานี้อย่างชัดเจน: ทีมของพวกเขาสร้าง API, สร้าง OpenAPI spec สำหรับ Swagger, นำเข้าคอลเลกชันไปยัง Postman สำหรับการทดสอบ, แล้วใช้ความพยายามอย่างต่อเนื่องในการทำให้สามตัวแทนนี้ซิงค์กัน การทดสอบพลาดกรณีขอบ (edge cases) เนื่องจากคอลเลกชันไม่ได้สะท้อนถึงสคีมาทั้งหมด เอกสารประกอบเกิดความคลาดเคลื่อนเนื่องจาก spec ไม่ได้เป็นข้อมูลป้อนเข้าในการสร้างการทดสอบ นี่ไม่ใช่กรณีขอบ แต่มันเป็นผลลัพธ์ที่คาดเดาได้ของเวิร์กโฟลว์ที่เน้นคำขอเป็นอันดับแรกในระดับใหญ่
สาเหตุหลัก: Postman ไม่ได้ถูกออกแบบมาให้เป็นที่เก็บ spec
Postman collections มีรูปแบบของตัวเอง Postman collection schema เป็นโครงสร้าง JSON ที่เป็นกรรมสิทธิ์ซึ่งอธิบายคำขอ, สคริปต์, และลำดับชั้นของโฟลเดอร์ มันไม่ใช่ OpenAPI Postman สามารถนำเข้าและส่งออก OpenAPI ได้ แต่การแปลงข้อมูลจะสูญเสียในทั้งสองทิศทาง: OpenAPI เป็น collection จะทิ้งรายละเอียดสคีมาที่ไม่สามารถแสดงออกเป็นคำขอได้; collection เป็น OpenAPI จะทิ้งสคริปต์และข้อมูลที่ไม่สามารถแสดงออกเป็นฟิลด์ spec ได้
นี่ไม่ใช่การวิพากษ์วิจารณ์ Postman มันเป็นการอธิบายว่าเครื่องมือนี้มีไว้เพื่ออะไรจริงๆ Postman เป็นตัวรันคำขอ (request runner) ที่มีฟีเจอร์การทำงานร่วมกันซึ่งสร้างขึ้นรอบๆ โมเดลที่เน้นคำขอ การใช้มันเป็นคำอธิบาย API ที่เป็นมาตรฐานของคุณจำเป็นต้องให้คุณกำหนดโครงสร้างที่รูปแบบนั้นไม่ได้ถูกออกแบบมาเพื่อรองรับ
เปรียบเทียบการแสดงผลทั้งสองสำหรับ single endpoint:
| คุณสมบัติ | Postman collection | OpenAPI spec |
|---|---|---|
| พารามิเตอร์คำขอ | จัดเก็บเป็นคู่คีย์-ค่า พร้อมคำอธิบายเสริม | มีการระบุประเภท, ตรวจสอบความถูกต้อง, พร้อมฟิลด์ required และ schema |
| รูปแบบการตอบกลับ | จับภาพเป็นตัวอย่างที่บันทึกไว้ (ไม่บังคับ) | กำหนดเป็น JSON Schema พร้อมการใช้ $ref ซ้ำในหลายเส้นทาง |
| การตอบกลับข้อผิดพลาด | เพิ่มด้วยตนเองต่อคำขอ | แสดงรายการใน responses พร้อม components/schemas ที่ใช้ร่วมกัน |
| การใช้สคีมาซ้ำ | ไม่มี; คัดลอก-วางระหว่างคำขอ | $ref ไปยัง components/schemas ถูกบังคับใช้โดยตัวตรวจสอบ |
| สัญญาที่เครื่องอ่านได้ | ไม่ | ใช่; เครื่องมือสามารถสร้างเซิร์ฟเวอร์, ไคลเอนต์, การจำลอง |
| เป็นมิตรกับการเปรียบเทียบ Git | JSON ที่มี ID ที่ไม่ชัดเจน; ตรวจสอบความหมายได้ยาก | YAML; การเปรียบเทียบความแตกต่างระดับบรรทัดที่มีความหมาย |
| Lint และตรวจสอบ | ไม่อยู่ในรูปแบบดั้งเดิม | Spectral, Redocly CLI และอื่นๆ |
ตารางแสดงให้เห็นว่าเหตุใดจึงเกิดความคลาดเคลื่อน: คอลเลกชันไม่สามารถแสดงสัญญาได้อย่างสมบูรณ์ ดังนั้นสัญญาจึงไปอยู่ในที่อื่น และทั้งสองก็จะคลาดเคลื่อนกันทันทีที่มีคนแก้ไขอันใดอันหนึ่งโดยไม่อีกอันหนึ่ง
“Spec-first” หมายถึงอะไรสำหรับทีม Postman
Spec-first ไม่ได้หมายความว่า "ออกแบบทุกอย่างใน YAML ก่อนเขียนโค้ดใดๆ" สำหรับทีมส่วนใหญ่ที่เปลี่ยนจากเวิร์กโฟลว์ที่เน้นคอลเลกชันเป็นหลัก มันหมายถึงการกลับทิศทางของการพึ่งพา ระเบียบวิธี spec-first จะวางเอกสาร OpenAPI ใน Git เป็นคำอธิบายที่เชื่อถือได้ของ API สิ่งประดิษฐ์อื่นๆ ทั้งหมด รวมถึงคอลเลกชันที่คุณใช้สำหรับการทดสอบ มาจากเอกสารนั้น ไม่ใช่ในทางกลับกัน
ในทางปฏิบัติ เวิร์กโฟลว์จะเป็นดังนี้:
- Spec ถูกคอมมิตไปยัง Git และตรวจสอบเป็นส่วนหนึ่งของกระบวนการ PR
- การทดสอบ, การจำลอง (mocks), และเอกสารประกอบถูกสร้างขึ้นจาก spec
- เมื่อ API เปลี่ยนแปลง spec จะเปลี่ยนก่อน สิ่งประดิษฐ์ปลายน้ำจะอัปเดตโดยอัตโนมัติหรือผ่านเครื่องมือ
- คอลเลกชันที่ทีมของคุณใช้สำหรับการทดสอบเชิงสำรวจจะถูกสร้างขึ้นจาก spec ดังนั้นจึงสะท้อนถึงสัญญาปัจจุบันเสมอ
คอลเลกชันยังคงอยู่ที่นั่น สคริปต์ของคุณ, การทดสอบที่ขับเคลื่อนด้วยข้อมูล, และตัวแปรสภาพแวดล้อมยังคงอยู่ที่นั่น ความแตกต่างคือคอลเลกชันอยู่ปลายน้ำของ spec ไม่ใช่ต้นน้ำ เมื่อมีฟิลด์ใหม่ปรากฏใน spec มันก็จะปรากฏในคอลเลกชันที่สร้างขึ้น เมื่อฟิลด์ถูกลบออกจาก spec การทดสอบจะล้มเหลวเพราะคำขอที่สร้างขึ้นไม่มีฟิลด์นั้นอีกต่อไป ความคลาดเคลื่อนกลายเป็นความล้มเหลวของ CI ไม่ใช่การค้นพบในอีกหกเดือนต่อมา
วิธีสร้างคอลเลกชันจาก spec ของคุณ
มีหลายวิธีในการดึงคอลเลกชันที่เข้ากันได้กับ Postman จาก OpenAPI spec นี่คือหนึ่งในนั้นที่ทำงานร่วมกับ Redocly CLI:
# ติดตั้ง Redocly CLI
npm install -g @redocly/cli

# ตรวจสอบ spec ก่อน
redocly lint openapi/petstore.yaml

# รวม spec (แก้ไข $ref chains)
redocly bundle openapi/petstore.yaml -o dist/petstore-bundled.yaml

# แปลงเป็น Postman collection v2.1 โดยใช้ไลบรารี openapi-to-postmanv2
npm install -g openapi-to-postmanv2

openapi2postmanv2 \
  --spec dist/petstore-bundled.yaml \
  --output dist/petstore-collection.json \
  --prettyPrint
ผลลัพธ์ที่ได้คือ Postman collection JSON มาตรฐาน คุณสามารถนำเข้ามันไปยัง Postman หรือใช้เป็นคอลเลกชันพื้นฐานใน Newman หรือ Postman CLI สคริปต์ก่อนคำขอ (pre-request scripts) และตัวแปรสภาพแวดล้อมของคุณยังคงเป็นไฟล์แยกต่างหากที่คุณดูแลอย่างอิสระ พวกมันจะไม่ถูกเขียนทับเมื่อคุณสร้างคอลเลกชันใหม่จาก spec ที่อัปเดต
คุณสามารถเชื่อมโยงสิ่งนี้เข้ากับ CI เพื่อให้คอลเลกชันถูกสร้างขึ้นใหม่จาก spec เสมอก่อนที่จะรันการทดสอบ:
# .github/workflows/api-tests.yml
name: การทดสอบสัญญา API

on:
  push:
    paths:
      - "openapi/**"
      - "src/**"

jobs:
  test:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4

      - name: ติดตั้ง dependency
        run: |
          npm install -g @redocly/cli openapi-to-postmanv2 newman

      - name: ตรวจสอบ OpenAPI spec
        run: redocly lint openapi/petstore.yaml

      - name: สร้าง collection จาก spec
        run: |
          redocly bundle openapi/petstore.yaml -o dist/petstore-bundled.yaml
          openapi2postmanv2 \
            --spec dist/petstore-bundled.yaml \
            --output dist/petstore-collection.json

      - name: รันการทดสอบด้วย collection ที่สร้างขึ้น
        run: |
          newman run dist/petstore-collection.json \
            --environment config/env-staging.json \
            --reporters cli,junit \
            --reporter-junit-export results/test-results.xml

      - name: อัปโหลดผลการทดสอบ
        uses: actions/upload-artifact@v4
        with:
          name: test-results
          path: results/
ด้วยรูปแบบนี้ spec จะเป็นข้อมูลป้อนเข้าของการรันการทดสอบทุกครั้ง การเปลี่ยนแปลง spec ที่ทำให้การทดสอบล้มเหลวจะถูกตรวจพบใน PR เดียวกันกับการเปลี่ยนแปลง spec นั้น
Apidog เข้ามามีบทบาทในเวิร์กโฟลว์นี้ได้อย่างไร
คุณค่าของ Apidog ไม่ใช่การที่มันมาแทนที่ Postman ในฐานะ request runner แต่เป็นการที่มันเชื่อมโยง OpenAPI spec เข้ากับสิ่งประดิษฐ์อื่นๆ ที่ทีมของคุณทำงานด้วย โดยไม่ต้องมีขั้นตอนการแปลงด้วยตนเอง Spec ใน Git ยังคงเป็นแหล่งข้อมูลที่แท้จริง Apidog เป็นชั้นสำหรับการทำงานร่วมกันและการดำเนินการที่อยู่บนสุดของมัน
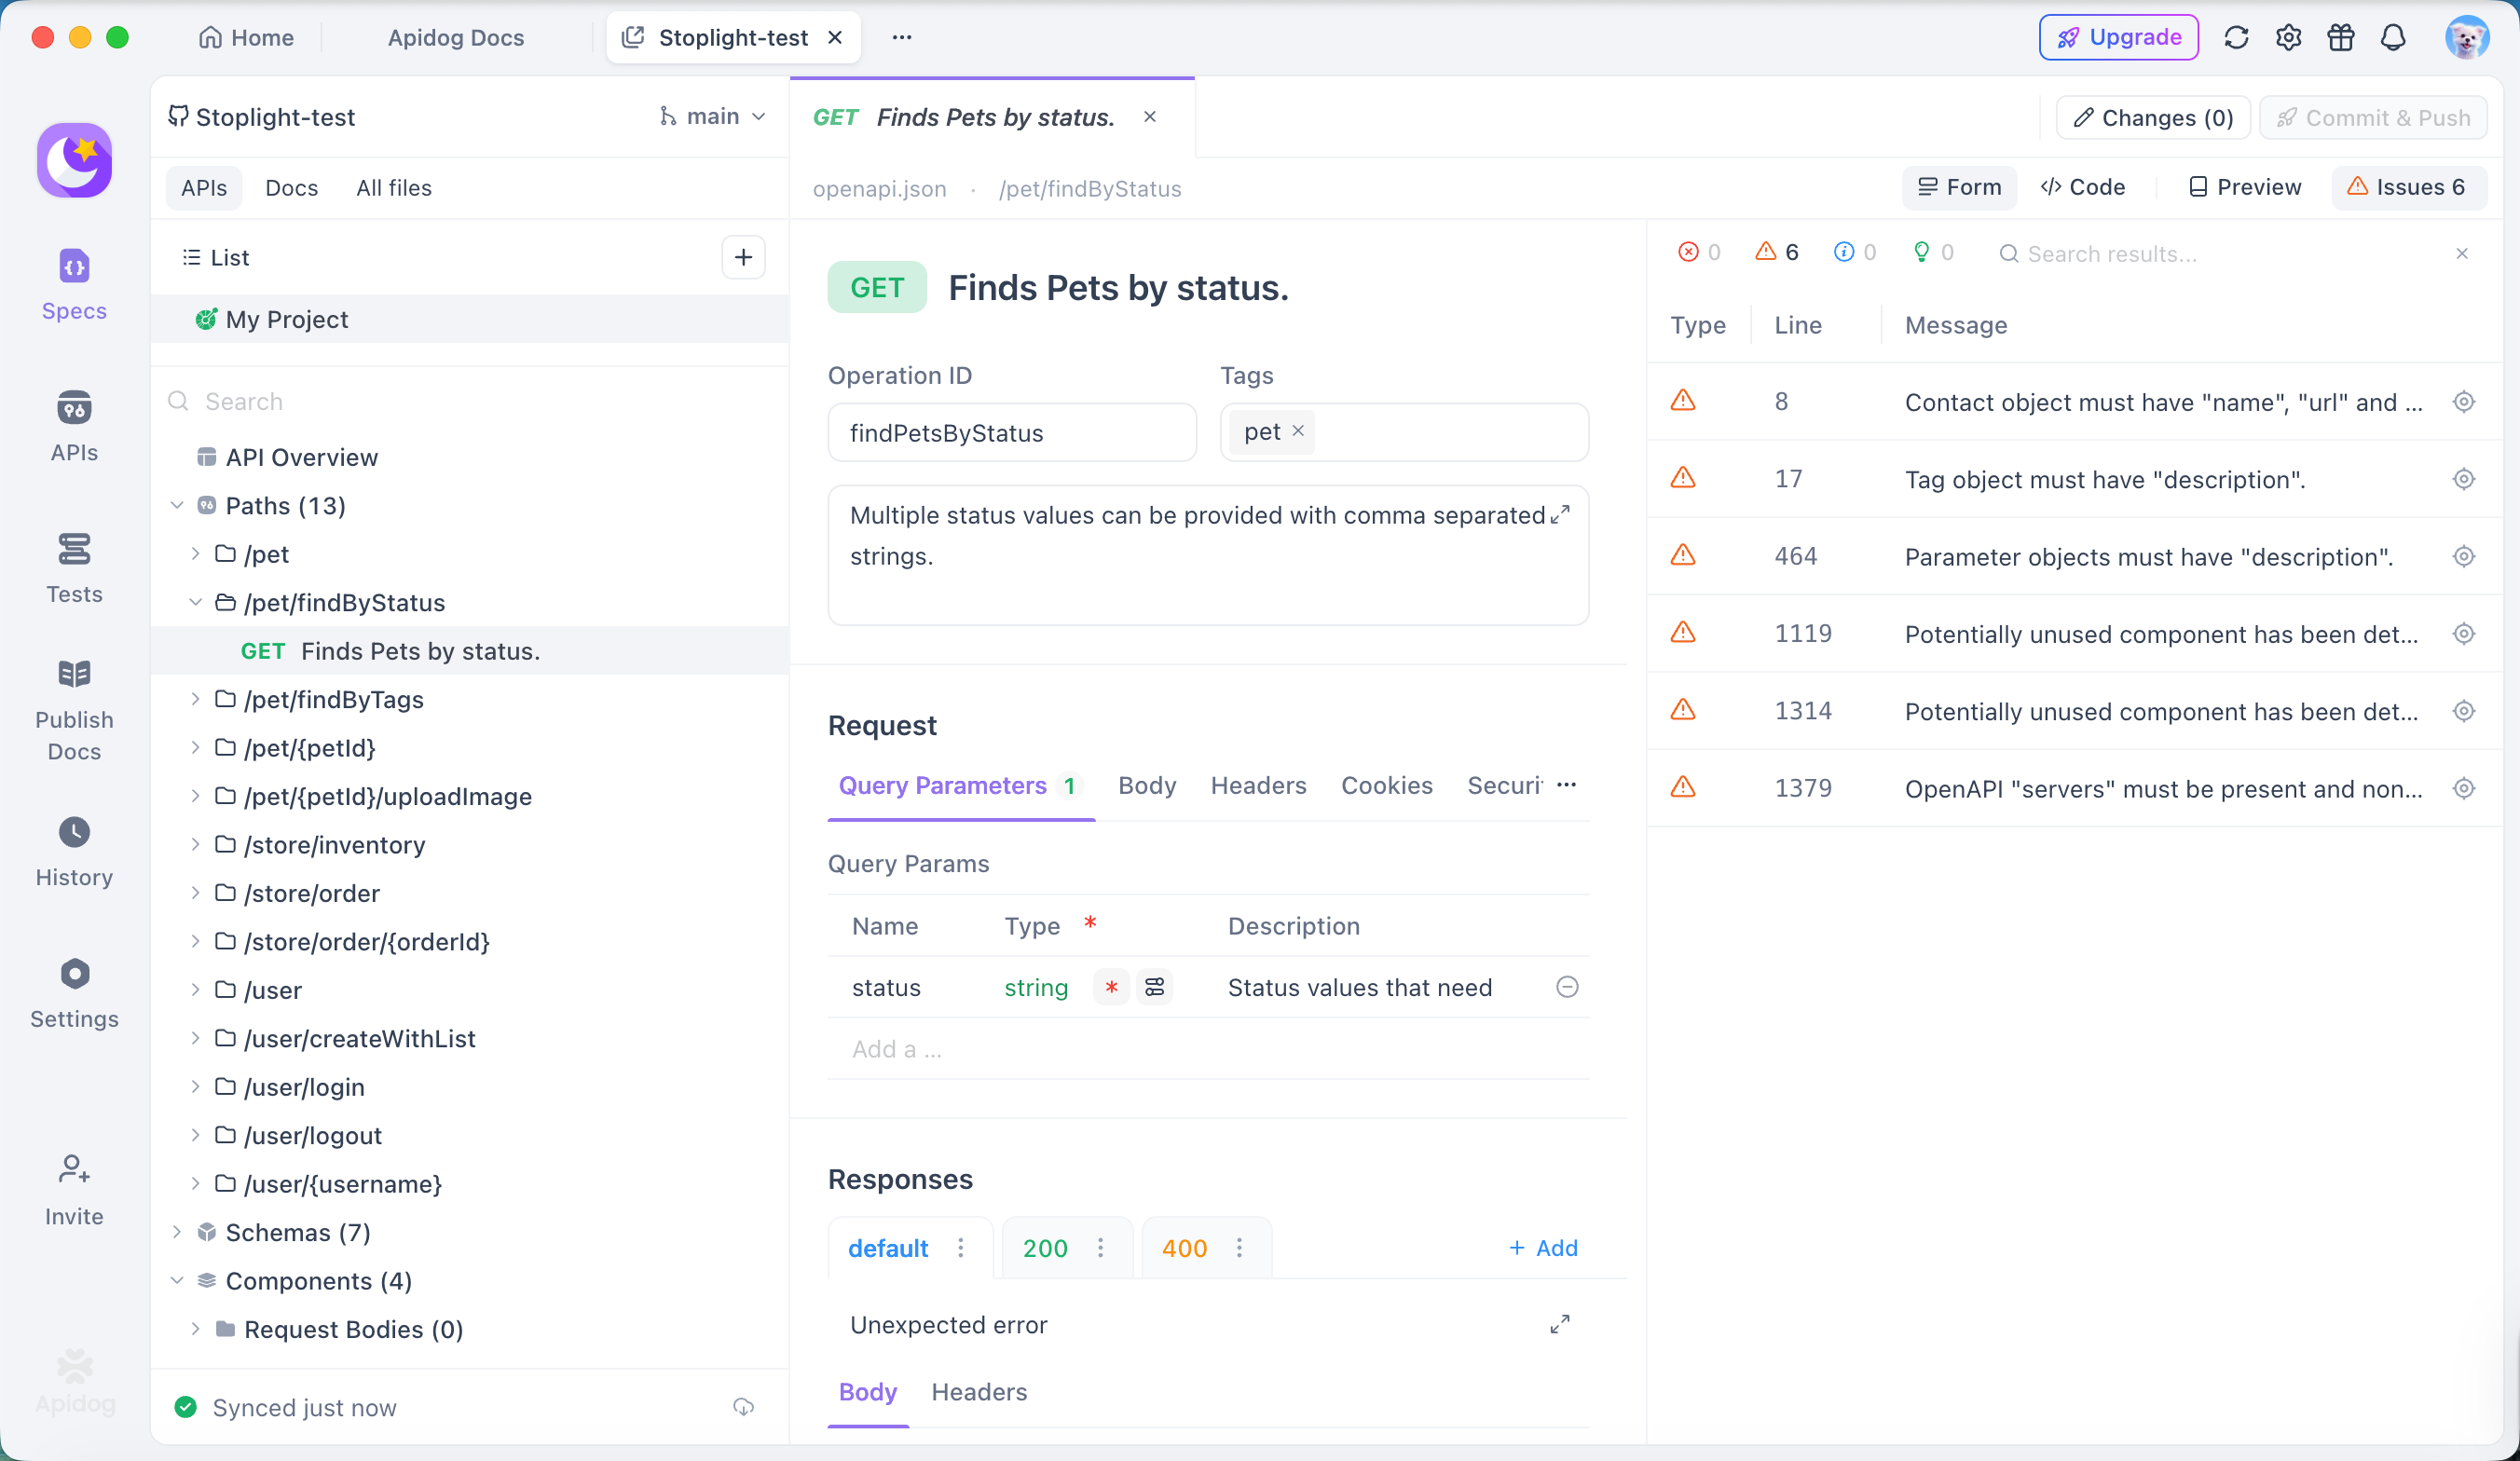
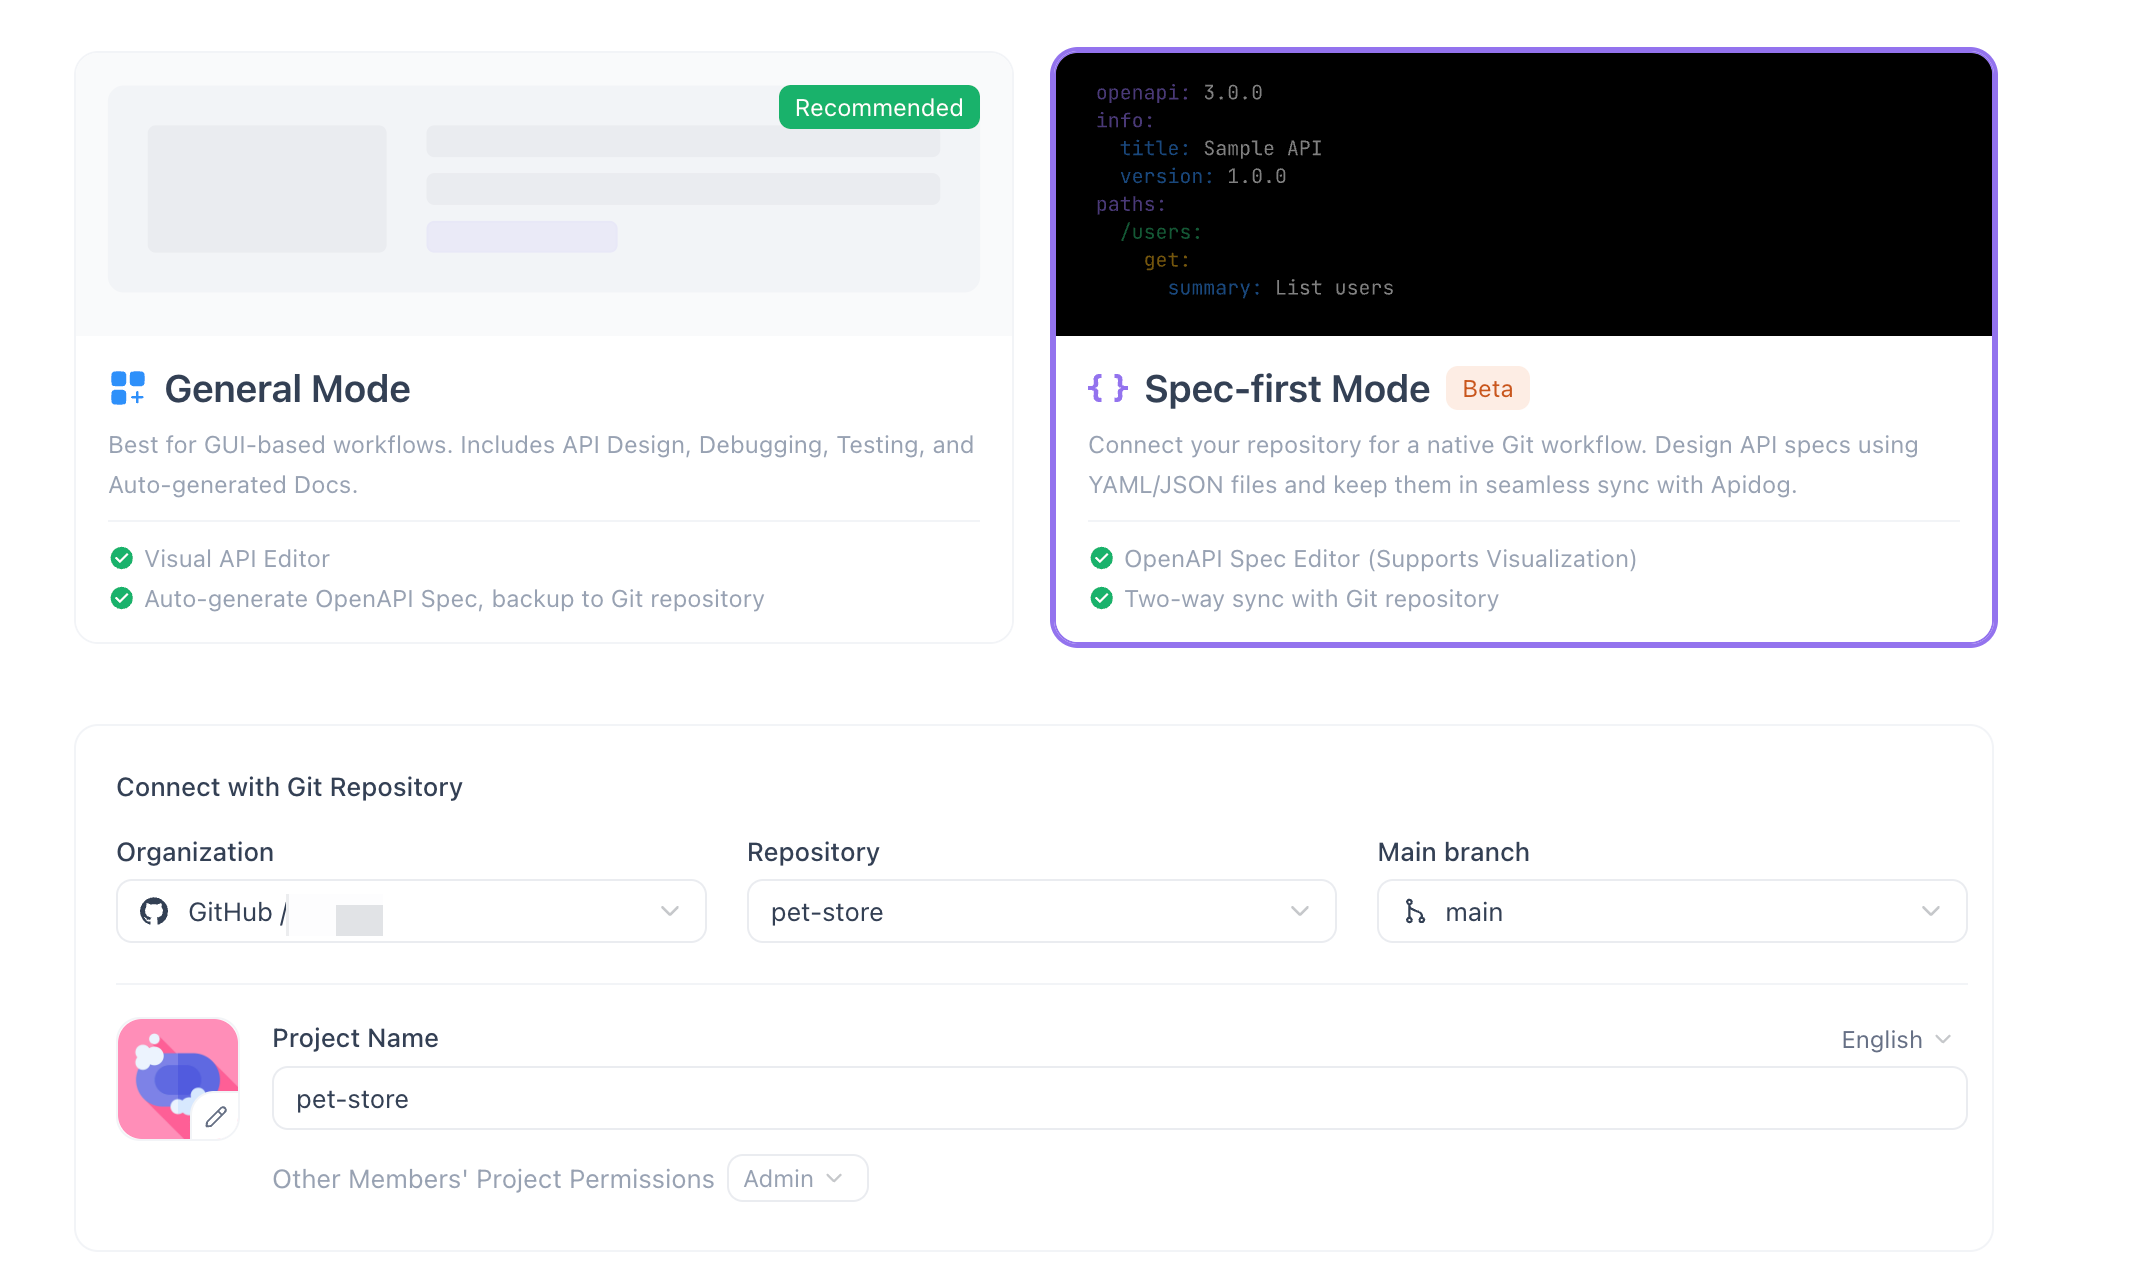
Apidog’s Spec-First Mode (ปัจจุบันอยู่ในช่วงเบต้า) ช่วยให้คุณซิงค์ OpenAPI spec จาก Git repository เข้าสู่ Apidog workspace ได้โดยตรง จาก spec ที่ซิงค์นั้น คุณจะได้รับการจำลองที่สร้างขึ้นโดยอัตโนมัติ (auto-generated mocks), เอกสารประกอบเชิงโต้ตอบ (interactive documentation), และสถานการณ์การทดสอบ (test scenarios) ซึ่งทั้งหมดจะอัปเดตโดยอัตโนมัติเมื่อ spec เปลี่ยนแปลงใน Git คุณไม่จำเป็นต้องดูแลคอลเลกชันแยกต่างหากควบคู่ไปกับ spec แต่ spec จะเป็นตัวขับเคลื่อนสิ่งที่ Apidog แสดงและดำเนินการ
สิ่งนี้มีความสำคัญสำหรับทีมที่ประสบปัญหาตามที่ STC Group และ World Economic Forum ได้อธิบายไว้: การดูแล Postman สำหรับการทดสอบ, เครื่องมือเอกสารประกอบแยกต่างหากสำหรับการแสดงผล spec, และ mock server สำหรับการพัฒนาส่วนหน้า (frontend development) ซึ่งเป็นสามระบบที่ทั้งหมดต้องสะท้อนถึง API contract เดียวกัน เมื่อ spec เปลี่ยนแปลง คุณจะอัปเดตในที่เดียวและทั้งสามส่วนก็จะอัปเดต ควรค่าแก่การตรวจสอบในการทดลองว่าสิทธิ์การเข้าถึง workspace ของ Apidog และความละเอียดของการเข้าสู่ระบบครั้งเดียว (SSO granularity) ตรงตามข้อกำหนดการควบคุมการเข้าถึงเฉพาะของคุณหรือไม่ โดยเฉพาะอย่างยิ่งสำหรับทีมขนาดใหญ่เช่นการปรับใช้ของ DHL ที่อธิบายไว้ (ผู้ใช้ 100+ คน) สิ่งเหล่านี้เป็นคำถามประเมินที่มีความหมายสำหรับ proof of concept
สำหรับเส้นทางการย้ายข้อมูล คุณสามารถ แปลง Postman collections ที่มีอยู่ของคุณเป็น Apidog เป็นจุดเริ่มต้น จากนั้นกำหนดให้ spec เป็นเอกสารหลักนับจากนี้เป็นต้นไป ขั้นตอนการนำเข้าเชิงกลได้กล่าวถึงโดยละเอียดในคู่มือที่เชื่อมโยงนั้น
การปฏิบัติต่อ spec เหมือนโค้ดในเวิร์กโฟลว์ Git ของคุณ
แนวทาง api-spec-as-code หมายความว่าเอกสาร OpenAPI ได้รับการปฏิบัติเช่นเดียวกับโค้ดแอปพลิเคชัน: pull requests, การตรวจสอบโค้ด, การ linting ใน CI, และแท็กเวอร์ชันที่ขอบเขตการเผยแพร่ ทีมส่วนใหญ่พบว่าพวกเขามีโครงสร้างพื้นฐานสำหรับสิ่งนี้อยู่แล้ว ขั้นตอนที่ขาดหายไปคือการนำไปใช้กับไฟล์ spec
แนวทางปฏิบัติบางประการที่ช่วยได้:
- จัดเก็บ spec ไว้ใน repository เดียวกันกับบริการที่อธิบาย ไม่ใช่ใน repo "docs" แยกต่างหาก สิ่งนี้ทำให้มั่นใจว่าการเปลี่ยนแปลง spec เกิดขึ้นใน PR เดียวกันกับการเปลี่ยนแปลงโค้ด
- เพิ่มขั้นตอนการตรวจสอบ Spectral lint ให้กับ CI pipeline ของคุณ Spectral จะตรวจสอบ spec เทียบกับ ข้อกำหนด OpenAPI และกฎที่ทีมของคุณกำหนดไว้ การอ้างอิงสคีมาที่เสีย, คำอธิบายที่หายไป, และการตั้งชื่อที่ไม่สอดคล้องกันจะกลายเป็นความล้มเหลวของ CI ไม่ใช่ความคิดเห็นในการตรวจสอบ
- ใช้การพัฒนา spec แบบ branch-based สำหรับการเปลี่ยนแปลงที่ทำให้เกิดการหยุดทำงาน (breaking changes) ในลักษณะเดียวกับการ branch โค้ดแอปพลิเคชัน Apidog workspaces รองรับการ branching บน spec ดังนั้นทีมต่างๆ สามารถทำงานกับ stable branch ได้ในขณะที่การเปลี่ยนแปลงที่ทำให้เกิดการหยุดทำงานกำลังอยู่ระหว่างการตรวจสอบ
- ปักหมุดเวอร์ชัน spec ใน repository ของผู้บริโภคปลายน้ำ เมื่อบริการ B ขึ้นอยู่กับ spec ของบริการ A สำหรับการทดสอบสัญญา ควรจะอ้างอิงแท็กเวอร์ชันเฉพาะ ไม่ใช่ HEAD ของ main
แนวทางนี้ได้อธิบายไว้โดยละเอียดใน คู่มือเวิร์กโฟลว์ API แบบ git-native หากคุณต้องการการตั้งค่าทีละขั้นตอนสำหรับโปรเจกต์ใหม่
คำถามที่พบบ่อย
ฉันต้องเลิกใช้ Postman ไปเลยหรือไม่?
ไม่ การเปลี่ยนแปลงระเบียบวิธีนี้เป็นเรื่องของทิศทางการพึ่งพา ไม่ใช่การเปลี่ยนเครื่องมือ คุณยังคงสามารถใช้ Postman สำหรับการทดสอบแบบสำรวจและการเขียนสคริปต์ได้ ความแตกต่างคือคอลเลกชันของคุณถูกสร้างขึ้นจาก spec ก่อนการรันการทดสอบแต่ละครั้ง แทนที่จะถูกดูแลเป็นสิ่งประดิษฐ์แยกต่างหาก หากทีมของคุณชื่นชอบ UI ของ Postman สำหรับงานสำรวจ ความชอบนั้นเข้ากันได้กับเวิร์กโฟลว์แบบ spec-first
จะเกิดอะไรขึ้นกับสคริปต์ Postman และตัวแปรสภาพแวดล้อมที่เรามีอยู่?
สคริปต์ก่อนคำขอ (pre-request scripts), สคริปต์ทดสอบ, และการกำหนดตัวแปรสภาพแวดล้อมของคุณไม่ได้เป็นส่วนหนึ่งของคอลเลกชันที่สร้างขึ้น พวกมันเป็นไฟล์แยกต่างหากที่คุณดูแลอย่างอิสระ เมื่อคุณสร้างคอลเลกชันใหม่จาก spec ที่อัปเดต สคริปต์จะไม่ถูกเขียนทับ คุณยังคงรักษาเลเยอร์พฤติกรรม (สคริปต์) ไว้ ในขณะที่เลเยอร์โครงสร้าง (การกำหนดคำขอ) จะมาจาก spec เสมอ
ฉันจะจัดการกับ endpoints ที่ยังไม่ได้อยู่ใน spec ได้อย่างไร?
ในเวิร์กโฟลว์แบบ spec-first, endpoint ที่ไม่อยู่ใน spec จะยังไม่พร้อมสำหรับการทดสอบ ฟังดูเข้มงวด แต่นั่นคือประเด็น: ตัวควบคุม spec ทำให้มั่นใจว่า endpoints ใหม่ได้รับการอธิบายอย่างเป็นทางการก่อนที่จะมีการเขียนการทดสอบสำหรับพวกมัน สำหรับการพัฒนาเชิงสำรวจ คุณสามารถทำงานกับ local stub และเพิ่มรายการ spec เป็นส่วนหนึ่งของ PR ที่แนะนำ endpoint นั้น ดู คู่มือเครื่องมือตรวจสอบ OpenAPI ที่ดีที่สุด สำหรับเครื่องมือที่ช่วยให้ขั้นตอนการแก้ไขแบบ spec-first เร็วขึ้น
Apidog Spec-First Mode พร้อมใช้งานแล้วหรือยัง?
Apidog Spec-First Mode กำลังอยู่ในช่วงเบต้า คุณสามารถเข้าถึงได้ผ่าน Apidog และประเมินว่าเวิร์กโฟลว์ Git-sync, การรองรับ branch, และการจำลองที่สร้างขึ้นโดยอัตโนมัติ (auto-generated mocks) ตรงตามความต้องการของทีมคุณหรือไม่ เช่นเดียวกับฟีเจอร์เบต้าอื่นๆ ควรทดสอบกับโครงสร้าง spec เฉพาะของคุณก่อนที่จะนำไปใช้เป็นเวิร์กโฟลว์การผลิต
ความแตกต่างระหว่างวิธีนี้กับการนำเข้า spec ของฉันไปใน Postman คืออะไร?
Postman สามารถนำเข้า OpenAPI spec และสร้างคอลเลกชันจากมันได้ นั่นคือการแปลงเพียงครั้งเดียว จากนั้นคอลเลกชันจะถูกดูแลอย่างอิสระจาก spec ทำให้เกิดความคลาดเคลื่อนขึ้นอีกครั้งทันที เวิร์กโฟลว์แบบ spec-first จะสร้างคอลเลกชันใหม่จาก spec ในทุกๆ การรัน CI (หรือการซิงค์) ดังนั้นคอลเลกชันจะไม่ล้าหลัง spec เกินกว่าหนึ่งบิลด์
สรุป
ปัญหาความคลาดเคลื่อนที่ทีมของคุณกำลังเจอไม่ใช่ข้อบกพร่องใน Postman แต่มันเป็นผลลัพธ์ที่คาดเดาได้จากการดูแลคำอธิบาย API สองชุดที่ทับซ้อนกันบางส่วนโดยไม่มีการพึ่งพาที่ชัดเจนระหว่างกัน วิธีแก้ไขคือการกำหนดให้ OpenAPI spec ใน Git เป็นแหล่งข้อมูลที่เชื่อถือได้ และปฏิบัติต่อ Postman collection เป็นสิ่งประดิษฐ์ที่ถูกสร้างขึ้นและอยู่ปลายน้ำของ spec นั้น
การกลับทิศทางนั้นเปลี่ยนสิ่งที่เสียไปและเวลาที่เสียไป การเปลี่ยนแปลง spec ที่ทำให้การทดสอบล้มเหลวจะถูกตรวจพบใน PR ที่ทำการเปลี่ยนแปลงนั้น เอกสารประกอบ, การจำลอง (mocks), และสถานการณ์การทดสอบยังคงสอดคล้องกันเนื่องจากทั้งหมดอ่านจากแหล่งข้อมูลเดียวกัน ภาระการบำรุงรักษาในการรักษาสองระบบให้ซิงค์กันจะหายไปเพราะมีเพียงระบบเดียว
ดาวน์โหลด Apidog และเปิด Spec-First Mode workspace ด้วย OpenAPI spec ที่มีอยู่ของคุณ หากคุณเริ่มต้นจากคอลเลกชันแทนที่จะเป็น spec คุณสามารถนำเข้าคอลเลกชันนั้นเป็นจุดเริ่มต้นของ OpenAPI แล้วทำงานแบบ spec-forward จากตรงนั้น เวิร์กโฟลว์ Git-sync จะเป็นรูปธรรมมากขึ้นเมื่อคุณเห็นมันทำงานกับ API ของคุณเอง แทนที่จะเป็นเพียงตัวอย่างที่ประดิษฐ์ขึ้นมา