
Jev คือ System One Model ของ TypeSafe AI: คุณส่งสถานะโปรแกรมพร้อมคำถามที่ระบุประเภทให้ แล้วมันจะส่งการตัดสินใจพร้อมความน่าจะเป็นที่ปรับเทียบแล้วแทนที่จะเป็นข้อความบรรยาย (นี่คือ Jev ที่เป็นโมเดล ไม่ใช่ FaZe Jev สตรีมเมอร์ หรือวัคซีน JEV) เป็นโมเดลแบบปิดน้ำหนัก (closed weights), ใช้ได้เฉพาะ API เท่านั้น, ให้บริการที่ POST https://api.typesafe.ai/v1/systemone ในชื่อ jev-latest ดังนั้นคำว่า “รัน Jev แบบโลคอล” จึงหมายถึง Jev โดยตรงไม่ได้ แต่หมายถึงกลุ่มโปรเจกต์โอเพนซอร์สของชุมชนที่สร้างขึ้นมาไม่กี่วัน ซึ่งนำโดย OpenJev ที่สร้างแนวคิดนี้ขึ้นมาใหม่ด้วยโมเดลโอเพนซอร์ส หากคุณยังใหม่กับตัวโมเดลเอง โปรดอ่าน Jev คืออะไร ก่อน บทความนี้จะกล่าวถึงการเลียนแบบของมัน
นี่คือบทสรุปและบทตรวจสอบความเป็นจริง: แต่ละ README อ้างว่าอะไร มีความเที่ยงตรงแค่ไหน ต้องการฮาร์ดแวร์แบบใด และจะทดสอบมันผ่าน HTTP endpoint แบบโลคอลใน Apidog ได้อย่างไร เช่นเดียวกับการทดสอบ TypeSafe API ไม่มีโปรเจกต์ใดได้รับการวัดประสิทธิภาพโดยบุคคลที่สาม และไม่มีโปรเจกต์ใดมาจาก TypeSafe
“รัน Jev แบบโลคอล” หมายความว่าอย่างไรได้บ้าง
โพสต์ เปิดตัว ของ TypeSafe อธิบายถึงโมเดลที่ได้รับการฝึกฝนด้วย Reinforcement Learning for Calibrated Decisions (RLCD), มีสามพรีมิทีฟ (noul, choice, score), เวลาตอบสนอง 70ms ถึง 500ms, และราคา $0.042 ต่อล้านโทเค็นอินพุตพร้อมเอาต์พุตฟรี สิ่งเหล่านี้เป็นการกล่าวอ้างจากผู้จำหน่าย สูตรการฝึกฝนยังไม่ได้รับการเผยแพร่ กระทู้ในชุมชนกล่าวว่า Jev ได้รับการฝึกฝนบนข้อมูลสังเคราะห์ 100% ให้ถือว่าเป็นข่าวลือที่ยังไม่ได้รับการยืนยัน
เนื่องจากสูตรเป็นความลับ “Open Jev” ทุกโปรเจกต์จึงใช้ทางลัดหนึ่งในสามวิธีดังนี้:
- อ่านค่า logits จากโมเดลแชทที่ถูกแช่แข็ง. ตั้งคำถามแบบปรนัยให้กับ Qwen ขนาดเล็ก ข้ามการสร้างข้อความ และเปลี่ยนค่า logits ของโทเค็นถัดไปต่อตัวเลือกให้เป็นความน่าจะเป็น OpenJev และ mini-jev ใช้วิธีนี้
- ฝึกฝนโมเดลให้คะแนนขนาดเล็กตั้งแต่เริ่มต้น. โมเดลที่มีหน้าที่เพียงให้คะแนนตัวเลือก N ตัวเทียบกับบริบทในการประมวลผลครั้งเดียว นั่นคือ jevlike
- เปลี่ยนเอนจินการถอดรหัส. ใช้โมเดลพื้นฐานเดิม ประเมินทุกฟิลด์แบบขนานเหนือผู้สมัครที่มีข้อจำกัด นั่นคือเอนจิน Apple Silicon บน Hugging Face และ pull request ของ vLLM
ไม่มีโปรเจกต์ใดที่สามารถสร้าง RLCD ขึ้นมาใหม่ได้ นั่นคือพาดหัวข่าวที่ซื่อสัตย์
OpenJev: อ่านค่า logits จาก Qwen ที่ถูกแช่แข็งบน 3090 หนึ่งตัว
OpenJev ตั้งคำถามว่า “เราสามารถรันบางอย่างที่เหมือน Jev บน 3090 ที่บ้านได้หรือไม่?” และตอบด้วยแพ็คเกจ Python ที่ได้รับอนุญาตภายใต้ MIT README ระบุไว้อย่างละเอียดว่า: มัน “สร้างรูปแบบอินเทอร์เฟซนั้นขึ้นมาใหม่ด้วยโมเดลโอเพนซอร์ส; แต่ไม่ได้สร้างโมเดลหรือการฝึกฝนของ Jev ที่ไม่เปิดเผยข้อมูลขึ้นมาใหม่”
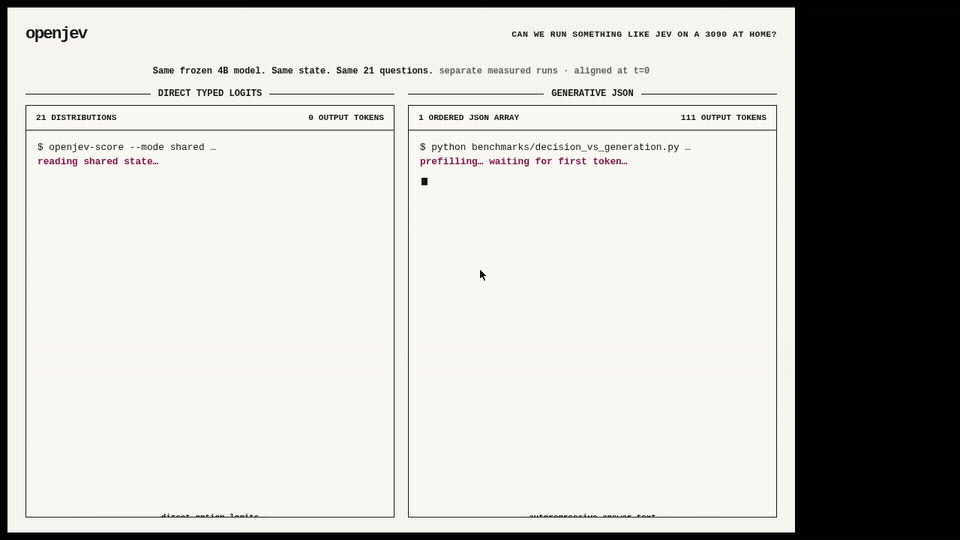
กลไกคือการส่งผ่านข้อมูลไปข้างหน้าครั้งเดียวที่อ่านค่า logits ของตัวเลือกที่ประกาศไว้ โดยไม่มีการสุ่มโทเค็นคำตอบ เกณฑ์และตัวเลือกจะมาพร้อมกับแต่ละคำขอ ดังนั้นจึงไม่มีการปรับแต่งใดๆ ต่อแต่ละงาน โมเดลหลักคือ Qwen3.5-4B
ตัวเลขที่ README รายงานบน RTX 3090 หนึ่งตัวพร้อม Qwen3.5-4B:
- ค่า logits แบบพิมพ์โดยตรง: 1.023 วินาที สำหรับ 21 คู่ความน่าจะเป็น เทียบกับ 5.332 วินาที สำหรับ JSON array แบบ autoregressive หรือช้ากว่า 5.21 เท่า
- บนชุดข้อมูลย่อย TypeSafe จำนวน 102 แถว มีความสอดคล้องแบบ Modal agreement ที่ 0.845 เทียบกับ 0.883 สำหรับ Jev ที่เผยแพร่แล้ว
อินพุตคือ JSONL ที่มี id, state, question, และ array ของ options ที่เป็น {id, description}; เอาต์พุตคือความน่าจะเป็นต่อตัวเลือก ไม่มี HTTP server ใน repo: คุณรัน openjev-score --mode direct --model Qwen/Qwen3.5-4B --input examples/decisions.jsonl, หรือลองเดโม WebGPU ที่ openjev.com ฮาร์ดแวร์: CUDA และ GPU ที่รองรับโมเดล 4B ใน BF16
สิ่งที่ขาดหายไป: ไม่มีพรีมิทีฟ noul หรือ score และความน่าจะเป็นเป็นแบบ softmax เหนือค่า logits ของตัวเลือก ไม่ใช่ความมั่นใจที่ปรับเทียบด้วย RLCD
mini-jev: การศึกษาที่ลงทะเบียนล่วงหน้าพร้อมเซิร์ฟเวอร์โลคอล
mini-jev เป็นการทดลองมากกว่าผลิตภัณฑ์ สโลแกนของมันคือ: “อินเทอร์เฟซแบบ Jev ดูเป็นอย่างไรบน Qwen3-4B ที่ถูกแช่แข็ง โดยอ่านค่า logits ของตัวเลือกตัวอักษรแทนการสร้าง JSON” มันรัน Qwen3-4B-Instruct-2507 บนการจัดประเภทความตั้งใจของ CLINC150 และเปรียบเทียบการสร้าง JSON ที่ถูกจำกัดไวยากรณ์กับการอ่านค่า logit ของตัวเลือกตัวอักษร
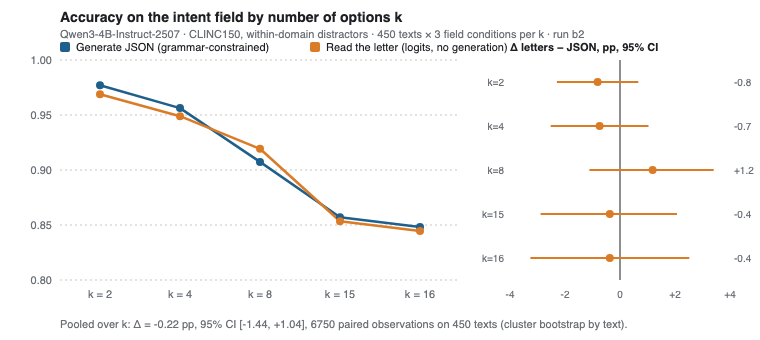
ผลลัพธ์จากการสังเกตการณ์จับคู่ 6,750 ชุด: ความแม่นยำของ JSON อยู่ที่ 0.909, ตัวอักษร 0.907, ความแตกต่าง -0.22 จุด ภายในช่วงความเชื่อมั่น 95% CI ของ [-1.44, +1.04] การอ่านตัวอักษรเร็วกว่าประมาณ 4 เท่าสำหรับข้อความ 32 โทเค็น
README ระบุคำศัพท์ของตนให้ตรงกับของ TypeSafe: choice และ noul คือ “สิ่งที่การศึกษานี้วัดจากโมเดลที่ถูกแช่แข็ง ในฐานะการอ่านตัวอักษรและค่าบูลีน; score (มาตราส่วนแบบเรียงลำดับ) ไม่ได้ถูกวัด” มันเรียกสิ่งนี้ว่า “ความสอดคล้องของคำศัพท์ ไม่ใช่การสร้างโมเดลของพวกเขาขึ้นมาใหม่” และเพิ่มคำเตือนที่ทุกโปรเจกต์ควรนำไปใช้: “การแบ่งปันตัวอักษรเป็นการจัดอันดับที่มีช่องว่างความเชื่อมั่น ไม่ใช่ความน่าจะเป็นที่ปรับเทียบแล้ว”
มันมาพร้อมกับเดโม HTTP MINIJEV_DEVICE=mps uv run python demo/server.py ให้บริการที่ 127.0.0.1:8765 ด้วย POST /run ซึ่งรับ schema และ text และส่งคืน letter, p, gap, และ answer ต่อฟิลด์ มันต้องการหน่วยความจำประมาณ 8.5 GB บน Apple Silicon หรือ NVIDIA GPU MIT, มี 11 ดาวในขณะที่เขียนบทความนี้
jevlike: ตัวให้คะแนนตัวเลือกที่สร้างขึ้นมาใหม่ตั้งแต่เริ่มต้น
jevlike กำลังถูกเผยแพร่ในฐานะ “โมเดลที่เหมือน Jev ที่ถูกวิศวกรรมย้อนกลับ” แต่ README ระบุไว้ต่างกัน: “TypeSafe ไม่ได้เผยแพร่การออกแบบของมัน Repository นี้เป็นโมเดลเริ่มต้นที่เป็นอิสระซึ่งมีรูปร่างอินพุตและเอาต์พุตเดียวกัน” ผู้เขียนเสริมว่าพวกเขา “ไม่ได้แสดงคุณภาพที่เท่าเทียมกับ Jev หรือสร้างวิธีการฝึกฝนที่เป็นส่วนตัวของ TypeSafe ขึ้นมาใหม่”
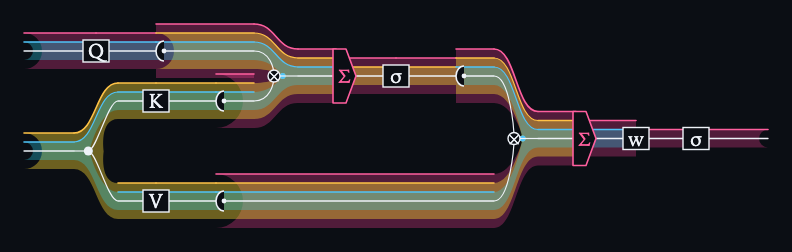
การออกแบบมีขนาดเล็ก แต่ละตัวเลือกจะได้รับเวกเตอร์คำถามที่เชื่อมโยงกับโทเค็นบริบท; ผลคูณดอตที่ใช้ร่วมกันจะให้คะแนนแต่ละคู่; softmax จะเปลี่ยนคะแนนให้เป็นความน่าจะเป็น ตัวเข้ารหัสเริ่มต้นคือ byte embeddings ที่เรียนรู้ตั้งแต่เริ่มต้น โดยมีตัวเข้ารหัส Hugging Face แบบแช่แข็งเป็นทางเลือก
ตัวเลขที่รายงาน: ประมาณ 98% บนเมนูสังเคราะห์, 26% บน Wikispeedia ด้วยตัวเข้ารหัส Qwen2.5-0.5B ที่ถูกแช่แข็ง เทียบกับ 8% ของการควบคุมแบบสุ่ม และการส่งผ่านข้อมูลครั้งเดียว “เร็วกว่าตัวถอดรหัสขนาดเล็กที่ถูกบังคับให้เขียน 400 โทเค็นประมาณ 100 เท่า” มันรันได้บน CPU, MPS, หรือ CUDA MIT, มี 764 ดาว
ความเที่ยงตรงต่ำที่สุดในกลุ่ม คุณฝึกฝนมันด้วยป้ายกำกับของคุณเอง ดังนั้นมันจึงเป็นตัวจัดประเภทที่คุณสร้างขึ้น ไม่ใช่โมเดลการตัดสินใจที่คุณสามารถป้อนเกณฑ์ที่กำหนดเองได้ ไม่มี noul หรือ score, ไม่มีการอ้างสิทธิ์ในการปรับเทียบ, ไม่มี HTTP server
การถอดรหัสแบบจำกัดแบบขนาน: เอนจิน Apple Silicon
Hugging Face Space parallel-constrained-decoding กำลังถูกเผยแพร่ในฐานะ “ทางเลือกโอเพนซอร์สของ Jev จาก Typesafe.ai” แต่ README ไม่เคยกล่าวถึง Jev, TypeSafe หรือ RLCD ชื่อของมันคือ “Parallel Constrained Decoding for Apple Silicon”: เอนจินการอนุมาน MLX สำหรับการแยกโครงสร้างข้อมูลเหนือ mlx-community/Qwen2.5-1.5B-Instruct-4bit โดยสามารถสลับตัวถอดรหัส mlx-lm ใดๆ เข้าไปได้
วิธีการ: เติมบริบทเพียงครั้งเดียวลงในแคช KV, กระจายไปยังทุกฟิลด์ของสคีมา, ประเมินเฉพาะ ID โทเค็นผู้สมัครที่ถูกต้องต่อฟิลด์, ใช้ softmax กับชุดนั้น, และประกอบ JSON ในโค้ด README รายงานบน M4 Max: การคัดกรองการฉ้อโกง 4 ฟิลด์ ใช้เวลา 420 ms แบบ autoregressive เทียบกับ 75 ms แบบขนาน (5.6x), และการคัดกรองการสนับสนุน 28 ฟิลด์ ใช้เวลา 1,900 ms เทียบกับ 270 ms (7.0x) มันอ้างว่ามีความถูกต้องของสคีมา 100% ซึ่งเป็นผลมาจากการไม่สุ่มข้อความอิสระเลย
มันให้บริการ HTTP บนพอร์ต 8000 ผ่าน uvicorn, โดยส่งคืน parsed_json พร้อม field_telemetry ที่มีความเชื่อมั่นต่อฟิลด์ ข้อกำหนด: Mac รุ่น M1 หรือใหม่กว่า, macOS 14+ Apache 2.0 ไม่มีตัวเลขความแม่นยำ มีเพียงความหน่วง และคำว่า “ปรับเทียบแล้ว” ในที่นี้หมายถึง softmax ที่แม่นยำเหนือผู้สมัคร ไม่ใช่การปรับเทียบที่ผ่านการฝึกฝน
vLLM PR 57250: โหมดที่เหมือน Jev สำหรับ DiffusionGemma
vLLM pull request #57250 ซึ่งเปิดเมื่อวันที่ 16 กันยายนและยังคงเปิดอยู่ เปลี่ยน DiffusionGemma ให้กลายเป็นสิ่งที่ผู้เขียนเรียกว่า “เครื่องเลือกตอบแบบปรับเทียบแล้ว”: แคนวาสที่มีช่องคำตอบแบบโทเค็นเดียวที่ถูกกำหนดค่าเริ่มต้น, อ่านที่ขีดจำกัดของขั้นตอน, พร้อมความเชื่อมั่นจาก logprobs และ entropy ฟิลด์ vllm_xargs ใหม่รวมถึง diffusion_seed_canvas, diffusion_max_steps, และ diffusion_read_only และตัวอย่าง structured_server.py จะแปลสคีมาให้เป็นแคนวาส
PR รายงาน 8.7 คำขอต่อวินาทีสำหรับการอ่านแคนวาสครั้งเดียว, 54 ที่ความพร้อมกัน 32 ทาง, และความแม่นยำประมาณ 90% บน corpus การจัดประเภทภาษา ผู้ตรวจสอบพบว่าขาดการทดสอบ race-condition และการสร้างเธรดแบบไม่จำกัดเป็นปัญหาที่ขัดขวาง จนกว่าจะมีการรวม (merge) มันยังคงเป็นการออกแบบที่ควรศึกษา ไม่ใช่การนำไปใช้งานจริง
แต่ละโปรเจกต์มีความเที่ยงตรงแค่ไหน?
| โปรเจกต์ | โมเดลพื้นฐาน | พรีมิทีฟ | การปรับเทียบ | เซิร์ฟเวอร์ HTTP | ฮาร์ดแวร์ |
|---|---|---|---|---|---|
| OpenJev | Qwen3.5-4B, แบบแช่แข็ง | choice | softmax เหนือค่า logits ของตัวเลือก | ไม่มี (CLI + เดโมในเบราว์เซอร์) | RTX 3090 หรือเทียบเท่า, CUDA |
| mini-jev | Qwen3-4B-Instruct, แบบแช่แข็ง | choice, noul | การจัดอันดับที่มีช่องว่าง | มี, พอร์ต 8765 | หน่วยความจำ 8.5 GB, MPS หรือ CUDA |
| jevlike | encoder ที่คุณฝึกฝน | choice | ไม่มีการกล่าวอ้าง | ไม่มี | CPU, MPS, หรือ CUDA |
| MLX engine | Qwen2.5-1.5B-Instruct-4bit | ฟิลด์สคีมา | softmax เหนือผู้สมัคร | มี, พอร์ต 8000 | Apple Silicon, macOS 14+ |
| vLLM PR | DiffusionGemma | ใช่/ไม่ใช่, choice, scale | logprobs พร้อม entropy | มี, เข้ากันได้กับ OpenAI | GPU ระดับ vLLM, ยังไม่รวมเข้า |
ทุกแถวคือโมเดลที่ถูกแช่แข็งหรือฝึกฝนด้วยตนเองที่อ่านค่า logits ซึ่งทำให้คุณได้รูปร่างแบบ Jev: คำตอบที่ระบุประเภท, ความน่าจะเป็นต่อตัวเลือก, การส่งผ่านข้อมูลไปข้างหน้าครั้งเดียว แต่มันไม่ได้ทำให้คุณได้ข้อเรียกร้องหลักของ Jev ที่ว่า RLCD ทำให้ความน่าจะเป็นเหล่านั้นซื่อสัตย์ การเปรียบเทียบ 0.845 ของ OpenJev เทียบกับ 0.883 เป็นการเปรียบเทียบเดียวกับโมเดลจริง และเป็นการประเมินของผู้เขียนเอง การตั้งค่าตรงกับคำแนะนำของเราในการ รัน Kimi K3 แบบโลคอล: น้ำหนัก, GPU หรือ Mac ซีรีส์ M, พอร์ตโลคอล
ทดสอบโปรเจกต์ใดๆ ใน Apidog เหมือน Jev API จริง
จุดประสงค์ของการสร้างแบบโลคอลคือเพื่อสลับใช้แทน API จริงโดยไม่ต้องเขียนการผสานรวมของคุณใหม่ ดังนั้นการทดสอบของคุณควรส่ง body เดียวกันไปยังทั้งสองโปรเจกต์ ไม่มีโปรเจกต์ใดในที่นี้ที่รองรับสคีมา {model, state, questions} ของ Jev โดยตรง วางอะแดปเตอร์บางๆ ไว้หน้าโปรเจกต์ใดก็ตามที่คุณรัน: แอป FastAPI ขนาด 40 บรรทัดที่รับ Jev body, เรียกใช้เครื่องมือ, และส่งคืน {"answers": {...}} พร้อมคีย์ choice, probabilities, และ confidence ตอนนี้ Apidog จะเห็นสัญญาเดียว
สองสภาพแวดล้อม, หนึ่งชุดคำขอ. สร้าง Local reproduction ด้วย BASE_URL = http://localhost:8765 โดยไม่มีคีย์ และ TypeSafe API ด้วย BASE_URL = https://api.typesafe.ai พร้อม TYPESAFE_API_KEY ในฟิลด์โลคอล เพื่อไม่ให้ซิงค์กับเพื่อนร่วมทีม (ดูข้อกำหนดขอบเขตที่นี่) ทุกคำขอใช้ {{BASE_URL}}/v1/systemone และ Bearer {{TYPESAFE_API_KEY}}; เซิร์ฟเวอร์โลคอลจะเพิกเฉยต่อเฮดเดอร์
ส่ง Jev body. POST {{BASE_URL}}/v1/systemone พร้อมสถานะและคำถามที่คุณจะส่งไปยัง jev-latest:
{
  "model": "jev-latest",
  "state": "My card was charged twice for one order and I need this fixed today.",
  "questions": {
    "department": { "type": "choice", "instructions": "Which team handles this?",
      "criteria": { "billing": "charges and refunds", "shipping": "delivery", "technical": "bugs" } },
    "wants_refund": { "type": "noul", "instructions": "Is the customer asking for money back?" }
  }
}
ยืนยันฟิลด์ความน่าจะเป็น. เพิ่มการยืนยันหลังการประมวลผล: answers.department.choice เท่ากับ billing; answers.department.probabilities.billing มากกว่า 0.7; answers.wants_refund.noul มากกว่า 0.8 พลิกเมนูแบบเลื่อนลงของสภาพแวดล้อมและรันสถานการณ์เดียวกันกับ TypeSafe ช่องว่างระหว่างการรันทั้งสองคือค่าความเที่ยงตรงของคุณ ซึ่งมีค่ามากกว่าตารางใน README ใดๆ
บันทึกการรันแบบโลคอลเป็น mock เพื่อให้ส่วนหน้าสร้างขึ้นกับออบเจกต์ answers ที่เสถียรโดยไม่ต้องใช้เวลา GPU เลย ดาวน์โหลด Apidog เพื่อตั้งค่า; แผนฟรีรองรับผู้ใช้สี่คน รูปแบบเดียวกันสำหรับโมเดลแชทอยู่ใน การทดสอบ LLM โลคอลเป็น API
คำถามที่พบบ่อย
OpenJev เหมือนกับ Jev หรือไม่?
ไม่ OpenJev อ่านค่า logits ของตัวเลือกจาก Qwen3.5-4B ที่ถูกแช่แข็ง และระบุไว้ใน README ของมัน Jev เป็นโมเดลแบบปิดของ TypeSafe ที่ฝึกฝนด้วย RLCD OpenJev รายงานความสอดคล้องแบบ Modal agreement ที่ 0.845 กับ Jev บนชุดข้อมูลย่อย 102 แถว ตามการประเมินของผู้เขียนเอง
ฉันควรลองอันไหนก่อน?
mini-jev หากคุณใช้ Mac และต้องการ HTTP endpoint วันนี้; OpenJev หากคุณมี NVIDIA GPU และต้องการการเปรียบเทียบที่ใกล้เคียงที่สุดกับ Jev ที่เผยแพร่แล้ว เลือก jevlike ก็ต่อเมื่อคุณมีข้อมูลที่มีป้ายกำกับสำหรับฝึกฝน
ฉันสามารถรับความน่าจะเป็นที่ปรับเทียบแล้วจากโมเดลที่ถูกแช่แข็งได้หรือไม่?
ไม่ได้ด้วยการอ่านค่า logits เพียงอย่างเดียว Softmax เหนือโทเค็นตัวเลือกเป็นการจัดอันดับที่มีช่องว่าง ดังที่ README ของ mini-jev ระบุไว้ การปรับเทียบต้องการการฝึกฝนหรือขั้นตอนหลังการประมวลผล เช่น การปรับอุณหภูมิ (temperature scaling) บนชุดข้อมูลที่มีป้ายกำกับของคุณ ซึ่งไม่มีโปรเจกต์ใดในที่นี้มีให้
การรันโปรเจกต์เหล่านี้ถูกกว่าการจ่ายเงินให้ TypeSafe หรือไม่?
ที่ราคา $0.042 ต่อล้านโทเค็นอินพุตพร้อมเอาต์พุตฟรี Jev ก็อยู่ในระดับราคาต่ำสุดของ ผู้ให้บริการ LLM API ที่ถูกที่สุด แล้ว การรันแบบโลคอลได้เปรียบในเรื่องความเป็นส่วนตัวและการใช้งานออฟไลน์ ไม่ใช่เรื่องราคา เมื่อคุณนับรวมเวลาการใช้ GPU
บทสรุปสำหรับคุณ
OpenJev, mini-jev, jevlike, เอนจิน MLX, และ vLLM PR ทั้งหมดพิสูจน์แนวคิดหนึ่ง: การตัดสินใจไม่จำเป็นต้องใช้ข้อความที่สร้างขึ้น และการอ่านค่า logits ในการส่งผ่านข้อมูลครั้งเดียวจะเร็วกว่า ไม่มีโปรเจกต์ใดพิสูจน์ว่าได้รับการปรับเทียบแล้ว และไม่มีโปรเจกต์ใดเป็น Jev รันโปรเจกต์หนึ่งหลังอะแดปเตอร์ที่คล้าย Jev, รักษาอีกสภาพแวดล้อมหนึ่งให้ชี้ไปที่ TypeSafe, และให้การยืนยันของคุณเป็นตัวตัดสินว่าพวกมันแตกต่างกันมากน้อยแค่ไหน