OpenAI และ Anthropic ได้ลดราคา API อย่างหนักนับตั้งแต่เดือนกรกฎาคม 2026 และการลดราคานั้นปรากฏอยู่บนหน้าาราคาของพวกเขาเอง GPT-5.6 Luna ลดลง 80% ในชั่วข้ามคืน, GPT-6.1 Sol ตั้งราคาที่ $2/$10 เทียบกับ GPT-5.6 Sol ที่ $5/$30, Claude Opus 5.5 ลดราคาการอ่านแคชลง 60% และ Claude Haiku 5.5 ตั้งราคาเพียงหนึ่งในสิบของ Haiku 4.5 หากโมเดลต้นทุน กฎการจัดเส้นทาง หรือการแจ้งเตือนงบประมาณของคุณมีมาก่อนเดือนกันยายน ตอนนี้มันผิดแล้ว ส่วนใหญ่ผิดไปในทางที่เป็นประโยชน์กับคุณ ข้างล่างนี้: ราคาก่อน/หลังที่ตรวจสอบแล้ว, การคำนวณต่อคำขอ, กับดักที่ยังคงทำให้บิลบานปลาย และวิธีให้ coding agent ของคุณเปลี่ยนงบประมาณโทเค็นให้กลายเป็นการทดสอบ
จุดเริ่มต้นคือบทความของ Max Woolf OpenAI and Anthropic cut their LLM prices by up to 80% within a few months. Why? และ กระทู้ Hacker News ของมัน เราได้กล่าวถึงด้านตลาดใน สงครามราคาโมเดล AI เดือนกันยายน 2026; บทความนี้ว่าด้วยสิ่งที่ทีมควรเปลี่ยนแปลง
ราคาก่อน/หลังที่ตรวจสอบแล้ว
USD ต่อหนึ่งล้านโทเค็น (อินพุต / เอาต์พุต / อินพุตที่แคชไว้), ระดับมาตรฐาน, ต่ำกว่าเกณฑ์บริบทแบบยาว แถวของ OpenAI มาจากหน้าาราคา OpenAI API ที่อ่านเมื่อ 2026-10-26 โดยราคา “ก่อน” มาจากสำเนาเก็บถาวรของหน้านั้น แถวของ Anthropic มาจากเอกสารราคา Claude ซึ่งแสดงโมเดลเก่าและใหม่ไว้เคียงข้างกัน
| การเปลี่ยนแปลงของโมเดล | ก่อน | หลัง | การเปลี่ยนแปลง | เมื่อไหร่ |
|---|---|---|---|---|
| GPT-5.6 Luna (ลดราคา) | $1 / $6 / $0.10 | $0.20 / $1.20 / $0.02 | -80% ทุกหมวด | 2026-07-30 |
| GPT-5.6 Terra (ลดราคา) | $2.50 / $15 / $0.25 | $2 / $12 / $0.20 | -20% | 2026-07-30 |
| GPT-5.6 Sol (โปรโมชัน) | $5 / $30 / $0.50 | $4 / $20 / $0.40 | อินพุต -20%, เอาต์พุต -33% | 2026-08-21 |
| GPT-5.6 Sol ราคาปกติ เป็น GPT-6.1 Sol | $5 / $30 / $0.50 | $2 / $10 / $0.10 | อินพุต -60%, เอาต์พุต -67%, แคช -80% | 2026-09-29 |
| GPT-5.6 Luna เป็น GPT-6 Luna | $0.20 / $1.20 / $0.02 | $0.10 / $0.50 / $0.01 | อินพุต -50%, เอาต์พุต -58% | 2026-09-22 |
| Claude Opus 5 เป็น Opus 5.5 | $5 / $25 / $0.50 | $4 / $20 / $0.20 | อินพุต/เอาต์พุต -20%, แคช -60% | 2026-09-22 |
| Claude Fable 5 เป็น Fable 5.1 | $10 / $50 / $1 | $10 / $50 / $0.25 | แคชเท่านั้น -75% | กันยายน 2026 |
| Claude Sonnet 5 เป็น Sonnet 5.5 | $2 / $10 / $0.20 | $2 / $10 / $0.10 | แคชเท่านั้น -50% | กันยายน-ตุลาคม 2026 |
| Claude Haiku 4.5 เป็น Haiku 5.5 | $1 / $5 / $0.10 | $0.10 / $0.50 / $0.01 | -90% (พรอมป์ต์ถึง 100K) | ตุลาคม 2026 |
มีเพียงแถวของ GPT-5.6 เท่านั้นที่เป็นการลดราคาบนโมเดลเดียวกัน ที่เหลือเป็นโมเดลรุ่นสืบทอดที่ถูกกว่า ดังนั้นคุณภาพและจำนวนโทเค็นจึงแตกต่างกัน ราคาเปิดตัวของ Sonnet 5 ที่ $2/$10 กลายเป็นราคาถาวร และเอกสารระบุว่าแผนการเปลี่ยนไปเป็น $3/$15 “จะไม่เกิดขึ้น” ส่วนลดของ GPT-5.6 Sol เป็นโปรโมชัน “มีให้อย่างน้อยถึงวันที่ 21 พฤศจิกายน 2026” ราคาของ Luna และ Terra ก่อนลดนั้นอยู่บนหน้าาราคา OpenAI ที่เก็บถาวรจากวันที่ 29 กรกฎาคม
รายละเอียดแยกตามโมเดล: การลดราคา GPT-5.6, ราคา GPT-6 Sol, ราคา Claude Haiku 5.5
ทำไมราคาจึงลดลง
เหตุผลจากเจ้าของเพียงหนึ่งเดียวมาจาก Anthropic: ประกาศเปิดตัว Claude Opus 5.5 ระบุว่าโมเดลนี้ “ใช้การประมวลผลน้อยกว่าในการให้บริการเมื่อเทียบกับ Opus 5 และราคาของมันสะท้อนถึงเรื่องนั้น” พร้อมประเมินว่าต้นทุนต่ำลง 40% สำหรับเวิร์กโหลดทั่วไป หน้าของ OpenAI ไม่ได้ให้เหตุผลใด ๆ ที่เหลือเป็นความเห็น:
- การแข่งขัน ต้นทุนการสลับต่ำ Woolf โต้แย้งว่าโมเดลในตอนนี้เป็นสิ่งทดแทนกันได้อย่างใกล้ชิด: การสลับเป็นเพียงการสับสวิตช์ในฮาร์เนสหรือเปลี่ยนสตริงโมเดลผ่านเราเตอร์ โมเดลแบบเปิดน้ำหนักที่ให้บริการโดยผู้ให้บริการหลายราย (เขานับได้ 29 รายสำหรับ DeepSeek Flash หนึ่งรุ่นบน OpenRouter เมื่อวันที่ 24 ตุลาคม) เป็นตัวกำหนดพื้นราคา
- ต่างตอบแทนกัน การลดราคาสลับไปมาระหว่างสองบริษัท และทั้งคู่ต่างเปิดตัวโมเดลเรือธงที่ถูกกว่าในวันที่ 22 กันยายน
- จังหวะการ IPO Woolf สังเกตว่าทั้งคู่มีข่าวลือว่าใกล้จะ IPO และเห็นว่าจังหวะเวลานั้นแปลก นั่นเป็นการคาดเดาเกี่ยวกับแรงจูงใจ
- ประสิทธิภาพ ผู้แสดงความคิดเห็นบน HN หลายคนเล่าเรื่องที่เรียบง่ายกว่า: แคชที่ดีขึ้น โมเดลที่เล็กลง การให้บริการที่ถูกกว่า
Woolf ยังอ้างข้อมูลจาก Vercel AI Gateway: ต้นทุนต่อโทเค็นลดลงเหลือ 43.3% ของระดับในเดือนเมษายน 2026 ขณะที่การใช้จ่ายโดยรวมเพิ่มขึ้น โทเค็นที่ถูกกว่ามักไม่ค่อยลดบิลลง เว้นแต่คุณจะเปลี่ยนวิธีใช้มัน
การลดราคาเปลี่ยนอะไร: การคำนวณต่อคำขอแบบลงมือทำ
เทิร์นของเอเจนต์ที่ใช้แคชหนัก
ลองดูเทิร์นหนึ่งของ coding agent: บทสนทนา 100,000 โทเค็นอ่านจากแคช, อินพุตใหม่ 2,000 โทเค็น, เอาต์พุต 1,000 โทเค็น
| โมเดล | การอ่านแคช | อินพุตใหม่ | เอาต์พุต | ต้นทุนต่อเทิร์น |
|---|---|---|---|---|
| GPT-5.6 Sol (ราคาปกติ) | $0.050 | $0.010 | $0.030 | $0.090 |
| GPT-5.6 Sol (โปรโมชัน) | $0.040 | $0.008 | $0.020 | $0.068 |
| GPT-6.1 Sol | $0.010 | $0.004 | $0.010 | $0.024 |
| Claude Opus 5 | $0.050 | $0.010 | $0.025 | $0.085 |
| Claude Opus 5.5 | $0.020 | $0.008 | $0.020 | $0.048 |
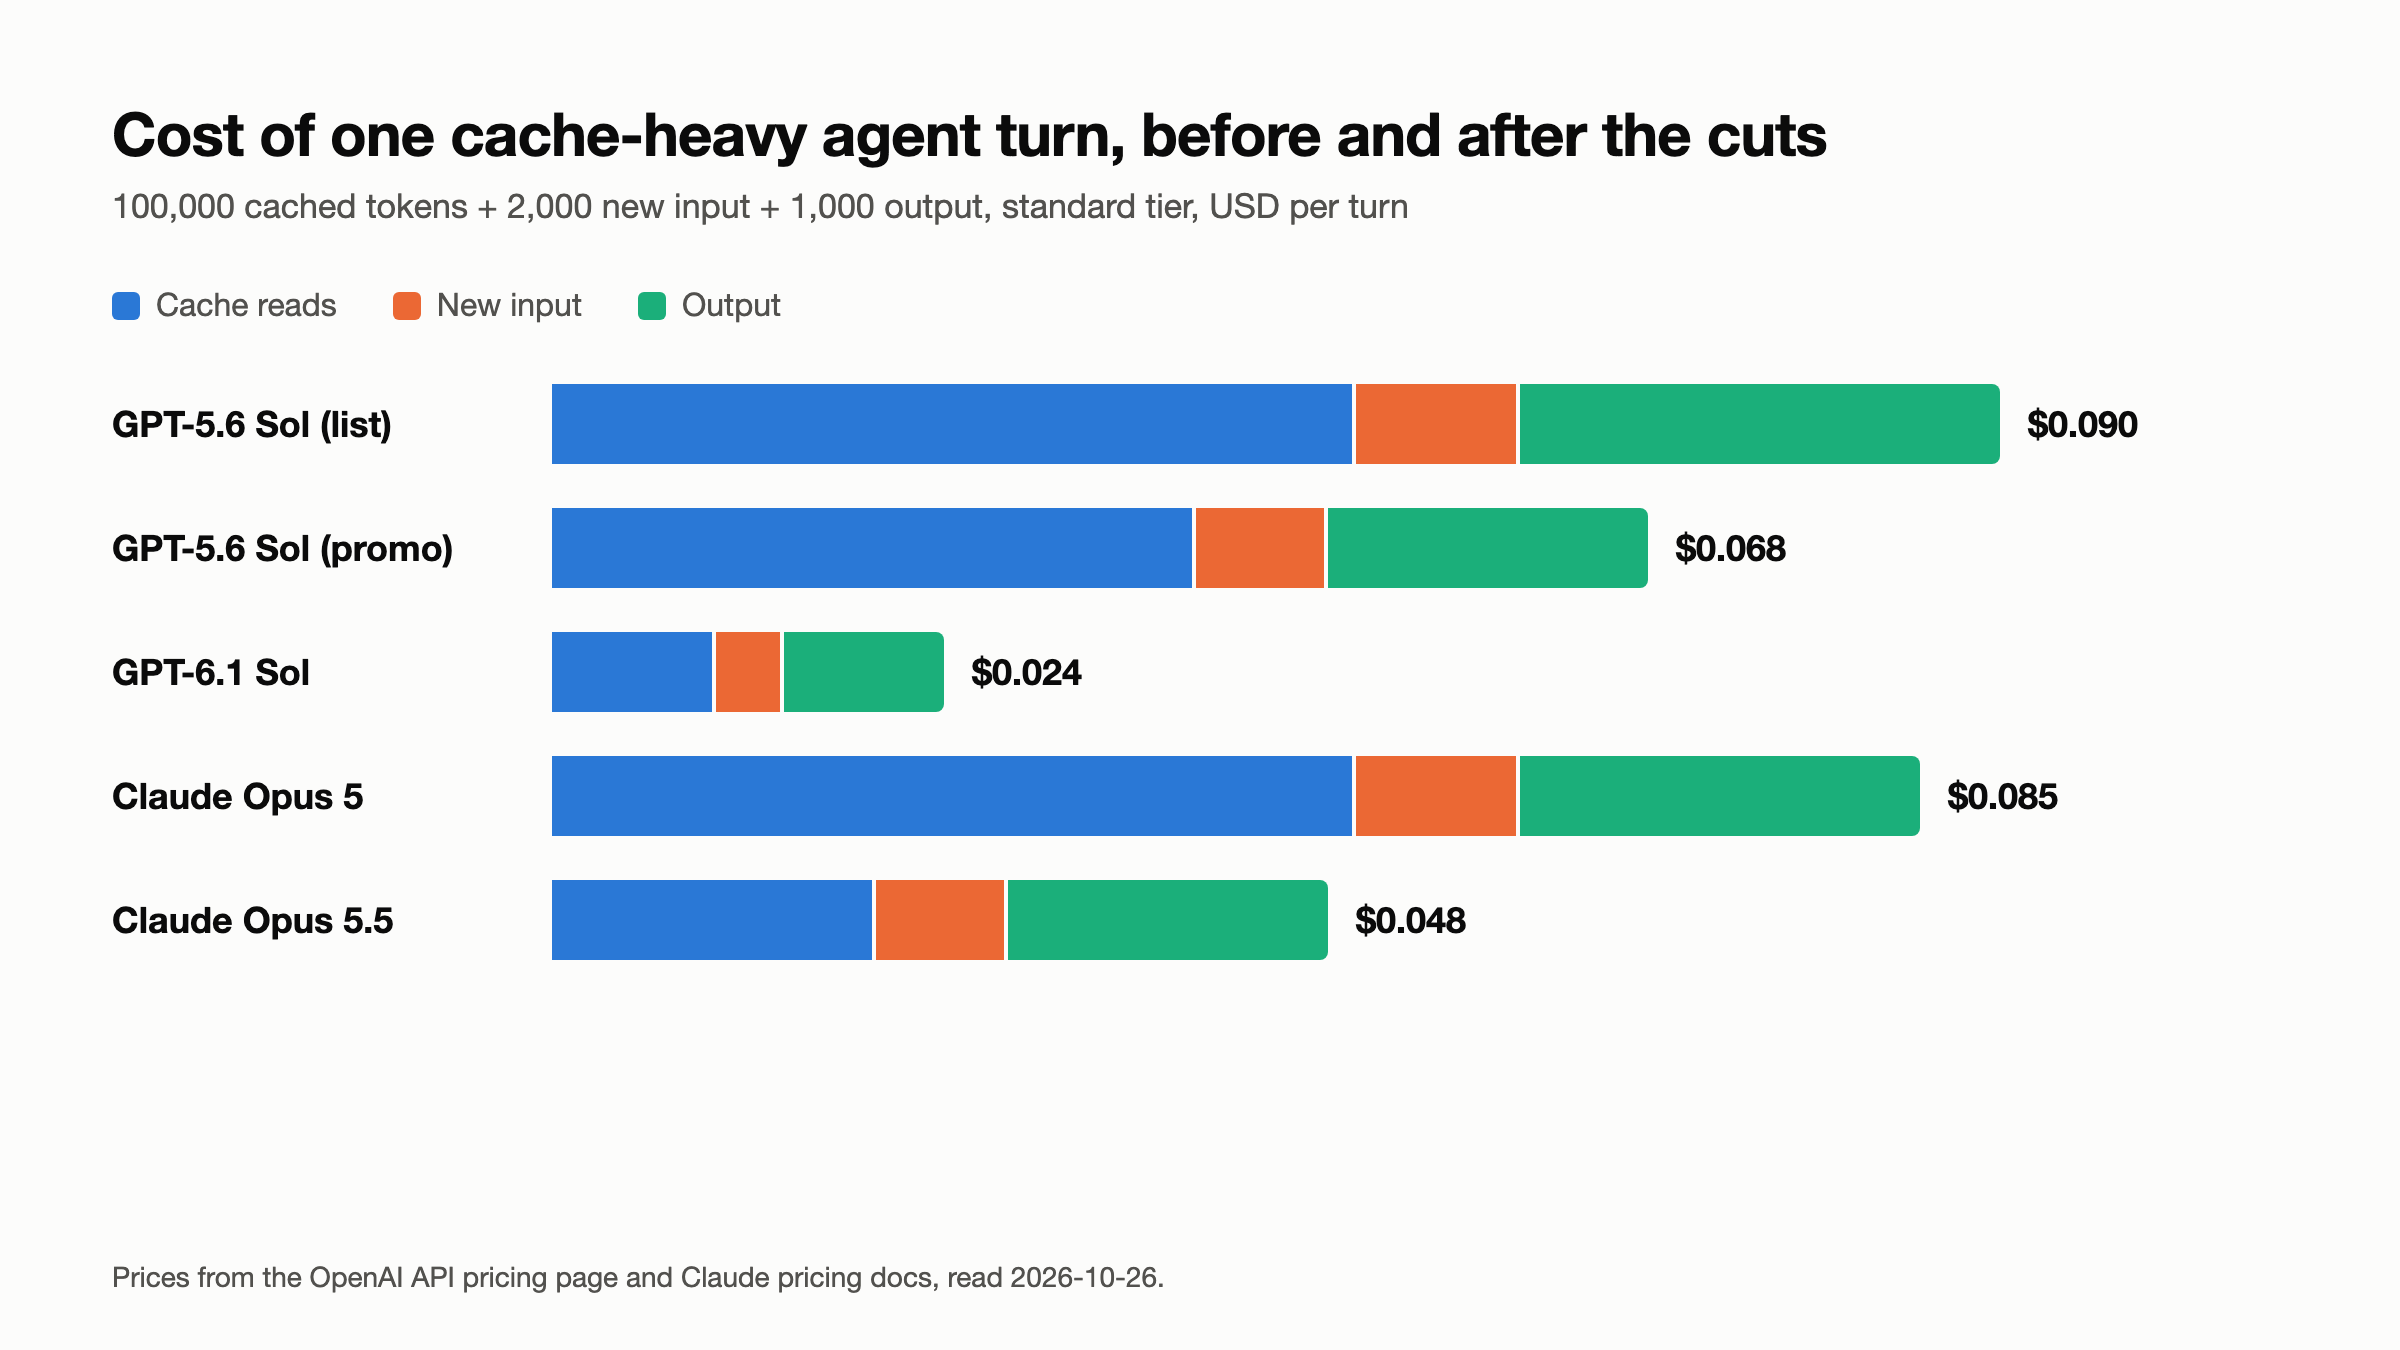
GPT-6.1 Sol ต่ำกว่าราคาปกติของ GPT-5.6 Sol อยู่ 73% ในเทิร์นนี้ และ Opus 5.5 ต่ำกว่า Opus 5 อยู่ 44% ใกล้เคียงกับตัวเลข 40% ของ Anthropic บนโมเดลเก่า การอ่านแคชคิดเป็นกว่าครึ่งของเทิร์น ดังนั้นราคาการอ่านแคชจึงกลายเป็นตัวเลขที่สำคัญสำหรับเอเจนต์ นั่นคือเหตุผลที่การลดเฉพาะแคชของ Fable 5.1 จึงสำคัญกว่าที่ราคา $10/$50 ที่ไม่เปลี่ยนแปลงบ่งบอก ดูการคำนวณจุดคุ้มทุนของการแคชใน Opus 5.5 และคู่มือ prompt caching ของ GPT-6 ของเรา
สิ่งที่ต้องเปลี่ยน: จัดอันดับโมเดลตามต้นทุนต่อเทิร์นที่อัตราการแคชจริงของคุณ ไม่ใช่ตามราคาอินพุตในราคาปกติ
ตัวจำแนกประเภทปริมาณสูง
ทีนี้ลองดูเราเตอร์หรือตัวจำแนก: 1 ล้านคำขอต่อวัน, อินพุต 1,500 โทเค็นและเอาต์พุต 200 โทเค็นต่อคำขอ, ไม่มีการแคช
- GPT-5.6 Luna ก่อน 30 กรกฎาคม: อินพุต 1.5B ที่ $1 บวกเอาต์พุต 200M ที่ $6 = $2,700/วัน
- GPT-6 Luna: $150 + $100 = $250/วัน
- Claude Haiku 4.5: $1,500 + $1,000 = $2,500/วัน
- Claude Haiku 5.5: $150 + $100 = $250/วัน
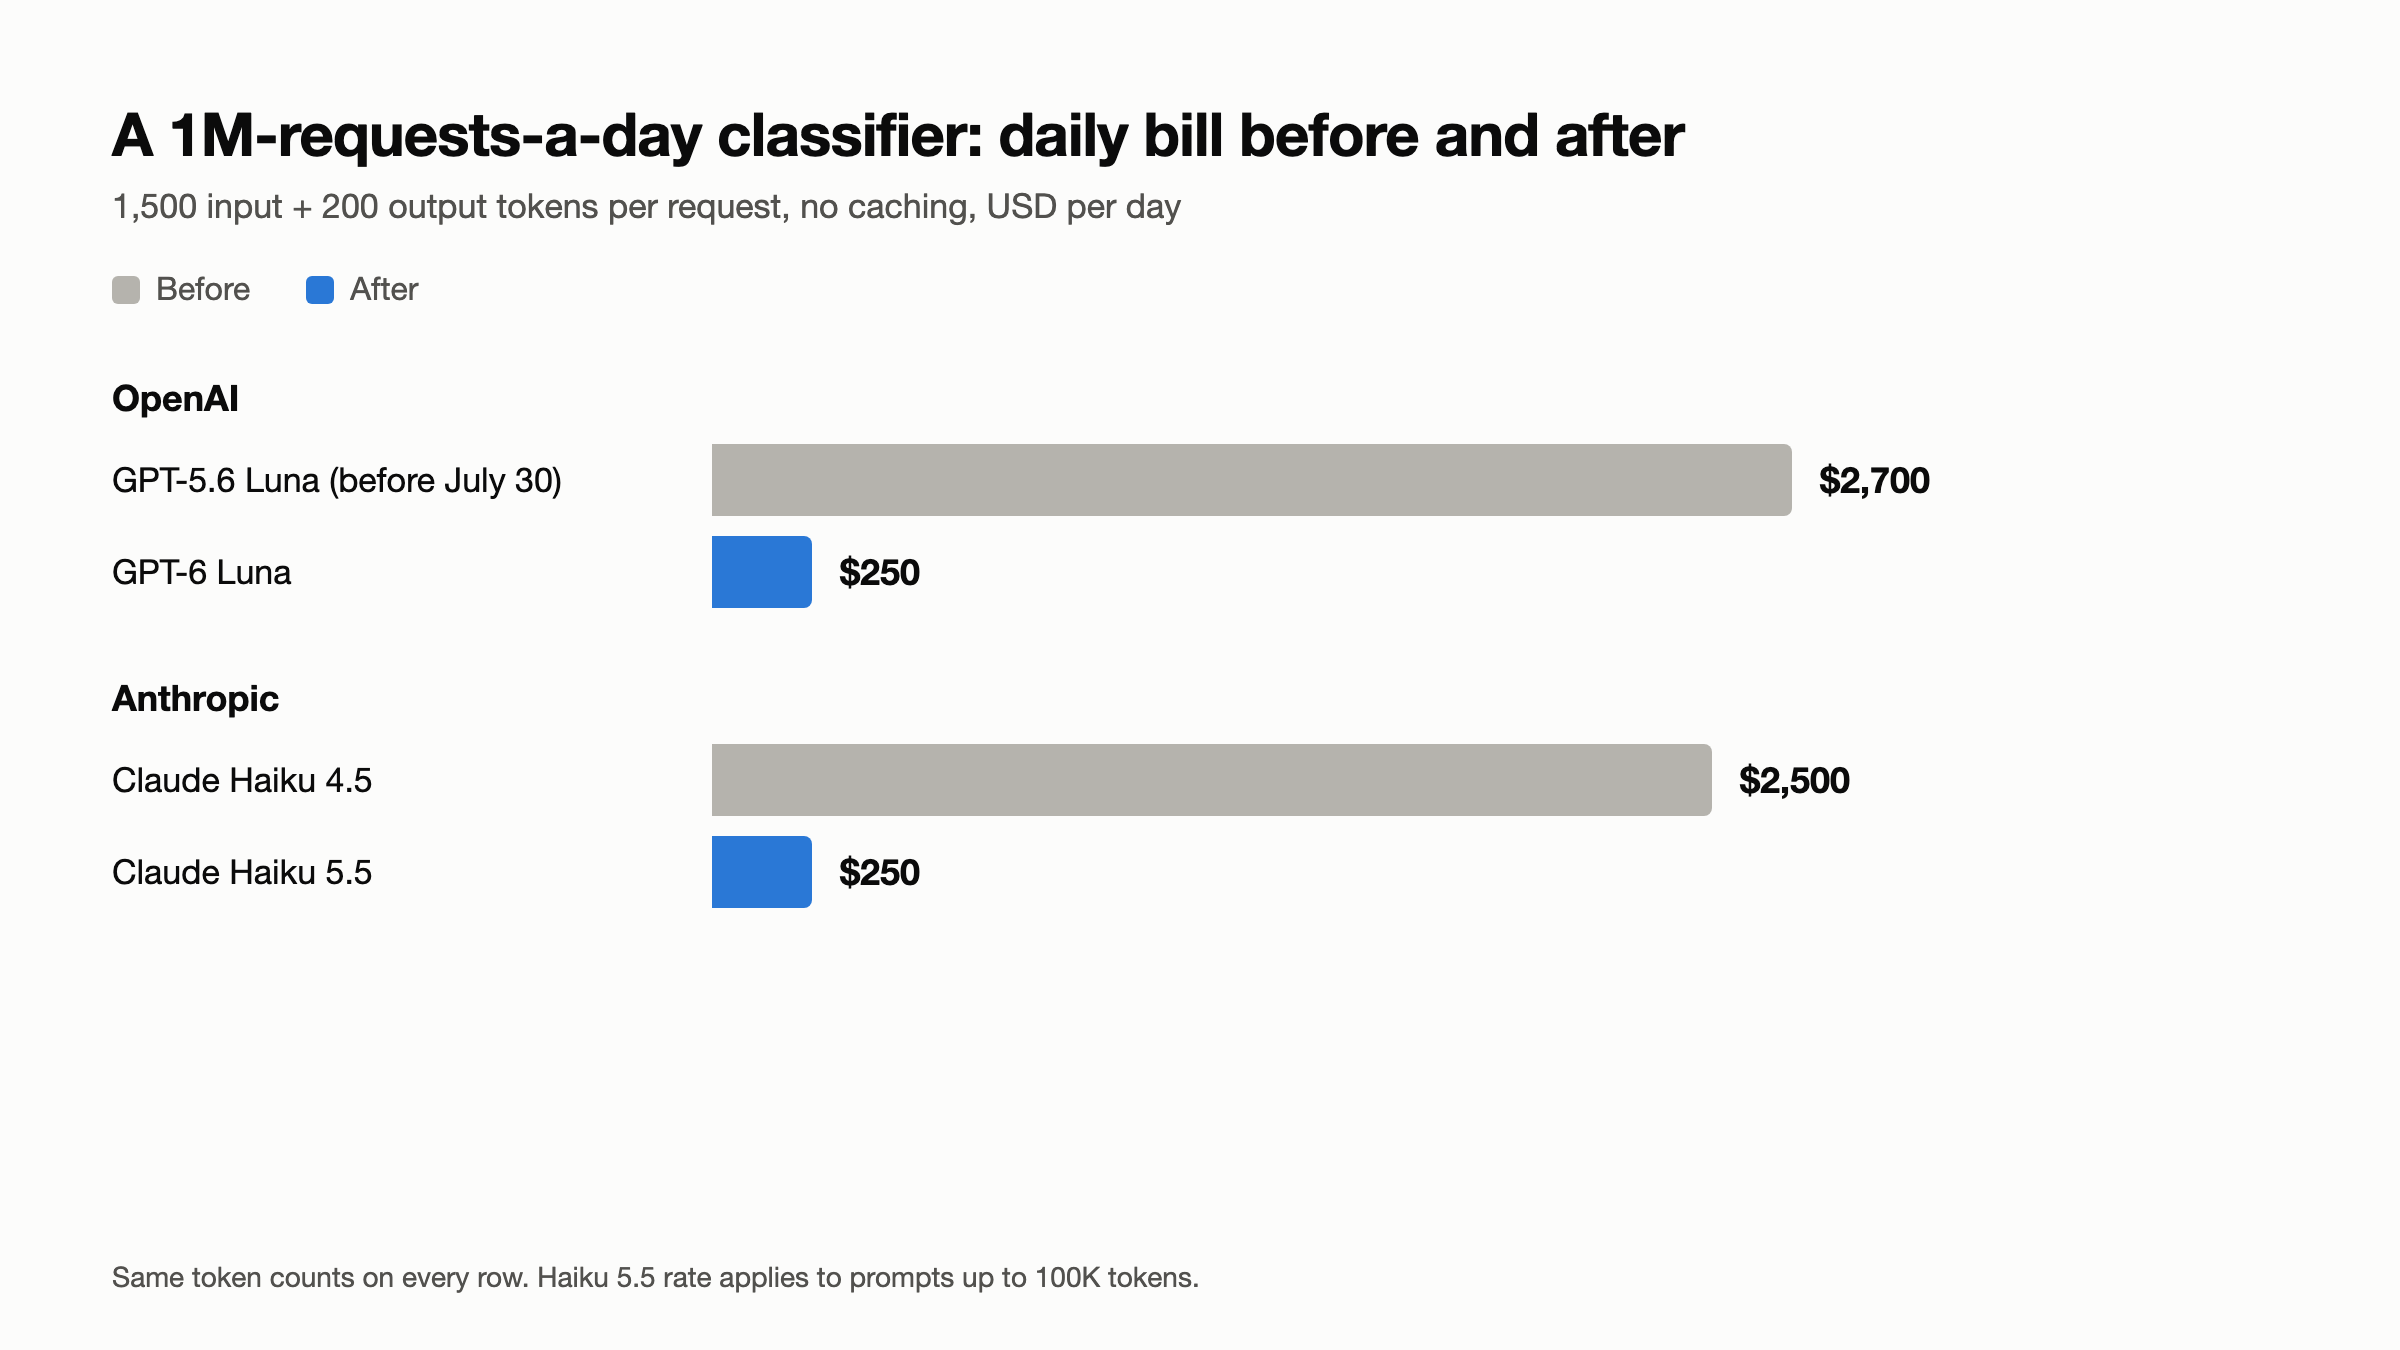
สิ่งที่ต้องเปลี่ยน: หยุดตัดพรอมป์ต์เพื่อประหยัดสำหรับโมเดลเล็ก และทดสอบว่าทราฟฟิกระดับกลางตอนนี้ใส่ในโมเดลเล็กได้หรือยัง รันชุด eval ของคุณก่อน: ราคาต่อโทเค็นไม่ได้บอกอะไรเกี่ยวกับความแม่นยำบนข้อมูลของคุณ
แบบกลุ่ม: ตัวเลขน้อยลง เปอร์เซ็นต์เท่าเดิม
ทั้งคู่ยังคงลด 50% สำหรับงานแบบอะซิงโครนัส: Batch API ของ Anthropic ลดอินพุตและเอาต์พุตครึ่งหนึ่ง และระดับ Flex/Batch ของ OpenAI ลดทุกอย่างครึ่งหนึ่ง รวมถึงอินพุตที่แคชไว้ (GPT-6.1 Sol: $1 / $5 / $0.05) สำหรับตัวจำแนกข้างต้น การทำแบบกลุ่มตอนนี้ประหยัดได้ $125 ต่อวัน สำหรับเวิร์กโหลดเล็ก การประหยัดนั้นอาจไม่คุ้มกับโครงสร้างพื้นฐานการจัดคิวเพิ่มเติมอีกต่อไป; สำหรับเวิร์กโหลดใหญ่ คู่มือ OpenAI Batch API ยังคงใช้ได้
กับดักที่ยังคงทำให้บิลบานปลาย
การเขียนแคชมีราคาแพงกว่าอินพุต Anthropic คิดค่าการเขียนแคช 1.25 เท่าของอินพุตฐานสำหรับการเขียน 5 นาที และ 2 เท่าสำหรับการเขียน 1 ชั่วโมง ตารางของ OpenAI ก็มีคอลัมน์การเขียนเช่นกัน: 1.25 เท่าสำหรับ 30 นาที และ 2.5 เท่าสำหรับ 12 ชั่วโมง (GPT-6.1 Sol: $2.50 และ $5 เทียบกับอินพุต $2) เพรฟิกซ์ที่เขียนแล้วไม่เคยถูกอ่านมีต้นทุนสูงกว่าไม่แคชเลย 25% ถึง 150% เมื่อการอ่านอยู่ที่ 5% ของอินพุต การเขียนสั้นจะคุ้มทุนหลังการอ่านหนึ่งครั้ง การเขียนยาวหลังการอ่านสองครั้ง
ตัวคูณบริบทแบบยาว บน GPT-6.1 Sol และ GPT-6 Luna หน้าโมเดลของ OpenAI ระบุว่าพรอมป์ต์ที่เกิน 272K โทเค็นอินพุตจะคิดราคาที่ 2 เท่าของอัตราอินพุตและแคช และ 1.5 เท่าของเอาต์พุต “สำหรับคำขอทั้งหมด” Claude Haiku 5.5 กระโดดจาก $0.10/$0.50 ไปเป็น $0.50/$2.50 เมื่อพรอมป์ต์เกิน 100,000 โทเค็น และ Anthropic นับการอ่านและเขียนแคชรวมเข้าในเกณฑ์นั้นด้วย โมเดล Claude 4.6 และใหม่กว่าอื่น ๆ คิดราคาหน้าต่าง 1M เต็มที่อัตรามาตรฐาน พรอมป์ต์ขนาดใหญ่เกินหนึ่งครั้งบนเส้นทางที่ใช้งานหนักสามารถลบการประหยัดทั้งหมดได้
โทเค็นการให้เหตุผลคือโทเค็นเอาต์พุต คู่มือการให้เหตุผลของ OpenAI ระบุว่าโทเค็นการให้เหตุผล “ถูกคิดค่าใช้จ่ายเป็นโทเค็นเอาต์พุต” และแสดงไว้ใน usage.output_tokens_details.reasoning_tokens การตอบกลับอาจถึง max_output_tokens ก่อนจะมีเอาต์พุตที่มองเห็นได้ และคุณยังต้องจ่ายอยู่ดี เอกสารต้นทุนการคิดของ Anthropic คิดค่าการคิดเต็มจำนวน ไม่ใช่แค่สรุปที่มองเห็นได้ ซึ่งรายงานใน usage.output_tokens_details.thinking_tokens เอาต์พุตเป็นฝั่งที่มีราคาแพงที่สุดในทุกแถว ดังนั้นการตั้งค่าระดับความพยายามจึงขยับบิลได้มากกว่าการเลือกโมเดล
การบวกเพิ่มตามภูมิภาค OpenAI บวกเพิ่ม 10% สำหรับการประมวลผลระดับภูมิภาค (การพำนักข้อมูล) บนโมเดลที่เปิดตัวตั้งแต่วันที่ 5 มีนาคม 2026 เป็นต้นไป และ 10% สำหรับปลายทาง FedRAMP Anthropic ใช้ตัวคูณ 1.1x เมื่อคุณตั้งค่า inference_geo: "us" และปลายทางระดับภูมิภาคบน Bedrock และ Google Cloud มีราคาสูงกว่าปลายทางทั่วโลก 10%
โทเค็นไนเซอร์และโปรโมชัน เอกสารของ Anthropic ระบุว่า Claude 4.7 และใหม่กว่าใช้โทเค็นไนเซอร์ที่ผลิตโทเค็นมากขึ้นประมาณ 30% สำหรับข้อความเดียวกันเมื่อเทียบกับ Sonnet 4.6 และรุ่นก่อนหน้า ดังนั้นบนข้อความเดียวกัน การเปลี่ยนจาก Haiku 4.5 เป็น Haiku 5.5 จึงคิดออกมาใกล้เคียง 87% มากกว่า 90% และหากคุณปักหมุด gpt-5.6-sol เพื่อคงอัตราโปรโมชัน ก็ให้จดวันที่ 21 พฤศจิกายน 2026 ไว้ในปฏิทินของคุณ
ให้ coding agent ของคุณใส่การยืนยันต้นทุนบนการเรียก LLM ด้วย Apidog CLI
ราคาเปลี่ยนทุกเดือน; จำนวนโทเค็นเปลี่ยนทุกครั้งที่มีคนแก้พรอมป์ต์หรือเพิ่มการตั้งค่าระดับความพยายาม วิธีแก้ที่ยั่งยืนคือการทดสอบที่จะล้มเหลวเมื่อการเรียกเกินงบประมาณ โดยรันบนทุก pull request ให้ Claude Code, Codex หรือ Cursor เขียนมันด้วย Apidog CLI
ติดตั้ง CLI และทักษะเอเจนต์หนึ่งครั้ง:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้พรอมป์ต์กับเอเจนต์ของคุณหนึ่งครั้ง:
In Apidog project <id>, create an environment "openai" with base URL https://api.openai.com
and an endpoint POST /v1/responses. Add a test case that sends our support-ticket summary
prompt to gpt-6.1-sol and asserts: HTTP 200, usage.output_tokens at most 1500 and
usage.output_tokens_details.reasoning_tokens at most 1000. Use an API key variable,
not a literal. Run it and summarize any failures.
เอเจนต์จะอ่านสกีมาของแต่ละเพย์โหลด ตรวจสอบความถูกต้องก่อนเขียน และรันเคส:
apidog environment create openai --project <id> --base-url https://api.openai.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog test-case category --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
งบประมาณจะอยู่ใน postProcessors ของเคสในรูปของการยืนยันบน JSONPath โดยใช้การเปรียบเทียบ เช่น isAtMost และ isAtLeast จากสกีมา test-case-create:
{
  "type": "assertion",
  "defaultEnable": true,
  "enable": true,
  "data": {
    "name": "output tokens under budget",
    "subject": "responseJson",
    "comparison": "isAtMost",
    "value": "1500",
    "path": "$.usage.output_tokens"
  }
}
สำหรับ Claude ให้ชี้ปลายทางไปที่ /v1/messages และยืนยันบน $.usage.output_tokens และ $.usage.output_tokens_details.thinking_tokens จากนั้นขอให้สร้างสถานการณ์ทดสอบที่เรียกแบบเดียวกันสองครั้งและยืนยันว่า $.usage.input_tokens_details.cached_tokens (OpenAI) หรือ $.usage.cache_read_input_tokens (Claude) ของการตอบกลับครั้งที่สองมากกว่าศูนย์: เมื่อมีคนทำให้เพรฟิกซ์ที่แคชไว้เสียหาย การบิลด์จะล้มเหลวก่อนใบแจ้งหนี้จะมาถึง ป้อนพรอมป์ต์ตัวแทนด้วย -d ส่งคีย์ API จาก CI secrets ด้วย --env-var และใช้ -r junit ในไปป์ไลน์ของคุณ (คู่มือ CI/CD) Apidog CLI ใน Claude Code ครอบคลุมการตั้งค่าเอเจนต์
คำถามที่พบบ่อย
OpenAI และ Anthropic ลดราคาถึง 80% จริงหรือ? สำหรับโมเดลหนึ่งตัว ใช่: GPT-5.6 Luna เปลี่ยนจาก $1/$6 เป็น $0.20/$1.20 เมื่อวันที่ 30 กรกฎาคม 2026 การลดส่วนใหญ่อื่น ๆ มาจากโมเดลรุ่นสืบทอดที่ถูกกว่า
การลดราคาใช้กับการสมัครสมาชิก Claude Code และ Codex หรือไม่? หน้าาราคาครอบคลุมเฉพาะ API Woolf กล่าวว่าการประหยัดนั้นไปถึงฮาร์เนสแบบสมัครสมาชิกด้วย แต่ก็รายงานว่า OpenAI ลดโควตาการใช้งานลงครึ่งหนึ่งในระดับ $200 ของ Codex ดังนั้นให้ตรวจสอบข้อจำกัดของแผนคุณ
ราคาของ GPT-5.6 Sol ถาวรหรือไม่? ไม่ เป็นโปรโมชัน อย่างน้อยถึงวันที่ 21 พฤศจิกายน 2026 อย่างไรก็ตาม GPT-6.1 Sol ถูกกว่าอยู่แล้ว
วิธีที่ถูกที่สุดในการลดบิลของเอเจนต์ตอนนี้คืออะไร? เพิ่มอัตราการแคชและลดระดับความพยายามในการให้เหตุผล การอ่านแคชครองส่วนใหญ่ของเซสชันยาว และการให้เหตุผลคิดค่าที่อัตราเอาต์พุต
ก้าวต่อไป
คำนวณต้นทุนใหม่สำหรับการเรียก LLM ที่ใช้งานหนักที่สุดสามรายการของคุณ แล้วให้เอเจนต์ของคุณเพิ่มการทดสอบงบประมาณโทเค็นให้แต่ละรายการ ดาวน์โหลด Apidog เพื่อเริ่มต้น