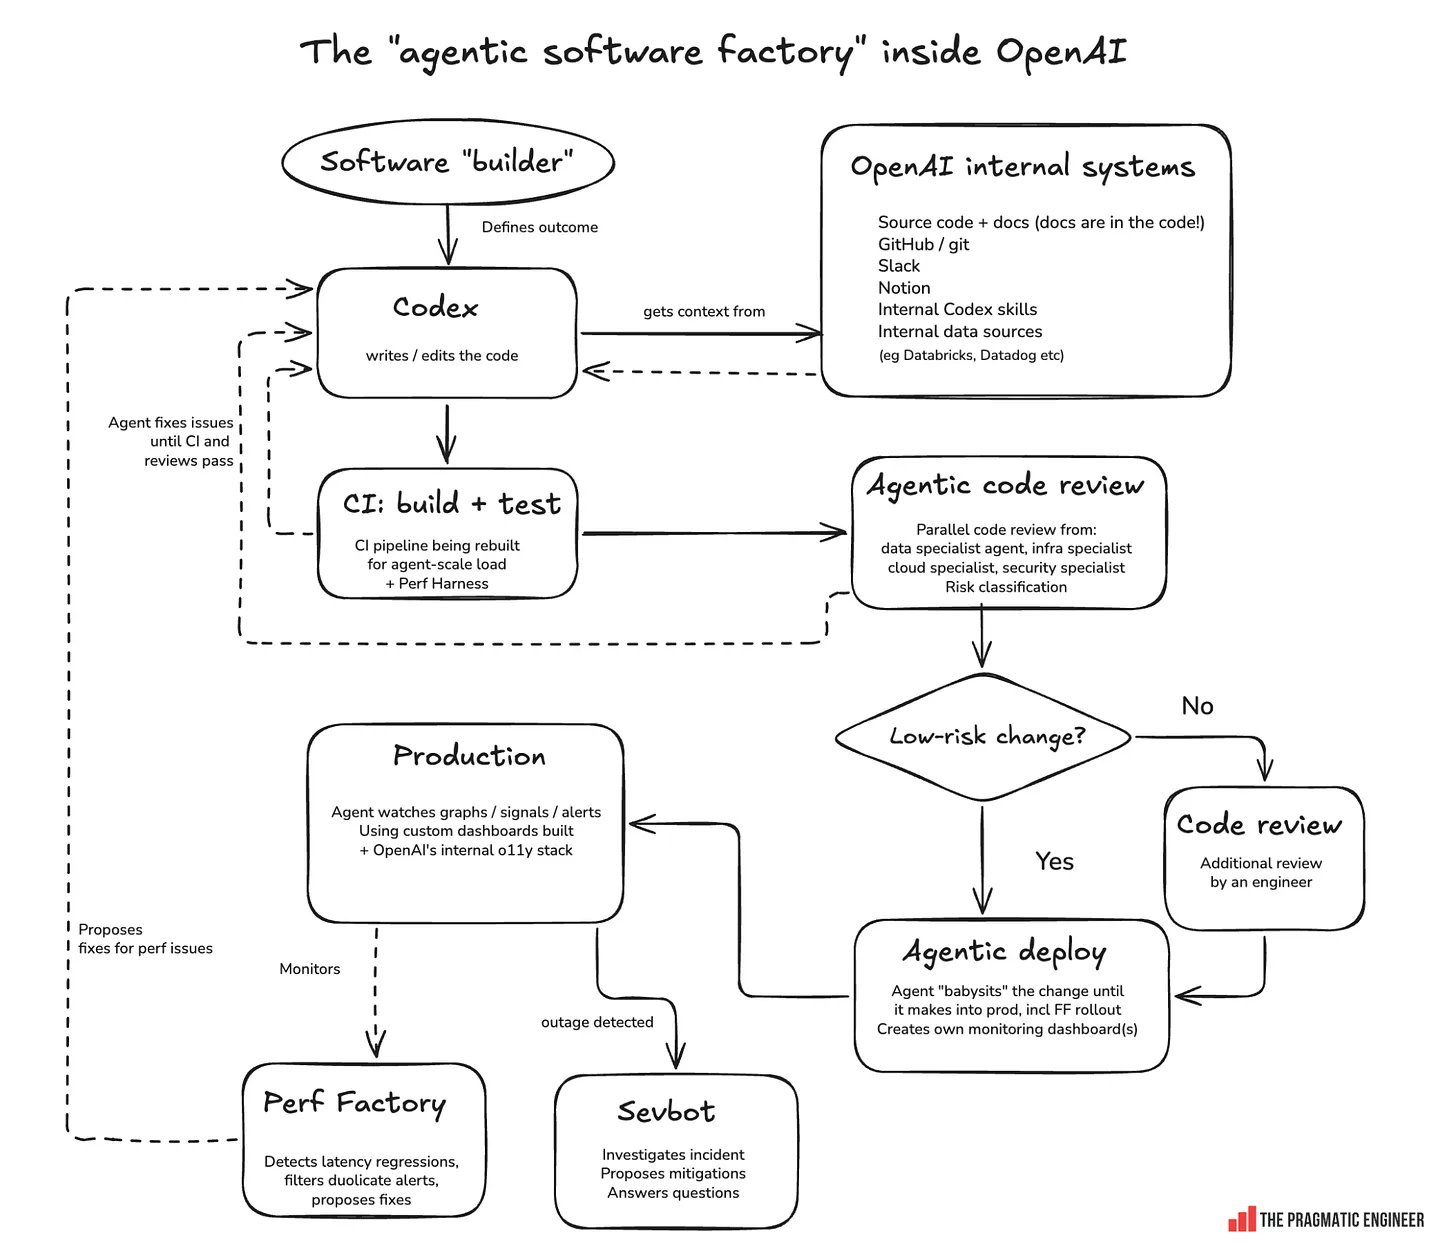
ไดอะแกรมของไปป์ไลน์วิศวกรรมภายในของ OpenAI กลายเป็นที่แพร่หลายใน X สัปดาห์นี้ มันแสดงช่องสิบช่อง ตั้งแต่ “ผู้สร้างซอฟต์แวร์กำหนดผลลัพธ์” ไปจนถึงเอเจนต์ที่เฝ้าดูกราฟการผลิตและยื่นรายงานเหตุการณ์ด้วยตัวเอง แหล่งที่มาคือนิวส์เล็ตเตอร์ของ Gergely Orosz ที่ชื่อ The Pragmatic Engineer ใน บทความชื่อ “โรงงานซอฟต์แวร์แบบเอเจนต์ของ OpenAI” และ ตัวไดอะแกรมเองก็แพร่กระจายอย่างรวดเร็วบน X
ปฏิกิริยาส่วนใหญ่พลาดรายละเอียดที่สำคัญ: ช่องสิบช่องเหล่านั้นหลายช่องอธิบายถึงการตั้งค่าทางวิศวกรรมภายในของ OpenAI ไม่ใช่ ผลิตภัณฑ์ Codex ที่คุณสามารถติดตั้งได้ในวันนี้ การรวมสองสิ่งนี้เข้าด้วยกันคือข้อผิดพลาดที่พบบ่อยที่สุดในการสนทนาเกี่ยวกับไดอะแกรมนี้ บทความนี้จะอธิบายไปทีละช่องและหยุดที่ขั้นตอนเดียวที่ทีมภายนอกสามารถลอกเลียนแบบได้จริง: CI
สิบขั้นตอนตามลำดับ
ไดอะแกรมนี้อ่านจากซ้ายไปขวาเป็นวงวน: มนุษย์กำหนดเป้าหมาย, เอเจนต์เขียนโค้ด, เกตอัตโนมัติตรวจสอบ, และเอเจนต์จะวนซ้ำต่อไปจนกว่าเกตเหล่านั้นจะผ่าน นี่คือลำดับเต็มพร้อมระบุว่าแต่ละขั้นตอนเป็นแบบภายในหรือที่จัดส่งแล้ว
| # | ขั้นตอน | เกิดอะไรขึ้น | ภายในเท่านั้นหรือจัดส่งใน Codex |
|---|---|---|---|
| 1 | ผู้สร้างซอฟต์แวร์ | วิศวกรหรือ PM กำหนดผลลัพธ์ | ขั้นตอนของมนุษย์ ไม่ใช่ซอฟต์แวร์ |
| 2 | Codex เขียน/แก้ไขโค้ด | ดึงบริบทจากแหล่งที่มา, เอกสาร, GitHub, Slack, Notion, ทักษะภายใน และระบบข้อมูลเช่น Databricks และ Datadog | Codex ที่จัดส่งแล้วสามารถเขียนโค้ดได้; กราฟบริบทภายใน (Slack, Notion, ข้อมูลภายใน) เป็นแบบภายในเท่านั้น |
| 3 | CI: สร้าง + ทดสอบ | ไปป์ไลน์กำลังถูกสร้างใหม่สำหรับโหลดระดับเอเจนต์ และ “Perf Harness” | จัดส่งแล้ว (CI ของคุณเอง); งานปรับขนาดเฉพาะของ OpenAI เป็นแบบภายใน |
| 4 | การตรวจสอบโค้ดแบบเอเจนต์ | การตรวจสอบแบบขนานจากเอเจนต์ผู้เชี่ยวชาญด้านข้อมูล, โครงสร้างพื้นฐาน, คลาวด์ และความปลอดภัย พร้อมกับการจัดประเภทความเสี่ยง | ภายในเท่านั้น |
| 5 | การตัดสินใจความเสี่ยงต่ำ | การเปลี่ยนแปลงที่มีความเสี่ยงต่ำจะดำเนินการต่อไป; การเปลี่ยนแปลงที่มีความเสี่ยงสูงจะได้รับการตรวจสอบเพิ่มเติมจากวิศวกรที่เป็นมนุษย์ | ภายในเท่านั้น |
| 6 | การปรับใช้แบบเอเจนต์ | เอเจนต์ “ดูแล” การเปลี่ยนแปลงสู่การผลิต รวมถึงการเปิดตัวฟีเจอร์แฟล็ก และสร้างแดชบอร์ดของตัวเอง | ภายในเท่านั้น |
| 7 | การตรวจสอบการผลิต | เอเจนต์เฝ้าดูกราฟ, สัญญาณ และการแจ้งเตือนบนสแต็กการสังเกตการณ์ภายในของ OpenAI | ภายในเท่านั้น |
| 8 | ตรวจพบข้อผิดพลาด -> Sevbot | ตรวจสอบเหตุการณ์, เสนอแนวทางแก้ไข, ตอบคำถาม | ภายในเท่านั้น |
| 9 | Perf Factory | กรองการแจ้งเตือนที่ซ้ำกัน, ค้นหาการถดถอยของเวลาแฝง, เสนอการแก้ไข | ภายในเท่านั้น |
| 10 | วนกลับ | เอเจนต์แก้ไขปัญหาจนกว่า CI และการตรวจสอบจะผ่าน จากนั้นผู้สร้างจะได้รับข้อเสนอการแก้ไข | อธิบายถึงวงจรภายใน |
มีเพียงหนึ่งขั้นตอนเท่านั้นคือขั้นตอน CI บวกกับส่วนหนึ่งของขั้นตอนที่ 2 ที่ทีมภายนอกสามารถชี้และพูดได้ว่า “เราก็มีสิ่งนั้นด้วย” ทุกอย่างตั้งแต่การตรวจสอบแบบเอเจนต์ไปจนถึง Sevbot ล้วนเป็นการสร้างภายในของ OpenAI
คอลัมน์ที่ระบุว่า "ภายในเท่านั้น" นั้นก็เป็นปัญหาการจัดหาเช่นกัน ชิ้นส่วนที่ OpenAI เก็บไว้หลังไฟร์วอลล์, การจัดระบบ, ประตูการตรวจสอบ, การอนุมัติโดยมนุษย์ คือชั้นที่ทีมส่วนใหญ่ไม่มีสิ่งใดรองรับ Sharkly เป็นแพลตฟอร์มที่เป็นกลางสำหรับผู้ให้บริการในการสร้างสิ่งนี้: ผู้สร้างกำหนดผลลัพธ์เป็นงาน (Task), มอบหมายให้เอเจนต์ (Agent), และเอเจนต์จะทำงานบนคอมพิวเตอร์โดยใช้ Runtime ใดก็ตามที่คุณมีอยู่แล้ว ไม่ว่าจะเป็น Claude Code หรือ Codex สถานะ "พร้อมสำหรับการเผยแพร่" (Ready for Release) เป็นสถานะที่มนุษย์ต้องดำเนินการก่อนที่สิ่งใดจะเสร็จสิ้น ดังนั้นการอนุมัติจึงยังคงเป็นงานของบุคคล ไม่ใช่ของไปป์ไลน์ Sharkly ไม่ได้มาแทนที่ Codex หรือเขียนโค้ดด้วยตัวเอง แต่จะรัน Runtime ที่คุณจ่ายเงินไปแล้วและเป็นที่อยู่สำหรับวงจรโดยรอบ
ขั้นตอนที่ 1-2: มนุษย์ยังคงกำหนดเป้าหมาย, Codex ยังคงเขียนโค้ด
ผู้สร้างซอฟต์แวร์ ซึ่งหมายถึงวิศวกรหรือผู้จัดการผลิตภัณฑ์ จะเป็นผู้กำหนดผลลัพธ์ที่ต้องการ จากนั้น Codex จะทำการเปลี่ยนแปลงโค้ดหลายครั้งจนกว่าจะบรรลุเป้าหมายนั้นและตรวจสอบว่าผลลัพธ์ทำงานได้ดี วงจรการตรวจสอบนั้นเป็นส่วนหนึ่งของ Codex ที่จัดส่งในปัจจุบัน: แอปเดสก์ท็อป (Mac ในเดือนกุมภาพันธ์ 2026, Windows ในเดือนมีนาคม), การรวม ChatGPT Work ตั้งแต่เดือนกรกฎาคม 2026, ปลั๊กอินและทักษะตามบทบาท, และคำสั่ง /goal สำหรับงานที่ใช้เวลานาน หากคุณต้องการทราบกลไกของคำสั่งนั้น เราได้ กล่าวถึง /goal สำหรับการทำงานของเอเจนต์อัตโนมัติ แยกต่างหาก
สิ่งที่ยังไม่ได้จัดส่งคือกราฟบริบทที่ป้อนให้ Codex ภายใน: เกือบทุกระบบของ OpenAI ตั้งแต่ Slack threads ไปจนถึง Databricks dashboards บทความของ Orosz ระบุไว้อย่างชัดเจนว่า: Codex ภายในของ OpenAI “มีความก้าวหน้ามากกว่าเวอร์ชันภายนอกมาก เนื่องจากมันเชื่อมต่อกับเกือบทุกระบบของ OpenAI” ช่องว่างระหว่าง Codex ภายในและภายนอกนี้คือประเด็นหลักที่แท้จริงของบทความ
ขั้นตอนที่ 3: CI คือจุดที่วงจรถูกบังคับใช้จริง
นี่คือขั้นตอนที่ควรให้ความสำคัญ เพราะเป็นช่องเดียวในไปป์ไลน์ทั้งหมดที่ทีมใดๆ ไม่ใช่แค่ OpenAI เท่านั้น ที่เป็นเจ้าของอยู่แล้ว บทความระบุว่า CI ของ OpenAI กำลังถูกสร้างใหม่เพื่อรองรับภาระที่เพิ่มขึ้นประมาณ 10 เท่าในระยะเวลาประมาณหกเดือน เพราะตอนนี้เอเจนต์ผลักดันการเปลี่ยนแปลงผ่านไปป์ไลน์มากกว่าที่มนุษย์ทำได้มาก “Perf Harness” จะทำงานควบคู่ไปกับการตรวจจับการถดถอยของประสิทธิภาพก่อนที่จะถึงขั้นตอนการตรวจสอบ
นี่คือส่วนที่มักจะถูกมองข้าม: เอเจนต์ที่ “แก้ไขปัญหาจนกว่า CI และการตรวจสอบจะผ่าน” จะน่าเชื่อถือได้ก็ต่อเมื่อสิ่งที่ CI ตรวจสอบนั้นมีความครอบคลุม หากชุดทดสอบของคุณครอบคลุมตรรกะของหน่วย แต่ไม่ใช่สัญญา API เอเจนต์ก็สามารถวนซ้ำจนได้บิลด์สีเขียวที่ยังคงส่งมอบการเปลี่ยนแปลงที่ก่อให้เกิดปัญหาได้ รหัสสถานะ, รูปแบบ Schema, พฤติกรรมการยืนยันตัวตน, และงบประมาณเวลาตอบสนองภายใต้โหลด คือประเภทของการตรวจสอบที่ทีมส่วนใหญ่มักลงทุนน้อยเกินไปเมื่อเทียบกับการทดสอบหน่วย นี่คือช่องที่ Apidog เข้ามามีบทบาท: การรันสถานการณ์การทดสอบของ Apidog ผ่าน Apidog CLI ภายในขั้นตอน CI ของคุณ จะทำให้เอเจนต์ต้องผ่านเกตที่ยากกว่าแค่ “โค้ดคอมไพล์ผ่าน” เราได้เขียนเกี่ยวกับวิธีการเชื่อมต่อสิ่งนี้ใน Apidog CLI ภายใน Codex นั่นคือบทบาทเดียวที่ Apidog เล่นในไปป์ไลน์นี้ มันไม่ใช่เอเจนต์ และไม่เกี่ยวข้องกับการปรับใช้, การตรวจสอบ หรือการตอบสนองต่อเหตุการณ์
ขั้นตอนที่ 4-5: เอเจนต์ผู้เชี่ยวชาญด้านการตรวจสอบและการตัดสินใจความเสี่ยง
หลังจาก CI ผ่าน การตั้งค่าภายในของ OpenAI จะส่งการเปลี่ยนแปลงผ่านการตรวจสอบแบบขนานจากเอเจนต์ผู้เชี่ยวชาญด้านข้อมูล, โครงสร้างพื้นฐาน, คลาวด์ และความปลอดภัย Orosz อธิบายว่ามัน “เทียบเท่ากับการมีผู้เชี่ยวชาญเฉพาะด้านที่เป็นมนุษย์จากแต่ละทีมโครงสร้างพื้นฐานที่เกี่ยวข้องมาตรวจสอบทุกการเปลี่ยนแปลง” ซึ่งเป็นมาตรฐานการตรวจสอบที่เข้มงวดกว่าที่ทีมมนุษย์ส่วนใหญ่สามารถจัดหาบุคลากรมาทำได้สำหรับทุก pull request คุณสมบัติการตรวจสอบโค้ดที่จัดส่งมากับ Codex นั้นแตกต่างและเบากว่าเอเจนต์ผู้เชี่ยวชาญภายในเหล่านี้; หากคุณกำลังตัดสินใจว่าผู้ตรวจสอบแบบเอเจนต์ทั่วไปสามารถทำอะไรได้บ้างสำหรับสแต็กของคุณ สรุปเครื่องมือตรวจสอบโค้ด AI ของเรา เป็นจุดเริ่มต้นที่ดี และ บทความเสริมของเราเกี่ยวกับการออกแบบการตรวจสอบแบบเอเจนต์และเกตความเสี่ยงของ OpenAI เจาะลึกถึงช่องนี้ (น้อง, ยืนยันว่าออนไลน์ก่อนลิงก์)
การจัดประเภทความเสี่ยงจะเป็นตัวตัดสินว่าจะเกิดอะไรขึ้นต่อไป พื้นที่ที่มีความเสี่ยงต่ำของโค้ดเบสสามารถเลือกให้เอเจนต์อนุมัติ PR ของตัวเองโดยอัตโนมัติ ทำให้ไม่ต้องมีการอนุมัติโดยมนุษย์สำหรับประเภทการเปลี่ยนแปลงนั้นๆ การเปลี่ยนแปลงที่มีความเสี่ยงสูงจะได้รับการตรวจสอบจาก AI เพิ่มเติม, การตรวจสอบโดยมนุษย์ภาคบังคับ หรือทั้งสองอย่าง OpenAI ยังไม่ได้เผยแพร่กฎเกณฑ์ที่แน่ชัดว่าอะไรถือเป็นความเสี่ยงต่ำ และเราจะไม่คาดเดาในที่นี้ แนวคิดหนึ่งที่สามารถนำไปใช้ได้ทั่วไปนอกเหนือจากการตั้งค่าเฉพาะของ OpenAI: การเปลี่ยนแปลงที่ก่อให้เกิดผลกระทบ (breaking change) กับสัญญา API สาธารณะไม่ควรถูกจัดประเภทเป็นความเสี่ยงต่ำ ไม่ว่าจะดูเล็กน้อยเพียงใดก็ตาม เครื่องมือที่เน้น Spec เป็นอันดับแรกซึ่งเก็บคำจำกัดความ OpenAPI และการทดสอบของคุณไว้ในที่เดียวกัน ทำให้การแยกแยะนั้นง่ายต่อการบังคับใช้โดยอัตโนมัติ เนื่องจากความแตกต่างของ Schema เป็นสัญญาณความเสี่ยงที่ชัดเจนกว่าความแตกต่างของจำนวนบรรทัดมาก
ขั้นตอนที่ 6-8: การปรับใช้, การเฝ้าดู และการตอบสนอง โดยไม่ต้องรอการแจ้งเตือนจากมนุษย์ก่อน
หากการเปลี่ยนแปลงผ่านการตรวจสอบ เอเจนต์ภายในจะ “ดูแล” การปรับใช้สู่การผลิต รวมถึงการเปิดตัวฟีเจอร์แฟล็ก และสร้างแดชบอร์ดการตรวจสอบของตัวเองสำหรับการเปลี่ยนแปลงเฉพาะนั้น เมื่อใช้งานจริง เอเจนต์เดียวกัน (หรือเอเจนต์ที่เกี่ยวข้อง) จะเฝ้าดูกราฟและการแจ้งเตือนบนสแต็กการสังเกตการณ์ภายในของ OpenAI เมื่อมีสิ่งใดขัดข้อง Sevbot จะเข้าควบคุม: มันจะตรวจสอบเหตุการณ์ เสนอแนวทางแก้ไข และตอบคำถามของนักพัฒนาใน Slack สิ่งสำคัญคือต้องระบุให้ชัดเจนว่า Sevbot ไม่ได้ทำอะไร มันเสนอ; แต่มันไม่ได้ดำเนินการ มนุษย์ยังคงอนุมัติแนวทางแก้ไขและยังคงต้องเข้าเวรดูแลระบบ ดังที่บทความระบุไว้อย่างชัดเจนว่า “หน้าที่เข้าเวรดูแลระบบยังไม่ใช่เรื่องในอดีต” ไม่มีขั้นตอนใดในขั้นตอนที่ 6 ถึง 8 ที่มีอยู่ในผลิตภัณฑ์ Codex ที่คุณสามารถซื้อได้
ขั้นตอนที่ 9-10: การถดถอยของประสิทธิภาพและการวนกลับ
Perf Factory ทำงานควบคู่ไปกับเส้นทางเหตุการณ์ มันจะคัดแยกการแจ้งเตือนและแดชบอร์ด กรองสัญญาณที่ซ้ำกัน ค้นหาการถดถอยของเวลาแฝงที่แท้จริง และเสนอการแก้ไข ซึ่งจากนั้นจะไหลกลับไปยังผู้สร้างต้นฉบับ เมื่อรวมกับ Sevbot นี่คือคำตอบของ OpenAI สำหรับความเมื่อยล้าจากการแจ้งเตือน: แทนที่จะให้วิศวกรที่เข้าเวรคัดแยกทุกการแจ้งเตือน เอเจนต์จะกรองและวินิจฉัยล่วงหน้าก่อน วงจรจะปิดลงด้วยขั้นตอนที่ 10: เอเจนต์จะแก้ไขต่อไปจนกว่า CI และทุกชั้นการตรวจสอบจะผ่าน
เหตุใดขอบเขตภายใน/ภายนอกจึงสำคัญสำหรับทีมของคุณ
หากคุณกำลังประเมินว่าวิศวกรรมแบบเอเจนต์สไตล์ “OpenAI” เป็นสิ่งที่ทีมของคุณสามารถนำมาใช้ได้ในไตรมาสนี้ คำตอบที่ซื่อสัตย์คือ: คุณสามารถนำขั้นตอนที่ 1 ถึง 3 มาใช้ได้ในวันนี้ และขั้นตอนที่ 4 ถึง 9 อธิบายถึงทิศทาง ไม่ใช่คุณสมบัติที่ซื้อได้ นั่นไม่ใช่การวิจารณ์ OpenAI; เครื่องมือภายในขนาดนั้นต้องใช้เวลาหลายปี โครงการโอเพนซอร์สหนึ่งโครงการ orchflows เป็นความพยายามสาธารณะที่จะประมาณวงจรนี้ด้วยคำสั่ง /software-factory สำหรับ Claude Code และ Codex; README ของมันระบุเป้าหมายอย่างตรงไปตรงมา โดยโต้แย้งว่าคุณต้องการเพียงสองทักษะแทนที่จะเป็นคลังทักษะมากมาย มันเป็นโครงการเริ่มต้นที่ไม่มีส่วนเกี่ยวข้อง ไม่ใช่การเผยแพร่ของ OpenAI ดังนั้นให้ถือว่าเป็นเพียงตัวอย่างอ้างอิงมากกว่าโรงงานที่สามารถนำมาใช้งานได้ทันที
การนำไปใช้ภายใน OpenAI เองนั้นเคลื่อนที่อย่างรวดเร็วในส่วนที่ไม่ต้องการการวางระบบภายในที่กำหนดเอง: การใช้งาน Codex ในทีมที่ไม่ใช่วิศวกรรมเพิ่มขึ้นจากประมาณ 0% เป็น 90% ในสี่เดือน ตั้งแต่เดือนกุมภาพันธ์ถึงพฤษภาคม 2026 นั่นเป็นสัญญาณที่ชัดเจนกว่าไดอะแกรมไปป์ไลน์เพียงอย่างเดียว เพราะมันบอกว่าส่วนที่ง่าย (เอเจนต์ที่เขียนโค้ดตามเป้าหมายที่ระบุ) เป็นเรื่องปกติอยู่แล้วที่ OpenAI ในขณะที่ส่วนที่ยาก (การปรับใช้, การตรวจสอบ และการตอบสนองต่อเหตุการณ์แบบเอเจนต์ที่เชื่อมโยงเข้ากับทุกระบบภายใน) ยังคงเป็นการสร้างเฉพาะ
สิ่งที่ยังคงเป็นมนุษย์
บทความนี้ระมัดระวังเกี่ยวกับสิ่งที่ไม่เปลี่ยนแปลง ผู้สร้างยังคงกำหนดผลลัพธ์ มนุษย์ยังคงอนุมัติการเปลี่ยนแปลงที่มีความเสี่ยงสูงและอนุญาตการบรรเทาเหตุการณ์ มีคนยังคงตรวจสอบสิ่งที่ Sevbot ทำหลังจากนั้น และการหมุนเวรเข้ากะยังคงมีอยู่ ประโยคที่บทความปิดท้ายนั้นจับภาพการเปลี่ยนแปลงได้ดีกว่าสถิติใดๆ: “การตัดสิน, การจัดลำดับความสำคัญ และรสนิยมกำลังมีความสำคัญมากขึ้น” ข้อควรระวังสองประการที่ทำให้สิ่งนี้ยังคงมีเหตุผล: การตรวจสอบแอปสโตร์บนมือถือยังคงเป็นคอขวดที่ต้องทำด้วยตนเองที่ไม่มีเอเจนต์ใดสามารถหลีกเลี่ยงได้ และการปรับขนาดโครงสร้างพื้นฐานเป็นการต่อสู้รายเดือน ไม่ใช่ปัญหาที่แก้ไขได้แล้ว
หากคุณกำลังสร้างเวอร์ชันของคุณเองของขั้นตอนที่ 1 ถึง 3 แทนที่จะรอให้ผู้ขายจัดส่งขั้นตอนที่ 4 ถึง 9 ให้เริ่มต้นด้วยเกตที่มีอยู่แล้วในไปป์ไลน์ของคุณ: CI บทความเสริมของเราเกี่ยวกับ การสร้างโรงงานซอฟต์แวร์ที่มีน้ำหนักเบากว่ารอบ Codex จะอธิบายถึงการสร้างนั้น (น้อง, ยืนยันว่าออนไลน์ก่อนลิงก์) และการออกแบบ Sevbot/Perf Factory จะได้รับการกล่าวถึงแยกต่างหากใน บทความของเราเกี่ยวกับโรงงานประสิทธิภาพและ Sevbot ของ OpenAI (น้อง, ยืนยันว่าออนไลน์ก่อนลิงก์) เอเจนต์ที่วนซ้ำจนกว่าการทดสอบจะผ่านเป็นความคิดที่ดีก็ต่อเมื่อการทดสอบที่มันวนซ้ำนั้นยืนยันบางสิ่งบางอย่างจริง ๆ Apidog จะเก็บการทดสอบสัญญา API ไว้ข้างๆ Spec เพื่อให้เกตนั้นยังคงซื่อสัตย์ในขณะที่เอเจนต์ ไม่ใช่แค่มนุษย์ เริ่มผลักดันการเปลี่ยนแปลงผ่านมัน