
NVIDIA ได้เปิดตัวโมเดล speech-to-text แบบ open-weight ที่แม่นยำที่สุดบน Hugging Face Open ASR Leaderboard และคุณสามารถใช้งานได้ฟรีตั้งแต่วันนี้ Nemotron 3.5 Transcribe (ชื่อเต็ม NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) เปิดตัวเมื่อวันที่ 28 ตุลาคม 2026 ภายใต้สัญญาอนุญาต OpenMDW-1.1 ซึ่งอนุญาตให้ใช้งานเชิงพาณิชย์ได้ นั่นหมายความว่ามีสามเส้นทางที่ราคา $0: demo Space ของ NVIDIA เอง, weights ฟรีบน GPU ของคุณเอง และ community Spaces ที่ห่อหุ้ม checkpoint เดียวกัน
คู่มือนี้ครอบคลุมแต่ละเส้นทางฟรี ความสามารถและข้อจำกัด รวมถึงทางเลือกแบบเสียค่าใช้จ่ายที่ถูกที่สุดเมื่อเส้นทางฟรีไม่เพียงพอ ข้อเท็จจริงทุกอย่างมาจาก model card อย่างเป็นทางการ, โพสต์เปิดตัวของ NVIDIA บน Hugging Face และ Open ASR Leaderboard ทั้งหมดอ่านเมื่อวันที่ 29 ตุลาคม 2026
หากคุณต้องการเพียง hosted API ให้ข้ามไปที่ คู่มือ Nemotron 3.5 Transcribe API ของเรา
Nemotron 3.5 Transcribe ฟรีหรือไม่?
ใช่ ในสองลักษณะ weights สามารถดาวน์โหลดได้ฟรีและสัญญาอนุญาตอนุญาตให้ใช้งานเชิงพาณิชย์และไม่เชิงพาณิชย์ ดังนั้นการ self-host จะมีค่าใช้จ่ายเพียงฮาร์ดแวร์เท่านั้น NVIDIA ยังเปิด demo Space ฟรีบน Hugging Face ที่คุณสามารถลองใช้งานได้ในเบราว์เซอร์
สิ่งที่ไม่ได้ฟรีคือ hosted APIs DeepInfra คิดค่าบริการ $0.002 ต่อนาทีของเสียง และ OpenRouter ระบุไว้ที่ $0.000033 ต่อวินาที ทั้งสองไม่มีตัวเลือกฟรี และ ณ วันที่ 29 ตุลาคม 2026 โมเดลนี้ยังไม่ปรากฏบน build.nvidia.com ซึ่งโมเดล NVIDIA หลายตัวมี free trial API การค้นหา "transcribe" ที่นั่นส่งคืนโมเดล ASR ภาษาสเปนที่ไม่เกี่ยวข้องหนึ่งตัว
ทำไมผู้คนจึงต้องการมัน: ตัวเลข
Nemotron 3.5 Transcribe เป็นโมเดลภาษาที่เสริมด้วยเสียง ASR encoder ขนาด 600M พารามิเตอร์และ speaker encoder ป้อนข้อมูลเข้าสู่โมเดลภาษาแบบ mixture-of-experts ที่ผสมผสาน Mamba-2 และ Transformer มีพารามิเตอร์ทั้งหมด 34B แต่มีเพียงประมาณ 4.3B ที่ทำงานต่อ token ซึ่งเป็นเหตุผลที่มันรันบน GPU เดียวได้
สิ่งที่มันทำได้ใน checkpoint เดียว:
- ถอดความใน 40 ภาษา โดย 13 ภาษาถูกจัดอยู่ในระดับ "leading" (อังกฤษ สเปน ฝรั่งเศส เยอรมัน ฮินดี เกาหลี โปรตุเกส และอื่นๆ)
- บันทึกเสียงนานถึงหนึ่งชั่วโมง ในการร้องขอเดียว (context 65,536 token)
- ระบุผู้พูด รองรับผู้พูดที่ติดป้ายได้ถึงแปดคน
- timestamps ระดับคำ ผ่าน CTC alignment head
- แปลเสียงพูด ไปและกลับจากภาษาอังกฤษใน 31 ภาษา
- Context prompting: ส่งชื่อและศัพท์เฉพาะเพื่อให้สะกดได้ถูกต้อง
- การตอบคำถามเกี่ยวกับเสียง (อังกฤษเท่านั้น)
บน Open ASR Leaderboard ที่อัปเดตเมื่อวันที่ 28 ตุลาคม 2026 มันได้คะแนน average WER 5.33% ซึ่งจัดอยู่ในอันดับที่ 9 จาก 61 โมเดล แปดตัวที่อยู่เหนือกว่า (Otter, Zoom Scribe v2 Pro, ElevenLabs Scribe v2, Azure Speech และอื่นๆ) ล้วนเป็น closed, paid API ในบรรดาโมเดลที่คุณดาวน์โหลดได้ ไม่มีอะไรจัดอันดับสูงกว่า whisper-large-v3 ของ OpenAI อยู่อันดับที่ 41 ที่ 7.16%
model card ของ NVIDIA เองรายงาน mean WER 4.71% บนชุดข้อมูลสาธารณะเก้าชุด ส่วน 5.33% ของ leaderboard เพิ่มชุดข้อมูลส่วนตัวอีกสองชุด ดังนั้นทั้งสองตัวเลขจึงซื่อสัตย์ ทั้งคู่วัดการผสมที่แตกต่างกัน
ข้อจำกัดหนึ่งที่ควรทราบก่อนเริ่ม: มันเป็นโมเดลแบบออฟไลน์ มันถอดความไฟล์ที่บันทึกไว้ ไม่ใช่สตรีมไมโครโฟนสด
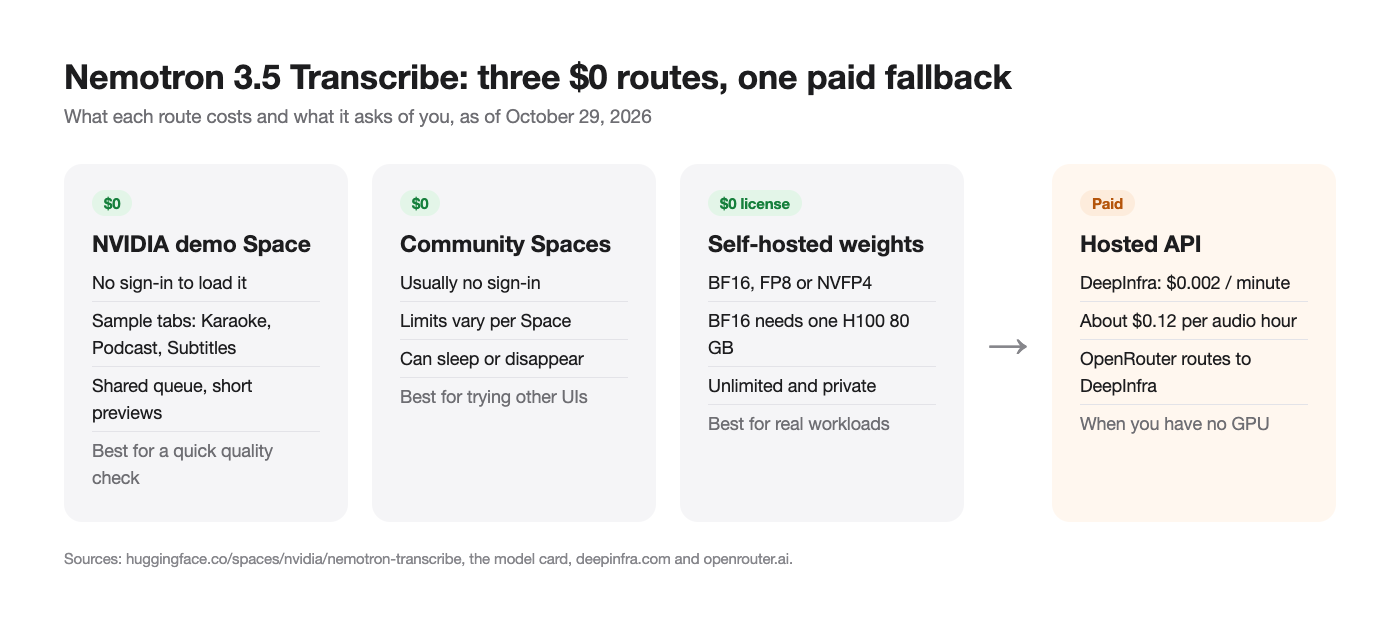
เปรียบเทียบทุกเส้นทางฟรีและเสียค่าใช้จ่าย
| เส้นทาง | ค่าใช้จ่าย | การลงชื่อเข้าใช้ | ข้อจำกัด | เหมาะสำหรับ |
|---|---|---|---|---|
NVIDIA demo Space (nvidia/nemotron-transcribe) |
$0 | ไม่ | ตัวอย่าง 60 วินาทีบนแท็บตัวอย่าง; คิวที่ใช้ร่วมกัน | ตรวจสอบคุณภาพอย่างรวดเร็ว |
| Community Spaces | $0 | โดยปกติไม่ | แตกต่างกันไปในแต่ละ Space; อาจ sleep หรือหายไป | ลอง UI อื่นๆ |
| Self-hosted weights (BF16, FP8, NVFP4) | $0 สัญญาอนุญาต, GPU ของคุณเอง | บัญชี Hugging Face เพื่อดาวน์โหลด | หนึ่ง H100 80 GB สำหรับ BF16; การ์ดเล็กกว่าต้องใช้ FP8 หรือ NVFP4 | ถอดความส่วนตัวแบบไม่จำกัด |
| DeepInfra API | $0.002 ต่อนาที | บัญชีและ API key | การใช้งานแบบเสียค่าใช้จ่าย | โปรดักชันโดยไม่มี GPU |
| OpenRouter | $0.000033 ต่อวินาที | บัญชีและเครดิต | ส่งต่อไปยัง DeepInfra เท่านั้น | key เดียวสำหรับหลายโมเดล |
| build.nvidia.com | ยังไม่ระบุ | ไม่เกี่ยวข้อง | ไม่เกี่ยวข้อง | จับตาดู |
มีเพียงสามแถวแรกเท่านั้นที่ไม่มีค่าใช้จ่าย
เส้นทางฟรี 1: demo Space ของ NVIDIA
วิธีที่เร็วที่สุดในการฟังว่าโมเดลทำอะไรได้คือ Space อย่างเป็นทางการของ NVIDIA ที่ huggingface.co/spaces/nvidia/nemotron-transcribe
- เปิด Space ในเบราว์เซอร์ของคุณ ไม่ต้องใช้บัญชีในการโหลด
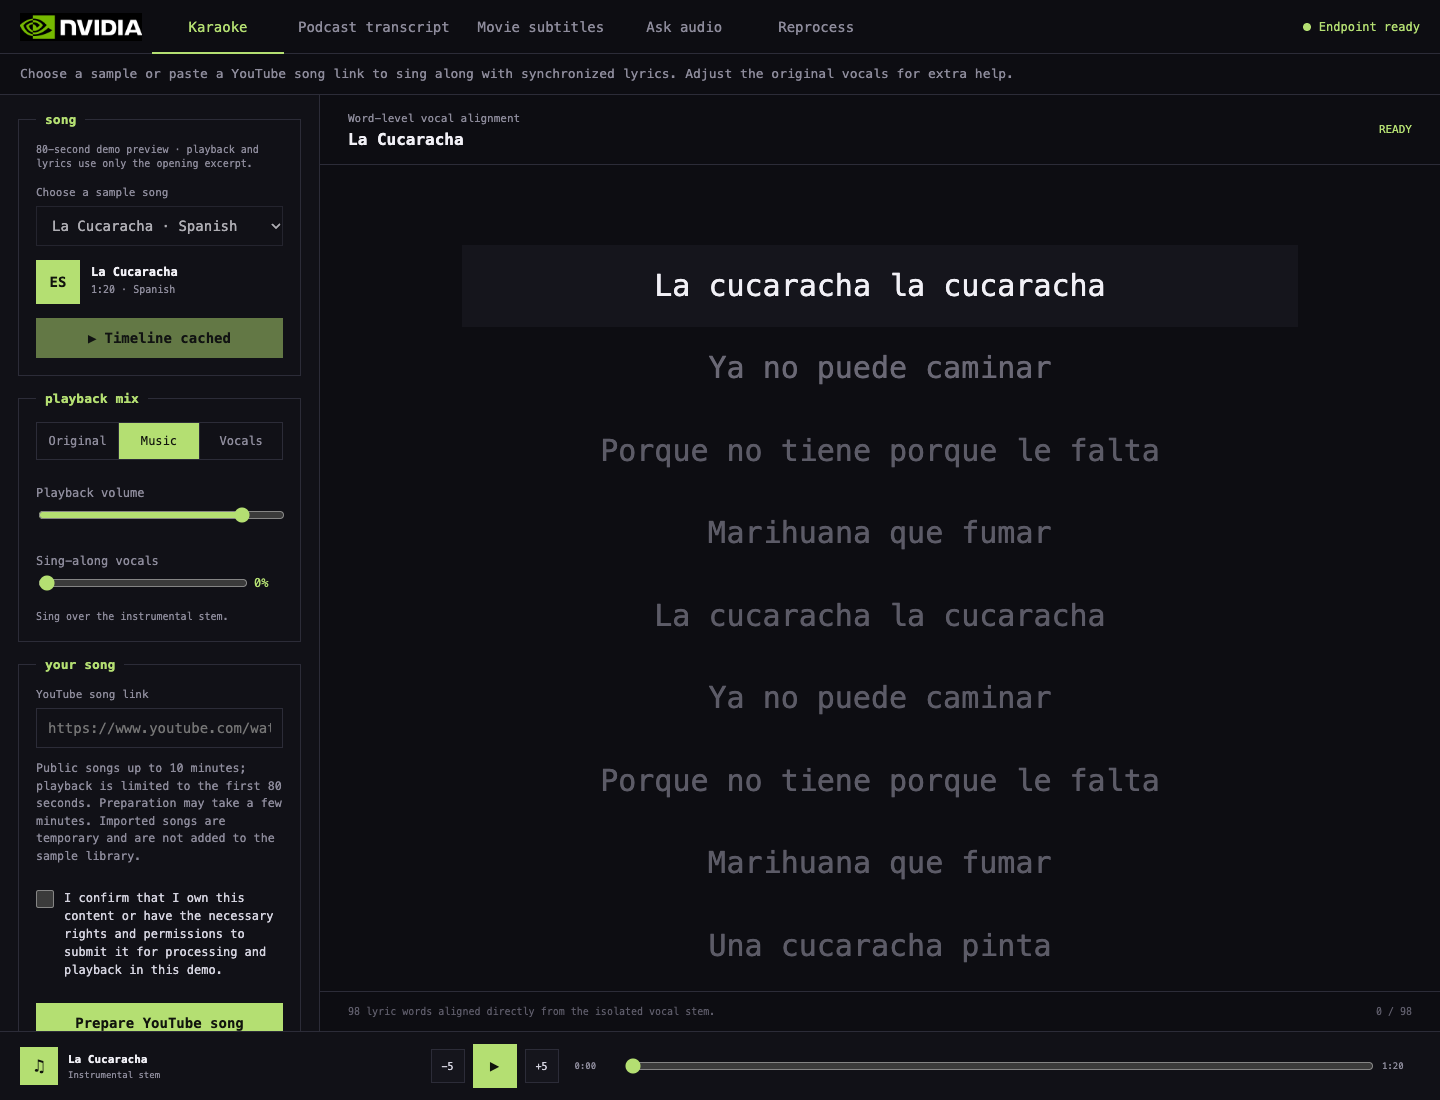
- เลือกแท็บ ณ วันที่ 29 ตุลาคม 2026 Space มีสามแท็บ: Karaoke (เนื้อเพลงที่จัดเวลาเป็นคำ), Podcast transcript (ข้อความที่มีการระบุผู้พูด) และ Movie subtitles (คำบรรยายที่จัดเวลา)
- เลือกตัวอย่างหรือวางลิงก์ตามที่แท็บอนุญาต แท็บ Karaoke ระบุว่าตัวอย่างครอบคลุม 60 วินาทีแรก
- รันและอ่านผลลัพธ์ มุมมอง Karaoke ไฮไลต์แต่ละคำขณะร้อง ซึ่งแสดงให้เห็น timestamps ระดับคำ
มองว่า Space เป็นเพียง demo ไม่ใช่ API ฟรี Public Spaces ใช้ GPU ร่วมกัน จัดคิวการร้องขอ และอาจเปลี่ยนแปลงโดยไม่แจ้งล่วงหน้า อย่าสร้างผลิตภัณฑ์บนมัน
เส้นทางฟรี 2: รัน open weights ด้วยตัวเอง
นี่คือ free tier ที่แท้จริง: การถอดความแบบไม่จำกัดบนฮาร์ดแวร์ที่คุณมีอยู่แล้ว โดยไม่มีข้อมูลออกจากเครื่องของคุณ สัญญาอนุญาต (OpenMDW-1.1) อนุญาตให้ใช้งานเชิงพาณิชย์ได้所以你สามารถส่งมันไปในผลิตภัณฑ์ได้
ข้อจำกัดคือฮาร์ดแวร์ การตั้งค่าอ้างอิงของ NVIDIA คือ H100 80 GB หนึ่งตัวใน BF16 ตารางความเข้ากันได้บน model card ระบุ:
- BF16: H100, H200, A100 80 GB, B200, GB200, DGX Spark
- FP8: H100, H200, L40S 48 GB
- NVFP4 เท่านั้น: RTX 5090 (32 GB) และ RTX PRO 6000 Blackwell
ดังนั้น RTX 5090 สำหรับผู้บริโภคใช้ได้ กับ checkpoint NVFP4 การ์ดรุ่นเก่า 24 GB เช่น RTX 4090 ไม่ได้อยู่ในรายการ
การทดสอบที่เร็วที่สุดต้องการเพียงติดตั้ง Transformers จาก source:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

inputs = processor.apply_transcription_request("meeting.wav").to(model.device)
outputs = model.generate(**inputs, max_new_tokens=1024)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=True))
วิธีนี้ใช้ได้ดีสำหรับไฟล์ไม่กี่ไฟล์สำหรับการประมวลผลเป็นชุด บันทึกเสียงยาว และ endpoint ที่เข้ากันได้กับ OpenAI ให้เสิร์ฟด้วย vLLM 0.32.0 และปลั๊กอิน NeMo Speech คำแนะนำแบบทีละขั้นตอนของเราในการรัน Nemotron 3.5 Transcribe ในเครื่อง มีการติดตั้งที่แน่นอนและคำสั่ง vllm serve จาก model card
ไม่มี GPU ในเครื่อง? การเช่าตามชั่วโมงเป็นเส้นทาง "เกือบฟรี" ที่ถูกที่สุดสำหรับงานค้างจำนวนมาก NVIDIA กล่าวว่า RTX PRO 6000 Blackwell หนึ่งตัวสามารถประมวลผลเสียง 100 ชั่วโมงในเวลาไม่ถึงสามนาทีด้วยบิลด์ NVFP4 แม้ว่าตัวเลขนั้นใช้การเพิ่มประสิทธิภาพการเสิร์ฟที่ยังไม่ open source
เส้นทางฟรี 3: community Spaces
หน้าของโมเดลระบุ community Spaces หลายแห่งที่สร้างบน checkpoint เดียวกัน รวมถึง hugging-apps/nemotron-3-5-transcribe และ mrfakename/nemotron-3.5-transcribe พวกมันมีประโยชน์เมื่อคิวของ NVIDIA Space ยาวหรือคุณต้องการกล่องอัปโหลดแบบธรรมดา พวกมันดำเนินการโดยบุคคล ดังนั้นคาดว่าจะมี sleep โควตา และลิงก์เสียเป็นครั้งคราว
Prompts ที่ให้ผลลัพธ์ฟรีที่ดีขึ้น
Nemotron 3.5 Transcribe รับคำสั่งภาษาธรรมชาติ สิ่งเหล่านี้มาจาก model card และรายการของ DeepInfra ปล่อยให้ system prompt ว่างไว้สำหรับการถอดความและใช้ temperature 0
ข้อความที่สะอาดและอ่านง่าย:
Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only.
ใครพูดอะไร:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
ชื่อผลิตภัณฑ์และศัพท์เฉพาะ:
Transcribe with punctuation and capitalization. Context terms: Apidog, OpenAPI, Kubernetes, gRPC.
การแปล:
Please translate the given speech to English.
Context terms สำคัญกว่าที่คุณคาดคิด บน ContextASR benchmark ของ NVIDIA WER ลดลงจาก 3.33% โดยไม่มี context เป็น 1.71% ด้วย context แบบละเอียด
เมื่อฟรีไม่เพียงพอ: เส้นทางเสียค่าใช้จ่ายที่ถูกที่สุด
หากคุณไม่มี GPU ที่รองรับและต้องการมากกว่า demo hosted API ก็ราคาถูก ที่ $0.002 ต่อนาทีของ DeepInfra บันทึกเสียงหนึ่งชั่วโมงมีค่าใช้จ่าย $0.12 และ 1,000 ชั่วโมงมีค่าใช้จ่าย $120 ส่วน $0.000033 ต่อวินาทีของ OpenRouter คิดเป็นประมาณ $0.119 ต่อชั่วโมง ส่งต่อไปยังผู้ให้บริการเดียวกัน
คำขอ DeepInfra ขั้นต่ำ จากหน้าของ API:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@meeting.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
การตอบสนองประกอบด้วย text, segments พร้อมเวลาเริ่มต้นและสิ้นสุด, words และ language ที่ตรวจพบ คู่มือ API ของเราอธิบายคีย์ ฟิลด์การตอบสนอง และค่าใช้จ่ายโดยละเอียด
ให้ coding agent ของคุณทดสอบ endpoint ด้วย Apidog CLI
ไม่ว่าคุณจะ self-host หรือใช้ DeepInfra คุณต้องการการตรวจสอบที่ล้มเหลวอย่างชัดเจนเมื่อการถอดความกลับมาว่างเปล่าหรือผิดภาษา มอบงานนั้นให้ coding agent ของคุณและ Apidog CLI แทนที่จะตรวจสอบ JSON ด้วยตาเปล่า
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code, Codex, Cursor or OpenCode
จากนั้นให้ prompt หนึ่งอย่างกับ agent ของคุณ:
In Apidog project <id>, create a test case for POST {{baseUrl}}/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
that uploads samples/hello.mp3 as the "audio" form field, asserts status 200, a non-empty "text",
"language" equal to "en", and at least one item in "words", then run it against the
deepinfra environment and summarize any failures.
agent จะอ่าน schema ตรวจสอบ payload เขียนเคสและรันมัน:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
สลับ environment ให้ชี้ไปที่เซิร์ฟเวอร์ในเครื่องของคุณเมื่อคุณย้ายจาก API ไปยัง self-hosting apidog run แบบเดียวกันกับ -r junit หยดลงใน CI; ดูการรัน Apidog CLI ใน CI/CD pipeline และApidog CLI ใน Claude Code สำหรับการตั้งค่า
ข้อจำกัดที่ควรทราบก่อนพึ่งพามัน
- ออฟไลน์เท่านั้น มันไม่สตรีม NVIDIA ชี้ไปที่โมเดล Nemotron 3.5 ASR Streaming แยกต่างหากสำหรับเสียงสด
- Audio Q&A เป็นภาษาอังกฤษเท่านั้น การถอดความครอบคลุม 40 ภาษา แต่ความเข้าใจเสียงและคำสั่งพูดถูกประเมินเฉพาะในภาษาอังกฤษ
- ป้ายผู้พูดไม่ใช่ตัวตน
<spk:0>หมายถึง "เสียงแรก" ไม่ใช่บุคคลที่ระบุชื่อ - ผลลัพธ์ยาวต้องมีที่ว่าง บทสนทนาหนึ่งชั่วโมงแบบหนาแน่นสามารถสร้าง output ประมาณ 20,000 token ดังนั้นตั้งค่า
max_new_tokensให้เหมาะสม - มันอาจ hallucinate ได้ model card เตือนว่ามันอาจ "สร้าง transcript ที่ดูสมเหตุสมผล" สำหรับเสียงที่ไม่ชัดเจน ตรวจสอบทุกอย่างที่เกี่ยวข้องกับกฎหมายหรือการแพทย์
คำถามที่พบบ่อย
Nemotron 3.5 Transcribe ฟรีสำหรับการใช้งานเชิงพาณิชย์หรือไม่? ใช่ สัญญาอนุญาต OpenMDW-1.1 อนุญาตให้ใช้งาน weights เชิงพาณิชย์และไม่เชิงพาณิชย์ Hosted APIs คิดค่าบริการสำหรับการประมวลผล
มี Nemotron 3.5 Transcribe API key ฟรีหรือไม่? ไม่พบในวันที่ 29 ตุลาคม 2026 DeepInfra และ OpenRouter เป็นแบบเสียค่าใช้จ่าย และมันยังไม่อยู่บน build.nvidia.com เปรียบเทียบกับAPI ฟรีของ NVIDIA สำหรับ Nemotron Nano 12B v2 VL ซึ่งได้ free trial endpoint
รันบน Mac ได้หรือไม่? ไม่จากรายการอย่างเป็นทางการ รันไทม์ที่รองรับกำหนดเป้าหมาย GPU ของ NVIDIA บน Linux หรือ Windows (WSL2) การรองรับ GGML ระบุไว้สำหรับ RTX 5090 และ RTX PRO 6000 เท่านั้น
เปรียบเทียบกับ Whisper อย่างไร? บน leaderboard วันที่ 28 ตุลาคม มันได้ average WER 5.33% เทียบกับ 7.16% สำหรับ whisper-large-v3 ดูคู่มือ Whisper API ของเราสำหรับตัวเลือก hosted ของ OpenAI และการจัดอันดับโมเดล speech-to-text open-source ที่ดีที่สุดของเราสำหรับภาพรวมทั้งหมด
รองรับ MP3 หรือไม่? ใช่ รองรับ WAV, FLAC, MP3, OGG หรืออะไรก็ตามที่ถอดรหัสเป็น PCM 16 kHz mono ใช้FFmpeg เพื่อแปลงรูปแบบอื่นๆ
สรุป
Nemotron 3.5 Transcribe ฟรีในส่วนที่สำคัญ: weights สัญญาอนุญาต และ demo ของ NVIDIA ลองใช้ Space เพื่อตรวจสอบคุณภาพ self-host บน H100, L40S หรือ RTX 5090 เพื่อการใช้งานส่วนตัวแบบไม่จำกัด และใช้ DeepInfra ที่ $0.12 ต่อชั่วโมงเมื่อคุณไม่มีฮาร์ดแวร์ ไม่ว่าคุณจะเลือกเส้นทางใด ให้ agent ของคุณรันการตรวจสอบ Apidog บน endpoint เพื่อให้ transcript ที่ไม่ดีไม่ไปถึงโปรดักชัน