การถอดเสียงบันทึกหนึ่งชั่วโมงด้วย Nemotron 3.5 Transcribe API ตัวใหม่ของ NVIDIA มีค่าใช้จ่าย 12 เซนต์ นั่นคือราคาของ DeepInfra ที่ $0.002 ต่อนาทีสำหรับโมเดล open-weight ชั้นนำบน Hugging Face Open ASR Leaderboard ซึ่งเป็นโมเดลที่คืนค่า word timestamps, speaker labels และภาษาที่ตรวจพบได้ในการเรียกครั้งเดียว
คู่มือนี้จะแนะนำวิธีขอ API key, การส่งคำขอครั้งแรก, การอ่านผลลัพธ์, การเขียน prompt สำหรับ speaker labels และศัพท์เฉพาะทาง ตลอดจนวิธีทำให้ค่าใช้จ่ายคาดเดาได้ ทุกอย่างด้านล่างนี้ตรวจสอบเมื่อวันที่ 29 ตุลาคม 2026 เทียบกับหน้าโมเดลบน DeepInfra, รายการบน OpenRouter และmodel card อย่างเป็นทางการ
กำลังมองหาช่องทางฟรี $0 อยู่ใช่ไหม? อ่านวิธีใช้ Nemotron 3.5 Transcribe ฟรี
Nemotron 3.5 Transcribe API ให้อะไรคุณบ้าง
NVIDIA เปิดตัว Nemotron 3.5 Transcribe (NVIDIA-Nemotron-3.5-Transcribe-30B-A4B) เมื่อวันที่ 28 ตุลาคม 2026 เป็นโมเดลเสียงแบบ open-weight ที่มีพารามิเตอร์รวม 34B และ active ประมาณ 4.3B สร้างบนโมเดลภาษาผสม Mamba-2 และ Transformer แบบ mixture-of-experts พร้อมต่อ ASR encoder และ speaker encoder เข้าไป
จาก endpoint เดียวคุณจะได้:
- การถอดเสียงใน 40 ภาษา
- ไฟล์ยาวสูงสุด หนึ่งชั่วโมง
- Word timestamps และ segment timestamps
- ข้อความถอดเสียงแบบระบุผู้พูดได้สูงสุดแปดคน
- การแปลเสียงพูดข้าม 31 ภาษาจากและไปยังภาษาอังกฤษ
- Context prompting สำหรับชื่อ, สินค้า และศัพท์เฉพาะทาง
- การระบุภาษา
บน Open ASR Leaderboard (อัปเดต 28 ตุลาคม 2026) มีค่า WER เฉลี่ย 5.33% อยู่อันดับ 9 จาก 61 โมเดล และอันดับหนึ่งในกลุ่มโมเดลที่มีน้ำหนักเปิดเผยสาธารณะ ส่วนแปดโมเดลที่อยู่เหนือขึ้นไปเป็น API เชิงพาณิชย์แบบปิด
มันเป็นโมเดลแบบ offline ส่งไฟล์บันทึกที่อัดไว้แล้ว ไม่ใช่สตรีมสด
จะเรียกใช้จากที่ไหน และมีค่าใช้จ่ายเท่าไร
ที่อัตรานี้ เสียง 1,000 ชั่วโมงมีค่าใช้จ่ายประมาณ $120 เมื่อเทียบกันแล้ว OpenAI Whisper API เคยคิดราคา $0.006 ต่อนาที ซึ่งเป็นสามเท่าของราคา DeepInfra และ whisper-large-v3 อยู่อันดับ 41 บน leaderboard เดียวกันที่ 7.16% WER
ขั้นตอนที่ 1: ขอ API key ของ DeepInfra
- สมัครบัญชีที่ deepinfra.com
- เปิด dashboard แล้วสร้าง API key
- เพิ่มวิธีการชำระเงินหรือเครดิต หน้าโมเดลต้องเข้าสู่ระบบแม้แต่จะใช้เดโมในเบราว์เซอร์
- export key ในเชลล์ของคุณ:
export DEEPINFRA_API_KEY="your_key_here"
อย่าให้ key หลุดเข้าไปใน source control ถ้าคุณทำงานผ่าน coding agent ให้ใส่ไว้ใน environment ของ agent ไม่ใช่ใน prompt
ขั้นตอนที่ 2: ถอดเสียงไฟล์แรกของคุณ
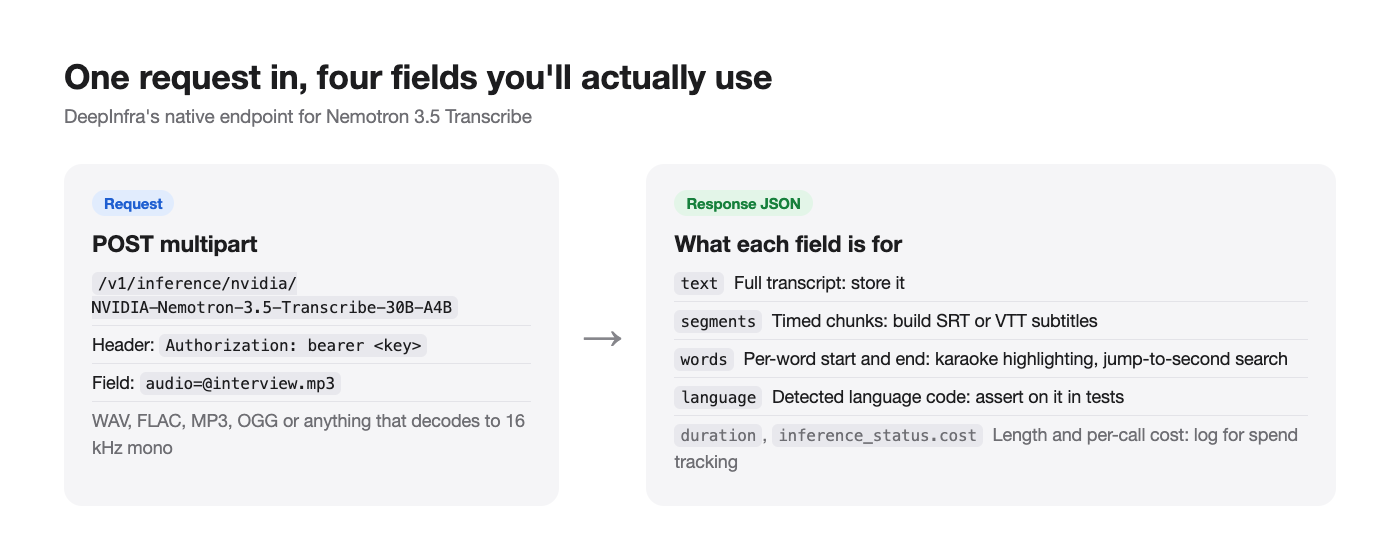
endpoint การ inference แบบเนทีฟของ DeepInfra รับ multipart upload ที่มีฟิลด์ audio นี่คือรูปแบบคำขอที่แน่นอนจากหน้า API ของมัน:
curl -X POST \
  -H "Authorization: bearer $DEEPINFRA_API_KEY" \
  -F audio=@interview.mp3 \
  'https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B'
โมเดลรองรับ WAV, FLAC, MP3, OGG หรือรูปแบบใดก็ตามที่ถอดรหัสเป็น PCM mono 16 kHz ได้ ถ้าคุณมีไฟล์ M4A หรือวิดีโอ ให้แปลงด้วย FFmpegก่อน:
ffmpeg -i call.m4a -ar 16000 -ac 1 call.wav
ขั้นตอนที่ 3: อ่านผลลัพธ์
DeepInfra ระบุรูปแบบผลลัพธ์ไว้ดังนี้ (ค่าด้านล่างเป็นเพียงตัวอย่าง):
{
  "text": "Hello World",
  "segments": [
    { "id": 0, "start": 0.0, "end": 1.0, "text": "Hello" },
    { "id": 1, "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "language": "en",
  "words": [
    { "start": 0.0, "end": 1.0, "text": "Hello" },
    { "start": 4.0, "end": 5.0, "text": "World" }
  ],
  "duration": 5.0,
  "inference_status": { "status": "succeeded", "runtime_ms": 0, "cost": 0.0 }
}
แต่ละฟิลด์ใช้ทำอะไร:
textคือข้อความถอดเสียงทั้งหมด เก็บค่านี้ไว้segmentsให้ท่อนที่มีการระบุเวลา ใช้สำหรับคำบรรยาย (SRT หรือ VTT)wordsให้เวลาของแต่ละคำ ใช้สำหรับการไฮไลต์แบบคาราโอเกะหรือการค้นหาที่กระโดดไปยังวินาทีที่แน่นอนlanguageคือรหัสภาษาที่ตรวจพบ ให้ assert กับค่านี้ในการทดสอบ เพราะภาษาที่ผิดเป็นความล้มเหลวที่พบบ่อยกับคลิปสั้นinference_status.costรายงานว่าการเรียกครั้งนั้นมีค่าใช้จ่ายเท่าไร ให้บันทึก log เพื่อติดตามค่าใช้จ่ายต่อไฟล์
ขั้นตอนที่ 4: เรียกใช้จาก Python
import os
import requests

URL = "https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"

def transcribe(path: str) -> dict:
    with open(path, "rb") as f:
        r = requests.post(
            URL,
            headers={"Authorization": f"bearer {os.environ['DEEPINFRA_API_KEY']}"},
            files={"audio": f},
            timeout=600,
        )
    r.raise_for_status()
    return r.json()

result = transcribe("interview.mp3")
print(result["language"], len(result["words"]), "words")
print(result["text"][:500])
ตั้ง timeout ยาว ๆ เสียงพูดต่อเนื่องหนึ่งชั่วโมงเต็มสามารถสร้าง output ได้ประมาณ 20,000 tokens และ model card เตือนว่างานที่ยาวใช้เวลานาน
DeepInfra ยังมีแท็บ "OpenAI Speech-to-Text" สำหรับโมเดลนี้ด้วย ดังนั้นโค้ด OpenAI SDK ที่เรียก audio.transcriptions น่าจะชี้ไปที่ base URL แบบ OpenAI-compatible ของ DeepInfra ได้ ตรวจสอบแท็บนั้นเพื่อดู base URL ที่แน่นอนก่อนสลับโค้ดโปรดักชัน
Prompt: คำต่อคำ, เรียบเรียง, ผู้พูด, ศัพท์เฉพาะ
สิ่งที่ทำให้ Nemotron 3.5 Transcribe แตกต่างจาก ASR API รุ่นเก่าคือมันรับคำสั่งได้ prompt ที่ NVIDIA แนะนำ ซึ่งระบุไว้ในหน้า DeepInfra:
| สิ่งที่คุณต้องการ | คำสั่ง |
|---|---|
| คำต่อคำ | Audio transcription. Language: as spoken. Wording: verbatim, including fillers and repetitions. Formatting: punctuation and capitalization. Output: transcript only. |
| ข้อความที่อ่านง่าย | Audio transcription. Language: as spoken. Wording: omit fillers and accidental repetitions; keep the remaining spoken wording unchanged. Formatting: punctuation and capitalization. Output: transcript only. |
| คำศัพท์เฉพาะทาง | Transcribe with punctuation and capitalization. Context terms: <names and terms>. |
| ใครพูดอะไร | Transcribe verbatim, including fillers. ... Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. |
| การแปล | Please translate the given speech to <target language>. |
ใช้ temperature 0 โดยปิด reasoning สำหรับการถอดเสียง การแปล และการระบุภาษา และปล่อย system prompt ให้ว่างไว้
Context terms ให้ผลตอบแทนคุ้มค่า NVIDIA รายงานว่า WER ของ ContextASR-Bench ลดจาก 3.33% เมื่อไม่มี context เหลือ 1.71% เมื่อมี context แบบละเอียด และ Earnings22 แบบมี context ลดจาก 12.54% เหลือ 9.58% สำหรับการประชุมรายงานผลประกอบการ ให้ส่งชื่อบริษัท ชื่อย่อหุ้น และชื่อผู้บริหารเข้าไป
ตรวจสอบแท็บ input schema ของ DeepInfra เพื่อดูฟิลด์ที่บรรจุคำสั่งบน endpoint แบบเนทีฟ บนเซิร์ฟเวอร์ที่โฮสต์เอง คำสั่งจะไปอยู่ใน chat message ถัดจากเสียง ดังที่แสดงในคู่มือการติดตั้งในเครื่องของเรา
ใช้ OpenRouter แทน
ถ้าคุณใช้ OpenRouter สำหรับ LLM อยู่แล้ว คุณสามารถใช้ key เดียวและบิลเดียวได้ model ID คือ nvidia/nemotron-3.5-transcribe ราคา $0.000033 ต่อวินาที โดยมี DeepInfra เป็นผู้ให้บริการรายเดียวที่ระบุไว้เมื่อวันที่ 29 ตุลาคม 2026 (uptime 100% และ latency ประมาณหนึ่งวินาทีในขณะนั้น) คัดลอกรูปแบบคำขอจากแท็บ API ของโมเดลบน OpenRouter เนื่องจาก audio endpoint แตกต่างจาก chat completions
ข้อแลกเปลี่ยน: OpenRouter เพิ่ม hop เครือข่าย และตอนนี้ยังไม่มี provider failover เพราะมีผู้ให้บริการรายเดียวที่ให้บริการโมเดลนี้
ทำให้ค่าใช้จ่ายคาดเดาได้
- ตัดความเงียบออกก่อน คุณจ่ายตามนาทีของเสียง ไม่ใช่ตามนาทีของคำพูด การตัดช่วงเงียบออกจากไฟล์บันทึกช่วยลดบิล
- ดาวน์มิกซ์และรีแซมเปิล 16 kHz mono คือสิ่งที่โมเดลใช้อยู่แล้ว การส่ง stereo 48 kHz มีแต่เพิ่มเวลาอัปโหลด
- แบตช์เป็นไฟล์ ไม่ใช่เป็นชิ้น โมเดลจัดการหนึ่งชั่วโมงได้ในคำขอเดียว การแยกไฟล์เป็นชิ้น 30 วินาทีจะทำให้ speaker labels และ context เสียหาย
- บันทึก log
inference_status.costรวมผลต่อลูกค้าแต่ละรายหรือต่องานแต่ละงาน - โฮสต์เองเมื่อปริมาณสม่ำเสมอสูงพอ NIM แบบปรับแต่งของ NVIDIA ประมวลผลเสียงได้ถึง 2,238 วินาทีต่อวินาทีบน RTX PRO 6000 Blackwell หนึ่งตัว ถ้าคุณถอดเสียงหลายพันชั่วโมงต่อเดือน การเช่า GPU หนึ่งตัวคุ้มกว่าราคาต่อนาที หมายเหตุว่าเส้นทาง vLLM โอเพนซอร์สคาดว่าจะช้ากว่าตัวเลข NIM นั้นประมาณสองเท่า
ให้ coding agent ของคุณทดสอบด้วย Apidog CLI
API ถอดเสียงล้มเหลวแบบเงียบ ๆ ได้: ตอบ 200 แต่ text ว่าง, คลิปภาษาสเปนถูกตรวจเป็นโปรตุเกส หรือ words หายไปหลังผู้ให้บริการอัปเดต แทนที่จะตรวจ JSON ด้วยมือ ให้ coding agent ของคุณเขียนและรันการตรวจสอบด้วย Apidog CLI
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้ prompt เดียวกับ agent ของคุณ:
In Apidog project <id>, add the DeepInfra endpoint POST
https://api.deepinfra.com/v1/inference/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
with a multipart "audio" field and a bearer token from {{DEEPINFRA_API_KEY}}.
Create a test case per file in samples/ (en.mp3, es.mp3, two-speakers.wav) asserting
status 200, non-empty "text", the expected "language", and "words" length > 0.
Run them against the prod environment and report failures with the response body.
agent จะอ่าน schema ตรวจสอบ payload เขียน test case และรัน:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
เพิ่ม -r junit แล้วคำสั่งเดิมจะกลายเป็น CI gate ดูApidog CLI ใน CI/CD pipeline และ Apidog CLI ใน Claude Code สำหรับการตั้งค่าแบบเต็ม
คำถามที่พบบ่อย
ราคา Nemotron 3.5 Transcribe API เท่าไร? $0.002 ต่อนาทีบน DeepInfra และ $0.000033 ต่อวินาทีบน OpenRouter ณ วันที่ 29 ตุลาคม 2026 ซึ่งประมาณ $0.12 ต่อชั่วโมงของเสียงบนทั้งสองเจ้า
มี API key ฟรีไหม? เราไม่พบแบบฟรี โมเดลนี้ยังไม่อยู่บน build.nvidia.com ช่องทางฟรีคือ Space เดโมของ NVIDIA และการโฮสต์เอง ดูคู่มือฟรี
ความยาวไฟล์สูงสุดเท่าไร? หนึ่งชั่วโมงต่อคำขอ พร้อม context 65,536 tokens
API สตรีมผลลัพธ์ไหม? ไม่ มันเป็นโมเดลแบบ offline ที่คืนข้อความถอดเสียงเมื่อไฟล์เสร็จ
รองรับภาษาใดบ้าง? 40 ภาษา จัดเป็นสามระดับ 13 ภาษา "ชั้นนำ" รวมถึงอังกฤษ สเปน ฝรั่งเศส เยอรมัน อิตาลี โปรตุเกส ฮินดี เกาหลี รัสเซีย และโปแลนด์ ญี่ปุ่น ตุรกี และยูเครนเป็นระดับ "พร้อมใช้งานโปรดักชัน" จีนกลางและอาหรับเป็นระดับ "รองรับ"
เทียบกับ API เสียงอื่น ๆ เป็นอย่างไร? ดูการจัดอันดับโมเดล speech-to-text โอเพนซอร์สที่ดีที่สุดของเรา และบทความรวบรวมAPI text-to-speech และ speech-to-text ชั้นนำที่ควรใช้ตอนนี้ที่เป็นรุ่นก่อนหน้า
เริ่มถอดเสียงได้เลย
ขอ key ของ DeepInfra ส่ง curl หนึ่งคำสั่งพร้อมไฟล์ MP3 แล้วคุณจะได้ข้อความที่มีการระบุเวลาและติดป้ายภาษากลับมาที่ราคา $0.002 ต่อนาที เพิ่ม context terms สำหรับโดเมนของคุณ ใช้ prompt สำหรับผู้พูดกับการประชุม และให้ agent ของคุณรันการตรวจสอบผ่าน Apidog ทุกครั้งที่ปล่อยเวอร์ชัน เพื่อไม่ให้ regression แบบเงียบ ๆ หลุดออกไปได้เลย