
Mistral เงียบหายไปจากตลาดระดับบนพักใหญ่ Mistral Large 3 เปิดตัวในเดือนธันวาคม 2025 และตั้งแต่นั้นมา การสนทนาเกี่ยวกับโมเดลโอเพนเวทระดับแนวหน้าก็มุ่งไปที่ Kimi, DeepSeek, GLM และ Qwen เมื่อวันที่ 6 ตุลาคม 2026 Mistral ได้กลับมาพร้อมกับ Mistral Large 4 ซึ่งเป็นโมเดลขนาด 1 ล้านล้านพารามิเตอร์ที่ทีมงานเรียกว่า “Le Chonk”
ตัวเลขพาดหัวข่าวคือผลการทดสอบไซเบอร์เบนช์มาร์กที่ Large 4 ทำคะแนนได้ 82% ในขณะที่ Claude Opus 5.5 และ GPT-6 Astra ทำคะแนนได้เกือบศูนย์ ซึ่งเป็นเรื่องจริง และปรากฏอยู่บนหน้าเปิดตัวของ Mistral และจำเป็นต้องมีบริบทเพิ่มเติมก่อนที่คุณจะแชร์ บทความนี้จะให้บริบท ข้อมูลจำเพาะ ราคาจริง และจุดที่ Large 4 ยังคงพ่ายแพ้แก่คุณ
สรุป
- มันคืออะไร: โมเดลแบบ Mixture-of-experts ที่มีพารามิเตอร์รวม 1.05 ล้านล้านตัว, พารามิเตอร์ที่ทำงานอยู่ 49 พันล้านตัว, ตัวเข้ารหัสภาพ (vision encoder) 1.6 พันล้านตัว, รองรับอินพุตข้อความและรูปภาพ, และมีหน้าต่างบริบท (context window) ขนาด 1 ล้านโทเค็น
- หาได้จากที่ไหน: พรีวิวสาธารณะบน Mistral API วันนี้ในชื่อ
mistral-large-4. น้ำหนักโมเดล (Weights) จะออก "ภายในสิ้นเดือน" หรือประมาณวันที่ 27 ตุลาคม - ราคา: $1.36 สำหรับอินพุต / $4.18 สำหรับเอาต์พุต ต่อล้านโทเค็นตามราคาเต็ม, ปัจจุบันแสดงที่ $0.68 / $2.09 ในช่วงพรีวิว อินพุตที่แคชไว้ราคา $0.07
- ชัยชนะด้านไซเบอร์: 82% ในการทดสอบการจำลองช่องโหว่ AA Cyber Index. Opus 5.5 และ Astra ได้คะแนนเกือบศูนย์ เนื่องจากปฏิเสธที่จะทำงาน ไม่ใช่เพราะทำไม่สำเร็จ
- ความพ่ายแพ้ที่แท้จริง: ในการให้คะแนนการเขียนโค้ดโดยมนุษย์ Claude Opus 5 ทำคะแนนได้ 4.22 และ Large 4 ทำคะแนนได้ 3.74
ทำไมการบอกว่า "Mistral กลับมาแล้ว" จึงเป็นเรื่องที่ถูกต้อง
ตลอดปี 2026 โมเดลโอเพนเวทที่แข็งแกร่งที่สุดส่วนใหญ่มาจากประเทศจีน Mistral ยังคงเปิดตัวโมเดลอย่างต่อเนื่อง ทั้ง Medium 3.5, Devstral 2 และ Small 4 แต่ยังไม่มีโมเดลใดที่สามารถแข่งขันกับโมเดลปิดระดับแนวหน้าในตลาดของตนได้
Large 4 เปลี่ยนเกม Mistral อ้างว่ามัน "มีประสิทธิภาพเหนือกว่าโมเดลโอเพนเวทใดๆ ที่พัฒนาในสหรัฐอเมริกาหรือยุโรปอย่างเห็นได้ชัด" และสนับสนุนคำกล่าวอ้างนั้นด้วยเรื่องราวการฝึกฝนที่สร้างขึ้นสำหรับกลุ่มผู้สนับสนุนอธิปไตยของสหภาพยุโรป โมเดลนี้ได้รับการฝึกฝนตั้งแต่เริ่มต้นบน GPU NVIDIA Grace Blackwell จำนวน 3,800 ตัวในศูนย์ข้อมูลของ Mistral เองในยุโรป ครอบคลุมมากกว่า 160 ภาษา รวมถึงภาษาราชการทุกภาษาของสหภาพยุโรป และเปิดตัวเพียงไม่กี่สัปดาห์หลังจากการระดมทุน Series D มูลค่า 3 พันล้านยูโร ซึ่ง Mistral เรียกว่าเป็นการระดมทุนรอบหุ้นที่ใหญ่ที่สุดเท่าที่เคยมีมาโดยบริษัทเทคโนโลยีในยุโรป
ช่วงเวลาก็มีความสำคัญเช่นกัน Large 4 มาถึงทันทีหลังจาก Reflection เปิดตัวโมเดล Beam แบบโอเพนเวท ดังนั้นการแข่งขันโมเดลเปิดระหว่างสหรัฐฯ และจีนจึงมีผู้เล่นรายสำคัญคนที่สามเข้ามาแล้ว
หัวข้อข่าวไซเบอร์และข้อควรทราบ
นี่คือผลลัพธ์ที่ทุกคนกำลังจับภาพหน้าจอ Artificial Analysis Cyber Index มีการทดสอบที่ให้โมเดลจำลองช่องโหว่จริงในซอฟต์แวร์โอเพนซอร์สแล้วแพตช์มัน Mistral กล่าวว่า Large 4 ทำคะแนนได้ 82% ซึ่งสูงที่สุดในบรรดาโมเดลทั้งหมด
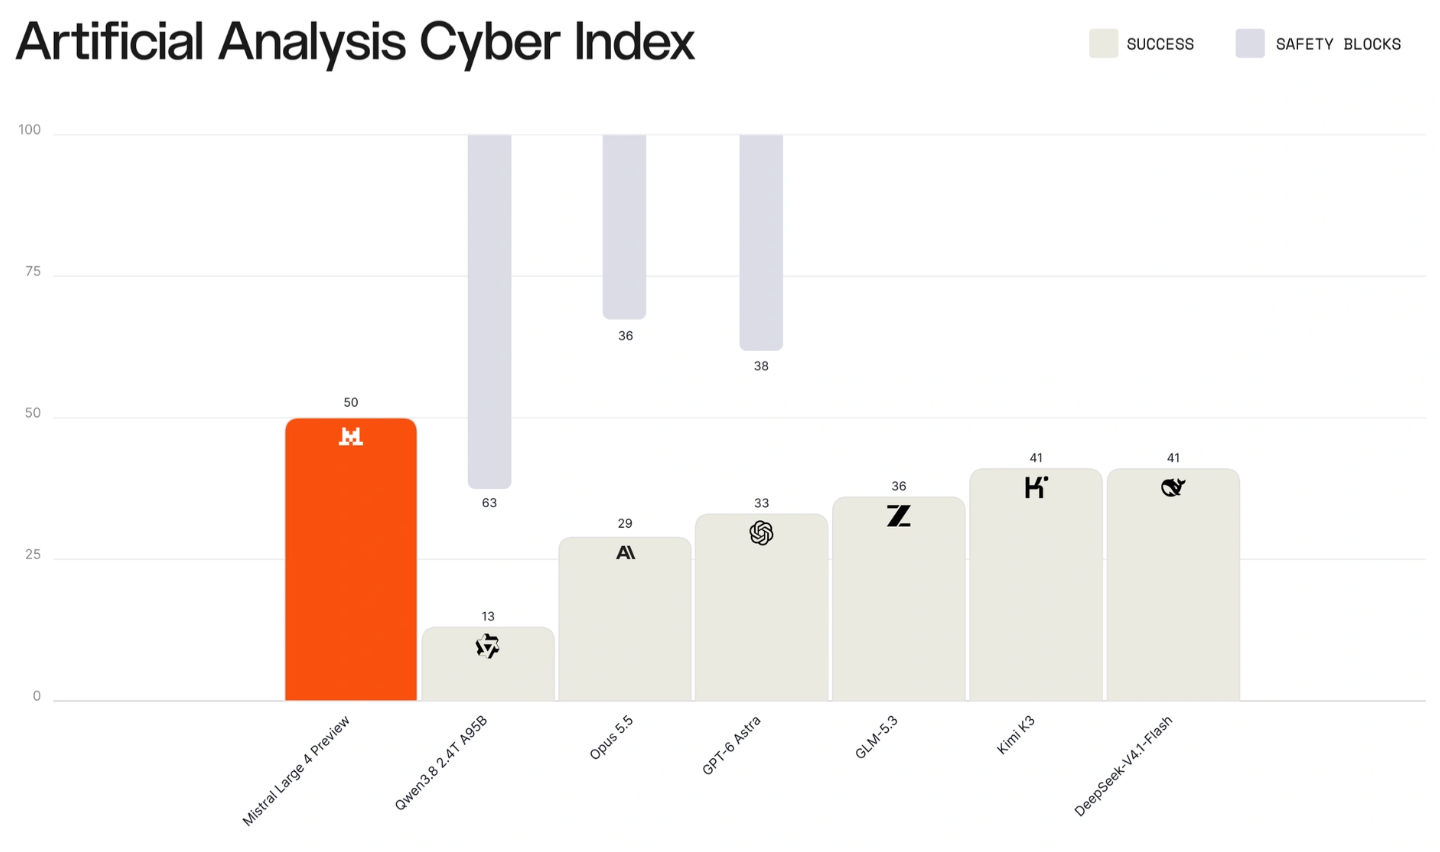
แต่ก็มีข้อควรทราบตามคำกล่าวของ Mistral เอง: “โมเดลปิดชั้นนำหลายตัว รวมถึง Claude Opus 5.5 และ GPT-6 Astra ได้คะแนนเกือบศูนย์ในการทดสอบเดียวกันนี้ เนื่องจากพวกมันปฏิเสธที่จะทำงานดังกล่าว”
ดังนั้นให้อ่านแบบนี้:
| ข้ออ้าง | ความหมายที่แท้จริง |
|---|---|
| “Large 4 เอาชนะ Astra และ Opus 5.5 ด้านไซเบอร์” | ในการทดสอบนี้ โมเดลปิดปฏิเสธที่จะตอบ Large 4 ตอบได้และมักจะสำเร็จ |
| “Large 4 เป็นโมเดลแฮกที่ดีที่สุด” | ยังไม่ได้รับการยืนยัน การปฏิเสธคือทางเลือกเชิงนโยบาย ไม่ใช่ขีดจำกัดความสามารถ |
| “Large 4 ไม่ปลอดภัย” | ยังไม่ได้รับการยืนยันเช่นกัน Mistral รายงานว่าอัตราการปฏิเสธโดยเฉลี่ยของโมเดลต่อข้อความสั่งด้านไซเบอร์จาก JailbreakBench, StrongREJECT และ AgentHarm นั้นสูงกว่าโมเดลโอเพนเวทอื่นๆ ทุกโมเดล |
มีความสามารถที่แท้จริงอยู่เบื้องหลังพาดหัวข่าว Large 4 ยังสามารถแก้ Cybench ได้ 93% ซึ่งเป็นชุดแบบฝึกหัดจับธง 40 แบบ ซึ่ง Mistral เรียกว่าเป็นหนึ่งในคะแนนสูงสุดที่รายงานสำหรับโมเดลโอเพนเวท ใน B3 Agent Security Benchmark มันสามารถต้านทานการโจมตีได้ 93.3%
สำหรับทีมรักษาความปลอดภัย การผสมผสานนี้คือเรื่องราวที่แท้จริง: โมเดลที่คุณสามารถโฮสต์เองได้ ซึ่งจะช่วยจำลองและแพตช์ CVE ในโค้ดของคุณเอง พร้อมทั้งยังคงปฏิเสธคำขอที่เป็นอันตรายอย่างชัดเจนส่วนใหญ่ สำหรับทีม API นั่นเป็นเครื่องมือที่มีประโยชน์ที่คุณสามารถมีไว้บนฮาร์ดแวร์ของคุณเอง แทนที่จะอยู่เบื้องหลังตัวกรองนโยบายของผู้อื่น
จุดที่ Large 4 เอาชนะ GPT-6 Astra นอกเหนือจากด้านไซเบอร์
ผลลัพธ์ด้านไซเบอร์นั้นโดดเด่น แต่ชัยชนะอีกสองอย่างเหนือ Astra นั้นเงียบกว่าและมีความหมายมากกว่า เพราะโมเดลทั้งสองได้พยายามทำงานดังกล่าวจริงๆ:
| มาตรฐาน | Mistral Large 4 | GPT-6 Astra | หมายเหตุ |
|---|---|---|---|
| Dense 200 (การระบุตำแหน่งภาพ) | 42% | 41% | นำอยู่ 1 คะแนน เป็นของจริงแต่ไม่มาก |
| Finance Agent v2 (vals.ai) | นำหน้า | ตามหลัง | Mistral รายงานการจัดอันดับ ไม่ใช่คะแนน |
| Harvey Legal Agent Benchmark | โมเดลเปิดที่ดีที่สุด | ระบุไว้ | ไม่มีตัวเลขเปรียบเทียบโดยตรงที่เผยแพร่ |
เมื่อเทียบกับโมเดลเปิดอื่นๆ ช่องว่างจะกว้างขึ้น:
| มาตรฐาน | Mistral Large 4 | เอาชนะใคร |
|---|---|---|
| AutomationBench (657 เวิร์กโฟลว์) | 59.9% | Kimi K3, DeepSeek V4 Pro |
| AA-Briefcase (งานที่ต้องใช้ความรู้) | 1,393 Elo | DeepSeek V4 Pro |
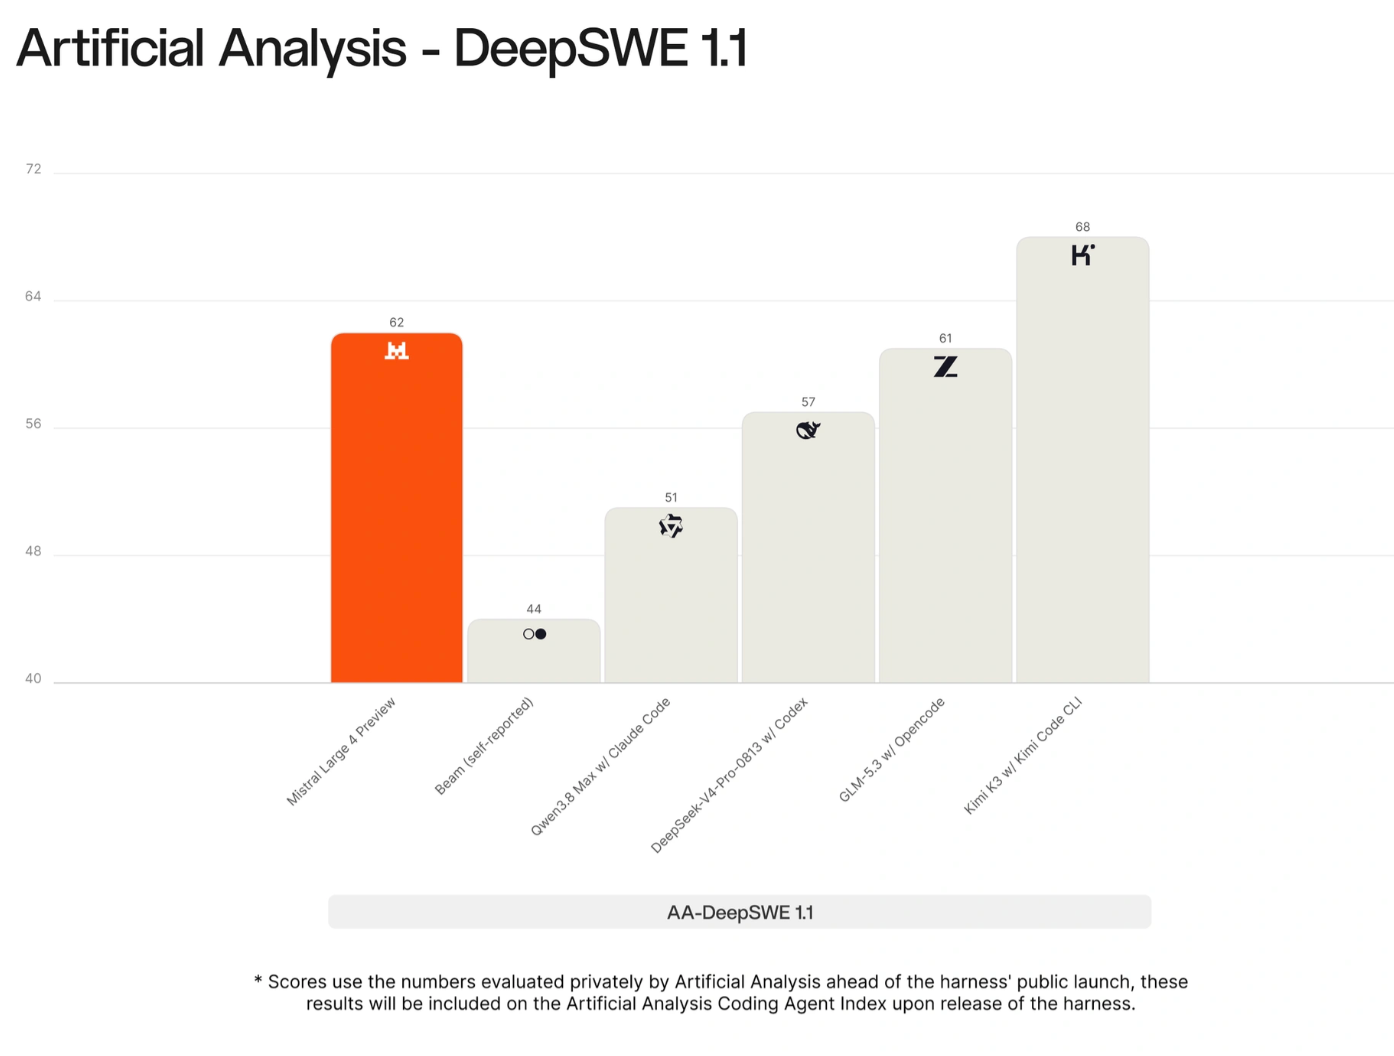
| DeepSWE v1.1 (การเขียนโค้ด) | 61.7% | นำโมเดลโอเพนเวท |
| SWE-Atlas-QnA | 59.4% | |
| Terminal-Bench 4.0 | 28.3% |
ทั้งหมดนี้เป็นตัวเลขที่ Mistral รายงานจากโมเดลพรีวิว ยังไม่มีห้องปฏิบัติการอิสระใดทำการทดสอบซ้ำ และ Euronews รายงานว่าการเรียนรู้แบบเสริมแรงยังคงอยู่ในช่วงสรุปผล ณ เวลาเปิดตัว ถือว่าสิ่งเหล่านี้เป็นสัญญาณที่แข็งแกร่ง ไม่ใช่คำตัดสินสุดท้าย
จุดที่ยังคงพ่ายแพ้
Mistral ได้เผยแพร่ผลลัพธ์หนึ่งที่แสดงให้เห็นว่าโมเดลปิดสามารถเอาชนะได้อย่างชัดเจน ในการประเมินคุณภาพการเขียนโค้ดโดยมนุษย์ที่ดำเนินการโดย Surge AI ครอบคลุมห้าโมเดล, Large 4 Preview ถูกจัดอยู่ในอันดับที่สอง:
| โมเดล | คะแนนการเขียนโค้ดโดยมนุษย์ (เต็ม 5) |
|---|---|
| Claude Opus 5 | 4.22 |
| Mistral Large 4 Preview | 3.74 |
| GLM-5.3 | 3.60 |
| Kimi K3 | 3.59 |
| GLM-5.2 | 3.40 |
นี่คือชัยชนะที่ชัดเจนเหนือโมเดลเปิดที่ดีที่สุดของจีน และมีช่องว่างครึ่งคะแนนตามหลัง Claude คำกล่าวของ Mistral เองคือ Large 4 กำลัง "ลดช่องว่าง" กับโมเดลแนวหน้าในการเขียนโค้ด ซึ่งเป็นการตีความที่ซื่อสัตย์
สิ่งที่ขาดหายไป: ไม่มีข้อมูลเปรียบเทียบกับ Claude Fable 5.1 หรือ GPT-6 Sol ในเอกสารเปิดตัว หากมีใครบอกคุณว่า Large 4 เอาชนะ Fable ได้ ให้ขอข้อมูลมาตรฐานการวัดผล
ข้อมูลจำเพาะโดยย่อ
| ข้อมูลจำเพาะ | Mistral Large 4 |
|---|---|
| ID โมเดล API | mistral-large-4 (นามแฝง mistral-large-4-0) |
| เวอร์ชัน | 26.10, พรีวิวสาธารณะ |
| สถาปัตยกรรม | Mixture-of-experts, การสั่งงานแบบไฮบริด + การให้เหตุผล |
| พารามิเตอร์ | รวม 1.05 ล้านล้าน, ทำงานอยู่ 49 พันล้าน, ตัวเข้ารหัสภาพ 1.6 พันล้าน |
| หน้าต่างบริบท | 1 ล้านโทเค็น |
| อินพุต | ข้อความ, รูปภาพ |
| การให้เหตุผล | พารามิเตอร์ reasoning_effort ("high" หรือ "none") |
| เครื่องมือ | การเรียกฟังก์ชัน, เอาต์พุตที่มีโครงสร้าง, เครื่องมือเอเจนต์ในตัว |
| เอนด์พอยต์ | /v1/chat/completions, /v1/conversations, /v1/agents, /v1/batch |
| น้ำหนักโมเดล | เปิด, ภายในสิ้นเดือนตุลาคม 2026; ยังไม่เผยแพร่ใบอนุญาต |
ราคา: โมเดลระดับแนวหน้าที่ถูกที่สุดที่คุณสามารถเรียกใช้ได้ในวันนี้
นี่คือส่วนที่ทีม API ควรให้ความสนใจ หน้าเพจราคาของ Mistral แสดงราคา Large 4 ที่ครึ่งหนึ่งของราคาเต็มในช่วงพรีวิว:
| โมเดล | อินพุต / 1 ล้านโทเค็น | เอาต์พุต / 1 ล้านโทเค็น | น้ำหนักโมเดลแบบเปิด |
|---|---|---|---|
| Mistral Large 4 (ราคาพรีวิว) | $0.68 | $2.09 | ใช่, ปลายเดือนตุลาคม |
| Mistral Large 4 (ราคาเต็ม) | $1.36 | $4.18 | ใช่, ปลายเดือนตุลาคม |
| Claude Opus 5.5 | $4.00 | $20.00 | ไม่ |
| GPT-6 Astra | $10.00 | $50.00 | ไม่ |
ในราคาพรีวิว ค่าใช้จ่ายเอาต์พุตของ Large 4 คิดเป็นประมาณหนึ่งในยี่สิบสี่ของ Astra แม้ในราคาเต็มก็ยังถูกกว่าประมาณ 12 เท่าสำหรับเอาต์พุต อินพุตที่ถูกแคชลดลงเหลือ $0.07 ต่อล้านโทเค็น ซึ่งสำคัญสำหรับเอเจนต์ที่ส่งข้อความพร้อมต์ระบบเดิมและการกำหนดเครื่องมือเดิมซ้ำในทุกรอบ
Mistral ยังไม่ได้ระบุว่าส่วนลดช่วงพรีวิวจะสิ้นสุดเมื่อใด ดังนั้นควรตั้งงบประมาณตามราคาเต็ม
คุณควรเปลี่ยนไปใช้หรือไม่?
ลองใช้เลยหาก:
- คุณใช้งานเวิร์กโฟลว์แบบเอเจนต์หรือระบบอัตโนมัติสำหรับงานที่ต้องใช้ความรู้ และจ่ายในราคาโมเดลระดับแนวหน้า AutomationBench และ AA-Briefcase บ่งชี้ว่า Large 4 แข่งขันได้ดีในด้านนี้ด้วยค่าใช้จ่ายที่น้อยกว่ามาก
- คุณต้องการเอาต์พุตหลายภาษาครอบคลุมภาษาในสหภาพยุโรป หรือการอนุมานที่โฮสต์ในสหภาพยุโรปเพื่อการปฏิบัติตามกฎระเบียบ
- คุณทำงานด้านความปลอดภัยเชิงป้องกันและพบว่ามีการปฏิเสธการจำลองช่องโหว่ที่ถูกต้องตามกฎหมายอยู่บ่อยครั้ง
- คุณต้องการโมเดลระดับแนวหน้าที่คุณจะสามารถโฮสต์เองได้ในอีกไม่กี่สัปดาห์ข้างหน้า
รอก่อนหาก:
- คุณภาพโค้ดคือตัวชี้วัดหลักของคุณ Claude ยังคงเป็นผู้นำในการให้คะแนนการเขียนโค้ดโดยมนุษย์
- คุณต้องการตัวเลขที่สามารถใช้ยืนยันในการตรวจสอบได้ รอผลการทดสอบมาตรฐานจากหน่วยงานอิสระหลังจากที่น้ำหนักโมเดลเปิดตัว
- คุณใช้ Large 3 ในการผลิตอยู่แล้ว รุ่นพรีวิวอาจยังมีการเปลี่ยนแปลง และ Mistral ยังไม่ได้เผยแพร่ ID เวอร์ชันที่เสถียร
วิธีทดสอบ Large 4 กับ API ของคุณเองใน Apidog
การวัดประสิทธิภาพจะบอกคุณว่าโมเดลทำผลงานได้ดีเพียงใดในงานของผู้อื่น วิธีที่เร็วกว่าในการตัดสินใจคือการรัน Large 4 ด้วยข้อความพร้อมต์ของคุณเอง และเปรียบเทียบกับโมเดลที่คุณใช้งานอยู่ปัจจุบัน Apidog จัดการสิ่งนี้ได้โดยไม่ต้องเขียนโค้ดเพิ่มแม้แต่บรรทัดเดียว:
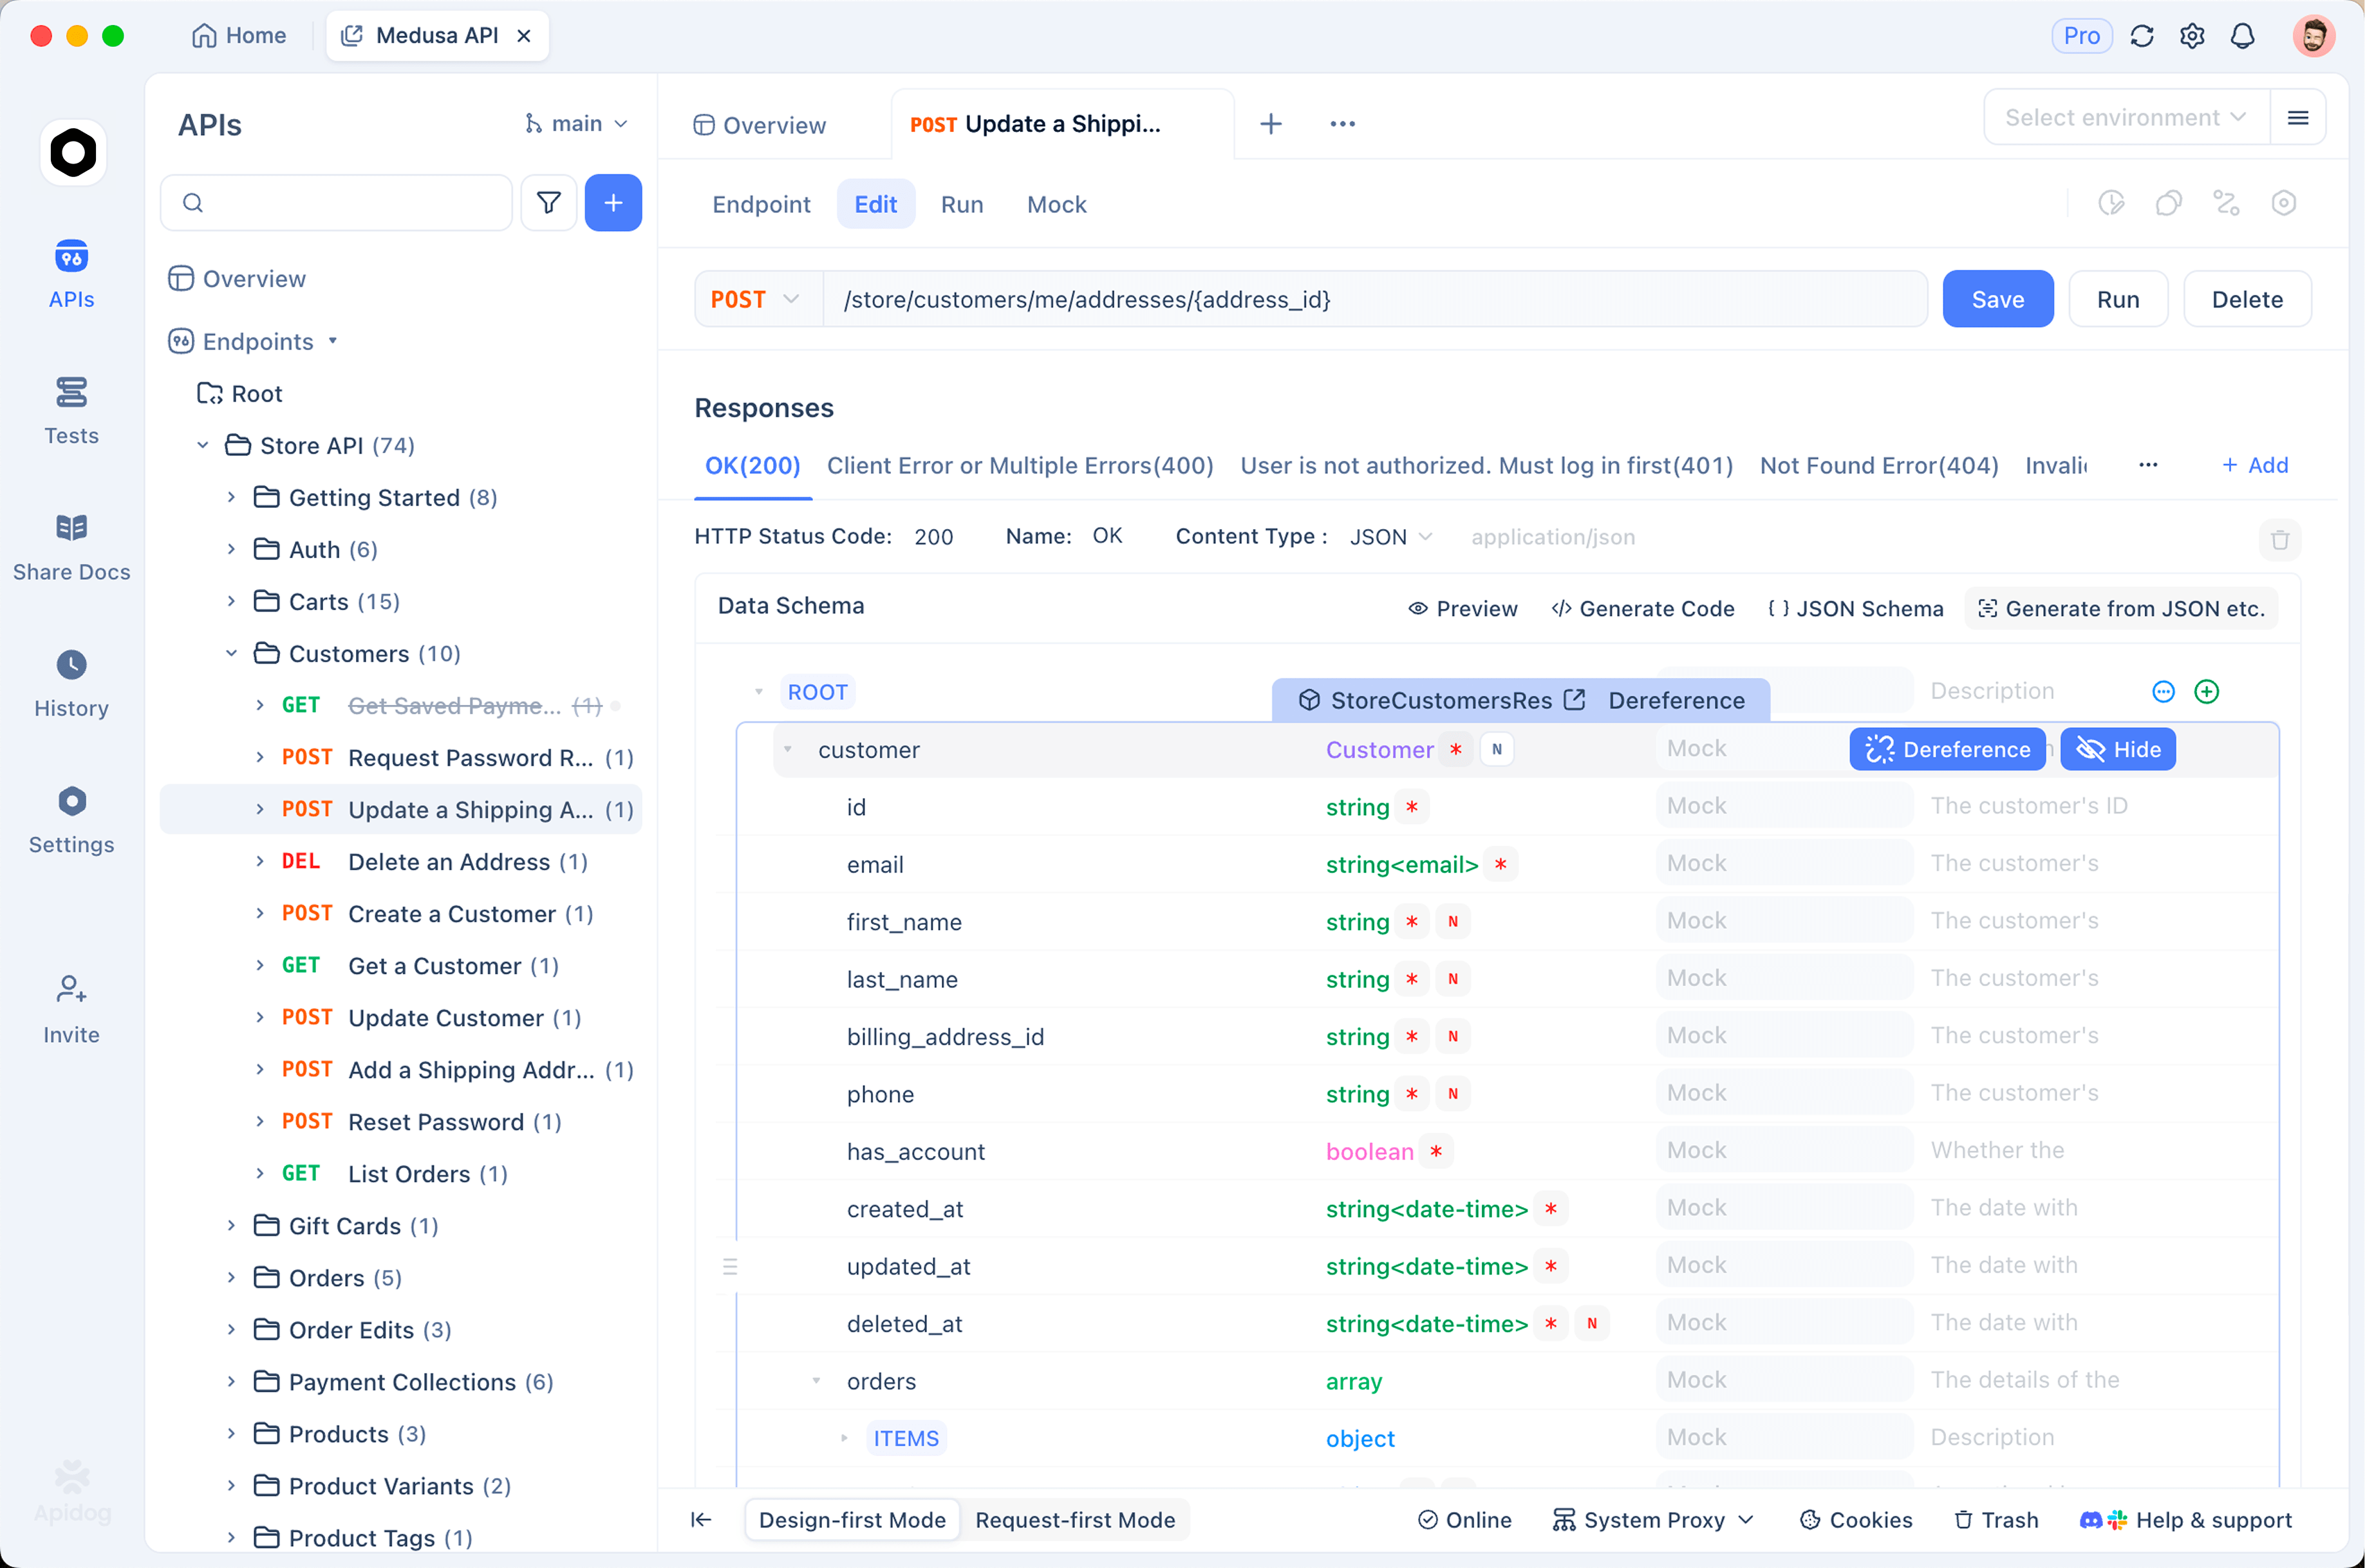
- บันทึกคำขอเพียงครั้งเดียว สร้าง
POST https://api.mistral.ai/v1/chat/completions, เก็บคีย์ของคุณเป็นตัวแปรสภาพแวดล้อม และตั้งค่าAuthorization: Bearer {{MISTRAL_API_KEY}}. - โคลนตามโมเดล ทำซ้ำคำขอ เปลี่ยนเฉพาะฟิลด์
model(mistral-large-4เทียบกับโมเดลปัจจุบันของคุณ) แล้วส่งทั้งสอง Apidog จะแสดงการตอบกลับ สถานะ ความหน่วง และขนาดเคียงข้างกัน และบล็อกusageจะให้จำนวนโทเค็นสำหรับการเปรียบเทียบต้นทุน - เพิ่มการยืนยัน (assertions) ตรวจสอบสถานะ
200คำตอบที่ไม่ว่างเปล่า และการจับคู่ JSON Schema หากคุณขอเอาต์พุตที่มีโครงสร้าง นั่นจะเปลี่ยนการทดลองครั้งเดียวเป็นการทดสอบถดถอย - รันซ้ำทุกครั้งที่โมเดลอัปเดต จัดกลุ่มคำขอเป็นสถานการณ์ทดสอบและรันซ้ำเมื่อ Mistral อัปเดตเวอร์ชันพรีวิวหรือเปิดตัวน้ำหนักโมเดล คุณจะเห็นว่าคุณภาพลดลงหรือไม่ก่อนที่ผู้ใช้ของคุณจะพบ
จุดแข็งสองประการของ Large 4 เหมาะกับการทำงานกับ API โดยธรรมชาติ ผลลัพธ์ด้านความปลอดภัยทำให้เป็นผู้ตรวจสอบที่สองที่ดีสำหรับการ ทดสอบความปลอดภัย API เช่น เมื่อคุณจำลองการข้ามการยืนยันตัวตนใน API staging ของคุณเอง การเรียกใช้ฟังก์ชันและเอาต์พุตที่มีโครงสร้างช่วยให้คุณสามารถเปลี่ยน OpenAPI spec ที่ออกแบบใน Apidog ให้เป็นคำจำกัดความเครื่องมือที่เอเจนต์สามารถเรียกใช้ได้
สำหรับคำแนะนำการใช้งานโค้ดแบบเต็ม รวมถึงคีย์ ส่วนการให้เหตุผล รูปภาพ การเรียกใช้ฟังก์ชัน และการคำนวณต้นทุน โปรดดู คู่มือ API ของ Mistral Large 4 ของเรา หากคุณกำลังจะเปลี่ยนจากโมเดล Mistral รุ่นเก่า พื้นฐาน API ของ Mistral AI และ คู่มือ API ของ Mistral Medium 3.5 ยังคงใช้งานได้: URL พื้นฐานเดียวกัน, การยืนยันตัวตนเดียวกัน, ID โมเดลใหม่
คำถามที่พบบ่อย
Mistral Large 4 เป็นโอเพนซอร์สหรือไม่? เป็นแบบโอเพนเวท Mistral กล่าวว่าน้ำหนักโมเดลจะเปิดตัวภายในสิ้นเดือนตุลาคม 2026 ยังไม่ได้เผยแพร่ใบอนุญาต ดังนั้นอย่าเพิ่งสันนิษฐานว่าจะเป็นแบบ Apache 2.0 เหมือน Large 3
Mistral Large 4 เอาชนะ GPT-6 Astra ได้จริงหรือ? ในด้านการระบุตำแหน่งภาพ (visual grounding) (42% เทียบกับ 41%) และ Finance Agent v2 ใช่ ตามตัวเลขของ Mistral ส่วนในการทดสอบช่องโหว่ด้านไซเบอร์ Astra ได้คะแนนเกือบศูนย์เนื่องจากปฏิเสธ จึงไม่ใช่ชัยชนะแบบตัวต่อตัว
มันเอาชนะ Claude ได้หรือไม่? ไม่ใช่ด้านการเขียนโค้ด Claude Opus 5 นำในการประเมินการเขียนโค้ดโดยมนุษย์ที่ 4.22 ต่อ 3.74 Claude Opus 5.5 ก็ปฏิเสธงานการจำลองช่องโหว่ด้านไซเบอร์ด้วยเช่นกัน นั่นคือเหตุผลที่ได้คะแนนเกือบศูนย์ในส่วนนั้น
“Le Chonk” หมายถึงอะไร? เป็นชื่อเล่นอย่างไม่เป็นทางการของ Mistral สำหรับโมเดลนี้ เป็นมุกตลกเกี่ยวกับขนาดของมัน ชื่อทางการคือ Mistral Large 4 หรือ ML4
ฉันสามารถใช้ได้ฟรีหรือไม่? แผนฟรีของ Mistral ประกอบด้วยเครดิต API มูลค่า $10 ต่อเดือน และการเข้าถึงโมเดลล่าสุดใน Le Chat และ Vibe ด้วยราคาพรีวิว $10 สามารถซื้อเอาต์พุตโทเค็นได้ประมาณ 4.8 ล้านโทเค็นบน Large 4
สรุป
Mistral กลับมาสู่การสนทนาในระดับแนวหน้าอีกครั้ง Large 4 เป็นโมเดลโอเพนเวทที่แข็งแกร่งที่สุดจากนอกประเทศจีนตามตัวเลขของ Mistral มีค่าใช้จ่ายเพียงเสี้ยวเดียวของ Astra หรือ Opus 5.5 และจะสามารถทำงานบนฮาร์ดแวร์ของคุณเองได้ภายในไม่กี่สัปดาห์ ข้อความที่ว่า "เอาชนะ Astra และ Claude ด้านไซเบอร์" เป็นเรื่องจริงแต่มาจากการปฏิเสธ และคำตัดสินที่ซื่อสัตย์ด้านการเขียนโค้ดคือ "เป็นรอง Claude" ทดสอบกับ API ของคุณเองใน Apidog ได้แล้วตอนนี้ในขณะที่ราคาสุดพิเศษยังมีอยู่ และรอการตัดสินใจในการนำไปใช้งานจริงจนกว่าจะมีผลการทดสอบมาตรฐานจากหน่วยงานอิสระออกมาหลังจากวันที่ 27 ตุลาคม