
น้ำหนักแบบเปิดของ Mistral Large 4 เปิดให้ดาวน์โหลดบน Hugging Face เมื่อวันที่ 29 ตุลาคม 2026 คุณจะได้โมเดลขนาด 1.05T พารามิเตอร์แบบเดียวกับที่ Mistral ให้บริการผ่าน API ภายใต้ลิขสิทธิ์ MIT ดัดแปลง ในรูปแบบ FP8 และ NVFP4 checkpoint พร้อม GGUF quants จากชุมชน คุณสามารถดาวน์โหลดได้โดยไม่ต้องมีขั้นตอนการอนุมัติ ให้บริการบน GPU ศูนย์ข้อมูล 8 ตัวด้วย vLLM หรือ SGLang หรือข้ามฮาร์ดแวร์และเรียก mistral-large-4 บน Mistral API ในราคา $0.70 ต่อโทเค็นอินพุตหนึ่งล้านโทเค็น
ด้านล่าง: สิ่งที่เปลี่ยนแปลงไปตั้งแต่ตัวอย่างเมื่อวันที่ 6 ตุลาคม ขนาดดาวน์โหลด ฮาร์ดแวร์ต่อเส้นทาง และลิขสิทธิ์ สำหรับภาพรวมโมเดล อ่าน Mistral Large 4 launch breakdown ของเรา; สำหรับรูปแบบคำขอและโค้ด SDK ดู Mistral Large 4 API guide
น้ำหนักแบบเปิดของ Mistral Large 4 คืออะไร?
น้ำหนักแบบเปิดของ Mistral Large 4 คือ checkpoint ที่ดาวน์โหลดได้ของโมเดลเรือธงของ Mistral ซึ่งมีชื่อเล่นว่า “Le Chonk” เป็นโมเดลแบบ multimodal mixture-of-experts ที่มีพารามิเตอร์รวมประมาณ 1.05T, เปิดใช้งานประมาณ 49B ต่อโทเค็น (52B เมื่อนับ embeddings และ output layers), vision encoder 1.6B และหน้าต่างบริบทขนาด 1M โทเค็น เปิดตัวภายใต้ Mistral Ecosystem Open-Weight License
model card อย่างเป็นทางการระบุ 72 text layers และ 128 routed experts โดยเลือก 4 ต่อโทเค็นบวกกับ shared expert 1 ตัว
การเปิดตัวนี้ไม่ใช่สำเนาที่หยุดนิ่งของตัวอย่างก่อนหน้า ประกาศ open-weight ของ Mistral กล่าวว่าโมเดลได้รับการเรียนรู้แบบเสริมกำลังเพิ่มอีกสามสัปดาห์โดยเน้นที่การเขียนโค้ดและความปลอดภัยไซเบอร์ก่อนที่น้ำหนักจะถูกปล่อยออกมา
มีอะไรเปลี่ยนแปลงไปตั้งแต่ตัวอย่างเมื่อวันที่ 6 ตุลาคม
หากคุณทดสอบ Large 4 ระหว่างช่วงตัวอย่าง มีสี่สิ่งที่แตกต่างออกไปในตอนนี้
| ด้าน | ตัวอย่างเมื่อวันที่ 6 ตุลาคม | การเปิดตัวแบบเปิดเมื่อวันที่ 29 ตุลาคม |
|---|---|---|
| น้ำหนัก | API เท่านั้น น้ำหนักสัญญาไว้ว่าจะตามมาทีหลัง | FP8 และ NVFP4 บน Hugging Face ไม่มีการควบคุมการเข้าถึง |
| โหมดการให้เหตุผล | high หรือ none |
low, medium, high (ค่าเริ่มต้น high); low แทนที่ none |
| Terminal-Bench 4.0 (รายงานโดย Mistral) | 28% | 41% โดยใช้โทเค็นเอาต์พุตน้อยลงประมาณ 30% |
| ความต้านทานการโจมตีของ B3 Agent Security (รายงานโดย Mistral) | 93.3% | 97.1% |
| ราคา API ต่อ 1M โทเค็น | แสดงในราคาส่วนลดช่วงตัวอย่าง | $0.70 อินพุต, $0.07 อินพุตแคช, $2.10 เอาต์พุต |
การเปลี่ยนแปลงโหมดการให้เหตุผลทำให้โค้ดพัง หากการผสานรวมช่วงตัวอย่างของคุณส่ง reasoning_effort: "none" ให้เปลี่ยนเป็น "low": โพสต์เปิดตัวบน Hugging Face ระบุว่า Transformers จะรัน none ที่ high ดังนั้นการตั้งค่าที่ล้าสมัยจะทำให้สิ้นเปลืองโทเค็นแทนที่จะล้มเหลว
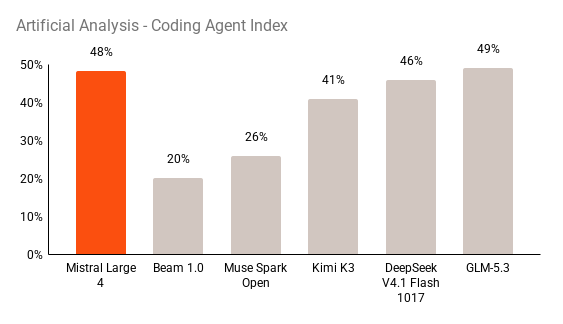
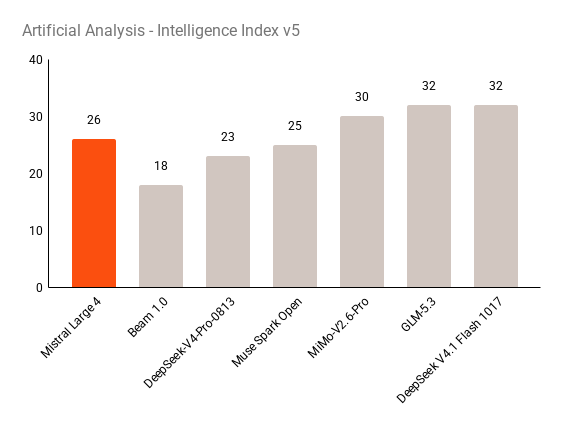
ตัวเลข benchmark ทั้งหมดในโพสต์นี้เป็นข้อมูลที่ผู้ขายรายงาน Mistral ยังอ้างว่าได้ 19.7% ใน FrontierCode 2.0 benchmark ส่วนตัวของ Cognition ซึ่งเป็นคะแนน open-weight สูงสุดในแผนภูมิของตน และ 48% ใน Artificial Analysis Coding Agent Index ซึ่งใกล้เคียงกับ GLM-5.3 การทำซ้ำโดยอิสระยังคงอยู่ระหว่างดำเนินการเมื่อเราตรวจสอบเมื่อวันที่ 2 พฤศจิกายน
สามวิธีในการรัน Mistral Large 4
คุณมีสามเส้นทาง และเส้นทางที่เหมาะสมขึ้นอยู่กับว่าคุณควบคุมฮาร์ดแวร์ได้มากแค่ไหน
- เรียก Mistral API Model id
mistral-large-4, $0.70 อินพุต, $0.07 อินพุตแคช และ $2.10 เอาต์พุตต่อล้านโทเค็น ไม่ต้องใช้ GPU - ใช้ผู้ให้บริการโฮสต์ Mistral ระบุ OpenRouter, endpoint ที่โฮสต์โดย NVIDIA และ NIM container รวมถึง Microsoft Foundry ซึ่งมี private deployment บน Azure ด้วย
- โฮสต์น้ำหนักด้วยตัวเอง ดาวน์โหลดจาก Hugging Face และให้บริการด้วย vLLM, SGLang, Transformers หรือ llama.cpp บนเครื่องของคุณเอง
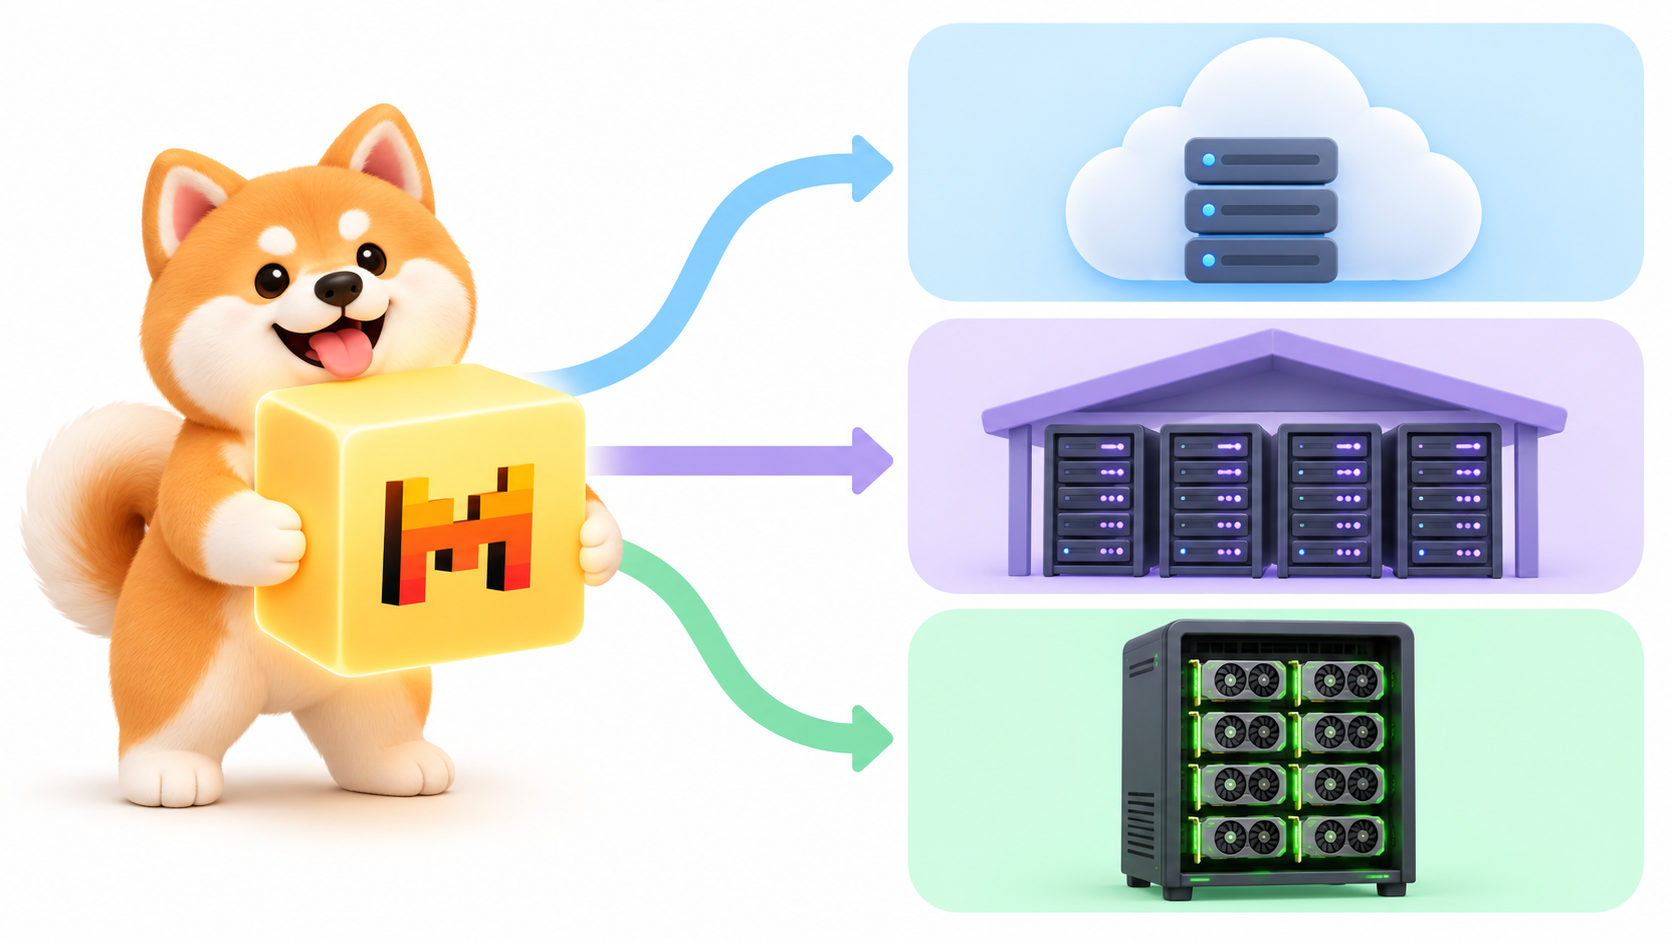
เริ่มจากเส้นทางที่ 1 หรือ 2 ย้ายไปเส้นทางที่ 3 ด้วยเหตุผลที่เป็นรูปธรรม: ข้อมูลที่ไม่สามารถออกจากเครือข่ายของคุณ, fine-tune ที่คุณต้องเป็นเจ้าของ, หรือปริมาณที่ทำให้โหนด 8 GPU ทำงานเต็มที่
วิธีดาวน์โหลด Mistral Large 4
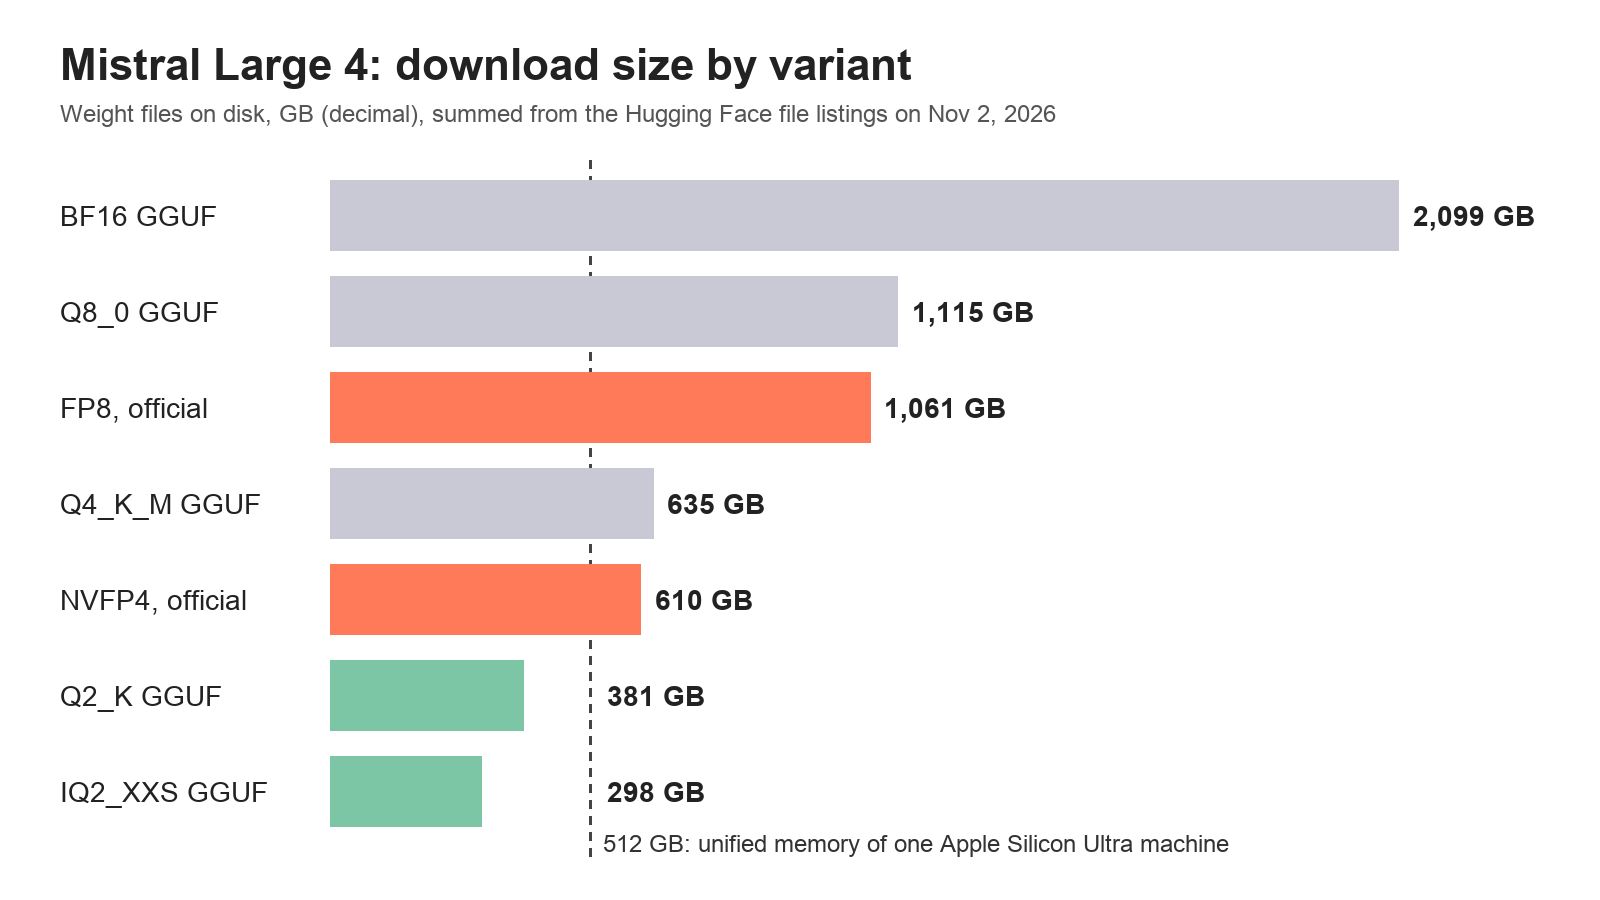
repo อย่างเป็นทางการไม่มีการควบคุมการเข้าถึง (Hugging Face API รายงาน gated: false สำหรับทั้งสอง) ดังนั้นบัญชีใดก็ตามหรือไคลเอนต์ไม่ระบุตัวตนสามารถดึงได้ ขนาดคือประตูด่านที่แท้จริง
| Repo | รูปแบบ | ขนาดบนดิสก์ |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8, อย่างเป็นทางการ | ประมาณ 1,061 GB |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4, อย่างเป็นทางการ | ประมาณ 610 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | ประมาณ 1,115 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | ประมาณ 635 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | ประมาณ 381 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | ประมาณ 298 GB |
เรารวมข้อมูลเหล่านี้จากรายการไฟล์ของแต่ละ repo เมื่อวันที่ 2 พฤศจิกายน 2026 Unsloth ยังเผยแพร่ GGUF quants ภายใต้ unsloth/Mistral-Large-4-1T-A52B-GGUF
ดาวน์โหลดเฉพาะไฟล์ที่คุณต้องการด้วย Hugging Face CLI:
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
การดาวน์โหลด FP8 ใช้เวลามากกว่าสองชั่วโมงเล็กน้อยที่ความเร็ว 1 Gbps ต่อเนื่อง
วิธีโฮสต์ Mistral Large 4 ด้วยตัวเอง
ตัวอย่างการให้บริการอย่างเป็นทางการทุกรายการสมมติว่าใช้หนึ่งโหนดที่มี 8 GPU และ tensor parallelism เป็น 8 นี่คือสิ่งที่แต่ละเอนจินคาดหวัง
| เอนจิน | Checkpoint | ฮาร์ดแวร์ในตัวอย่างอย่างเป็นทางการ |
|---|---|---|
| vLLM | FP8 | 8 GPU, --tensor-parallel-size 8; Hugging Face Inference Endpoints ใช้ 8x H200 |
| vLLM | NVFP4 | 8 NVIDIA Blackwell GPU |
| SGLang | FP8 | 8 GPU, --tp-size 8 |
| Transformers | FP8 | 8 GPU ผ่าน torchrun |
| llama.cpp | Q2_K GGUF | เครื่อง Apple Silicon Ultra หนึ่งเครื่องที่มีหน่วยความจำรวม 512 GB |
vLLM
model card แนะนำ vLLM และมี Docker image เฉพาะ:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
เก็บ flag parser ทั้งสองไว้ ไม่ฉะนั้นข้อความคิดจะไปอยู่ใน content และการเรียกเครื่องมือจะมาเป็นข้อความดิบ สำหรับการถอดรหัสที่เร็วขึ้น การ์ดได้บันทึก DSpark speculative decoder แบบเลือกได้: เพิ่ม --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'
บน 8x H200 กับ drafter นั้น Hugging Face วัดได้ประมาณ 65 โทเค็นต่อวินาทีสำหรับหนึ่งคำขอ และประมาณ 480 โทเค็นต่อวินาทีโดยรวมจากบทสนทนา ShareGPT 1,000 รายการภายใต้โหลด
SGLang ก็ใช้ได้เช่นกัน: ตัวอย่าง sglang serve ใน model card ใช้ --tp-size 8, --speculative-algorithm DSPARK และ parser สำหรับการให้เหตุผลและการเรียกเครื่องมือแบบ auto
llama.cpp บน Mac
ทีม llama.cpp สนับสนุนตั้งแต่วันแรก Q2_K quant (381 GB) พอดีกับเครื่อง Apple Silicon Ultra หนึ่งเครื่องที่มีหน่วยความจำรวม 512 GB:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
Hugging Face รายงานประมาณ 90 โทเค็นต่อวินาทีสำหรับ prefill และ 15 สำหรับ generation บน M3 Ultra หนึ่งเครื่อง: ใช้ได้สำหรับการทดลองส่วนตัว แต่ช้าสำหรับ agent loop quant 2-bit ยังสูญเสียคุณภาพ ดังนั้นทดสอบกับงานของคุณเองก่อน
การสุ่มที่ Mistral แนะนำคือ temperature=1.0 และ top_p=0.95 ในทุกระดับการให้เหตุผล
การเรียกโมเดลที่คุณโฮสต์เอง
vLLM และ SGLang เปิดเผยเซิร์ฟเวอร์ที่เข้ากันได้กับ OpenAI ดังนั้นคำขอจะดูเหมือน chat completion ทั่วไป:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
บน API ที่โฮสต์ ให้ส่ง body เดียวกันไปที่ https://api.mistral.ai/v1/chat/completions โดยใช้ "model": "mistral-large-4" และ Bearer key เอกสารเซิร์ฟเวอร์ที่เข้ากันได้กับ OpenAI ของ vLLM มีรายการฟิลด์ที่ยอมรับ
ให้ Claude Code ทดสอบทั้งสอง endpoint ด้วย Apidog CLI
โมเดลที่โฮสต์เองล้มเหลวอย่างเงียบๆ: flag parser ที่หายไปทำให้การให้เหตุผลรั่วไหลเข้าไปใน content หรือการเรียกเครื่องมือกลับมาเป็นข้อความธรรมดา ให้ coding agent ของคุณตรวจสอบทั้งสองเส้นทางด้วย Apidog CLI แทนที่จะวางคำสั่ง curl ด้วยมือ
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
จากนั้นให้ prompt หนึ่งข้อกับ Claude Code:
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
agent จะอ่านแต่ละ schema ตรวจสอบ payload และรันเคส:
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
เพิ่ม --upload-report เพื่อดูการรันในแอป Apidog หรือใส่บรรทัด apidog run ... -r junit เดียวกันใน CI เพื่อที่การอัปเกรด vLLM จะไม่สามารถส่งออกพร้อมการเรียกเครื่องมือที่พังได้ คู่มือ Apidog CLI ใน Claude Code ของเราครอบคลุมการตั้งค่าโดยละเอียดยิ่งขึ้น แผนฟรีของ Apidog รองรับผู้ใช้สูงสุด 4 คน
ลิขสิทธิ์: สิ่งที่คุณทำได้และทำไม่ได้
Mistral Ecosystem Open-Weight License เป็น MIT ที่มีเงื่อนไขเพิ่มเติมหนึ่งข้อ
คุณสามารถ: รัน, ปรับใช้, fine-tune และแก้ไขโมเดลและอนุพันธ์ของมัน สำหรับการใช้เชิงพาณิชย์และไม่ใช่เชิงพาณิชย์ ตราบใดที่คุณเก็บข้อความลิขสิทธิ์และอนุญาตไว้ในสำเนา
คุณต้องมีลิขสิทธิ์เชิงพาณิชย์แยกต่างหากจาก Mistral หาก: คุณรันเป็น “Model as a Service” ซึ่งลิขสิทธิ์กำหนดว่าเป็นการให้บุคคลที่สามเข้าถึงโมเดลหรืออนุพันธ์ของมันเพื่อการอนุมานหรือ post-training
เงื่อนไขนั้นไม่ใช้กับ: การใช้ภายใน, ผลิตภัณฑ์สำหรับผู้ใช้ปลายทางที่โมเดลอยู่ภายในฟีเจอร์หรือ harness เฉพาะ, การส่งต่อคำขอไปยังโมเดลที่คนอื่นโฮสต์, และการใช้ผ่านผลิตภัณฑ์ของ Mistral เอง
ผู้ช่วยเขียนโค้ดภายในหรือฟีเจอร์ผลิตภัณฑ์ที่สร้างบนโมเดลนั้นทำได้ การขายต่อการอนุมานดิบต้องมีข้อตกลง นี่คือบทสรุป ไม่ใช่คำแนะนำทางกฎหมาย
สำหรับคำแนะนำที่คล้ายกันบนโมเดล open-weight อื่น ดู คู่มือการโฮสต์ GLM-5.3 ด้วยตัวเอง ของเรา
คุณควรโฮสต์เองหรือเรียก API?
เรียก API เมื่อปริมาณของคุณปานกลาง, คุณต้องการบริบท 1M โดยไม่ต้องปรับแต่งขีดจำกัดเซิร์ฟเวอร์, หรือคุณยังไม่ได้รันโหนด 8 GPU ในราคา $0.70 อินพุต และ $2.10 เอาต์พุตต่อล้านโทเค็น, 100 ล้านโทเค็นอินพุตบวก 20 ล้านโทเค็นเอาต์พุตต่อเดือนคิดเป็น $112 ก่อนส่วนลดแคชใดๆ
โฮสต์เองเมื่อข้อมูลของคุณไม่สามารถออกจากเครือข่ายได้, เมื่อคุณต้องการเป็นเจ้าของ fine-tune (Hugging Face แสดงการฝึก LoRA ด้วย TRL บนโหนด 8x B300), หรือเมื่อปริมาณที่คงที่ทำให้โหนดทำงานเต็มที่ บริการ Forge ของ Mistral เป็นตัวเลือกแบบจัดการสำหรับการปรับแต่งบนข้อมูลของคุณเอง
คำถามที่พบบ่อย
น้ำหนักแบบเปิดของ Mistral Large 4 ดาวน์โหลดฟรีหรือไม่?
ใช่ repo อย่างเป็นทางการทั้งสองบน Hugging Face ไม่มีการควบคุมการเข้าถึง ดังนั้นคุณสามารถดาวน์โหลดได้โดยไม่ต้องขอสิทธิ์ การรันต่างหากคือค่าใช้จ่าย: checkpoint FP8 อย่างเป็นทางการมีขนาดประมาณ 1,061 GB และตัวอย่างการให้บริการใช้ GPU ศูนย์ข้อมูล 8 ตัว
ฉันสามารถรัน Mistral Large 4 บน GPU เดียวได้หรือไม่?
ไม่มีสูตรอย่างเป็นทางการใดที่ครอบคลุม GPU เดียว ตัวอย่าง vLLM, SGLang และ Transformers ทุกตัวอย่างใช้ 8 GPU กับ tensor parallelism การตั้งค่าที่เล็กที่สุดที่บันทึกไว้คือ llama.cpp กับ Q2_K quant 381 GB บนเครื่อง Apple Silicon Ultra หนึ่งเครื่องที่มีหน่วยความจำรวม 512 GB
Mistral Large 4 เป็นโอเพนซอร์สหรือไม่?
เป็น open weight ไม่ใช่โอเพนซอร์สในความหมายของ OSI คุณได้รับน้ำหนักภายใต้ลิขสิทธิ์ MIT ดัดแปลงที่อนุญาตให้ใช้เชิงพาณิชย์ แต่การเสนอโมเดลให้บุคคลที่สามเป็นบริการอนุมานหรือ post-training ต้องมีลิขสิทธิ์เชิงพาณิชย์แยกต่างหากจาก Mistral
โมเดล open-weight เหมือนกับโมเดล API หรือไม่?
Mistral กล่าวว่า checkpoint ที่เปิดตัวได้รับการเรียนรู้แบบเสริมกำลังเพิ่มอีกสามสัปดาห์หลังจากตัวอย่างเมื่อวันที่ 6 ตุลาคม และ API ให้บริการโมเดลที่อัปเดตแล้วในชื่อ mistral-large-4 โหมดการให้เหตุผลก็เปลี่ยนเช่นกัน: ใช้ low, medium หรือ high
Mistral Large 4 API มีค่าใช้จ่ายเท่าไร?
Mistral ระบุ $0.70 ต่อล้านโทเค็นอินพุต, $0.07 ต่อล้านโทเค็นอินพุตแคช และ $2.10 ต่อล้านโทเค็นเอาต์พุต ณ วันที่ 2 พฤศจิกายน 2026