MCP กับ CLI แตกต่างกันที่จังหวะที่เอเจนต์ของคุณต้องจ่ายค่าใช้จ่ายสำหรับเครื่องมือ MCP server จะส่งชื่อ คำอธิบาย และ JSON Schema ของทุกเครื่องมือไปยังโมเดลก่อนที่คุณจะพิมพ์อะไรเลย ส่วน CLI ไม่มีค่าใช้จ่ายจนกว่าเอเจนต์จะรันมันและอ่าน --help หรือผลลัพธ์ของมัน จากการวัดจริงในสภาพแวดล้อมหนึ่ง พบว่า MCP server ทั่วไปสี่ตัวเพิ่ม tool definitions ถึง 11,923 tokens ในขณะที่ Apidog CLI skill เพิ่มเพียง 112 tokens
ช่องว่างนี้คือเรื่องราวทั้งหมดเบื้องหลังโพสต์สองชิ้นบน Dev.to ในสัปดาห์นี้ นักพัฒนาคนหนึ่งพิมพ์ “Run tests” ลงใน coding agent แล้วพบว่า request แรกใช้ input tokens ถึง 28,400 tokens ทั้งที่ไม่ได้แนบไฟล์และไม่มีประวัติการสนทนา ตัวการคือ MCP servers ถึงเจ็ดตัว อีกโพสต์หนึ่งโต้แย้งว่า MCP นั้นง่ายมากในการสร้าง และส่วนที่ยากจริง ๆ (การยืนยันตัวตน การอนุมัติ การเรียกซ้ำซ้อน) จะเริ่มขึ้นหลังจากที่เดโมทำงานได้แล้วเท่านั้น
บทความนี้จะเน้นที่คำถามเดียว: tool definitions กินพื้นที่ context window ของคุณมากแค่ไหน และเมื่อไรที่ CLI ซึ่งเอเจนต์เรียกใช้ตามความต้องการจะมีต้นทุนต่ำกว่า ถ้าปัญหาของคุณคือ tool responses ที่ใหญ่โตเกินไป ลองอ่านบทความคู่กันเรื่อง การตัด API responses ที่บวมให้กระชับ
ทำไม MCP servers จึงใช้ tokens จาก context window
MCP server ประกาศเครื่องมือของตัวเองผ่านเมธอด tools/list ตามข้อกำหนด MCP tools เครื่องมือแต่ละตัวจะมี name, description และ inputSchema (JSON Schema สำหรับอาร์กิวเมนต์ของมัน) เพื่อให้โมเดลเลือกเครื่องมือได้ client ต้องใส่ definitions เหล่านี้ลงใน request ในรูปแบบดั้งเดิม สิ่งนี้เกิดขึ้นในทุกเทิร์นของทุกบทสนทนา ไม่ว่าเอเจนต์จะเรียกใช้เครื่องมือนั้นหรือไม่
ดังนั้นต้นทุนจะเพิ่มขึ้นตามสามปัจจัย:
- จำนวนเครื่องมือ integration กับ GitHub แบบเต็มรูปแบบสามารถเปิดเผยเครื่องมือได้มากถึงหลายสิบตัว
- ความลึกของ Schema อ็อบเจกต์ที่ซ้อนกัน, enum และคำอธิบายที่ยาวทั้งหมดกลายเป็น tokens
- จำนวนเทิร์น agent loop จะส่ง definitions ซ้ำอีกครั้งในทุกขั้นตอน
โพสต์ของ necoz ให้ตัวเลขเปรียบเทียบ: stack ที่มี 52 เครื่องมือใช้ schema 24,600 tokens ในเทิร์นแรก เทียบกับ 640 tokens สำหรับชุด 4 เครื่องมือ และประมาณ 246,000 tokens ตลอด loop 10 ขั้นตอน ให้ถือว่านี่เป็นการวัดของนักพัฒนาคนหนึ่ง ไม่ใช่ benchmark มาตรฐาน Prompt caching ช่วยลดต้นทุนด้านเงินของ definitions ที่เกิดซ้ำ แต่ tokens เหล่านั้นยังคงครอบครองพื้นที่ใน window และแย่งความสนใจกับโค้ดของคุณ
ยังมีต้นทุนด้านคุณภาพอีกด้วย เอกสารtool search ของ Anthropic ระบุว่าระบบที่มีหลาย servers ทั้ง GitHub, Slack, Sentry, Grafana และ Splunk “อาจใช้ definitions ประมาณ 55k tokens ก่อนที่ Claude จะเริ่มทำงานใด ๆ” และความแม่นยำในการเลือกเครื่องมือของ Claude จะลดลงเมื่อมีเครื่องมือที่ใช้ได้เกิน 30 ถึง 50 ตัว
Tokens ของ MCP tool definitions: การวัดที่คุณทำซ้ำได้
เมื่อวันที่ 2026-11-16 ผมรัน MCP servers ห้าตัวแบบ local ผ่าน stdio ส่ง initialize และ tools/list จากสคริปต์ Node 30 บรรทัด และนับ tokens ใน name, description และ inputSchema ของแต่ละเครื่องมือ
ข้อควรระวังก่อนอื่น: ผมนับด้วย encoding o200k_base ของ tiktoken ของ OpenAI เพราะรันแบบ offline ได้ Claude, Gemini และโมเดลอื่น ๆ ใช้ tokenizer ของตัวเอง ดังนั้นตัวเลขของคุณจะต่างกันไปบ้าง สิ่งที่สำคัญในที่นี้คือสัดส่วนเปรียบเทียบระหว่างแต่ละรูปแบบ
| MCP server (เวอร์ชัน) | เครื่องมือ | Definition tokens | เฉลี่ยต่อเครื่องมือ |
|---|---|---|---|
@playwright/mcp 0.0.85 |
25 | 4,634 | 185 |
@modelcontextprotocol/server-filesystem 2.3.0 |
16 | 3,281 | 205 |
@modelcontextprotocol/server-memory 2.1.1 |
9 | 2,013 | 224 |
@modelcontextprotocol/server-everything 2.3.0 |
16 | 1,995 | 125 |
| สี่ตัวรวมกัน | 66 | 11,923 | 181 |
apidog-mcp-server 0.0.18 |
3 | 291 | 97 |
Server ธรรมดาสี่ตัวมีต้นทุนประมาณ 12,000 tokens ก่อนที่เอเจนต์จะได้อ่านไฟล์สักไฟล์
แถวสุดท้ายคือตัวอย่างตรงข้ามที่น่าสนใจ Apidog MCP server เปิดเผยเครื่องมือเฉพาะทางเพียงสามตัว (อ่าน OpenAPI spec ของโปรเจกต์, อ่านไฟล์ $ref, รีเฟรช spec) จึงมีต้นทุนเพียง 291 tokens จำนวนเครื่องมือและความลึกของ schema ต่างหากที่เป็นตัวกำหนดค่าใช้จ่าย ไม่ใช่ตัวโปรโตคอล
ฝั่ง CLI ผมวัดว่าเอเจนต์อ่านอะไรบ้างเมื่อใช้ Apidog CLI 2.2.12:
| ข้อความ CLI | เมื่อไรที่เข้าสู่ context | Tokens |
|---|---|---|
| คำอธิบาย Apidog CLI skill (frontmatter) | ทุกเซสชัน ในรูปแบบรายการ skill | 112 |
| เนื้อหา Apidog CLI skill | เฉพาะเมื่องานตรงกับ skill | 1,189 |
apidog --help |
เฉพาะเมื่อเอเจนต์รันมัน | 668 |
apidog test-case --help |
เฉพาะเมื่อเอเจนต์รันมัน | 511 |
apidog run --help |
เฉพาะเมื่อเอเจนต์รันมัน | 1,036 |
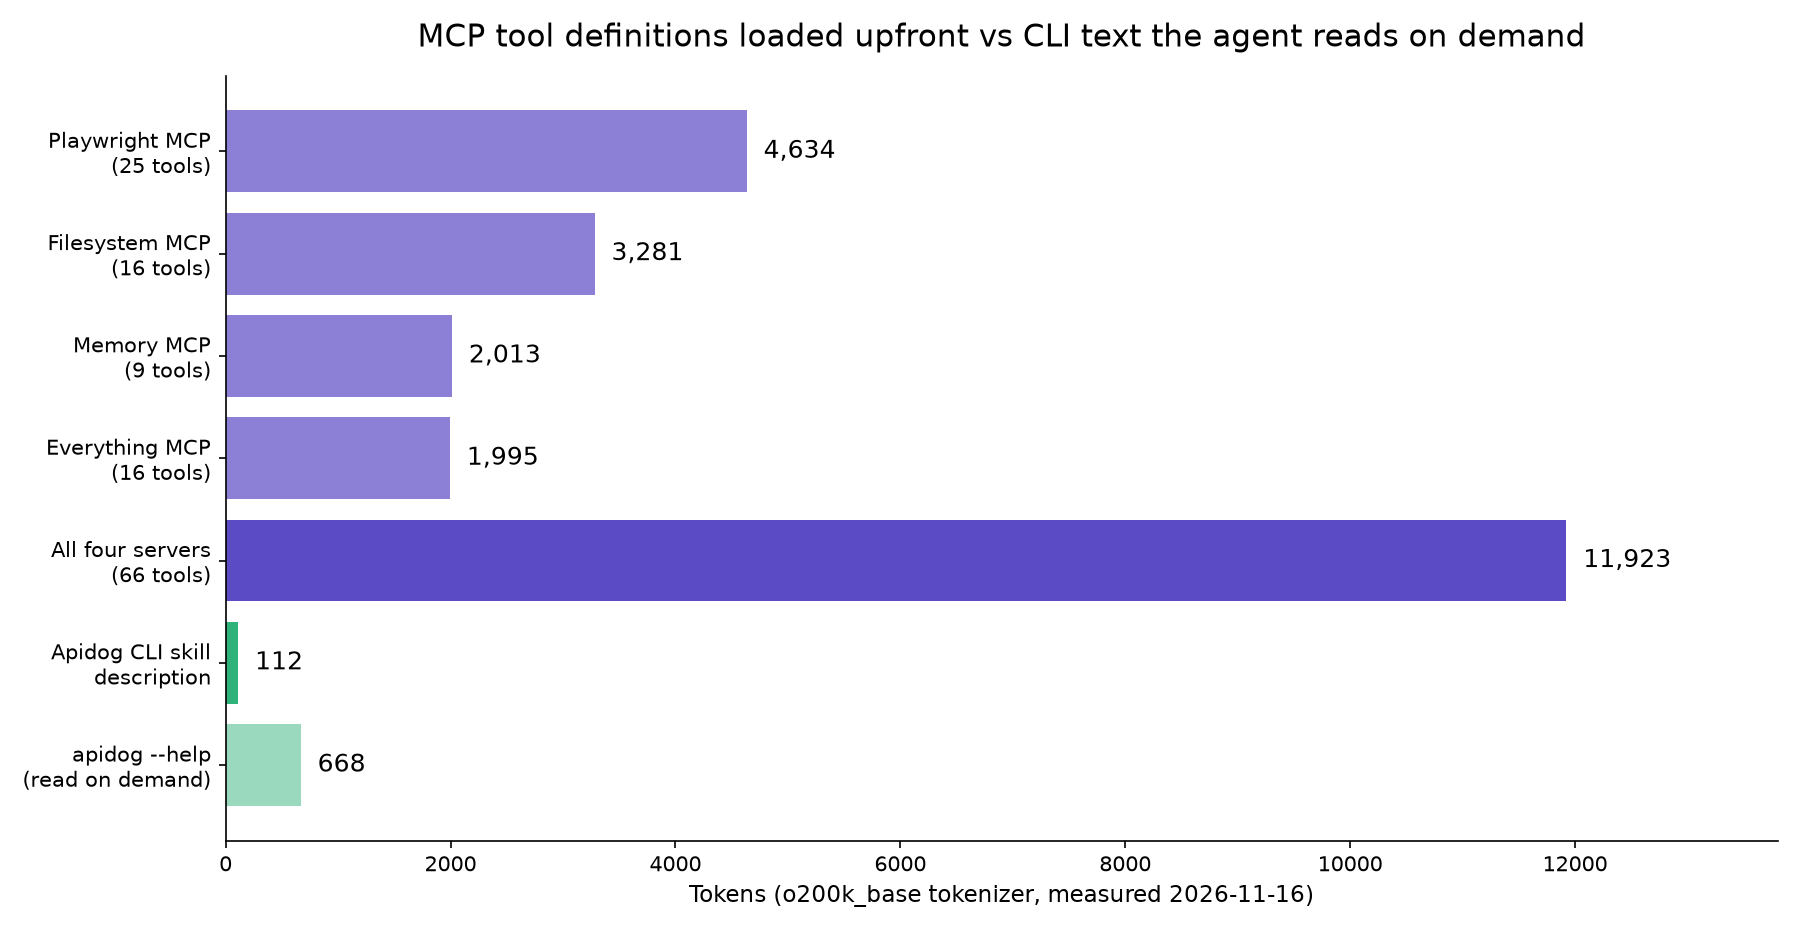
ต้นทุนแบบ always-on ของเส้นทาง CLI คือ 112 tokens แม้ว่าเอเจนต์จะโหลด skill เต็มรูปแบบและอ่าน help สามหน้า ก็จะใช้ราว 3,500 tokens และเกิดขึ้นเฉพาะในบทสนทนาที่ต้องใช้เท่านั้น
MCP vs CLI: การเปรียบเทียบต้นทุน token
| MCP server (โหลด definitions ล่วงหน้า) | CLI ที่เรียกผ่าน shell | |
|---|---|---|
| ต้นทุนล่วงหน้า | Schema ของทุกเครื่องมือ ทุกเทิร์น | ศูนย์ หรือคำอธิบาย skill สั้น ๆ |
| การค้นพบ | tools/list แบบมีโครงสร้าง |
ข้อความ --help อ่านเมื่อจำเป็น |
| ผลลัพธ์ | อะไรก็ตามที่เครื่องมือคืนค่า | อะไรก็ตามที่คำสั่งพิมพ์ออกมา (กรองได้) |
| ใช้งานข้าม client ได้ | MCP client ตัวใดก็ได้ ใช้ config เดียว | เอเจนต์ใดก็ได้ที่มี shell tool |
| อาร์กิวเมนต์แบบมี type | มี ผ่าน JSON Schema | Flags; ไฟล์ payload ตรวจสอบแยกต่างหาก |
| การยืนยันตัวตนและสิทธิ์ | เป็นหน้าที่ของ server (OAuth สำหรับ HTTP server แบบ remote) | การล็อกอินและสิทธิ์ shell ในเครื่องของคุณ |
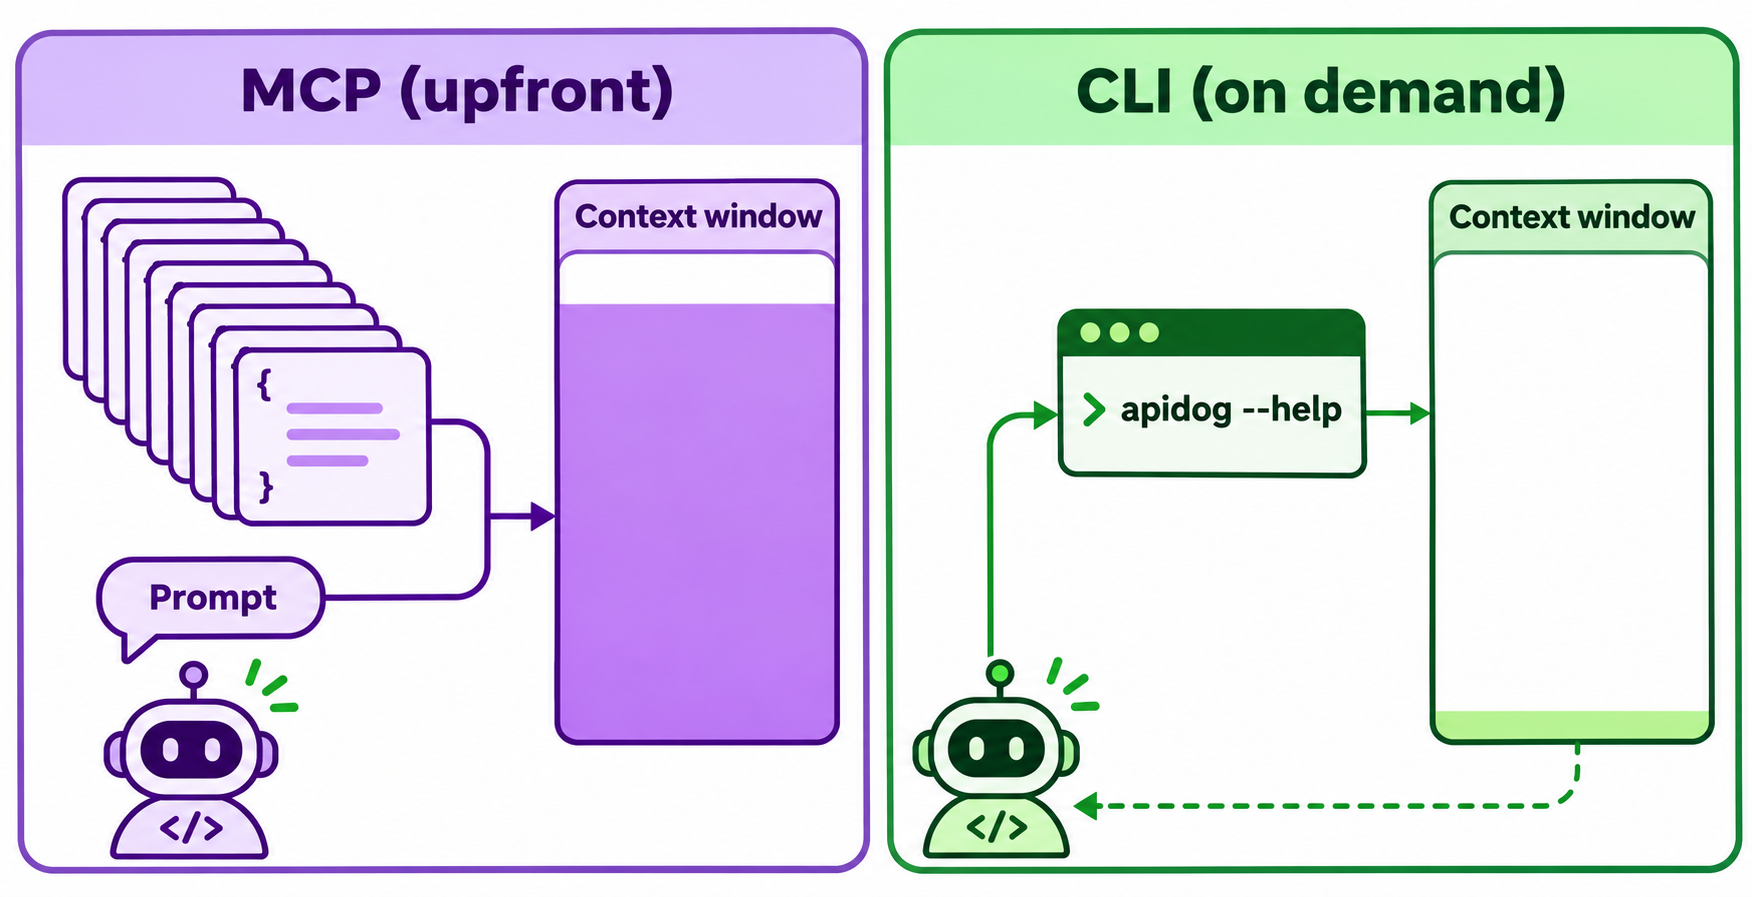
CLI ได้เปรียบด้านต้นทุนล่วงหน้าเพราะเอเจนต์มี shell tool อยู่แล้ว การรัน apidog endpoint list --project 123 ใช้ Bash tool ที่มันก็จะต้องโหลดอยู่แล้ว ส่วนเส้นทาง MCP ได้เปรียบเมื่อคุณต้องการความสามารถเดียวกันในหลาย client โดยไม่ต้องเขียน integration สำหรับแต่ละตัว ซึ่งเป็นประเด็นที่ Sylwia Lask ย้ำ: MCP ไม่ใช่สิ่งที่มาแทน REST แต่เป็นวิธีมาตรฐานสำหรับ AI clients ในการค้นพบและเรียกใช้เครื่องมือ
Client ของคุณอาจเลื่อนการโหลด MCP tools อยู่แล้ว
ก่อนที่คุณจะถอด server ออกทั้งหมด ลองตรวจดูว่าเอเจนต์ของคุณทำอะไรอยู่ ต้นทุนที่กล่าวมาข้างต้นสันนิษฐานว่า definitions ถูกโหลดล่วงหน้า แต่บาง client ไม่ได้ทำเช่นนั้นโดยค่าเริ่มต้นอีกต่อไป
เอกสาร MCP ของ Claude Code ระบุว่า tool search เปิดใช้งานโดยค่าเริ่มต้น: “มีเพียงชื่อเครื่องมือและคำแนะนำของ server ที่โหลดตอนเริ่มเซสชัน” และ definitions เต็มรูปแบบจะโหลดเมื่อ Claude ค้นหามัน คุณควบคุมได้ด้วย ENABLE_TOOL_SEARCH:
- ไม่ตั้งค่า หรือ
true: MCP tools ถูกเลื่อนออกไปและโหลดตามความต้องการ auto: เครื่องมือโหลดล่วงหน้าตราบใดที่ผลรวม definitions ยังต่ำกว่า 10% ของ context windowauto:N: เหมือนกัน แต่ใช้เปอร์เซ็นต์ที่คุณกำหนดเองfalse: MCP tool ทุกตัวโหลดล่วงหน้า
มีข้อยกเว้นสองข้อที่ควรรู้ โมเดลที่เก่ากว่า Opus 4 และ Sonnet 4 จะโหลด MCP tools ล่วงหน้าไม่ว่ากรณีใด และ server ที่ตั้งค่า alwaysLoad: true จะข้ามการเลื่อนโหลด รัน /context ใน Claude Code เพื่อดูว่าเครื่องมือใดถูกทำเครื่องหมายว่าเลื่อนโหลด บน Claude API เอง แนวคิดเดียวกันคือ tool search tool: คุณตั้ง defer_loading: true บนเครื่องมือที่ไม่ควรโหลดล่วงหน้า และ Anthropic ระบุว่าวิธีนี้มักลด tokens ของ definitions ได้มากกว่า 85%
การเลื่อนโหลดแก้ปัญหาต้นทุนของ definitions แต่ไม่ใช่ต้นทุนของผลลัพธ์: Claude Code จะเตือนเมื่อ MCP tool คืนค่ามากกว่า 10,000 tokens และจำกัดผลลัพธ์ไว้ที่ 25,000 โดยค่าเริ่มต้น (MAX_MCP_OUTPUT_TOKENS) ยังไม่คุ้นเคยกับโปรโตคอลนี้? เริ่มจากบทความ MCP คืออะไรและทำไมจึงสำคัญต่อ API
เมื่อไรควรใช้ MCP หรือ CLI สำหรับงาน API
สำหรับงานออกแบบ ทดสอบ และเอกสาร API ใช้แนวแบ่งนี้:
- ใช้ CLI เมื่องานนั้นเป็นสิ่งที่คุณก็จะรันใน terminal อยู่แล้ว: ลิสต์ endpoint, export ไฟล์ OpenAPI, สร้างและรัน test case, รันชุดทดสอบใน CI เอเจนต์จ่ายค่า help text เฉพาะเมื่อจำเป็น และคุณสามารถ pipe ผลลัพธ์ผ่าน
jqหรือ--reportersเพื่อให้กระชับได้ - ใช้ MCP server แบบเฉพาะทาง เมื่อเอเจนต์ต้องการการเข้าถึงแบบมีโครงสร้างในทุกเทิร์น เช่น การอ่าน OpenAPI spec ของคุณขณะเขียนโค้ด client สามเครื่องมือที่ใช้ 291 tokens ถือว่าเป็นราคาที่สมเหตุสมผล
- หลีกเลี่ยงการเปิดใช้ server ห้าตัวขึ้นไปแบบ global ในทุกโปรเจกต์ นั่นคือรูปแบบที่ทำให้เกิดคำสั่ง “Run tests” ที่กิน 28,400 tokens
ไม่ว่าคุณจะเลือกทางไหน คำเตือนของ Sylwia ยังใช้ได้อยู่: เครื่องมือที่เขียนข้อมูลต้องมีการตรวจสอบสิทธิ์ฝั่ง server, มีขั้นตอนอนุมัติโดยมนุษย์สำหรับการกระทำที่มีความเสี่ยง และมีการตรวจจับการเรียกซ้ำ เพื่อไม่ให้การรันซ้ำสร้างระเบียนเดิมขึ้นมาสองครั้ง
ให้ coding agent ของคุณขับเคลื่อน Apidog CLI
นี่คือเส้นทางแบบ CLI สำหรับงาน API โดยให้ coding agent ของคุณเป็นคนพิมพ์ ติดตั้ง CLI, ล็อกอินหนึ่งครั้ง และเพิ่ม agent skill:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
คุณยังสามารถสั่งเอเจนต์ว่า “Read https://apidog.com/apidog-cli-installation-guide.md and set up Apidog CLI” แล้วมันจะทำตามคู่มือติดตั้งสำหรับเอเจนต์
จากนั้นสั่งด้วย prompt เดียว:
In Apidog project 123, list the endpoints, export the spec as OpenAPI 3.1 to
./openapi.json, then create a test case for GET /users/{id} that asserts a 200
status and an id field, run it against environment 456 and summarize failures.
Read --help for each command before using it. Print only the lines you need.
เอเจนต์จะอ่าน help ไปด้วย ตรวจสอบ JSON ไปด้วย แล้วรัน test case:
apidog endpoint list --project 123 --page 1 --page-size 500
apidog export --project 123 --format openapi --oas-version 3.1 --output ./openapi.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project 123 --file case.json
apidog run --test-case <caseId> --project 123 -e 456 -r cli,json
แต่ละคำสั่งคืนค่า JSON แบบมีโครงสร้าง มักมาพร้อม agentHints.nextSteps เอเจนต์จึงรู้ว่าควรรันอะไรต่อไปโดยไม่ต้องโหลด schema สำหรับทุกการกระทำที่เป็นไปได้ บรรทัดเดียวกัน apidog run ... -r junit ใช้ใน CI ได้เลย ตามที่แสดงในคู่มือ Apidog CLI CI/CD pipeline สำหรับ walkthrough บน Claude Code ดูที่ Apidog CLI in Claude Code และสำหรับตัวเลขการประหยัด tool calls ที่วัดจริง ดูที่ tool calls ลดลง 30%, tokens ลดลง 25%
เพื่อดูทุกกลุ่มคำสั่งก่อนเริ่มใช้งาน อ่านหน้า Apidog CLI
วิธีลดต้นทุน token ของ MCP ได้ตั้งแต่วันนี้
- รัน
/contextใน Claude Code (หรือฟังก์ชันเทียบเท่าใน client ของคุณ) และจดผลรวมของ tool definitions - ย้าย server ที่ไม่จำเป็นจาก config ระดับ global ไปเป็น config ระดับโปรเจกต์
- เปิดใช้ deferred loading (
ENABLE_TOOL_SEARCHใน Claude Code) - เปลี่ยน server แบบครอบคลุมมากเกินไปเป็น CLI บวก skill สั้น ๆ สำหรับงานที่เหมาะกับ terminal
- สำหรับ server ที่คุณสร้างเอง ให้มีเครื่องมือน้อย ๆ และคำอธิบายสั้น ๆ
คำถามที่พบบ่อย
MCP tools ใช้ tokens หรือไม่หากเอเจนต์ไม่เคยเรียกใช้? ใน client ที่โหลด definitions ล่วงหน้า คำตอบคือใช่ ชื่อ คำอธิบาย และ input schema ของทุกเครื่องมือจะถูกใส่ในทุก request ส่วน client ที่มี deferred loading เช่น Claude Code เมื่อเปิด tool search จะส่งเพียงชื่อเครื่องมือจนกว่าจะจำเป็นต้องใช้เครื่องมือนั้น
MCP server ใช้ tokens ประมาณเท่าไร? ขึ้นอยู่กับจำนวนเครื่องมือและความลึกของ schema จากการวัดของผม @playwright/mcp ใช้ 4,634 tokens สำหรับ 25 เครื่องมือ และ Apidog MCP server ใช้ 291 tokens สำหรับ 3 เครื่องมือ โดยนับด้วย tokenizer o200k_base
CLI ถูกกว่า MCP เสมอสำหรับ AI agents หรือไม่? ในแง่ต้นทุนล่วงหน้า เกือบจะเสมอ เพราะเอเจนต์ใช้ shell tool ที่มีอยู่แล้วซ้ำ แต่ในแต่ละครั้งที่เรียก CLI ก็อาจท่อน context ได้ถ้าเอเจนต์พิมพ์ payload ขนาดใหญ่ออกมา จึงควรกรองผลลัพธ์ไม่ว่าจะเลือกทางไหน
Prompt caching ช่วยแก้ปัญหา context บวมของ MCP ได้หรือไม่? มันช่วยลดราคาของ definitions ที่เกิดซ้ำ แต่ไม่ได้ปลดล็อกพื้นที่ context window และโมเดลยังคงต้องให้ความสนใจกับ tokens เหล่านั้นในทุกเทิร์น
ฉันควรเลิกใช้ MCP servers หรือไม่? ไม่ควร ใช้ server แบบเฉพาะทางสำหรับการเข้าถึงแบบมีโครงสร้างในทุกเทิร์น และสำหรับการแชร์ความสามารถเดียวกันข้ามหลาย client ส่วนงาน API ที่เหมาะกับ terminal เช่น export และการรันเทสต์ ให้ย้ายไปใช้ CLI