เมื่อ voice agent ล้มเหลวในการโทรจริง สาเหตุมักไม่ได้อยู่ที่ LLM หรือเสียงพูด แต่ปัญหาเริ่มต้นตั้งแต่ขั้นตอนก่อนหน้า นั่นคือที่ตัวเสียงที่ agent ได้ยิน ไม่ว่าจะส่งเข้าสู่ระบบ speech-to-text (STT) หรือส่งตรงเข้าโมเดล speech-to-speech ก็ตาม STT ยุคใหม่จัดการเสียงจราจรและเครื่องปรับอากาศได้ดี แต่สิ่งที่มันรับมือไม่ได้คือเสียงคนพูดคนที่สอง: เพื่อนร่วมงาน เสียงทีวี หรือเสียง agent ที่โต๊ะถัดไปในคอลเซ็นเตอร์ มันจะฟังเสียงเหล่านั้นด้วย และ agent ก็ทำงานตามคำที่ผู้โทรไม่เคยพูดเลย
Krisp Voice Isolation ทำงานอยู่หน้า STT และตัดเสียงทุกเสียงออก ยกเว้นเสียงของผู้พูดหลัก สำหรับรีวิวนี้ ผมได้อ่าน benchmark และเอกสารประกอบของ Krisp สมัครใช้งาน API แบบ self-serve และนำไฟล์เสียงจริง 8 ไฟล์จาก dataset สาธารณะของ Krisp มาทดสอบผ่านระบบ จากนั้นจึงถอดเสียงทั้งก่อนและหลังการประมวลผลด้วยโมเดล STT แบบ open-source เพื่อดูว่าอะไรเปลี่ยนไปบ้าง
สรุปสั้นๆ: ถ้า agent ของคุณรับสายจากสำนักงาน บ้าน คอลเซ็นเตอร์ หรือที่ใดก็ตามที่มีเสียงคนพูดอยู่ในพื้นหลัง Voice Isolation มีค่าที่จะนำไปใส่ไว้ใน pipeline ของคุณ ในการทดสอบของผม เสียงพูดในพื้นหลังที่กลายเป็นคำหลอกๆ ถึง 331 คำใน transcript ลดลงเหลือศูนย์ ข้อแลกเปลี่ยนก็มีจริงแต่เล็กน้อย: ต้นทุนเพิ่มขึ้นเล็กน้อยสำหรับเสียงโทรศัพท์ที่สะอาด API มีเฉพาะภูมิภาคสหรัฐฯ และโมเดลบน API มีน้อยกว่าบน SDK
ปัญหา: เสียงพูดจากฉากหลัง ไม่ใช่เสียงรบกวน
โมเดล STT ถูกฝึกให้จับเสียงพูด ไม่ได้ถูกฝึกให้ตัดสินว่าเสียงพูดของใครสำคัญ เสียงรบกวนสามารถถูกกรองออกได้เพราะมันไม่ใช่เสียงพูด แต่เสียงพูดของคนที่สองดูเหมือนเสียงพูดทุกประการ เพราะมันคือเสียงพูดจริงๆ
ตัวอย่างจาก Krisp เองก็ชัดเจนดี ผู้โทรขอยกเลิกการสมัครสมาชิก ขณะที่เพื่อนร่วมงานที่อยู่ใกล้ๆ ถามเรื่องอาหารกลางวัน STT จะคืนข้อความมาเป็นสตรีมเดียวโดยไม่มีอะไรบอกว่าคำไหนมาจากผู้โทร พนักงานจึงได้รับทั้งสองคำขอในรูปแบบเดียวกัน
เรื่องนี้ทำให้ voice agent ล้มเหลวในสามด้าน:
- การถอดเสียงผิดพลาด คำพูดของคนแปลกหน้าหลุดเข้าไปในข้อความถอดเสียง และ LLM ก็ตอบคำถามที่ผู้โทรไม่เคยพูดเลย
- การหยุดพูดเข้ามาแทรกโดยไม่จริง Agent ได้ยินเสียงคนแปลกหน้า เข้าใจว่าผู้โทรกำลังจะพูดแทรก จึงหยุดพูดกลางประโยค
- การสลับกันพูดพังทลาย เสียงพูดจากฉากหลังทำให้ Agent คิดว่าผู้โทรยังพูดไม่จบ จึงไม่สามารถระบุได้ว่าตอนของผู้โทรสิ้นสุดลงแล้ว
ในทุกกรณี ตรรกะของ Agent ทำงานได้ตามที่ออกแบบไว้ มันเพียงแค่ตอบสนองต่อเสียงพูดที่มันไม่ควรได้ยินตั้งแต่แรก
ตัวเลขแสดงให้เห็นว่าช่องว่างนี้กว้างแค่ไหน จากการทดสอบ Voice Isolation 2.5 release test ของ Krisp ระบบ STT 10 ระบบมีอัตราคำผิด (WER) เฉลี่ยอยู่ที่ 2.10% ในไฟล์เสียงเดี่ยวที่สะอาด แต่เมื่อมีคนที่สองพูดทับเสียงผู้โทร ระบบชุดเดิมกลับมีค่าเฉลี่ยสูงถึง 35.92% การกดเสียงรบกวนไม่สามารถปิดช่องว่างนี้ได้ เพราะสิ่งที่รบกวนคือเสียงพูด ไม่ใช่เสียงรบกวนทั่วไป
Krisp Voice Isolation คืออะไร
Krisp Voice Isolation API & SDK ทำหน้าที่ตัดเสียงพูดจากบุคคลอื่นและเสียงรบกวนออกจากสตรีมเสียงแบบเรียลไทม์ โดยส่งต่อเฉพาะเสียงของผู้พูดหลักเท่านั้น ได้รับการออกแบบมาสำหรับ voice AI agents โดยเป็นเทคโนโลยีหลักชุดเดียวกับที่ Krisp นำเสนอสำหรับการโทรของมนุษย์ภายใต้ชื่อ Background Voice Cancellation (BVC)
โดยปกติจะถูกวางไว้ลำดับแรกใน pipeline ของ agent เพื่อให้ทุกโมเดลที่อยู่ถัดจากมารับรู้เสียงของผู้พูดเพียงคนเดียว:
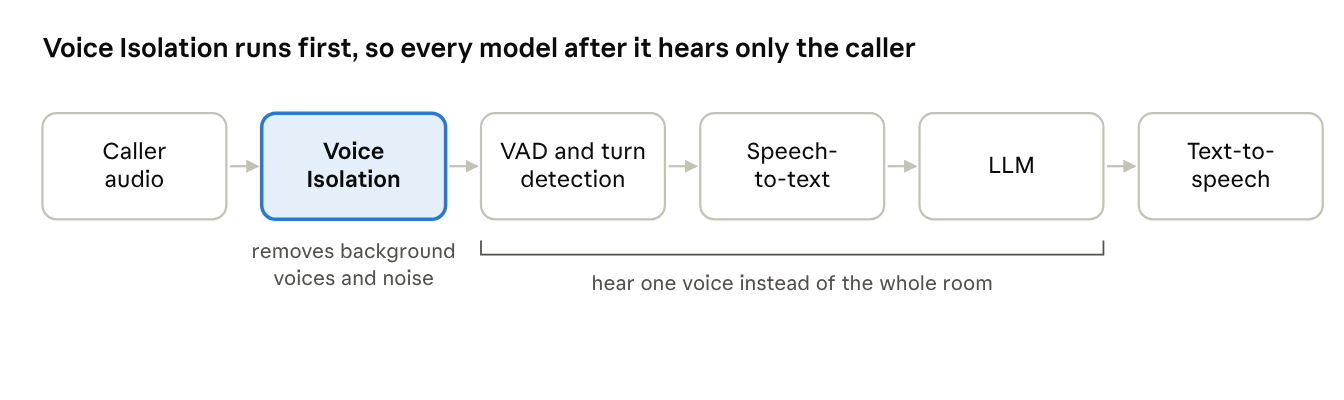
ตำแหน่งของ Voice Isolation ใน pipeline ของ voice agent
การวางตำแหน่งนี้สำคัญมาก หากไม่มีสิ่งนี้ VAD และ turn detection จะรับรู้เสียงของคนอื่นในบริเวณนั้นด้วย ซึ่งเป็นสาเหตุของการเข้าใจผิดว่าถูกขัดจังหวะ
Krisp ได้ลงทุนด้าน voice AI มาเป็นเวลาประมาณเก้าปี และระบุว่าประมวลผลเสียงพูดมากกว่า 1 ล้านล้านนาทีต่อปี Voice Isolation เป็นหนึ่งในผลิตภัณฑ์ในไลน์อัพ voice AI API และ SDK ของ Krisp โดย Voice Isolation เป็นส่วนหนึ่งของ VIVA ซึ่งเป็นชุดโมเดลเรียลไทม์สำหรับ voice agents ของ Krisp ที่ประกอบด้วย Turn-Taking, Interrupt Prediction และ VAD โดยมันทำงานร่วมกับ turn-taking แทนที่จะเข้ามาแทนที่
โมเดลทั้งสี่ตัวช่วยให้คุณควบคุมความเข้มข้นในการตัดเสียงพูดและเสียงรบกวนจากพื้นหลังได้ เมื่อใช้ความเข้มข้นสูงสุด (การตั้งค่าเริ่มต้น) Default จะตัดเสียงได้มากที่สุด Balanced ประมวลผลเสียงพูดหลักด้วยความเข้มข้นที่ต่ำกว่าโดยใช้ทรัพยากรการคำนวณเท่าเดิม Lite ใช้ทรัพยากรการคำนวณประมาณหนึ่งในสามของ Default ส่วน HD ออกแบบมาสำหรับสตรีม WebRTC ที่ 32 kHz แทนที่จะเป็นเสียงโทรศัพท์ ระดับความเข้มข้นเป็นการตั้งค่าที่ปรับได้ขณะรันไทม์โดยไม่ต้องเปลี่ยนทรัพยากรการคำนวณ ใน API คือพารามิเตอร์ suppression_level ซึ่งมีค่าตั้งแต่ 0 ถึง 100
ข้อจำกัดหนึ่งที่ควรรู้ล่วงหน้าคือ โมเดลสำหรับตัดเสียงพูดออกนี้ถือว่าผู้พูดอยู่ใกล้ไมโครโฟน โดยเป็นแนวทางคร่าว ๆ ว่าเมื่อเกินระยะประมาณ 30 ซม. เสียงพูดของผู้พูดหลักเองอาจถูกตัดออกไปได้ ซึ่งไม่ใช่กฎตายตัว แต่เป็นเพียงคำแนะนำทั่วไป และระยะทางจริงขึ้นอยู่กับสภาพแวดล้อมทางเสียง สำหรับอุปกรณ์ระยะไกล (far-field) อย่างลำโพงอัจฉริยะ Krisp มีโมเดลแยกต่างหากที่ตัดเฉพาะเสียงรบกวน
เวอร์ชัน 2.5 เปิดตัวในเดือนสิงหาคม 2026 และ Krisp ได้เผยแพร่ benchmark แบบเปิดและชุดข้อมูล ในเดือนกันยายน ปัจจุบันโมเดลนี้พร้อมใช้งานทั้งในรูปแบบ API แบบบริการตนเองและ SDK
สิ่งที่เบนช์มาร์กของ Krisp บอกอะไรบ้าง
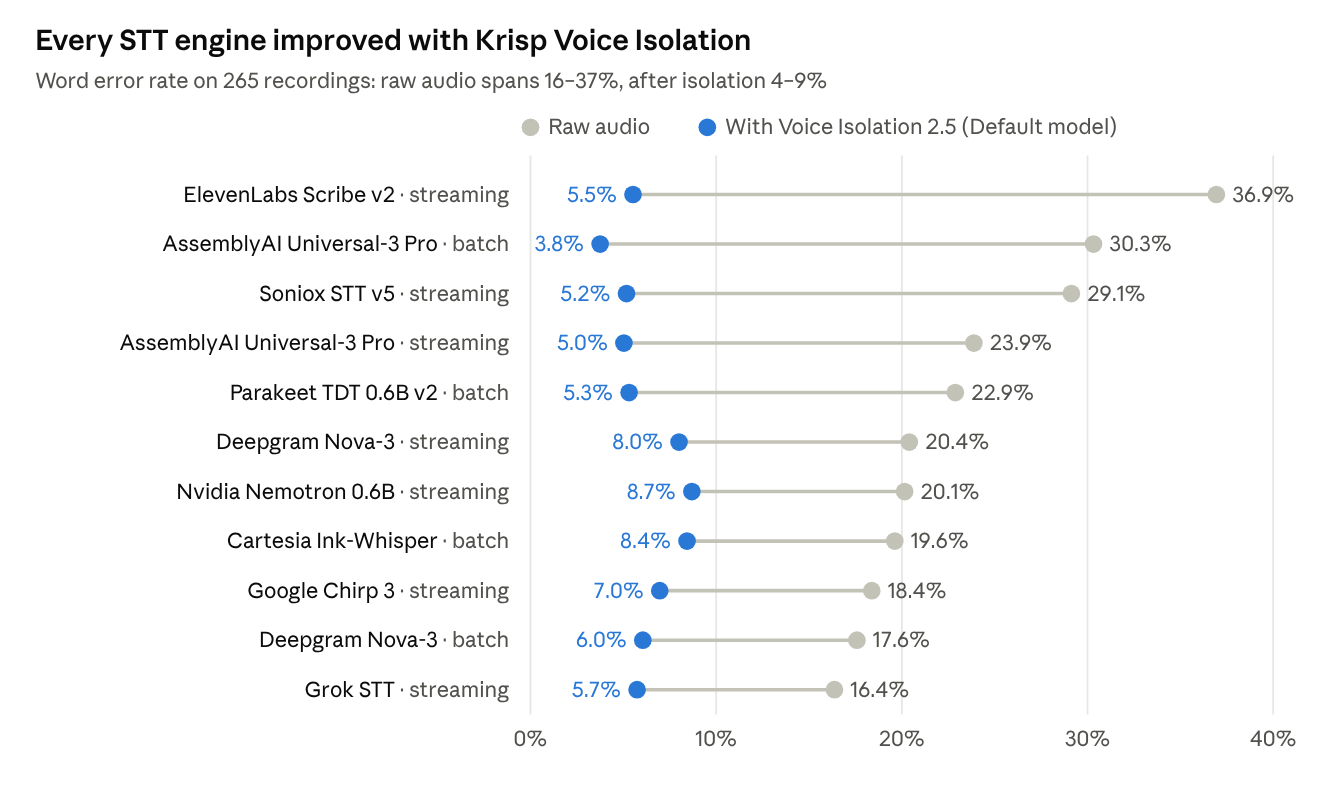
จากเบนช์มาร์กสาธารณะของ Krisp พบว่า Voice Isolation ช่วยลดอัตราการผิดพลาดของคำ (word error rate) เฉลี่ยจาก 23.24% เหลือ 6.24% หรือลดลง 73%
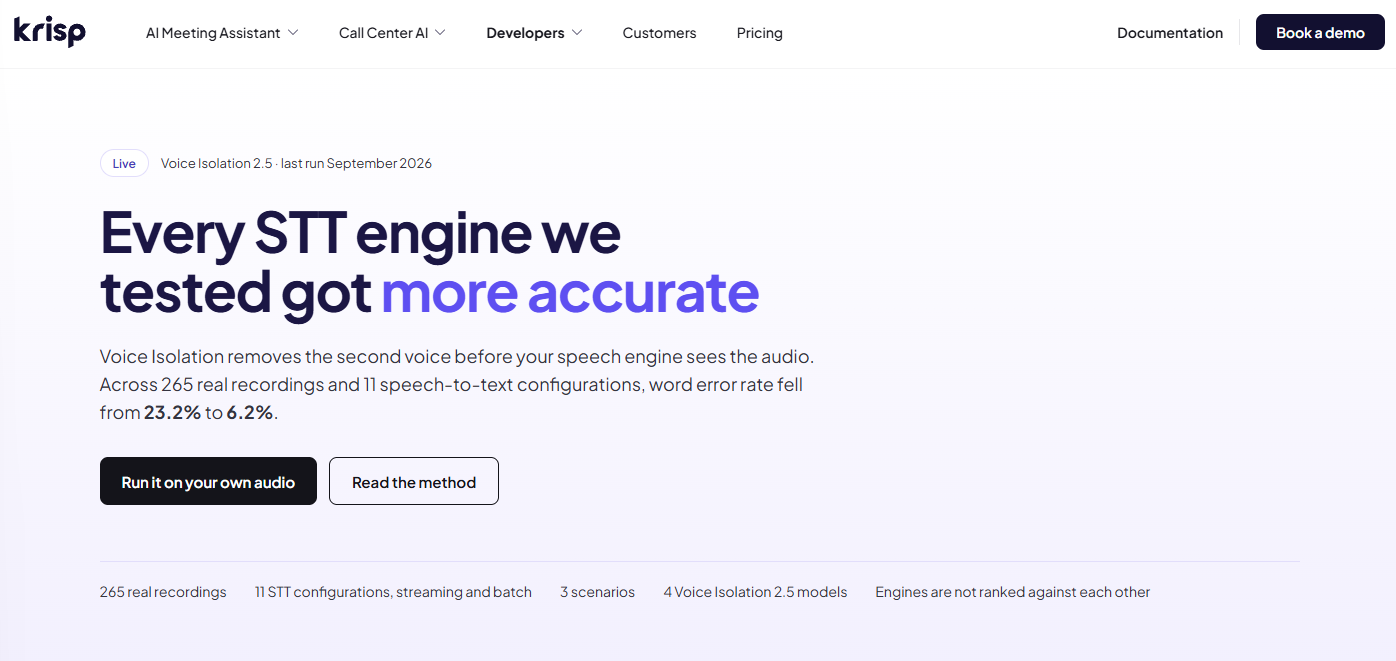
หน้า เบนช์มาร์กของ Krisp สรุปผลลัพธ์หลักไว้ดังนี้
เบนช์มาร์กนี้ใช้บันทึกเสียงจริง 265 ไฟล์ จากสถานที่ต่าง ๆ เช่น สำนักงาน บ้าน ชั้นปฏิบัติการของคอลเซ็นเตอร์ 4 ชั้น และภายในรถยนต์ โดยไม่มีการจำลองสถานการณ์หรือผสมเสียงเข้าไปภายหลัง บันทึกเสียงส่วนใหญ่ใช้บทสนทนารูปแบบเดียวกัน คือ ผู้พูดหลักจะพูด จากนั้นมีอีกคนเข้ามาสอด แล้วผู้พูดหลักเงียบไปช่วงหนึ่งขณะที่อีกฝ่ายยังพูดต่อ ก่อนที่ผู้พูดหลักจะกลับมาพูดอีกครั้ง ช่วงเงียบดังกล่าวคือจุดทดสอบที่แท้จริง เพราะคำถอดความที่ถูกต้องในช่วงนั้นคือ "ไม่มีข้อความ" แต่ละไฟล์ถูกรันผ่านการตั้งค่า STT 11 แบบจากเอนจิน 9 ตัว ทั้งแบบเปิดและไม่เปิดใช้ isolation
ที่มา: Krisp voice isolation benchmark, ต.ค. 2026 · การตั้งค่า STT 11 แบบ รวมทุกสถานการณ์
ทุกเอนจินดีขึ้นหมด และไม่มีตัวใดแย่ลง แต่ผลที่มีประโยชน์กว่าคือระยะห่างระหว่างเอนจิน: บนเสียงดิบ ช่องว่างกว้างราว 20 จุด แต่หลังใช้ isolation ช่องว่างเหลือเพียงประมาณ 5 จุด หากเอเจนต์ของคุณได้ยินเสียงพูดจากพื้นหลัง การทำความสะอาดสัญญาณเสียงนำเข้าจะช่วยปรับปรุง WER ได้มากกว่าการเปลี่ยนผู้ให้บริการ STT เสียอีก
แยกตามสถานการณ์แล้ว ผลการปรับปรุงขึ้นอยู่กับว่ามีเสียงอื่นแทรกเข้ามาหรือไม่:
จุดที่มันยังไม่ช่วย
Krisp เปิดเผยจุดอ่อนของตัวเองอย่างตรงไปตรงมา ซึ่งผมคิดว่าเป็นส่วนที่น่าเชื่อถือที่สุดของบทความนี้
- เสียงจากโทรศัพท์ที่สะอาดอยู่แล้วกลับแย่ลงเล็กน้อย เมื่อไม่มีเสียงเอ๋ออีกฝ่ายให้กำจัด การแยกเสียงจึงส่งผลต่อเสียงหลักเพียงอย่างเดียว WER ของสายโทรศัพท์เพิ่มจาก 3.48% เป็น 3.91% และมีไฟล์หนึ่งแย่จาก 9.42% เป็น 21.65% โมเดล Balanced ทำได้ดีที่สุดในกรณีนี้ที่ 3.53%
- เสียงก้องหนักยังเป็นปัญหาอยู่ ในการทดสอบ เวอร์ชัน 2.5 แยกต่างหาก ไฟล์เสียงผู้พูดคนเดียวที่มีสภาพเสียงสะท้อนยากๆ ทำคะแนนได้ 11.61% เมื่อเปิด isolation เทียบกับ 8.02% เมื่อไม่เปิด ซึ่งดีกว่าเวอร์ชัน 2.1 (15.42%) มาก แต่ยังคงแย่กว่าการไม่ทำอะไรเลย
- การแยกเสียงเกินจำเป็นทำให้เกิดข้อผิดพลาดแบบเงียบๆ Krisp อธิบายว่าโมเดลรุ่นก่อนๆ บางครั้งตัดเสียงหลักบางส่วนออกไปด้วย คนฟังยังเข้าใจเนื้อหาเสียงได้ แต่ STT ตัดทั้งวลีหลุดไป ทำให้ข้อความถอดความอ่านลื่นไปมาแต่มีช่องว่าง โมเดลเวอร์ชัน 2.5 ถูกปรับแต่งสำหรับ STT มากกว่าหูคน เพื่อแก้ปัญหานี้
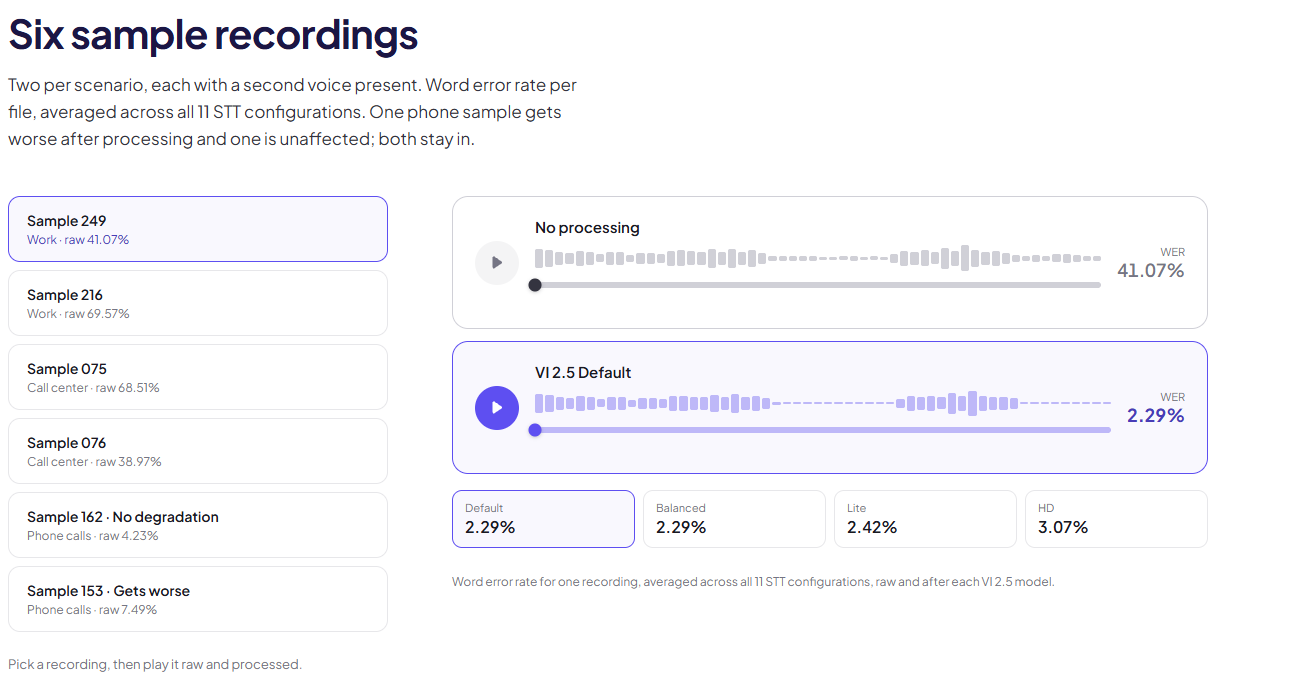
หน้าเบนช์มาร์กให้คุณเล่นไฟล์เสียงทั้งแบบต้นฉบับและแบบประมวลผลแล้วได้ 6 ไฟล์ Sample 153 ซึ่งเป็นสายโทรศัพท์ ถูกติดป้ายว่า "Gets worse"
อีกสองเรื่องที่ควรรู้ ตัวเลข 73% และ 46.4% ที่เห็นบนเว็บไซต์ของ Krisp มาจากการทดสอบที่ต่างกัน คือ 265 ไฟล์เสียงในเบนช์มาร์กสาธารณะ และ 1,685 ไฟล์เสียงในการทดสอบเวอร์ชัน 2.5 และผลลัพธ์ของ Krisp เป็นการเปรียบเทียบเสียงที่เปิดและไม่เปิด isolation ของตัวเอง ไม่ใช่เทียบกับผลิตภัณฑ์ isolation ของผู้ให้บริการรายอื่น
ไฟล์เสียง สคริปต์ถอดความที่เขียนด้วยมือ ป้ายกำกับ segment และผลลัพธ์ของทุกโมเดลถูกเปิดให้ ดาวน์โหลดสาธารณะบน Hugging Face ใครก็รันการทดสอบซ้ำได้ ซึ่งนั่นคือสิ่งที่ผมทำต่อในขั้นตอนถัดไป
ลองใช้จริง: ทดสอบ Voice Isolation API
ในการทดสอบของผม Voice Isolation ตัดคำพูดของคนอื่นในพื้นหลังออกจากชุดข้อมูลถอดเสียงได้ทั้งหมด และ WER แบบรวมลดลงจาก 40.1% เหลือ 10.2%
การเตรียมตั้งค่า
การสมัครบน Developers Portal ใช้เวลาไม่นาน สามารถล็อกอินผ่าน Google, Microsoft หรืออีเมลได้ ช่วงทดลองใช้ให้เครดิตมูลค่า $30 และจำกัดการเชื่อมต่อพร้อมกัน 2 เซสชัน จากนั้นไปที่ API Keys → Create key แล้วคุณจะได้รับคีย์ที่คัดลอกได้เพียงครั้งเดียวเท่านั้น
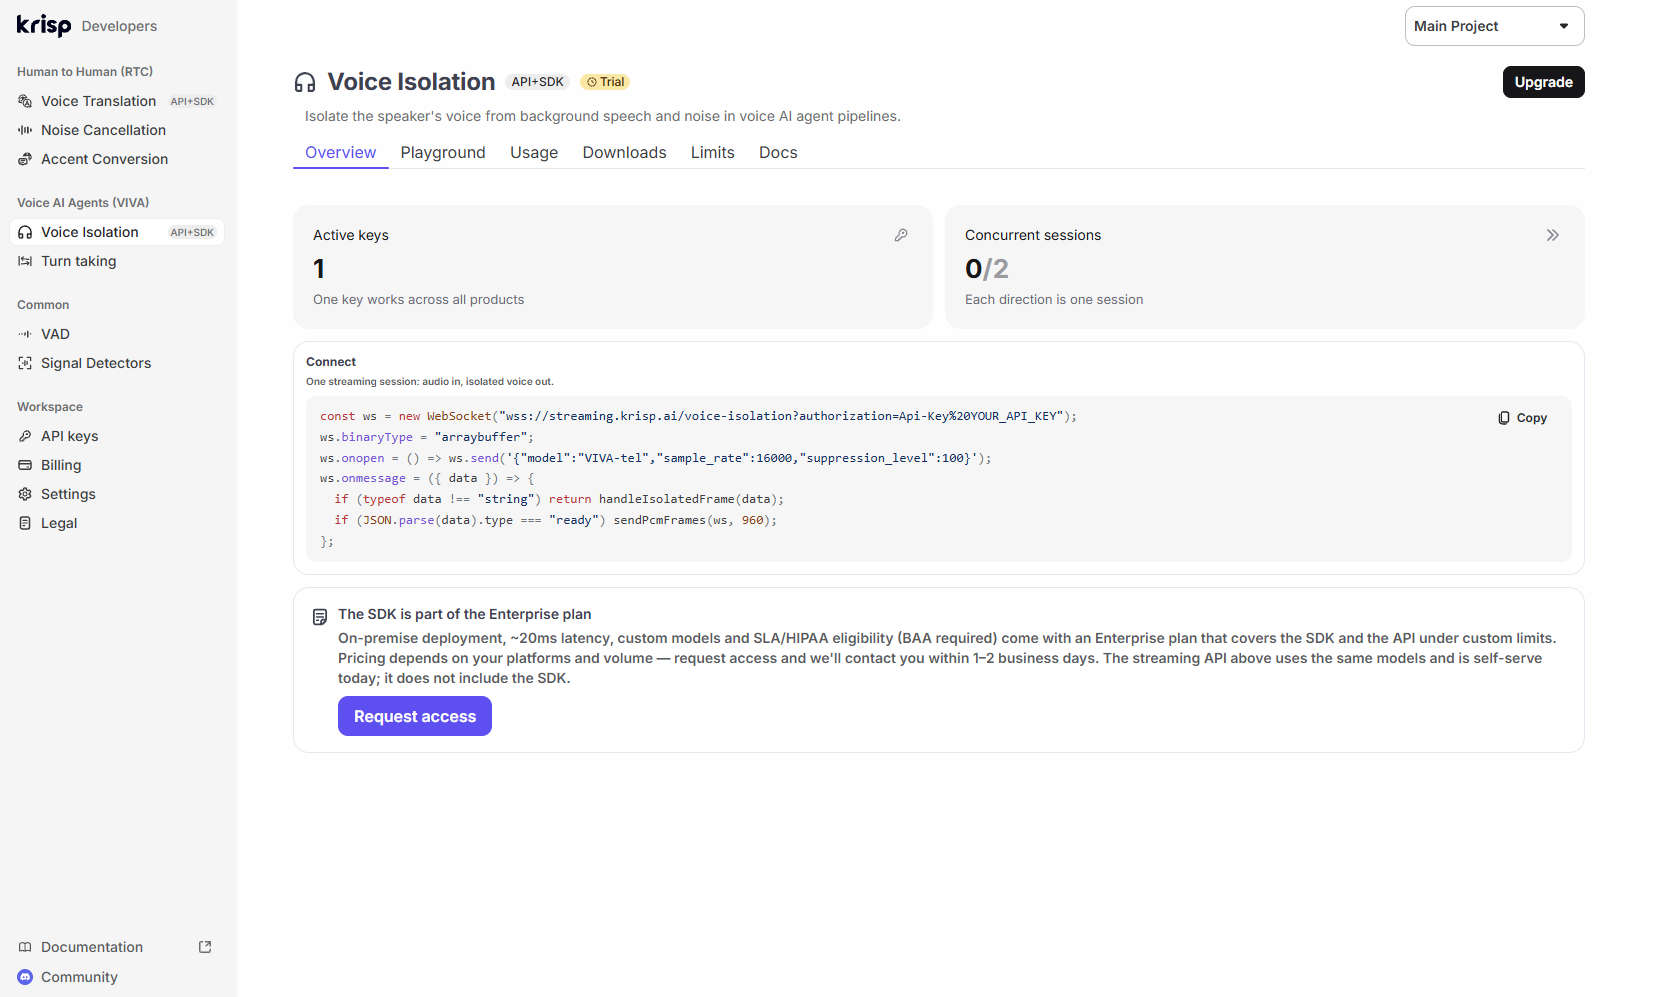
หน้า Voice Isolation ใน Developers Portal บนแพ็กเกจทดลองใช้
API key ที่ผมสร้างขึ้นสำหรับรีวิวนี้ คีย์เดียวใช้ได้กับผลิตภัณฑ์ Krisp API ทั้งหมด รวมถึง Voice Translation API ด้วย
API นี้เป็น WebSocket โดย backend ของคุณจะแลก API key เป็น session token แบบใช้ได้ชั่วคราว จากนั้น client จะส่งข้อความ JSON สั้น ๆ เพื่อทักทาย รอสถานะ ready แล้วสตรีมข้อมูลเสียงแบบ 16-bit mono PCM และรับเสียงที่ทำความสะอาดแล้วกลับมาทีละเฟรม:
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
โค้ดนี้ใกล้เคียงกับ API quickstart ของ Krisp ซึ่งเป็นสคริปต์ Python สั้น ๆ ที่ใช้ทำความสะอาดไฟล์ WAV มีกฎหนึ่งข้อที่ทำให้หลายคนติด: ข้อความเสียงทุกข้อความต้องมีความยาว 30 ms พอดี ถ้าไม่ตรงเซสชันจะจบลงด้วย error แบบ invalid_frame_duration ดังนั้นให้เติมความเงียบ (silence) ในเฟรมสุดท้ายให้เต็ม
สำหรับการทดสอบ ผมเลือกไฟล์บันทึกเสียง 8 ไฟล์จากชุดข้อมูลสาธารณะของ Krisp: ไฟล์บันทึกเสียงในออฟฟิศ 3 ไฟล์ จากพื้นที่คอลเซ็นเตอร์ 3 ไฟล์ และสายโทรศัพท์จากในรถ 2 ไฟล์ รวมประมาณ 11 นาที ผมสตรีมแต่ละไฟล์ผ่าน API ด้วยความเร็วแบบเรียลไทม์จากเอเชีย จากนั้นถอดเสียงทั้งไฟล์ดิบและไฟล์ที่ทำความสะอาดแล้วด้วย NVIDIA Parakeet TDT 0.6B v2 ซึ่งเป็นโอเพนซอร์สและเป็นหนึ่งในเอนจินที่ใช้ใน benchmark ของ Krisp แล้วให้คะแนนแต่ละช่วงที่มีป้ายกำกับเทียบกับชุดข้อมูลถอดเสียงโดยมนุษย์
ผลลัพธ์
ผลการปรับปรุงเกือบทั้งหมดมาจากที่เดียว คือช่วงที่ผู้พูดหลักเงียบและมีคนอื่นพูดต่อไปเรื่อยๆ จากเสียงดิบ Parakeet แปลงเสียงพูดจากพื้นหลังเป็นคำในข้อความถอดเสียงถึง 331 คำ แต่หลังใช้ Voice Isolation กลับไม่มีเลย เสียงพื้นหลังในช่วงนั้นเบากว่า 13 ถึง 34 dB ในขณะที่ระดับเสียงของผู้พูดหลักแทบไม่เปลี่ยนแปลง (ภายใน 1 dB)
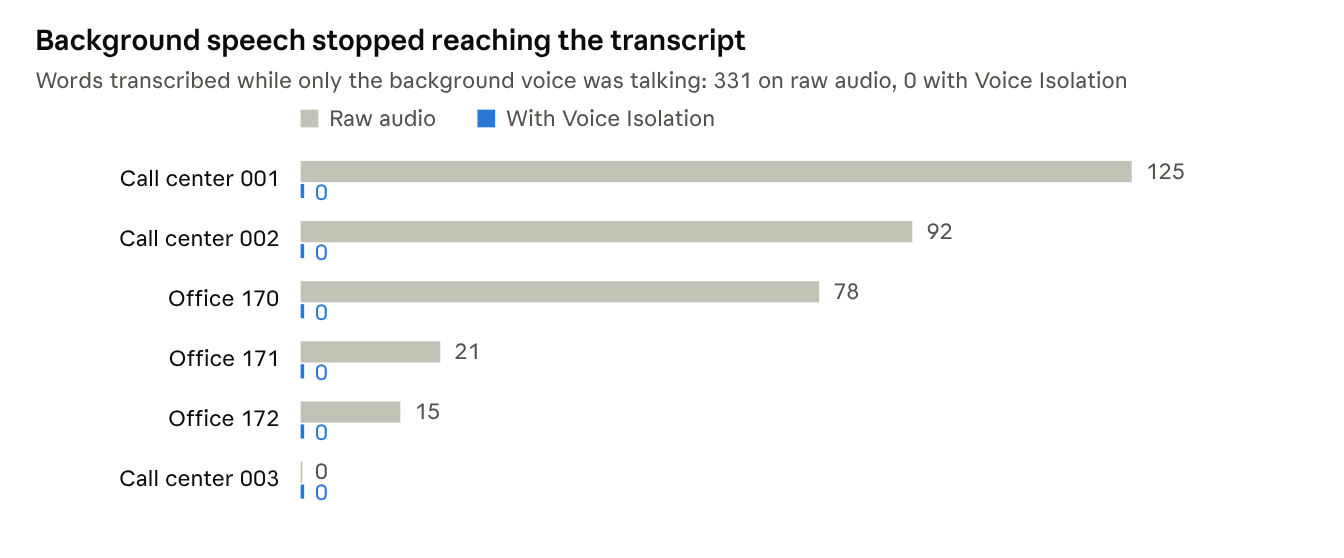
การทดสอบของฉัน · Krisp API (VIVA-tel) ถอดเสียงด้วย Parakeet TDT 0.6B v2 · ไฟล์บันทึกเสียง 6 ไฟล์ที่มีช่วงที่มีเฉพาะเสียงพื้นหลัง
ตัวอย่างคอลเซ็นเตอร์นี้ชี้ให้เห็นว่าทำไมเรื่องนี้จึงสำคัญ ในช่วงที่เจ้าหน้าที่ที่ฉันทดสอบอยู่หยุดพัก เจ้าหน้าที่โต๊ะข้างๆ กำลังคุยสายอื่นอยู่ ข้อความถอดเสียงดิบจับสายนั้นมาได้ทุกคำ ว่า:
thank you for calling meridian bank before i begin i will need to confirm your identity for security could you give me your full name your date of birth...
เอเจนต์เสียงจะเข้าใจว่านั่นคือผู้โทรกำลังพูด แต่ด้วย Voice Isolation ช่วงเดียวกันนั้นกลับมาเป็นค่าว่าง
เมื่อทั้งสองคนพูดพร้อมกัน การเปลี่ยนแปลงก็น้อยมาก: 13.2% จากเสียงดิบ เทียบกับ 12.5% จากเสียงที่ทำความสะอาดแล้ว Parakeet เลือกเสียงที่ดังและใกล้กว่าอยู่แล้วในช่วงพวกนั้น ส่วนความผิดพลาดที่เหลือส่วนใหญ่เป็นเรื่องรูปแบบการเขียนตัวเลขในการให้คะแนนของฉัน (หมายเลขโทรศัพท์ ราคา รหัสไปรษณีย์) ซึ่งกระทบทั้งสองเวอร์ชันเท่ากัน
ในสายโทรศัพท์ที่สะอาดสองสาย หนึ่งไฟล์มีความผิดพลาดเพิ่มขึ้นหนึ่งจุด และอีกไฟล์ลดลงสองจุด ซึ่งสอดคล้องกับข้อค้นพบของ Krisp เองว่าค่าใช้จ่ายบนเสียงที่สะอาดอยู่ในระดับต่ำ
ความหน่วงและความน่าเชื่อถือเมื่อใช้งานจากนอกสหรัฐฯ
ในปัจจุบัน API นี้ให้บริการเฉพาะภูมิภาคสหรัฐฯ เท่านั้น และเอกสารของ Krisp เตือนว่าลูกค้าจากที่อื่นจะเจอความหน่วงเพิ่มขึ้น จากเอเชีย เวลารอบกลาง (median round trip) ของเฟรมหนึ่งเฟรม (ส่งออกไปจนได้รับเสียงที่ทำความสะอาดแล้วกลับมา) อยู่ที่ 260–520 ms ขึ้นกับแต่ละเซสชัน และการสร้างเซสชันมักใช้เวลา 1.5–3 วินาที นั่นคือระยะทางของเครือข่าย ไม่ใช่ตัวโมเดล เพราะ Krisp ระบุความหน่วงเชิงอัลกอริทึมไว้ที่ 15 ms แต่ถ้าเอเจนต์ของคุณให้บริการผู้ใช้ที่อยู่ไกลจากสหรัฐฯ คุณจะรู้สึกถึงความหน่วงนี้ และการรัน SDK บนเซิร์ฟเวอร์ของคุณเองจะช่วยหลีกเลี่ยงปัญหานี้ได้
หนึ่งในเก้าเซสชันของฉันหลุดประมาณ 70 วินาทีหลังเริ่มใช้งานด้วยการปิดการเชื่อมต่อแบบผิดปกติ การรันซ้ำใช้ได้ปกติ ฉันมองว่าเป็นเพราะเส้นทางเครือข่ายที่ยาวจากเอเชีย มากกว่าจะเป็นตัวบริการ แต่มันก็เป็นเครื่องเตือนใจว่าต้องจัดการการเชื่อมต่อใหม่ในระบบจริงด้วย
เกี่ยวกับการทดสอบนี้: ไฟล์แปดไฟล์ถือเป็นตัวอย่างขนาดเล็ก ไม่ใช่การวัดมาตรฐาน (benchmark) ฉัน resample ไฟล์บันทึก 32 kHz เป็น 16 kHz สำหรับโมเดลโทรศัพท์ (VIVA-tel) ใช้เอนจิน STT เดียว และใช้การทำ text normalization แบบง่าย ดังนั้นตัวเลขสัมบูรณ์ของฉันจึงเทียบกับของ Krisp ไม่ได้ สิ่งที่ฉันต้องการตรวจสอบคือทิศทางและขนาดของการเปลี่ยนแปลง ซึ่งก็ตรงกับที่ Krisp รายงานไว้
ประสบการณ์ของนักพัฒนา: API หรือ SDK
Voice Isolation มีให้ใช้งานสองรูปแบบ โดยรูปแบบที่คุณสามารถใช้ได้ขึ้นอยู่กับแพ็กเกจของคุณ
API คือวิธีที่ง่ายที่สุดในการเริ่มต้น: ไม่ต้องส่งไฟล์โมเดล และไม่ต้องรันอะไรบน CPU ของคุณ ข้อแลกเปลี่ยนคือเสียงของคุณจะถูกส่งไปยังคลาวด์ของ Krisp และคุณจะได้โมเดลเพียงสองตัวแทนที่จะเป็นสี่ตัว: VIVA-tel สำหรับเสียงโทรศัพท์ 8 หรือ 16 kHz และ VIVA-pro สำหรับเสียง wideband 32 kHz ซึ่ง VIVA-pro ยังไม่ปรากฏใน API reference แต่มีอยู่ใน Playground ของพอร์ทัล ในการทดสอบของผม API ยอมรับโมเดลนี้ได้ และ Krisp ยืนยันว่าสามารถใช้งานได้แล้ว
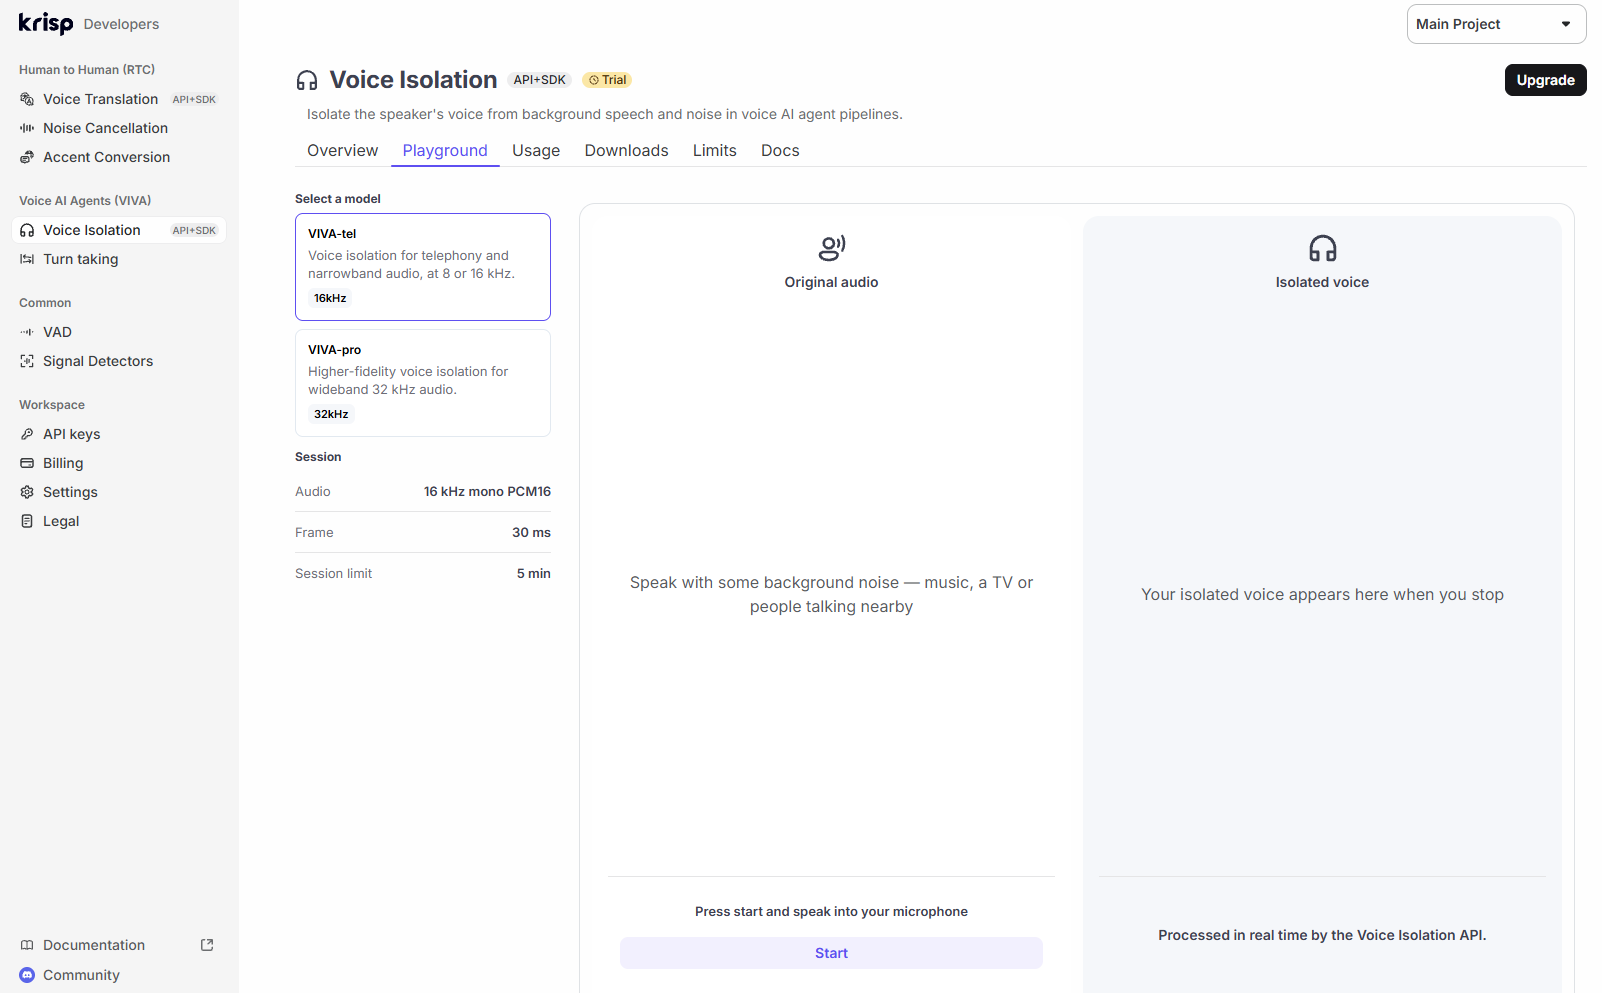
Playground ในพอร์ทัลช่วยให้คุณทดสอบโมเดล API ตัวใดก็ได้ด้วยไมโครโฟนของคุณเองก่อนที่จะเขียนโค้ดสักบรรทัด
ส่วน SDK จะเก็บเสียงไว้บนเซิร์ฟเวอร์ของคุณเอง และเชื่อมต่อออนไลน์เพียงเพื่อตรวจสอบใบอนุญาตเท่านั้น และจุดนี้เองที่ทำให้เรื่องต้นทุนน่าสนใจ บทความเรื่อง CPU ของ Krisp ชี้ให้เห็นว่าการเปิด flag เพียงตัวเดียวใน SDK คือ enableLowPrecisionExecution สามารถเพิ่มจำนวนสายเรียกที่เซิร์ฟเวอร์ประมวลผลได้บน CPU ที่รองรับ FP16 ได้ประมาณสองเท่า โดยอินสแตนซ์ AWS Graviton3 แบบ 16 vCPU เพิ่มจาก 76 สายเรียกสดเป็น 137 สาย และโมเดล Lite รองรับสตรีมได้ประมาณสามเท่าของโมเดลเต็มรูปแบบ อย่างไรก็ตาม บนชิป Intel Ice Lake รุ่นเก่า flag นี้ไม่มีผลใดๆ
การผสานรวม
- Pipecat มี filter สำเร็จรูปให้ใช้ คุณเพียงเพิ่ม KrispVivaFilter() เป็น audio input filter บน transport ของคุณ และสามารถใช้ร่วมกับ KrispVivaTurn สำหรับ turn detection ได้ ข้อควรระวังคือมันใช้ SDK ดังนั้นคุณต้องมีสิทธิ์เข้าถึง SDK และไฟล์โมเดล ไม่ใช่แค่ API key
- LiveKit มีโมเดล Krisp ให้ใช้ใน LiveKit Cloud รวมถึง background voice cancellation (noise_cancellation.BVC()) สำหรับ agent โดย LiveKit จะเก็บค่าใช้จ่ายเพิ่มสำหรับโมเดลแยกเสียงของตน
- WebRTC และ telephony pipeline สามารถใช้ SDK โดยตรงได้ และ API ใช้งานได้กับทุกอย่างที่เปิด WebSocket ได้
เอกสารประกอบเขียนชัดเจนและทันสมัย คู่มือ quickstart ใช้งานได้ตั้งแต่ครั้งแรก และข้อความแจ้งข้อผิดพลาดบอกคุณได้อย่างละเอียดว่าอะไรผิดพลาด ไปจนถึงขนาดเฟรมที่คาดหวังกับที่ได้รับ จุดที่ผมไม่พอใจมีอย่างเดียวคือการตั้งชื่อ: บล็อกพูดถึง Default, Balanced, Lite และ HD ไฟล์ดาวน์โหลดของ SDK ใช้ชื่อแบบ krisp-viva-vi-tel-v2.5.1 และ API เรียกโมเดลของตัวเองว่า VIVA-tel และ VIVA-pro โดยมีเพียงตัวแรกที่ปรากฏใน API reference ถ้ามีตารางจับคู่ชื่อในเอกสารคงจะช่วยได้มาก
ราคา
API นี้คิดค่าบริการตามชั่วโมงของเสียง และราคาถูกพอที่ต้นทุนไม่ควรเป็นตัวตัดสินว่าจะใช้งานหรือไม่
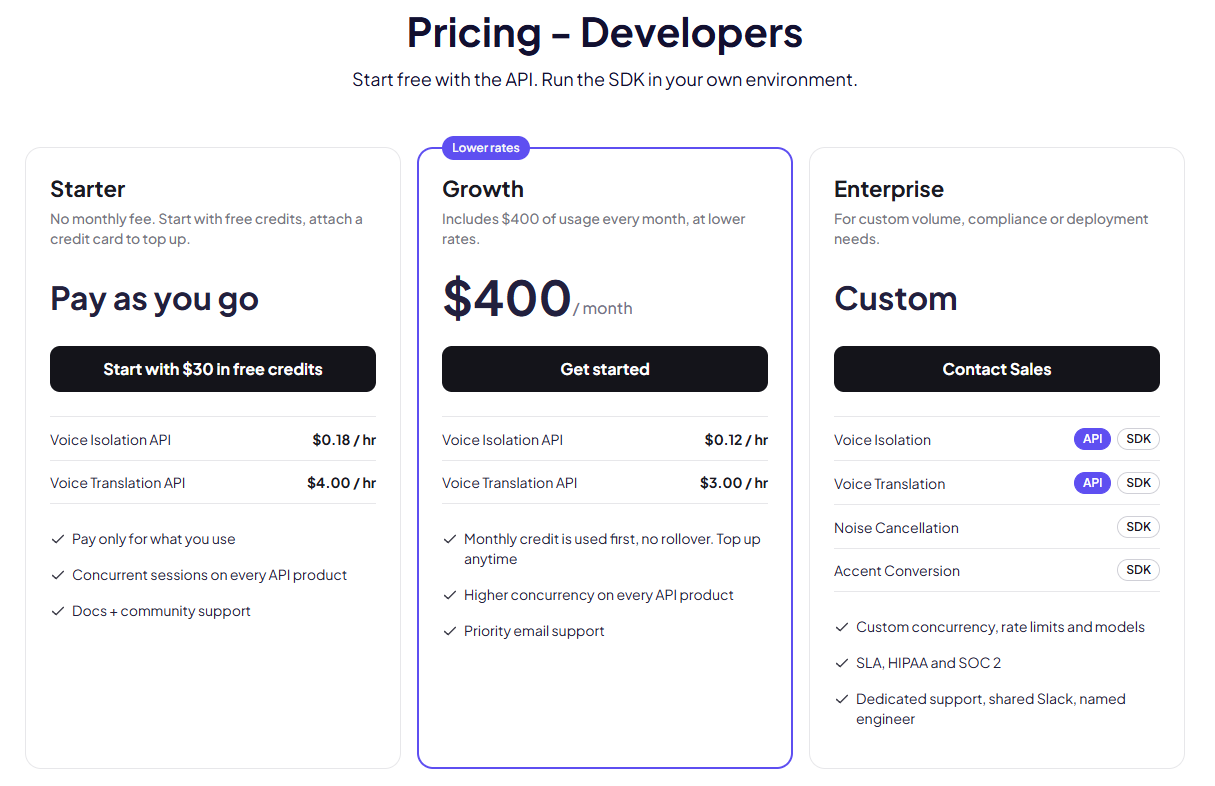
ราคาสำหรับนักพัฒนาของ Krisp, พฤศจิกายน 2026
แผน Starter แบบจ่ายตามการใช้งาน Voice Isolation API มีราคา $0.18 ต่อชั่วโมงเสียง โดยไม่มีค่ารายเดือน อัตรานี้เหมือนกันสำหรับโมเดล API ทั้งสองตัวคือ VIVA-tel และ VIVA-pro แผน Growth ราคา $400 ต่อเดือน รวมเครดิตการใช้งานมูลค่า $400 และลดอัตราเหลือ $0.12 ต่อชั่วโมง พร้อมความสามารถในการทำงานพร้อมกันที่สูงขึ้นและการสนับสนุนแบบลำดับความสำคัญ ส่วนแผน Enterprise เป็นแบบราคาที่ตกลงกันเอง และเป็นแผนเดียวที่รวม SDK, SLA และการรับรอง HIPAA และ SOC 2
เครดิตเริ่มต้น $30 ครอบคลุมการใช้งานได้ประมาณ 166 ชั่วโมงเสียงในอัตราแผน Starter ซึ่งเพียงพอสำหรับการทดสอบอย่างแน่นอน เครดิตมีอายุ 12 เดือน และคิดค่าบริการตามการใช้งานเป็นรายนาที เพื่อให้เห็นภาพ การทำความสะอาดเสียงในสายเรียก 5 นาทีใช้ต้นทุนเพียงประมาณ 1.5 เซนต์ในแผน Starter
SDK มีให้ใช้เฉพาะในแผน Enterprise ในราคาที่ตกลงกันเท่านั้น ดังนั้นหากคุณต้องการรันโมเดลเหล่านี้บนเซิร์ฟเวอร์ของคุณเอง คุณจะต้องติดต่อฝ่ายขาย อัตราราคามาจากหน้าราคาของ Krisp ซึ่งตรวจสอบเมื่อเดือนพฤศจิกายน 2026
ทางเลือกอื่น
Krisp ไม่ใช่ตัวเลือกเดียวสำหรับการกำจัดเสียงพูดจากพื้นหลัง แต่ยังไม่มีการทดสอบเปรียบเทียบผลิตภัณฑ์เหล่านี้แบบตัวต่อตัวโดยอิสระจากที่ใดแต่อย่างใด เนื่องจากแต่ละผู้ให้บริการเผยแพร่ตัวเลขของตัวเองจากข้อมูลของตัวเอง จึงควรมองตัวเลขด้านล่างนี้ในฐานะข้ออ้างสิทธิ์เท่านั้น
จุดที่ Krisp โดดเด่นคือหลักฐานเชิงประจักษ์ เป็นผู้ให้บริการรายเดียวในที่นี้ที่มี benchmark แบบเปิดเผยและทำซ้ำได้ครอบคลุม 11 รูปแบบการตั้งค่า STT และยังเผยแพร่กรณีที่ตัวเองแพ้ด้วย นอกจากนี้ยังยืดหยุ่นที่สุดในด้านการนำไปใช้งาน: ผ่าน cloud API, SDK บนเซิร์ฟเวอร์ หรือฝังมาพร้อมกับ LiveKit และ Pipecat
บทสรุป
Krisp Voice Isolation คือทางแก้ที่ควรหยิบมาใช้เมื่อ voice agent ทำงานได้ดีในช่วงทดสอบ แต่กลับมีปัญหาเมื่อรับสายจริง มันตัดเสียงพูดที่ agent ของคุณไม่ควรได้ยินออกไป ใช้งานได้กับ STT ที่คุณใช้อยู่แล้วโดยไม่ต้องเปลี่ยน และทั้งเบนช์มาร์กของ Krisp เองและการทดสอบของผมล้วนชี้ไปในทางเดียวกัน คือเสียงพูดจากพื้นหลังไม่สามารถทะลุเข้ามาใน transcript ได้อีกต่อไป
ข้อดี
- ตัดเสียงพูดจากพื้นหลัง ไม่ใช่แค่เสียงรบกวน ซึ่งเป็นปัญหาที่ STT แก้เองไม่ได้
- ใช้งานได้กับ STT engine ใดก็ได้ โดยไม่ต้องตั้งค่ารายภาษาหรือทำ voice enrollment
- รันบน CPU ได้ โดยมี algorithmic latency เพียง 15 ms
- เบนช์มาร์กเปิดเผยและทำซ้ำได้ รวมถึงกรณีที่มันทำได้แย่ด้วย
- API แบบ self-serve พร้อมเครดิตฟรี $30 และราคาถูกที่ $0.12–$0.18 ต่อชั่วโมง
- มี Pipecat filter สำเร็จรูปและรองรับ LiveKit
ข้อเสีย
- ความแม่นยำลดลงเล็กน้อยกับเสียงโทรศัพท์ที่สะอาด และยังให้ผลแย่กว่าเสียงดิบในห้องที่มีเสียงสะท้อนหนัก
- API รันในภูมิภาคสหรัฐอเมริกาเท่านั้น ทำให้ latency เพิ่มขึ้นชัดเจนในพื้นที่อื่น
- API มีโมเดลให้เลือกเพียง 2 แบบเทียบกับ 4 แบบของ SDK; การใช้งานแบบ on-premise ต้องใช้ Enterprise SDK
เหมาะกับใคร: ทีมที่ agent ของตนรับสายจากคอลเซ็นเตอร์ ออฟฟิศ บ้าน รถยนต์ หรือที่ใดก็ตามที่มีคนอื่นพูดอยู่ใกล้ๆ เริ่มจาก API เพื่อวัดผลกับไฟล์เสียงของคุณเองก่อน แล้วจึงย้ายไปใช้ SDK หากคุณต้องการโมเดลอื่น latency ที่ต่ำลงนอกสหรัฐอเมริกา หรือการที่เสียงไม่ออกจากเซิร์ฟเวอร์ของคุณ
ใครไม่จำเป็นต้องใช้: agent ที่ผู้โทรเกือบทุกครั้งอยู่คนเดียวในห้องเงียบสงบ หรืออุปกรณ์ far-field อย่าง smart speaker ซึ่งโมเดลตัดเสียงพูดไม่ได้ถูกออกแบบมาสำหรับสภาพแวดล้อมแบบนั้น
คุณสามารถ ลองใช้ Krisp Voice Isolation API ด้วยเครดิตฟรี แล้วนำไฟล์เสียงของคุณเองมาทดลองรันดูได้ภายในช่วงบ่ายเดียว
คำถามที่พบบ่อย
Voice Isolation กับ Noise Cancellation เหมือนกันหรือไม่? ไม่เหมือนกัน Noise Cancellation จะกำจัดเสียงที่ไม่ใช่เสียงพูด เช่น เสียงรถ เสียงคีย์บอร์ด ส่วน Voice Isolation จะกำจัดเสียงพูดของคนอื่นด้วย ซึ่ง Noise Cancellation จะปล่อยเสียงเหล่านั้นไว้
Krisp Voice Isolation ใช้งานร่วมกับผู้ให้บริการ STT ของฉันได้ไหม? ได้ เพราะมันประมวลผลข้อมูลเสียงด้วยตัวเอง จึงวางไว้หน้า STT engine ตัวใดก็ได้ Krisp ได้ทดสอบกับ 11 การตั้งค่า รวมถึงโมเดลของ Deepgram, AssemblyAI, ElevenLabs, Soniox, Google, Cartesia และ NVIDIA นอกจากนี้ยังวางไว้หน้าโมเดล speech-to-speech ได้อีกด้วย แม้ Krisp ยังไม่ได้เผยแพร่ผลการทดสอบสำหรับการใช้งานลักษณะนี้ แต่ก็ไม่มีอะไรห้ามคุณจากการลองใช้งาน
มันแทนที่ turn detection ได้หรือไม่? ไม่ มันทำงานอยู่ก่อนขั้นตอน VAD และ turn detection เพื่อส่งเสียงที่สะอาดกว่าให้กับขั้นตอนเหล่านั้น Krisp มี Turn-Taking เป็นโมเดลแยกต่างหากใน VIVA SDK ชุดเดียวกัน
ผู้ใช้ต้องลงทะเบียนเสียงของตนเองหรือไม่? ไม่จำเป็น ไม่ต้องมีการลงทะเบียนหรือการฝึกโมเดลด้วยเสียงของผู้ใช้แต่อย่างใด
เพิ่ม latency มากแค่ไหน? Krisp ระบุว่ามี algorithmic latency 15 มิลลิวินาที และเอกสาร SDK ระบุว่า latency ที่เพิ่มขึ้นอยู่ที่ประมาณ 20 มิลลิวินาที หากใช้ cloud API จะมีเวลาเครือข่ายไปยังรีเจียนสหรัฐฯ เพิ่มเข้ามาอีกด้วย
ใช้กับสายโทรศัพท์ได้หรือไม่? ได้ รองรับเสียงโทรศัพท์แบบ narrowband และ codec ทั่วไปอย่าง G.711, G.722, G.729 และ Opus รวมถึงชุดหูฟัง Bluetooth
แล้วการโทรแบบคนกับคนล่ะ? เทคโนโลยีเดียวกันนี้มีให้ใช้งานในชื่อ Background Voice Cancellation (BVC) ใน RTC SDK ของ Krisp ซึ่งทำงานบนอุปกรณ์ของผู้ใช้ผ่านเบราว์เซอร์ แอปเดสก์ท็อป และแอปมือถือ ศูนย์บริการลูกค้าที่ใช้พนักงานจริงสามารถใช้งานได้ผ่านผลิตภัณฑ์ call center AI ของ Krisp ซึ่งช่วยกรองเสียงพูดของพนักงานที่อยู่ใกล้เคียงออกจากสายของลูกค้า