
Moonshot AI ได้เปิดตัว Kimi K3 เมื่อวันที่ 16 กรกฎาคม 2026 และรายงานข่าวการเปิดตัวก็ชี้ว่าเป็นการท้าทาย Anthropic โดยตรง TechCrunch รายงานว่า K3 คาดว่าจะลดช่องว่างกับโมเดลแบบปิด โดยอ้างแหล่งข่าวที่กล่าวว่า K3 อาจเทียบเท่าหรือแม้กระทั่งเหนือกว่า Claude Opus 4.8 บทความนี้จะเปรียบเทียบกันในแต่ละมิติ โดยมีตัวเลขที่สามารถตรวจสอบได้และตัวเลขที่ไม่สามารถตรวจสอบได้ระบุไว้อย่างชัดเจน
สรุปสั้นๆ: K3 ชนะในด้านราคา, ขนาด Context Window และการเปิดกว้าง; Opus 4.8 ให้ความมั่นใจในฐานะผู้จำหน่ายที่จัดการอย่างเป็นผู้ใหญ่ เนื่องจากทั้งสองใช้รูปแบบ OpenAI SDK คุณสามารถส่งคำขอเดียวกันผ่านทั้งสองและเปรียบเทียบผลลัพธ์, ความหน่วง และต้นทุนในเครื่องมืออย่าง Apidog
TL;DR และบทสรุปโดยย่อ
Kimi K3 เป็นโมเดล Mixture-of-Experts ขนาด 2.8 ล้านล้านพารามิเตอร์ พร้อม Context Window ขนาด 1 ล้านโทเค็น, ราคาอินพุตที่ถูก และน้ำหนักโมเดลแบบเปิดที่จะมาถึงประมาณวันที่ 27 กรกฎาคม 2026 Claude Opus 4.8 เป็นโมเดลกรรมสิทธิ์แบบปิดในตระกูล Opus ของ Anthropic ที่มีราคาสูงกว่า พร้อมชื่อเสียงด้านการให้เหตุผลและการทำงานแบบ Agent ที่แข็งแกร่ง การให้คะแนนอิสระจาก Artificial Analysis ให้ K3 มีดัชนี Intelligence Index ที่ 57 ซึ่งจัดอยู่ในอันดับที่ 4 จาก 189 โมเดล และดีที่สุดในกลุ่มน้ำหนักโมเดลแบบเปิด
นี่คือข้อสรุปสั้นๆ:
- เลือก Kimi K3 สำหรับ Context Window ที่ใหญ่มาก, ต้นทุนต่ำที่ปริมาณมาก, หรือความสามารถในการโฮสต์เองและปรับแต่งน้ำหนักโมเดลแบบเปิด
- เลือก Claude Opus 4.8 สำหรับความสัมพันธ์กับผู้ขายที่เป็นผู้ใหญ่, การสนับสนุนและการรับประกัน SLA ที่มีการจัดการ, และประวัติผลงานการผลิตที่ยาวนานในการทำงานแบบ Agent ที่ซับซ้อน หากคุณยินดีจ่ายราคาระดับพรีเมียม
- ใกล้เคียงกันแต่ยังไม่แน่นอน ยังไม่มีตารางเปรียบเทียบ K3 กับ Opus 4.8 แบบตัวต่อตัวที่เป็นอิสระ ดังนั้นควรระมัดระวังกับพาดหัวข่าวที่ว่า "โมเดลหนึ่งชนะอีกโมเดลโดยรวม"
ข้อสังเกตเพิ่มเติมหนึ่งข้อ: โมเดลเรือธงของ Anthropic ที่เปิดให้ใช้งานทั่วไปในปัจจุบันคือ Claude Fable 5; Opus 4.8 อยู่ในระดับที่ต่ำกว่านั้น ไม่ใช่โมเดลเรือธง บล็อกเปิดตัวของ Moonshot กล่าวว่า K3 "ยังคงตามหลังโมเดลกรรมสิทธิ์ที่ทรงพลังที่สุดอย่าง Claude Fable 5 และ GPT 5.6 Sol" โดยระบุ Fable 5 และ Sol ไม่ใช่ Opus ดังนั้นเรื่องราวที่แท้จริงจึงไม่ใช่ "โมเดลเปิดโค่น Anthropic" แต่เป็น "โมเดลเปิดลดช่องว่าง ชนะในด้านราคา, Context และการเปิดกว้าง และตามหลังเฉพาะในด้านคุณภาพระดับสูงสุดเท่านั้น"
การเปิดตัว และเหตุใดจึงมีการเปรียบเทียบนี้
K3 เป็นก้าวที่ยิ่งใหญ่ที่สุดของ Moonshot ในการพัฒนาโมเดลแบบ Open-Weight และด้วยพารามิเตอร์รวม 2.8 ล้านล้านพารามิเตอร์ ทำให้เป็นโมเดล Open-Weight ที่ใหญ่ที่สุดจากจีนจนถึงปัจจุบัน สถาปัตยกรรมใช้ Kimi Delta Attention, Attention Residuals และการออกแบบที่ Moonshot เรียกว่า Stable LatentMoE ซึ่งเปิดใช้งานผู้เชี่ยวชาญ 16 จาก 896 คนต่อโทเค็น Moonshot ไม่ได้เผยแพร่จำนวนพารามิเตอร์ที่ใช้งาน ดังนั้นเราจะไม่ประเมิน ส่วนคำอธิบายหลักเกี่ยวกับ Kimi K3 คืออะไร ครอบคลุมสถาปัตยกรรมและการเข้าถึงทั้งหมด
การเปรียบเทียบนี้มีขึ้นเนื่องจากองค์กรต่างๆ ยังคงถามว่าโมเดลปิดที่มีราคาสูงคุ้มค่าหรือไม่ เมื่อโมเดลแบบ Open-Weight มีคุณภาพใกล้เคียงกันและสามารถรันบนฮาร์ดแวร์ของคุณเองได้ กรอบการเปรียบเทียบจึงกลายเป็น "K3 เทียบกับ Opus 4.8" แทนที่จะเป็น "K3 เทียบกับ Fable 5" เนื่องจาก Opus 4.8 เป็นระดับที่โมเดล Open Challenger มีโอกาสที่น่าเชื่อถือ รายงานของ TechCrunch ให้บริบทของตลาด
Kimi K3 และ Claude Opus 4.8 โดยสรุป
นี่คือการเปรียบเทียบแบบเคียงข้างกันในมิติที่ส่งผลต่อการตัดสินใจซื้อ หากตัวเลขใดไม่ได้รับการยืนยันต่อสาธารณะ ช่องนั้นจะระบุไว้
| มิติ | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| ผู้ขาย | Moonshot AI | Anthropic |
| เปิดตัว | 16 กรกฎาคม 2026 | ส่วนหนึ่งของ Claude Opus 4 line |
| ประเภทโมเดล | 2.8T-param MoE (Stable LatentMoE, เปิดใช้งานผู้เชี่ยวชาญ 16 จาก 896 คน) | กรรมสิทธิ์, ไม่เปิดเผยสถาปัตยกรรม |
| ID โมเดล / การเข้าถึง | kimi-k3, เข้ากันได้กับ OpenAI SDK |
Claude API (ตระกูล claude-opus-4-8) |
| Context Window | 1,048,576 โทเค็น (1M) | ใหญ่, แต่ต่ำกว่า Context Window 1M ของ K3 |
| ราคาอินพุต | $0.30 / ล้านโทเค็นเมื่ออยู่ในแคช, $3.00 / ล้านโทเค็นเมื่อไม่พบในแคช | $5.00 / ล้านโทเค็น |
| ราคาเอาต์พุต | $15.00 / ล้านโทเค็น | $25.00 / ล้านโทเค็น |
| ความเร็วเอาต์พุต | ~62 โทเค็น/วินาที (Artificial Analysis) | ไม่ได้อ้างอิงที่นี่; ดู Artificial Analysis |
| คะแนนอิสระ | ดัชนี Intelligence Index 57, อันดับ 4 จาก 189 (Artificial Analysis) | ระดับกรรมสิทธิ์สูงสุด (ดู Artificial Analysis) |
| น้ำหนักโมเดล | น้ำหนักแบบเปิด, ประมาณ 27 กรกฎาคม 2026 | ปิด |
| ตำแหน่งคุณภาพ | ดีที่สุดในบรรดาแบบเปิด; ตามหลัง Fable 5 และ GPT 5.6 Sol (Moonshot) | ระดับกรรมสิทธิ์ที่แข็งแกร่งรองจาก Fable 5 ของ Anthropic |
เซลล์ส่วนใหญ่ให้ K3 ได้เปรียบในด้านเศรษฐศาสตร์และการเข้าถึง คุณภาพเป็นประเด็นที่ถกเถียงกัน และเราจะเจาะลึกต่อไป
ความฉลาดและคุณภาพ: ที่ซึ่งระดับสูงสุดยังคงอยู่
คุณภาพเป็นมิติที่ยากที่สุดในการระบุให้แน่ชัด เนื่องจากยังไม่มีการเปรียบเทียบมาตรฐานที่เป็นอิสระร่วมกันระหว่าง K3 และ Opus 4.8 สัญญาณอิสระที่ชัดเจนที่สุดคือ Artificial Analysis ซึ่งดัชนี Intelligence Index ของ K3 อยู่ในระดับแนวหน้าหรือใกล้เคียงกับแนวหน้าในการประเมินด้านการให้เหตุผล การเขียนโค้ด และความรู้ และเป็นโมเดลแบบ open-weight อันดับต้นๆ ในกระดานนั้น นอกจากนี้ยังระบุว่า K3 ทำงานช้ากว่าค่าเฉลี่ยและมีผลลัพธ์ที่ยาวเหยียด
ข้อโต้แย้งมาจาก Moonshot เอง บล็อกการเปิดตัว ของพวกเขายอมรับอย่างตรงไปตรงมาว่าประสิทธิภาพโดยรวมของ K3 "ยังคงตามหลังโมเดลกรรมสิทธิ์ที่ทรงพลังที่สุดอย่าง Claude Fable 5 และ GPT 5.6 Sol" ประโยคนั้นระบุชื่อ Fable 5 และ Sol ไม่ใช่ Opus 4.8 ดังนั้น Moonshot เองก็ยอมรับว่า K3 ตามหลัง Fable 5 และ Sol และไม่ได้พูดถึง K3 ที่แพ้ Opus 4.8
ตารางเปรียบเทียบผู้ขายยืนยันสิ่งนั้น จากตัวเลขการเปิดตัวของ Moonshot ที่การตั้งค่าการให้เหตุผลสูงสุด K3 ทำคะแนนเหนือกว่า Opus 4.8 ในทุกเกณฑ์มาตรฐานที่ระบุไว้:
| เกณฑ์มาตรฐาน | Kimi K3 | Claude Opus 4.8 |
|---|---|---|
| Terminal-Bench 2.1 | 88.3 | 84.6 |
| DeepSWE | 67.5 | 59.0 |
| BrowseComp | 91.2 | 84.3 |
| Automation Bench | 30.8 | 27.2 |
| SpreadsheetBench 2 | 34.8 | 31.6 |
ตัวเลขเหล่านี้เป็นตัวเลขที่ผู้ขายดำเนินการ ไม่ใช่การเปรียบเทียบแบบตัวต่อตัวที่เป็นอิสระ: ห้องปฏิบัติการเผยแพร่ชุดข้อมูลที่ดูดี แต่เป็นตัวเลขที่ Moonshot เผยแพร่จริง และแสดงให้เห็นว่า K3 นำหน้า Opus 4.8 ในทุกด้าน รวมถึง DeepSWE ซึ่งเป็นตัววัดการเขียนโค้ดแบบ agentic ที่ยากที่สุดในชุด สำหรับมุมมองที่ระบุแหล่งที่มา โปรดดูที่บทวิเคราะห์ เกณฑ์มาตรฐานของ Kimi K3 และสำหรับโมเดลระดับแนวหน้าที่นำ K3 อย่างแท้จริง โปรดดู Kimi K3 vs GPT-5.6 Sol บทสรุปที่แท้จริง: จากตัวเลขที่เรามี K3 อย่างน้อยก็เท่ากับ Opus 4.8 และนำหน้าในชุดทดสอบของ Moonshot เอง ข้อดีที่แท้จริงของ Opus 4.8 ไม่ใช่คะแนนเกณฑ์มาตรฐาน แต่เป็นความสมบูรณ์ของเครื่องมือของ Anthropic ประวัติความน่าเชื่อถือ และการรับรองจากผู้ขายที่ได้รับการจัดการ
ราคา: ช่องว่างที่กว้างที่สุด
ต้นทุนคือจุดที่ทั้งสองแตกต่างกันมากที่สุด และตัวเลขก็ได้รับการเผยแพร่แล้ว Kimi K3 คิดราคา $0.30 ต่อล้านโทเค็นสำหรับการป้อนข้อมูลที่อยู่ในแคช, $3.00 สำหรับการป้อนข้อมูลที่ไม่พบในแคช และ $15.00 สำหรับผลลัพธ์ Claude Opus 4.8 คิดราคา $5.00 สำหรับการป้อนข้อมูล และ $25.00 สำหรับผลลัพธ์ ดังนั้น K3 จึงถูกกว่าอย่างมากสำหรับการป้อนข้อมูลที่แคชไว้ ($0.30 เทียบกับ $5.00) ยังคงถูกกว่าครึ่งราคาสำหรับการป้อนข้อมูลที่ไม่พบในแคช ($3.00 เทียบกับ $5.00) และถูกกว่า 40% สำหรับผลลัพธ์ ($15.00 เทียบกับ $25.00)
สำหรับปริมาณงานที่เน้นบริบทซ้ำๆ เช่น แชทบอทที่ส่งคำสั่งระบบและเอกสารเดิมซ้ำๆ การกำหนดราคาแบบ cache-hit ของ K3 จะช่วยประหยัดค่าใช้จ่ายได้มาก และสำหรับการสร้างผลลัพธ์ในปริมาณมาก ช่องว่างราคาเอาต์พุตเพียงอย่างเดียวก็สามารถปรับเปลี่ยนค่าใช้จ่ายรายเดือนได้ หากต้องการจำลองปริมาณการใช้งานของคุณ คู่มือ การกำหนดราคา Kimi K3 จะอธิบายระดับต่างๆ และโพสต์ การกำหนดราคา Claude Opus 4.8 ก็ทำเช่นเดียวกันในฝั่ง Anthropic
ข้อควรระวัง: ราคาต่อโทเค็นที่ถูกกว่าไม่ได้หมายถึงงานที่ถูกกว่าเสมอไป โมเดลที่พูดมากอาจลบล้างข้อได้เปรียบต่อโทเค็นบางส่วนโดยการสร้างโทเค็นมากขึ้น และ Artificial Analysis ระบุว่า K3 เป็นโมเดลที่พูดมาก ดังนั้นควรวัดต้นทุนรวมจากพร้อมท์จริง ไม่ใช่จากอัตราค่าบริการ
Context Window: พื้นที่ทำงานที่กว้างขวาง
Context เป็นชัยชนะที่ชัดเจนของ K3 บนกระดาษ Kimi K3 มี Context Window ขนาด 1,048,576 โทเค็น ซึ่งเพียงพอที่จะรองรับโค้ดเบสขนาดใหญ่มาก ชุดเอกสารยาวๆ หรือประวัติการสนทนาหลายรอบที่ยาวนานในคำขอเดียว โดยไม่ต้องแบ่งส่วนอย่างรุนแรง Claude Opus 4.8 ก็มี Context Window ขนาดใหญ่เช่นกัน แต่ต่ำกว่าขีดจำกัด 1M ของ K3
หากปริมาณงานของคุณเป็นแบบ Long-Context จริงๆ (เช่น เก็บ Repository ทั้งหมด, ชุดสัญญาความยาวเท่าหนังสือ, หรือ Corpus งานวิจัยขนาดยาวในพร้อมท์เดียว) K3 จะให้พื้นที่ทำงานที่มากกว่า ก่อนที่คุณจะต้องสร้างกลไกการดึงข้อมูล แต่ Context Window ที่ใหญ่ขึ้นเป็นความสามารถ ไม่ใช่การรับประกันคุณภาพตลอดช่วงทั้งหมด ดังนั้นควรตรวจสอบให้แน่ใจว่าคำตอบยังคงแม่นยำลึกเข้าไปในพร้อมท์ขนาดหนึ่งล้านโทเค็น ก่อนที่คุณจะพึ่งพามัน
ความเปิดกว้าง: น้ำหนักโมเดลแบบเปิดเทียบกับแบบปิด
ความเปิดกว้างเปลี่ยนแปลงสิ่งที่คุณได้รับอนุญาตให้ทำกับโมเดล และไม่มีราคาหรือเกณฑ์มาตรฐานใดจะมาแทนที่ได้ การเปิดตัวน้ำหนักโมเดลของ Kimi K3 ในช่วงประมาณวันที่ 27 กรกฎาคม 2026 เปิดโอกาสที่โมเดลปิดทำไม่ได้: การโฮสต์ด้วยตนเองเพื่อความเป็นส่วนตัวของข้อมูลหรือสภาพแวดล้อมที่แยกจากเครือข่ายภายนอก การปรับแต่งด้วยข้อมูลของคุณเอง และอิสระจากข้อจำกัดอัตราหรือแผนงานของผู้ขายรายเดียว สำหรับอุตสาหกรรมที่มีการควบคุม "น้ำหนักโมเดลที่รันบนฮาร์ดแวร์ของเรา" อาจเป็นปัจจัยตัดสินใจโดยไม่คำนึงถึงคะแนนเกณฑ์มาตรฐาน
Claude Opus 4.8 เป็นแบบปิด คุณเข้าถึงได้ผ่าน API ของ Anthropic และได้รับบริการที่มีการจัดการ: การโฮสต์ที่สม่ำเสมอ ความสัมพันธ์ด้านการสนับสนุน นโยบายที่เผยแพร่ และไม่ต้องดูแลโครงสร้างพื้นฐาน เอกสาร API ของ Anthropic ครอบคลุมตระกูลโมเดล K3 มอบการควบคุมและความรับผิดชอบให้คุณ; Opus มอบความสะดวกสบายและผู้ขายที่พึ่งพาได้ให้คุณ
ความเร็วและความหน่วง
ความเร็วมีความละเอียดอ่อนมากกว่าตัวเลขเดียว Artificial Analysis วัดความเร็วของ K3 ได้ประมาณ 62 โทเค็นต่อวินาที ซึ่งต่ำกว่าค่ามัธยฐานประมาณ 73 โทเค็นสำหรับระดับราคาเดียวกัน แม้ว่าเวลาในการสร้างโทเค็นแรกจะเร็วประมาณ 1.99 วินาทีก็ตาม ดังนั้น K3 จึงให้ความรู้สึกตอบสนองที่รวดเร็วในการเริ่มต้นการตอบกลับ แต่สร้างเนื้อหาช้า และผลลัพธ์ที่ยาวเหยียดทำให้การเติมเต็มประโยคยาวๆ รู้สึกช้าลงอีก เราไม่มีตัวเลขอิสระที่ตรงกันสำหรับ Opus 4.8 ดังนั้นควรทดสอบทั้งสองด้วยพร้อมท์ของคุณเองหากปริมาณงานสำหรับเอาต์พุตยาวๆ มีความสำคัญ
ตารางการตัดสินใจตามปริมาณงาน
แทนที่จะตัดสินว่าใครชนะ ให้จับคู่โมเดลกับงาน
| ปริมาณงาน | เหมาะสมกว่า | เหตุผล |
|---|---|---|
| งาน Long-Context มากๆ (ทั้ง Repository, ชุดเอกสารขนาดใหญ่) | Kimi K3 | Context Window 1M โทเค็นช่วยลดงาน Chunking และ Retrieval |
| การสร้างผลลัพธ์ปริมาณมากที่คำนึงถึงต้นทุน | Kimi K3 | อัตราอินพุตและเอาต์พุตต่ำกว่า, ราคา cache-hit ที่แข็งแกร่ง |
| การโฮสต์ด้วยตนเอง, การจัดเก็บข้อมูลในประเทศ, หรือ Fine-tuning | Kimi K3 | น้ำหนักโมเดลแบบเปิดประมาณ 27 กรกฎาคม 2026 |
| การให้เหตุผลที่ยากที่สุดและขีดจำกัดคุณภาพ Agentic | ทดสอบทั้งคู่ | มีการโต้แย้ง: เกณฑ์มาตรฐานการเปิดตัวของ Moonshot เองแสดงว่า K3 นำหน้า Opus 4.8 แต่เป็นการดำเนินการของผู้ขายและ Opus มีประวัติการผลิตที่ยาวนานกว่าใน Agent ที่ซับซ้อน |
| ความน่าเชื่อถือและการสนับสนุนที่สำคัญต่อภารกิจ | Claude Opus 4.8 | บริการเชิงพาณิชย์ที่มีการจัดการพร้อม SLA, การสนับสนุน และนโยบายที่เผยแพร่ |
| แอปพลิเคชันแบบโต้ตอบที่อ่อนไหวต่อความหน่วง | ทดสอบทั้งคู่ | K3 มีเวลา-ถึง-โทเค็นแรกที่รวดเร็ว แต่การสร้างผลลัพธ์ช้ากว่าและยาวเหยียดกว่า |
| โปรเจกต์ต้นแบบและโปรเจกต์เสริมที่จำกัดงบประมาณ | Kimi K3 | เส้นทางที่ถูกที่สุดสู่คุณภาพที่ใกล้เคียงระดับแนวหน้า |
K3 เป็นเจ้าของด้านเศรษฐศาสตร์, Context และการควบคุม และตามเกณฑ์มาตรฐานของ Moonshot เอง K3 ก็เทียบเท่าหรือเหนือกว่า Opus 4.8 ในด้านคุณภาพด้วย สิ่งที่ Opus 4.8 มีคือความมั่นใจในฐานะผู้ขายที่ได้รับการจัดการ ทีมส่วนใหญ่จะพบว่าปริมาณงานบางอย่างเอียงไปทางหนึ่งและบางอย่างเอียงไปทางอื่น ดังนั้นควรเก็บทั้งสองไว้ใกล้มือแทนที่จะเลือกใช้เพียงหนึ่งเดียว
กรณีการใช้งานจริง
สตาร์ทอัพที่กำลังสร้างผลิตภัณฑ์วิเคราะห์เอกสาร สัญญาที่ยาวนาน ปริมาณการสืบค้นข้อมูลสูง และกำไรต่ำ Context 1M ของ K3 และราคาที่ต่ำเข้ากันได้ดีเกือบสมบูรณ์แบบ และน้ำหนักโมเดลแบบเปิดยังให้เส้นทางการโฮสต์ด้วยตนเองหากความต้องการการจัดเก็บข้อมูลในประเทศกลายเป็นสิ่งจำเป็นในภายหลัง
องค์กรที่กำลังทำให้เวิร์กโฟลว์ของ Agent หลายขั้นตอนเป็นอัตโนมัติ ความน่าเชื่อถือมีความสำคัญและความผิดพลาดมีค่าใช้จ่ายสูง เกณฑ์มาตรฐานของ Moonshot ชี้ว่า K3 นำหน้า แต่ประวัติการผลิตที่ยาวนานกว่าของ Opus 4.8 คือสิ่งที่บางทีมยอมจ่ายราคาระดับพรีเมียมจนกว่าตัวเลขเหล่านั้นจะได้รับการยืนยัน
ธนาคารที่ได้รับการควบคุมซึ่งไม่สามารถส่งข้อมูลไปยัง Third-Party API ได้ การถกเถียงเรื่องเกณฑ์มาตรฐานเป็นเรื่องที่ไร้ประโยชน์: น้ำหนักโมเดลแบบเปิดของ K3 สามารถรันได้ในสภาพแวดล้อมของธนาคารเอง ในขณะที่ Opus 4.8 ในฐานะบริการ API แบบปิดอาจไม่สามารถใช้งานได้เลย
การทดสอบทั้งสองกับคำขอเดียวกันใน Apidog
การเปรียบเทียบบนกระดาษทำได้เพียงระดับหนึ่งเท่านั้น เนื่องจาก Kimi K3 เข้ากันได้กับ OpenAI SDK และ Claude Opus 4.8 สามารถเข้าถึงได้ผ่าน API ของตัวเอง คุณจึงสามารถตั้งค่าทั้งสองเป็นคำขอใน Apidog และส่ง Payload เดียวกันไปยังทั้งคู่ได้
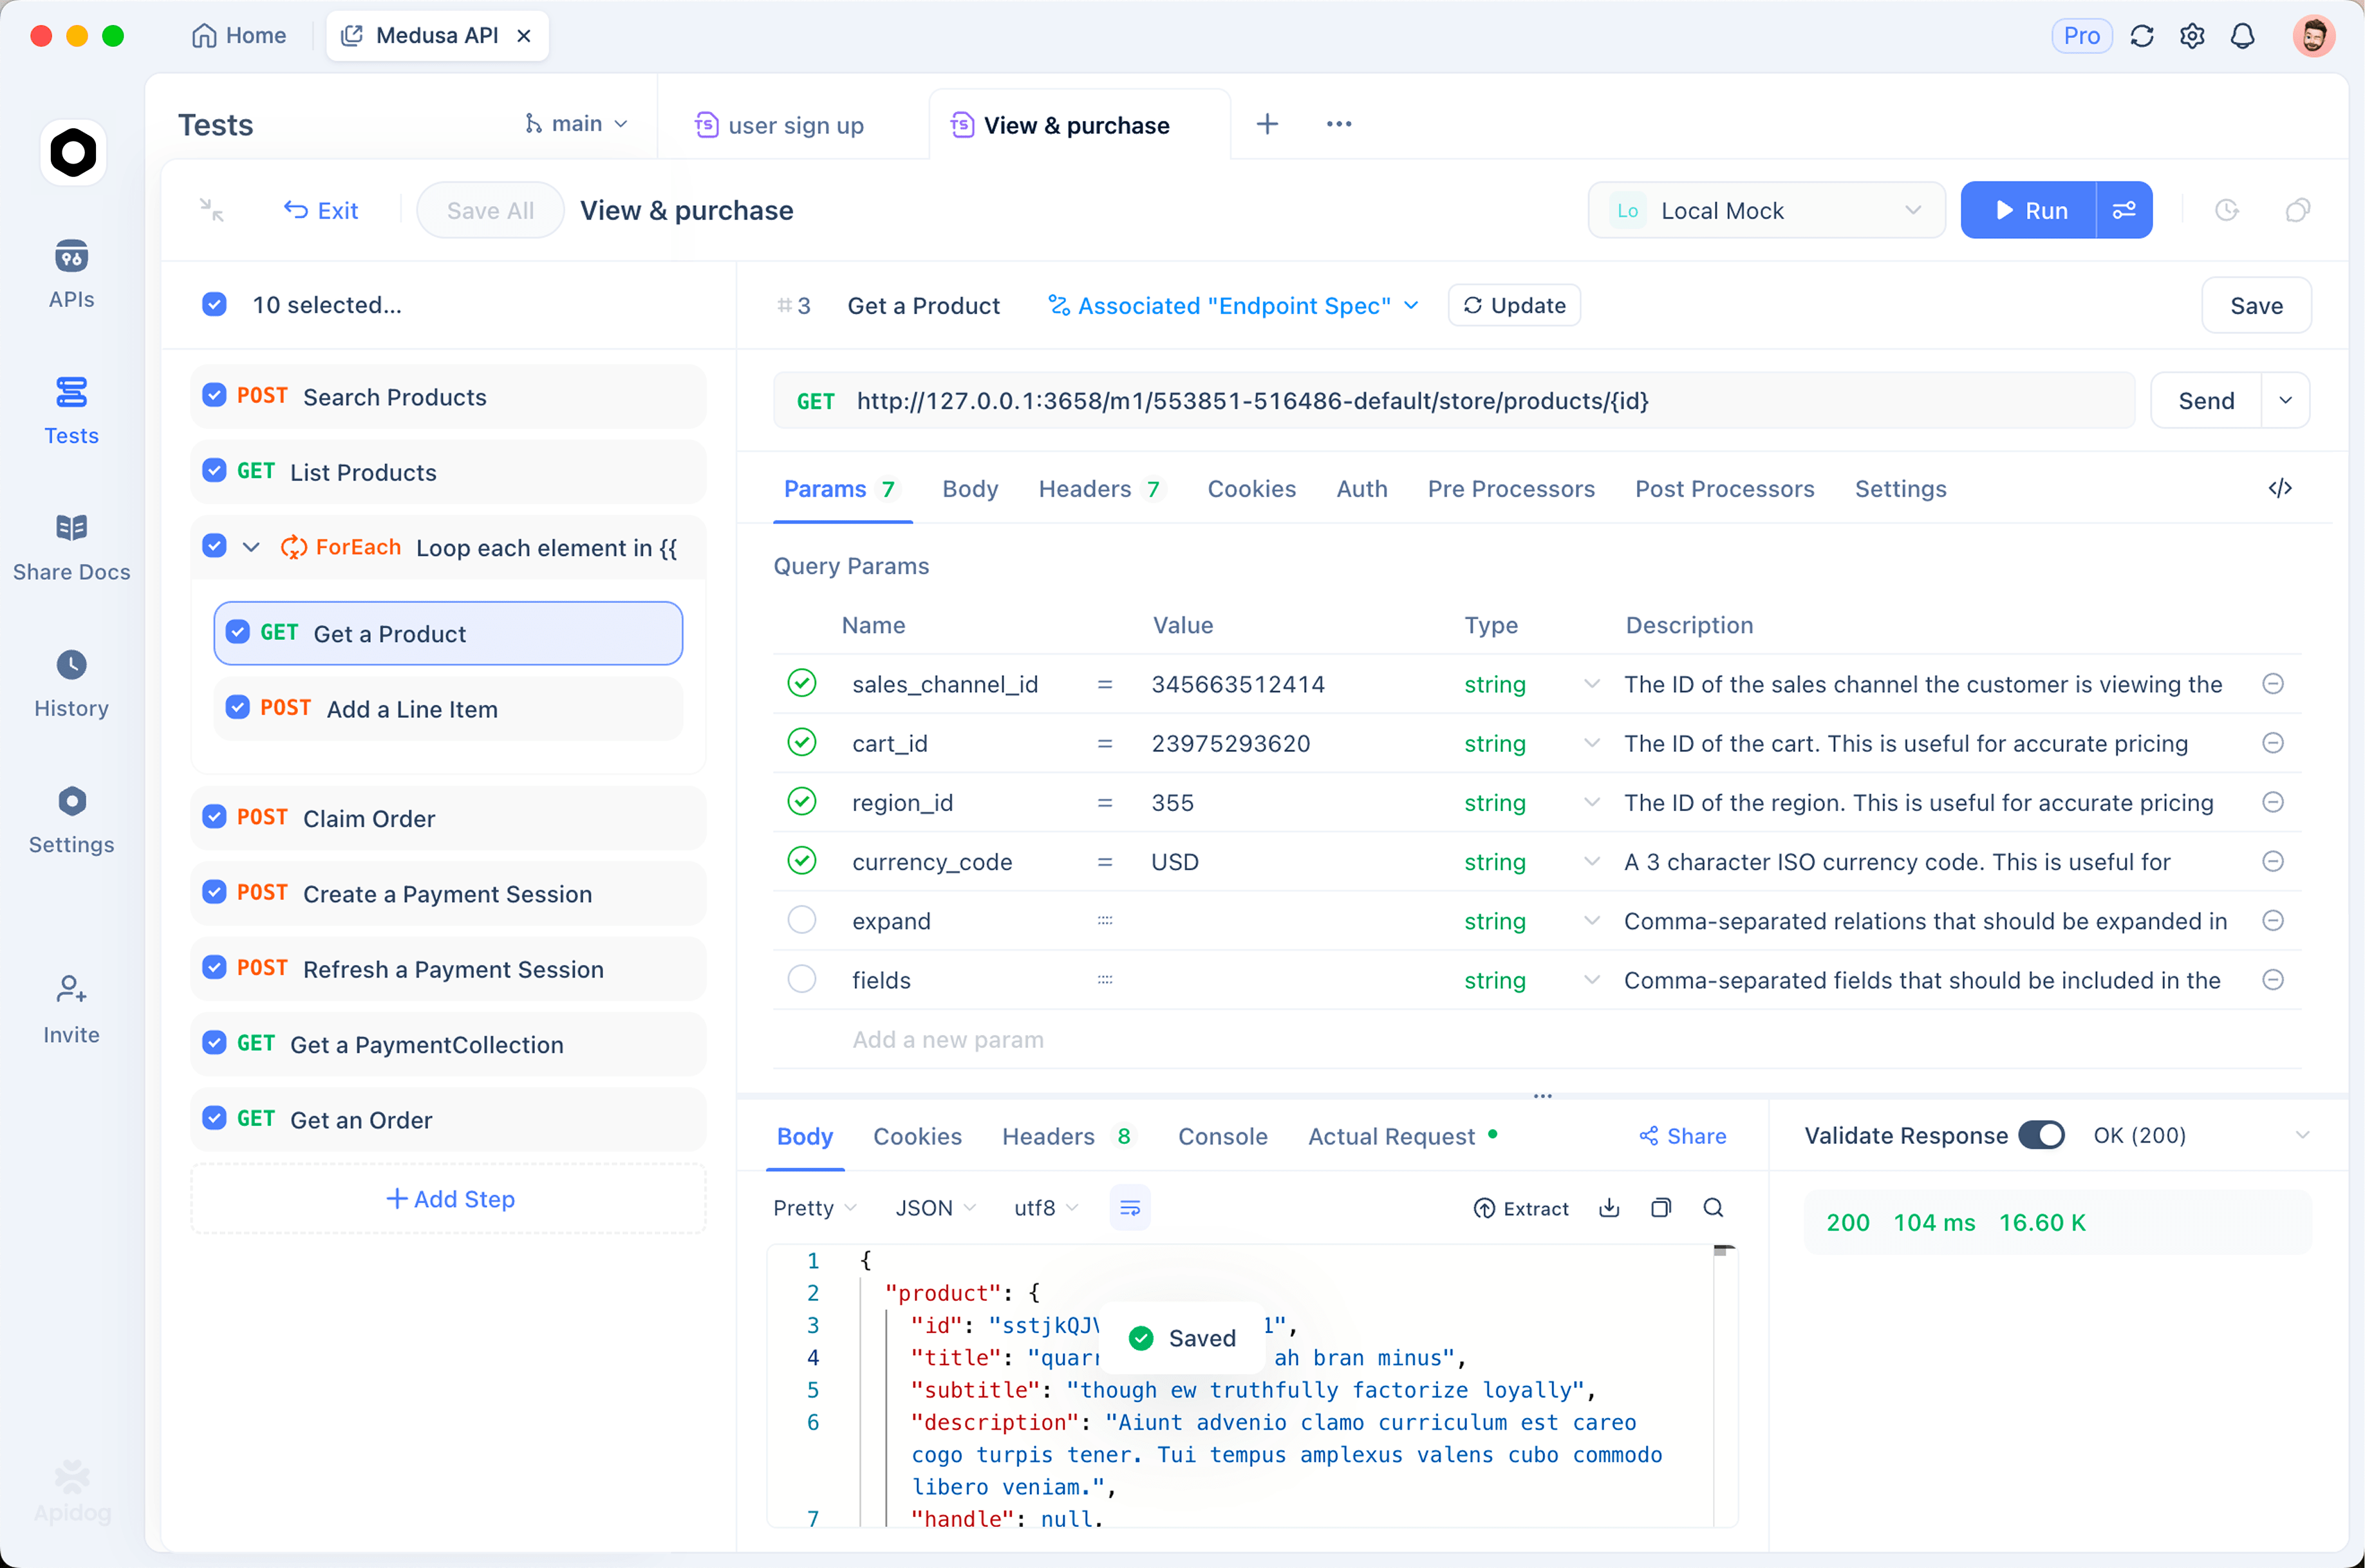
สร้างคำขอหนึ่งสำหรับ K3 endpoint และอีกหนึ่งสำหรับ Opus จัดเก็บคีย์และ Base URL ของคุณเป็น Environment Variables จากนั้นส่ง Prompt เดียวกันไปยังทั้งสอง Apidog จะแสดง Response Body, Status และ Timing สำหรับการเรียกแต่ละครั้ง เพื่อให้คุณสามารถเปรียบเทียบคุณภาพคำตอบ, ความหน่วง และค่าใช้จ่ายโทเค็นบนอินพุตที่เหมือนกัน และการบันทึกเป็น Collection จะช่วยให้คุณมีชุดทดสอบที่ทำซ้ำได้เพื่อรันซ้ำเมื่อใดก็ตามที่โมเดลใดโมเดลหนึ่งมีการอัปเดต คุณสามารถขับเคลื่อนการตรวจสอบเหล่านี้ด้วย Apidog ภายใน VS Code และแนวทางนี้ยังทำหน้าที่เป็น การทดสอบ API โดยไม่ต้องใช้ Postman ดาวน์โหลด Apidog เพื่อตั้งค่าด้วยตัวคุณเอง เป้าหมาย: แทนที่ "โมเดลไหนดีกว่าโดยทั่วไป" ด้วย "โมเดลไหนดีกว่าสำหรับพร้อมท์นี้ ด้วยต้นทุนเท่านี้ และความหน่วงเท่านี้"
สรุป
Kimi K3 ชนะ Claude Opus 4.8 อย่างเด็ดขาดในด้านราคา, Context Window และการเปิดกว้าง และจากเกณฑ์มาตรฐานการเปิดตัวของ Moonshot เอง K3 ก็ทำคะแนนเหนือกว่า Opus 4.8 ในด้านคุณภาพด้วย แม้ว่าตัวเลขเหล่านั้นจะเป็นการดำเนินการของผู้ขายและยังไม่ได้รับการยืนยันโดยอิสระก็ตาม สิ่งที่ Opus 4.8 ยังคงรักษาไว้คือด้านความมั่นใจ: ผู้ขายที่ได้รับการจัดการ, นโยบายที่เผยแพร่ และประวัติความน่าเชื่อถือที่พิสูจน์แล้วในการทำงานแบบ Agent ที่ซับซ้อน หากปริมาณงานของคุณเป็นแบบ Long-Context, คำนึงถึงต้นทุน หรือต้องการการโฮสต์ด้วยตนเอง K3 คือตัวเลือกที่ใช้งานได้จริง; หากคุณต้องการความสัมพันธ์เชิงพาณิชย์และประวัติผลงานที่พิสูจน์แล้ว Opus 4.8 ก็คุ้มค่ากับราคาพรีเมียม เนื่องจากยังไม่มีการเปรียบเทียบแบบตัวต่อตัวที่เป็นอิสระ จึงควรทดสอบทั้งสองด้วยพร้อมท์ของคุณเองก่อนตัดสินใจ
คำถามที่พบบ่อย
Kimi K3 ดีกว่า Claude Opus 4.8 หรือไม่? ใกล้เคียงกัน และจากตัวเลขที่เรามี K3 ดูเหมือนจะอย่างน้อยก็เท่ากัน มันชนะในด้านราคา, Context และการเปิดกว้าง และจากเกณฑ์มาตรฐานการเปิดตัวของ Moonshot เอง มันทำคะแนนเหนือกว่า Opus 4.8 ในทุกงานที่ระบุไว้ แม้ว่าตัวเลขเหล่านั้นจะเป็นการดำเนินการของผู้ขายและยังไม่ได้รับการยืนยันโดยอิสระก็ตาม Moonshot กล่าวว่า K3 ตามหลังโมเดลกรรมสิทธิ์ระดับท็อป แต่ระบุชื่อ Fable 5 และ GPT-5.6 Sol ไม่ใช่ Opus 4.8 ดังนั้นข้อได้เปรียบที่แท้จริงของ Opus 4.8 คือประวัติผลงานและการสนับสนุนที่มีการจัดการ ไม่ใช่การนำในเกณฑ์มาตรฐาน
Kimi K3 ถูกกว่ามากแค่ไหน? K3 คิดราคา $0.30 ต่อล้านโทเค็นสำหรับอินพุตที่อยู่ในแคช, $3.00 สำหรับอินพุตที่ไม่พบในแคช และ $15.00 สำหรับเอาต์พุต Opus 4.8 คิดราคา $5.00 สำหรับอินพุต และ $25.00 สำหรับเอาต์พุต ดังนั้น K3 จึงถูกกว่ามากสำหรับอินพุตที่แคชไว้, ถูกกว่าครึ่งราคาสำหรับอินพุตที่ไม่พบในแคช และถูกกว่าประมาณ 40% สำหรับเอาต์พุต การประหยัดจริงขึ้นอยู่กับว่าอินพุตของคุณสามารถแคชได้มากแค่ไหน
มีการเปรียบเทียบอิสระที่เปรียบเทียบ Kimi K3 และ Opus 4.8 โดยตรงหรือไม่? ยังไม่มี Artificial Analysis ให้คะแนน Intelligence Index ที่เป็นอิสระสำหรับโมเดลแต่ละตัว และ Moonshot เผยแพร่ตัวเลขเกณฑ์มาตรฐานของตัวเอง แต่ไม่มีตารางเปรียบเทียบ K3 กับ Opus 4.8 แบบตัวต่อตัวที่เป็นอิสระ ควรพิจารณาชัยชนะที่ผู้ขายรายงาน รวมถึงตัวเลข "อันดับหนึ่งในสี่จากแปดเกณฑ์มาตรฐานการทำงานอัตโนมัติ" ว่าเป็นการรายงานตนเองจนกว่าจะได้รับการยืนยันโดยอิสระ
Kimi K3 เป็นคู่แข่งของ Opus 4.8 หรือ Claude Fable 5? K3 แข่งขันทั่วทั้งตลาด การรายงานข่าวการเปิดตัวจัดให้ K3 แข่งกับ Opus 4.8 เพราะนั่นคือระดับที่โมเดล Open Challenger สามารถไปถึงได้อย่างสมเหตุสมผล โมเดลเรือธงปัจจุบันของ Anthropic คือ Claude Fable 5 ซึ่ง Moonshot ยอมรับว่า K3 ยังคงตามหลังอยู่ ดังนั้น K3 จึงควรทำความเข้าใจว่าเป็นการไล่ตามโมเดลกรรมสิทธิ์มากกว่าการเป็นอันดับหนึ่ง