
Kimi K2.7 Code ของ Moonshot ได้ถูกนำมาเปรียบเทียบกับโมเดลสองตัวที่นักพัฒนาส่วนใหญ่ใช้จริงและต้องจ่ายเงิน: Claude Opus และ GPT-5.5 สรุปสั้นๆ คือ โมเดลปิดยังคงได้คะแนนสูงกว่าในงานเขียนโค้ดส่วนใหญ่ แต่ส่วนต่างไม่ได้มากเท่าที่ราคาของมันบอกใบ้ Kimi เป็นโมเดลแบบ open-weight ที่คุณสามารถดาวน์โหลดและโฮสต์เองได้ และมีคะแนนใกล้เคียงกับโมเดลที่คุณต้องเช่าใช้เพียงไม่กี่คะแนน
การเปรียบเทียบนี้จะนำตัวเลขมาแสดงควบคู่กัน ชั่งน้ำหนักกับต้นทุนและการเปิดเผย และบอกคุณว่าควรเลือกตัวไหนสำหรับงานประเภทใด
สรุปโดยย่อ
- คุณภาพการเขียนโค้ดดิบ: GPT-5.5 และ Claude Opus นำหน้าในชุดทดสอบส่วนใหญ่ Kimi K2.7 Code ตามหลังอยู่ไม่กี่คะแนน
- ต้นทุน: Kimi ราคาถูกกว่ามาก ($0.95/$4.00 ต่อล้านโทเค็น) และสามารถโฮสต์เองได้ฟรี โมเดลปิดมีราคาแพงกว่าและไม่สามารถโฮสต์บนฮาร์ดแวร์ของคุณเองได้
- การเปิดเผย: Kimi มาพร้อมน้ำหนักโมเดลแบบเปิด (open weights) ภายใต้ใบอนุญาต MIT ที่ปรับปรุงแล้ว Opus และ GPT-5.5 เป็นแบบปิด
- ข้อสรุป: เลือกโมเดลที่ทันสมัยที่สุดสำหรับคุณภาพสูงสุดในการทำงานครั้งเดียว; เลือก Kimi เมื่อต้นทุน ปริมาณ หรือการควบคุมข้อมูลมีความสำคัญมากกว่าคะแนนไม่กี่แต้มสุดท้าย
ผู้เข้าแข่งขันโดยสรุป
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| ประเภท | Open weight (MIT ที่ปรับปรุง) | ปิด | ปิด |
| สถาปัตยกรรม | MoE, 1T ทั้งหมด / 32B ที่ใช้งาน | ไม่เปิดเผย | ไม่เปิดเผย |
| หน้าต่างบริบท | 256K โทเค็น | ขนาดใหญ่ | ขนาดใหญ่ |
| โฮสต์เอง | ได้ | ไม่ | ไม่ |
| ราคา (ต่อล้านโทเค็น) | $0.95 ขาเข้า / $4.00 ขาออก | สูงกว่า, เช่าเท่านั้น | สูงกว่า, เช่าเท่านั้น |
ความแตกต่างเชิงโครงสร้างคือประเด็นสำคัญ Kimi บอกคุณได้อย่างชัดเจนว่าคืออะไรและให้คุณรันมันได้เอง ส่วนอีกสองโมเดลเป็นบริการที่คุณต้องเรียกใช้งาน
เกณฑ์มาตรฐานการเขียนโค้ด
นี่คือคะแนนที่ Moonshot รายงานไว้ ถือว่าเป็นการนำเสนอของทางผู้ขาย เนื่องจากชุดทดสอบหลายชุดเป็นของ Moonshot เอง แต่รูปแบบโดยรวมมีความสอดคล้องกันและควรค่าแก่การอ่าน
| เกณฑ์มาตรฐาน | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5 เป็นอันดับหนึ่งในสองรายการแรก; Claude Opus นำใน MLS Bench Lite และทำคะแนนได้ใกล้เคียงในทุกรายการ Kimi อยู่ต่ำกว่าเล็กน้อยในแต่ละรายการ ช่องว่างมีอยู่จริงแต่เล็กน้อยใน Kimi Code Bench v2 และกว้างกว่าใน Program Bench หากงานของคุณเป็นไปตามเกณฑ์มาตรฐานที่สอง โมเดลที่ล้ำสมัยก็จะคุ้มค่า
เกณฑ์มาตรฐาน Agentic และการใช้เครื่องมือ
เอเจนต์เขียนโค้ดจะอยู่รอดหรือไม่ขึ้นอยู่กับการเรียกใช้เครื่องมือ ไม่ใช่แค่การสร้างโค้ดเท่านั้น ในจุดนี้ภาพรวมจะเข้มข้นขึ้น
| เกณฑ์มาตรฐาน | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
ใน MCP Mark Verified, Kimi เอาชนะ Claude Opus ได้เล็กน้อย แม้ว่า GPT-5.5 จะนำไปค่อนข้างมากก็ตาม ใน MCP Atlas ทั้งสามโมเดลมีคะแนนห่างกันประมาณห้าจุด สำหรับงานที่เกี่ยวข้องกับเอเจนต์ Kimi มีคะแนนใกล้เคียงกับกลุ่มโมเดลอื่น ๆ มากกว่าที่คะแนนการเขียนโค้ดดิบแสดงให้เห็น ซึ่งเป็นสิ่งสำคัญเพราะเป็นจุดที่ค่าใช้จ่ายโทเค็นสะสม
ต้นทุนคือจุดที่ Kimi ชนะ
เกณฑ์มาตรฐานวัดคุณภาพ แต่ไม่ได้วัดค่าใช้จ่าย Kimi K2.7 Code มีค่าใช้จ่าย $0.95 ต่อล้านโทเค็นขาเข้า และ $4.00 ต่อล้านโทเค็นขาออก โดยมีค่าใช้จ่ายสำหรับการใช้ข้อมูลที่แคชไว้ที่ $0.19 ต่อล้าน โทเค็น โมเดลปิดที่ทันสมัยกว่ามีค่าใช้จ่ายต่อโทเค็นสูงกว่าอย่างมาก และคุณไม่สามารถหลีกเลี่ยงได้ด้วยการโฮสต์เอง; ไม่มีให้ดาวน์โหลด
สองปัจจัยที่ช่วยเพิ่มการประหยัด:
- น้ำหนักโมเดลแบบเปิดหมายถึงตัวเลือกแบบศูนย์โทเค็น. โฮสต์เองบนฮาร์ดแวร์ของคุณ และค่าใช้จ่ายต่อโทเค็นจะหายไปทั้งหมด คุณแลกเปลี่ยนมันกับเวลาการใช้ GPU
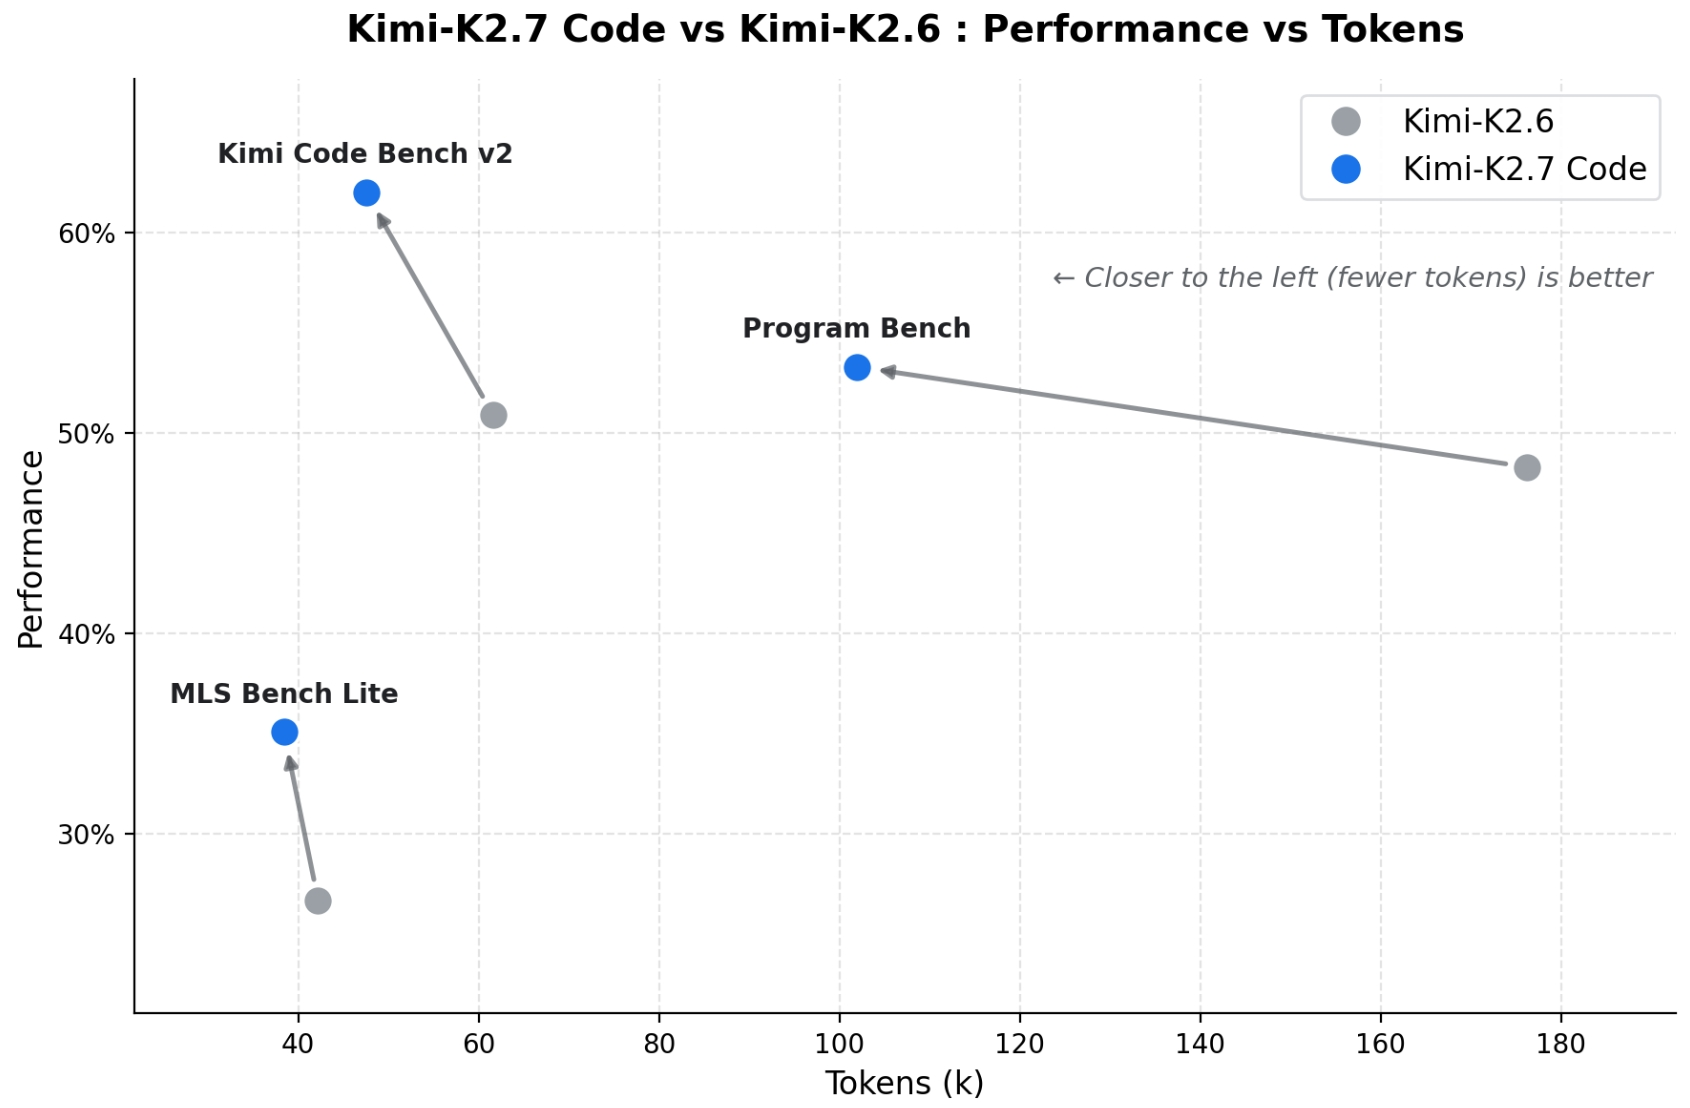
- การให้เหตุผลที่ประหยัด. K2.7 Code ใช้โทเค็นสำหรับการคิดน้อยกว่า K2.6 ประมาณ 30% สำหรับงานเดียวกัน ดังนั้นแต่ละขั้นตอนของเอเจนต์จึงมีค่าใช้จ่ายน้อยลง คำแนะนำของเราเกี่ยวกับ การลดค่าใช้จ่ายโทเค็นของเอเจนต์ จะเจาะลึกถึงสาเหตุที่สิ่งนี้มีความสำคัญ
สำหรับเอเจนต์ที่เรียกใช้เครื่องมือหลายร้อยครั้งต่องาน โมเดลที่มีคุณภาพดีถึง 90% แต่มีราคาเพียงเสี้ยวเดียว มักจะชนะในเรื่องของมูลค่ารวม
บริบทและการเปิดเผย
ทั้งสามโมเดลจัดการบริบทที่ยาวได้ดี; หน้าต่างบริบทของ Kimi คือ 256K โทเค็น ซึ่งเพียงพอสำหรับบริการเต็มรูปแบบรวมถึงการทดสอบในหนึ่งพรอมต์ ความแตกต่างที่สำคัญกว่าคือใบอนุญาต น้ำหนักโมเดล MIT ที่ได้รับการปรับปรุงของ Kimi ช่วยให้คุณสามารถ fine-tune, ตรวจสอบ และรันโมเดลแบบ air-gapped ได้ สำหรับทีมที่มีข้อกำหนดด้านการปฏิบัติตามกฎระเบียบหรือการจัดเก็บข้อมูลในพื้นที่ นี่ไม่ใช่แค่เรื่องที่ดีที่จะมี; แต่มันคือปัจจัยตัดสิน และโมเดลแบบปิดก็ไม่สามารถนำมาพิจารณาได้เลย
ควรเลือกใช้เมื่อใด
เลือก GPT-5.5 หรือ Claude Opus หาก:
- คุณต้องการคุณภาพการเขียนโค้ดสูงสุดในการทำงานครั้งเดียว และคะแนนเกณฑ์มาตรฐานเพียงไม่กี่แต้มนั้นคุ้มค่ากับราคา
- คุณพอใจกับการเช่าบริการแบบปิดที่มี SLA (Service Level Agreement) ที่มีการจัดการ
- งานที่ยากที่สุดของคุณมีลักษณะคล้ายกับ Program Bench ซึ่งเป็นจุดที่ช่องว่างกว้างที่สุด
เลือก Kimi K2.7 Code หาก:
- คุณใช้งานเอเจนต์ปริมาณมากที่ค่าใช้จ่ายโทเค็นเป็นตัวตัดสินความเป็นไปได้
- ข้อมูลต้องอยู่บนโครงสร้างพื้นฐานของคุณเอง
- คุณต้องการ fine-tune หรือตรวจสอบโมเดล
- คุณกำลังเพิ่มประสิทธิภาพของมูลค่ารวม ไม่ใช่แค่การเป็นอันดับหนึ่ง
สำหรับการเปรียบเทียบที่กว้างขึ้น การเปรียบเทียบ MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 ของเราครอบคลุมคู่แข่ง open-weight อื่นๆ และ DeepSeek V4 vs Claude Opus สำหรับการเขียนโค้ด เจาะลึกการเปรียบเทียบระหว่างโมเดลเปิดและปิดอีกครั้ง หากคุณกำลังเปรียบเทียบเอเจนต์แทนที่จะเป็นโมเดล โปรดดู Claude Code vs OpenAI Codex
ทดลองเปรียบเทียบด้วยตัวคุณเอง
เกณฑ์มาตรฐานเป็นเพียงจุดเริ่มต้น ไม่ใช่ข้อสรุปสำหรับโค้ดเบสของคุณ การทดสอบที่เที่ยงตรงคือการรันทั้งสามโมเดลกับงานของคุณเองและอ่านผลลัพธ์ Kimi Code CLI ให้เอเจนต์ฟรีแก่คุณเพื่อเริ่มต้น และคุณสามารถเรียกใช้ API ของแต่ละโมเดลโดยตรงเพื่อเปรียบเทียบผลลัพธ์ดิบได้
เมื่อคุณดำเนินการ ให้ทดสอบปลายทางใน Apidog: ส่งพรอมต์เดียวกันไปยังแต่ละโมเดล, บันทึกการเรียกใช้งานแบบเคียงข้างกัน, และเปรียบเทียบคุณภาพการตอบสนอง, ความหน่วง, และการใช้โทเค็นในที่เดียว ดาวน์โหลด Apidog เพื่อทำการทดสอบเปรียบเทียบ
คำถามที่พบบ่อย
- Kimi K2.7 Code ดีกว่า Claude Opus หรือ GPT-5.5 หรือไม่? จากเกณฑ์มาตรฐานการเขียนโค้ดที่ Moonshot รายงาน ไม่; โมเดลปิดได้คะแนนสูงกว่าในชุดทดสอบส่วนใหญ่ ข้อได้เปรียบของ Kimi คือน้ำหนักโมเดลแบบเปิดและต้นทุนที่ต่ำกว่ามาก ในขณะที่ยังคงทำคะแนนได้ใกล้เคียงกัน
- Kimi ราคาถูกกว่าเท่าไหร่? มีค่าใช้จ่าย $0.95 ต่อล้านโทเค็นขาเข้า และ $4.00 ต่อล้านโทเค็นขาออก และสามารถโฮสต์เองได้ฟรี โมเดลปิดที่ล้ำสมัยมีค่าใช้จ่ายต่อโทเค็นสูงกว่าและไม่สามารถโฮสต์เองได้
- ฉันสามารถรัน Kimi K2.7 Code ได้ด้วยตัวเองหรือไม่? ได้ น้ำหนักโมเดลเป็นแบบเปิดภายใต้ใบอนุญาต MIT ที่ปรับปรุงแล้ว; สามารถรันได้ด้วย vLLM, SGLang หรือ KTransformers
- ตัวไหนดีที่สุดสำหรับเอเจนต์เขียนโค้ด? สำหรับคุณภาพดิบ GPT-5.5 นำหน้า สำหรับเอเจนต์ปริมาณมากที่เน้นประสิทธิภาพด้านต้นทุน Kimi ให้คุณค่าที่ดีกว่า และมีคะแนนใกล้เคียงกันในเกณฑ์มาตรฐาน Agentic
- เกณฑ์มาตรฐานเหล่านี้เป็นกลางหรือไม่? ชุดทดสอบหลายชุดเป็นของ Moonshot เอง ดังนั้นควรอ่านโดยถือว่าเป็นการนำเสนอของทางผู้ขาย ช่องว่างที่สอดคล้องกันกับโมเดลที่ทันสมัยกว่าคือสัญญาณที่มีประโยชน์ ไม่ใช่ตัวเลขที่แน่นอน
สรุป
Kimi K2.7 Code ไม่ได้เอาชนะ Claude Opus หรือ GPT-5.5 ในเกณฑ์มาตรฐานการเขียนโค้ดส่วนใหญ่ และ Moonshot ก็ไม่ได้อ้างเช่นนั้น มันทำคะแนนได้ต่ำกว่าเล็กน้อย แต่มีค่าใช้จ่ายน้อยกว่ามากและมาพร้อมกับน้ำหนักโมเดลแบบเปิดที่คุณสามารถรันได้เอง สำหรับคุณภาพสูงสุดเท่าที่จะเป็นไปได้ โมเดลปิดที่ทันสมัยกว่ายังคงเป็นผู้ชนะ สำหรับเอเจนต์ปริมาณมาก การติดตั้งแบบส่วนตัว หรือใครก็ตามที่พิจารณามูลค่ารวมมากกว่าอันดับสูงสุด Kimi เป็นตัวเลือกที่ฉลาดกว่า ลองรันทั้งสามโมเดลกับโค้ดของคุณเอง เปรียบเทียบผลลัพธ์ใน Apidog และให้เวิร์กโหลดของคุณเป็นผู้ตัดสินใจ