
คนส่วนใหญ่จะพบกับโมเดลใหม่ด้วยการเปิดกล่องแชทแล้วพิมพ์โต้ตอบ แต่ Jev กลับตรงกันข้าม มันคือโมเดล System One ของ TypeSafe AI และมันไม่ได้สร้างข้อความใดๆ เลย: คุณส่งสถานะของโปรแกรมพร้อมชุดคำถามที่มีประเภทข้อมูลที่กำหนดไว้ แล้วมันจะคืนค่าการตัดสินใจพร้อมความน่าจะเป็นที่แนบมา การเปลี่ยนบทบาทนี้คือเทคนิคทั้งหมด โมเดลภาษาของคุณยังคงเขียนต่อไป; Jev จะตัดสินใจว่าจะเกิดอะไรขึ้นต่อไป และโค้ดของคุณจะตัดสินใจว่าจะทำอย่างไรกับการตัดสินใจนั้น
คู่มือนี้ครอบคลุมสถาปัตยกรรมที่เกี่ยวข้องกับการเรียกใช้ ไม่ใช่การเรียกใช้ตัวมันเอง หากคุณต้องการข้อมูลเบื้องต้นก่อน ให้เริ่มต้นด้วย Jev คืออะไร จากนั้นอ่าน ประกาศเปิดตัว ของ TypeSafe เอง เพื่อทำความเข้าใจมุมมองของบริษัท
สิ่งที่ Jev โดดเด่นเป็นพิเศษ
ฟังก์ชันพื้นฐานสามอย่างครอบคลุมทุกสิ่งที่ Jev ทำ `noul` จะคืนค่าความน่าจะเป็นที่ข้อความหนึ่งเกี่ยวกับสถานะนั้นเป็นจริง `choice` จะเลือกหนึ่งตัวเลือกจากแผนผังเกณฑ์ (สูงสุด 255 ตัวเลือก) และคืนค่าตัวเลือกที่เลือก การกระจายความน่าจะเป็นทั้งหมด และค่าความเชื่อมั่น `score` จะจัดลำดับสถานะบนเกณฑ์ประเมินแบบมีลำดับตั้งแต่ 2 ถึง 10 ระดับ และคืนค่าระดับ คำอธิบาย ความน่าจะเป็น และความเชื่อมั่น ข้อมูลเบื้องหลังเกี่ยวกับบริษัทและตระกูลโมเดลสามารถดูได้ในบทความของเราเกี่ยวกับ TypeSafe AI
คุณสมบัติสี่ประการมีความสำคัญต่อสถาปัตยกรรม ทุกคำตอบมาในประเภทที่โปรแกรมของคุณเข้าใจอยู่แล้ว ทุกคำตอบมีความไม่แน่นอนของตัวเอง ดังนั้น "ไม่แน่ใจ" จึงกลายเป็นทางแยกแทนที่จะเป็นเรื่องน่าประหลาดใจ คำถามหลายข้อเกี่ยวกับสถานะหนึ่งๆ สามารถแก้ไขได้ในครั้งเดียว และด้วยราคา $0.042 ต่อหนึ่งล้านโทเค็นอินพุตโดยไม่มีค่าใช้จ่ายสำหรับโทเค็นเอาต์พุต คุณสามารถถามได้ทุกเหตุการณ์แทนที่จะเป็นเพียงตัวอย่าง
ใช้ Jev เป็นผู้ตัดสิน ไม่ใช่ผู้เขียน
สี่บทบาทที่แยกจากกันอย่างชัดเจน:
- LLM เป็นผู้สร้าง. โค้ด, ฉบับร่างอีเมล, สรุป, แผนการ
- Jev เป็นผู้ตัดสิน. มันจะจัดประเภทคำขอ, ประเมินความเสี่ยง, เลือกเส้นทาง, และตรวจสอบผลลัพธ์เทียบกับเกณฑ์ที่คุณกำหนดไว้ล่วงหน้า
- โค้ดของคุณเป็นผู้ควบคุม. ค่าเกณฑ์และกฎต่างๆ จะตัดสินใจว่าจะดำเนินการ, ลองใหม่, ขยายผล, หรือหยุด
- มนุษย์จัดการกับกรณีพิเศษ. ความเชื่อมั่นต่ำและความเสี่ยงสูงจะถูกส่งให้มนุษย์จัดการ
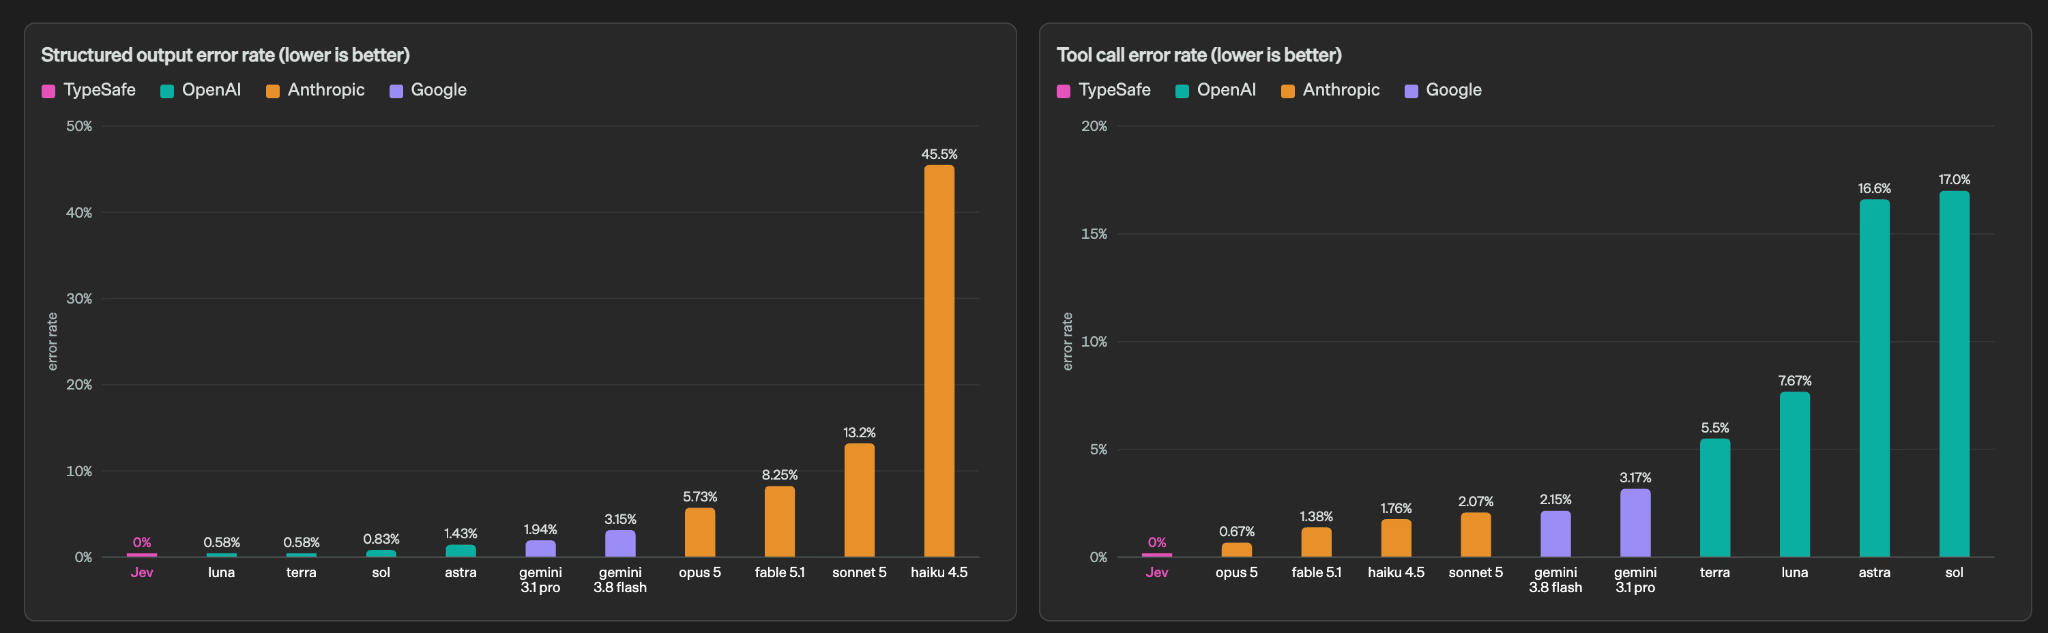
นี่คือเหตุผลว่าทำไมการแบ่งแยกนี้จึงได้ผล โมเดลภาษามีความยืดหยุ่นเพราะสามารถสร้างอะไรก็ได้ และอิสระนั้นเองที่ทำให้มันยากที่จะนำไปใช้ในเวิร์กโฟลว์ที่คุณต้องพึ่งพา กรอบแนวคิดของ TypeSafe คือ Jev "เลิกสร้างข้อความ" และได้รับสัญญาที่จำกัดเป็นการตอบแทน: ชุดคำตอบที่เป็นไปได้จะถูกกำหนดไว้ล่วงหน้าก่อนที่คำขอจะออกจากเซิร์ฟเวอร์ของคุณ ทุกผลลัพธ์จะเข้ากับรูปร่างที่ประกาศไว้ และความไม่แน่นอนคือตัวเลขที่คุณสามารถเปรียบเทียบกับค่าเกณฑ์ได้
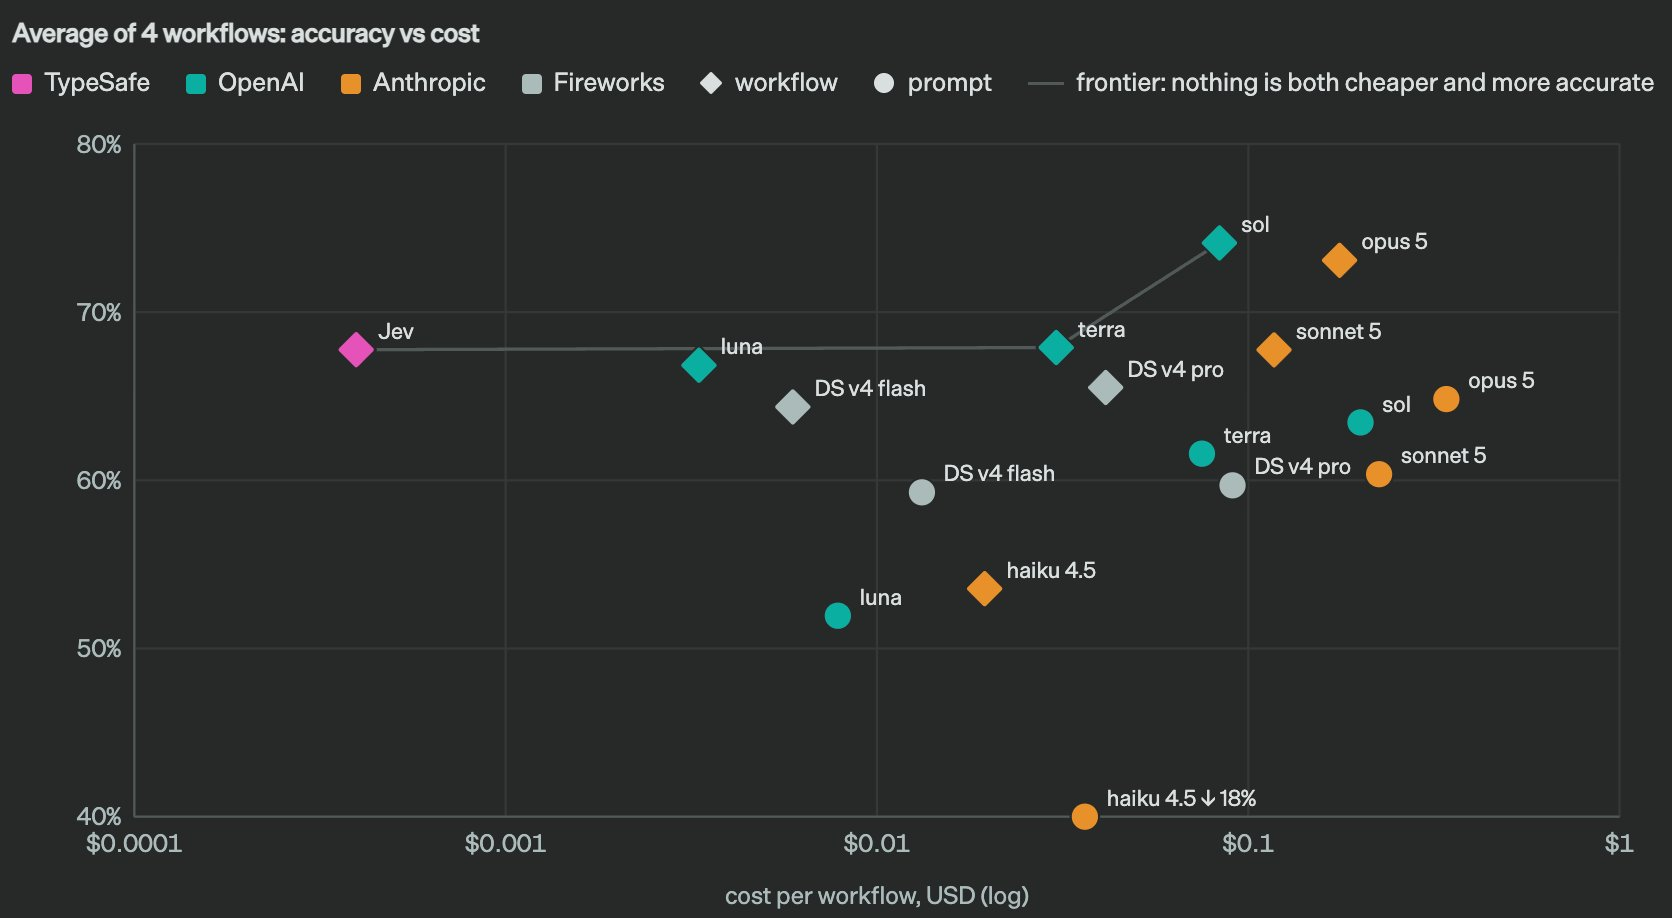
ด้านต้นทุนก็มาจากการแลกเปลี่ยนเดียวกันนี้ TypeSafe รายงานเวลาตอบสนองแบบ end-to-end อยู่ที่ 70ms ถึง 500ms และอ้างว่าเร็วกว่า 193.6 เท่า และถูกกว่า 444.6 เท่าในเวิร์กโฟลว์ที่ทดสอบ โปรดพิจารณาว่านี่เป็นตัวเลขจากผู้ขาย ไม่ใช่ข้อมูลอ้างอิงที่เป็นอิสระ ประเด็นเชิงโครงสร้างยังคงอยู่ไม่ว่าจะด้วยวิธีใด: โมเดลที่มีราคาแพงจะทำงานก็ต่อเมื่อจำเป็นต้องเขียนบางสิ่งบางอย่างจริงๆ และการตัดสินซ้ำๆ รอบๆ โมเดลนั้นจะทำงานในที่ที่มีราคาถูก
การออกแบบคำถามที่ Jev สามารถตอบได้
ทุกคำขอจะประกอบด้วย `state` ที่ใช้ร่วมกันหนึ่งรายการและชุดคำถามอิสระหลายข้อ Jev จะอ่านสถานะเพียงครั้งเดียวแล้วตอบคำถามทั้งหมด การคัดแยกคำขอสนับสนุนจะดูเหมือนสิ่งนี้:
{
  "model": "jev-latest",
  "state": {
    "message": "I've been trying to connect Stripe for three days. I'm losing sales and I need this fixed today.",
    "plan": "Pro",
    "account_age_months": 14,
    "recent_technical_tickets": 3
  },
  "questions": {
    "department": {
      "type": "choice",
      "instruction": "Which team should own this ticket?",
      "criteria": {
        "billing": "Payments, charges, invoices, subscription changes",
        "technical": "Bugs, broken behavior, failing integrations",
        "sales": "Pricing, plans, questions asked before purchase"
      }
    },
    "frustration": {
      "type": "score",
      "instruction": "How frustrated is this customer?",
      "criteria": [
        "Calm and matter of fact",
        "Frustrated but civil",
        "Extremely frustrated or threatening to leave"
      ]
    },
    "urgent": {
      "type": "noul",
      "instruction": "The customer needs a resolution today."
    }
  }
}
สามนิสัยที่แยกคำถามที่ได้ผลออกจากคำถามที่คลุมเครือ
หยุดเขียนพรอมต์. บุคลิกภาพ, ตัวอย่างที่ทำสำเร็จแล้ว และบทนำที่ยาวๆ ใช้เพื่อชี้นำตัวสร้างข้อความ Jev ไม่ได้สร้างข้อความ มันต้องการสถานะ คำถามเชิงอะตอมหนึ่งข้อ และคำอธิบายที่แม่นยำว่าแต่ละคำตอบหมายถึงอะไร เกณฑ์ที่อธิบายได้ดีกว่าป้ายกำกับเปล่าๆ: “การชำระเงิน, ค่าใช้จ่าย, ใบแจ้งหนี้, การเปลี่ยนแปลงการสมัครสมาชิก” จะนำทางได้ดีกว่าคำว่า “การเรียกเก็บเงิน” เพียงอย่างเดียว อย่าขอให้มันอธิบายตัวเองด้วย เพราะการตอบสนองมีเพียงการตัดสินใจ ความน่าจะเป็น และความเชื่อมั่นเท่านั้น ไม่มีอะไรอื่น
หนึ่งคำถาม หนึ่งการตัดสิน. “ลูกค้าเป้าหมายนี้มีคุณค่า เร่งด่วน และมีแนวโน้มที่จะซื้อหรือไม่?” คือสามคำถามที่ถูกรวมไว้ในชุดเดียวกัน แยกคำถามเหล่านี้ออกและรวมผลลัพธ์ในโค้ด ซึ่งคุณสามารถเห็นน้ำหนักและเปลี่ยนแปลงได้
อย่าให้โมเดลคำนวณ. Jev ตัดสินความหมาย โปรแกรมของคุณเป็นผู้คำนวณ ใช้ตารางส่วนลด และตรวจสอบเงื่อนไขสัญญา การแบ่งแยกนี้คือสิ่งที่ทำให้ทุกอย่างตรวจสอบได้
TypeSafe ยังมี skill แบบ drop-in ที่สอน agent การเขียนโค้ดให้ปฏิบัติตามหลักการเหล่านี้ ซึ่งสามารถติดตั้งใน Claude Code ได้ด้วย `claude plugin marketplace add typesafe-ai/skills` หรือที่อื่นๆ ด้วย `npx skills add typesafe-ai/skills` หน้า agent skill มีรายละเอียด
รักษา state ให้สะอาด
state ที่เกี่ยวข้องสำคัญกว่า state ที่มีข้อมูลมากเกินไป โดยปกติจะครอบคลุมสามส่วน: วัตถุที่ถูกตัดสิน บริบทที่จำเป็นในการอ่านวัตถุนั้น และข้อเท็จจริงที่จะเปลี่ยนการตัดสินใจหากมีการเปลี่ยนแปลง สิ่งอื่นๆ ล้วนเป็นข้อมูลรบกวนที่คุณต้องจ่ายค่าส่ง
ลบรายการบันทึกที่ซ้ำกัน ประวัติที่เก่ากว่าปัญหาปัจจุบัน และประโยคใดๆ ที่ระบุข้อสรุปที่คุณหวังว่าโมเดลจะเข้าถึง ขีดจำกัดสูงสุดคือ 64k โทเค็นต่อคำขอ โดยมี 32k สำหรับ state บวกกับคำถามที่ยาวที่สุด แต่ความแม่นยำอาจเปลี่ยนแปลงได้ก่อนที่คุณจะถึงขีดจำกัดนั้น เมื่อการกำหนดเส้นทางเริ่มไม่ชัดเจน การลดขนาด state มักจะเป็นวิธีแก้ไขที่เร็วกว่าการเขียนเกณฑ์ใหม่
คำถามแบบขนานและเกตความเชื่อมั่น
เนื่องจาก Jev อ่าน state เพียงครั้งเดียว คำถามที่สิบสามจึงมีค่าใช้จ่ายน้อยกว่าการส่งไปกลับครั้งที่สองมาก ส่งการตัดสินใจอิสระทุกรายการที่อาจเปลี่ยนแปลงการดำเนินการ: เจตนา, ความเสี่ยง, ความเร่งด่วน, อารมณ์ความรู้สึก, ความเกี่ยวข้อง, ขั้นตอนต่อไปที่จำเป็น จากนั้นตัดคำถามใดๆ ที่คำตอบไม่เคยเปลี่ยนการทำงานของโค้ดคุณออก สัญญาณที่ไม่ได้ใช้งานคือค่าบำรุงรักษาที่ไม่มีประโยชน์
จับคู่ฟังก์ชันพื้นฐานกับรูปแบบการตัดสิน ระดับที่ค่อยเป็นค่อยไป เช่น ความรุนแรง คุณภาพ และความเหมาะสม ควรอยู่ใน `score` ไม่ใช่ในคำตอบบังคับแบบใช่/ไม่ใช่ ข้อความที่เป็นข้อเท็จจริงเพียงข้อเดียวควรอยู่ใน `noul` ชุดปลายทางที่แน่นอนควรอยู่ใน `choice`
เกตคือที่ที่สถาปัตยกรรมทำงานจริงๆ คำตอบที่มีประเภทข้อมูลที่กำหนดไว้อาจยังคงเป็นคำตอบที่ผิด ดังนั้นความเชื่อมั่นจึงเป็นตัวตัดสินว่าจะเกิดอะไรขึ้นต่อไป รูปแบบเริ่มต้นที่ใช้งานได้: ดำเนินการโดยอัตโนมัติเมื่อความเชื่อมั่นสูงกว่า 0.85, ส่งช่วง 0.55 ถึง 0.85 ให้โมเดลที่แข็งแกร่งกว่าหรือประมวลผลซ้ำ และจัดคิวสิ่งที่ต่ำกว่า 0.55 ให้กับมนุษย์ ตัวเลขเหล่านั้นเป็นเพียงตัวอย่าง รูปแบบ confidence routing ของ TypeSafe กำหนดค่าเกณฑ์แยกกันต่อการดำเนินการ โดยอิงตามต้นทุนของการผิดพลาด และ หน้าความเชื่อมั่น ของมันบอกให้คุณ "ทดสอบด้วยข้อมูลของคุณเอง และปรับเปลี่ยนตามผลลัพธ์ที่คุณสังเกตเห็น" เมื่อค่าเกณฑ์ของคุณถูกปรับแต่งแล้ว ให้ตรึงโมเดล: `jev-latest` จะติดตามเวอร์ชันเสถียรล่าสุด ในขณะที่ `jev-1.13.0` จะตรึงพฤติกรรมที่คุณวัดไว้
ทดสอบเลเยอร์การตัดสินใจใน Apidog
เลเยอร์การตัดสินใจจะน่าเชื่อถือก็ต่อเมื่อคุณสามารถพิสูจน์ได้ว่ามันทำงานอย่างไร นั่นหมายถึงคำขอที่บันทึกไว้และการยืนยัน ไม่ใช่เพียงแค่ประวัติการเรียกใช้ครั้งเดียวในเทอร์มินัล Apidog ให้คุณทั้งสองอย่าง และการยืนยันจะดูแตกต่างจากการทดสอบ API ทั่วไป เพราะคุณกำลังตรวจสอบตัวเลขและค่า enum แทนที่จะเป็นสตริง
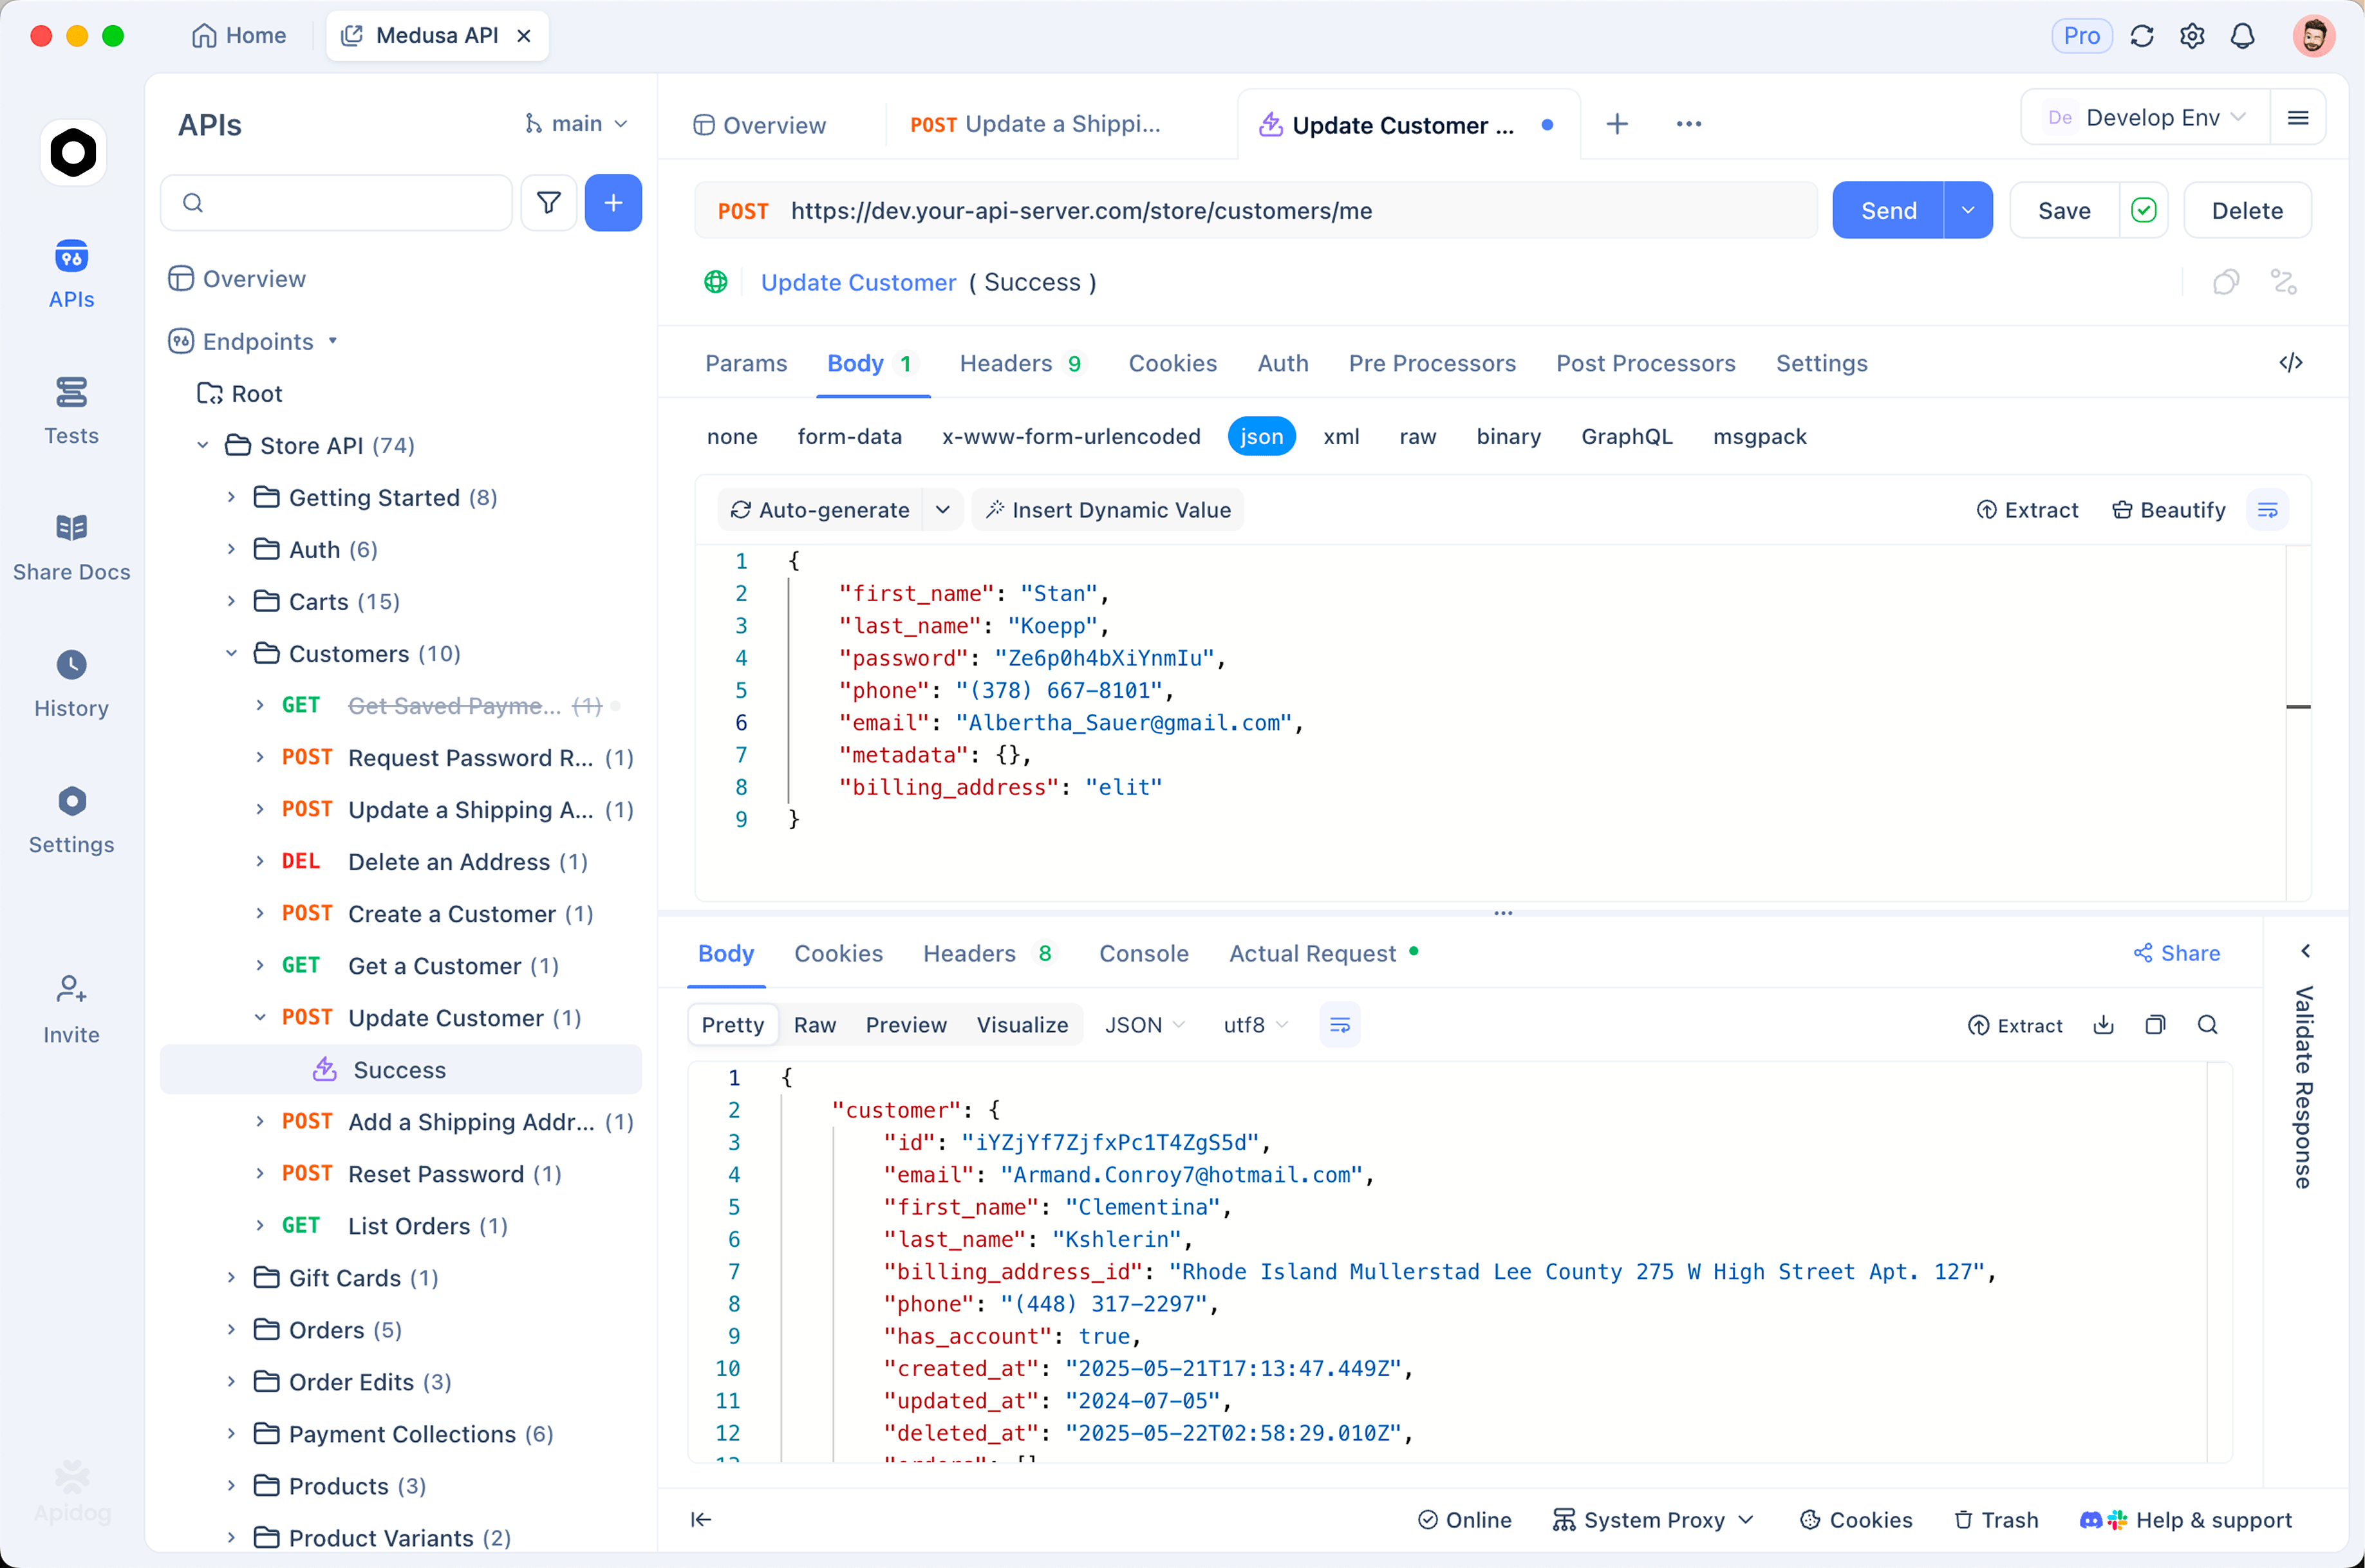
จัดเก็บคีย์เป็นตัวแปรสภาพแวดล้อม. สร้างสภาพแวดล้อมชื่อ `TypeSafe` เพิ่ม `TYPESAFE_API_KEY` เป็นค่าโลคัลเพื่อให้ยังคงอยู่ในเครื่องของคุณ และอ้างอิงมันเป็น `{{TYPESAFE_API_KEY}}` ใน Bearer token คู่มือของเราเกี่ยวกับ สภาพแวดล้อมและตัวแปรลับ ครอบคลุมกฎขอบเขต
ส่งการเรียกใช้จริง. `POST https://api.typesafe.ai/v1/systemone` พร้อมกับบอดี้ state-plus-questions ด้านบน
ยืนยันผลการตัดสินใจ. เพิ่มการยืนยันหลังการประมวลผล เช่น `answers.department.choice` เท่ากับ `billing`, `answers.urgent.noul` มากกว่า `0.9` และ `answers.frustration.score` มากกว่า `1.5` ตอนนี้การเปลี่ยนแปลงพฤติกรรมจะทำให้การทดสอบล้มเหลว แทนที่จะนำตั๋วไปผิดทางอย่างเงียบๆ
จากนั้นสร้างสถานการณ์ที่สำคัญ. บันทึกชุดของสถานะที่มีป้ายกำกับเล็กๆ เป็นสถานการณ์การทดสอบ: คำถามที่สงบ, การขู่ยกเลิกด้วยความโกรธ, และข้อความที่จงใจกำกวมซึ่งเราเตอร์ที่ดีควรจะลังเล ยืนยันความเชื่อมั่นสูงในสองกรณีแรก และยืนยันว่าความเชื่อมั่น _ลดลง_ ต่ำกว่าเกตของคุณในกรณีที่สาม สถานการณ์เดียวนี้เปลี่ยนการปรับแต่งค่าเกณฑ์ให้กลายเป็นหลักฐานแทนการคาดเดา และมันจับความล้มเหลวที่ยากที่สุดที่จะสังเกตเห็นด้วยมือได้: มีคนเปลี่ยนคำอธิบายเกณฑ์, ทุกการตอบสนองยังคงถูกต้อง, และการกำหนดเส้นทางก็เปลี่ยนไปอย่างเงียบๆ รันมันใน CI แล้วการเขียนใหม่ก็จะทำให้บิลด์ล้มเหลว
จำลองโครงสร้างการตอบกลับ เพื่อให้การทำงานของส่วนหน้าไม่สิ้นเปลืองโทเค็น เนื่องจากอ็อบเจกต์ `answers` ถูกประกาศไว้ก่อนคำขอ การจำลองและการตอบกลับจริงจึงไม่สามารถแตกต่างกันได้ ดาวน์โหลด Apidog เพื่อตั้งค่านี้; แผนฟรีครอบคลุมทีมสี่คน
ห้าเวิร์กโฟลว์ที่เลเยอร์การตัดสินใจคุ้มค่าต่อการลงทุน
- เครื่องยืนยันสากล. ห่อหุ้มทุกการเรียกใช้ LLM ที่มีค่าใช้จ่ายสูง ตรวจสอบพรอมต์ขาเข้าเพื่อหาการฉีด (injection), ตรวจสอบเครื่องมือที่เลือกเพื่อหาความไม่ตรงกันที่ชัดเจน, ตรวจสอบเอาต์พุตเพื่อหาข้อกำหนดที่ขาดหายไป, และตรวจสอบคำตอบสุดท้ายสำหรับการอ้างสิทธิ์ที่ข้อมูลต้นฉบับไม่รองรับ การตรวจสอบราคาถูกรอบสมองที่มีราคาแพง
- ศูนย์ควบคุมการสนับสนุน. จัดประเภทตั๋ว, ตรวจจับความเร่งด่วน, ความหงุดหงิด, เจตนาการขอคืนเงิน, และความเสี่ยงในการยกเลิกในการเรียกใช้ครั้งเดียว แล้วจึงกำหนดเส้นทาง ผลลัพธ์ที่ได้คือจำนวนตั๋วในคิวที่ผิดน้อยลง และบัญชีที่มีค่าที่ถูกทิ้งไว้เฉยๆ น้อยลง
- การคัดกรองลูกค้าเป้าหมาย. ให้คะแนนความเหมาะสมของบริษัท, ความพร้อมทางเทคนิค, ปัญหาที่ระบุ, ความตั้งใจในการซื้อ, และความเร่งด่วน เป็นสัญญาณแยกต่างหาก จากนั้นรวมเข้าด้วยกันด้วยน้ำหนักที่คุณกำหนดเองและสามารถอธิบายได้ในการทบทวนไปป์ไลน์
- เราเตอร์โมเดล. ตัดสินใจต่อคำขอว่าโค้ดที่กำหนด, โมเดลขนาดเล็ก, โมเดลล้ำสมัย, หรือมนุษย์ ควรจัดการกับมัน โดยทั่วไปแล้วนี่คือจุดที่การประหยัดค่าใช้จ่ายปรากฏขึ้นเป็นอันดับแรก
- งานข้อมูลขนาดใหญ่. รันการตัดสินเชิงความหมายเดียวกันทั่วบันทึกการสนับสนุน, รีวิว, รายการ, สคริปต์, หรือร่องรอยของเอเจนต์ เพื่อดึงคุณสมบัติที่มีโครงสร้างและจัดอันดับบันทึกที่คุ้มค่ากับการตรวจสอบโดยมนุษย์ การวิเคราะห์ที่จะใช้ได้จริงก็ต่อเมื่อการตัดสินใจแต่ละครั้งรวดเร็วและแทบจะไม่มีค่าใช้จ่าย
คำถามที่พบบ่อย
ฉันยังคงต้องการโมเดลภาษาอยู่หรือไม่? ใช่ Jev ไม่สามารถเขียนคำตอบ, สรุป, หรือโค้ดได้ มันจะตัดสินใจว่าระบบใดควรทำ และมันสามารถประเมินฉบับร่างหลังจากนั้นเทียบกับเกณฑ์ที่ชัดเจน เช่น การปฏิบัติตามนโยบาย หรือว่าคำตอบมีการให้คำมั่นสัญญาที่คุณไม่ได้ทำไว้หรือไม่
สิ่งนี้แตกต่างจาก JSON mode หรือ structured outputs อย่างไร? Structured outputs จะจำกัดรูปแบบของโมเดลข้อความ; โมเดลยังคงสร้างโทเค็นและยังคงสามารถยืนยันสิ่งที่ไม่เป็นจริงในรูปแบบที่ถูกต้องได้ Jev จะคืนค่าการกระจายความน่าจะเป็นเหนือชุดคำตอบที่คุณกำหนด ดังนั้นความไม่แน่นอนจึงเป็นฟิลด์หลัก คำอธิบายของเราเกี่ยวกับ structured outputs ของ OpenAI ครอบคลุมอีกด้านของการเปรียบเทียบนั้น
ฉันจะเข้าถึงได้อย่างไร? Jev อยู่ในช่วงเข้าถึงล่วงหน้าพร้อมรายชื่อรอ ดังนั้นจึงยังไม่ใช่บริการแบบ self-service TypeSafe จะนำนักพัฒนาออกจากรายชื่อรอเป็นชุดๆ และคุณจะลงชื่อเข้าใช้ที่ console.typesafe.ai เมื่อคุณได้รับสิทธิ์ นอกจากนี้ยังสามารถใช้งานได้ผ่าน Vercel AI Gateway ในชื่อ `typesafe-ai/jev` โดยใช้ `experimental_evaluate` ใน AI SDK 7 ซึ่งเป็น SDK-only และไม่ได้เปิดเผยบนเอนด์พอยต์ที่เข้ากันได้กับ OpenAI คู่มือของเราเกี่ยวกับ การรับ Jev API key มีรายละเอียดคำขอและ SDK
ฉันสามารถรันสิ่งที่คล้ายกันนี้บนเครื่องของฉันได้หรือไม่? มีหลายโครงการที่สร้างบางส่วนของแนวคิดนี้ขึ้นมาใหม่ด้วย constrained decoding เหนือน้ำหนักแบบเปิด เราได้เปรียบเทียบโครงการเหล่านี้ใน OpenJev และทางเลือก Jev แบบโอเพนซอร์ส รวมถึงความแม่นยำของแต่ละโครงการต่อความเชื่อมั่นที่ปรับเทียบแล้ว
สิ่งที่คุณจะได้รับจากสิ่งนี้
Jev ไม่ใช่โมเดลที่จะมาแทนที่โมเดลอื่นๆ ของคุณ มันคือเลเยอร์ที่ตัดสินใจว่าเมื่อไหร่ ที่ไหน และควรจะรันโมเดลเหล่านั้นหรือไม่ สร้างมันด้วยวิธีนี้: state ที่สะอาดหนึ่งเดียว, คำถามเชิงอะตอมที่มีเกณฑ์ชัดเจน, การประเมินแบบขนาน, และเกตความเชื่อมั่นที่อยู่หน้ารายการการกระทำทุกอย่าง จากนั้นพิสูจน์ว่าเกตทำงานได้ด้วยสถานการณ์ที่บันทึกไว้ใน Apidog ก่อนที่จะกำหนดเส้นทางตั๋วจริงแม้แต่ใบเดียว