
หากต้องการใช้ Firecrawl Local ให้ติดตั้งด้วย cargo install firecrawl-local รัน firecrawl-local init เพื่อลงทะเบียนเป็น MCP server ใน Claude Code และ Cursor จากนั้นรีสตาร์ททั้งสองเครื่องมือ เอเจนต์ของคุณก็จะสามารถ scrape, crawl และ map เว็บไซต์บนเครื่องของคุณเองได้ สำหรับการเขียนโค้ด ให้รัน firecrawl-local serve แล้วชี้ Firecrawl SDK ตัวใดก็ได้ไปที่ http://localhost:3002
คู่มือนี้จะแสดงวิธีใช้ Firecrawl Local ทีละขั้นตอน พร้อมเอาต์พุตจริงจากการทดสอบของเราเมื่อวันที่ 19 พฤศจิกายน 2026 (Firecrawl Local 0.1.0 บน Mac arm64) รวมถึงพรอมป์สำหรับป้อนให้เอเจนต์ของคุณ และวิธีให้เอเจนต์ทดสอบ API ภายในเครื่องด้วย Apidog CLI
สิ่งที่คุณต้องเตรียมก่อนเริ่ม
Firecrawl Local คือไบนารี Rust ตัวเดียวจาก repository ของ Firecrawl ก่อนติดตั้ง ตรวจสอบว่าคุณมี:
- Rust และ C compiler ดาวน์โหลด Rust ได้จาก rustup.rs บน macOS ให้รัน
xcode-select --installส่วนบน Debian หรือ Ubuntu ให้ติดตั้งbuild-essential - Node.js 22 หรือใหม่กว่า หากต้องการใช้ MCP server เพราะต้องรันแพ็กเกจ npm
firecrawl-mcpผ่านnpx - Chrome หรือ Chromium (ไม่บังคับ) Firecrawl Local ใช้เบราว์เซอร์ที่คุณมีอยู่แล้วสำหรับหน้าที่ต้องใช้ JavaScript หน้าที่เป็น static ใช้งานได้โดยไม่ต้องมีก็ได้
- Claude Code, Cursor หรือ MCP client อื่น คำสั่ง
initยังรองรับ Claude Desktop, Windsurf, Gemini CLI และ Codex อีกด้วย
หากคุณเพิ่งเริ่มรู้จัก Firecrawl เอง เริ่มจากคู่มือ web scraping ด้วย Firecrawl ของเราแล้วค่อยกลับมา
ขั้นตอนที่ 1: ติดตั้ง Firecrawl Local
ติดตั้ง crate จาก crates.io แล้วตรวจสอบเวอร์ชัน:
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Cargo จะคอมไพล์จากซอร์ส บน Mac ของเรา release build ใช้เวลา 6 นาที 54 วินาที และไบนารีถูกวางไว้ที่ ~/.cargo/bin/firecrawl-local ตรวจสอบให้แน่ใจว่าโฟลเดอร์นั้นอยู่ใน PATH ของคุณ หรือจด full path ไว้ เพราะคุณจะต้องใช้สำหรับตั้งค่า MCP ด้วยตนเอง
ขั้นตอนที่ 2: รัน scrape ครั้งแรกจาก terminal
ก่อนจะเชื่อมต่ออะไรเข้ากับเอเจนต์ ให้ตรวจสอบก่อนว่าการดึงข้อมูลทำงานได้:
FIRECRAWL_CLOUD=off firecrawl-local scrape https://example.com --markdown
มันพิมพ์ข้อความหลักของหน้าเว็บออกมาเป็น markdown ใน 1.2 วินาที หากตัด --markdown ออก คุณจะได้ JSON แบบเดียวกับที่ Firecrawl API ส่งกลับ --format markdown,links ใช้เลือกฟอร์แมต โดยตัวเลือกภายในเครื่องมี markdown, html, rawHtml และ links
ต่อไปคือ crawl ที่เขียนไฟล์ markdown หนึ่งไฟล์ต่อหนึ่งหน้า:
FIRECRAWL_CLOUD=off firecrawl-local crawl https://docs.firecrawl.dev --limit 20 --out ./pages
คำสั่งนี้ดึง 20 หน้าจากเอกสาร Firecrawl ใน 4.4 วินาที และบันทึกไฟล์ชื่อประมาณ 0005-docs.firecrawl.dev_advanced-scraping-guide.md แฟล็ก crawl ที่มีประโยชน์จาก firecrawl-local crawl --help:
| แฟล็ก | การทำงาน |
|---|---|
-l, --limit |
จำนวนหน้าสูงสุด (ค่าเริ่มต้น 100) |
--max-depth |
ความลึกของลิงก์ที่จะติดตาม |
--include, --exclude |
regex ของ path ที่จะเก็บหรือข้าม ใช้ซ้ำได้ |
--entire-domain |
ติดตามลิงก์ที่อยู่นอก path เริ่มต้น |
-c, --concurrency |
จำนวนหน้าที่ดึงพร้อมกัน |
--ignore-robots |
ข้าม robots.txt (ปกติจะอ่านเสมอ) |
firecrawl-local map https://firecrawl.dev จะคืน URL ทุกตัวที่พบจาก sitemap และหน้าเริ่มต้น ออกมาเป็น JSON บรรทัดเดียว
ขั้นตอนที่ 3: เพิ่ม Firecrawl Local ไปยัง Claude Code และ Cursor ด้วย init
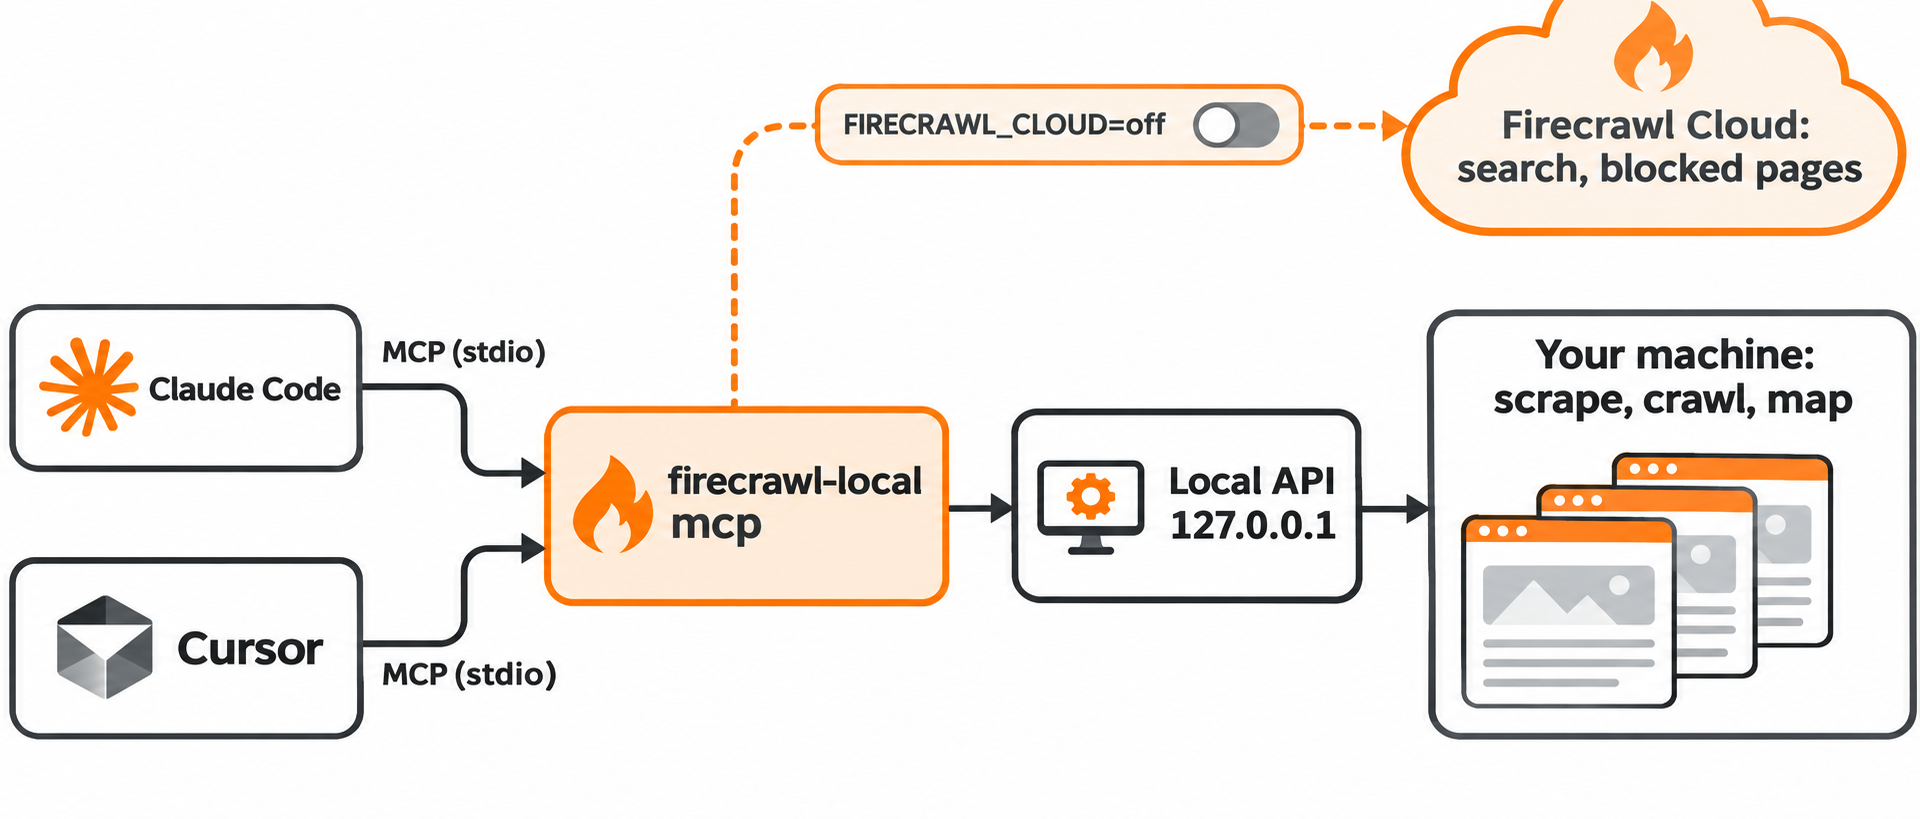
init จะค้นหาเครื่องมือ AI บนเครื่องของคุณและเพิ่ม Firecrawl Local เข้าไปใน MCP config ของแต่ละตัว ดูก่อนได้ด้วยการพรีวิว:
firecrawl-local init --dry-run
บน Mac ของเรา คำสั่งนี้แสดงรายการเครื่องมือทั้งหมดที่จะถูกแก้ไข:
Firecrawl MCP server:
  Claude Code: would be added in ~/.claude.json
  Claude desktop: would be added in ~/Library/Application Support/Claude/claude_desktop_config.json
  Cursor: would be added in ~/.cursor/mcp.json
  Gemini CLI: would be added in ~/.gemini/settings.json
  Codex: would be added in ~/.codex/config.toml
dry run ยังแสดงข้อมูลที่จะถูกส่งไปยัง Firecrawl Cloud ด้วย ได้แก่ search query, URL ของหน้าที่บล็อกเครื่องของคุณ, การเรียก Alexandria หลังจากที่คุณลงชื่อเข้าใช้ และ install ID แบบสุ่มพร้อมชื่อเครื่องมือ AI ของคุณ หน้าที่โหลดได้ตามปกติภายในเครื่องจะไม่ถูกส่งไป
หากต้องการตั้งค่าเฉพาะสองเครื่องมือที่คู่มือนี้ครอบคลุม ให้ระบุ --agent ซ้ำ:
firecrawl-local init --agent claude-code --agent cursor
ชื่อที่ใช้ได้คือ claude-code, claude-desktop, cursor, windsurf, gemini และ codex คำสั่ง init จะแบ็กอัปไฟล์ config ทุกไฟล์ก่อนเขียน หลังเสร็จให้รีสตาร์ท Claude Code และ Cursor เพื่อให้โหลด server ใหม่
ตั้งค่า Firecrawl Local ใน Claude Code ด้วยตนเอง
หากคุณไม่อยากให้เครื่องมือใดมาแก้ไข config ของคุณ ให้เพิ่ม stdio server เองด้วยคำสั่ง MCP ของ Claude Code:
claude mcp add firecrawl -e FIRECRAWL_CLOUD=off -- ~/.cargo/bin/firecrawl-local mcp --public-only
รัน /mcp ใน Claude Code เพื่อยืนยันว่า server เชื่อมต่อแล้ว
ตั้งค่า Firecrawl Local ใน Cursor ด้วยตนเอง
Cursor อ่าน MCP server จาก ~/.cursor/mcp.json (global) หรือ .cursor/mcp.json (ระดับโปรเจกต์) ให้ใช้ full path ไปยังไบนารี:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"],
      "env": { "FIRECRAWL_CLOUD": "off" }
    }
  }
}
--public-only ทำให้ server ปฏิเสธ localhost และที่อยู่เครือข่ายส่วนตัว เปิดไว้เสมอเมื่อเอเจนต์อ่านหน้าที่คุณไม่เชื่อถือ เพราะคำสั่งที่ซ่อนอยู่บนหน้าอาจชักจูงให้เอเจนต์ไปยัง URL ภายในได้
ขั้นตอนที่ 4: พรอมป์สำหรับป้อนให้เอเจนต์
firecrawl-local mcp เริ่ม API ภายในเครื่องบนพอร์ต loopback และรันแพ็กเกจ firecrawl-mcp กับมัน เอเจนต์ของคุณจะเห็นเครื่องมือ MCP มาตรฐานของ Firecrawl โดย scrape, crawl, map และ batch scrape ทำงานบนเครื่องคุณ หากคุณเคยใช้Firecrawl MCP server แบบโฮสต์ ชื่อเครื่องมือจะเหมือนกัน
พรอมป์ที่เข้ากับเครื่องมือภายในเครื่องได้ดี:
Map https://docs.example.com, then crawl only the /api/ pages (limit 40)
and write a summary of every endpoint into docs/vendor-api.md.
Scrape the changelog at https://example.com/changelog as markdown and list
every breaking change from the last three releases.
Batch scrape these five pricing pages and build a comparison table of
plan names and limits. Quote only what the pages say.
หลีกเลี่ยงพรอมป์ที่ต้องใช้ search เพราะเมื่อตั้ง FIRECRAWL_CLOUD=off เครื่องมือนั้นจะไม่ทำงานเลย สำหรับการตั้งค่า search แบบ local ทั้งหมด ดูคู่มือweb search แบบโอเพนซอร์สสำหรับ Claude ของเรา
ขั้นตอนที่ 5: รัน Firecrawl Local API และชี้ SDK ไปที่มัน
สำหรับสคริปต์และ pipeline ให้รัน API server:
FIRECRAWL_CLOUD=off firecrawl-local serve
มันจะฟังที่ 127.0.0.1:3002 health check จะตอบกลับทันที:
curl -s localhost:3002/health
# {"status":"ok","engine":"firecrawl-local","version":"0.1.0"}
การ scrape จะคืนรูปแบบ v2 ที่คุ้นเคย พร้อมตัวบ่งชี้ภายในเครื่องสองตัว คือ "engine": "local-fetch" และ "source": "local" รวมทั้ง creditsUsed: 0
curl -s localhost:3002/v2/scrape -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown","links"]}'
ชี้ Firecrawl SDK มาที่นี่ได้โดยไม่ต้องใช้ API key สำหรับ Python:
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
สำหรับ Node:
import { Firecrawl } from "firecrawl";

const app = new Firecrawl({ apiUrl: "http://localhost:3002" });
const doc = await app.scrape("https://example.com");
console.log(doc.markdown);
init ยังแนะนำทางลัดอีกด้วย คือตั้ง FIRECRAWL_API_URL=http://127.0.0.1:3002 แล้วโค้ด Firecrawl ที่มีอยู่ของคุณจะทำงานในเครื่องเอง Firecrawl CLI ใช้ข้อมูล login ร่วมกับ Firecrawl Local ดังนั้นคำสั่ง login ของเครื่องมือใดก็ใช้ได้กับทั้งสอง
การ crawl เป็นแบบ async POST /v2/crawl คืน job ID ทันที และ GET /v2/crawl/{id} รายงาน status: completed, total: 10, creditsUsed: 0 และ expiresInSeconds: 3587 ในอีกไม่กี่วินาทีถัดมา job เก็บไว้ในหน่วยความจำ หมดอายุหนึ่งชั่วโมงหลังเริ่ม และหายไปเมื่อ serve หยุดทำงาน ดังนั้นควรบันทึกผลลัพธ์ทันทีที่ crawl เสร็จ
โปรเซส server ใช้หน่วยความจำ resident ประมาณ 10 MB ตอน idle และ 43 MB หลัง crawl 10 หน้าที่ว่า วัดด้วย ps โพสต์เปิดตัวของ Firecrawl อ้างว่าเร็วกว่า 37 เท่าและใช้หน่วยความจำน้อยกว่า self-hosted Firecrawl ถึง 230 เท่า แต่ README ไม่ได้เผยวิธีการวัด จึงควรถือว่าตัวเลขเหล่านี้มาจากฝั่ง Firecrawl
ทำให้ Firecrawl Local เป็น local อย่างสมบูรณ์ด้วย FIRECRAWL_CLOUD
โดยค่าเริ่มต้น (auto) จะมีสามอย่างที่ถูกส่งไปยัง Firecrawl Cloud ได้แก่ search, หน้าที่บล็อกเครื่องของคุณ และ Alexandria data provider (ซึ่งต้องใช้บัญชีฟรีผ่าน firecrawl-local login) ตัวแปร FIRECRAWL_CLOUD ควบคุมการส่งต่อ:
| ค่า | ผลลัพธ์ |
|---|---|
auto (ค่าเริ่มต้น) |
Search, fallback ของหน้าที่ถูกบล็อก และ Alexandria ทำงานทั้งหมด |
search |
ส่งเฉพาะ search ไปยัง Firecrawl Cloud |
off |
ไม่มีอะไรถูกส่งไปยัง Firecrawl Cloud |
ค่าที่ไม่รู้จักจะถูกนับเป็น off เมื่อปิดคลาวด์ POST /v2/search จะตอบกลับด้วย "code":"CLOUD_ONLY" พร้อมข้อความบอกให้ตั้ง FIRECRAWL_API_KEY หรือ FIRECRAWL_CLOUD=auto หน้าที่คลาวด์ดึงให้คุณจะมี "source": "firecrawl-cloud" กำกับไว้ คุณจึงสามารถบอกได้เสมอว่าผลลัพธ์มาจากที่ไหน
serve จะปฏิเสธ localhost และเป้าหมายในเครือข่ายส่วนตัว เว้นแต่คุณจะส่ง --allow-private และการ bind --host ที่ไม่ใช่ loopback ต้องใช้ --token ที่อยู่ cloud metadata และ link-local จะถูกบล็อกในทุกโหมด
ให้เอเจนต์เขียนโค้ดของคุณทดสอบ Firecrawl Local API ด้วย Apidog CLI
crawl endpoint คือจุดที่ทำให้ pipeline พังได้ง่ายที่สุด เพราะเป็น async, job หมดอายุ และเมื่อ server หยุดก็จะสูญหาย แทนที่จะ poll ด้วยตนเอง ให้เอเจนต์เขียนโค้ดของคุณสร้างและรันการทดสอบด้วย Apidog CLI
ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
จากนั้นป้อนพรอมป์หนึ่งข้อความให้ Claude Code หรือ Cursor:
firecrawl-local serve is running on http://localhost:3002. In Apidog project <id>,
import an OpenAPI file for POST /v2/scrape, POST /v2/crawl and GET /v2/crawl/{id},
create an environment for that base URL, and build a test scenario that starts a
crawl of https://docs.firecrawl.dev with limit 10, saves the returned id, polls
GET /v2/crawl/{id} until status is "completed", and asserts total equals completed
and every page has non-empty markdown. Run it and summarize any failures.
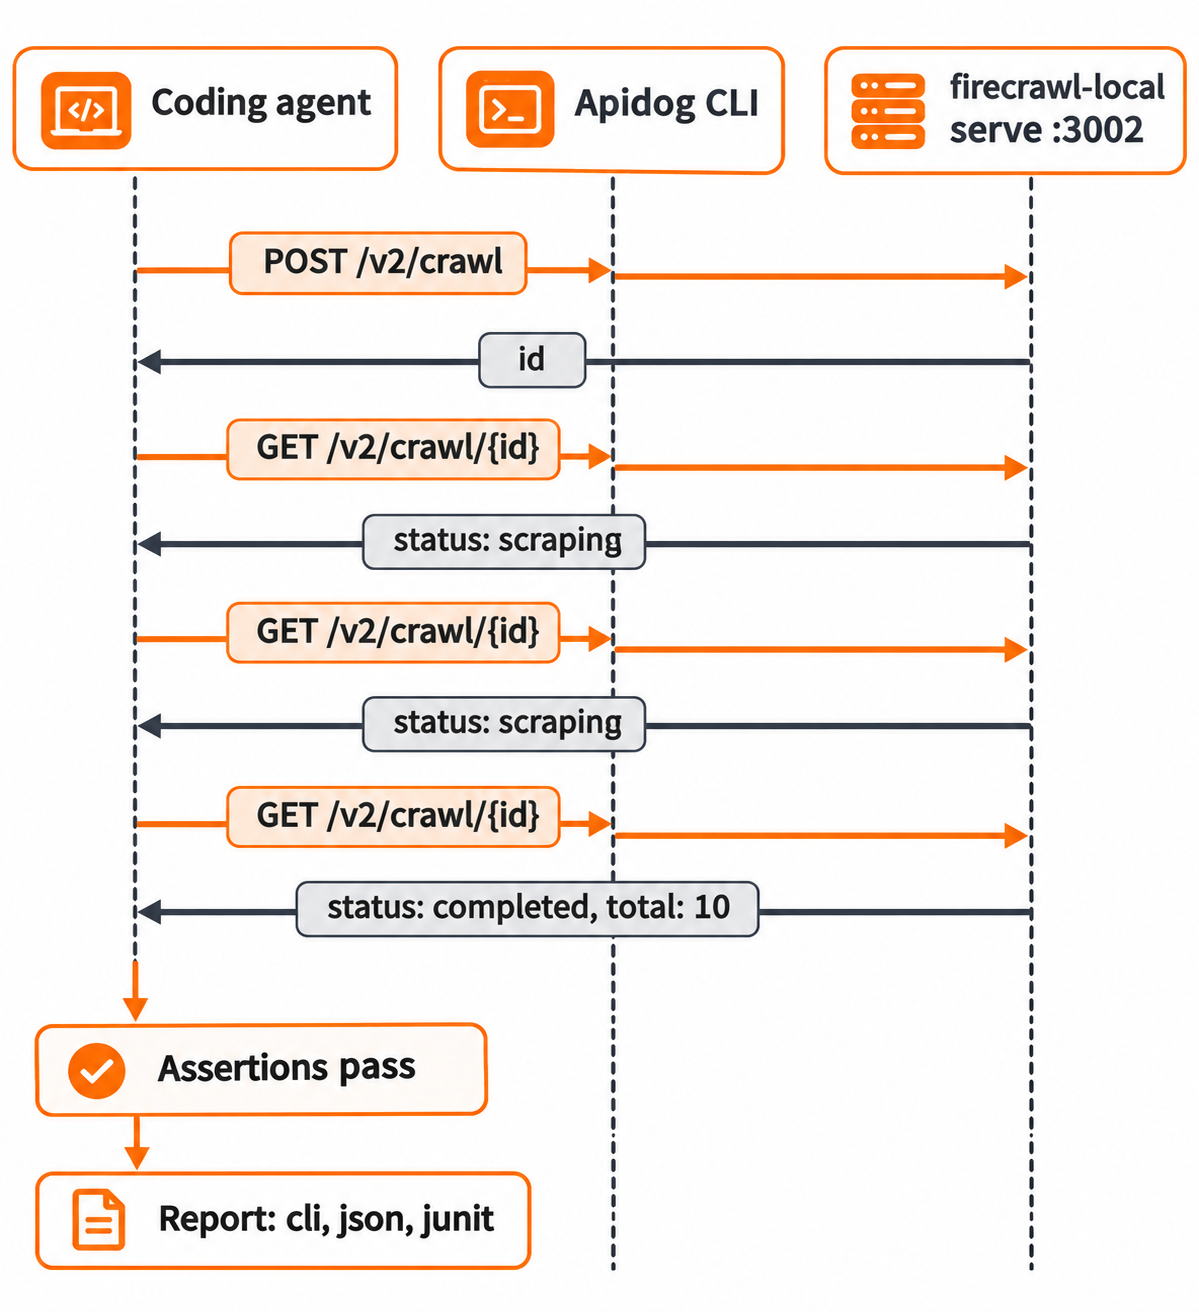
เอเจนต์จะอ่าน schema ของแต่ละ payload ตรวจสอบ และรันคำสั่งเช่นนี้ ซึ่งทั้งหมดนำมาจาก apidog <cmd> --help ใน CLI 2.2.12:
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file ./scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Apidog CLI ส่งคำขอจากเครื่องของคุณ ดังนั้น localhost:3002 จึงเข้าถึงได้ เปลี่ยนเป็น -r junit เพื่อนำการรันเดียวกันไปใส่ใน CI คู่มือApidog CLI ใน Claude Code และ Apidog CLI ใน Cursor ของเราครอบคลุมฝั่งเอเจนต์ แพลน Free ของ Apidog รองรับทีมสูงสุด 4 ผู้ใช้
การแก้ไขปัญหา Firecrawl Local
| อาการ | วิธีแก้ |
|---|---|
404 พร้อม NOT_FOUND ที่ /v1/scrape |
ให้บริการเฉพาะ v2 เท่านั้น เปลี่ยน client ของคุณไปใช้ /v2/... |
CLOUD_ONLY ที่ /v2/search |
เป็นเรื่องปกติเมื่อตั้ง FIRECRAWL_CLOUD=off; ใช้ auto หรือ search |
| เอเจนต์ไม่แสดงเครื่องมือ Firecrawl | รีสตาร์ทเครื่องมือหลังรัน init; ตรวจสอบ Node.js 22+ |
| หน้า JavaScript ได้ผลลัพธ์น้อยเกินไป | ติดตั้ง Chrome หรือตั้ง --browser always |
ฟอร์แมต json หรือ summary หายไป |
ไม่รองรับภายในเครื่อง คุณจะได้รับคำเตือนแทน |
| ไม่พบ Crawl ID | job หมดอายุหลังหนึ่งชั่วโมง หรือ serve ถูกรีสตาร์ท |
คำถามที่พบบ่อย
Firecrawl Local ฟรีหรือไม่? การ scrape, crawl และ map ภายในเครื่องไม่ส่งข้อมูลใดไปยัง Firecrawl และใช้ 0 เครดิตในการทดสอบของเรา โค้ดเป็น AGPL-3.0 ส่วน SDK เป็น MIT ส่วน search และ Alexandria ต้องผ่าน Firecrawl Cloud
ต้องใช้ API key กับ Firecrawl Local หรือไม่? ไม่ต้อง สำหรับ route ภายในเครื่อง คุณต้องใช้ key เฉพาะกับ Alexandria data provider ผ่าน firecrawl-local login หรือ FIRECRAWL_API_KEY
Firecrawl Local ใช้ได้กับ Windsurf, Codex และ Gemini CLI หรือไม่? ได้ init รองรับ windsurf, codex และ gemini รวมถึง Claude Code, Claude Desktop และ Cursor
โค้ด Firecrawl เดิมของฉันรันกับมันได้โดยไม่ต้องแก้ไขหรือไม่? สำหรับ v2 scrape, map, crawl และ batch scrape ได้ เพียงเปลี่ยน API URL เป็น http://localhost:3002 แต่ route v0 และ v1 ไม่ได้ให้บริการ และ actions ของเบราว์เซอร์จะถูกเพิกเฉย
Firecrawl Local เคารพ robots.txt หรือไม่? เคารพ มันอ่าน robots.txt เมื่อ crawl และระบุตัวตนใน User-Agent เจ้าของเว็บจึงติดต่อมันได้ในชื่อ FirecrawlLocal แฟล็ก --ignore-robots จะปิดการทำงานนี้ ใช้เฉพาะบนเว็บไซต์ที่คุณเป็นเจ้าของเท่านั้น