
DeepSeek V4 เปิดตัวเมื่อวันที่ 23 เมษายน 2026 พร้อมน้ำหนักโมเดลที่ได้รับอนุญาตแบบ MIT บน Hugging Face การเลือกใช้ใบอนุญาตเดียวนี้เปลี่ยนสมการสำหรับทุกทีมที่ต้องการ AI ระดับแนวหน้าบนฮาร์ดแวร์ของตนเอง V4-Flash (รวม 284 พันล้านพารามิเตอร์, 13 พันล้านพารามิเตอร์ที่ทำงานอยู่) สามารถทำงานได้บน H100 สองตัวในรูปแบบ FP8 V4-Pro (รวม 1.6 ล้านล้านพารามิเตอร์, 49 พันล้านพารามิเตอร์ที่ทำงานอยู่) ต้องการคลัสเตอร์ แต่สามารถทำงานเทียบเคียงได้กับ GPT-5.5 และ Claude Opus 4.6 ในด้านโค้ดและการให้เหตุผล
คู่มือนี้เป็นการติดตั้งใช้งานแบบภายใน (local-deployment) ครอบคลุมข้อกำหนดด้านฮาร์ดแวร์, ตัวเลือกการควอนไทซ์, การตั้งค่า vLLM และ SGLang, การกำหนดค่าการใช้งานเครื่องมือ, และขั้นตอนการทดสอบใน Apidog เพื่อตรวจสอบเซิร์ฟเวอร์ภายในก่อนที่คุณจะส่งทราฟฟิกจริงไปใช้งาน
สำหรับภาพรวมผลิตภัณฑ์ โปรดดู DeepSeek V4 คืออะไร สำหรับวิธีการใช้งาน API แบบโฮสต์ โปรดดู วิธีใช้ DeepSeek V4 API สำหรับการเปรียบเทียบต้นทุน โปรดดู ราคา DeepSeek V4 API
สรุปโดยย่อ
- V4-Flash ทำงานบน 2 × H100 80GB ในรูปแบบ FP8 หรือ 1 × H100 ในรูปแบบ INT4 น้ำหนักโมเดลมีขนาดประมาณ 500GB ในรูปแบบ FP8
- V4-Pro ต้องการ H100 16 ตัวขึ้นไปในรูปแบบ FP8 สำหรับปริมาณงานในระดับ Production; ไม่ใช่โมเดลสำหรับแล็ปท็อป
- vLLM เป็นวิธีที่เร็วที่สุดในการสร้างเซิร์ฟเวอร์ที่เข้ากันได้กับ OpenAI
vllm>=0.9.0รองรับ V4 เพิ่มเข้ามา - SGLang เป็นทางเลือกสำหรับทีมที่ต้องการฟังก์ชันการใช้งานเครื่องมือและเอาต์พุตที่มีโครงสร้างที่ดีขึ้น
- การควอนไทซ์เป็น AWQ INT4 หรือ GPTQ INT4 ทำให้ V4-Flash สามารถทำงานได้บนการ์ด 80GB ใบเดียว โดยมีการสูญเสียคุณภาพประมาณ 5%
- ใช้ Apidog เพื่อชี้ไปที่
http://localhost:8000/v1และใช้คอลเลกชันเดิมที่คุณใช้กับ Hosted API
ใครควรโฮสต์ด้วยตัวเอง
การโฮสต์ V4 ด้วยตัวเองเป็นทางเลือกที่เหมาะสมสำหรับทีมสามประเภทดังนี้
- ข้อจำกัดด้านการปฏิบัติตามข้อกำหนด. งานด้านสุขภาพ, การเงิน, กฎหมาย หรือการป้องกันประเทศที่ข้อมูลไม่สามารถออกจากเครือข่ายได้ การอนุญาตแบบ MIT ของโมเดลแบบเปิดหมายถึงไม่มีข้อตกลงการใช้งานและไม่มีการไหลเวียนของข้อมูลข้ามพรมแดน
- ปริมาณงานขนาดใหญ่ที่เสถียร. ด้วยอัตราการ Cache-miss, V4-Pro API มีค่าใช้จ่าย 1.74 ดอลลาร์สหรัฐฯ ต่ออินพุต 1 ล้านโทเค็น และ 3.48 ดอลลาร์สหรัฐฯ ต่อเอาต์พุต 1 ล้านโทเค็น สำหรับปริมาณงานที่เกินประมาณ 200 พันล้านโทเค็นต่อเดือน ฮาร์ดแวร์เฉพาะเริ่มคุ้มค่ากว่าการจ่ายตามการใช้งานต่อโทเค็น
- การ Fine-tuning และการวิจัย. เช็คพอยต์ Base มีไว้สำหรับการฝึกอบรมล่วงหน้าอย่างต่อเนื่องและการปรับใช้กับโดเมนเฉพาะ ใบอนุญาต MIT ครอบคลุมการเผยแพร่โมเดลที่ได้จากการปรับปรุงเพื่อการค้า
ใครที่ไม่ควรโฮสต์ด้วยตัวเอง: นักพัฒนาต้นแบบ, ทีมที่ไม่มีประสบการณ์ในการใช้งาน GPU, และใครก็ตามที่มีปริมาณงานที่สามารถใช้งาน Hosted API ได้ในงบไม่เกิน 200 ดอลลาร์สหรัฐฯ ต่อเดือน ค่าใช้จ่ายในการดำเนินงานจะกลืนกินเงินที่ประหยัดได้ไปอย่างรวดเร็วในขนาดเล็ก
ข้อกำหนดด้านฮาร์ดแวร์
DeepSeek V4 ใช้ความแม่นยำผสมแบบ FP4 + FP8 โดยกำเนิด นั่นหมายความว่าการคำนวณหน่วยความจำนั้นเป็นมิตรมากกว่าที่การนับจำนวนพารามิเตอร์แบบทั่วไปแนะนำ
| รูปแบบ | พารามิเตอร์ทั้งหมด | พารามิเตอร์ที่ทำงานอยู่ | VRAM (FP8) | VRAM (INT4) | การ์ดขั้นต่ำ |
|---|---|---|---|---|---|
| V4-Flash | 284B | 13B | ~500GB | ~140GB | 2 × H100 80GB (FP8) หรือ 1 × H100 (INT4) |
| V4-Pro | 1.6T | 49B | ~2.4TB | ~700GB | 16 × H100 80GB (FP8) หรือ 8 × H100 (INT4) |
คำชี้แจงเพิ่มเติมบางประการ:
- หน่วยความจำ MoE คือรวมทั้งหมด ไม่ใช่เฉพาะส่วนที่ทำงานอยู่. คุณต้องมี VRAM เพียงพอสำหรับผู้เชี่ยวชาญ (experts) ทุกคน แม้ว่าจะมีเพียงส่วนย่อยเท่านั้นที่ทำงานต่อโทเค็น ตัวเลข "active" 13 พันล้านนี้สะท้อนถึงค่าใช้จ่ายในการประมวลผลต่อโทเค็นเท่านั้น ไม่ใช่หน่วยความจำ
- H200 และ MI300X สามารถทดแทนกันได้. 141GB หรือ 192GB ต่อการ์ดหมายถึงใช้การ์ดน้อยลงสำหรับโมเดลเดียวกัน
- GPU สำหรับผู้บริโภคไม่เหมาะสม. แม้แต่ V4-Flash ในรูปแบบ INT4 ก็ไม่สามารถทำงานบน RTX 5090 ขนาด 24GB ได้
- Apple Silicon: M3 Max และ M4 Max ที่มีหน่วยความจำรวม 128GB สามารถรัน V4-Flash ได้ด้วยการควอนไทซ์ที่หนักหน่วง แต่จะทำงานช้า เป็นเพียงของเล่นสำหรับนักพัฒนา ไม่ใช่เป้าหมายสำหรับการใช้งานจริง
ขั้นตอนที่ 1: ดาวน์โหลดน้ำหนักโมเดล
แหล่งเก็บข้อมูลอย่างเป็นทางการ:
deepseek-ai/DeepSeek-V4-Flashdeepseek-ai/DeepSeek-V4-Prodeepseek-ai/DeepSeek-V4-Flash-BaseและDeepSeek-V4-Pro-Baseสำหรับ Fine-tuning
ติดตั้ง CLI และดึงข้อมูล:
pip install -U "huggingface_hub[cli]"
huggingface-cli login

huggingface-cli download deepseek-ai/DeepSeek-V4-Flash \
  --local-dir ./models/deepseek-v4-flash \
  --local-dir-use-symlinks False
สำรองพื้นที่ดิสก์ประมาณ 500GB สำหรับ V4-Flash และหลายเทราไบต์สำหรับ V4-Pro ModelScope (modelscope.cn) มีเช็คพอยต์เดียวกันและมักจะเร็วกว่าสำหรับผู้ใช้ในประเทศจีน
ขั้นตอนที่ 2: เลือกเอนจินสำหรับให้บริการ
มีเอนจินสำคัญสองตัวคือ: vLLM และ SGLang
- vLLM. ให้ปริมาณงานสูงสุด, อินเทอร์เฟซที่เข้ากันได้กับ OpenAI ที่สะอาดที่สุด, มีชุมชนที่ใหญ่ที่สุด เป็นทางเลือกเริ่มต้น
- SGLang. มีฟังก์ชันพื้นฐานสำหรับการใช้งานเครื่องมือที่ดีกว่า, เอาต์พุตที่มีโครงสร้าง, และได้ประโยชน์บางอย่างจาก Long Context เลือกตัวนี้หากปริมาณงานของคุณเน้นการเรียกใช้ฟังก์ชันเป็นหลัก
ทั้งสองรองรับ V4 ได้ทันทีตามเวอร์ชันที่เปิดตัวในสัปดาห์นี้
ขั้นตอนที่ 3: ให้บริการ V4-Flash ด้วย vLLM
pip install "vllm>=0.9.0"

vllm serve deepseek-ai/DeepSeek-V4-Flash \
  --tensor-parallel-size 2 \
  --max-model-len 1048576 \
  --dtype auto \
  --enable-prefix-caching \
  --port 8000
แฟล็กที่ควรรู้:
--tensor-parallel-size 2แบ่งโมเดลออกเป็น 2 H100s เพิ่มจำนวนเพื่อใช้การ์ดมากขึ้น--max-model-len 1048576เปิดใช้งาน Context Window ขนาด 1M โทเค็นแบบเต็ม ลดเหลือ 131072 หากไม่จำเป็น; Context ที่สั้นลงจะช่วยเพิ่ม VRAM--enable-prefix-cachingจำลองการคิดราคาแบบ Cache-hit ของ Hosted API ในเครื่อง ผลลัพธ์เหมือนกัน: คำนำหน้าที่ซ้ำกันจะทำงานเร็วขึ้นมาก--dtype autoรองรับความแม่นยำผสมแบบ FP8 ของ V4
เมื่อเซิร์ฟเวอร์ทำงานแล้ว ไคลเอนต์ที่เข้ากันได้กับ OpenAI ใดๆ ก็สามารถทำงานกับ http://localhost:8000/v1 ได้
ขั้นตอนที่ 4: ให้บริการ V4-Pro ด้วย vLLM
V4-Pro ต้องการคลัสเตอร์ รูปแบบคำสั่งไม่เปลี่ยนแปลง เพียงแค่การขนาน (parallelism) เท่านั้น
vllm serve deepseek-ai/DeepSeek-V4-Pro \
  --tensor-parallel-size 8 \
  --pipeline-parallel-size 2 \
  --max-model-len 524288 \
  --enable-prefix-caching \
  --port 8000
Context ลดลงเหลือ 512K เพื่อให้พอดีกับ H100 16 ตัว; สามารถเพิ่มกลับเป็น 1M ได้หาก VRAM เพียงพอ Pipeline parallelism และ Tensor parallelism เป็นรูปแบบทั่วไปสำหรับการติดตั้งใช้งานแบบข้ามโหนด
ขั้นตอนที่ 5: ให้บริการด้วย SGLang (ทางเลือกสำหรับการใช้งานเครื่องมือ)
pip install "sglang[all]>=0.4.0"

python -m sglang.launch_server \
  --model-path deepseek-ai/DeepSeek-V4-Flash \
  --tp 2 \
  --context-length 1048576 \
  --port 30000
SGLang เปิดเผยอินเทอร์เฟซที่เข้ากันได้กับ OpenAI ที่ http://localhost:30000/v1 DSL lang ของ SGLang ให้การเรียกใช้ฟังก์ชันและพริมิทีฟโหมด JSON ที่ชัดเจนกว่าคำแนะนำ JSON-schema ของ vLLM
ขั้นตอนที่ 6: ควอนไทซ์สำหรับการ์ด GPU เดี่ยว
การควอนไทซ์แบบ INT4 ทำให้ V4-Flash ทำงานบนการ์ด 80GB ใบเดียวได้ โดยมีการสูญเสียคุณภาพที่สามารถวัดได้แต่เพียงเล็กน้อย มีสองแนวทาง
AWQ (แนะนำ)
pip install autoawq

python -c "
from awq import AutoAWQForCausalLM
from transformers import AutoTokenizer

model_path = './models/deepseek-v4-flash'
out_path = './models/deepseek-v4-flash-awq'
model = AutoAWQForCausalLM.from_pretrained(model_path)
tokenizer = AutoTokenizer.from_pretrained(model_path)
model.quantize(tokenizer, quant_config={'w_bit': 4, 'q_group_size': 128})
model.save_quantized(out_path)
tokenizer.save_pretrained(out_path)
"
GPTQ
pip install auto-gptq
# Follow the GPTQ quantization recipe; similar pattern to AWQ.
ให้บริการเช็คพอยต์ที่ควอนไทซ์แล้วด้วย vLLM โดยการส่ง --quantization awq หรือ --quantization gptq เมื่อเริ่มใช้งาน
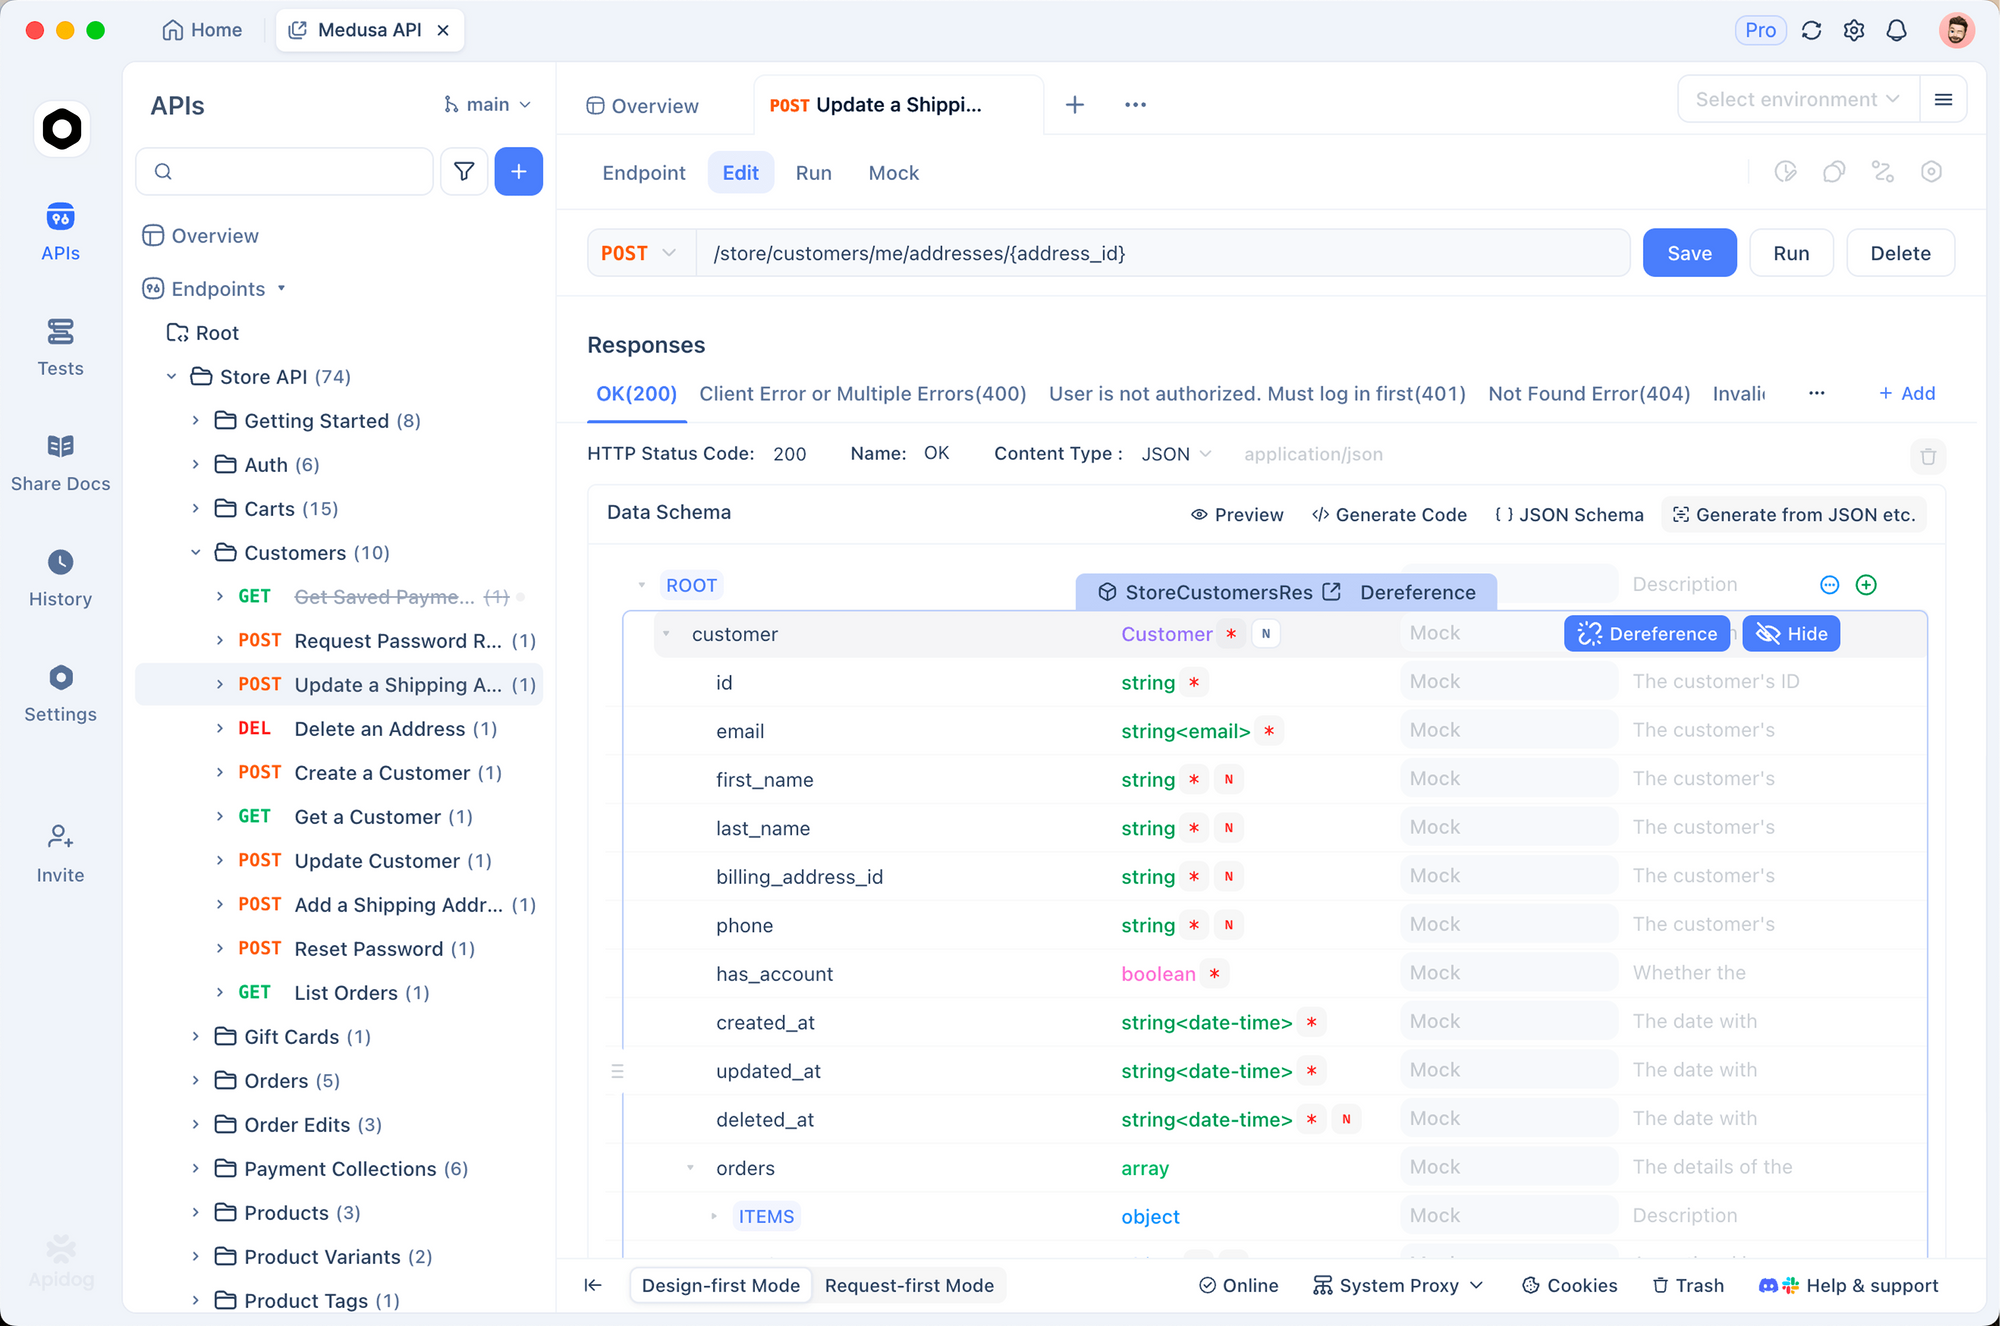
ขั้นตอนที่ 7: ทดสอบด้วย Apidog
อย่าส่งทราฟฟิก Production ไปยังเซิร์ฟเวอร์ภายในที่เพิ่งตั้งค่าใหม่ ตรวจสอบความถูกต้องก่อน
- ดาวน์โหลด Apidog.
- สร้างคอลเลกชันที่ชี้ไปที่
http://localhost:8000/v1/chat/completions - วาง Prompt ทดสอบเดียวกันกับที่คุณใช้กับ Hosted API เปรียบเทียบการตอบกลับแบบเคียงข้างกัน
- ส่งคำขอไปยัง Endpoint ด้วยการทดสอบ Context ขนาด 500K โทเค็น เพื่อยืนยันว่า KV Cache ทำงานได้อย่างถูกต้อง
- รัน Tool-calling flow แบบ End-to-End ก่อนที่คุณจะเชื่อมต่อ Agent loop
คอลเลกชันเดียวกับที่คุณใช้กับ DeepSeek V4 API แบบโฮสต์ สามารถใช้ได้กับเซิร์ฟเวอร์ภายในด้วยการเปลี่ยน Base-URL เพียงครั้งเดียว นั่นคือประโยชน์ของ Endpoint ที่เข้ากันได้กับ OpenAI
การตรวจสอบและการเฝ้าระวัง
สี่เมตริกที่ควรติดตามตั้งแต่วันแรก:
- โทเค็นต่อวินาที. ทั้งส่วน Prompt และ Generation vLLM เปิดเผยข้อมูลเหล่านี้ที่
/metricsในรูปแบบ Prometheus - การใช้ GPU.
nvidia-smiหรือ DCGM หากคงที่ต่ำกว่า 70% มักจะหมายความว่าขนาด Batch ของคุณไม่ถูกต้อง - อัตราการ Cache Hit ของ KV Cache. ด้วย
--enable-prefix-caching, vLLM จะรายงานสิ่งนี้; อัตราการ Hit ที่ลดลงบ่งชี้ถึง Prompt ที่มีการเปลี่ยนแปลงบ่อย ซึ่งส่งผลต่อปริมาณงาน - ความหน่วงของคำขอ p50/p95/p99. ใช้การ Trace แบบมาตรฐาน; p99 ที่เพิ่มขึ้นในขณะที่ p50 คงที่ หมายความว่ามีรูปแบบคำขอหนึ่งที่ทำให้คิวหยุดชะงัก
ส่งข้อมูลทั้งสี่ไปยัง Grafana หรือระบบ Observability อื่นๆ ที่คุณใช้งานอยู่
การ Fine-tuning เช็คพอยต์ V4 Base
เช็คพอยต์ Base มีไว้สำหรับการฝึกอบรมล่วงหน้าอย่างต่อเนื่องและการ SFT (Supervised Fine-Tuning) โดยมีขั้นตอนมาตรฐานดังนี้:
pip install "torch>=2.6" transformers accelerate peft trl

# Standard SFT with LoRA on V4-Flash-Base
python -m trl sft \
  --model_name_or_path deepseek-ai/DeepSeek-V4-Flash-Base \
  --dataset_name your-org/your-sft-set \
  --output_dir ./models/v4-flash-custom \
  --per_device_train_batch_size 1 \
  --gradient_accumulation_steps 16 \
  --learning_rate 2e-5 \
  --bf16 true \
  --use_peft true \
  --lora_r 64 \
  --lora_alpha 128
การ Fine-tuning แบบ Full-parameter บน V4-Pro เป็นงานวิจัยที่ซับซ้อน LoRA adapters บน V4-Flash-Base เป็นขีดจำกัดที่สมจริงสำหรับทีมส่วนใหญ่; ให้คุณภาพที่ดีขึ้นมาก โดยใช้การประมวลผลเพียงเล็กน้อย
ข้อผิดพลาดที่พบบ่อย
- OOM เมื่อเริ่มต้น. มักเกิดจาก
--max-model-lenถูกตั้งค่าสูงเกินกว่าที่ VRAM จะรองรับได้ หรือ--tensor-parallel-sizeถูกตั้งค่าต่ำเกินไป ลด Context ลงครึ่งหนึ่งหรือเพิ่ม Parallelism เป็นสองเท่า - คำขอแรกช้า. vLLM คอมไพล์ Kernel แบบ Lazy การเรียกใช้ครั้งแรกต่อรูปร่างจะช้าเสมอ; วอร์มอัพด้วยคำขอ Dummy
- ข้อผิดพลาดในการแยกวิเคราะห์การใช้งานเครื่องมือ. รูปแบบการเข้ารหัสของ DeepSeek แตกต่างจาก OpenAI เล็กน้อย ปักหมุด SDK ของคุณไปยังเวอร์ชันที่รองรับ V4 อย่างชัดเจน
- ข้อผิดพลาด FP8 บนการ์ดรุ่นเก่า. A100s ไม่รองรับ FP8 โดยกำเนิด ใช้ BF16 กับการ์ดใดๆ ที่ไม่ใช่ Hopper; คาดว่า VRAM จะเพิ่มขึ้นประมาณ 2 เท่า
เมื่อการโฮสต์ด้วยตัวเองเริ่มคุ้มค่า
การคำนวณจุดคุ้มทุนโดยประมาณ อ้างอิงจาก ราคา DeepSeek V4 แบบโฮสต์:
- V4-Flash ที่ 200 พันล้านโทเค็นอินพุตต่อเดือน + 20 พันล้านโทเค็นเอาต์พุตต่อเดือน: ประมาณ 33.6K ดอลลาร์สหรัฐฯ บน Hosted API การเช่าเซิร์ฟเวอร์ 8 × H100 มีค่าใช้จ่ายประมาณ 20K ดอลลาร์สหรัฐฯ ต่อเดือน การโฮสต์ด้วยตัวเองประหยัดได้ประมาณ 40%
- V4-Pro ที่ 500 พันล้านอินพุต + 50 พันล้านเอาต์พุตต่อเดือน: ประมาณ 1.04 ล้านดอลลาร์สหรัฐฯ บน Hosted API คลัสเตอร์ 16 × H100 มีค่าเช่าประมาณ 35K ดอลลาร์สหรัฐฯ ต่อเดือน การโฮสต์ด้วยตัวเองประหยัดได้มากกว่า 95%
จุดคุ้มทุนสำหรับ V4-Flash อยู่ที่ประมาณ 100 พันล้านโทเค็นต่อเดือนสำหรับการใช้งานจริง ต่ำกว่านั้น Hosted API จะถูกกว่า และค่าใช้จ่ายในการดำเนินงานไม่คุ้มค่า
คำถามที่พบบ่อย
- ฉันสามารถรัน V4-Flash บน A100 เพียงตัวเดียวได้หรือไม่? ด้วยการควอนไทซ์ที่หนักและ Context ที่สั้นลง สามารถทำได้ แต่จะช้า INT4 บน A100 ขนาด 80GB ทำงานที่ 5 ถึง 15 โทเค็น/วินาที สถาปัตยกรรมของ H100 คือสิ่งที่ต้องการสำหรับ V4
- V4 รองรับการ Fine-tuning แบบ LoRA หรือไม่? รองรับ ใช้เช็คพอยต์ Base และ Pipeline มาตรฐานของ TRL หรือ Axolotl การกำหนดเส้นทางของ MoE ไม่ได้เปลี่ยนแปลงหลักการของ LoRA
- เซิร์ฟเวอร์ภายในเครื่องเข้ากันได้กับ OpenAI หรือไม่? ใช่ ทั้ง vLLM และ SGLang เปิดเผย
/v1/chat/completionsและ/v1/completionsด้วยรูปแบบคำขอของ OpenAI คู่มือ Hosted API สามารถใช้งานกับ Localhost ได้โดยไม่มีการเปลี่ยนแปลง - ฉันจะเปิดใช้งาน Thinking Mode ในเครื่องได้อย่างไร? ส่ง
thinking_mode: "thinking"หรือ"thinking_max"ใน Request Body ทั้ง vLLM และ SGLang จะส่งแฟล็กนี้ไปยังโมเดล - ฉันสามารถสตรีมจาก V4 เซิร์ฟเวอร์ภายในได้หรือไม่? ได้ ตั้งค่า
stream: trueเหมือนที่คุณทำกับ OpenAI หรือ DeepSeek API แบบโฮสต์ - วิธีที่ถูกที่สุดในการทดลองก่อนซื้อฮาร์ดแวร์คืออะไร? เช่า H100 หนึ่งตัวบน RunPod หรือ Lambda เป็นเวลาสองสามชั่วโมง รัน V4-Flash ที่ INT4 และวัด Throughput เทียบกับ Prompt จริงของคุณ การทดสอบมูลค่า 10 ถึง 30 ดอลลาร์สหรัฐฯ จะตอบคำถามเกี่ยวกับฮาร์ดแวร์ได้เร็วกว่าการวางแผนเป็นสัปดาห์