DeepSeek ได้เผยแพร่น้ำหนักโมเดล DeepSeek-V4.1-Flash บน Hugging Face ภายใต้ใบอนุญาต MIT เมื่อวันที่ 10 กันยายน 2026 ซึ่งเป็นวันเดียวกับที่โมเดลเปิดให้บริการทั่วไป (GA) บน API นี่เป็นช่วงเวลาที่ไม่ปกติ ห้องแล็บส่วนใหญ่จะเปิดตัวเอนด์พอยต์แบบโฮสต์ก่อน แล้วจึงปล่อยน้ำหนักโมเดลในอีกหลายสัปดาห์ต่อมา หากมีการปล่อยเลย
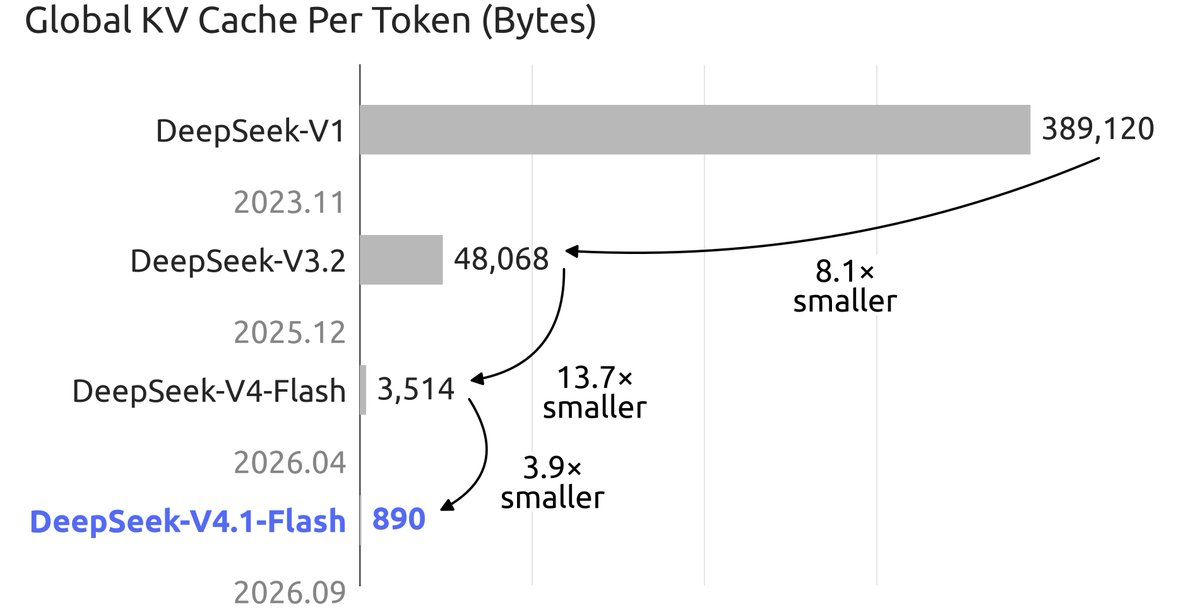
ตัวเลขพาดหัวอาจทำให้ผู้อ่านส่วนใหญ่ตกใจ: พารามิเตอร์ 552 พันล้านตัวในโครงสร้างหลัก และ 763 พันล้านตัวเมื่อรวมกับตัวเข้ารหัสภาพ แต่การออกแบบภายใต้นั้นเป็นมิตรกับการโฮสต์ด้วยตนเองมากกว่าที่ขนาดของโมเดลบ่งบอก มีเพียง 8 พันล้านพารามิเตอร์ที่ทำงานระหว่าง prefill และ 16 พันล้านพารามิเตอร์ระหว่าง decode และแคช FP4 KV แบบใหม่ใช้พื้นที่เพียง 890 ไบต์ต่อโทเค็น ซึ่งประมาณหนึ่งในสี่ของที่ V4-Flash ต้องการ การคำนวณนั้นถูก แต่หน่วยความจำคือข้อจำกัด
ไม่ว่าอย่างไรก็ตาม ผู้คนก็จะลองดูอยู่ดี คู่มือนี้จะให้ข้อมูลการคำนวณหน่วยความจำ เส้นทางที่เป็นไปได้สำหรับฮาร์ดแวร์แต่ละระดับ คำสั่งตั้งค่าทั่วไป และวิธีทดสอบเอนด์พอยต์ที่เข้ากันได้กับ OpenAI แบบโลคัลเทียบกับ API แบบโฮสต์ใน Apidog หากคุณต้องการภาพรวมของโมเดลก่อน ให้อ่าน DeepSeek-V4.1-Flash คืออะไร? แล้วค่อยกลับมาที่นี่
สรุป (TL;DR)
- น้ำหนักโมเดล: โครงสร้างหลัก MoE 552B, ใบอนุญาต MIT ประมาณ 552 GB ที่ 8-บิต, ประมาณ 280 GB ที่ 4-บิต, เฉพาะโครงสร้างหลักเท่านั้น
- แคช KV: 890 ไบต์ต่อโทเค็น บริบทเต็ม 1M โทเค็นต้องการประมาณ 0.9 GB ส่วนนี้ได้รับการแก้ไขแล้ว
- การให้บริการแบบ 4-บิตที่สมจริงต้องใช้ GPU ขนาด 80 GB จำนวน 4 ถึง 8 ตัว ทุกอย่างที่ต่ำกว่านั้นคือการใช้งาน CPU หรือ SSD offload ซึ่งจะช้า
- API แบบโฮสต์คิดค่าบริการ $0.15 ต่อ 1M โทเค็นอินพุตแบบ cache-miss ในช่วงนอกเวลาทำการ สำหรับทีมส่วนใหญ่ นี่ประหยัดกว่าค่าไฟฟ้าเพียงอย่างเดียว
สิ่งที่คุณกำลังดาวน์โหลด
การ์ดโมเดล อธิบายถึงโครงสร้างหลักแบบ Mixture-of-Experts ที่มีพารามิเตอร์ 552B พร้อมเลย์เอาต์ Causal Encoder-Decoder แบบใหม่: 40 เลเยอร์, แบ่งเป็น 20 ตัวเข้ารหัสและ 20 ตัวถอดรหัส แต่ละเลเยอร์จะส่งข้อมูลผ่านผู้เชี่ยวชาญ 384 คนบวกกับผู้เชี่ยวชาญที่ใช้ร่วมกัน 1 คน ตัวเข้ารหัสภาพ DeepSeek-ViT ทำให้เช็คพอยต์ทั้งหมดมีพารามิเตอร์ถึง 763B และคุณจะต้องดาวน์โหลดทั้งหมดแม้ว่าคุณจะต้องการเพียงข้อความก็ตาม
สามประเด็นสำคัญสำหรับการอนุมานในเครื่อง:
- พารามิเตอร์ที่ทำงานอยู่มีขนาดเล็ก 8B ทำงานระหว่าง prefill, 16B ทำงานระหว่าง decode จำนวน FLOPs ต่อโทเค็นดูเหมือนโมเดลขนาดกลางแบบหนาแน่น ปัญหาคือพารามิเตอร์ 552B ทุกตัวจะต้องอยู่ในตำแหน่งที่ forward pass สามารถเข้าถึงได้
- แคช KV เป็นแบบ FP4 บันทึกการเปิดตัว ระบุว่าแคชใช้ HBM เพียง 1/4 และพื้นที่จัดเก็บ SSD เพียง 1/8 เมื่อเทียบกับรุ่นก่อนหน้า ที่ 890 ไบต์ต่อโทเค็น บริบทแบบยาวจึงไม่ใช่ปัญหาด้านหน่วยความจำอีกต่อไป
- กลไก Attention ถูกออกแบบมาให้บางเบา (sparse) Compressed Sparse Attention 2 ที่มีสามโหมดคงที่ได้รับการฝึกฝนที่บริบท 64K และขยายไปถึง 1M ในช่วงท้ายของการรัน 45T-โทเค็น นี่คือเหตุผลที่ตัวเลข KV ยังคงเล็กเมื่อบริบทเป็น 1M
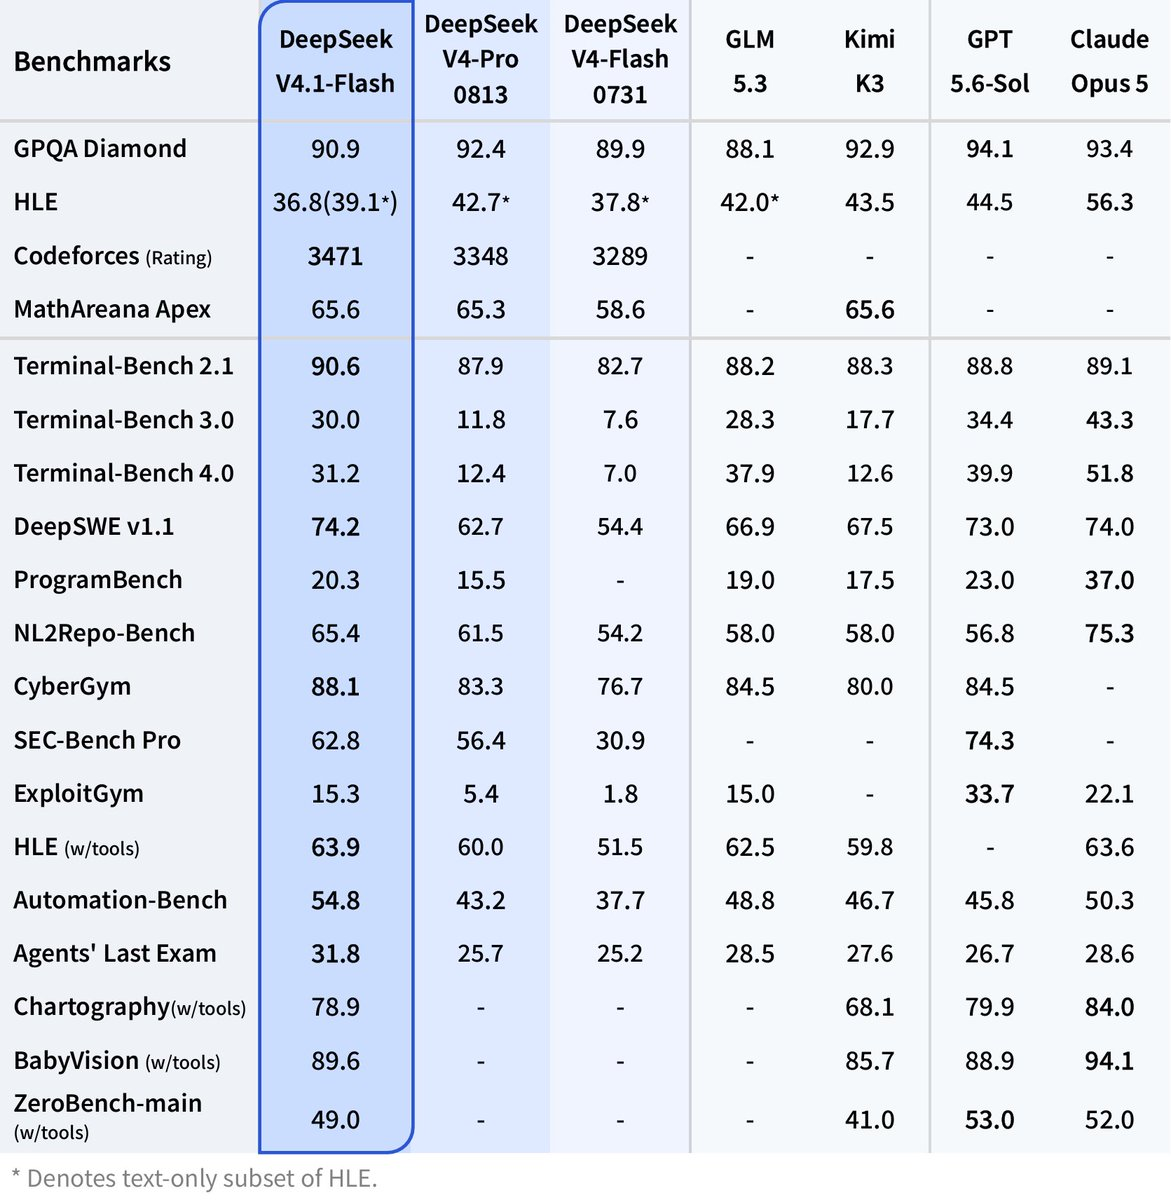
รายงานทางเทคนิค ครอบคลุมสถาปัตยกรรมทั้งหมด ตัวเลขเกณฑ์มาตรฐานทุกตัวบนการ์ดรายงานโดย DeepSeek; ให้ถือว่าเป็นข้อกล่าวอ้าง
การคำนวณหน่วยความจำ
ตัวเลขด้านล่างนี้เป็นการคูณโดยตรง ไม่ใช่การวัด และไม่รวมโอเวอร์เฮดของเอนจิน, activations, และตัวเข้ารหัสภาพ
| ส่วนประกอบ | ขนาด | วิธีการคำนวณ |
|---|---|---|
| น้ำหนักโครงสร้างหลัก, 8-บิต | ~552 GB | 552B พารามิเตอร์ x 1 ไบต์ |
| น้ำหนักโครงสร้างหลัก, 4-บิต | ~280 GB | 552B พารามิเตอร์ x 0.5 ไบต์ |
| แคช KV, ต่อโทเค็น | 890 ไบต์ | จากการ์ดโมเดล |
| แคช KV ที่บริบท 128K | ~0.11 GB | 890 x 128,000 |
| แคช KV ที่บริบท 1M | ~0.89 GB | 890 x 1,000,000 |
มีสองสิ่งที่โดดเด่น ประการแรก แคช KV เป็นเพียงค่าปัดเศษ เซสชัน 1M โทเค็นใช้พื้นที่ไม่ถึงหนึ่งกิกะไบต์ ดังนั้นคุณสามารถเก็บเซสชันยาวๆ ได้หลายสิบเซสชันโดยไม่กระทบงบประมาณน้ำหนักโมเดล ประการที่สอง น้ำหนักโมเดลคือปัญหาทั้งหมด ไม่มีเทคนิคการหาปริมาณใดที่จะทำให้พารามิเตอร์ 552B พอดีกับ GPU สำหรับผู้บริโภคเครื่องเดียวได้ และการออกแบบ 8B-active ก็ไม่ได้ช่วยอะไร เพราะการกำหนดเส้นทางแบบ MoE ยังคงต้องการให้ผู้เชี่ยวชาญทุกคนถูกโหลดและสามารถเข้าถึงได้
นั่นเป็นเหตุผลที่การตั้งค่าแบบ offloaded รู้สึกไม่สมดุล Prefill จะประมวลผลเป็นชุดข้อมูลตลอดทั้ง prompt และยังคงถูกจำกัดด้วยการคำนวณ Decode จะเรียกพารามิเตอร์ที่ใช้งานอยู่ 16B จาก RAM หรือ SSD สำหรับทุกโทเค็น แบนด์วิดท์ต่างหาก ไม่ใช่ FLOPs ที่เป็นตัวกำหนดจำนวนโทเค็นต่อวินาทีของคุณ
ระดับฮาร์ดแวร์ที่เป็นไปได้จริง
ไม่มีตัวเลข throughput (ปริมาณงาน) ในที่นี้ ไม่มีใครนอก DeepSeek ที่มีน้ำหนักโมเดลนานพอที่จะเผยแพร่เกณฑ์มาตรฐานที่เชื่อถือได้
ระดับ 1: เซิร์ฟเวอร์หลาย GPU, การ์ด 4 ถึง 8 ใบในคลาส 80 GB การ์ด 80 GB สี่ใบให้คุณ 320 GB ซึ่งเพียงพอสำหรับน้ำหนักโมเดล 4-บิต พร้อมพื้นที่เล็กน้อยสำหรับแคช KV และโอเวอร์เฮดของเอนจิน การ์ดแปดใบให้คุณ 640 GB ซึ่งเพียงพอสำหรับเช็คพอยต์ 8-บิต หรือการปรับใช้ 4-บิตที่สะดวกสบายด้วยแบทช์ขนาดใหญ่ นี่เป็นระดับเดียวที่ “รันในเครื่อง” หมายถึงการให้บริการระดับโปรดักชันด้วย tensor parallelism และเป็นการลงทุนห้าหรือหกหลัก หรือการเช่าคลาวด์หลายดอลลาร์ต่อชั่วโมง
ระดับ 2: เวิร์กสเตชันหน่วยความจำสูงเครื่องเดียวพร้อม CPU offload คอมพิวเตอร์ที่มี RAM ระบบ 512 GB ขึ้นไปและ GPU หนึ่งหรือสองตัวสามารถเก็บน้ำหนักโมเดล 4-บิตใน RAM และส่งสตรีมเลเยอร์ผู้เชี่ยวชาญไปยัง GPU ตามความต้องการ มันใช้งานได้ แต่ช้า เพราะแบนด์วิดท์ของ decode คือบัส DDR5 ของคุณแทนที่จะเป็น HBM ใช้สำหรับการประมวลผลแบบแบทช์และการประเมินผลข้ามคืน ไม่ใช่สำหรับการสนทนาแบบโต้ตอบ
ระดับ 3: Apple Silicon พร้อมการสตรีมจาก SSD เส้นทางสำหรับผู้ที่ชื่นชอบ Mac Studio ขนาด 512 GB สามารถเก็บน้ำหนักโมเดล 4-บิตในหน่วยความจำแบบรวม (unified memory) ซึ่งเป็นตัวเลือกที่ใช้งานได้จริงหากคุณมีอยู่แล้ว ต่ำกว่านั้น คุณจะอยู่ในอาณาเขตของ กระทู้ Kimi K3 HN: น้ำหนักโมเดลถูกแบ่งเก็บใน SSD ภายนอก, mmap ทำงานหนัก, ได้ประมาณ 1 โทเค็นต่อวินาที มันพิสูจน์ว่าโมเดลทำงานได้ แต่ไม่ได้หมายความว่ามันมีประโยชน์บนเครื่องนั้น คู่มือของเราเกี่ยวกับการรัน Kimi K3 ในเครื่อง ครอบคลุมการแลกเปลี่ยนเดียวกันกับโมเดลที่ใหญ่กว่า และ วิธีการรัน DeepSeek V4 ในเครื่อง ครอบคลุมรุ่นก่อนหน้า
เส้นทางการตั้งค่า
เมื่อมีฮาร์ดแวร์พร้อมแล้ว ขั้นตอนคือ: ดาวน์โหลด, ให้บริการผ่านเอนด์พอยต์ที่เข้ากันได้กับ OpenAI, ทดสอบ
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
บนสาย 1 Gbps, ทุก 100 GB ใช้เวลาประมาณ 15 นาทีที่ความเร็วเต็มที่ ควรเผื่อเวลาไว้หนึ่งชั่วโมงหรือมากกว่า
การให้บริการคือจุดที่ต้องระมัดระวัง การสนับสนุน Day-0 ใน vLLM, SGLang, llama.cpp และ Ollama สำหรับสถาปัตยกรรม CED และ CSA2 attention นั้น [ตรวจสอบ]; ประเภทเลเยอร์ใหม่มักจะต้องมีการแก้ไขเอนจินก่อนที่น้ำหนักโมเดลจะถูกโหลด และบันทึกการเปิดตัวไม่ได้ระบุชื่อเอนจินเฉพาะ ค้นหาบันทึกการเปลี่ยนแปลงของแต่ละโปรเจกต์สำหรับ “DeepSeek-V4.1” ก่อนที่คุณจะตัดสินใจดาวน์โหลด เมื่อมีการสนับสนุนแล้ว การให้บริการด้วย vLLM ข้าม 8 GPU จะมีลักษณะดังนี้:
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
`llama-server` ของ llama.cpp หรือโมเดล Ollama จะเปิดเผยเอนด์พอยต์สไตล์ `http://localhost:8000/v1` เดียวกันเมื่อมีการแปลง GGUF แล้ว ดังนั้นไคลเอ็นต์ OpenAI SDK ใดๆ ก็สามารถทำงานได้โดยการเปลี่ยนเพียงบรรทัดเดียว:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
ค่า `temperature=1.0` และ `top_p=0.95` ตรงกับการตั้งค่าที่แนะนำในการ์ดโมเดล สำหรับ Ollama, คู่มือ Ollama ของเราครอบคลุมขั้นตอน Modelfile และ คู่มือ vLLM ครอบคลุมแฟล็ก multi-GPU อย่างละเอียด
ทางเลือกที่เป็นประโยชน์: API แบบโฮสต์
ในช่วงนอกเวลาทำการ หน้าราคา ระบุว่า `deepseek-flash` คิดค่าบริการ $0.15 ต่อ 1M โทเค็นอินพุตแบบ cache-miss, $0.003 ต่อ 1M โทเค็นอินพุตแบบ cache-hit และ $0.60 ต่อ 1M โทเค็นเอาต์พุต ในช่วงเวลาเร่งด่วน ราคาจะเพิ่มเป็นสองเท่า ดังนั้น 1 พันล้านโทเค็นอินพุตบวก 200 ล้านโทเค็นเอาต์พุตต่อเดือนจะมีค่าใช้จ่ายประมาณ $270 ในช่วงนอกเวลาทำการ และ $540 ในช่วงเวลาเร่งด่วน ก่อนที่ cache hits จะลดฝั่งอินพุตลงอีก เซิร์ฟเวอร์ 8-GPU ในคลาส 80 GB มีค่าใช้จ่ายต่อเดือนมากกว่านั้นเฉพาะค่าไฟฟ้าและค่าทำความเย็นภายใต้การใช้งานอย่างต่อเนื่อง ก่อนที่คุณจะตัดค่าเสื่อมราคาฮาร์ดแวร์หรือจ้างคนดูแล เว้นแต่คุณจะมีกฎการเก็บรักษาข้อมูล (data-residency rule) หรือฮาร์ดแวร์ที่ว่างอยู่แล้ว API ก็คุ้มค่ากว่า การเปลี่ยนทำได้ง่ายๆ เพียงแค่เปลี่ยน `base_url` คู่มือ API ของ DeepSeek-V4.1-Flash ของเราจะอธิบายวิธีการ
การรันในเครื่องจะดีกว่าเมื่อข้อจำกัดไม่ใช่เรื่องเงิน: สภาพแวดล้อมแบบ air-gapped, ข้อมูล prompt ที่คุณไม่สามารถส่งออกไปที่ใดได้ หรือการวิจัยที่ต้องการปรับเปลี่ยนน้ำหนักโมเดล
ทดสอบเอนด์พอยต์ในเครื่องเทียบกับ API แบบโฮสต์ใน Apidog
ไม่ว่าจะเลือกทางไหน ให้ทดสอบก่อนที่จะเชื่อถือ กำหนด Apidog ไปยังเอนด์พอยต์ทั้งสอง รันคำขอที่บันทึกไว้ชุดเดียวกัน และปล่อยให้ assertion บอกคุณว่าบิลด์ในเครื่องของคุณตรงกับเวอร์ชันอ้างอิงหรือไม่
- สร้างสองสภาพแวดล้อม หนึ่งชื่อ `local` โดยตั้งค่า `base_url` เป็น `http://localhost:8000/v1` และอีกหนึ่งชื่อ `hosted` โดยตั้งค่า `base_url` เป็น `https://api.deepseek.com` และคีย์จริงของคุณ ทุกคำขอจะใช้ `{{base_url}}/chat/completions` และ `Bearer {{api_key}}`
- บันทึกชุด prompt ขนาดเล็กเป็นคำขอ Prompt ห้าถึงสิบ prompt ที่แสดงถึงปริมาณงานของคุณ: การแยก JSON, การแก้ไขโค้ด, สรุปบริบทแบบยาว ตั้งค่า `model` เป็น `deepseek-flash` ในทุกคำขอ เพราะมันทำงานได้ทั้งบนเซิร์ฟเวอร์ทั้งสอง
- เพิ่ม assertion สำหรับงาน JSON ให้ยืนยันว่าการตอบกลับสามารถแยกวิเคราะห์ได้และมีคีย์ที่จำเป็นอยู่ สำหรับทุกคำขอ ให้ยืนยันว่า `finish_reason` เท่ากับ `stop` ซึ่งจะช่วยจับการตัดทอนที่เกิดจากการตั้งค่าบริบทที่ไม่ถูกต้อง
- รันชุดคำขอเทียบกับทั้งสองสภาพแวดล้อม สลับดรอปดาวน์สภาพแวดล้อมจาก `hosted` เป็น `local` และรันสถานการณ์ทดสอบเดิมซ้ำ ความล้มเหลวที่ปรากฏเฉพาะบน `local` คือปัญหาการหาปริมาณหรือเทมเพลตของคุณ ซึ่งสามารถแยกแยะได้ด้วยการคลิกเดียว
- ดูการสตรีม ตั้งค่า `stream: true` และใช้มุมมอง SSE เพื่อดูเหตุการณ์ที่มาถึงทีละรายการ เซิร์ฟเวอร์ในเครื่องที่บัฟเฟอร์การตอบกลับทั้งหมดก่อนส่งจะดูปกติในการเรียกที่ไม่ใช่การสตรีม แต่จะผิดพลาดในที่นี้
- รวมเข้าใน CI รันสถานการณ์ด้วย `apidog-cli` ในทุกการอัปเกรดเอนจิน เพื่อให้เทมเพลตแชทที่เสียจะทำให้ไปป์ไลน์ล้มเหลวแทนผู้ใช้
ดาวน์โหลด Apidog และขั้นตอนทั้งหมดจะรันจากโปรเจกต์เดียว
คำถามที่พบบ่อย (FAQ)
- ฉันสามารถรัน DeepSeek-V4.1-Flash บนแล็ปท็อปได้หรือไม่? ไม่ได้มีประโยชน์มากนัก โครงสร้างหลัก 4-บิตมีขนาดประมาณ 280 GB แล็ปท็อปสามารถสตรีมจาก SSD ได้เช่นเดียวกับการทดลอง Kimi K3 ที่ความเร็วประมาณ 1 โทเค็นต่อวินาที ซึ่งเป็นแค่การสาธิต ไม่ใช่การทำงานจริง ใช้ API หรือหนึ่งในตัวเลือกใน วิธีใช้ DeepSeek-V4.1-Flash ฟรี
- พารามิเตอร์ที่ทำงานอยู่ 8B หมายความว่าฉันต้องการ VRAM เพียง 8 GB ใช่หรือไม่? ไม่ใช่ พารามิเตอร์ที่ทำงานอยู่กำหนดการคำนวณต่อโทเค็น ไม่ใช่หน่วยความจำ การกำหนดเส้นทาง MoE สามารถเลือกผู้เชี่ยวชาญคนใดก็ได้จาก 384 คนต่อเลเยอร์สำหรับโทเค็นใดๆ ดังนั้นพารามิเตอร์ทั้งหมด 552B จะต้องถูกโหลดและเข้าถึงได้
- บริบท 1M ต้องการหน่วยความจำเท่าใด? ประมาณ 0.89 GB ของแคช KV ที่ 890 ไบต์ต่อโทเค็น นี่คือส่วนที่ราคาถูกของโมเดลนี้ น้ำหนักโมเดลคือส่วนที่มีราคาแพง
- ใบอนุญาตปลอดภัยสำหรับการใช้งานเชิงพาณิชย์หรือไม่? ใช่ น้ำหนักโมเดลเป็นของ MIT ตามการ์ดโมเดลของ Hugging Face
สิ่งนี้บอกอะไรคุณได้บ้าง
DeepSeek-V4.1-Flash เป็นโอเพนซอร์สในด้านที่สำคัญทางกฎหมายและเทคนิค: น้ำหนักโมเดล MIT, รายงานทางเทคนิคสาธารณะ และการออกแบบแคช KV ที่ทำให้เซสชัน 1M โทเค็นแทบไม่ใช้หน่วยความจำ มันไม่ได้เปิดเผยในลักษณะที่คุณสามารถรันบนเครื่องใต้โต๊ะของคุณได้ สำหรับทีมส่วนใหญ่ การเลือกใช้ API แบบโฮสต์ที่ราคา $0.15 ต่อ 1M โทเค็นอินพุตในช่วงนอกเวลาทำการคือทางเลือกที่เหมาะสม โดยจะสงวนการปรับใช้ในเครื่องไว้สำหรับข้อมูลที่ไม่สามารถออกจากอาคารได้
ไม่ว่าจะเลือกทางไหน ให้ทดสอบก่อนที่จะเชื่อถือ กำหนด Apidog ไปยังเอนด์พอยต์ทั้งสอง รันคำขอที่บันทึกไว้ชุดเดียวกัน และปล่อยให้ assertion บอกคุณว่าบิลด์ในเครื่องของคุณตรงกับเวอร์ชันอ้างอิงหรือไม่