
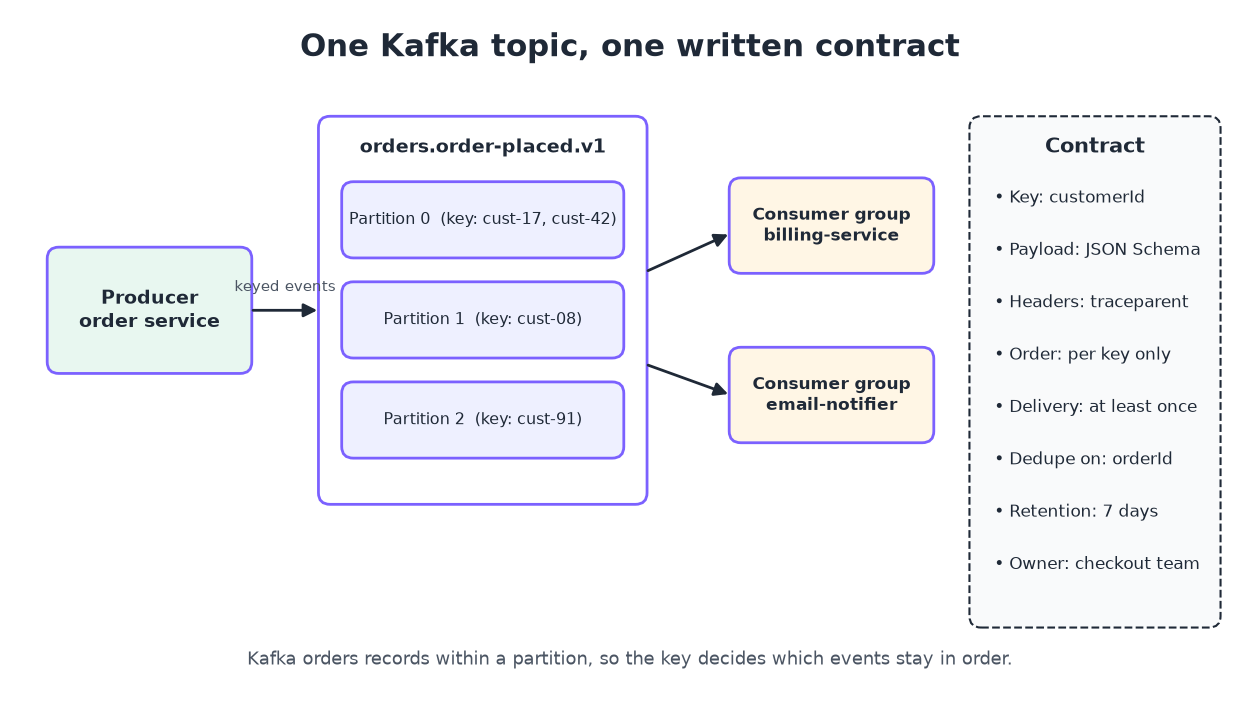
ในการจัดทำเอกสารสำหรับ Kafka APIs คุณควรเขียน contract สำหรับทุก topic โดย contract นั้นต้องระบุชื่อ topic, event key, payload schema, headers, การรับประกันเรื่องลำดับและการส่งมอบข้อมูล, consumer groups, ระยะเวลา retention และเจ้าของ จากนั้นเก็บ contract นั้นไว้ข้างเอกสาร HTTP API ของคุณ เพื่อให้ producers และ consumers อ่านข้อมูลจากแหล่งความจริง (source of truth) เดียวกัน แทนที่จะต้องถอดรหัสโครงสร้างข้อความจาก cluster ที่กำลังใช้งานจริง
คู่มือนี้ครอบคลุมแต่ละส่วนของ contract, วิธีเขียนในรูปแบบ AsyncAPI, วิธีพัฒนา schema อย่างปลอดภัย และวิธีให้ coding agent ของคุณทำงานเหล่านี้โดยใช้ Apidog CLI
หากคุณเพิ่งเริ่มต้นกับการออกแบบแบบ event-driven ลองเริ่มจากบทความ วิธีสร้าง event-driven APIs และ คู่มือเกี่ยวกับ webhooks และ event-driven architecture
Kafka API คืออะไร?
Kafka API คือชุดของ topics, รูปแบบข้อความ และกฎการส่งมอบข้อมูลที่ services ใช้แลกเปลี่ยน events ผ่าน Apache Kafka cluster ซึ่งแตกต่างจาก REST API ตรงที่ไม่มีใครเรียก endpoint แล้วรอ response Producers จะเขียน records ลงใน topics, consumers จะอ่านตามจังหวะของตัวเอง และ contract จะอยู่ในโครงสร้างและความหมายของ records เหล่านั้น
เอกสารของ Kafka อธิบายไว้อย่างตรงไปตรงมาว่า "event ประกอบด้วย key, value, timestamp และ metadata headers ที่เป็นทางเลือก" Kafka เองไม่ได้ตรวจสอบว่ามีอะไรอยู่ภายใน value Producer สามารถเขียน JSON ในวันนี้ และเขียน JSON ในรูปแบบอื่นในวันพรุ่งนี้ โดย broker จะยอมรับทั้งสองแบบ นั่นคือเหตุผลว่าทำไม Kafka APIs จึงต้องการ contract ที่เขียนเป็นลายลักษณ์อักษรมากกว่า HTTP APIs: เพราะไม่มีอะไรในชั้น transport ที่จะหยุดการเปลี่ยนแปลงที่ทำให้ระบบพังได้
Topics ที่ไม่มีเอกสารมักล้มเหลวในลักษณะที่คาดเดาได้: consumer เดาชนิดข้อมูลของ field จากตัวอย่างเดียวแล้วพังเมื่อเจอ null หรือ service ใหม่ไม่รู้ว่าตัวเองจะได้รับข้อความแต่ละข้อความอย่างน้อยหนึ่งครั้ง จึงคิดเงินซ้ำเมื่อมีการ retry
สิ่งที่ต้องจัดทำเอกสารสำหรับ Kafka topic แต่ละตัว
ทุก topic ต้องมีข้อมูลหลักชุดเดียวกัน ใช้ตารางนี้เป็น checklist ของคุณ:
| ฟิลด์ของ contract | สิ่งที่ต้องบันทึก | ตัวอย่าง |
|---|---|---|
| ชื่อ topic | ชื่อเต็มและรูปแบบการตั้งชื่อ | orders.order-placed.v1 |
| วัตถุประสงค์ | ประโยคเดียวที่อธิบายความหมายของ event | “คำสั่งซื้อผ่านการชำระเงินแล้วและพร้อมจัดส่ง” |
| Event key | ฟิลด์ใดเป็น key และเพราะอะไร | customerId เพื่อให้คำสั่งซื้อของลูกค้าแต่ละคนเรียงลำดับถูกต้อง |
| Payload schema | ทุกฟิลด์ ชนิดข้อมูล ค่า required และ format | JSON Schema, Avro หรือ Protobuf |
| Headers | ชื่อ ชนิดข้อมูล และความหมายของแต่ละ header | traceparent, schema-version |
| Partitions และลำดับ | จำนวน partitions และการรับประกันเรื่องลำดับ | 12 partitions, เรียงลำดับตาม customerId |
| Delivery semantics | At least once, idempotent producer, transactions | At least once; consumers ต้อง deduplicate ด้วย orderId |
| Consumer groups | Groups ที่รู้จักและหน้าที่ของแต่ละกลุ่ม | billing-service, email-notifier |
| Retention | ระยะเวลาที่ records ยังอ่านได้ | 7 วัน |
| ความเป็นเจ้าของ | ทีมเจ้าของ ช่องทางติดต่อ และนโยบายเวอร์ชัน | ทีม Checkout, #checkout-events |
แถวเรื่องลำดับและการส่งมอบสำคัญที่สุด: เพราะผู้อ่านไม่สามารถอนุมานสิ่งเหล่านี้จากข้อความตัวอย่างได้
วิธีจัดทำเอกสาร Kafka APIs ใน 6 ขั้นตอน
- ระบุทุก topic และเจ้าของของมัน ดึงรายการ topics จาก cluster ของคุณและระบุว่าใครเป็นผู้เขียนลงแต่ละตัว
- กำหนด key บันทึกว่าฟิลด์ใดเป็น key และสิ่งนั้นมีผลต่อลำดับอย่างไร
- เขียน payload schema อธิบายทุกฟิลด์ด้วย JSON Schema, Avro หรือ Protobuf
- อธิบาย headers และ metadata รวมถึง headers สำหรับ tracing, เวอร์ชัน schema และ content type
- ระบุการรับประกัน จัดทำเอกสารเรื่อง delivery semantics, ขอบเขตของลำดับ, retention และ consumer groups
- เผยแพร่ไว้ที่ที่คนมองหา วาง contract ไว้ข้างเอกสาร HTTP API ของคุณ และทำ versioning เหมือนโค้ด
ขั้นตอนที่ 1 และ 2: topics และ keys
รูปแบบการตั้งชื่ออย่าง <domain>.<event>.<version> บอกผู้อ่านว่าใครเป็นเจ้าของ topic และกำลังอ่านเวอร์ชันใด จากนั้นจัดทำเอกสารเรื่อง key เพราะมันเป็นตัวกำหนด partition เอกสารของ Kafka ระบุว่า "events ที่มี event key เดียวกัน (เช่น customer หรือ vehicle ID) จะถูกเขียนลง partition เดียวกัน" และ consumers จะอ่าน events ของ partition หนึ่ง "ตามลำดับเดียวกันกับตอนที่ถูกเขียน"
ดังนั้น contract ของคุณควรระบุว่า "เรียงลำดับตาม customerId" ไม่ใช่แค่ "เรียงลำดับ" Kafka รับประกันลำดับเฉพาะภายใน partition เท่านั้น ไม่เคยรับประกันทั่วทั้ง topic
ขั้นตอนที่ 3: payload schema
Payload คือส่วนที่ consumers ใช้เขียนโค้ดต่อ ดังนั้นอธิบายมันทีละฟิลด์ นี่คือ JSON Schema สำหรับ event order-placed:
{
  "type": "object",
  "required": ["orderId", "customerId", "totalCents", "currency", "placedAt"],
  "properties": {
    "orderId": { "type": "string", "description": "Unique order ID; use it to deduplicate" },
    "customerId": { "type": "string", "description": "Also the record key" },
    "totalCents": { "type": "integer", "minimum": 0 },
    "currency": { "type": "string", "enum": ["USD", "EUR", "GBP"] },
    "placedAt": { "type": "string", "format": "date-time" },
    "couponCode": { "type": ["string", "null"] }
  }
}
คำอธิบายว่า "use it to deduplicate" บอก consumer ว่าควรใช้ฟิลด์นั้นทำอะไร ไม่ใช่แค่บอกชนิดข้อมูล หากคุณยังไม่คุ้นเคยกับฟอร์แมตนี้ ลองอ่านบทความ JSON Schema คืออะไร
ขั้นตอนที่ 4 และ 5: headers และการรับประกัน
ระบุ header แต่ละตัว (trace context, schema version, content type) และระบุว่า consumers สามารถพึ่งพามันได้หรือไม่ จากนั้นเขียนเรื่องการรับประกันการส่งมอบโดยใช้ศัพท์เดียวกับของ Kafka เอกสาร design ของ Kafka ระบุว่า "Kafka รับประกันการส่งมอบแบบ at-least-once เป็นค่าเริ่มต้น" ซึ่งหมายความว่าข้อความ "จะไม่สูญหายแต่อาจถูกส่งซ้ำ" หาก producer ของคุณใช้ตัวเลือก idempotent หรือ transactions ให้ระบุไว้ หากไม่ใช้ ให้บอก consumers ว่าต้อง deduplicate และระบุฟิลด์ที่ใช้ deduplicate
จัดทำเอกสาร consumer groups ด้วย ภายในกลุ่มที่ subscribe แต่ละกลุ่ม partition หนึ่ง "จะถูกอ่านโดย consumer เพียงหนึ่งตัว" ในแต่ละช่วงเวลา สิ่งนี้บอกผู้อ่านว่ากลุ่มหนึ่งขยายตัว (scale out) ได้มากแค่ไหน: หนึ่ง consumer ที่ใช้งานจริงต่อหนึ่ง partition
เขียน contract ด้วย AsyncAPI
เครื่องมือต่างๆ ต้องการฟอร์แมตที่เครื่องอ่านได้ และสำหรับ Kafka นั่นก็คือ AsyncAPI ซึ่งเป็น specification "ที่ใช้อธิบาย message-driven APIs ในรูปแบบที่เครื่องอ่านได้" โดยทำหน้าที่เหมือนกับที่ OpenAPI ทำสำหรับ REST
เอกสาร AsyncAPI 3.0 ประกอบด้วย info, servers, channels, operations และ components โดย channel จะ map ไปยัง topic ผ่าน address และแต่ละ operation จะมี action เป็น send หรือ receive:
asyncapi: 3.0.0
info:
  title: Orders events
  version: 1.0.0
channels:
  orderPlaced:
    address: orders.order-placed.v1
    messages:
      orderPlaced:
        $ref: '#/components/messages/orderPlaced'
operations:
  publishOrderPlaced:
    action: send
    channel:
      $ref: '#/channels/orderPlaced'
components:
  messages:
    orderPlaced:
      payload:
        $ref: './schemas/order-placed.json'
AsyncAPI ยังมี Kafka bindings ในระดับ server, channel, operation และ message อีกด้วย ซึ่งเป็นที่สำหรับรายละเอียดเฉพาะของ Kafka ที่ฟิลด์ทั่วไปไม่สามารถแสดงได้ เก็บ spec ไว้ใน repo ของ producer เพื่อให้ pull request ที่แก้ไข event ยังแก้ไข contract ของมันด้วย
วิวัฒนาการของ Kafka schema: จัดทำเอกสารกฎความเข้ากันได้
Schema ของคุณย่อมเปลี่ยนแปลง contract ควรระบุว่าการเปลี่ยนแปลงแบบใดปลอดภัย หากคุณใช้ schema registry ให้จัดทำเอกสาร compatibility mode ของมัน เอกสาร schema evolution ของ Confluent แสดงรายการโหมดเหล่านี้ พร้อมระบุว่า "ค่า compatibility type เริ่มต้นของ Confluent Schema Registry คือ BACKWARD":
| โหมด | ใครอ่านอะไรได้ |
|---|---|
| BACKWARD | Consumers ที่ใช้ schema ใหม่สามารถอ่านข้อมูลที่เขียนด้วย schema ก่อนหน้า |
| BACKWARD_TRANSITIVE | Consumers ที่ใช้ schema ใหม่สามารถอ่านข้อมูลจาก schema เก่าทั้งหมด |
| FORWARD | Consumers ที่ใช้ schema เดิมสามารถอ่านข้อมูลที่เขียนด้วย schema ใหม่ |
| FORWARD_TRANSITIVE | Consumers ที่ใช้ schema เก่ารุ่นใดก็ได้สามารถอ่านข้อมูลที่เขียนด้วย schema ใหม่ |
| FULL | เข้ากันได้ทั้ง backward และ forward กับ schema ก่อนหน้า |
| FULL_TRANSITIVE | เข้ากันได้ทั้ง backward และ forward กับ schema เก่าทั้งหมด |
| NONE | ปิดการตรวจสอบความเข้ากันได้ |
ในทางปฏิบัติ ภายใต้ BACKWARD คุณสามารถเพิ่ม optional fields และลบฟิลด์ที่มีค่า default ได้ การเปลี่ยนชื่อ required field หรือเปลี่ยนชนิดข้อมูลของมันจะทำให้ consumers พัง เมื่อจำเป็นต้องมี breaking change ให้เผยแพร่ topic เวอร์ชันใหม่ (orders.order-placed.v2) จัดทำเอกสารทั้งสองเวอร์ชัน และกำหนดวันยกเลิกสำหรับเวอร์ชันเก่า
ให้ coding agent ของคุณจัดทำเอกสาร Kafka APIs ด้วย Apidog CLI
Contract ที่เขียนด้วยมือจะคลาดเคลื่อนทันทีที่มีคนแก้ไข producer Coding agent ของคุณสามารถอ่านโค้ด producer, เขียน schemas และรักษาเอกสารให้ตรงกันขณะที่คุณทำการตรวจสอบ Apidog CLI มอบคำสั่งที่จำเป็นให้กับ Claude Code, Codex, Cursor หรือ agent แบบ terminal ใดก็ได้ เพื่อทำสิ่งนี้ในโปรเจกต์ Apidog
ติดตั้ง CLI, ล็อกอิน และเพิ่ม Apidog skill เพื่อให้ agent ของคุณรู้จักคำสั่งต่างๆ:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
คุณยังสามารถมอบงานตั้งค่าให้ agent ทำได้เลย: บอกให้มันอ่าน คู่มือติดตั้ง Apidog CLI แล้วตั้งค่าให้ตัวเอง
จากนั้นสั่ง agent ของคุณด้วย prompt เดียว:
Read the Kafka producers in ./services/orders. For every topic they write to,
create an Apidog data schema in project <projectId> for the message payload,
then create one Markdown doc per topic with the key, headers, ordering,
delivery guarantee, consumer groups, retention and owner. Validate every
payload before you write it.
Agent จะตรวจสอบโครงสร้าง payload, validate ไฟล์ แล้วเขียน schema และหน้า contract:
apidog cli-schema get schema-create
apidog cli-schema validate schema-create --file order-placed.schema.json
apidog schema create --project <projectId> --file order-placed.schema.json
apidog cli-schema get doc-create
apidog doc create --project <projectId> --file order-placed.doc.json
apidog schema list --project <projectId>
apidog schema create จะเก็บ payload เป็น data schema ที่ใช้ซ้ำได้ Endpoint HTTP ของคุณสามารถอ้างอิง model เดียวกันได้ ทำให้ Order ที่นิยามครั้งเดียวใช้ได้ทั้งกับ REST response และ Kafka event apidog doc create จะเขียนเอกสาร Markdown ลงในโครงสร้างโปรเจกต์ ซึ่งเก็บ contract ของ topic ตามตารางด้านบน เมื่อมีการแก้ไข producer ให้รัน prompt อีกครั้ง และ agent จะใช้ apidog schema update สำหรับคำแนะนำแบบละเอียดเพิ่มเติมเกี่ยวกับงานเอกสารด้วย agent ดูได้ที่ วิธีจัดทำเอกสาร APIs จาก CLI และ Apidog CLI ใน Claude Code
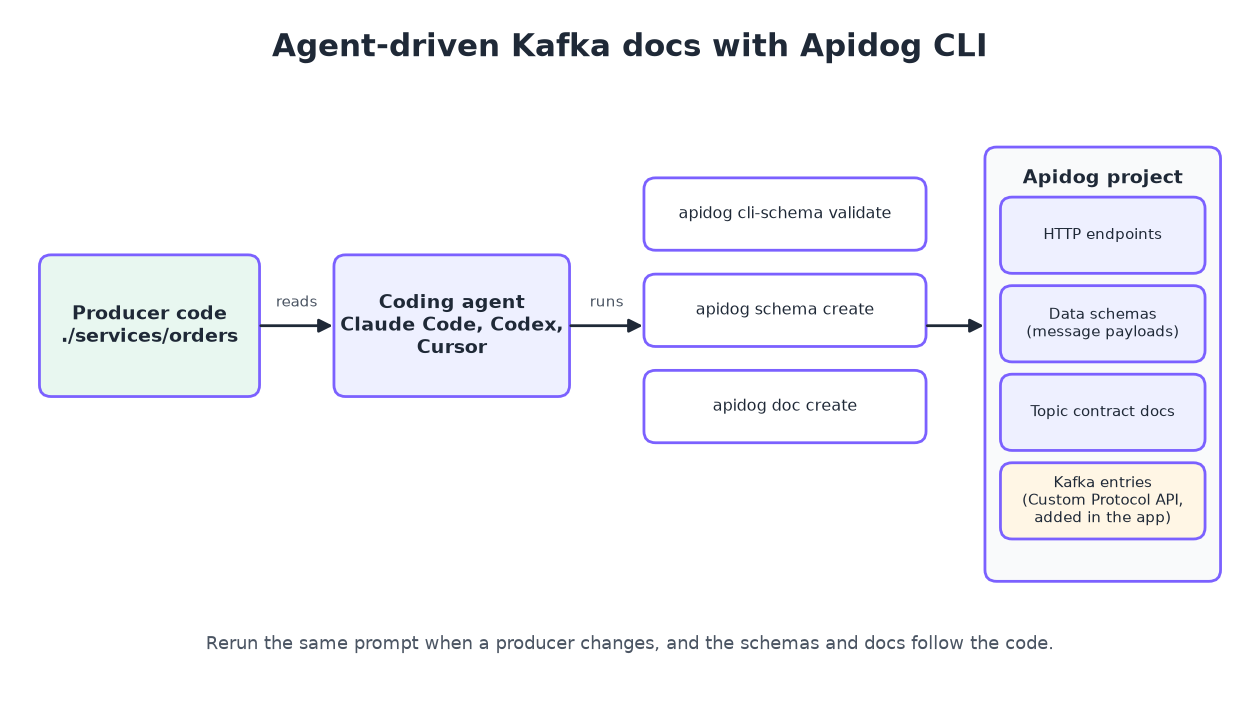
มีหนึ่งขั้นตอนที่ต้องทำในแอป คือ Apidog's Custom Protocol API จัดทำเอกสาร Kafka endpoints ควบคู่กับ HTTP endpoints: เลือก New Other Protocol APIs แล้วเลือก Other Custom Protocol API เลือก Kafka เป็น protocol และกรอก URI (ซึ่งก็คือ topic), ชื่อ, สถานะ, ผู้ดูแล, tags และคำอธิบาย รายการเหล่านี้ใช้โครงสร้างโฟลเดอร์, การค้นหา และ Quick Share ร่วมกับเอกสาร HTTP ของคุณ ในปัจจุบัน CLI ยังไม่มีคำสั่งสำหรับ custom protocol endpoints ดังนั้นนี่คือส่วนเดียวที่คุณต้องสร้างด้วยตนเอง
Apidog Free รองรับผู้ใช้ได้ถึง 4 คน ทำให้ทีมเล็กสามารถเก็บเอกสาร REST และ Kafka ไว้ในโปรเจกต์เดียวโดยไม่มีค่าใช้จ่าย
คำถามที่พบบ่อย
มี OpenAPI สำหรับ Kafka หรือไม่?
AsyncAPI ทำหน้าที่แทน โดยอธิบาย servers, channels (topics), operations และ message payloads ในรูปแบบ YAML หรือ JSON พร้อม bindings เฉพาะสำหรับ Kafka
จำเป็นต้องมี schema registry เพื่อจัดทำเอกสาร Kafka APIs หรือไม่?
ไม่จำเป็น แต่มันช่วยได้ เอกสารระบุกฎ ส่วน registry บังคับใช้กฎ ณ จุดเขียนข้อมูล หากคุณใช้ registry ให้จัดทำเอกสาร compatibility mode ของมัน
การจัดทำเอกสาร Kafka topic ต่างจาก REST endpoint อย่างไร?
เอกสาร REST อธิบาย request และ response ส่วนเอกสาร Kafka อธิบายข้อความหนึ่งข้อความที่ consumers จำนวนมากจะอ่านในภายหลัง จึงต้องมี key, ขอบเขตของลำดับ, การรับประกันการส่งมอบ, retention และ consumer groups ด้วย ซึ่งสิ่งเหล่านี้ไม่ปรากฏในเอกสาร REST ทั่วไป
Apidog ทดสอบ Kafka messages ได้หรือไม่?
Apidog จัดทำเอกสาร Kafka endpoints ผ่าน Custom Protocol API แต่ไม่สามารถส่งหรืออ่าน Kafka messages ได้ ใช้มันเก็บ contract และ payload schemas แล้วทดสอบโค้ด producer และ consumer ด้วย Kafka client library ของคุณ
ควรอัปเดตเอกสาร Kafka บ่อยแค่ไหน?
ทุกครั้งที่ producer เปลี่ยนข้อความ ผูกมันเข้ากับ code review: pull request ที่แก้ไข event ต้องอัปเดต contract ด้วย หรือให้ agent ของคุณสร้างใหม่ด้วย Apidog CLI