
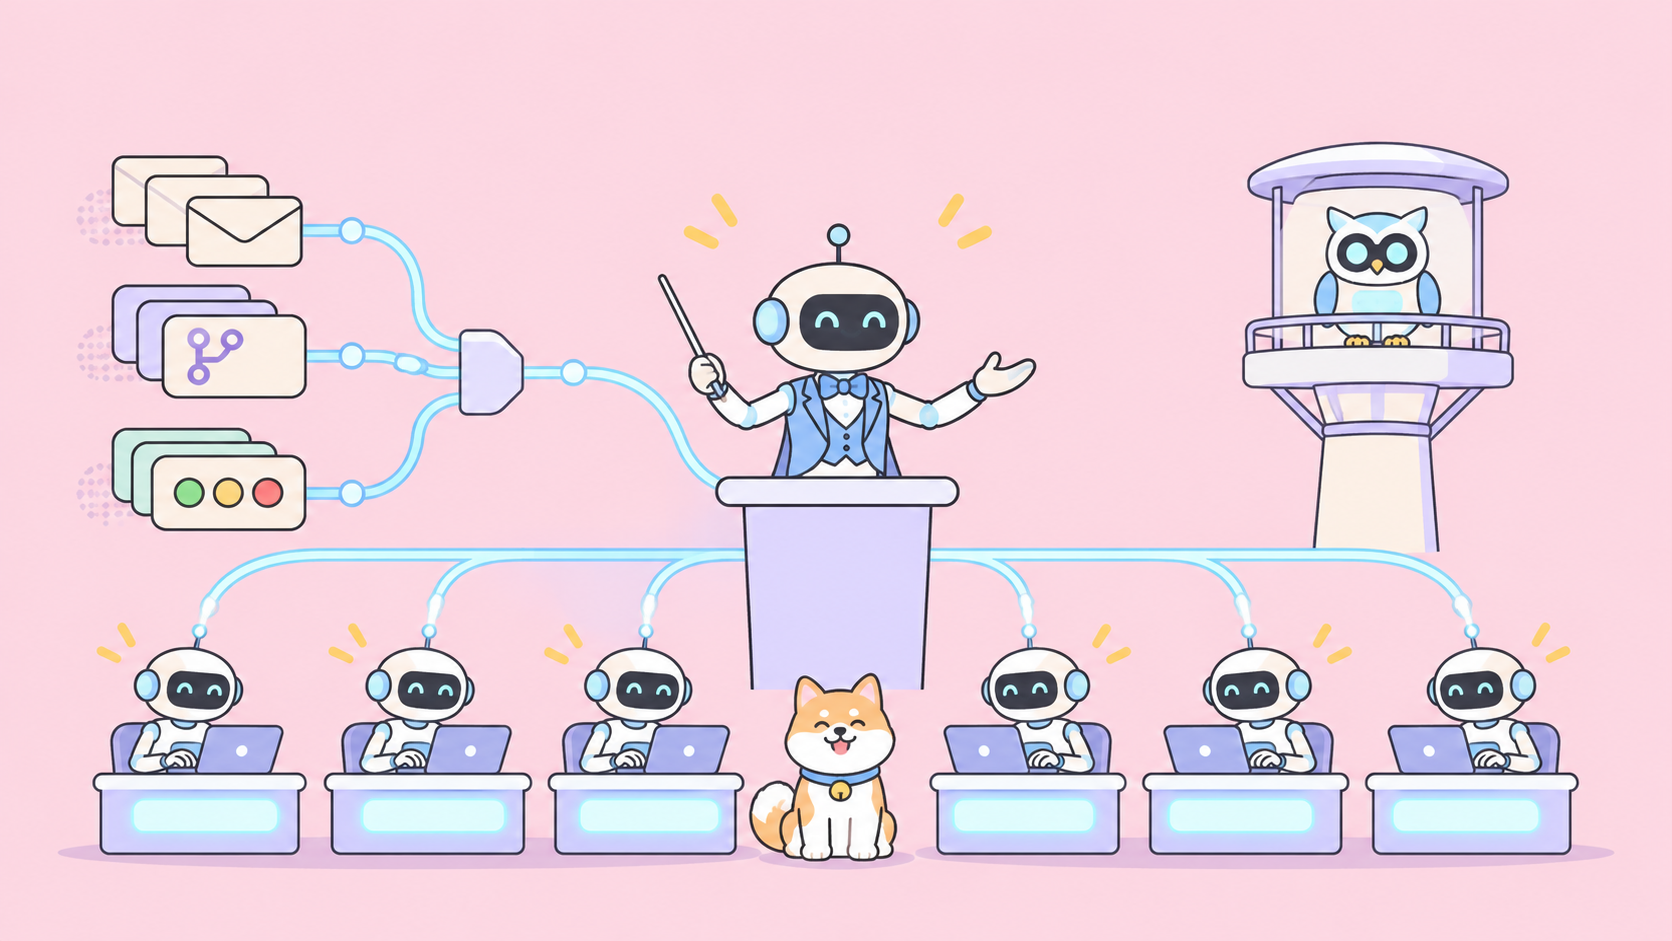
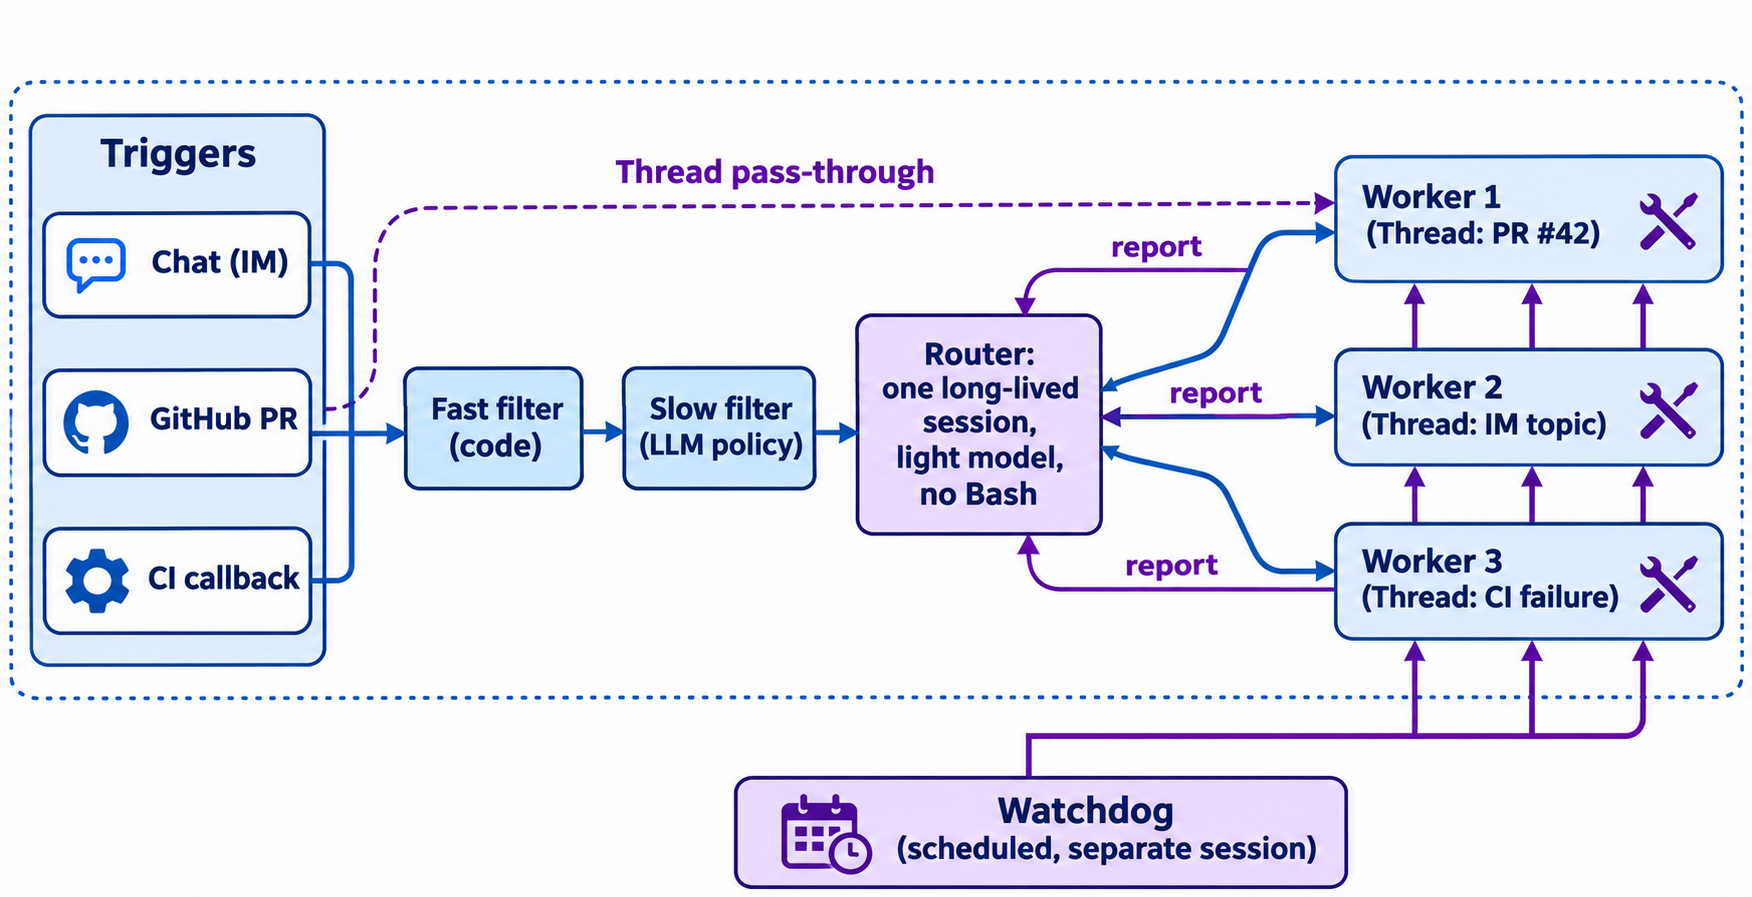
การสร้าง super-agent ในลักษณะเดียวกับที่ DeepSeek Harness อธิบายไว้นั้น ให้แบ่ง agent ออกเป็นสองเลเยอร์: เซสชัน Router หนึ่งเซสชันที่ทำงานอยู่ตลอด ทำหน้าที่สื่อสารกับมนุษย์และกระจายงาน และเซสชัน Worker แยกต่างหากอีกจำนวนมาก ซึ่งแต่ละเซสชันจะรันงานเพียงงานเดียวพร้อมชุดเครื่องมือครบครัน ทั้งสองส่วนจะรับข้อมูลผ่าน Triggers ของเหตุการณ์ต่าง ๆ (เช่น แช็ต, GitHub, CI) ส่งต่องานที่ทำต่อเนื่องตาม Thread และเพิ่ม Watchdog แยกต่างหากเพื่อคอยตรวจสอบทุกอย่าง
คู่มือนี้จะนำบทความด้านการออกแบบของ DeepSeek Harness ที่ชื่อว่า “Exploring Super-agent Design” มาเรียบเรียงเป็นขั้นตอนการสร้างทีละสเต็ป ข้อควรทราบคือ บทความนี้อธิบายถึงสถาปัตยกรรม ไม่ใช่ฟีเจอร์ที่เปิดตัวอย่างเป็นทางการแล้ว โดยบางส่วนจะอยู่ในปลั๊กอินต้นแบบชื่อ dsh-superagent-prototype ซึ่งผู้เขียนระบุไว้ว่า “ไม่ใช่ผลิตภัณฑ์อย่างเป็นทางการของ DeepSeek” และโค้ดตัวอย่างทั้งหมดด้านล่างนี้เป็นเพียงการสาธิตเพื่อให้เห็นภาพ ไม่ใช่โค้ดจริงของ DeepSeek
super-agent คืออะไร?
super-agent คือเพื่อนร่วมทีม AI รายเดียวที่ออนไลน์อยู่ตลอดเวลา สามารถรับเหตุการณ์จากหลากหลายช่องทาง (เช่น แช็ต, pull request, CI) ประมวลผลงานหลายอย่างพร้อมกันในเซสชันที่แยกจากกัน และตอบกลับผู้ใช้งานในฐานะตัวตนเดียวกันอย่างสม่ำเสมอ
ปัญหาคือ เซสชันของ agent นั้นทำงานแยกขาดจากกัน และ “ปกติแล้วคนเราสามารถติดตามเซสชันที่กำลังทำงานอยู่ได้เพียง 3 ถึง 5 เซสชันพร้อมกันเท่านั้น” งานเดี่ยวถูกจำกัดด้วยขีดความสามารถของโมเดล ส่วนการทำงานหลายงานพร้อมกันถูกจำกัดด้วยสมาธิและความสนใจของมนุษย์ ซึ่ง super-agent ได้รับการออกแบบมาเพื่อแก้ปัญหาข้อจำกัดอย่างหลังนี้
super-agent มีคุณลักษณะ 4 ประการ:
- Continuous (ต่อเนื่อง): เป็น agent เดียวกันทั้งบนโปรแกรมแช็ต (IM) และ GitHub ไม่ว่าคุณจะคุยแผน A ในแช็ต แล้วเปลี่ยนไปคุยแผน B ในคอมเมนต์ของ PR ตัว agent ก็ยังเข้าใจบริบทและทำงานต่อได้ทันที
- Productive (เปี่ยมประสิทธิภาพ): รันงานได้หลายงานพร้อมกัน และสามารถรับคำสั่งถัดไปได้ทันทีก่อนที่งานก่อนหน้าจะทำเสร็จ
- Proactive (ทำงานเชิงรุก): คอยจับตาดูเหตุการณ์ต่าง ๆ และจะไม่รบกวนโดยไม่จำเป็น เว้นแต่จะมีสิ่งที่ต้องดำเนินการจริง ๆ
- Persistent (ทำงานต่อเนื่องยาวนาน): ออนไลน์อยู่ตลอดเวลา และสามารถฟื้นฟูตัวเองได้โดยอัตโนมัติ
หากคุณเพิ่งเคยรู้จักตัว harness เป็นครั้งแรก ขอแนะนำให้เริ่มต้นศึกษาจากบทความ DeepSeek Harness คืออะไร และเปรียบเทียบกับ Claude Code อย่างไร
สถาปัตยกรรมของ super-agent: โมดูลหลักทั้ง 5 ส่วน
บทความดังกล่าวได้แบ่งระบบออกเป็น 5 โมดูล ซึ่งสรุปพร้อมขั้นตอนในการสร้างแต่ละส่วนไว้ดังนี้:
| โมดูล | หน้าที่การทำงาน | ขั้นตอนการสร้าง |
|---|---|---|
| Two-level architecture (สถาปัตยกรรมสองระดับ) | Router ทำหน้าที่กระจายงาน ส่วน Workers ทำหน้าที่ประมวลผล | 1 |
| Event-driven Triggers (ทริกเกอร์แบบขับเคลื่อนด้วยเหตุการณ์) | แปลงเหตุการณ์จากแช็ต, GitHub และ CI ให้เป็นข้อมูลอินพุตของ agent | 2 |
| Full-duplex, multi-channel (ทำงานสองทางพร้อมกันและรองรับหลายช่องทาง) | เครื่องมือแบบอะซิงโครนัส และการตอบกลับที่ปรับตามช่องทาง | 4 |
| Compute, state, environment split (แยกส่วนประมวลผล สถานะ และสภาพแวดล้อม) | Loop แบบไร้สถานะ (Stateless), บันทึกสถานะลงฐานข้อมูล และเครื่องปลายทางอยู่ที่เดิม | 5 |
| Watchdog | เซสชันแยกต่างหากเพื่อคอยตรวจสอบความคืบหน้าและข้อผิดพลาด | 6 |
ขั้นตอนที่ 1: แยก Router ออกจาก Workers
Router คือเซสชันเดียวที่ทำงานอยู่ตลอดเวลา โดยจะจัดการการโต้ตอบกับมนุษย์และการกระจายงานทั้งหมด และจะไม่รันงานจริงด้วยตัวเองเลย จึงสามารถทำงานได้โดยไม่ต้องมีเครื่องมืออย่าง Bash และใช้เพียงโมเดลขนาดเล็กที่ประหยัดค่าใช้จ่ายกว่าก็เพียงพอ เมื่อมี Trigger หลายตัวส่งเข้ามาในระหว่างรอบการทำงานของ Router ระบบจะรวมเป็นชุด (batch) เพื่อส่งในคอลถัดไป: อินพุตยาวแต่เอาต์พุตสั้น โดยนำมารวมกันในขั้นตอน prefill
แต่ละ Worker จะเป็นเซสชันแยกเดี่ยวสำหรับแต่ละงาน ได้รับเครื่องมือครบครันและใช้โมเดลที่มีความสามารถสูงสุดเท่าที่คุณจัดสรรได้ Worker จะไม่สื่อสารกับมนุษย์โดยตรง แต่จะรายงานผลกลับไปยัง Router ทั้งนี้ Worker เองสามารถเรียกใช้ subagent หรือทำงานเป็นทีม agent ทั้งทีมเลยก็ย่อมได้
อย่าสับสนรูปแบบนี้กับทีม agent ทั่วไป เพราะหัวหน้าทีมจะทำหน้าที่ย่อยงานชิ้นใหญ่ที่มีความเกี่ยวเนื่องกันออกเป็นส่วน ๆ แต่ Router จะกระจายงานที่เป็นอิสระต่อกันเท่านั้น ซึ่งคุณสามารถนำทั้งสองรูปแบบมาใช้งานซ้อนกันได้
# Illustrative sketch, not DeepSeek's code
class Router:
    def on_events(self, batch):              # triggers arriving mid-turn are batched
        plan = self.llm_light.decide(batch)  # dispatch, reply, or ignore
        for task in plan.new_tasks:
            Worker.spawn(task, model="strongest", tools="all", report_to=self)
        for msg in plan.replies:
            self.channels.send(msg)          # only the Router speaks to humans
ขั้นตอนที่ 2: เปลี่ยนเหตุการณ์ให้กลายเป็น Triggers
ทุกอินพุตที่ส่งเข้ามายัง super-agent ล้วนเป็น Trigger: ไม่ว่าจะเป็นข้อความแช็ต, เหตุการณ์ webhook ของ GitHub, เพย์โหลดจาก Slack Events API หรือการเรียกกลับ (callback) จากระบบ CI ทว่าข้อมูลส่วนใหญ่ไม่จำเป็นต้องส่งไปถึงโมเดลเลยด้วยซ้ำ ในบทความจึงได้ออกแบบการกรองออกเป็นสองชั้น
- เส้นทางลัดด้วยโค้ด (Fast path, in code): กรองตามแหล่งที่มา, กลุ่ม และรายการอนุญาต (allowlist) ของผู้ใช้หรือบอท โดยแต่ละแหล่งที่มาจะถูกกำหนดโหมด เช่น “ตอบสนองต่อคำขอที่ระบุชัดเจนเท่านั้น” “เป็นผู้เข้าเกณฑ์” หรือ “เพิกเฉย”
- เส้นทางหลักด้วย LLM (Slow path, with an LLM): รายการที่เป็นผู้เข้าเกณฑ์จะถูกส่งต่อไปยังโมเดลเพื่อบังคับใช้นโยบายที่เขียนไว้ในรูปแบบของ prompt เช่น “ให้ตอบกลับเมื่อมีคนรายงานบั๊กในช่องนี้”
เอนด์พอยต์รับข้อมูลเข้าของคุณควรตอบรับอย่างรวดเร็วแล้วค่อยประมวลผลต่อในภายหลัง แนวปฏิบัติที่ดีที่สุดสำหรับ webhook ของ GitHub แนะนำให้ตอบกลับด้วยรหัส 2XX ภายใน 10 วินาที ซึ่งการเรียกใช้โมเดลไม่สามารถรับประกันความเร็วระดับนี้ได้ ให้ตอบกลับด้วย 202 Accepted นำ Trigger เข้าคิว แล้วปล่อยให้ Router มารับไปประมวลผลต่อ ทั้งนี้คู่มือการออกแบบ webhook ให้มีความเสถียรของเราได้ครอบคลุมเรื่องการลองใหม่ (retries) และ idempotency สำหรับเลเยอร์นี้ไว้แล้ว
ขั้นตอนที่ 3: ส่งต่องานที่ทำต่อเนื่องตาม Thread
Thread คือลำดับของเหตุการณ์ที่เกิดขึ้นต่อเนื่องกันใน PR หนึ่งรายการ, หัวข้อหนึ่งในโปรแกรมแช็ต หรือเธรดอีเมลหนึ่งสาย โดย Worker ที่ถูกสร้างขึ้นสำหรับเหตุการณ์แรกของ Thread จะทำการ subscribe ไว้ จากนั้นเหตุการณ์ที่ตามมาในภายหลังจะถูกส่งตรงไปยัง Worker ตัวดังกล่าวทันทีโดยไม่ต้องเรียกผ่าน Router อีก
การจับคู่การทำงานนี้เป็นแบบกลุ่มต่อกลุ่ม (many-to-many) หากมี Worker สองตัวทำงานบน PR เดียวกัน ทั้งคู่ก็จะได้รับเหตุการณ์ของ PR นั้น และสามารถจัดการแก้ไขข้อขัดแย้งผ่านทาง PR ได้โดยตรงโดยไม่ต้องส่งข้อความหากันเอง
หากข้ามขั้นตอนนี้ไป คุณจะต้องจ่ายต้นทุนที่สูงขึ้น: ในการทดลองของบทความ การตัดระบบส่งต่อตรงนี้ออกส่งผลให้ Router ต้องตัดสินใจเพิ่มขึ้นราว 30% และทำให้ปริมาณการใช้โทเค็นเพิ่มขึ้นประมาณ 37%
ขั้นตอนที่ 4: จัดการบริบทเสมือนแคชและทำให้เครื่องมือทำงานแบบอะซิงโครนัส
Router ไม่สามารถเก็บข้อมูลทั้งหมดไว้ได้ บทความจึงมองบริบทเสมือนเป็นแคช:
- แทรกไว้ในตัว (Inline) สำหรับข้อมูลที่มีแนวโน้มว่าจะต้องใช้: เช่น ID ต่าง ๆ, สรุปสั้น ๆ, ข้อความข้างเคียง
- ตัดทิ้งลงดิสก์ (Spill) สำหรับส่วนที่เหลือ: ตัดทอนเนื้อหาและทิ้งพอยน์เตอร์ไว้เพื่อให้ agent ตามไปอ่านได้
ID ที่คงที่ของ Trigger, Thread และ Worker จะเชื่อมโยงกันเป็นกราฟอ้างอิงที่ผู้เขียนเรียกว่า “Chain of Recall” โดย agent จะสามารถข้ามจาก Trigger ไปยัง Thread และต่อไปยัง Worker ที่รับผิดชอบได้ ซึ่งช่วยให้สามารถดึงข้อมูลย้อนกลับแบบหลายทอดได้โดยไม่ต้องใช้ prompt ขนาดยักษ์
จากนั้นให้เปลี่ยนไปใช้ระบบ full-duplex (สองทางพร้อมกัน) โดยแทนที่เครื่องมือ run() แบบซิงโครนัสที่บล็อกการทำงาน ด้วยคำสั่งแบบอะซิงโครนัสอย่าง start() และ stop() ซึ่ง start() จะส่งสถานะ “Started” กลับมาทันที ส่วนผลลัพธ์จะถูกส่งตามมาทีหลังในรูปแบบของเหตุการณ์ใหม่ วิธีนี้ทำให้ agent สามารถรับคำสั่งถัดไปของคุณได้แม้ว่างานก่อนหน้าจะยังรันอยู่ก็ตาม ในบทความระบุว่า DeepSeek Harness มีฟังก์ชันนี้อยู่แล้ว แต่ไม่ได้เปิดใช้งานเป็นค่าเริ่มต้น
สุดท้าย ให้ปรับการตอบกลับให้สอดคล้องกับแต่ละช่องทาง (channel-aware) ตามกฎที่พวกเขาทดสอบ มีการจำกัดความยาวของคำตอบในโปรแกรมแช็ตไว้ไม่เกิน 100 คำ ในขณะที่การตอบกลับบน GitHub, อีเมล และเอกสาร จะได้รับรายงานที่มีโครงสร้างชัดเจนและเนื้อหาละเอียดแน่นหนา
นอกจากนี้ยังรองรับ speculative execution (การประมวลผลล่วงหน้าแบบคาดการณ์) อีกด้วย: โดยในกลุ่มผู้ใช้ทดสอบ นโยบายแบบ “จำลองปัญหาและแก้ไขอย่างเงียบ ๆ” จะส่งผลลัพธ์ให้ก็ต่อเมื่อสามารถยืนยันการแก้ปัญหาแบบง่าย ๆ ได้แล้วเท่านั้น มิฉะนั้นจะคงความเงียบไว้
ขั้นตอนที่ 5: แยกส่วนประมวลผล สถานะ และสภาพแวดล้อมออกจากกัน
รันลูปการทำงานของ agent ในคอนเทนเนอร์บนคลาวด์แบบไร้สถานะ (stateless) และจัดเก็บสถานะของเซสชันไว้ในฐานข้อมูล ส่วนสภาพแวดล้อมในการพัฒนาให้อยู่ที่เดิม: เครื่องคอมพิวเตอร์แต่ละเครื่องจะรัน daemon ขนาดเล็ก ซึ่งบทความเรียกว่า BYOM (Bring Your Own Machine) หากลูปเกิดขัดข้องจนแครชก็สามารถรีสตาร์ตใหม่ที่ไหนก็ได้และโหลดสถานะกลับคืนมา โดยที่คลังโค้ดยังคงอยู่บนเครื่องเดิม
บทความนี้ได้อ้างอิงถึงบทความของ Anthropic เรื่อง “Scaling Managed Agents: Decoupling the brain from the hands” ซึ่งใช้แนวคิดเดียวกัน แต่เน้นไปที่แซนด์บ็อกซ์ที่มีการจัดการมากกว่าเครื่องของคุณเอง
ขั้นตอนที่ 6: เพิ่ม Watchdog
Watchdog คือเซสชันแยกต่างหากที่ทำงานตามตารางเวลา โดยอยู่นอกระบบหลัก มีหน้าที่จัดการกับข้อผิดพลาดของ API และสอบถามโมเดลว่า Worker แต่ละตัวยังคงคืบหน้าอยู่หรือเริ่มทำงานออกนอกลู่นอกทาง ผู้ดูแลระบบยังสามารถสอบถาม Watchdog ได้โดยตรงว่าทำไมงานบางอย่างจึงล้มเหลว ควรแยกส่วนนี้ออกจากโพรเซสของ Router เพื่อไม่ให้ Router ที่ค้างลากเอาระบบมอนิเตอร์ล่มตามไปด้วย
สิ่งที่ผลการทดลองบ่งชี้
ผู้เขียนได้ทดสอบส่งข้อความแช็ตและ CI ราว 300 ข้อความ ซึ่งมีคำของานอยู่ประมาณ 20 รายการ โดยจำลองการเขียนโค้ดด้วยการตั้งเวลา และทดสอบแต่ละรูปแบบซ้ำ 5 ครั้ง ซึ่งผู้เขียนระบุว่าผลลัพธ์นี้ “เป็นเพียงข้อมูลบ่งชี้เบื้องต้นเท่านั้น”
| การตั้งค่า (Setup) | p50 (นาที) | p95 (นาที) | โทเค็น Cache-read ต่อการรัน |
|---|---|---|---|
| Super-agent | 12.4 | 15.7 | 23.2M |
| ไม่มี Thread pass-through | 12.6 | 15.5 | 31.8M |
| เซสชันเดียว + เครื่องมือ subagent, prompt แบบกลาง ๆ | 20.4 | 29.5 | 6.1M |
| เซสชันเดียว, prompt ที่เน้นกระจายงานเป็นหลัก | 13.8 | 29.0 | 10.8M |
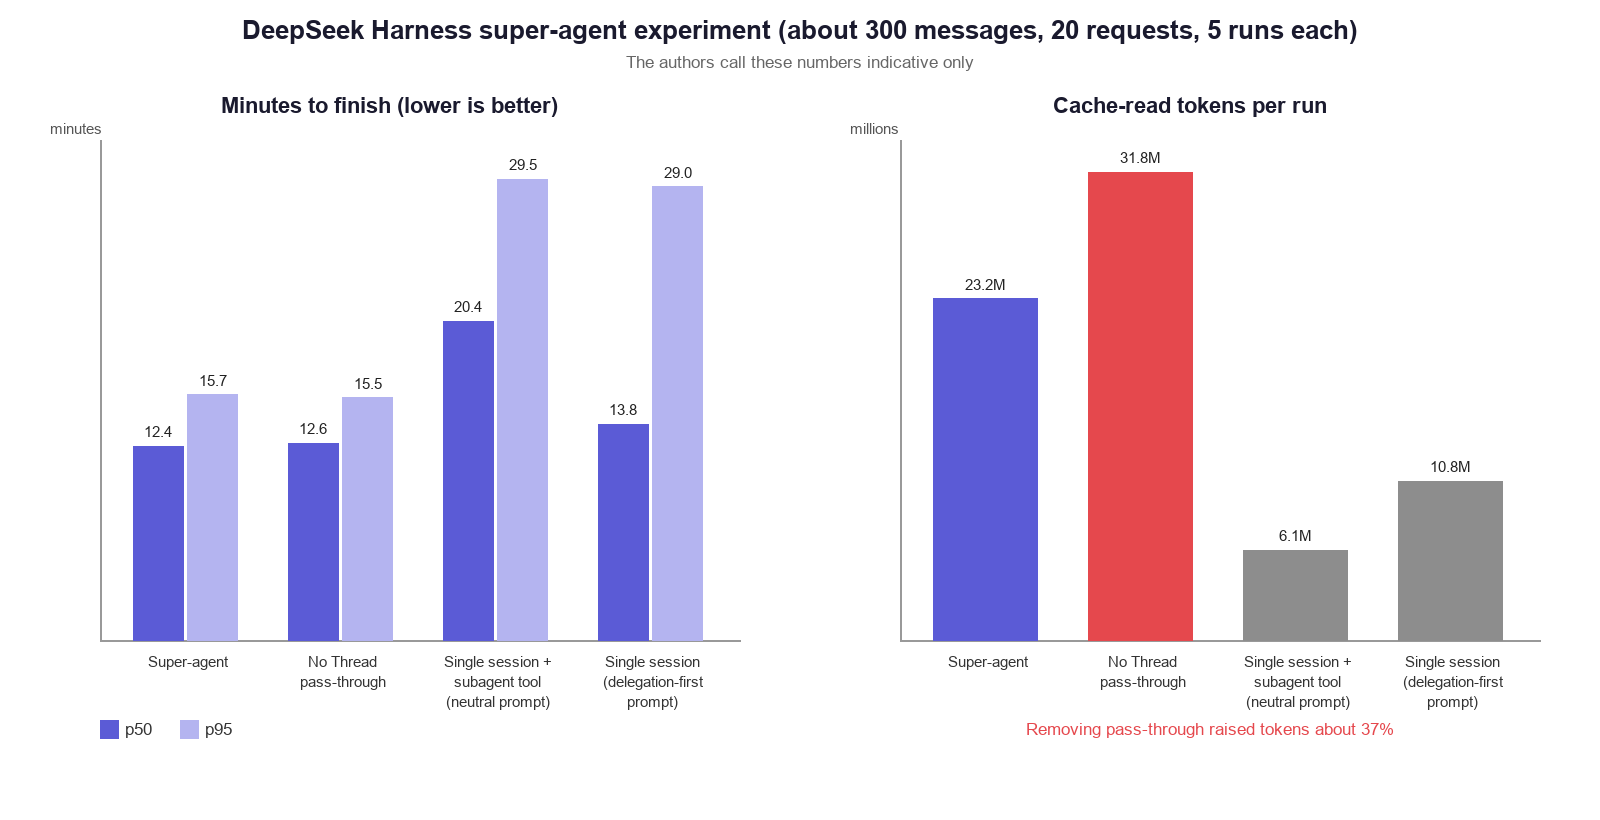
มีผลการค้นพบที่โดดเด่นอยู่ 2 ประการด้วยกัน: หากใช้ prompt แบบกลาง ๆ เซสชันเดี่ยวจะไม่กระจายงานเลยตลอดการรันทั้ง 5 ครั้ง ทำให้ค่า p95 สูงกว่า super-agent เกือบเท่าตัว ส่วนการใช้ prompt ที่เน้นกระจายงานเป็นหลักนั้นช่วยปรับปรุงค่ามัธยฐานได้ดีขึ้น แต่ไม่ช่วยเรื่องกรณีที่ช้าผิดปกติ (tail latency) ทั้งนี้ super-agent จะใช้โทเค็นมากกว่าเซสชันเดี่ยว ดังนั้นสิ่งที่คุณแลกมาด้วยโทเค็นก็คือความเร็ว (latency) และการประหยัดสมาธิของมนุษย์
การทดสอบที่สองเป็นการทดสอบโหลดเฉพาะตัว Router อย่างเดียว เมื่อปริมาณ Trigger เพิ่มขึ้นจาก 1 เป็น 40 ครั้งต่อนาที ขนาดของชุดข้อมูล (batch size) จะเพิ่มจาก 1.0 เป็น 2.8 และเวลาต่อคำขอเพิ่มจาก 2.5 วินาที เป็น 3.9 วินาที ในขณะที่เวลาต่อการตัดสินใจหนึ่งครั้งกลับลดลงจาก 6.4 วินาที เหลือเพียง 1.6 วินาที การรวมชุดข้อมูล (batching) จึงเป็นหัวใจสำคัญที่ช่วยป้องกันไม่ให้ Router ตัวเดียวกลายเป็นคอขวดเร็วเกินไป
ทดสอบระบบรับ Trigger เข้าด้วย Apidog CLI
Trigger ทุกตัวเริ่มต้นขึ้นในรูปแบบของคำขอ HTTP ที่ส่งมายังเอนด์พอยต์รับข้อมูลของคุณ ดังนั้นเอนด์พอยต์นี้จึงเป็นด่านแรกที่ควรค่าแก่การทดสอบที่สุด หากเอนด์พอยต์ทำคอมเมนต์ของ PR ตกหล่น หรือกำหนด thread_id ใหม่ให้แก่ทุกเหตุการณ์ ระบบกำหนดเส้นทางของ Thread ก็จะพังลง และข้อความติดตามผลทั้งหมดจะถูกส่งวนกลับไปที่ Router แทน คุณสามารถให้ agent เขียนโค้ดและรันแบบทดสอบดังกล่าวได้ด้วย Apidog CLI
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
จากนั้นให้ป้อน prompt เพียงข้อความเดียวให้กับ agent ของคุณ:
In Apidog project <id>, create POST /triggers/github for a GitHub
pull_request_review_comment webhook. Add a test case that sends two
comments on the same PR and asserts: status 202, a trigger_id in the
body, and the same thread_id both times. Run it against staging and
summarize any failures.
agent จะอ่านสกีมาของแต่ละเพย์โหลด ตรวจสอบความถูกต้องของ JSON สร้างเอนด์พอยต์และชุดทดสอบ แล้วดำเนินการรัน:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <stagingEnvId> -r cli,json
คำสั่ง apidog run เดียวกันนี้เมื่อใส่ -r junit จะสามารถนำไปเชื่อมต่อเข้ากับไปป์ไลน์ของคุณได้ทันที ดูรายละเอียดเพิ่มเติมได้ที่ Apidog CLI in CI/CD หาก agent ของคุณคือ DeepSeek Harness สามารถทำตามคู่มือการตั้งค่านี้ หรือหากเป็น Claude Code ให้ใช้คู่มือนี้ ทั้งนี้แพ็กเกจฟรีของ Apidog ครอบคลุมผู้ใช้สูงสุด 4 คน
ปัญหาที่ยังรอการแก้ไข
บทความได้ระบุประเด็นที่ยังไม่ได้รับการแก้ไขไว้ดังนี้:
- การปรับขนาดของ Router และการเลือกโครงสร้างของ Worker เมื่อโหลดเพิ่มสูงขึ้น
- ความจำระยะยาว ที่นอกเหนือไปจาก Chain of Recall
- UX แบบไร้เซสชัน: การควบคุมสั่งการ agent โดยไม่มีหน้าต่างแช็ตเดี่ยวเพียงหน้าต่างเดียว
- ขอบเขตของบริบทและโปรโตคอลระหว่าง agent กับ agent โดยมี A2A เป็นหนึ่งในตัวเลือกที่น่าสนใจ
- ความปลอดภัย: การโจมตีด้วย prompt injection ที่เล็ดลอดเข้าสู่ลูปบนคลาวด์อาจแพร่กระจายไปยังทุกเครื่องที่เชื่อมต่ออยู่ได้ รวมถึงข้อมูลประจำตัว (credentials) ในบริบทอาจรั่วไหลได้ ผู้เขียนจึงต้องการให้ agent สามารถใช้ข้อมูลประจำตัวได้โดยไม่จำเป็นต้องมองเห็นข้อมูลเหล่านั้นเลย
คำถามที่พบบ่อย (FAQ)
super-agent เป็นฟีเจอร์ของ DeepSeek Harness ที่ฉันเปิดใช้งานได้เลยหรือไม่? ไม่ใช่ บทความนี้อธิบายถึงสถาปัตยกรรม โดยมีบางส่วนอยู่ในปลั๊กอิน dsh-superagent-prototype ซึ่งผู้เขียนระบุว่าไม่ใช่ผลิตภัณฑ์อย่างเป็นทางการของ DeepSeek ส่วนเครื่องมือแบบ full-duplex นั้นได้รับการพัฒนาไว้แล้วแต่ถูกปิดไว้เป็นค่าเริ่มต้น
ทำไม Router จึงใช้โมเดลขนาดเล็กกว่า? เพราะทำหน้าที่เพียงแค่กระจายงานและสื่อสารกับมนุษย์เท่านั้น โดยไม่ต้องรันงานจริงหรือใช้งาน Bash ส่วน Workers จะทำหน้าที่คิดวิเคราะห์อย่างหนักด้วยโมเดลที่มีความสามารถสูงสุด
super-agent แตกต่างจากทีม agent อย่างไร? หัวหน้าทีมจะแบ่งงานชิ้นใหญ่ที่มีความเกี่ยวเนื่องกันออกเป็นส่วน ๆ ส่วน Router จะกระจายงานที่เป็นอิสระต่อกัน ทั้งนี้ Worker หนึ่งตัวสามารถรันทีม agent ของตัวเองภายใน super-agent ได้เช่นกัน
Thread pass-through คืออะไร? เหตุการณ์ที่ตามมาในภายหลังบน PR, หัวข้อในโปรแกรมแช็ต หรือเธรดอีเมล จะถูกส่งตรงไปยัง Worker ที่เป็นเจ้าของ Thread นั้น โดยข้าม... [truncated 795 chars]