
Groq มอบคีย์ Free Plan ให้ทุกบัญชีสำหรับปลายทางที่รองรับ OpenAI และคีย์นั้นใช้งานได้ทันทีที่คุณสมัคร สิ่งที่ทำให้คนมักสะดุดไม่ใช่การเข้าถึง แต่คือการอยู่ภายในขีดจำกัดเมื่อแอปของคุณเรียกโมเดลจริง ๆ Groq เผยแพร่ตัวเลข Free Plan รายโมเดลในเอกสาร แต่ตัวเลขเหล่านั้นเปลี่ยนได้และบัญชีของคุณเองอาจแตกต่าง นิสัยที่เชื่อถือได้คือตรวจสอบการตั้งค่าบัญชีของคุณ แล้วอ่านเฮดเดอร์ตอบกลับในทุกการเรียก เพราะขีดจำกัดอาจเปลี่ยนกลางเซสชัน
คู่มือนี้ครอบคลุมการขอคีย์ การชี้ไคลเอนต์ OpenAI มาตรฐานไปยังปลายทางของ Groq และส่วนที่โพสต์ “free tier” ส่วนใหญ่ข้ามไป: การเฝ้าดูขีดจำกัดของคุณแบบเรียลไทม์ แทนที่จะรู้จาก 429 ในโปรดักชัน จากนั้นเอเจนต์เขียนโค้ดของคุณจะเปลี่ยนการตรวจสอบนั้นเป็นเทสต์ Apidog CLI เพื่อให้ทำซ้ำได้ ไม่ใช่คำสั่ง curl ครั้งเดียวที่คุณลืมไป
สรุปสั้น
Groq มีสองระดับ: Free Plan และ Developer Plan ขีดจำกัดอัตราใช้ในระดับองค์กร (ไม่ใช่ต่อผู้ใช้) คุณจะชนเพดานใดก็ตามที่ถึงก่อนระหว่างคำขอ โทเค็น หรือยอดรวมรายวัน และโทเค็นที่แคชไว้ไม่นับรวมกับคุณ Groq เผยแพร่ตัวเลข Free Plan รายโมเดล แต่ตัวเลขที่ใช้กับบัญชีของคุณอยู่ในหน้าขีดจำกัดในคอนโซลของคุณ ดังนั้นวิธีที่เชื่อถือได้คืออ่านจากเฮดเดอร์ตอบกลับ x-ratelimit-* ในทุกการเรียก แทนที่จะเชื่อตารางที่อาจเปลี่ยนโดยไม่แจ้งให้ทราบ
การขอคีย์และการเรียกปลายทาง
สร้างบัญชีที่ console.groq.com และสร้างคีย์จากหน้าคีย์ Groq เปิดเผยคีย์นั้นผ่าน API ที่รองรับ OpenAI ดังนั้นถ้าคุณเคยเรียก SDK ของ OpenAI มาก่อน คุณก็รู้รูปแบบอยู่แล้ว ชี้ base URL ไปที่ Groq แทน OpenAI และเก็บอย่างอื่นให้เหมือนเดิม:
curl https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "llama-3.1-8b-instant",
    "messages": [{"role": "user", "content": "Summarize this ticket in one sentence."}]
  }'
หรือใช้ไคลเอนต์ Python OpenAI อย่างเป็นทางการ:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["GROQ_API_KEY"],
    base_url="https://api.groq.com/openai/v1",
)

response = client.chat.completions.create(
    model="llama-3.3-70b-versatile",
    messages=[{"role": "user", "content": "List three causes of API timeout errors."}],
)

print(response.choices[0].message.content)
เอกสาร ความเข้ากันได้กับ OpenAI ของ Groq ระบุช่องว่างบางอย่างที่ควรรู้ก่อนคัดลอกโค้ดเดิมของคุณมาใช้: logprobs, logit_bias, top_logprobs และ messages[].name ล้วนส่งคืนข้อผิดพลาด 400, n ต้องเท่ากับ 1 ถ้าคุณตั้งค่า และอุณหภูมิ 0 จะถูกแปลงเป็น float บวกค่าที่น้อยมาก แทนการถอดรหัสแบบ greedy จริง
Free Plan กับ Developer Plan
ถ้อยคำของ Groq เองก็ตรงไปตรงมา: “อัปเกรดเป็นแผน Developer เพื่อเข้าถึงขีดจำกัดที่สูงขึ้น การประมวลผล Batch และ Flex และอื่น ๆ” Free Plan คือสิ่งที่คีย์ใหม่ทุกคีย์เริ่มต้น และใช้งานได้จริงสำหรับการทดสอบและโปรเจกต์เล็ก ๆ ด้านข้าง
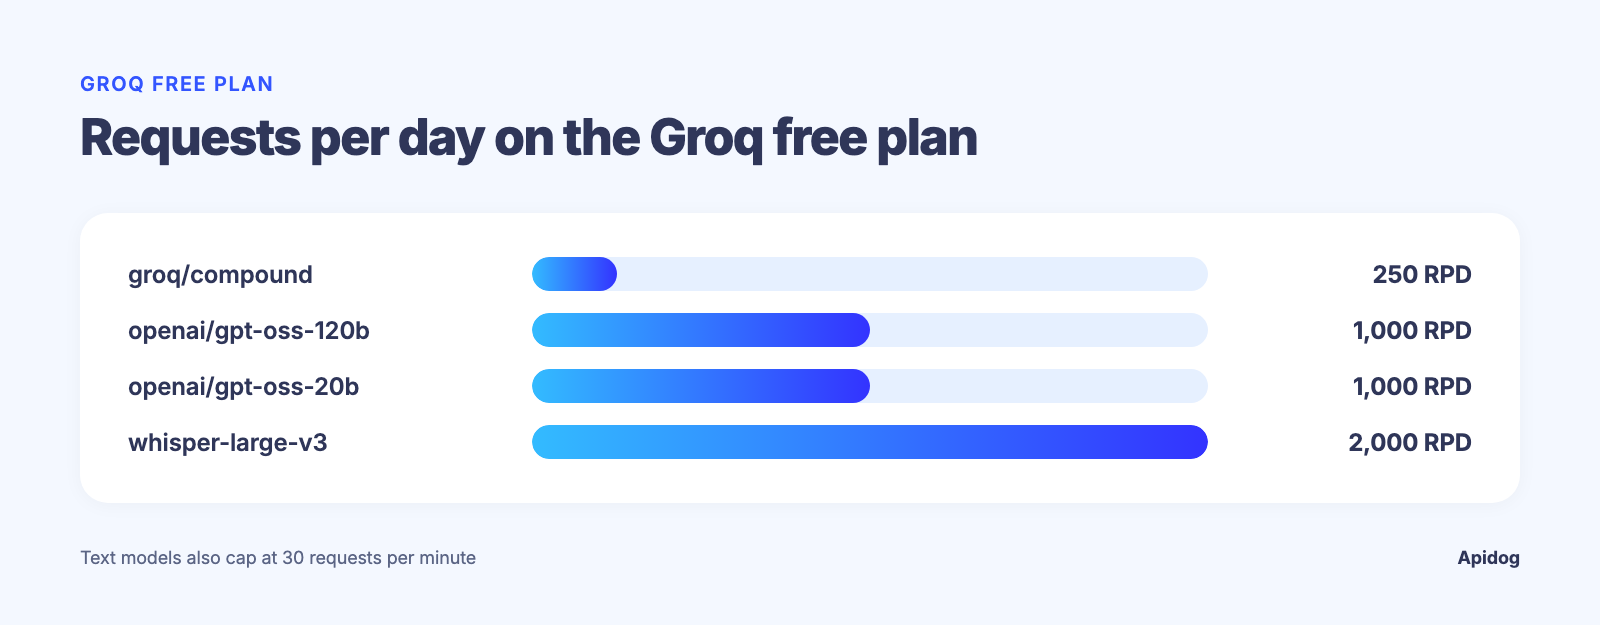
นี่คือสิ่งที่ Free Plan อนุญาตสำหรับโมเดลบางตัว ตามเอกสารขีดจำกัดอัตราของ Groq ณ วันที่อ่าน 2026-09-15:
| โมเดล | RPM | RPD | TPM | TPD | เสียง |
|---|---|---|---|---|---|
groq/compound |
30 | 250 | 70K | - | - |
openai/gpt-oss-120b |
30 | 1K | 8K | 200K | - |
openai/gpt-oss-20b |
30 | 1K | 8K | 200K | - |
whisper-large-v3 |
20 | 2K | - | - | 7.2K ASH / 28.8K ASD |
หน้าเดียวกันนั้นมีแท็บ Developer Plan ที่มีเพดานสูงขึ้นสำหรับทุกโมเดล พร้อมการประมวลผล Batch และ Flex มองตารางด้านบนเป็นภาพรวม ณ ขณะหนึ่ง เพราะ Groq อาจเปลี่ยนตัวเลขเหล่านี้โดยไม่แจ้งให้ทราบ ตัวเลขของคุณเองอยู่ในหน้าขีดจำกัดในการตั้งค่าบัญชี ของคุณ: ถ้าไม่ตรงกัน ให้เชื่อหน้านั้นมากกว่าหน้านี้
รายละเอียดนโยบายสองข้อสำคัญกว่าตัวเลขดิบ ขีดจำกัดอัตราใช้ “ในระดับองค์กร ไม่ใช่ผู้ใช้แต่ละราย” ดังนั้นห้าคนที่ใช้ Groq org เดียวกันจะใช้ขีดจำกัดร่วมกันหนึ่งชุด ไม่ใช่ห้าชุดแยกกัน และ “โทเค็นที่แคชไว้ไม่นับรวมกับขีดจำกัดอัตราของคุณ” ซึ่งหมายความว่าโครงสร้างพรอมป์ที่แคชไว้ดีจะให้ปริมาณงานจริงมากกว่าที่ตัวเลขพาดหัวบอกเป็นนัย
โมเดลที่ควรรู้ก่อนชนขีดจำกัด
ขีดจำกัดที่สำคัญขึ้นอยู่กับว่าคุณเรียกโมเดลใด โมเดลข้อความและระบบ Compound ของ Groq ทำงานที่บริบท 131,072 โทเค็น:
| ID โมเดล | ประเภท |
|---|---|
llama-3.1-8b-instant |
ข้อความอเนกประสงค์แบบเร็ว |
llama-3.3-70b-versatile |
ข้อความอเนกประสงค์ขนาดใหญ่ |
openai/gpt-oss-120b |
โมเดลให้เหตุผลแบบ open-weight |
openai/gpt-oss-20b |
โมเดลให้เหตุผลแบบ open-weight ขนาดเล็ก |
groq/compound |
ระบบเอเจนต์ |
groq/compound-mini |
ระบบเอเจนต์ขนาดเบา |
โมเดล Whisper คือ whisper-large-v3 และ whisper-large-v3-turbo ไม่เข้าตารางนี้ พวกมันเป็นโมเดลถอดเสียง และ Groq วัดปริมาณงานเป็นวินาทีเสียงต่อชั่วโมงและต่อวัน (ASH/ASD) ควบคู่กับเพดาน RPM และ RPD ของตัวเอง ไม่ใช่เป็นโทเค็น
แต่ละโมเดลมีเพดาน RPM, RPD และโทเค็นของตัวเอง ดังนั้นอย่าสันนิษฐานว่าขีดจำกัดของ llama-3.1-8b-instant ใช้กับ openai/gpt-oss-120b ได้
อ่านเฮดเดอร์ขีดจำกัดอัตราแทนการเดา
ทุกการตอบกลับจาก api.groq.com มีชุดเฮดเดอร์ที่บอกคุณได้อย่างแม่นยำว่าคุณอยู่ตรงไหน โดยไม่ต้องเข้าคอนโซล:
x-ratelimit-limit-requestsและx-ratelimit-limit-tokensเพดานของคุณสำหรับหน้าต่างปัจจุบันx-ratelimit-remaining-requestsและx-ratelimit-remaining-tokensสิ่งที่เหลืออยู่ตอนนี้x-ratelimit-reset-requestsและx-ratelimit-reset-tokensเมื่อหน้าต่างรีเฟรชretry-afterส่งมาเมื่อเกิด 429 บอกคุณว่าต้องรอนานเท่าไร
อ่าน x-ratelimit-remaining-tokens หลังทุกการเรียก แล้วคุณจะมีมาตรวัดสด ไม่ใช่ตัวเลขคงที่ที่คุณค้นครั้งเดียวแล้วลืมกลับมาดู นี่คือการตรวจสอบอย่างเร็วด้วย cURL โดยพิมพ์เฉพาะเฮดเดอร์:
curl -sD - https://api.groq.com/openai/v1/chat/completions \
  -H "Authorization: Bearer $GROQ_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "llama-3.1-8b-instant", "messages": [{"role": "user", "content": "hi"}]}' \
  -o /dev/null | grep -i ratelimit
ลองรันคำสั่งนั้นหลายครั้งในลูปกับสคริปต์ทดสอบที่คุยเก่ง แล้วคุณจะเห็น x-ratelimit-remaining-tokens นับถอยหลัง ถ้าแอปของคุณต้องใช้ลอจิก backoff ดูคู่มือของเราเกี่ยวกับวิธีใช้งานจำกัดอัตรา API สำหรับรูปแบบที่เคารพเฮดเดอร์ retry-after แทนการเดาความหน่วง
ให้เอเจนต์เขียนโค้ดของคุณรันการตรวจสอบด้วย Apidog CLI
การเต้นรำ curl-and-grep ด้วยมือได้ผลสำหรับเซสชันดีบักครั้งเดียว แต่มันไม่ขยายไปถึงทีม และไม่มีใครรันคำสั่งเชลล์แบบครั้งเดียวซ้ำก่อนทุกดีพลอย ยกการตรวจสอบให้เอเจนต์เขียนโค้ดของคุณแทน: ด้วย Apidog CLI มันเขียนเทสต์ครั้งเดียวและรันเมื่อคุณสั่ง ตั้งค่าครั้งเดียว:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
โทเค็นได้จาก Apidog ใต้ Account Settings, API Access Token จากนั้นให้พรอมป์หนึ่งข้อกับเอเจนต์:
Use Apidog CLI on project <id>. Create a Groq environment with base URL
https://api.groq.com/openai/v1 and add POST /chat/completions with Bearer auth
from {{GROQ_API_KEY}}. Create one test case per model we run in production
(llama-3.1-8b-instant, openai/gpt-oss-120b) that asserts status 200 and fails
when x-ratelimit-remaining-tokens drops below 10% of x-ratelimit-limit-tokens.
Put both cases in a "Groq limits" test suite, run it, and report the headers.
คำสั่งที่มันรัน ตรวจสอบกับ Apidog CLI 2.2.7:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog endpoint create --project <id> --file groq-chat.json
apidog cli-schema validate test-case-create --file groq-8b-case.json
apidog test-case create --project <id> --file groq-8b-case.json
apidog test-suite create --project <id> --name "Groq limits"
apidog run --test-suite <suiteId> --project <id> -e <envId> \
  --env-var "GROQ_API_KEY=$GROQ_API_KEY" -r cli,junit
งบประมาณที่หดลงจะปรากฏเป็นเทสต์ที่ล้มเหลว แทนที่จะเป็น 429 เซอร์ไพรส์ระหว่างเดโม ใส่บรรทัดสุดท้ายนั้นในงาน CI ก่อนดีพลอย ตามในคู่มือ ไปป์ไลน์ CI/CD ของ Apidog CLI ของเรา หรือขอเอเจนต์ให้ apidog scheduled-task create ซึ่งรันชุดทดสอบบน runner ตาม cron สิ่งนี้สำคัญขึ้นเมื่อพิจารณาการรวมระดับองค์กรของ Groq: เพื่อนร่วมทีมหนึ่งคนรันงานแบบ batch อาจกินงบประมาณที่แชร์ไว้ซึ่งปลายทางโปรดักชันของคุณต้องใช้อีกหนึ่งชั่วโมงถัดมา มันเป็นแนวคิดเดียวกับโพสต์ของเราเกี่ยวกับการทดสอบ API สำหรับขีดจำกัดอัตรา GPT
ทำอย่างไรเมื่อคุณชนขีดจำกัดจริง ๆ
เมื่อได้ 429 กลับมา ให้เคารพ retry-after แทนการลองใหม่ทันที ลูปลองใหม่ที่ถี่เกินไปกับขีดจำกัดระดับคำขอจะใช้งบประมาณที่เหลือของคุณเร็วขึ้นและดันหน้าต่างรีเซ็ตให้ไกลออกไป ถ้าคุณกำลังสร้างสิ่งนี้ในบริการโปรดักชันแทนสคริปต์ทดสอบ คู่มือฉบับสมบูรณ์เกี่ยวกับข้อผิดพลาดเกินขีดจำกัดอัตรา ของเราอธิบายกลยุทธ์ backoff ที่ใช้ได้กับผู้ให้บริการหลายราย ไม่ใช่แค่ Groq
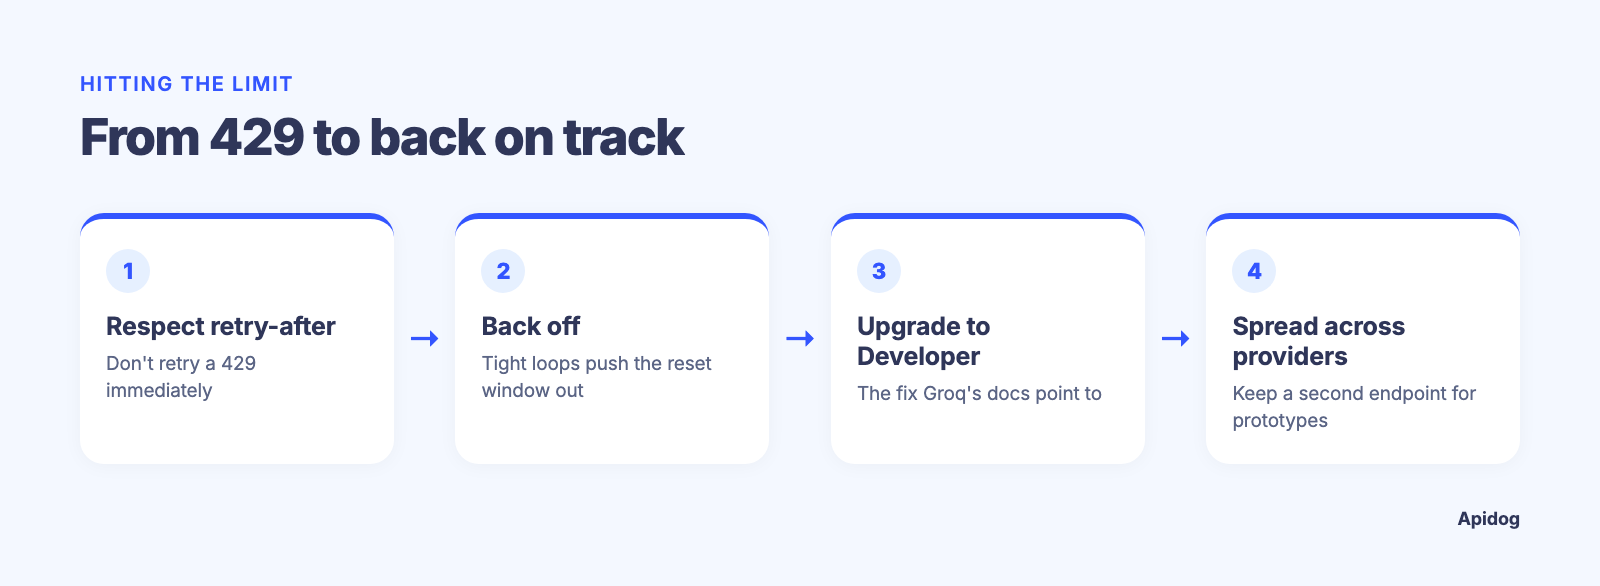
ถ้าคุณชนเพดานบน Free Plan อย่างสม่ำเสมอ วิธีแก้ที่เร็วที่สุดคือการอัปเกรดเป็น Developer Plan ที่ Groq ชี้ตรงในเอกสาร วิธีแก้ที่เร็วรองลงมา โดยเฉพาะสำหรับต้นแบบ คือกระจายทราฟฟิกไปยังผู้ให้บริการมากกว่าหนึ่งราย บทความรวบรวมทางเลือก OpenRouter ของเราครอบคลุมปลายทางอื่น ๆ ที่ควรมีติดตัวไว้สำหรับสถานการณ์นี้โดยเฉพาะ
คำถามที่พบบ่อย
Groq มีระดับฟรีสำหรับ API หรือไม่? มี ทุกบัญชีใหม่เริ่มต้นบน Free Plan โดยเข้าถึงปลายทางที่รองรับ OpenAI ได้ Groq เผยแพร่ตัวอย่างขีดจำกัด Free Plan สำหรับหลายโมเดล แต่เพดานที่ใช้กับบัญชีของคุณจริง ๆ อยู่ในหน้าขีดจำกัดในการตั้งค่าคอนโซล ของคุณ
ฉันจะตรวจสอบขีดจำกัดอัตรา Groq ปัจจุบันได้อย่างไร? สองวิธี: เปิดหน้าขีดจำกัดในการตั้งค่าบัญชีของคุณ หรืออ่านเฮดเดอร์ x-ratelimit-limit-requests และ x-ratelimit-limit-tokens บนการตอบกลับ API ใดก็ได้ เฮดเดอร์สะท้อนขีดจำกัดจริงของบัญชีคุณ ณ ขณะที่คุณเรียก ซึ่งเชื่อถือได้มากกว่าตัวเลขที่คุณเห็นครั้งเดียวแล้วจำไว้
เกิดอะไรขึ้นเมื่อฉันเกินขีดจำกัดอัตรา Groq? คุณจะได้รับการตอบกลับ 429 พร้อมเฮดเดอร์ retry-after บอกว่าต้องรอกี่วินาที ดูคู่มือเกินขีดจำกัดอัตรา ของเราเพื่อจัดการในโค้ดแทนการเดาความหน่วง
โทเค็นที่แคชไว้นับรวมกับขีดจำกัดอัตรา Groq ของฉันหรือไม่? ไม่ Groq ระบุตรง ๆ ว่าโทเค็นที่แคชไว้ไม่นับรวมกับขีดจำกัดอัตราของคุณ ดังนั้นโครงสร้างพรอมป์ที่ใช้ข้อความระบบที่แคชไว้ซ้ำจะได้ปริมาณงานจริงมากกว่าที่ขีดจำกัดโทเค็นดิบบอกเป็นนัย
ขีดจำกัดอัตรา Groq เป็นต่อผู้ใช้หรือต่อองค์กร? ต่อองค์กร ทุกคีย์ภายใต้ Groq org เดียวกันใช้พูลคำขอและโทเค็นร่วมกันหนึ่งพูล ดังนั้นสคริปต์ของเพื่อนร่วมทีมอาจกินงบประมาณที่แอปโปรดักชันของคุณต้องการ
โมเดล Groq ใดมีหน้าต่างบริบทสูงที่สุด? llama-3.1-8b-instant, llama-3.3-70b-versatile, openai/gpt-oss-120b, openai/gpt-oss-20b และระบบ Compound ล้วนทำงานที่บริบท 131,072 โทเค็น โมเดล Whisper เป็นการถอดเสียง ไม่ใช่ข้อความ ดังนั้น Groq จึงวัดขีดจำกัดเป็นระยะเวลาเสียงแทน ขีดจำกัดอัตราแตกต่างกันไปในแต่ละโมเดลแม้อยู่ในหน้าต่างบริบทเดียวกัน ดังนั้นตรวจสอบแต่ละตัวแยกกัน
แล้วคุณจะอยู่ตรงไหน
วิธีใช้ Groq API แบบฟรีไม่ใช่ตัวเลขลับ แต่เป็นนิสัย ขอคีย์ ชี้ปลายทางที่รองรับ OpenAI ไปที่มัน และอ่านเฮดเดอร์ตอบกลับในทุกการเรียก แทนที่จะเชื่อตัวเลขที่คุณเจอในโพสต์บล็อก รวมถึงโพสต์นี้ด้วย
ให้เอเจนต์เขียนโค้ดของคุณสร้างการตรวจสอบนั้นครั้งเดียวด้วย Apidog CLI พร้อมการยืนยันค่าโทเค็นที่เหลือสำหรับแต่ละโมเดล แล้วมันจะรันในทุกดีพลอยจากนั้นเป็นต้นไป การตั้งค่าใช้เวลาน้อยกว่าการอ่านเอกสาร Groq ที่เหลือ สำหรับเนื้อหาที่ลึกขึ้นเกี่ยวกับการทดสอบชั้น API ของ AI ภายใต้โหลด คู่มือของเราเกี่ยวกับเครื่องมือทดสอบ API ที่ดีที่สุดสำหรับเอเจนต์ AI เป็นจุดต่อไปที่ดี