
Grok 4.6 เปิดตัวเมื่อวันที่ 12 สิงหาคม พร้อมกับคำกล่าวอ้างที่เปลี่ยนแปลงการตัดสินใจเกี่ยวกับโมเดลระดับแนวหน้า: ความฉลาดที่เทียบเท่า GPT-5.6 Sol ในดัชนี Artificial Analysis โดยมีค่าใช้จ่าย 6 ดอลลาร์ต่อเอาต์พุต 1 ล้านโทเค็น แทนที่จะเป็น 30 ดอลลาร์ บทความเปรียบเทียบส่วนใหญ่ที่คุณพบยังคงอ้างอิง Grok 4.5 ซึ่งล้าหลังโมเดลแนวหน้ามากพอจนราคาไม่สำคัญ นั่นไม่ใช่สถานการณ์อีกต่อไปแล้ว ดังนั้นการเปรียบเทียบนี้จึงเริ่มต้นใหม่ด้วยตัวเลขของเวอร์ชัน 4.6
สรุปสั้นๆ คือ GPT-5.6 Sol ยังคงเป็นตัวเลือกที่แข็งแกร่งที่สุดสำหรับเอเจนต์เขียนโค้ดขนาดใหญ่ระดับ repository, Claude Fable 5 เป็นผู้นำในงานอัตโนมัติระยะยาวอย่างฉิวเฉียด และ Grok 4.6 ตอนนี้เป็นตัวเลือกที่คุ้มค่าซึ่งมีความสามารถใกล้เคียงพอที่จะทำให้โมเดลอีกสองตัวต้องพิสูจน์ราคาของตนเอง การเลือกที่เหมาะสมขึ้นอยู่กับปริมาณงานของคุณ ดังนั้นด้านล่างนี้คือตัวเลข ข้อควรพิจารณาเกี่ยวกับ API และวิธีการทดสอบทั้งสามแบบที่สามารถทำซ้ำได้บนระบบของคุณเอง หากคุณต้องการทำการทดสอบนั้นวันนี้ Apidog ช่วยให้คุณเข้าถึง API ทั้งสามได้พร้อมกันจากเวิร์กสเปซเดียว ฟรี
ปุ่ม
สรุปโดยย่อ
- ดัชนีความฉลาด: Claude Fable 5 เป็นผู้นำที่ 62; Grok 4.6 และ GPT-5.6 Sol เสมอกันที่ 61
- ราคา (เอาต์พุต, ต่อ 1 ล้านโทเค็น): Grok 4.6 ที่ 6 ดอลลาร์, Claude Opus 4.8 ที่ 25 ดอลลาร์, GPT-5.6 Sol ที่ 30 ดอลลาร์ ซึ่งแตกต่างกันถึง 5 เท่า
- บริบท: GPT-5.6 Sol 1.05 ล้านโทเค็น, Claude Fable 5 1 ล้านโทเค็น, Grok 4.6 500K โทเค็น
- การเขียนโค้ด: Sol Max เป็นผู้นำ DeepSWE (73.0% เทียบกับ 65.9% ของ Grok); Fable 5 Max เป็นผู้นำ FrontierCode (63.6% เทียบกับ 61.3%)
- เอเจนต์: Fable 5 Max เป็นผู้นำ APEX-Agents ที่ 59.2%; Grok 4.6 (57.5%) เหนือกว่า Sol Max (56.7%) เล็กน้อย
- ค่าใช้จ่ายต่อภารกิจที่สำเร็จ: Grok 4.6 ถูกวัดที่ 0.84 ดอลลาร์โดย Artificial Analysis ซึ่งเป็นราคาต่ำที่สุดในบรรดาโมเดลระดับแนวหน้า
- อย่าตัดสินใจจากเกณฑ์มาตรฐานเพียงอย่างเดียว: ให้ลองทำการทดสอบแบบ 20 พร้อมท์กับปริมาณงานของคุณเอง (ดูวิธีการด้านล่าง)
ข้อมูลจำเพาะและราคาเปรียบเทียบ
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| ผู้พัฒนา | xAI | OpenAI | Anthropic |
| ดัชนีความฉลาด | 61 | 61 | 62 |
| ขนาดหน้าต่างบริบท | 500K | 1.05M | 1M |
| ราคาอินพุต / 1M | $2 | $12 | $10 |
| ราคาเอาต์พุต / 1M | $6 | $30 | $25* |
| รุ่นเร็ว/พรีเมียม | ราคา 2 เท่า | ระดับ Sol Max | ระดับ Fable 5 Max |
| รูปแบบ API | รองรับ OpenAI | ของ OpenAI โดยตรง | Anthropic Messages |
| วันที่อัปเดตข้อมูล | ก.พ. 2026 |
*ราคา Claude ที่แสดงสำหรับ Opus 4.8; ราคาของ Fable 5 แตกต่างกันไปตามการตั้งค่าความพยายาม (effort setting) ดู คู่มือราคา GPT-5.6 และ รายละเอียดการลดค่าใช้จ่าย Claude ของเราสำหรับตารางข้อมูลทั้งหมด
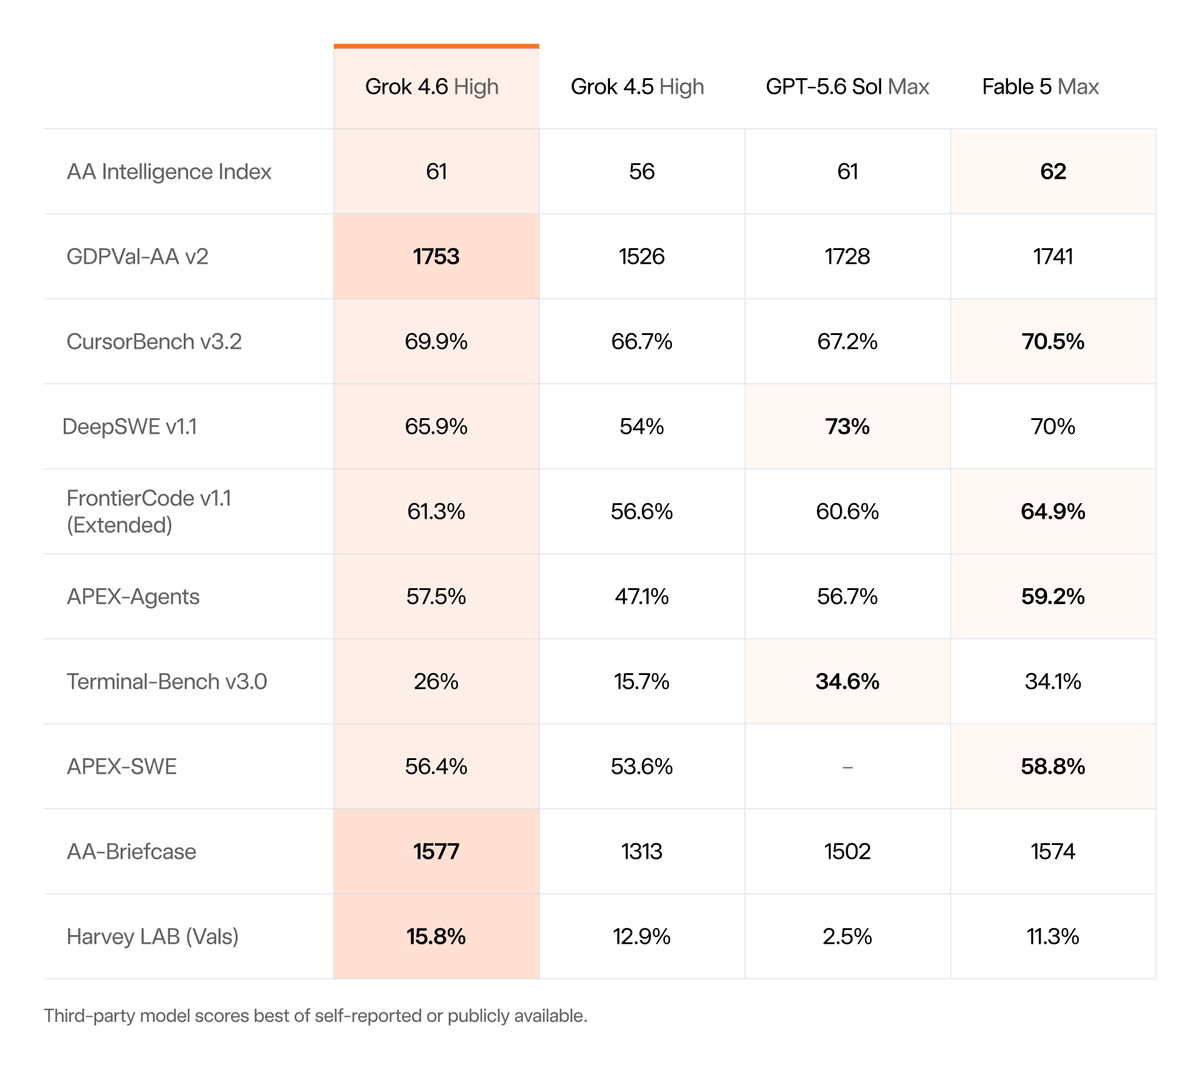
ความไม่สมดุลของราคาคือประเด็นสำคัญ ในส่วนของอินพุต Grok คิดค่าใช้จ่ายเพียงหนึ่งในหกของ OpenAI; และในส่วนของเอาต์พุตหนึ่งในห้า สำหรับปริมาณงานแชทก็เป็นสิ่งที่ดี; แต่สำหรับปริมาณงานของเอเจนต์ ซึ่งภารกิจเดียวสามารถสร้างการเรียกใช้โมเดลได้หลายสิบครั้งและบันทึกการใช้เครื่องมือที่ยาวนาน มันจะส่งผลให้เกิดความแตกต่างระหว่างเอเจนต์ราคา 50 ดอลลาร์ต่อวันกับ 250 ดอลลาร์ต่อวัน
เกณฑ์มาตรฐานการเขียนโค้ด: Sol สำหรับความลึก, Grok สำหรับความคุ้มค่า
ตามตัวเลขการเปิดตัว โมเดลแต่ละตัวมีความโดดเด่นในด้านที่แตกต่างกัน:
| เกณฑ์มาตรฐาน | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (การแก้ไขระดับ repository) | 65.9% | 73.0% | |
| FrontierCode v1.1 Extended | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
อ่านได้ดังนี้:
- การนำ DeepSWE 7 จุดของ GPT-5.6 Sol Max นั้นเป็นเรื่องจริงและมีความสำคัญ การแก้ไขข้อบกพร่องขนาด Repository เป็นเกณฑ์มาตรฐานการเขียนโค้ดที่ยากที่สุดและมีคุณค่าทางเศรษฐกิจมากที่สุด หากเอเจนต์ของคุณทำงานกับโค้ดเบสขนาดใหญ่ที่มีอยู่โดยมีการดูแลน้อยที่สุด Sol ก็ยังคงเป็นทางเลือกที่ปลอดภัยที่สุด การเปรียบเทียบ GPT-5.6 Sol กับ Claude Fable 5 ของเราครอบคลุมการเปรียบเทียบนี้อย่างละเอียด
- Claude Fable 5 ชนะด้วยความสม่ำเสมอ เป็นผู้นำในดัชนีรวม, FrontierCode และ APEX-Agents ไม่มีอะไรที่โดดเด่นเป็นพิเศษ แต่ก็แทบจะไม่เคยแย่กว่าอันดับสองเลย โปรไฟล์นี้เหมาะสำหรับงานอัตโนมัติระยะยาวที่ขั้นตอนผิดพลาดเพียงครั้งเดียวสามารถทำให้ความคืบหน้าหนึ่งชั่วโมงสะดุดได้
- Grok 4.6 ไม่เคยล้าหลังมากนัก และบางครั้งก็นำหน้า การเป็นผู้นำใน CursorBench และ Terminal-Bench ในขณะที่ยังคงอยู่ใกล้เคียงในด้านอื่น ๆ ด้วยค่าใช้จ่ายที่น้อยกว่ามาก เป็นโปรไฟล์ของโมเดลที่คุณควรส่งปริมาณงานส่วนใหญ่ไปให้ และส่งเฉพาะกรณีที่ยากจริงๆ ไปยังโมเดลอื่น
ข้อสังเกตที่ซื่อสัตย์: ตัวเลขเหล่านี้เป็นตัวเลขที่รายงานโดยผู้จำหน่ายเป็นส่วนใหญ่ในช่วงสัปดาห์เปิดตัว เกณฑ์มาตรฐานการเปิดตัวของ Grok 4.5 ต้องอ่านอย่างละเอียด และข้อควรระวังเดียวกันนี้ใช้กับผู้จำหน่ายทุกรายที่นี่
ค่าใช้จ่ายต่อภารกิจ ไม่ใช่ค่าใช้จ่ายต่อโทเค็น
ราคาโทเค็นอาจทำให้เข้าใจผิดเมื่อโมเดลมีความแตกต่างกันในด้านความละเอียดและอัตราการลองใหม่ (retry rates) โมเดลราคาถูกที่ทำงานล้มเหลวในครั้งสุดท้ายจะสร้างงานตรวจสอบและแก้ไขซึ่งมีค่าใช้จ่ายมากกว่าโทเค็นที่ประหยัดได้ ตัววัดที่ดีกว่าคือค่าใช้จ่ายต่อภารกิจที่สำเร็จ และในจุดนี้ การวัดผลอิสระของ Artificial Analysis นั้นโดดเด่น: Grok 4.6 มีค่าเฉลี่ย 0.84 ดอลลาร์ต่อภารกิจในการประเมินเอเจนต์ ซึ่งต่ำที่สุดในบรรดาโมเดลระดับแนวหน้า โดยได้รับความช่วยเหลือจากการใช้โทเค็นอย่างมีระเบียบวินัยมากกว่าแค่ราคาที่ถูก
ตัวอย่างการคำนวณ สมมติว่าเอเจนต์การเขียนโค้ดของคุณใช้โทเค็นอินพุตเฉลี่ย 500K และโทเค็นเอาต์พุต 100K ต่อภารกิจที่สำเร็จ:
| โมเดล | ค่าอินพุต | ค่าเอาต์พุต | ต่อภารกิจ |
|---|---|---|---|
| Grok 4.6 | $1.00 | $0.60 | $1.60 |
| Claude Opus 4.8 | $5.00 | $2.50 | $7.50 |
| GPT-5.6 Sol | $6.00 | $3.00 | $9.00 |
ที่ 1,000 ภารกิจต่อเดือน Grok สามารถประหยัดเงินได้ประมาณ 6,000–7,400 ดอลลาร์ เมื่อเทียบกับตัวเลือกอื่น ๆ หากอัตราความสำเร็จในปริมาณงานของคุณยังคงอยู่ เงื่อนไขนี้เป็นหัวใจสำคัญของเกม ซึ่งเป็นเหตุผลที่คุณควรทดสอบก่อนตัดสินใจใช้จริง
การออกแบบ API ที่ใช้งานง่าย: ต้นทุนที่แท้จริงของการผสานรวม
- Grok 4.6 รองรับ OpenAI หากคุณมีไคลเอ็นต์ที่รองรับ OpenAI คุณสามารถชี้
base_urlไปที่https://api.x.ai/v1และเริ่มใช้งานได้ทันที นอกจากนี้ยังมีให้บริการบน OpenRouter, Vercel และ Cloudflare สำหรับผู้ใช้เกตเวย์ - GPT-5.6 Sol มีระบบนิเวศที่ลึกที่สุด: Responses API, การเรียกใช้เครื่องมือแบบโปรแกรม และ SDK ของบริษัทเองที่มีอยู่ทั่วไป ดู วิธีการใช้ GPT-5.6 API สำหรับโครงสร้างระดับชั้น
- Claude Fable 5 ใช้ Messages API ของ Anthropic ซึ่งมีรูปแบบคำขอที่แตกต่างกัน ความน่าเชื่อถือในการใช้เครื่องมือที่ยอดเยี่ยม และพารามิเตอร์ effort ที่แลกเปลี่ยนค่าใช้จ่ายกับความสามารถภายในโมเดลเดียว
ความยุ่งยากในการโยกย้ายต่ำที่สุดระหว่าง Grok และ OpenAI (รูปแบบที่ใช้ร่วมกัน) และสูงสุดเมื่อย้ายไปหรือมาจาก Anthropic หากคุณคาดว่าจะสลับหรือกำหนดเส้นทางระหว่างโมเดล ความไม่สมมาตรนั้นควรเป็นส่วนหนึ่งของการตัดสินใจทางสถาปัตยกรรมของคุณ
หน้าต่างบริบท: เมื่อ 500K เพียงพอ
บนกระดาษ หน้าต่างโทเค็น 1.05M ของ GPT-5.6 Sol เป็นสองเท่าของ 500K ของ Grok 4.6 โดยมี 1M ของ Claude Fable 5 ตามมาติดๆ ในทางปฏิบัติ คำถามคือปริมาณงานของคุณเก็บอะไรไว้ในบริบทจริงๆ
หน้าต่าง 500K สามารถบรรจุคำได้ประมาณ 350,000 คำ: ซึ่งเป็นโค้ดเบสทั้งหมดของบริการขนาดกลาง, บันทึกการสนับสนุนหนึ่งปี หรือเอกสารทางกฎหมายหลายร้อยหน้า งานของเอเจนต์ส่วนใหญ่ไม่เคยใช้ถึงขนาดนั้น ปริมาณงานที่ต้องการระดับล้านโทเค็นอย่างแท้จริงนั้นมีจำกัด: การวิเคราะห์ทั้ง monorepo, บันทึกการสนทนาของเอเจนต์หลายเซสชันที่ยาวมากที่คุณไม่ต้องการสรุป และการประมวลผลเอกสารขนาดใหญ่จำนวนมากในการเรียกใช้ครั้งเดียว
ข้อสังเกตเชิงปฏิบัติสองประการที่คัดค้านการเลือกตามขนาดหน้าต่างเพียงอย่างเดียว ประการแรก ทุกโมเดลจะประสิทธิภาพลดลงเมื่อบริบทเต็ม; คุณภาพการดึงข้อมูลที่ความจุ 80% จะแย่กว่าที่ 20% ในทั้งสามโมเดล ดังนั้นสถาปัตยกรรมที่ยัดข้อมูลเต็มหน้าต่างจึงไม่ค่อยดีกว่าสถาปัตยกรรมที่ดึงข้อมูลแบบเลือกสรร ประการที่สอง โทเค็นอินพุตคือส่วนที่งบประมาณหมดไป: การเติมหน้าต่างเต็มของ Sol มีค่าใช้จ่ายประมาณ 12.60 ดอลลาร์ต่อคำขอตามราคาที่ระบุ ในขณะที่การเติมของ Grok มีค่าใช้จ่าย 1 ดอลลาร์ หากพร้อมท์ของคุณเกิน 400K โทเค็นเป็นประจำ คุณไม่เพียงแค่ต้องการหน้าต่างที่ใหญ่ขึ้นเท่านั้น แต่คุณยังต้องการกลยุทธ์การแคชและการดึงข้อมูลด้วย ไม่ว่าคุณจะเลือกผู้จำหน่ายรายใดก็ตาม
วันที่อัปเดตข้อมูลและความพร้อมของระบบนิเวศ
Grok 4.6 มาพร้อมกับวันที่อัปเดตข้อมูลถึง 1 กุมภาพันธ์ 2026 ซึ่งใหม่ที่สุดในสามโมเดล ซึ่งสำคัญสำหรับเอเจนต์การเขียนโค้ดที่อ้างอิงเฟรมเวิร์กที่มีการเปลี่ยนแปลงอย่างรวดเร็ว นี่เป็นข้อได้เปรียบที่แท้จริงแต่เล็กน้อย: สแต็กเอเจนต์ที่จริงจังจะใช้เครื่องมือดึงข้อมูลและเอกสารประกอบเป็นพื้นฐานมากกว่าการเชื่อถือความรู้แบบพารามิเตอร์
ระบบนิเวศเป็นเรื่องที่ตรงกันข้าม OpenAI มีพื้นผิวการผสานรวมกับบุคคลที่สามที่ลึกที่สุด, Anthropic มีส่วนแบ่งทางความคิดในกรอบการทำงานของเอเจนต์ที่แข็งแกร่งที่สุด และ xAI เป็นผู้มาใหม่ที่อาศัยความเข้ากันได้กับ OpenAI เพื่อยืมทั้งสองอย่าง การเดิมพันนั้นส่วนใหญ่ใช้ได้ผล: สิ่งใดก็ตามที่รองรับรูปแบบการเติมข้อความแชทสามารถใช้งานกับ Grok ได้ในวันนี้ และการเข้าถึงผ่านเกตเวย์อย่าง OpenRouter, Vercel และ Cloudflare หมายความว่าคุณสามารถนำไปใช้ได้โดยไม่ต้องปรับเปลี่ยนโครงสร้างพื้นฐานของคุณ สิ่งที่คุณต้องแลกคือความสมบูรณ์ของฟังก์ชันการทำงานหลัก, Batch API, ระบบแคช และการควบคุมการใช้งานแบบละเอียด ซึ่งยังไม่สมบูรณ์เท่าของคู่แข่งรายเก่า
โมเดลใดเหมาะกับงานใด
- เอเจนต์เขียนโค้ดอัตโนมัติขนาด repository, เน้นคุณภาพเป็นอันดับแรก: GPT-5.6 Sol การเป็นผู้นำของ DeepSWE หมายถึงความผิดพลาดที่น้อยลงในการรันบนโค้ดเบสขนาดใหญ่
- งานที่ต้องใช้ความรู้ในระยะยาวและเซสชันของเอเจนต์หลายชั่วโมง: Claude Fable 5 มีคะแนนรวมดีที่สุด, เกณฑ์มาตรฐานเอเจนต์ดีที่สุด, มีประวัติที่แข็งแกร่งที่สุดในการทำงานได้ราบรื่น
- ปริมาณงานเอเจนต์สูง, ผลิตภัณฑ์ที่คำนึงถึงต้นทุน, หรือโมเดลเริ่มต้นของ Router: Grok 4.6 ให้ผลลัพธ์ระดับแนวหน้าในราคาที่ถูก; ส่งต่อ 10% ของงานที่ยากที่สุดไปยัง Sol หรือ Fable
- การเขียนโค้ดแบบโต้ตอบใน IDE: การที่ Grok 4.6 เป็นผู้นำใน CursorBench และรุ่นที่เร็วขึ้น 2 เท่า ทำให้เป็นคู่แข่งที่น่าสนใจ; มันถูกสร้างขึ้นมาเพื่อสิ่งนี้โดยเฉพาะหลังจาก ได้รับการฝึกฝนจากเซสชัน Cursor จริง
ทดสอบทั้งสามบนระบบของคุณได้ในบ่ายวันเดียว
เกณฑ์มาตรฐานคาดการณ์ค่าเฉลี่ย ไม่ใช่ปริมาณงานของคุณ นี่คือการทดสอบแบบทำซ้ำได้โดยใช้ Apidog:
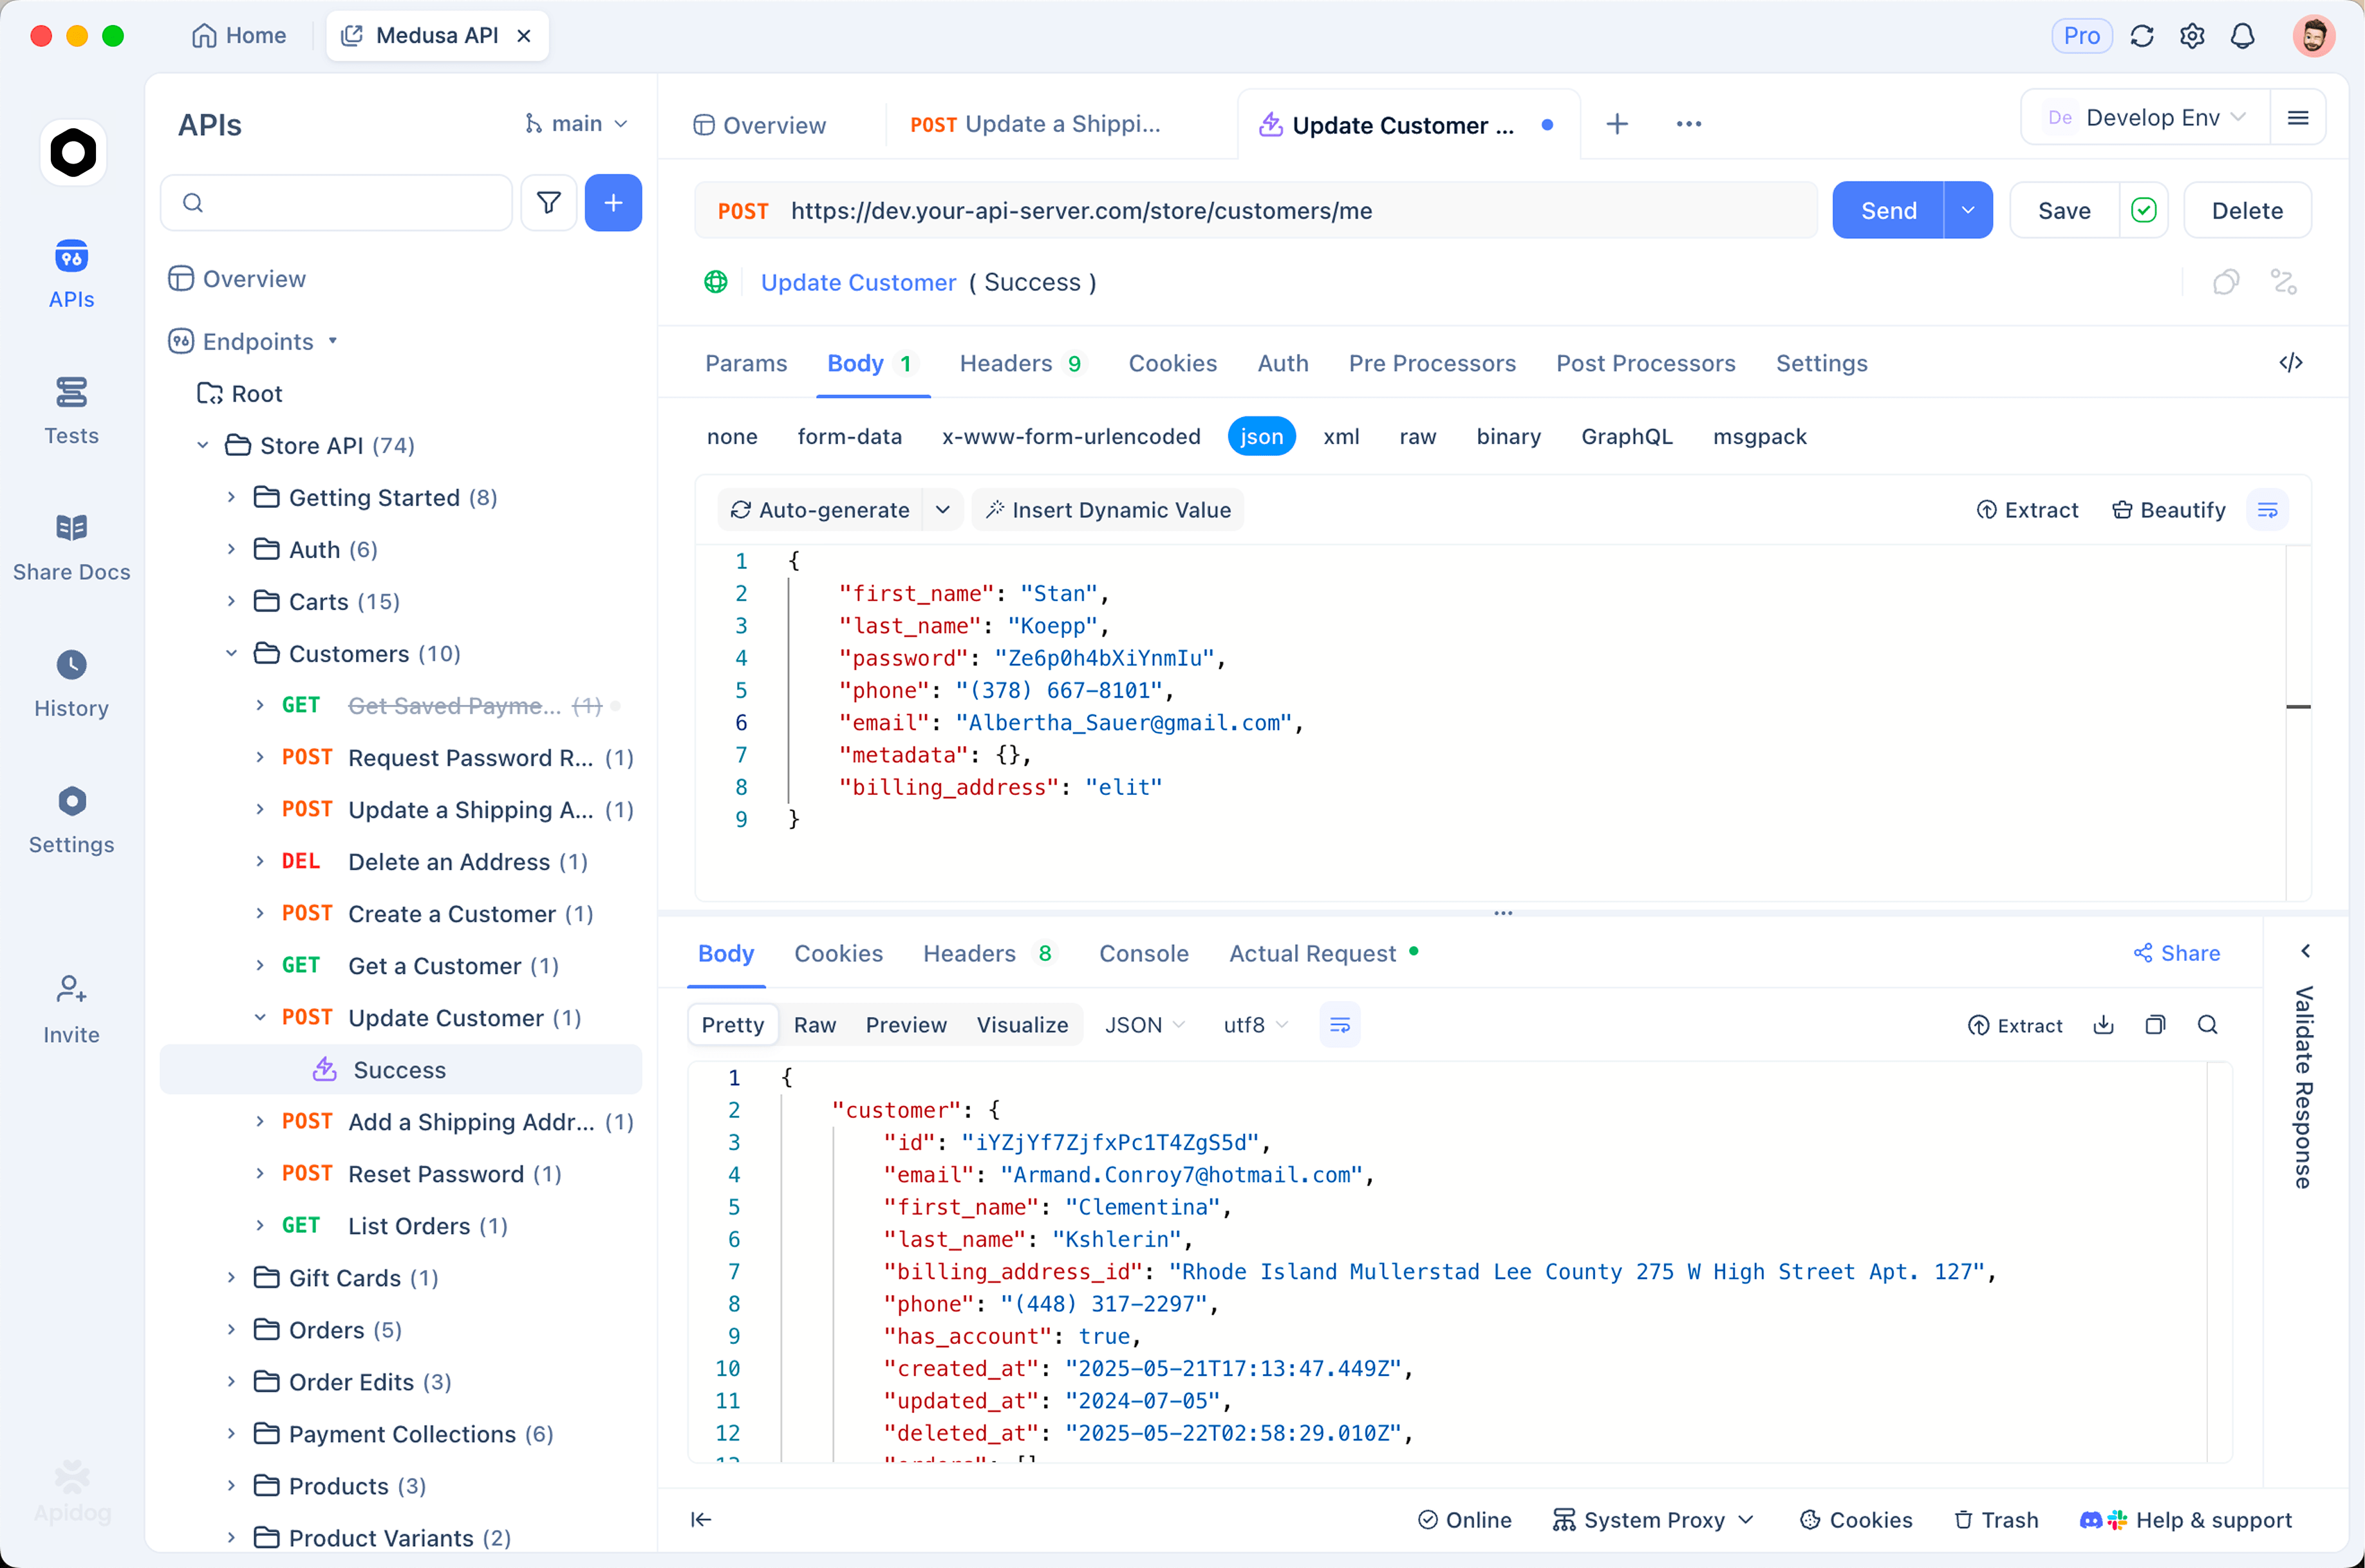
- หนึ่งโปรเจกต์ สามสภาพแวดล้อม สร้างสภาพแวดล้อมสำหรับ xAI (`api.x.ai/v1`), OpenAI และ Anthropic โดยแต่ละแห่งมีระบบยืนยันตัวตนเป็นของตัวเอง คำขอเดียวกันสามารถเปลี่ยนผู้ให้บริการได้ด้วยการเลือกจากเมนูแบบเลื่อนลงเพียงครั้งเดียว
- รวบรวม 20 พร้อมท์จริง ดึงงานจริงจากผลิตภัณฑ์ของคุณ ไม่ใช่คำถามเล่นๆ รวมพร้อมท์ระบบของคุณ, คำจำกัดความเครื่องมือของคุณหากคุณใช้การเรียกใช้ฟังก์ชัน และอย่างน้อยห้ากรณีที่ทราบว่ายาก
- ยืนยันสิ่งที่คุณให้ความสำคัญ เพิ่มการยืนยัน Apidog สำหรับความถูกต้องของคำตอบ, การใช้โทเค็นจากออบเจกต์ `usage` และเกณฑ์ความล่าช้า สำหรับปริมาณงานที่เรียกใช้เครื่องมือ ให้ยืนยันว่า JSON ของการเรียกใช้เครื่องมือสามารถแยกวิเคราะห์ได้และตรงกับสคีมาของคุณ โมเดลมักจะล้มเหลวในจุดนี้บ่อยกว่าในการสร้างข้อความทั่วไป
- เรียกใช้เป็นสถานการณ์ทดสอบ สามครั้งต่อโมเดล ผลลัพธ์ของ LLM มีความหลากหลาย; การรันสามครั้งจะเปิดเผยความแปรปรวนที่การสาธิตครั้งเดียวซ่อนไว้ ส่งออกผลลัพธ์และเปรียบเทียบอัตราความสำเร็จและค่าใช้จ่ายต่อความสำเร็จ ไม่ใช่ค่าใช้จ่ายต่อโทเค็น
- เก็บชุดทดสอบไว้ เมื่อโมเดลเวอร์ชันถัดไปออก (ตามกำหนดปัจจุบัน ภายในไม่กี่เดือน) ให้รันซ้ำ การเลือกโมเดลเป็นการตัดสินใจรายไตรมาสแล้ว และทีมที่มีเครื่องมือประเมินผลมาตรฐานจะสามารถเปลี่ยนได้เร็วกว่าทีมที่ตัดสินใจใหม่ด้วยเรื่องเล่าต่างๆ หลายสัปดาห์
คำถามที่พบบ่อย
- Grok 4.6 ดีกว่า GPT-5.6 Sol หรือไม่? ทั้งสองเสมอกันในดัชนีรวมที่ 61 Sol เป็นผู้นำอย่างชัดเจนในการเขียนโค้ดขนาด repository (DeepSWE 73.0% เทียบกับ 65.9%); Grok เป็นผู้นำใน CursorBench และ Terminal-Bench และมีค่าใช้จ่ายน้อยกว่า 5 เท่าในส่วนเอาต์พุต "ดีกว่า" ขึ้นอยู่กับว่าปริมาณงานของคุณดูเหมือน DeepSWE หรือเหมือนเซสชัน IDE มากกว่า
- Grok 4.6 ดีกว่า Claude Fable 5 หรือไม่? Fable 5 เป็นผู้นำในดัชนี (62 เทียบกับ 61), FrontierCode และ APEX-Agents ซึ่งทั้งหมดนำอยู่เพียงเล็กน้อย ข้อได้เปรียบของ Grok คือราคา สำหรับงานอัตโนมัติที่ต้องการความแม่นยำสูง Fable 5 คือตัวเลือก; สำหรับปริมาณงานที่คำนึงถึงต้นทุน Grok คือตัวเลือก
- โมเดล AI ใดที่ถูกที่สุดในระดับแนวหน้าในปี 2026? Grok 4.6 ที่ราคา 2 ดอลลาร์/6 ดอลลาร์ต่อล้านโทเค็น และวัดผลอิสระที่ 0.84 ดอลลาร์ต่อภารกิจของเอเจนต์ โทเค็นเอาต์พุตของคู่แข่งแนวหน้าที่ใกล้ที่สุดมีค่าใช้จ่ายประมาณ 4 เท่า
- ฉันควรเปลี่ยนเอเจนต์ในระบบการผลิตไปใช้ Grok 4.6 หรือไม่? ไม่ใช่แค่เกณฑ์มาตรฐานเพียงอย่างเดียว ให้ทำการทดสอบที่กล่าวมาข้างต้นกับปริมาณงานจริงของคุณก่อน ช่องว่างราคา 5 เท่าจะคุ้มค่าก็ต่อเมื่ออัตราความสำเร็จยังคงอยู่กับภารกิจของคุณ
- ฉันสามารถใช้โมเดลทั้งสามภายใต้รูปแบบ API เดียวกันได้หรือไม่? ส่วนใหญ่ทำได้ Grok 4.6 รองรับรูปแบบการเติมข้อความแชทของ OpenAI โดยตรง ดังนั้นจึงใช้โค้ดไคลเอ็นต์ร่วมกับ GPT-5.6 ได้ Claude ต้องการ Messages API ของ Anthropic หรือเกตเวย์อย่าง OpenRouter ที่ทำให้ทั้งสามโมเดลทำงานภายใต้อินเทอร์เฟซเดียวโดยมีค่าธรรมเนียมเล็กน้อย
- ขนาดหน้าต่างบริบทที่เล็กกว่าของ Grok 4.6 มีความสำคัญหรือไม่? สำหรับงานเอเจนต์และแชทส่วนใหญ่ ไม่สำคัญ; 500K โทเค็นนั้นสูงกว่าการใช้งานปกติมาก และโมเดลทั้งสามก็ประสิทธิภาพลดลงเมื่อใกล้ถึงขีดจำกัดอยู่ดี มันจะสำคัญถ้าคุณประมวลผล monorepo ทั้งหมดหรือชุดเอกสารขนาดใหญ่เป็นประจำในการเรียกใช้ครั้งเดียว ซึ่งหน้าต่างขนาด 1.05M ของ Sol จะช่วยให้มีพื้นที่ทำงานจริง
ปุ่ม